研究定位
ViT 把图像切成 patch,把每个 patch 投影成 token。Transformer 因此可以处理图像,但 token 数量会直接决定注意力成本。
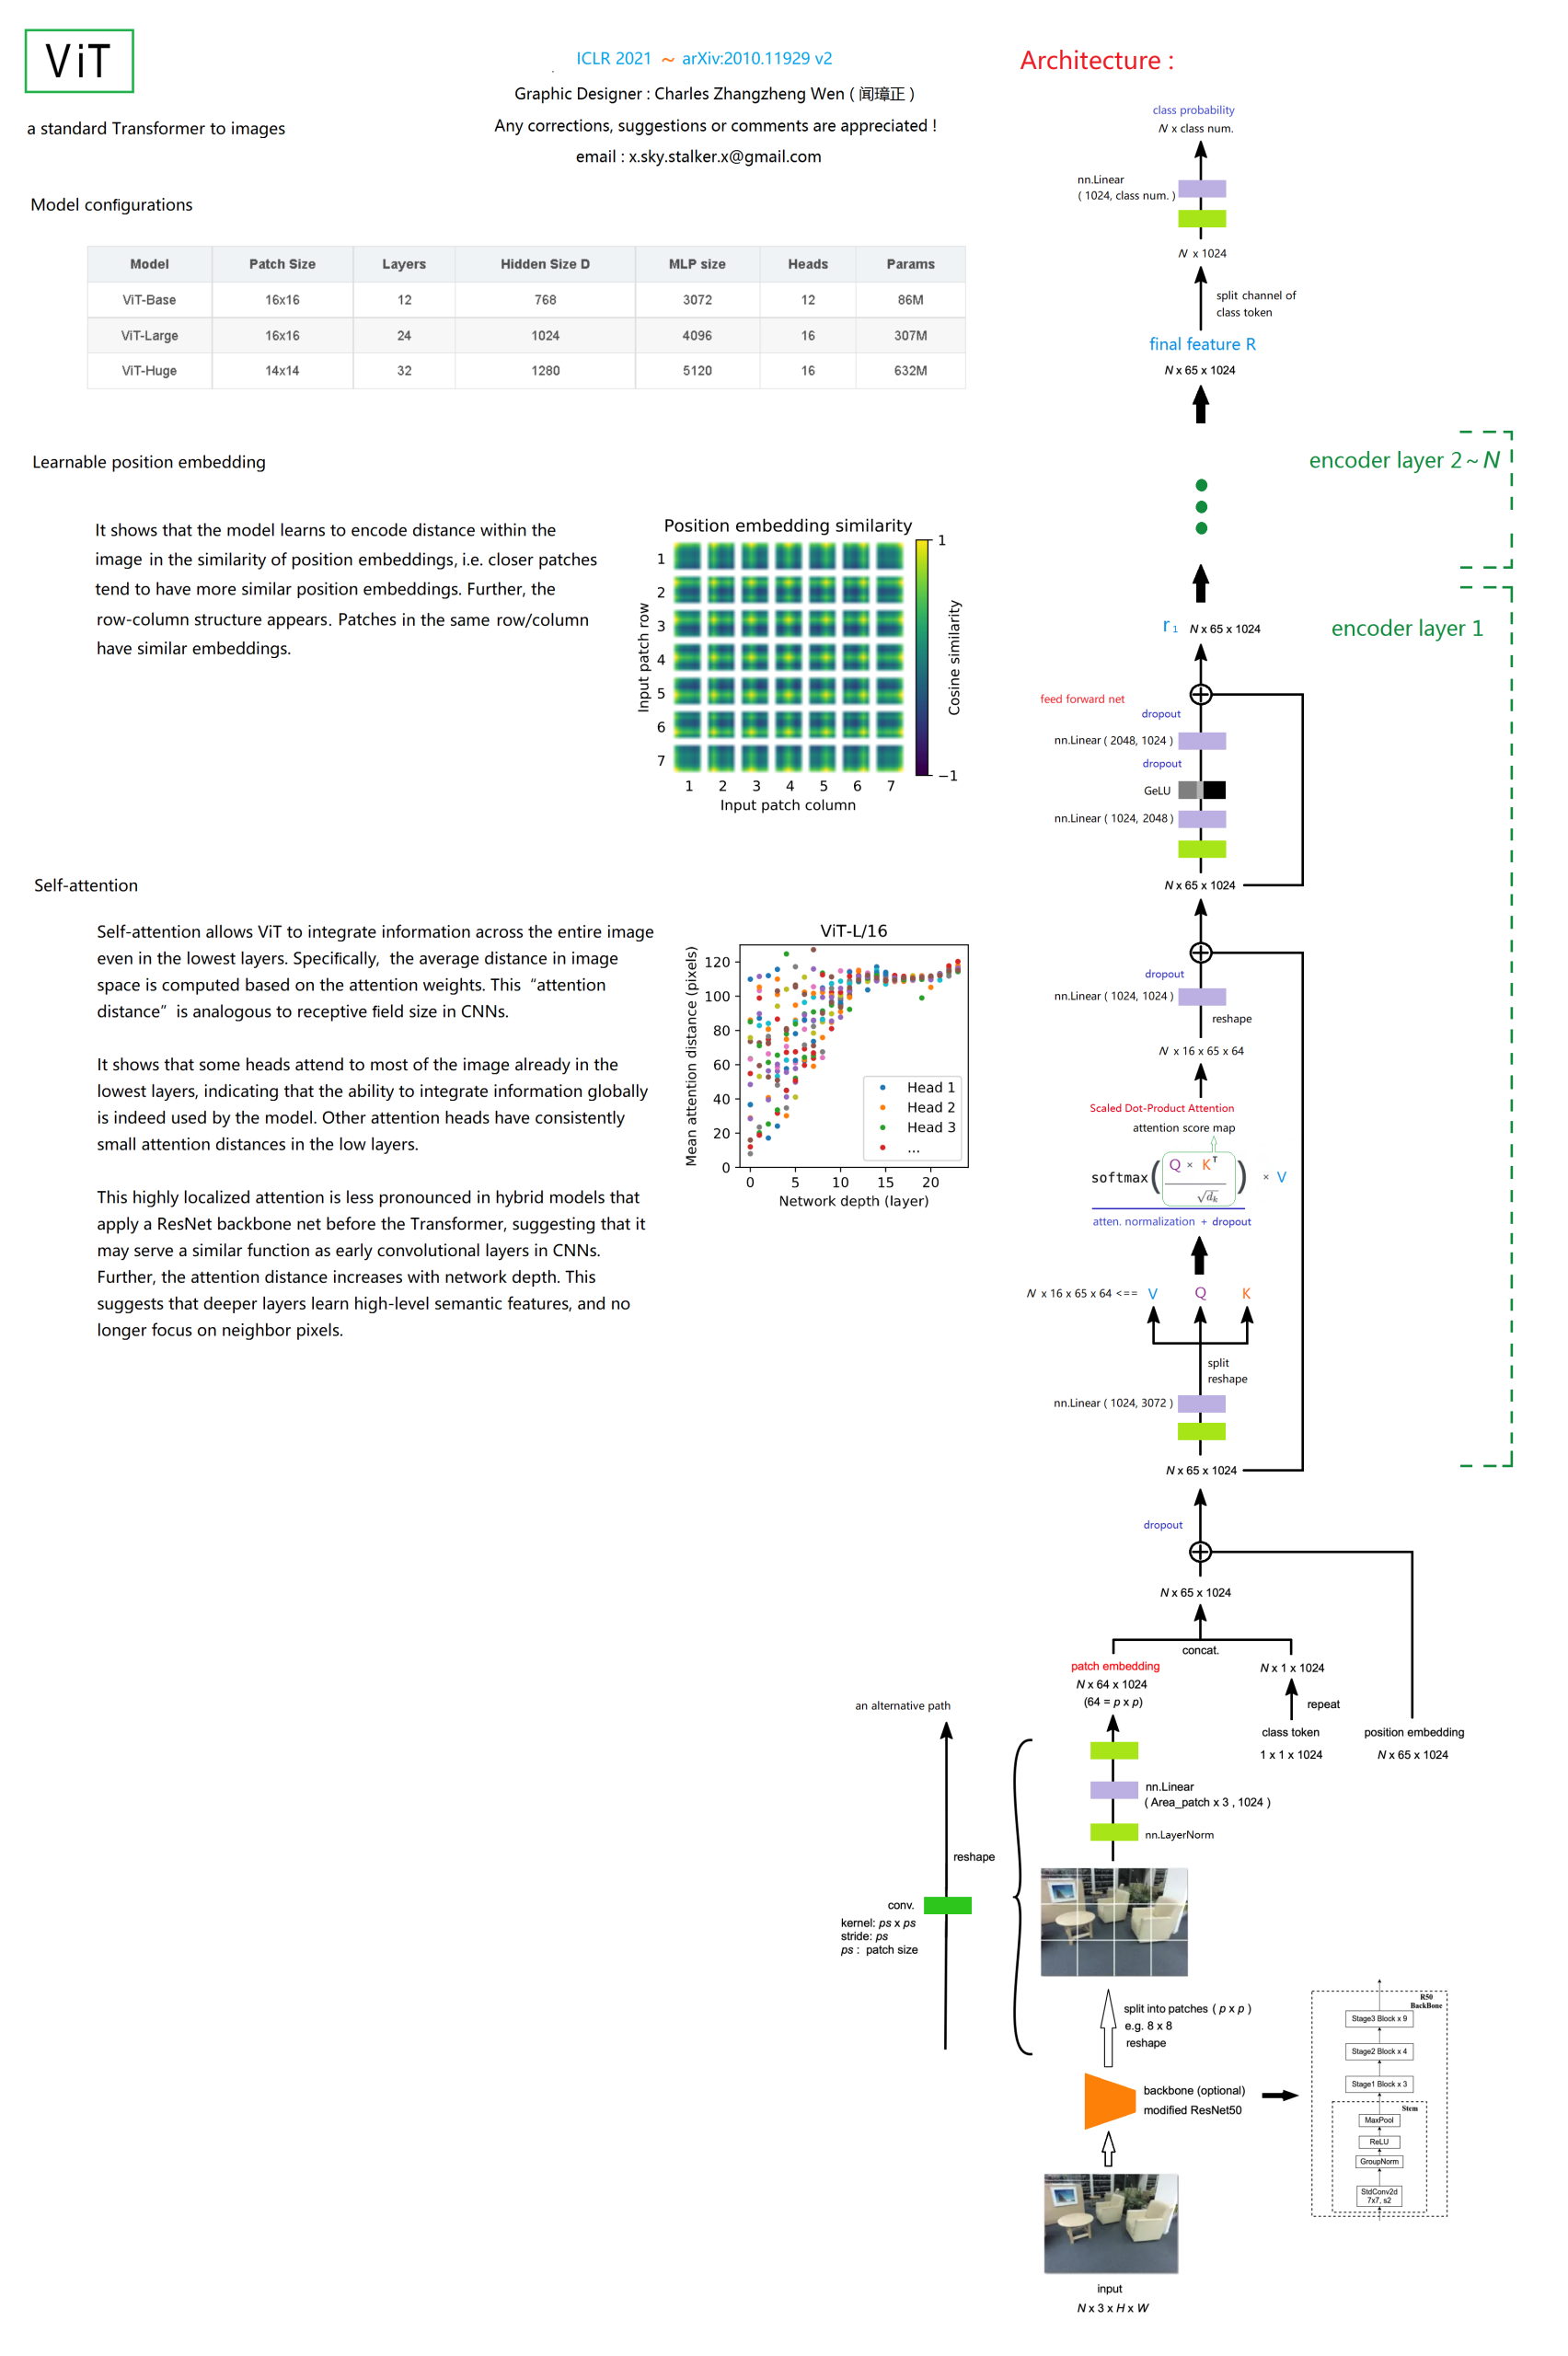
模型比较
ViT:全局 patch 自注意力
若图像为 H×W、patch 为 P×P:
$$
N=\frac{HW}{P^2}
$$
[B,3,H,W] → patchify [B,N,3P²]
→ projection [B,N,D] → 位置编码
→ Transformer Encoder → 分类头
$$
Attention(Q,K,V)=softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)V
$$
注意力矩阵为 [B,h,N,N]。patch 越小,细节越多,但 N2 成本上升很快。
Swin:窗口注意力与层级特征
注意力只在局部窗口中计算,下一层移动窗口,让原本分隔的窗口交换信息;patch merging 逐步降低分辨率、增加通道,形成适合检测与分割的层级结构。
MAE:遮住大部分 patch 再重建
Encoder 只处理可见 patch,轻量 Decoder 补入 mask token 并重建被遮挡区域。预训练的目的不是最终修图,而是学习可迁移表征;下游任务通常保留 Encoder、丢掉 Decoder。
DINO:不同视图保持一致
自监督 DINO 使用 student–teacher,让同一图像不同视图的输出保持一致;teacher 常由 student 参数的指数滑动平均更新。它和 DETR 系的“检测版 DINO”同名但不是同一个模型。
研究小结
ViT 证明 patch token 可行;Swin 解决高分辨率和层级特征问题;MAE 研究高效遮挡重建预训练;DINO 研究无标签的一致性表征。它们不是简单替代关系,而是在回答不同问题。
研究延伸
视觉 Transformer 的关键问题是 token 数、注意力范围和预训练目标。后续可以比较 patch size、窗口大小、mask ratio、teacher 更新方式对表示质量和计算成本的影响。
读相关论文时建议记录:模型是否需要大规模预训练,迁移到检测/分割时是否保留层级特征,性能提升来自架构本身还是训练配方。这样能避免把“更大的训练资源”误读成“更好的结构”。