把 day05~07 学过的 Transformer 架构接上真实数据,用 Tatoeba 英法句对走完「清洗 → 双词表 → 截断填充 → 三类 Mask → token 级 loss → Teacher Forcing → 自回归解码 → BLEU」的全流程,并留下 25 个 epoch 的真实训练曲线、一次真实的翻译失败样例和一份手写 BLEU 实现。
一、这份材料解决什么问题
day05~07 那份材料讲的是「Transformer 是什么」:多头注意力怎么拆、Mask 怎么加、nn.Transformer 有哪些参数。但架构看懂 ≠ 会做任务。真正上手时有三个问题必须回答,这份材料就是来回答它们的:
- 数据怎么进模型。翻译任务的输入是两句话(英、法),不是分类任务的一个标签。两条序列各自要维护一张词表、各自要
embedding → 位置编码,还要把变长句子对齐成固定长度的张量。词表之外的新词怎么办?句首句尾谁来告诉模型”开始/结束”?这是PAD/SOS/EOS与截断填充要解决的事。 - Mask 到底该在哪几个位置加。day05~07 讲了”mask 是给分数加 -10^9“,但实际写代码时有 三个 mask 张量要传,而且同一个 mask 在不同注意力模块里要传两次、另一次又绝对不能传。传错不会报错,只会让指标悄悄变坏,这是本案例最容易翻车、也最容易被评审者追问的地方。
- 指标怎么算才有意义。翻译是”一个源句对应多个正确目标句”的任务,逐 token 准确率根本衡量不了翻译质量(本案例的原文就明确写了这一点),所以要引入 BLEU,并且要看清 token acc 与 BLEU 之间的落差从哪来。
在整条学习链上的位置:
RNN/LSTM/GRU(day03)→ 注意力机制(day04)→ Transformer 架构(day05~07)
                                                    ├→ Transformer 英译法案例(day08,本份:架构→端到端任务)
                                                    ├→ RNN 英译法案例(day09,同一任务、旧架构的对照组)
                                                    ├→ FastText(day10,非 Transformer 路线)
                                                    ├→ transformers 迁移学习 / BERT 微调(day11)
                                                    └→ BERT 与 GPT 架构(day12)
对新闻分类项目(类今日头条新闻标题 10 分类)来说,这份材料提供的是四个可迁移的工程习惯,而不是翻译本身:
| 本案例的做法 | 在项目里的等价物 |
|---|---|
用 padding_idx + ignore_index 让 <PAD> 不参与 loss 与准确率 |
标题分类用 tokenizer(..., padding='max_length') + attention_mask,loss 同样要忽略 padding |
先看句子长度分布再定 seq_len(原文强调”只能用训练集”) |
定新闻标题的 max_length(128/256)不能拍脑袋,要看长度分位数 |
| 按最小验证损失保存模型,而不是存最后一个 epoch | BERT 微调同样存 best checkpoint,否则存到过拟合模型 |
| 先划分数据集再构建词表(原文写”工程上应该这样”,但代码没这么做) | 防数据泄漏的通用纪律,见第五节 |
二、核心结论
- 这个案例 = 一张 mask 表 + 一条移位规则。整份代码的骨架就两句话:
tgt_input = target[:, :-1](右移一位作解码器输入)、tgt_output = target[:, 1:](原序列作监督信号);再配三个 mask,src_key_padding_mask、tgt_key_padding_mask、tgt_mask(因果)。架构本身交给nn.Transformer,一行搞定。 - 同一个 padding mask 用两次,因果 mask 只在解码器掩码自注意力里用一次。
src_key_padding_mask既作编码器的key_padding_mask(屏蔽源句 PAD),又作解码器交叉注意力的memory_key_padding_mask(屏蔽编码器输出的 PAD,因为那是同一批位置);解码器的掩码自注意力则同时收tgt_key_padding_mask(管 PAD)和tgt_mask(管未来)。 - 解码器必须加因果 mask,是因为训练时整句目标是并行喂进去的。不遮未来,模型在第 i 步就能直接”看见”第 i+1 个真实词,训练 loss 会低到失真,推理时却拿不到未来词,指标立刻崩溃。因果 mask 让训练时的信息可见范围与推理时严格一致。
- Teacher Forcing 是训练提速换来的”训练-推理不一致”。训练喂真实目标词,一次前向得到所有位置的 logits;推理喂自己上一步的输出,误差会累积。本案例实测把这种落差量化得很清楚:同一批测试数据,Teacher Forcing 下 token acc = 0.7431、loss = 1.4538;换成自回归生成,acc 掉到 0.6097、loss 涨到 3.2650(acc 掉 13.3 个百分点,loss 涨 124%)。这个差距就是 exposure bias。
- token accuracy 只能当调试信号,不能当翻译质量。25 个 epoch 后 train acc = 0.9257 / val acc = 0.7606,但模型对
"i love you"的真实输出是"je vous vous .",代词错、还重复了一个词。原文自己就点明了这一点,并给了替代指标:自回归生成 + corpus BLEU,本案例实测 BLEU = 35.74(单参考、简化实现,见 4.8 的局限说明)。
三、知识地图
原文的学习目标与章节结构如下(【掌握】/【了解】照录原文标注):
day08 Transformer 英译法案例(10 个一级章节)
├── 学习目标
│   ├── 了解 英译法的数据集
│   ├── 掌握 构建词表的方法                              【掌握】
│   ├── 掌握 数据处理中的截断填充方法                    【掌握】
│   ├── 掌握 构建基于 Transformer 的 EncoderDecoder 模型 【掌握】
│   └── 掌握 训练基于 Transformer 的 EncoderDecoder 模型 【掌握】
├── 1 案例描述:端到端 英文→法文 机器翻译,覆盖完整 NLP 工作流
├── 2 获取数据:.\data\eng-fra-v2.txt(英\t法 制表符分隔)
├── 3 数据预处理
│   ├── 1 文本清洗:转小写 / 去无效字符 / 保留 . ! ?        【降低词表规模,减少噪声】
│   ├── 2 特殊符号(必须):<PAD> / <SOS> / <EOS>          【决定 Seq2Seq 能否正确工作】
│   └── 3 Padding 与截断:统一到 MAX_LENGTH,<PAD> 必须忽略
├── 4 模型结构
│   ├── 输入部分:nn.Embedding(vocab_size, d_model) + 可学习位置编码 nn.Embedding(seq_len, d_model)
│   ├── EncoderDecoder:nn.Transformer(d_model, nhead, num_encoder_layers, num_decoder_layers, dim_feedforward, dropout)
│   ├── 输出部分:nn.Linear(d_model, vocab_size)
│   ├── 输入输出形状表(source / logits / target 输入输出)
│   ├── 掩码 mask 三种(src_key_padding_mask / tgt_key_padding_mask / tgt_mask)  ← 本份材料的核心
│   └── 实现过程 0~6(清洗→词表→数据集→搭网→训练→测试→预测)
├── 5 训练关键技术
│   ├── 5.1 损失函数:CrossEntropyLoss(ignore_index=pad_idx)
│   ├── 5.2 准确率定义:Token-level Accuracy(忽略 PAD),⚠ token acc ≠ 翻译质量,真实评估用 BLEU
│   ├── 5.3 推理流程:自回归(Next Token Prediction)5 步表
│   └── 5.4 Teacher Forcing:训练用真实目标词,验证/测试/预测用模型预测词
├── 6 Transformer 英译法案例(完整可运行代码 + 逐 epoch 真实输出)  【掌握】
├── 7 扩展:Transformer 为什么能在 seq_len 维度并行?      【原理补丁】
│   └── 注意力是矩阵运算 / Teacher Forcing 让整句一次前向 / 因果掩码只限制信息流不破坏并行 / 推理有自回归依赖
├── 8 扩展:BLEU 指标
│   ├── 8.1 BLEU 是什么(n-gram 重合度 + 长度惩罚,常用 BLEU-4)
│   ├── 8.2 怎么算(n-gram 精确率带截断 → 几何平均 → BP)
│   ├── 8.3 数据示例 BLEU-2 手算(Ref: je suis etudiant / Cand: je suis un etudiant → ≈50 分)
│   └── 8.4 一句话理解(BLEU 低不一定完全错;实际项目配合人工评估)
├── 9 常见高频题(4 题:评价指标 / padding 干扰 / 推理流程 / Label Smoothing)  【重点】
└── 10 代码作业
    ├── 作业1:改超参数(d_model 256→128 等),对比参数量(17,363,968 → 2,178,560)
    ├── 作业2:手写 BLEU-1,对 5 条翻译结果打印预测/参考/分数
    └── 作业3:Beam Search 最简实现(beam_size=3,对比贪心解码)
四、原理详解
4.1 数据准备:清洗、双词表,以及一个被漏掉的 <UNK>
翻译任务要维护两张词表,源语言(英文)和目标语言(法文)各一张,因为它们共享一个词表没有意义(英法只有极少数拼写重叠)。词表的本质是 token → id 的字典,加上反向字典 id → token 用于把生成结果翻译回文本。
机制。清洗函数 clean_text 只做三件事:
def clean_text(string):
    string = string.strip().lower()                       # 1. 转小写 + 去首尾空白
    string = re.sub(r"([.!?])", r" \1 ", string)           # 2. 标点前后补空格(让它变成独立 token)
    string = re.sub(r"[^a-zA-Z.!?]+", r" ", string)        # 3. 字母和 .!? 之外的字符全部换成空格
    return string.strip()
第 2 步很关键:"i am ok." 若不去补空格,标点会粘在词上,ok. 和 ok 会变成两个 token,词表凭空膨胀;补完空格后标点独立成 token,全语料只需要 3 个标点符号。第 3 步顺手干掉了数字、重音符号、撇号,注意这一步把法语的 é/è/à 全部抹平(etudiant 而不是 étudiant),也把 don't 拆成 don + t,这是后面输出 "je vous vous ." 这类奇怪结果的数据层面原因之一。
词表构建的实际做法是一遍遍历 + 去重:
src_vocab = {token: idx for idx, token in enumerate(SPECIAL_TOKENS)}   # <PAD>0 <SOS>1 <EOS>2
for source, target in pairs:
    for token in source.split():
        if token not in src_vocab:
src_vocab[token] = len(src_vocab) # 新词的 id = 当前词表长度真实规模(原文输出):src_vocab 2804 个 token、tgt_vocab 4346 个 token、去重后 10593 个句对。法文词表比英文大,符合直觉(法语动词变位、冠词、性数配合把形态撑开了:desole / desolee、payee)。
一个真实的缺陷:没有 <UNK>。SPECIAL_TOKENS 只有 3 个符号,而所有”词表外”的 fallback 都指向索引 0:
index_source = [self.src_vocab.get(token, self.src_vocab.get("", 0)) for token in source.split()]dict.get(token, 默认值) 的默认值是 <PAD> 的索引 0。也就是说,任何 OOV 词都会被当成 <PAD>。这在训练时被 ignore_index 顺手掩盖了(那些位置不算 loss),但代价是:一个句子里出现新词,那个位置在编码器里就退化成”空白填充向量”,模型只能靠上下文猜。正确做法是加一个 <UNK> token,让 OOV 落到 <UNK> 上,模型至少知道”这里有个词,只是我不认识”。这是本案例最值得在被追问时主动指出的问题。
另一个纪律问题:代码是在全量数据上建词表、之后才划分 train/val/test(代码注释自己也承认了:”注意工程上,应该先划分数据集,再使用训练集来构建词表”)。这构成轻度的数据泄漏,测试集里的词被收进了词表。在这个案例里影响很小(词表不做筛选、没有 min_freq),但同样的写法搬到分类项目上就会虚高指标。
4.2 特殊符号与截断填充:把变长句子对齐成张量
一个 batch 里每个句子长度都不同,张量要求形状规整,所以必须对齐。对齐的不是空白,而是两个信息:’这里开始’、’这里结束’、’这里啥也没有’。这三个语义分别就是 <SOS>、<EOS>、<PAD>。
为什么 Seq2Seq 必须有 <SOS> / <EOS>:解码器是自回归的,它需要知道”从哪一格开始生成”(第一格喂 <SOS>);也需要一个可学习的停止信号,否则模型不知道句子该在哪结束,只能一路生成到 max_len 然后被硬截断,输出尾巴上会挂一串垃圾词。原文把这两点归纳成一句:”<SOS>/<EOS> 决定 Seq2Seq 是否能正确工作”。而 <PAD> 是纯工程技术符号,语义上是”无”,所以原文强调它”只用于对齐长度”、”在损失和准确率中必须忽略”。
截断填充的实现(MyDataset.pad_sequence),三步,顺序不能换:
def pad_sequence(self, index_seq, vocab, seq_len):
    index_seq = index_seq[:seq_len - 2]                        # 1. 先截到 seq_len-2,给首尾符号留位置
    index_seq = [vocab["<SOS>"]] + index_seq + [vocab["<EOS>"]] # 2. 加首尾标记
    index_seq += [vocab.get("<PAD>", 0)] * (seq_len - len(index_seq))  # 3. 右侧补 <PAD> 到 seq_len
    return torch.tensor(index_seq, dtype=torch.long)
注意第 1 步是 seq_len - 2 而不是 seq_len:先截断再加首尾,否则加完就超长了。这是新手最常见的 off-by-two。
带数字的小例子。为说明方便,用一张假想小词表 <PAD>:0 <SOS>:1 <EOS>:2 i:3 love:4 you:5 je:6 vous:7 aime:8 .:9,设 SRC_SEQ_LEN = TGT_SEQ_LEN = 12:
源句 "i love you"     → [1, 3, 4, 5, 2, 0, 0, 0, 0, 0, 0, 0]   ← 长度 12,<SOS>…<EOS> 后全 PAD
目标句 "je vous aime ." → [1, 6, 7, 8, 9, 2, 0, 0, 0, 0, 0, 0]
然后按移位规则切成训练用的输入与监督信号:
target        = [1, 6, 7, 8, 9, 2, 0, 0, 0, 0, 0, 0]      (B, 12)
tgt_input     = target[:, :-1] = [1, 6, 7, 8, 9, 2, 0, 0, 0, 0, 0]   (B, 11) ← 喂给解码器
tgt_output    = target[:, 1:]  = [6, 7, 8, 9, 2, 0, 0, 0, 0, 0, 0]   (B, 11) ← 用来算 loss
对齐着看这两行,就是”用第 i 个位置的信息预测第 i+1 个词”:输入 <SOS> 要预测出 je,输入 je 要预测出 vous……输入 <EOS>(索引 2)要预测出 <PAD>。等等,最后这一项需要解释:<EOS> 后面那一位的监督信号是 <PAD>,但它会被 ignore_index 排除掉,所以模型学到的实际是”输入 <EOS> 时输出什么都无所谓”?并不是。真正让模型学会”该停了”的是训练数据里每个句子末尾那个 <EOS> 本身:tgt_output 里赫然包含 <EOS>(上例位置 4),模型必须学会在 aime 之后(准确说是 . 之后)输出 <EOS>。这才是停止信号的来源,也解释了 4.7 里推理循环”命中 <EOS> 就停”为什么成立。
这里还有一处细节改动:tgt_output 里的 <PAD> 在算准确率时用 mask = y_true != pad_idx 排除,所以上例的有效 token 数是 5(je vous aime . <EOS>),不是 11。这个数字直接决定了 loss 的分母,见 4.5。
seq_len 怎么定。原文给了明确定义与纪律:先画 source/target 的句子长度分布直方图(plot_seq_len_dist,bins=10),”选择合适的句子最大长度 seq_len,只能用训练集”。但在正式代码里 SRC_SEQ_LEN = TGT_SEQ_LEN = 12 上面的注释写的是”这里先随便写一个”,也就是说这份案例的 12 是拍出来的,不是量出来的。考虑到最长只放 12 个 token,第 1 步又砍掉 2 个位置,超过 10 个词的句子会被硬截断并直接丢失信息(语句后半段消失,翻译必然出错)。位置编码表长度则按”seq_len 的 2~4 倍”设为 MAX_SRC_LEN = MAX_TGT_LEN = 32,理由原文写了两条:模型中一般不会直接定义数据参数、支持推理阶段的变长输入。
4.3 模型结构:三段拼装 + 一张原图
nn.Transformer 是个”黑盒 EncoderDecoder”,它只吃 (B, S, d_{model}) 的浮点张量。所以模型 = 把 token id 变成向量(输入部分)→ 交给 nn.Transformer 做交互(编码解码)→ 把向量变回词表打分(输出部分)。
# 输入部分
self.src_embedding    = nn.Embedding(len(src_vocab), d_model, padding_idx=self.src_pad_idx)
self.tgt_embedding    = nn.Embedding(len(tgt_vocab), d_model, padding_idx=self.tgt_pad_idx)
self.src_pos_encoding = LearnablePositionalEncoding(d_model=d_model, max_len=MAX_SRC_LEN)  # nn.Embedding(32, 512)
self.tgt_pos_encoding = LearnablePositionalEncoding(d_model=d_model, max_len=MAX_TGT_LEN)
# EncoderDecoder
self.transformer = nn.Transformer(d_model=512, nhead=8, num_encoder_layers=6, num_decoder_layers=6,
                                  dim_feedforward=2048, dropout=0.1,
                                  batch_first=True,   # 张量顺序 (B, S, d_model)
                                  norm_first=True)    # Pre-LN: LayerNorm → sublayer → dropout → add
# 输出部分
self.linear1 = nn.Linear(d_model, len(tgt_vocab))位置编码这里是可学习版本(nn.Embedding(max_len, d_model) 再与词向量相加),而不是 day05~07 的 sin/cos:
def forward(self, x):
    seq_len = x.shape[1]
    position_ids = torch.arange(0, seq_len, dtype=torch.long, device=x.device).unsqueeze(0)  # (1, S)
    pos_encoding = self.position_encoding(position_ids)                                       # (1, S, D)
    return x + pos_encoding                                                                   # 相加,不是拼接
padding_idx 的作用值得单独记:nn.Embedding(vocab_size, d_model, padding_idx=0) 会把第 0 行的向量固定为全 0 且不更新梯度。于是”PAD 位置不携带信息”这件事在词向量层面就已经物理实现了,后面 mask 只是把这件事在注意力层面再确认一遍。
参数量核算(nn.Embedding / nn.Linear / nn.Transformer 的参数公式,本案配置 d_{model}=512,\ n_{head}=8,\ L=6,\ d_{ff}=2048,\ |V_{src}|=2804,\ |V_{tgt}|=4346,\ max\_len=32):
| 模块 | 参数量 |
|---|---|
nn.Transformer(12 层合计 + 首尾两个 LayerNorm) |
44,140,544 |
src_embedding(2804 × 512) |
1,435,648 |
tgt_embedding(4346 × 512) |
2,225,152 |
src_pos_encoding(32 × 512) |
16,384 |
tgt_pos_encoding(32 × 512) |
16,384 |
linear1(512 → 4346,含 bias) |
2,229,498 |
| 合计 | 50,063,610(≈ 50.1 M) |
这个核算方式是先按公式算、再用课件作业里两个实测参数量做校验的:d_{model}=256 配置算出 17,363,968、d_{model}=128 配置算出 2,178,560,与原文输出逐个数字一致,因此上表可信。单头维度 d_{model}/n_{head} = 512/8 = 64。
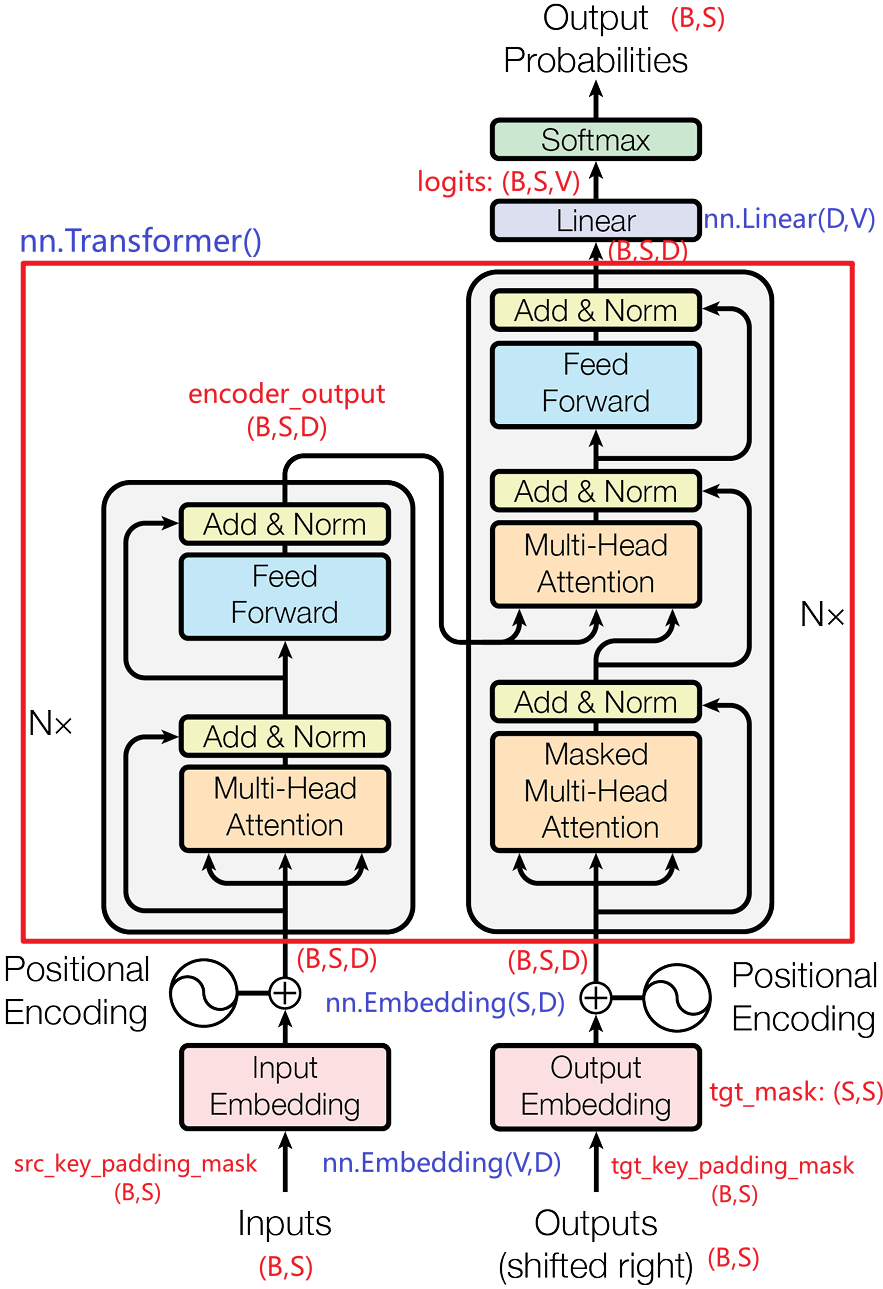
图注:这张图是经典 Encoder-Decoder 全景图的形状标注版,用红色标张量形状、蓝色标对应的 PyTorch 模块。自下而上看:左右两侧各有一个 Inputs (B,S) / Outputs (shifted right) (B,S) 入口(下面紧跟蓝色 nn.Embedding(V,D) 与红色 src_key_padding_mask (B,S) / tgt_key_padding_mask (B,S) 标注),进入粉色 Input Embedding / Output Embedding(蓝色 nn.Embedding(S,D) 标注在中间),再与圆圈符号 Positional Encoding 做 ⊕ 加法。左侧灰色大框是编码器:橙色 Multi-Head Attention → 绿色 Add & Norm → 蓝色 Feed Forward → Add & Norm,左标 Nx;其最终 Add & Norm 的输出有一条向右的箭头标注红色 encoder_output (B,S,D)。右侧灰色大框是解码器:橙色 Masked Multi-Head Attention(注意名字里带 Masked)→ Add & Norm → Multi-Head Attention → Add & Norm → Feed Forward → Add & Norm,同样标 Nx;中间那个 Multi-Head Attention 收两条输入箭头,一条来自下方解码器流、一条来自左侧 encoder_output,即交叉注意力。右侧标红色的 tgt_mask: (S,S) 指向解码器输入通路,因果 mask 只在解码器的掩码自注意力处生效。整个编码器+解码器被一个红色大框包住,框外左上角标 nn.Transformer()。框顶输出 (B,S,D) 进入紫色 Linear(右标 nn.Linear(D,V)),箭头旁红字 logits: (B,S,V),再往上绿色 Softmax → 顶部红字 (B,S) 与 Output Probabilities。图中每个 Add & Norm 都有一条绕过子层的残差线。
输入输出形状汇总(这是”能背出来”的版本):
| 名称 | 形状 | 说明 |
|---|---|---|
source |
(B, S_{src})= (64, 12) | 源序列 token id |
target |
(B, S_{tgt})= (64, 12) | 完整目标序列(含 <SOS>/<EOS>) |
tgt_input |
(B, S_{tgt}-1) = (64, 11) | target[:, :-1],解码器输入 |
logits |
(B, S_{tgt}-1, |V_{tgt}|) = (64, 11, 4346) | 每个位置在目标词表上的打分 |
tgt_output(监督) |
(B, S_{tgt}-1) = (64, 11) | target[:, 1:] |
4.4 三类 Mask:位置、形状、为什么
mask 不删 token,只在 softmax 之前把不该被关注的位置的分数压到 -\infty,让它们的注意力权重趋近 0。PyTorch 约定 True = 遮蔽(不许看)。这个案例有三个 mask,各自管一件不同的事:
| Mask | 形状 | 用在哪 | 它管什么 |
|---|---|---|---|
src_key_padding_mask |
(B, S_{src}) | ① 编码器自注意力的 key_padding_mask;② 解码器交叉注意力的 memory_key_padding_mask |
源句里的 <PAD> 不许被当作 key 关注 |
tgt_key_padding_mask |
(B, S_{tgt}-1) | 解码器掩码自注意力的 key_padding_mask |
目标句里的 <PAD> 不许被当作 key 关注 |
tgt_mask(因果 / causal) |
(S_{tgt}-1, S_{tgt}-1) | 解码器掩码自注意力的 attn_mask |
位置 i 只能看 \le i 的位置,不许看未来 |
注意两个关键设计:第一行用两次、第二三行叠在同一个模块上。src_key_padding_mask 之所以能复用,是因为交叉注意力的 K/V 正是编码器输出,同一批源位置在编码器里是 PAD,在编码器输出里依然是 PAD;至于解码器掩码自注意力为什么不收 src_key_padding_mask,因为它根本不接触源序列。
padding mask 的构造就是一次逐元素比较(极简,无需任何循环):
src_key_padding_mask = (source  == self.src_pad_idx)      # (B, S_src)  bool
tgt_key_padding_mask = (tgt_input == self.tgt_pad_idx)    # (B, S_tgt-1) bool
因果 mask 的构造是取上三角:
def _generate_causal_mask(self, seq_len):
    # 上三角(含对角线上方一条)为 True,对角线和下方为 False
    return torch.triu(torch.ones(seq_len, seq_len), diagonal=1).to(dtype=torch.bool, device=DEVICE)
以 T=5 为例,tgt_mask 的真实取值是:
        被看的key位置 →   0      1      2      3      4
查询位置 0                False  True   True   True   True    ← 位置0 只能看 0
查询位置 1                False  False  True   True   True    ← 位置1 能看 0,1
查询位置 2                False  False  False  True   True    ← 位置2 能看 0,1,2
查询位置 3                False  False  False  False  True
查询位置 4                False  False  False  False  False   ← 位置4 能看全部
diagonal=1 的含义是”从对角线上方第一条开始取”,所以对角线本身是 False(允许看自己),这是正确的自回归语义:预测位置 i 时,位置 i 的输入是”前 i 个词 + 第 i 个词在移位后的对应物”,不存在自我泄漏,因为移位已经错开了一位。
为什么解码器必须要有因果 mask,三条理由,逐条都能独立说通:
- 防止标签泄漏(label leakage / cheating)。训练时
tgt_input是整个右移序列一次性喂入的,第 i 个位置与第 i+1 个位置在同一个张量里。没有因果 mask,第 i 个位置的 query 可以直接关注到第 i+1 个位置(那正是它要预测的答案)。模型会迅速学会”抄右邻居”,训练 loss 一路降到极低,但这套本领在推理时毫无用处,推理时右边是空的。 - 训练与推理的信息可见性必须一致。推理时,生成第 t 个词只有前 t-1 个词可用。因果 mask 把训练时的可见范围强行约束成同一件事,模型学到的函数才在推理时可用。这是”训练-推理一致性”在设计上的第一道闸门。
- 移位(shifted right)与因果 mask 是一对配套件。只移位不加 mask ⇒ 泄漏;只加 mask 不移位 ⇒ 模型永远在预测自己刚读到的词。原文把这两件事分开写在两处(”输入
target[:,:-1]/ 输出target[:,1:]” 与 “tgt_mask表示每个位置能看到哪些位置”),实际必须成对理解,这也是为什么原图底部把输入标成Outputs (shifted right)并在旁边标上tgt_mask: (S,S)。
易混的三个”为什么”:为什么编码器不需要因果 mask(源句是双向可看的,翻译时要看完整个句子才能准确理解);为什么交叉注意力不需要因果 mask(它关注的是源句,源句的”未来”本来就该看);为什么 mask 用 True 而不是 -10^9(nn.Transformer 接受 bool,内部自动换算成加性 -\infty;手写注意力时才需要自己 masked_fill)。
4.5 训练流程与 loss 计算
分类任务一份输入对一个标签,翻译任务的”一份输入”是一批句子对,loss 要对齐到每个非 PAD token 上。所以翻译任务的 loss 是 token 级的加权平均,不是 batch 级的简单平均。
损失函数只有一行:
loss_fn = nn.CrossEntropyLoss(ignore_index=tgt_vocab.get("<PAD>", 0))ignore_index 让 <PAD> 位置的交叉熵既不进入分子也不进入分母,于是 loss 天然就是”本 batch 内所有非 PAD token 的平均损失”。注意不需要自己写 mask,CrossEntropyLoss 自带 ignore_index 就能做这件事。原文对此的表述是”<PAD> 不参与损失计算”、”loss 是非 PAD token 的平均损失”。
训练主循环(原文称”斌子法则”的落地版本,顺序一字不差):
for x, y in train_loader:
    x, y = x.to(DEVICE), y.to(DEVICE)
    y_logits = model(x, y)["logits"]              # 1. 前向:(B,11,V)
    y_true   = y[:, 1:]                            # 2. 监督信号 = target[:,1:]
    mask     = y_true != pad_idx                   # 3. 有效 token 掩码
    num_tokens = mask.sum().item()                 #    本 batch 有效 token 数
    loss = loss_fn(y_logits.reshape(-1, V), y_true.reshape(-1))   # 4. 算损失(压平成 2D)
    optimizer.zero_grad()                          # 5. 梯度清零
    loss.backward()                                # 6. 反向
    optimizer.step()                               # 7. 更新
    total_loss += loss.item() * num_tokens         # 8. 反算成"和",而不是累加平均值
    total_correct_tokens += ((y_logits.argmax(dim=-1) == y_true) & mask).sum().item()
    total_tokens += num_tokens
avg_loss = total_loss / total_tokens               # 9. 再除以全局有效 token 数
acc      = total_correct_tokens / total_tokens
这里有两个必须讲透的细节:
(1)为什么要 reshape(-1, ...)。CrossEntropyLoss 接受 (B, C) 或 (B, C, d_1, \dots) 的输入,配 (B) 或 (B, d_1, \dots) 的目标,它按”第 1 维是类别、其余维度是样本”来算。本例的 logits 是 (64, 11, 4346),若直接传,PyTorch 会把 4346 当类别维,形状对得上(类别在最后),实际上是对的。代码显式 reshape 成 (704, 4346) + (704,) 是把”每个 token 是一个独立样本”这件事写成显式语义,避免依赖对 API 内部维度约定的记忆。原文注释写得很直白:”ce 多分类交叉熵计算的损失是沿着 0 轴平均的损失,这里需要将样本数量变成 token 的数量”。
(2)为什么要 loss.item() * num_tokens。这是本案例最容易被忽略、又最容易让 loss 曲线失去可比性的一处。因为 ignore_index 生效,每个 batch 返回的 loss 已经是”该 batch 内非 PAD token 的均值”。若直接 total_loss += loss.item(),等于给每个 batch 等权重,但每个 batch 的有效 token 数并不相等(末尾 batch 不满 64 行、句子长短不一)。正确做法是先乘回该 batch 的有效 token 数还原成”总和”,全部累加后再除以全局有效 token 总数:
\mathcal{L} = -\frac{1}{\sum_{b,t}\mathbb{1}[y_{b,t}\ne \text{PAD}]}\sum_{b,t}\mathbb{1}[y_{b,t}\ne \text{PAD}]\ \log p_\theta\big(y_{b,t}\mid x_b,\, y_{b,<t}\big)
这段代码在数学上就是这个式子的严格实现。被追问时如果被问”翻译任务的 loss 怎么算”,答这三层就够:交叉熵 → ignore_index 排除 PAD → 按有效 token 数做全局加权平均。
准确率的定义同样是 token 级:
total_correct_tokens += ((y_logits.argmax(dim=-1) == y_true) & mask).sum().item()
acc = total_correct_tokens / total_tokens # 分母是有效 token 数,不是 batch 数 × 11两个易错点:& mask 是必须的,否则 PAD 位置会因为”模型也很擅长预测 PAD”而虚高准确率;分母用 total_tokens 而不是 总样本数 × 11,否则短句的权重会被系统性高估。原文对这类指标的定位很清醒:”token accuracy ≠ 翻译质量,真实翻译评估通常使用 BLEU”。
学习率与优化器:AdamW(lr=1e-4, weight_decay=1e-3),EPOCHS=25,BATCH_SIZE=64。注意这里没有 warmup、没有学习率调度(原论文用 warmup,作业 1 也正是让你补这一块);lr=1e-4 对 50 M 参数的小模型属于保守设置,这是它能平稳收敛的重要原因。训练速度很轻:133 个 batch(8474/64 向上取整)每轮约 7~8 秒。
写代码时掉过的四个坑(原文可见的痕迹):
- 顺序写错:前向必须在
zero_grad()之前,否则第一步的梯度被清掉;loss.backward()必须在zero_grad()之后、step()之前。原文注释里把顺序明确标成”5.梯度清零 → 6.反向传播 → 7.更新参数”。 - 不同位置的 pad 来源要一致:数据集里用
vocab.get("<PAD>", 0)、loss 里用tgt_vocab.get("<PAD>", 0)、mask 里用SPECIAL_TOKENS.index("<PAD>")。三处必须指向同一个 id(这里是 0),否则 mask 会遮错位置且不会报错。 - device 不一致:
_generate_causal_mask里显式.to(device=DEVICE),src_key_padding_mask/tgt_key_padding_mask也.to(DEVICE)。在 GPU 上这一步漏掉就是一条RuntimeError: Expected all tensors to be on the same device。 enable_nested_tensor警告:原文输出里反复出现
UserWarning: enable_nested_tensor is True, but self.use_nested_tensor is False because encoder_layer.norm_first was True。
PyTorch 的编码器有一条针对 padding 的 nested tensor 快速路径,但它要求 post-LN;本例用了norm_first=True(Pre-LN),所以这条优化被自动关掉。后果只是少了一点速度,不影响正确性,看到这条警告不用改代码,但要能解释它。
4.6 Teacher Forcing:训练提速,代价是训练-推理不一致
自回归生成的第 t 步需要第 t-1 步的输出。如果严格照这个来,训练就没法并行,必须等上一步算完。Teacher Forcing 的做法是:训练时不用模型自己的预测,直接喂真实的前缀。于是整个序列一次性喂进去,一次前向就得到所有位置的 logits,与监督信号逐位对齐。
原文的对照表:
| 场景 | 下一步输入 |
|---|---|
| 训练 | 真实目标词 |
| 验证 / 测试 / 预测 | 模型预测词 |
代码里它落在哪:训练走 model(x, y)(传了 target),评估/推理走 model(x, None)。forward 用 target is not None 分流:
def forward(self, source, target=None, is_inference=False):
    if target is not None:          # 训练模式:Teacher Forcing
        tgt_input = target[:, :-1]
        ...                          # 一次前向,输出 {"logits": (B,11,V)}
    else:                            # 推理模式:自回归
        for i in range(MAX_LEN):
... # 逐 token 生成为什么它是损失函数之外的另一半并行性:nn.Transformer 本身靠矩阵乘法并行,但若没有 Teacher Forcing,自回归的依赖链会把并行度压成 1(每个位置都要等前一个位置的输出)。原文在扩展节把这个因果关系讲得很清楚:”decoder 输入是右移的目标序列,因此可在一次前向中同时得到各位置预测”。所以”训练能并行”这个结论其实是三件事共同成立的:注意力是矩阵运算 + Teacher Forcing 让整句一次前向 + 因果掩码只限制信息流、不破坏并行(所有位置仍在同一次前向里算,只是互相看不到未来)。
代价:exposure bias(曝光偏差)。训练时模型永远在”干净前缀”上预测,第 t 步的输入是真实的第 t-1 个词;推理时输入是模型自己产出的词,一旦第 t-1 步错了,错误会被当成事实继续往后滚。这就是为什么本案例同一个模型在同一批测试集上:
| 评估方式 | token acc | loss |
|---|---|---|
| Teacher Forcing 测试 | 0.7431 | 1.4538 |
| 自回归测试 | 0.6097 | 3.2650 |
| 差距 | −13.34 pp | +124% |
原文把这个数据集称作”训练时老师带着走、考试时自己走”,并给出工程结论:自回归测试才是工程主流的真实评估(原文写”自回归测试(工程主流)”)。简历/汇报里如果只报 Teacher Forcing 的准确率,属于选择性汇报。
缓解手段(可以展开,原文的高频题也点了相关方向):
- Scheduled Sampling / 计划采样:训练早期多用真实前缀,后期逐步按概率替换成模型自己的预测,让模型慢慢适应”自己产出的前缀”。代价是实现复杂、训练不稳定。
- Label Smoothing(标签平滑):原文高频题第 4 题就问这个,作用是”降低模型过度自信,缓解过拟合,通常能提升泛化与翻译稳定性”。它不能消除 exposure bias,但能让模型在错一点前缀时更鲁棒。
nn.Transformer的交叉熵部分默认就带label_smoothing=0.1之类的设置(该案例用外置CrossEntropyLoss,需要自己加)。 - Beam Search:不改变训练,但在解码时同时保留多条候选,降低”一步错、步步错”的概率。见 4.7。
- 用验证/测试阶段也做自回归来获得诚实的指标,这一点本案例做到了。
4.7 推理:自回归生成、贪心解码与束搜索
是什么(原文的定义):”自回归推理(Next Token Prediction)是模型逐个预测下个 token,并用预测的 token 继续预测下一个 token。当前 token 依赖之前的 token。”
原文的五步流程表:
| 步骤 | 做什么 | 关键点 |
|---|---|---|
| 1 Encoder 编码 | 将源句子输入 Encoder,得到 memory | 提供整句上下文语义 |
| 2 初始化 Decoder | 以 <SOS> 作为目标端初始输入 |
生成从起始符开始 |
| 3 预测下一个 token | Decoder 根据 memory + 已生成序列输出概率分布 | 常用 argmax 选词 |
| 4 拼接并循环 | 将新 token 追加到序列末尾,继续下一步 | 逐步自回归生成 |
| 5 停止生成 | 命中 <EOS> 或达到 max_len |
满足任一条件即停止 |
代码实现(forward 的 target is None 分支):
MAX_LEN = MAX_TGT_LEN - 1 if is_inference else TGT_SEQ_LEN - 1
encoder_output = self.encode(source, src_key_padding_mask)
ys = torch.full((batch_size, 1), self.tgt_vocab.get("<SOS>", 1), dtype=torch.long, device=DEVICE)
all_logits = []
for i in range(MAX_LEN):                                 # 逐步生成
    tgt_mask = self._generate_causal_mask(ys.size(1))     # 每步都要重建因果 mask(尺寸在变)
    tgt_key_padding_mask = (ys == self.tgt_pad_idx)
    decoder_output = self.decode(ys, encoder_output, tgt_key_padding_mask, src_key_padding_mask, tgt_mask)
    logits = self.linear1(decoder_output[:, -1, :])       # 只取最后一个时间步
    all_logits.append(logits)
    this_word = logits.argmax(dim=-1)                     # ← 贪心解码
    ys = torch.cat([ys, this_word.unsqueeze(1)], dim=-1)  # 拼回去,构成下一步的输入
return {"logits": torch.stack(all_logits, dim=1), "ys": ys[:, 1:]}   # ys 去掉开头的 <SOS>
四个值得注意的工程点:
- 只取最后一个位置:
decoder_output[:, -1, :]。虽然每步都把整个前缀重算一遍,但只有最后一位有用。 - 没有 KV Cache:每一步都重算全部前缀的 K/V,总复杂度是 O(T^2 d),这是推理比训练慢、且
predict里MAX_LEN = MAX_TGT_LEN - 1 = 31时耗时明显的原因。生产实现会把已算过的 K/V 缓存起来复用,把每步成本降到 O(Td)。 is_inference的双重含义:True表示真正的预测(无真实目标,MAX_LEN = 31);False表示测试阶段的自回归评估(要求生成长度与真实目标一致 =TGT_SEQ_LEN - 1 = 11,这样才能逐位算 loss 和 acc)。- 停止条件在
predict里实现,不在forward里:y_tokens_list.index(eos_idx)找到第一个<EOS>就把后面全砍掉。也就是说forward的循环一定会跑满MAX_LEN步(有浪费),但输出是干净的。
推理结果的真实样例(这比任何讲解都有说服力):
text = "i love you"
print(predict(text, model, src_vocab, tgt_vocab, rev_tgt_vocab))
# 输出: je vous vous .对照一下:"i love you" 的合理法语是 "je t'aime .";模型给出的是 "je vous vous ."。这份输出的三点信息:① 句法骨架对了,主语 je + 宾语代词 + 动词 + 句号,语序符合法语;② 代词选错(vous 而非 t)且重复了一次;③ 这种”重复一个高频词”是自回归模型在不敢输出 <EOS> 时的典型退化,也是束搜索的主要用武之地。
贪心解码(Greedy Decoding):每步取 argmax,等价于 beam_size = 1。优点是一次前向一步、实现最简单、速度快;缺点是把整句的概率最优近似成”每一步局部最优”,一步选错无法回退。本案例的 predict 用的就是它。
束搜索(Beam Search):每步保留累计对数概率最高的 beam_size 条候选,最后取整句得分最高的一条。原文的作业 3 给了一个不依赖模型的最简实现骨架:
beam_size = 2
beams = [(0.0, [vocab["<SOS>"]])]            # (累计 log_prob, 序列)
for probs in step_probs:                      # probs: 该步词表上的概率分布
    log_probs = torch.log(probs + 1e-9)       # 取对数概率(加 eps 防 log(0))
    candidates = []
    for score, seq in beams:                  # 展开所有 (beam × V) 组合
        for token_id, lp in enumerate(log_probs):
            candidates.append((score + lp.item(), seq + [token_id]))
    candidates.sort(key=lambda x: x[0], reverse=True)
    beams = candidates[:beam_size]            # 按累计得分排序,保留 beam_size 个
代码里的关键设计:累加的是对数概率而不是概率(连乘会数值下溢,取对数后变成加法,而且天然等价于最大化整句概率)。原文这次演示的输出是:
贪心解码结果: ['je', 'aime']
Beam Search (beam_size=2) top结果:
  第1名: ['je', 'aime']  (score=-1.6094)
  第2名: ['tu', 'aime']  (score=-1.8971)
这是一个值得注意的细节:在这个模拟例子里,束搜索的第一名和贪心完全一样,因为构造的概率分布里 je 在第一步就是概率最高的词。束搜索的价值不在”永远改变结果”,而在于当局部最优与全局最优冲突时它能救回来;同时它保留的备选列表(tu aime、score 更低)也说明它付出了 beam_size 倍的算力只为换取这种可能性。作业 3 的 step_probs 是手写的假数据,要看出真实差异必须换成模型每步的实际输出概率。
三者的取舍(常考):
| 解码策略 | 原理 | 优点 | 缺点 | 适用 |
|---|---|---|---|---|
| 贪心 argmax | 每步取最大概率词 | 最快、最简单 | 局部最优,易重复/易漏掉更好的整句 | 演示、简单基线、对延迟敏感 |
| 束搜索 | 保留 top-k 条路径,比较整句累计 log 概率 | 通常优于贪心,指标更稳 | 算力 × beam_size;beam 大反而可能又长又平庸 | 翻译、摘要等追求质量的任务 |
| 采样(temperature / top-k / top-p) | 按概率分布随机采样 | 输出多样 | 不可控、易跑偏 | 创意写作、对话生成 |
4.8 BLEU:为什么 token accuracy 换成它
翻译没有唯一答案。"i am out of work ." 在这份数据里就有两个正确法语(je suis au chomage . 与 je suis sans travail .),token 级准确率会把”选对了另一个正确答案”也判成错。BLEU 换了一个问法:不看逐词位置对不对,看预测里的 n-gram 有多少真的出现在参考译文里。
公式(原文给出的版本,与标准 BLEU 一致):
\mathrm{BLEU} = BP \cdot \exp\left(\sum_{n=1}^{N} w_n \log p_n\right), \qquad BP = \begin{cases} 1, & c > r \\ \exp(1 – r/c), & c \le r \end{cases}
其中 p_n 是 n-gram 精确率(带截断:某个 n-gram 在预测里出现了 5 次、在参考里只出现 2 次,只算 2 次,防止靠重复刷分),w_n 常用等权 1/N,N 常取 4(即 BLEU-4);c 是候选长度、r 是参考长度,BP 惩罚过短译文(不惩罚过长,因为过长会被精确率自然压低)。注意 BP 用来做乘法、几何平均用来压制高阶 n-gram 的波动,这两个设计都是为了让 BLEU 不能靠”只输出高频词”或”只输出短句”刷高。
原文的手算例子(BLEU-2),值得完整走一遍:
- 参考句 Ref:
je suis etudiant预测句 Cand:je suis un etudiant - 1-gram:Cand 有 4 个词
je, suis, un, etudiant,其中 3 个(je, suis, etudiant)出现在 Ref 中 ⇒ p_1 = 3/4 = 0.75 - 2-gram:Cand 的 2-gram 有 3 个(
je suis、suis un、un etudiant),Ref 的 2-gram 有 2 个(je suis、suis etudiant),匹配 1 个 ⇒ p_2 = 1/3 \approx 0.333 - BP:c = 4、r = 3,c > r ⇒ BP = 1
- BLEU-2:1 \times \exp\left(\frac{1}{2}\log 0.75 + \frac{1}{2}\log 0.333\right) \approx 0.50,即约 50 分
这个例子精确地展示了 BLEU 的”严厉”:多了一个冠词 un,词义全对,分数只有 50。这也解释了 4.4 节为什么说”BLEU 低不一定完全错”。
代码实现(原文 compute_corpus_bleu,逐步对应公式):
for ref, cand in zip(references, candidates):
    for n in range(1, max_n + 1):
        cand_ngrams = Counter(tuple(cand[i:i+n]) for i in range(len(cand)-n+1))
        ref_ngrams  = Counter(tuple(ref[i:i+n])  for i in range(len(ref)-n+1))
        total_counts[n-1]   += sum(cand_ngrams.values())                        # 分母:候选 n-gram 总数
        clipped_counts[n-1] += sum(min(v, ref_ngrams[k]) for k, v in cand_ngrams.items())  # 分子:截断匹配数
precisions = [max(p, 1e-9) for p in precisions]         # 平滑,避免某阶为 0 时整句 BLEU 直接为 0
bp = 1.0 if cand_len > ref_len else math.exp(1 - ref_len / cand_len)
bleu = bp * math.exp(sum(math.log(p) for p in precisions) / max_n) * 100
min(v, ref_ngrams[k]) 这一行就是”截断”的实现,把候选里每个 n-gram 的计数削到不超过它在参考里的计数。max(p, 1e-9) 是平滑,因为只要有一阶精确率为 0,\log 0 = -\infty 会让整句 BLEU 直接归零,句长一短就出现”整阶为 0″(例如候选长度只有 3,4-gram 总数为 0)。
本案例的实测值:BLEU = 35.74(实测两次一致;第二次专门只跑 BLEU 也得到 35.74,说明结果可复现)。这个分数要带着三层”打折”来读:
- 单参考。实现里注释写明”简化版 corpus BLEU(单参考)”。而这份数据里大量源句有 2 个正确译文(原文展示的前 15 行里就有 3 处),选中了没进参考列表的那个正确译文会被算成全错,分数被系统性低估。生产上要传多参考(
sacrebleu支持多参考)。 - 没有独立 tokenizer。用的是清洗后的空格切分(
clean_text已经把标点拆成独立 token),这与 WMT 标准 13a tokenizer 的口径不同,得到的 BLEU 不能直接和论文数字对比。 - 测试集本身带”多答案噪声”。一个源句对应多个目标句,模型无法确定学哪一个,这会同时压低 token acc 和 BLEU 的上限(见 4.9)。
一个口径提醒:BLEU 是语料级指标(evaluate_bleu 把整个测试集 1060 条的候选与参考收集起来一次性算),而不是逐句 BLEU 再平均。逐句算再平均会因为短句噪声大、BP 惩罚不稳定而偏离语料级定义。原文的实现是正确的。
作业 2 的 BLEU-1 与”真正的 BLEU”差在哪:作业要求”输入预测序列和参考序列(均为 token 列表),计算 1-gram 精确率”。给出的实现是
ref = set(t for t in ref_tokens if t not in special)   # 参考去重成集合
match = sum(1 for t in pred if t in ref)               # 预测逐个查集合
return match / len(pred)
它只做 1-gram、不做截断、用集合而不是计数:若预测是 je je je .、参考是 je suis .,这个实现会给出 3/4,而真正的 BLEU-1 截断后只能算 1 次,应为 1/4 \times BP。原文作业提示也承认了这是简化版(”BLEU-1 = 预测句中出现在参考句里的词数 / 预测句总词数”)。被追问时如果被追问”BLEU 的截断是什么、为什么需要”,这就是最好的切入点。作业输出的 5 条结果(0.75 / 0.75 / 1.0 / 0.6667 / 0.6667)与这个简化定义一致,可以用来自查理解。
4.9 真实训练过程复盘:25 个 epoch 发生了什么
原文保留了逐 epoch 的完整输出,这是这份材料最珍贵的地方。以下是全部 25 轮(标 ★ 的是被保存的那一轮):
| Epoch | train_loss | train_acc | val_loss | val_acc |
|---|---|---|---|---|
| 1 | 3.7575 | 0.4911 | 2.8790 | 0.5777 ★ |
| 2 | 2.5835 | 0.6003 | 2.3784 | 0.6210 ★ |
| 3 | 2.1014 | 0.6470 | 2.0892 | 0.6473 ★ |
| 4 | 1.7530 | 0.6888 | 1.8580 | 0.6804 ★ |
| 5 | 1.4744 | 0.7262 | 1.7066 | 0.6990 ★ |
| 6 | 1.2455 | 0.7594 | 1.6070 | 0.7082 ★ |
| 7 | 1.0569 | 0.7889 | 1.5212 | 0.7247 ★ |
| 8 | 0.8977 | 0.8133 | 1.4579 | 0.7280 ★ |
| 9 | 0.7667 | 0.8347 | 1.4064 | 0.7362 ★ |
| 10 | 0.6541 | 0.8544 | 1.3642 | 0.7395 ★ |
| 11 | 0.5582 | 0.8703 | 1.3535 | 0.7445 ★ |
| 12 | 0.4846 | 0.8859 | 1.3193 | 0.7502 ★ |
| 13 | 0.4173 | 0.8974 | 1.3111 | 0.7497 ★ |
| 14 | 0.3650 | 0.9060 | 1.3138 | 0.7541 |
| 15 | 0.3213 | 0.9120 | 1.2972 | 0.7566 ★(全局最小 val_loss,模型被保存) |
| 16 | 0.2896 | 0.9157 | 1.3115 | 0.7544 |
| 17 | 0.2614 | 0.9180 | 1.3187 | 0.7543 |
| 18 | 0.2410 | 0.9212 | 1.3239 | 0.7516 |
| 19 | 0.2248 | 0.9223 | 1.3367 | 0.7531 |
| 20 | 0.2116 | 0.9241 | 1.3348 | 0.7563 |
| 21 | 0.2027 | 0.9253 | 1.3626 | 0.7539 |
| 22 | 0.1966 | 0.9250 | 1.3637 | 0.7561 |
| 23 | 0.1889 | 0.9259 | 1.3737 | 0.7527 |
| 24 | 0.1807 | 0.9279 | 1.3642 | 0.7547 |
| 25 | 0.1786 | 0.9257 | 1.3937 | 0.7606 |
读这张表能读出四件事:
- 训练是健康收敛的。train_loss 从 3.7575 单调降到 0.1786,train_acc 从 0.4911 升到 0.9257;第一轮就把 loss 打到 2.88,说明优化器配置没毛病。
- 第 15 轮之后是教科书级的过拟合。train_loss 继续降(0.32 → 0.18,降 44%),val_loss 反而从 1.2972 爬回 1.3937(升 7.4%),参数开始背答案了。
- train / val 的差距就是泛化 gap:第 25 轮 0.9257 vs 0.7606,差 16.5 个百分点。对 8474 条样本、50 M 参数、25 个 epoch 的配置来说很典型。
- 验证准确率比验证损失”晚熟”:最小 val_loss 在第 15 轮(acc 0.7566),最高 val_acc 却出现在第 25 轮(0.7606)。原因是交叉熵在算概率分布、准确率只看 argmax,后期模型把 top-1 对了但分布变尖,val_loss 因此变差、acc 却微升。这说明用哪个指标选模型会得到不同的模型。本案例用的是
min_val_loss:
if val_loss < min_val_loss:
    min_val_loss = val_loss
    best_acc = val_acc
    torch.save(model.state_dict(), MODEL_FILE)     # 只在变好时覆盖保存
最终测试结果(加载的正是第 15 轮那份权重):
| 项 | 值 |
|---|---|
| Teacher Forcing 测试 | acc 0.7431,loss 1.4538 |
| 自回归测试 | acc 0.6097,loss 3.2650 |
| 语料级 BLEU(自回归生成) | 35.74 |
predict("i love you") |
je vous vous . |
注意 Teacher Forcing 的测试 acc 0.7431 与验证集 acc 0.7566 很接近,这反过来验证了”按最小 val_loss 保存 + 正确加载”这条链路是通的。如果测试指标比验证指标高出一大截,通常意味着数据泄漏或词表用过全量数据。
4.10 训练不稳定 / 不收敛:原因清单与调试手段
这一节不照抄原文(原文没有专门的排查章节),而是把这份案例里真实出现过的现象逐条归因,方便被追问”你训练时遇到过什么问题”。
A. 先分清三种”坏”:loss 不降(一直卡在高位)、loss 震荡/发散(忽高忽低或 NaN)、loss 正常但指标差(loss 在降、翻译不能用)。三者的排查路径完全不同,别混着调。
B. 与本案例直接相关的 12 条原因:
| # | 原因 | 在本案例里的具体形态 | 现象 |
|---|---|---|---|
| 1 | 因果 mask 漏传 | forward 里不传 tgt_mask(nn.Transformer 默认会自己生成一个,但如果显式传了 None/形状错就会静默出错) |
train_loss 异常低、val_loss 高,推理输出乱,最隐蔽的坑,因为不报错 |
| 2 | padding mask 漏传或方向反了 | 忘记 .to(DEVICE)、或把 True/False 语义搞反(PyTorch 是 True = 遮蔽) |
loss 偏高且掉不动;PAD 位置开始主导注意力 |
| 3 | loss 没设 ignore_index |
用了默认 CrossEntropyLoss() |
因为 PAD 占大量位置,模型退化成”多输出 PAD”,loss 数值看起来还行但 acc 极低 |
| 4 | loss 平均口径不一致 | 直接 total_loss += loss.item() 而不乘 num_tokens |
loss 曲线不可比、随 batch 内 padding 比例漂移 |
| 5 | 无 <UNK>,OOV 全映射成 PAD |
vocab.get(token, 0) 的 fallback 指向 0 |
训练集 loss 正常,测试集遇新词就崩;测试指标远低于训练 |
| 6 | seq_len 定得太小 |
SRC_SEQ_LEN = 12 且截到 10 个词 |
长句信息被物理截断,loss 在一段平台后就降不下去;这是本案例 val_loss 卡在 1.3 左右的合理嫌疑之一 |
| 7 | 位置编码表长度不足 | 若 MAX_SRC_LEN < 实际 seq_len,nn.Embedding 索引越界 |
直接 IndexError(这个会报错,反而是好事) |
| 8 | 词表泄漏 | 先在全量数据建词表再划分数据集(本案例的做法) | 指标虚高,但换个数据集就掉下来 |
| 9 | 多参考答案的标签噪声 | 同一英文句对应 2 个法语(原文前 15 行就有 3 例) | 模型在多个目标之间摇摆,token acc 与 BLEU 的天然上限被压低;本案例 val_acc 长期贴在 0.76 很可能与它有关 |
| 10 | 学习率过大 / 没有 warmup | 本例是 lr=1e-4 + AdamW,没有 scheduler(作业 1 才让补) |
若把 lr 提到 1e-3 量级,前几个 epoch 容易震荡或 NaN |
| 11 | 保存策略选错 | 只存最后一个 epoch ⇒ 拿到第 25 轮的过拟合模型(val_loss 1.3937,比第 15 轮差 7.4%) | 测试指标莫名比验证指标差 |
| 12 | 设备不一致 | mask 在 CPU、张量在 GPU | RuntimeError: Expected all tensors to be on the same device(会报错,不难查) |
C. 调试手段(按成本从低到高):
- 单批过拟合测试(overfit a single batch):取 1~2 条样本,反复训几百步,看 loss 能不能贴到 0、acc 能不能到 100%。这是区分”代码 bug”和”模型/数据难度”的分水岭,如果连两条样本都过拟合不了,问题一定在 mask / loss / 移位这三条链路上,别去调学习率。
- 打印 mask 的形状与
True占比:print(src_key_padding_mask.shape, src_key_padding_mask.float().mean())。已经写了num_tokens = mask.sum().item()的地方顺手打印就能确认”有效 token 数”是否符合预期(例如(64, 11)里大概只有一半有效)。 - 两个指标对照跑:同一份权重,分别跑 Teacher Forcing 与自回归评估。若差距巨大(本案例 0.7431 vs 0.6097),说明模型依赖干净前缀,是 exposure bias 主导,而不是训练不收敛。这是最容易被误判为”模型没训好”的情况。
- 看 loss 与 acc 是否同步:val_loss 变差而 val_acc 变好(本案例第 16~25 轮),说明过拟合已经发生、模型在变”尖”,应及早停。
- 检查
<EOS>的生成行为:统计自回归输出里<EOS>出现的比例。如果大量句子跑满MAX_LEN还不输出<EOS>,说明停止信号没学好,本案例输出"je vous vous ."这种重复退化,通常伴随<EOS>学得不稳。 - 可视化长度分布再定
seq_len:plot_seq_len_dist(bins=10)本来就在代码里,只是被注释掉了。把注释打开、按 95 分位数定seq_len,比拍 12 靠谱得多。 - 梯度裁剪:
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)。本案例没用,但在 Transformer 上这是最廉价的防发散手段之一。
五、易错点与常见误解
| 常见说法 | 正确的说法 | 为什么 |
|---|---|---|
| 直接把整句 target 喂给解码器 | 必须先右移一位:tgt_input = target[:, :-1],监督信号是 target[:, 1:] |
不移位就是在”预测自己刚读到的词”;这是”next token prediction”的字面含义 |
| 加了因果 mask 就不算泄漏了 | 移位 + 因果 mask,两个都要 | 只移位不遮未来会泄漏;只遮未来不移位会退化成自编码任务 |
src_key_padding_mask 只在编码器用 |
它用两次:编码器自注意力的 key_padding_mask + 解码器交叉注意力的 memory_key_padding_mask |
交叉注意力的 K/V 就是编码器输出,同一批位置在那里依然是 PAD |
| 解码器掩码自注意力要把源掩码也传进去 | 不需要,它只收 tgt_key_padding_mask + tgt_mask |
解码器掩码自注意力根本不接触源序列 |
tgt_mask 形状是 (B, S, S) |
是 (S, S),与 batch 无关(padding mask 才带 B) | 因果结构对每条样本都一样;PyTorch 会自动广播到 (B\cdot H, S, S) |
| Mask 里的 1/0 | 用 bool,True = 遮蔽(不许看) |
PyTorch 约定;torch.triu(..., diagonal=1) 得到的正是”未来位置 = True” |
<PAD> 只是占位,模型自己会学会忽略它 |
必须显式排除:ignore_index + padding_idx + key_padding_mask,三处都要 |
padding_idx 管词向量为 0、key_padding_mask 管注意力看不见、ignore_index 管 loss 不算;少一处就有一处漏 |
| loss 默认就是 token 级平均 | CrossEntropyLoss 默认按 batch 内元素平均,不含 ignore_index 时会连 PAD 一起算;跨 batch 累积还必须乘 num_tokens |
见 4.5 的推导;这一步错会让 loss 曲线失去跨 batch 可比性 |
| token accuracy 高就说明翻译好 | token acc 只是调试信号,翻译质量看 BLEU | 翻译一句多解,逐 token 对齐会把”另一个正确答案”判成错;原文明确写了这一点 |
| 报 Teacher Forcing 的准确率就代表模型水平 | 应报自回归指标(工程主流);两者在本案例差 13.3 个百分点 | exposure bias,见 4.6 |
| 束搜索一定比贪心好 | 它是一个算力换质量的权衡,beam 过大还可能输出更长更平庸的句子;本案例作业的模拟里第一名与贪心完全相同 | 束搜索只在”局部最优 ≠ 全局最优”时才有增益;指标要实测 |
| BLEU 越低说明模型越差 | BLEU 低只说明”与这一份参考译文的局部词组重合度低”;单参考、非标 tokenizer 都会压低分数 | 本案例就是单参考、简化实现、无标准 tokenizer,35.74 不能与论文数字比 |
| BLEU-1 就是”预测里有多少词在参考里” | 真正的 BLEU-1 还要截断(min(候选计数, 参考计数))+ 长度惩罚 BP | 不然 je je je . 也能拿高分;作业 2 的实现是刻意简化的 |
| 验证损失越小,验证准确率就越高 | 两者可以背离:本案例第 25 轮 val_loss 最差区(1.3937)却有最高 val_acc(0.7606) | 交叉熵看分布、acc 看 argmax;模型变尖会让两者分道扬镳 |
| 代码里说 0.9/0.05/0.05,就按这个拆 | 实际跑的是 0.8/0.1/0.1(split_pairs 默认参数),输出也印证:8474 / 1059 / 1060 |
原文两处口径不一致;以实际输出为准,读课件时要以代码和输出为准而不是正文表格 |
| 词表和数据集随便哪个先做 | 应先划分数据集,再用训练集建词表(原文代码注释也这么说) | 本案例是先建词表再划分,属轻度泄漏;词表带 min_freq 过滤时泄漏会明显放大 |
predict 里 MAX_TGT_LEN - 1 和 TGT_SEQ_LEN - 1 可以混用 |
两者语义不同:前者是真正的自由生成(31 步),后者是为了与真实长度对齐以便算 loss(11 步) | 由 is_inference 分支切换;混用会导致测试时形状对不上 |
SPECIAL_TOKENS 里只有 <PAD>/<SOS>/<EOS> 是完备的 |
缺 <UNK>,OOV 会退化成 <PAD> |
见 4.1;这是本案例最值得主动指出的设计缺陷 |
那句 enable_nested_tensor 警告说明代码写错了 |
它只是 Pre-LN(norm_first=True)自动关闭了编码器的 nested tensor 快速路径,不影响正确性 |
该优化要求 post-LN;看到它不用改代码,但要能解释 |
六、横向对比与研究脉络
6.1 同一任务、不同架构:本案例 vs RNN 版(day09)
| 维度 | Transformer 版(本案例,day08) | RNN / LSTM Seq2Seq(day09 对照组) |
|---|---|---|
| 编码器 | N 层自注意力 + FFN,任意两位置直接交互 | 逐时间步递推,信息靠隐藏状态搬运 |
| 解码器 | 掩码自注意力 + 交叉注意力 + FFN,训练时整句并行 | 逐时间步解码,训练时也只能按时间步串行 |
| 依赖路径长度 | O(1) | O(n),长句衰减 |
| 位置信息 | 必须显式补(本案例用可学习 nn.Embedding) |
天然带顺序,无需位置编码 |
| 参数量(可比配置) | 本案例 ≈ 50.1 M(含词表相关) | 同规模下通常更省参数,但深度受梯度问题限制 |
| 训练并行度 | seq_len 维度可并行(Teacher Forcing + 因果 mask) | seq_len 维度不可并行 |
| 长句表现 | 更好(无长依赖衰减) | 句子越长越差 |
| 主代码复杂度 | 架构交给 nn.Transformer 一行;精力花在数据与 mask 上 |
需要手写循环结构,for t in range(seq_len) 贯穿全流程 |
| 主要难点 | 三类 mask 传对位置 | 隐藏状态传递、梯度消失 |
两者在本案例量级的数据(1 万句对)上都能训起来;Transformer 的收益在长句上体现得更明显,而本案例 seq_len = 12 恰好把这个优势压小了,这也是一个值得指出的”案例设计局限”。
6.2 训练与解码策略对比
| 策略 | 训练时下一步输入 | 推理时下一步输入 | 关键取舍 |
|---|---|---|---|
| Teacher Forcing(本案例训练) | 真实目标词 | — | 可并行、收敛快;带来 exposure bias |
| 自回归(本案例推理/测试) | — | 模型上一步输出 | 与推理一致、指标诚实;误差累积、慢(无 KV cache) |
| Scheduled Sampling | 按概率在真实/预测间切换 | 模型输出 | 缓解 exposure bias;实现复杂、训练不稳 |
| 贪心解码 | — | 每步 argmax | 最快;局部最优 |
| 束搜索(本案例作业 3) | — | 保留 top-k 条路径 | 质量更稳;算力 × beam_size |
| 采样 / top-k / top-p | — | 按分布采样 | 多样性好;不可控 |
6.3 评估指标对比
| 指标 | 算什么 | 主要缺点 | 本案例取值 |
|---|---|---|---|
| Token accuracy | 逐 token argmax 命中率(忽略 PAD) | 不是翻译质量;一句多解时把正确答案判错 | 0.7431(TF)/ 0.6097(AR) |
| 交叉熵 loss | 目标词上的负对数似然(忽略 PAD) | 不直观;会与 acc 背离 | 1.4538(TF)/ 3.2650(AR) |
| BLEU-4(语料级) | n-gram 截断精确率的几何均值 × BP | 单参考偏低、非标 tokenizer 不可比、不看语义 | 35.74 |
| 人工评估 | 人打分(流畅度/忠实度) | 贵、不可复现 | 原文建议”配合人工评估一起看” |
6.4 演进脉络(本材料所处的位置)
RNN/LSTM Seq2Seq(逐时间步串行)
   ↓ 引入注意力:解码器不再只依赖最后一个隐藏状态,而是能"回看"编码器各位置
注意力机制(day04)
   ↓ 注意力足够强,就可以把循环整个去掉
Transformer(day05~07,"Attention Is All You Need",2017)
   ↓ 同一个架构,只取 Encoder 做双向理解 → BERT 类(day11/12,预训练 + 微调)
   ↓ 只取 Decoder,做单向自回归生成 → GPT 类 → LLM(day11/12,DeepSeek API 零样本/少样本)
本案例(day08)的位置:**架构 → 完整任务的第一次落地**,把 day05~07 的部件全部用上,
同时是 day09(RNN 版同任务)的对照基准、day11(transformers 微调)的语法与数据准备基础。
一句话概括:它不含新知识,而是把已有知识第一次串成一条能跑通、能看指标、能复现的完整链路。被追问时”你完整做过一个 NLP 项目吗”这一类问题,最有说服力的回答就来自这份材料,因为它有 25 个 epoch 的真实曲线、一次失败的翻译样例、和一份自己手写的 BLEU。
七、在新闻分类项目中的落地
这份材料本身(英法翻译)与新闻分类项目(新闻标题 10 分类)任务不同,但工程骨架是同一套。逐条对应:
(1)用在哪一步,数据准备
| 本案例 | 新闻分类项目里的等价实现 |
|---|---|
clean_text:转小写、标点拆开、[^a-zA-Z.!?]+ 过滤 |
标题清洗:去 HTML 标签、去 URL、统一全半角;中文不需要”标点补空格”,但需要分词这一步(jieba 或 BERT tokenizer) |
构建 src_vocab / tgt_vocab 两张词表 |
TF-IDF 走 TfidfVectorizer(stop_words=停用词).fit_transform() 时自带词表;FastText 不需要词表;BERT 用 AutoTokenizer.from_pretrained(...) 的词表(≈3 万 subword) |
vocab.get(token, 0) 的 OOV 退化成 PAD |
BERT 的 [UNK] 是正确设计;FastText 靠 subword 天然缓解 OOV |
| 先建词表后划分数据集 | 必须反过来:先 train_test_split 再 fit 向量化器 / 用训练集语料训 tokenizer,否则 TF-IDF 的 idf 会用测试集信息 |
长度分布直方图定 seq_len |
分类的 max_length 按标题长度 95 分位定(常见 64 或 128),而不是默认 512 |
(2)用在哪一步,训练循环
新闻分类项目的”斌子法则”(加载配置 → 准备数据/模型/损失/优化器 → 外层轮次 + 内层批次 → 前向 → 算损失 → 梯度清零 → 反向 → 更新 → 保存模型/参数字典)与本案例的 train_one_epoch + train 是同一个骨架。可以直接复用的三条:
- loss 按有效 token 加权(
total_loss += loss.item() * num_tokens),只要做了 padding,这条纪律就必须延续;分类任务被 padding 影响的是 BERT 微调时的attention_mask。 - 按最小验证损失保存 checkpoint(
if val_loss < min_val_loss: torch.save(...)),本案例第 15 轮 vs 第 25 轮的差距(val_loss 1.2972 vs 1.3937)就是这个纪律值多少钱。 - 指标与 loss 可能背离(本案例第 25 轮),分类任务里表现为”val_loss 升、val_acc 平”,别只看一个指标。
(3)关键参数怎么调
| 参数 | 本案例取值 | 迁移到新闻分类项目的建议 |
|---|---|---|
d_model / nhead |
512 / 8(单头 64 维) | BERT-base 固定 768 / 12;自研小模型按 64 的单头维度取 d_model = 64 × nhead |
num_layers |
6 + 6 | BERT-base 是 12;小数据(18w)上 4~6 层往往够 |
d_ff |
2048(= 4 × d_model) | 保持 4 倍关系 |
batch_size |
64 | BERT 微调常用 16~32(显存约束);本案例 133 batch/epoch 在 GPU 上 7~8 秒,说明数据量不是瓶颈 |
lr |
1e-4(AdamW,无 warmup) | BERT 微调要压到 2e-5 ~ 5e-5;从零训小模型 1e-4 合理 |
weight_decay |
1e-3 | 同类量级 |
epochs |
25 | BERT 微调 3~5 轮就够;必须早停 |
max_length / seq_len |
12(拍出来的 ) | 先画长度分布再定,并意识到”截断 = 信息丢失” |
norm_first |
True(Pre-LN) |
自研深层 Transformer 优先 Pre-LN,训练更稳、更容易去掉 warmup |
| 解码策略 | 贪心(案例)/ 束搜索(作业) | 分类任务不需要解码;但 LLM 零样本分类要用(temperature=0 等价贪心) |
(4)实际坑在哪
- mask 传错不报错,只变差,这条在 BERT 微调里同样成立:忘了传
attention_mask,padding 会参与自注意力,短标题被长标题污染,指标掉几个点但不会报错。 - 多正确答案 + 标注噪声会压死指标上限,本案例的英法数据里一个源句对应多个目标句,模型在 0.76 的 val_acc 上就撞墙了。新闻分类项目的 10 类标题如果存在类别混淆(例如”体育”与”娱乐”边界),同样会撞墙,这时调模型不如看数据。
- 过度自信的模型 loss 会背离 acc,早停策略与评估指标要对齐。
<UNK>/OOV 的处理,决定”遇到没见过的词会不会直接失效”。
(5)与项目里其它方案怎么配合
| 项目里的方案 | 与这份材料的关系 |
|---|---|
| TF-IDF + 随机森林 | 完全不同的路线(稀疏特征 + 树模型)。本材料提供对照系:为什么深度模型能做”理解”而 TF-IDF 只能看词频;而且”先建词表后划分数据集”与 TF-IDF 用测试集语料算 idf 是同一类纪律问题 |
| FastText | 同样是”从零训词向量 + 简单网络”。本案例的”建词表 → 截断填充 → 训练”在 FastText 里被 train_supervised() 一行封装;理解本案例才知道它替你省掉了什么,省掉的正是 mask 与位置编码,所以它天然做不了长程依赖 |
BERT(transformers 微调) |
本案例是 BERT 的前置知识:BERT = 只保留本案例的 encoder,因此不需要 tgt_mask、不需要移位、不需要 Teacher Forcing;但 padding mask 一模一样(就是 tokenizer 返回的 attention_mask),ignore_index 的纪律也一模一样 |
| LLM(DeepSeek API 零样本/少样本分类) | LLM 就是只有 Decoder 的自回归模型。4.7 的自回归循环与贪心/束搜索取舍,正是理解”为什么生成慢””temperature 怎么影响输出””max_tokens 怎么设”的最小模型 |
| 模型压缩(量化/蒸馏/剪枝/低秩分解) | 蒸馏 loss 里的 hard_loss 与软标签都建立在”Teacher Forcing 式一次前向”上,本案例 4.5 的 loss 结构就是它的底座;剪枝去掉多少注意力头由 nhead/d_model 决定;低秩分解作用的对象正是上表里占 44.1 M 的 nn.Transformer |
话术落点:把这份材料讲成项目经历时,按”数据 → mask → loss → Teacher Forcing → 自回归评估 → BLEU”的顺序讲,每一环都能报真实数字(8474/1059/1060 的划分、0.7431 vs 0.6097 的差距、第 15 轮的最小 val_loss),最后主动说两个坑:OOV 没有 <UNK> 会退化成 PAD、先建词表后划分数据集属于轻度泄漏。这比背概念有力得多。
八、重点问答
Q1:机器翻译为什么不能用准确率(accuracy)当主要评价指标?BLEU 是什么?
A:翻译任务一个源句有多个正确答案,逐 token 准确率会把”另一个同样正确的译法”判成错,所以我只把它当调试信号。我会用 BLEU,它看的是预测译文和参考译文在 n-gram 上的重合度,而且带截断和长度惩罚。具体是:算 1~4-gram 的精确率,某个 n-gram 在预测里出现多次但参考里只有少数几次,就只算参考里那几次,防止靠重复刷分;然后把各阶精确率做几何平均,再乘一个长度惩罚 BP,候选比参考短的时候 BP 小于 1。我那个英法案例里,Teacher Forcing 的 token acc 是 0.7431,但自回归生成加语料级 BLEU 只有 35.74,这两个数字放在一起才能说明模型真实水平。
Q2:Teacher Forcing 是什么?它有什么问题?
A:Teacher Forcing 是训练时解码器的下一步输入不用模型自己的预测,而直接用真实目标词。好处是整条目标序列可以一次性喂进去并行前向,训练快、收敛快,这也是 Transformer 训练能并行的一半原因。问题是训练和推理不一致,推理时没有真实词,只能喂自己上一步的输出,一旦错一步,错误就会被当成事实往后累积,这叫 exposure bias。我实测过这个落差:同一个模型在同一批测试集上,Teacher Forcing 下 acc 0.7431、loss 1.4538,换成自回归生成就掉到 acc 0.6097、loss 3.2650,准确率掉了 13 个百分点。所以对外报指标必须报自回归的,工程上也是自回归测试为主流;缓解手段有 scheduled sampling、标签平滑和束搜索。
Q3:Transformer 做翻译时,padding mask 和 causal mask 分别加在哪里?为什么解码器必须有 causal mask?
A:我那个案例里有三个 mask。第一个 src_key_padding_mask 形状是 (B, 源句长),它用两次:一次作编码器自注意力的 key padding mask,一次作解码器交叉注意力的 memory key padding mask,因为交叉注意力的 K/V 就是编码器输出,同一批位置在那里还是 PAD。第二个 tgt_key_padding_mask 形状是 (B, 目标长-1),只用在解码器的掩码自注意力上。第三个 tgt_mask 是因果 mask,形状 (T, T),和 batch 无关,只用在解码器的掩码自注意力里。PyTorch 里 True 代表遮蔽。因果 mask 用 torch.triu(ones(T,T), diagonal=1) 取上三角,保证位置 i 只能看到 i 及之前。解码器必须有它的原因是训练时整个右移后的目标序列是一次性喂入的,不遮住未来,位置 i 的 query 就能直接看到位置 i+1 那个”答案”,模型会学会抄右邻居,训练 loss 很低但推理时右边是空的立刻崩。它同时也是”训练可并行”的前提,掩码只限制信息流,不破坏并行计算。
Q4:为什么 Transformer 训练能并行、推理不能?
A:一句话:训练能并行是因为自注意力和 Teacher Forcing 支持”整句一次前向”,推理不能并行是因为生成满足自回归依赖。拆开是三点。第一,注意力本身是 QK^T 加 mask 再 softmax 的矩阵运算,天然并行。第二,训练时解码器输入是右移的目标序列,输出一次就得到所有位置的 logits,和监督信号逐位对齐,所以不需要等上一步。第三,因果掩码只关闭信息可见性,所有位置仍在同一次前向里算完。而推理时没有真实目标词,第 t 步的输入等于第 t-1 步的输出,时间维度上存在真实依赖,只能逐步生成。工程上会用一个技巧缓解:缓存已经算过的 K/V,就是 KV cache,把每步成本从重算整个前缀降下来。
Q5:翻译任务的 loss 怎么算?padding 怎么不影响它?
A:三层。第一层是交叉熵,在目标词表上做多分类。第二层排除 padding,用 CrossEntropyLoss(ignore_index=pad_idx),让 PAD 位置既不进分子也不进分母,所以返回的 loss 已经是本 batch 内非 PAD token 的平均。第三层是跨 batch 累积的口径,因为每个 batch 的有效 token 数不一样,不能直接累加 batch 的均值,要先把每个 batch 的 loss 乘回它的有效 token 数还原成总和,全部累加完再除以全局有效 token 总数。我代码里就是 total_loss += loss.item() * num_tokens,最后 avg_loss = total_loss / total_tokens,准确率的分母也用 total_tokens。至于 padding 完全不干扰,其实要三处配合:embedding 的 padding_idx=0 让 PAD 词向量固定为全 0,key padding mask 让 PAD 不被当作 key 关注,ignore_index 让 PAD 不算 loss。少任何一处都有漏洞。
Q6:你训练这个模型时遇到过什么问题?怎么排查的?
A:最大的问题是学生成阶段指标突然变差。我一开始只报了 Teacher Forcing 的准确率,后来做自回归评估发现掉了 13 个百分点,一开始以为模型没训好,其实是 exposure bias,不是训练不收敛,判据就是:同一份权重下两种评估方式差距巨大,说明模型依赖干净前缀。第二个坑是过拟合:train_loss 从 3.76 一路降到 0.18,val_loss 在第 15 轮达到最小 1.2972 之后回升到 1.3937,而 train_acc 0.9257 对 val_acc 0.7606 差了 16 个百分点。我的做法是按最小验证损失保存模型,所以最终加载的是第 15 轮的权重,测试拿到的 0.7431 和验证的 0.7566 很接近,说明这条链路是对的。第三个坑是 OOV,我那份代码没有 <UNK>,词表外的词用 dict.get 的默认值落到了 PAD 的索引 0 上,等于把一个不认识的词当成空白。排查手法上我最依赖的是”单批过拟合”:拿一两条样本反复训,看 loss 能不能贴到 0,如果连这都做不到,问题一定在 mask、loss 或者移位这三条链路上,不用去调学习率。
Q7:贪心解码和束搜索的区别?你会怎么选?
A:贪心是每步取概率最大的词,等价于 beam_size 等于 1,最快也最简单,但它是局部最优,一步选错没法回退。束搜索每步保留累计对数概率最高的 top-k 条候选,最后取整句得分最高的一条,用 beam_size 倍的算力换更稳的整句质量。注意累加的是对数概率不是概率,因为连乘会数值下溢,取对数后变成加法,而且等价于最大化整句概率。选择的依据是任务和延迟:演示或延迟敏感就用贪心,翻译摘要这类追求质量的用 beam 3 到 5。不过束搜索不保证更好,我做的那个对比模拟里,beam_size=2 的第一名和贪心完全相同,因为贪心第一步选的就是概率最高的词;而且 beam 开太大会输出更长更平庸的句子。所以我不会盲信,会实测 BLEU 再定。
Q8:构建词表和截断填充时要注意什么?
A:词表方面,翻译任务要建两张,源语言和目标语言各一张,因为它们词汇不重叠;词表必须以特殊符号开头,我用的是 <PAD>=0、<SOS>=1、<EOS>=2,<PAD> 放在索引 0 是为了配合 embedding 的 padding_idx=0。这里有个我踩过的坑:特殊符号里还必须有一个 <UNK>,我那份代码没有,所有词表外的词都被 dict.get 的默认值映射成了 PAD,等于把不认识的词当成空白,测试集一遇新词就掉分。截断填充方面,顺序不能反:先把序列截到 seq_len 减 2,再在首尾加 <SOS> 和 <EOS>,最后在右侧补 <PAD> 到 seq_len,先加符号再截断就超长了。另外 seq_len 不能拍脑袋,要先画训练集上源句和目标句的长度分布直方图,按分位数来定,我那个案例的 12 是随手写的,超过 10 个词的句子会被硬截断,信息直接丢掉。最后还有一条纪律:必须是先划分训练验证测试集、再用训练集建词表,反过来做是数据泄漏。
九、延伸阅读
数据集
- Tatoeba 英法句对(本案例
eng-fra-v2.txt的来源格式):https://www.manythings.org/anki/fra-eng.zip。这是 Tatoeba 项目经 manythings.org 发布的制表符分隔双语对照文件,格式就是每行英文句子 \t 法文句子,与本案例展示的数据格式一致。本案例用的是去重后的 10593 对子集。 - Tatoeba 项目本体:
https://tatoeba.org/,多语言句子对的开放语料库,可按语言对、许可协议筛选下载。
评估工具
- sacreBLEU:
pip install sacrebleu,官方仓库https://github.com/mjpost/sacrebleu。生产级 BLEU 实现,自带 WMT 标准 tokenizer、支持多参考、会输出可复现的版本签名字符串。本案例 35.74 分不能与论文数字直接对比,用 sacrebleu 重算才是可比口径。 - NLTK 的 BLEU:
nltk.translate.bleu_score,提供sentence_bleu/corpus_bleu,适合快速实验与教学对照,把本案例手写的compute_corpus_bleu与它对比,可以验证平滑与 BP 的实现细节。 - huggingface/datasets 的 sacrebleu metric:在 HF 生态里直接调用 BLEU,返回
score / counts / totals / precisions / bp / sys_len / ref_len,适合流水线化评测。
官方文档(本案例直接依赖的 API)
torch.nn.Transformer:https://pytorch.org/docs/stable/generated/torch.nn.Transformer.html,src_key_padding_mask/tgt_key_padding_mask/memory_key_padding_mask/tgt_mask四个参数的确切形状与 mask 语义(含True= 遮蔽)以此为准。torch.nn.MultiheadAttention:https://pytorch.org/docs/stable/generated/torch.nn.MultiheadAttention.html,attn_mask与key_padding_mask的区别、bool 与 float mask 的换算规则。torch.nn.CrossEntropyLoss:https://pytorch.org/docs/stable/generated/torch.nn.CrossEntropyLoss.html,ignore_index与label_smoothing的行为定义。torch.nn.Embedding:https://pytorch.org/docs/stable/generated/torch.nn.Embedding.html,padding_idx的精确语义(该行固定为全 0、不参与梯度更新)。
论文与方法
- Attention Is All You Need(2017),Transformer 原始论文,本案例
nn.Transformer的架构出处;读懂它才能理解 4.3 那张图里每个部件的来由。 - BLEU 原始定义(Papineni 等),n-gram 截断精确率 + 长度惩罚 BP 的原始表述;本案例 8.2 的公式与之同构。
可迁移的工程参考
- PyTorch 官方 NLP 教程中的 seq2seq 翻译教程(GRU + 注意力版本),与本案例是同一任务的不同实现路线,可作 day09 的补充对照,也可用来对比”手写循环”与”
nn.Transformer封装”的工作量差异。 - HuggingFace
transformers:https://github.com/huggingface/transformers,day11 微调路线的工具;本案例的”词表 → 特殊符号 → 截断填充 → mask”四件事,在它的AutoTokenizer里被封装成一次调用(返回input_ids/attention_mask),对照着看能看出框架替你省掉了什么、又藏起了什么。