NLP 系列的收尾总结课,用一张总表钉死 Encoder-only / Decoder-only / Encoder-Decoder 三类架构的差别,再把 BERT 与 GPT 的预训练任务、微调方式、适用任务逐项对照。
一、这份材料解决什么问题
前面的课时是分头讲的:Transformer 结构、注意力机制、词向量、ELMo/BERT/GPT 各自的细节。到这一课,材料做的是「横向收口」:先给一张三类架构总表,再把 BERT 和 GPT 分别拆到”输入表示 → 预训练任务 → 下游任务头 → 微调参数”这一级。
为什么这件事在被追问时值钱:
- 评审者问架构对比时,考的不是”BERT 是双向、GPT 是单向”这种背结论,而是你能否把差别归因到 Attention Mask 这一行代码上,mask 的形状决定了模型能不能看未来,能不能看未来决定了它能做理解还是做生成。这是整份材料唯一的一条主线。
- 在新闻分类项目新闻分类流水线里,这一课正好卡在第三级(BERT 微调)和第四级(LLM 零样本分类)的交界处:第三级用 BERT 系的 Encoder-only 做 10 分类,第四级用 LLM(Decoding 架构)做零样本/少样本分类。同一份数据、同一个任务,两类架构都上场了,评审者很自然会追问”那你为什么两个都用?各自解决了什么?”
- 材料最后两节(ELMo/GPT/BERT 对比表、常见高频题)几乎就是原题清单,其中”为什么 BERT 不适合直接做自回归生成”是这份材料自己点出的高频题。
二、核心结论
- 三类架构的差别只有一个根:Attention 里允许谁看谁。Encoder 只有 padding mask,能看未来;Decoder 有 causal mask(上三角遮蔽),不能看未来;Encoder-Decoder 是前者给后者当条件。
- 双向 ≠ 两个单向拼起来。BERT 的”双向”是 Encoder 自注意力里没有 causal mask,每个 token 同时看左右两侧;ELMo 才是”左 LSTM + 右 LSTM 拼接”,两者不是同一回事。
- BERT = MLM + NSP,输出交给任务头;句子级任务取
[CLS]的最终隐藏状态(或pooler_output),token 级任务取每个 token 的隐藏状态。微调时只调任务头 + 整体小学习率微调。 - GPT = next token prediction,模型本身就是输出。GPT 基于 Transformer Decoder,但去掉了 Encoder-Decoder Attention,只留 Masked Multi-Head Attention + Feed Forward;做分类要自己加 pooling + 线性层,不是架构原生能力。
- 工程选型是四步走:先跑 baseline(中文 MacBERT / 通用 RoBERTa)→ 指标瓶颈换 DeBERTa → 抽取类任务换 SpanBERT → 资源受限再上蒸馏/量化/剪枝。
三、知识地图
3.1 原材料结构树
day12 BERT 与 GPT 架构
├── 1. NLP 主流架构对比……【掌握】              ← 全课总表(三类架构 × Mask × 用途 × 代表模型)
├── 2. BERT 模型介绍
│   ├── 2.1 学习目标
│   ├── 2.2 BERT 简介(2018 Google,双向预训练 + 微调范式,SQuAD/GLUE/MultiNLI)……【了解】
│   ├── 2.3 BERT 架构
│   │   ├── 三类 Embedding(Token / Segment / Position 相加)……【掌握】
│   │   ├── 多层 Transformer Encoder,无 causal mask 的"双向"……【掌握】
│   │   ├── 任务头设计:分类 / NER / QA……【掌握】
│   │   └── 句子级 vs token 级任务头对照表(6 行)……【掌握】
│   │   └── 工程调参建议(bs / lr / epoch / AdamW)……【掌握】
│   ├── 2.4 预训练任务:MLM(15%、80-10-10)+ NSP(50% 正负样本)……【理解】
│   ├── 2.5 小结 + 高频题速查表(6 组)……【理解】
├── 3. BERT 模型变体……【理解】
│   ├── RoBERTa / MacBERT / ALBERT / DeBERTa / ELECTRA
│   ├── SpanBERT / DistilBERT / ERNIE(百度)/ SciBERT·BioBERT
│   └── 校招项目落地顺序(baseline → 冲效果 → 专精 → 压缩)
├── 4. GPT 模型介绍
│   ├── 4.1 GPT 介绍(OpenAI,核心论文 2 篇,与 BERT 的单向/双向差别)……【了解】
│   ├── 4.2 GPT 架构(Decoder Block 去掉 Encoder-Decoder Attention)……【掌握】
│   ├── 4.3 训练过程:无监督预训练 + 有监督微调,目标函数 L1 / L2 / L3……【掌握】
│   ├── 4.3 GPT 下游任务微调类型表 + GPT-2 生成代码示例……【掌握】
│   └── 4.4 小结
├── 5. 扩展:BERT / GPT / ELMo 三者对比……【理解】
└── 6. 常见高频题(5 题)……【掌握】
3.2 权重标注说明
材料只在 BERT 与 GPT 两处写了「学习目标」(了解 / 掌握 / 理解),上表沿用材料的原标注;材料未标注的章节(第 1 节总表、第 3 节变体、第 6 节高频题),按”是否常被追问”给出的估读,已和材料自身的强调程度对齐(例如材料把总表放在全课第一节,且高频题里直接问架构差异,故标【掌握】)。
四、原理详解
4.1 三类架构 + 两种 Attention Mask(全课主线)
Transformer 的自注意力本质是”每个 token 给所有 token 打分,然后加权求和”。这么一个全连接式的打分矩阵,如果不加限制,第 5 个 token 就能直接读到第 8 个 token 的信息。Mask 就是往这个打分矩阵上加的限制条件,限制方式不同,就分出了三类架构。
两种 mask:
| 掩码 | 作用 | 加在哪 | 谁在用 |
|---|---|---|---|
| padding mask | 把 batch 里补齐的 <pad> 位置屏蔽掉,不让模型把填充位当成真实语义 |
Encoder 自注意力、Decoder 的交叉注意力和自注意力 | 所有架构都要用 |
| causal mask | 上三角置为 -\infty,让位置 i 只能看到 \le i 的位置(含自己) | Decoder 的自注意力 | GPT / T5·BART 的 Decoder |
关键区分:padding mask 是”工程必需”(不定长序列 batch 化),causal mask 是”建模选择”(决定能不能看未来)。BERT 的表格里写”仅 padding mask”,意思不是”没有 mask”,而是”没有因果遮蔽”,所以它能看未来,这就是”双向”。
为什么 causal mask 用 -\infty:自注意力是 \mathrm{softmax}(QK^T/\sqrt{d_k})V,把某个位置分数设成 -\infty,softmax 后它的权重严格为 0,等价于”看不见”。这也是为什么图里 Masked 矩阵上三角写的是 -inf 而不是 0,写 0 的话 softmax 后仍有正权重,等于没遮住。
三类架构一句话总结:
- Encoder-only(BERT):全可见,产出”带上下文的表示”,擅长判别式任务。
- Decoder-only(GPT):只能看左侧,产出”下一个词的概率分布”,擅长生成。
- Encoder-Decoder(T5 / BART):Encoder 全可见地编码输入,Decoder 带因果遮蔽地生成输出,用交叉注意力把两者接起来,适合”输入一段 → 输出另一段”的翻译/摘要。
4.2 BERT:三类 Embedding 与”双向”的真实含义
输入表示:三类 Embedding 逐元素相加(不是拼接)得到输入向量:
- Token Embedding:词/子词的向量,序列首位放
[CLS]; - Segment Embedding:句子对任务里区分 A 句 / B 句;
- Position Embedding:BERT 用的是可学习位置编码(和原始 Transformer 的固定正弦编码不同,这是材料明确点出的差别)。
模型真正接收的三个输入张量是 input_ids、attention_mask、token_type_ids(句对任务才用得上 token_type_ids)。
双向的含义:材料给的定义很干净,Transformer Encoder 的自注意力机制里没有因果掩码(causal mask),每个 token 可以同时看到左右两侧的 token。这句话在被追问时比”BERT 是双向的”值钱得多,因为它把结论还原成了机制。
任务头:模型本体不区分任务,靠头部切换。材料的对照表可以归纳成”看粒度、看标签数、看激活/损失”:
| 预测粒度 | 任务类型 | 用哪个特征表示 | 输出维度 | 激活 + 损失 |
|---|---|---|---|---|
| 句子级 | 单标签多分类(情感、意图、新闻主题) | [CLS] 最终隐藏状态 / pooler_output |
类别数 C | Softmax + CrossEntropy |
| 句子级 | 多标签多分类 | 同上 | 标签数 C | Sigmoid + BCEWithLogits |
| 句子级 | 单标签二分类(语义匹配、句对相似度) | 两句 [CLS] 表示(拼接/差值/点乘/余弦) |
1 | Sigmoid + BCEWithLogits(也可 2 logits + Softmax + CE) |
| token 级 | 单标签多分类(NER、词性标注) | 每个 token 的最终隐藏状态 | 标签数 C | Softmax + CrossEntropy |
| token 级 | 抽取式 QA / 阅读理解 | 每个 token 的最终隐藏状态 | 2(start / end) | Softmax + CE(start) + CE(end) |
| token 级 | 完形填空、MLM | 被 mask 的 token 隐藏状态 | 词表大小 V | Softmax + CrossEntropy(未 mask 位置 ignore_index=-100) |
两个输出的区别(高频追问):
last_hidden_state:形状(batch_size, seq_len, d_model),每个 token 一个向量,用于 token 级任务;pooler_output:把[CLS]的向量过一层线性 +tanh,用于句子级分类。注意它带了 tanh 非线性,跟直接取last_hidden_state[:, 0]不是同一个东西。
工程调参建议(材料原表,可直接背):Batch size 16/32;学习率 2e-5 ~ 5e-5;Epoch 3~4(可增到 5);优化器 AdamW,weight_decay=0.01。
[CLS] 与 [SEP] 的作用:[CLS] 标记句子开始,它的最终隐藏状态被当作整句表示用于分类;[SEP] 分隔句子/文本段落并标记结束。序列形式:
[CLS] token1 token2 ... tokenN [SEP]                    # 单句任务
[CLS] 句A tokens [SEP] 句B tokens [SEP]                 # 句对任务
4.3 BERT 的预训练任务:MLM 与 NSP
MLM(Masked Language Model),解决”想双向就不能用标准语言模型”的矛盾。标准语言模型是”看左边预测下一个词”,天生单向;BERT 想同时看左右,就不能让模型知道要预测哪个词,于是改成”挖空填词”:
- 随机选 15% 的 token 参与预测,其中:
- 80% 替换为
[MASK]:强制模型学习上下文填空; - 10% 换成随机词:防止模型”背位置”,强化依赖上下文;
- 10% 保留原词:减少分布偏移,让模型看到真实 token 形态。
这三档比例背后的逻辑是训练-推理不一致问题:下游任务里根本不存在 [MASK] 这个符号,如果 100% 都用 [MASK],模型学到的表示会和实际使用时的输入分布脱节,所以留 10% 原词兜底。
NSP(Next Sentence Prediction),建模句间关系。输入句子对 (A, B),预测 B 是不是 A 的真实下一句:50% 正样本(真实下一句)、50% 负样本(随机句子)。它服务的下游场景就是语义匹配、句对相似度、问答这种需要”两段文本关系”的任务。
小结(材料原文口径):BERT = 三类 Embedding + Transformer Encoder 堆叠 + 任务头;MLM 解决双向表征,NSP 建模句间关系;微调时只需调整任务头即可适配分类、匹配、QA、NER 等多任务。
4.4 BERT 变体:每个改动解决了什么问题
| 模型 | 核心架构与特点 | 关键优化 / 改进 | 适用场景 |
|---|---|---|---|
| RoBERTa | 与 BERT 架构一致 | 更大数据(16GB → 160GB)、更大 batch(256 → 8000)、更长训练、去 NSP、动态 Mask、Byte-BPE 编码 | 主流工业 baseline,效果全面优于 BERT |
| MacBERT | 中文优化版 BERT | MLM 改进:近义词替换 + 全词 + n-gram Mask;去 NSP → SOP | 中文分类 / NER / QA 强,通用中文 baseline |
| ALBERT | Transformer Encoder | 词嵌入因式分解(低维 Embedding + 线性投影)、层间参数共享、去 NSP → SOP(句子顺序预测)、去掉 Dropout、长句 + n-gram Masking | albert-tiny 仅 1.8M 参数,超轻量、推理快、精度略降,适合资源受限 |
| DeBERTa | 解耦注意力(content & position 分离) | Disentangled Attention、相对位置编码、Mask 解耦 | BERT 系最强性能,GLUE / SuperGLUE / SQuAD SOTA |
| ELECTRA | 判别式预训练 | Generator + Discriminator,预测 token 是否被替换 | 小模型性能接近大模型,效率最强 |
| SpanBERT | 强化 span 表示 | Span Masking、SBO(Span Boundary Objective)、去 NSP | 抽取式 QA、实体识别更强 |
| DistilBERT | BERT 蒸馏版 | 知识蒸馏、层数减半 | 40% 参数、60% 速度,精度保留约 97% |
| ERNIE(百度) | 中文知识增强 | 实体/词级 Mask、知识图谱注入 | 中文信息抽取、搜索、对话强 |
| SciBERT / BioBERT | 领域专用预训练 | 学术 / 生物医学语料继续预训练 | 科研、医疗 NLP 明显优于通用模型 |
看这张表的方法:横向对比时抓一条主线,”改 MLM 的挖空方式”(MacBERT、SpanBERT、ERNIE、ALBERT)vs “改训练配方”(RoBERTa)vs “改注意力/位置编码”(DeBERTa)vs “改目标函数”(ELECTRA)vs “改体积”(ALBERT、DistilBERT)。这样记,被追问”你还知道哪些 BERT 变体”时能成串输出,而不是背名字。
材料给的校招项目落地顺序:
| 步骤 | 说明 |
|---|---|
| Step1 先跑 baseline | 中文用 MacBERT,英文/通用用 RoBERTa |
| Step2 再冲效果 | 指标瓶颈时换 DeBERTa |
| Step3 按任务换专精模型 | 抽取类任务优先 SpanBERT |
| Step4 资源受限再压缩 | 蒸馏 / 量化 / 剪枝,先保线上时延与成本 |
4.5 GPT 的架构:从 Decoder Block 到 12 层堆叠
GPT 与 BERT 的定位差别(材料原文):GPT 是单向语言模型,只利用前文预测下一个词 → 擅长文本生成(NLG);BERT 是双向语言模型,同时利用上下文 → 擅长文本理解(NLU)。
GPT 基于 Transformer Decoder 架构,但去掉了 Encoder-Decoder Attention。每个 Decoder Block 只保留两块:
- Masked Multi-Head Attention
- Feed Forward 层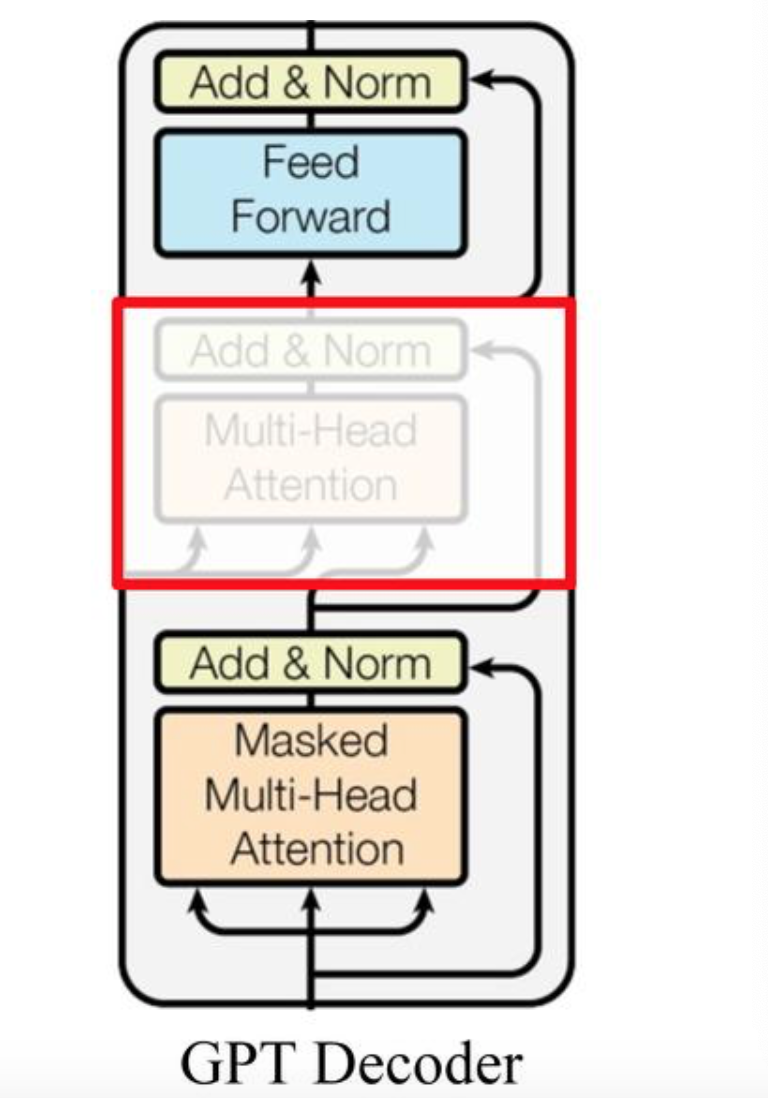
图注:这是 GPT Decoder 单层的结构图,自底向上串联。底部橙色块是 Masked Multi-Head Attention,往上经过 Add & Norm(浅绿色),再往上是被红框圈出的两块灰色半透明块 Multi-Head Attention + Add & Norm,这两块就是原版 Transformer Decoder Block 里接受 Encoder 输出的交叉注意力部分,被 GPT 删掉了,所以画成淡灰色(表示”不存在”)。再往上接 Feed Forward(蓝色)与顶部的 Add & Norm。图中每个子层都有绕行的残差连接箭头(Add 就是残差相加),注意力的三路输入箭头对应 Q、K、V。图底标注 GPT Decoder。这张图是”GPT 只保留 Masked Self-Attention + FFN”这句话的可视化证据。
Masked Multi-Head Attention 保证模型在预测下一个词时只能看到前文信息。材料给的例子非常直观:给定 4 个单词 [A, B, C, D],GPT 需要用 [A] 预测 B、用 [A, B] 预测 C、用 [A, B, C] 预测 D。所以当要预测 B 时,必须把 [B, C, D] 遮掩起来,注意 B 自己也被遮住,因为预测 B 时还没有 B。
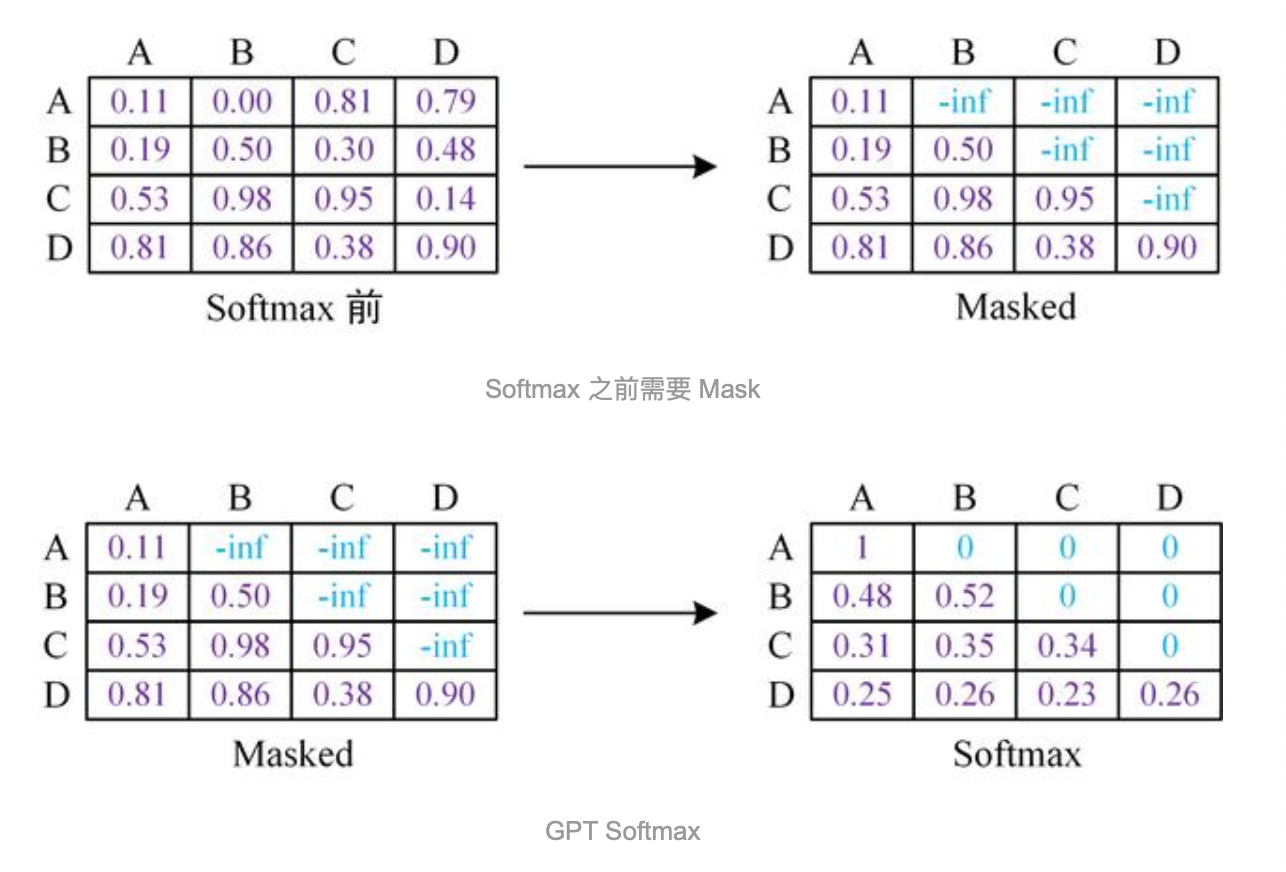
图注:图中四个 4\times4 矩阵,行列均为 A/B/C/D,展示同一个打分矩阵在 mask 前后的变化。左上「Softmax 前」是原始注意力分数(A 行:0.11、0.00、0.81、0.79;B 行:0.19、0.50、0.30、0.48;C 行:0.53、0.98、0.95、0.14;D 行:0.81、0.86、0.38、0.90)。箭头指向右上「Masked」:严格上三角被替换为 -inf,即 A 行只剩 0.11、B 行只剩 0.19 与 0.50、C 行只剩 0.53、0.98、0.95,对角线(自己看自己)与下三角(看左侧历史)全部保留。图中文字标注「Softmax 之前需要 Mask」点明了位置,mask 必须加在 softmax 之前。左下与右上内容相同(Masked),再经箭头到右下「Softmax」:上三角全部变成 0,每行和为 1,A 行成为 [1, 0, 0, 0](预测 B 时只能看到 A,权重全给 A),其余行按各自保留的分数归一化。图底标注「GPT Softmax」。
数字小例子(自己验算一遍最稳):拿 B 行来说,保留的分数是 0.19 和 0.50,\mathrm{softmax}([0.19, 0.50]) = [0.42, 0.58],图里写成 0.48 / 0.52,是示意性取整,结构和结论一致(两个位置归一化、其余为 0)。再看 D 行:\mathrm{softmax}([0.81,0.86,0.38,0.90]) \approx [0.26, 0.28, 0.17, 0.29],和图里的 0.25/0.26/0.23/0.26 同量级。要记住的是两件事:mask 加在 softmax 之前;被遮位置在 softmax 后严格为 0。
层数与整体结构:典型 GPT-Decoder 数量是 12 层(GPT-2 / base 规模),大模型可达到 24 层或更多。
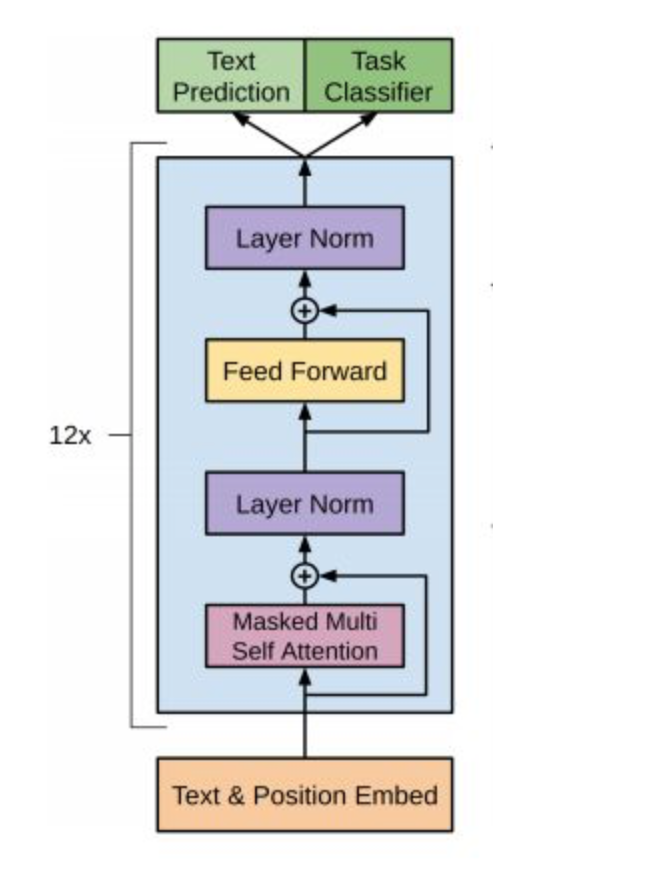
图注:自底向上看。最底部橙色块是 Text & Position Embed,只有文本嵌入与位置嵌入,没有 BERT 的 segment embedding(GPT 不需要句对输入)。往上是浅蓝色大框,左侧用括号标注 12x,表示这个块堆叠 12 次;块内自底向上依次为 Masked Multi Self Attention(粉红)→ 残差相加(⊕)→ Layer Norm(紫色)→ Feed Forward(黄色)→ 残差相加(⊕)→ Layer Norm。这种”子层 → 相加 → LayerNorm”的顺序是 post-norm 写法。块顶部分出两个绿色输出头:Text Prediction(语言模型头,预测下一个词)与 Task Classifier(下游任务头),这两个头正是 GPT “两阶段训练”的图形化:预训练用 Text Prediction,微调换 Task Classifier,底座共享。
4.6 GPT 的两阶段训练
GPT 的训练是典型的两阶段:第一阶段无监督预训练语言模型,第二阶段有监督下游任务微调。
阶段一:无监督预训练(next token prediction)
通过”由前文预测下一个词”学习语言规律,无需人工标注。输入是 tgt_input(前文文本序列),输出是 tgt_output(前文对应的下一个词组成的序列),本质就是用 tgt_input 预测对应的 tgt_output。
给定句子 U = [u_1, u_2, \dots, u_n],训练目标是最大化”由前文预测当前词”的概率:
L_1(U)=\sum_i \log P(u_i \mid u_{i-k},\cdots,u_{i-1};\Theta)
其中 k 是上下文窗口大小。输入表示为词嵌入与位置编码之和:
h_0 = U W_e + W_p
其中 W_e 是词嵌入矩阵,W_p 是位置编码矩阵。把 h_0 逐层传入 Decoder Block:
h_l = \mathrm{transformer\_block}(h_{l-1}),\quad l \in [1, L]
最后用顶层隐状态预测下一个词(注意这里用了词嵌入矩阵的转置做权重绑定,即输入嵌入和输出投影共享参数):
P(u)=\mathrm{softmax}(h_L W_e^{T})
阶段二:有监督下游任务微调
训练数据是输入序列 [x_1, \dots, x_n] 加标签 y,目标是据输入预测标签。在分类任务中,通常只取序列的最后一个隐藏状态 h_n 作为句子表示,再过一个输出线性层(通常是 softmax)预测标签:
P(y \mid x_1,\cdots,x_n)=\mathrm{softmax}(h_n W_y + b_y),\qquad
L_2=\sum_{(x,y)}\log P(y \mid x_1,\cdots,x_n)
这一步和 BERT 的对照点值得记牢:BERT 取的是句首 [CLS],GPT 取的是句尾的最后一个隐状态。原因是 GPT 单向,只有最后一个位置”看过”了整句话,句首位置只有它自己。这也解释了材料下面这张表里”GPT 做分类需要自定义下游网络”的原因。
两阶段目标合成最终的优化函数:
L_3 = L_2 + \lambda L_1
GPT 下游任务微调类型(材料原表):
| 任务类型 | GPT 输出使用方式 | 是否需要自定义下游网络 | 备注 / 建议 |
|---|---|---|---|
| 文本生成(NLG) | 直接使用 LM head logits | 否 | 可直接生成文本,少量微调可提升生成质量 |
| 文本分类 / 回归 | 使用 last_hidden_state 或自定义 pooling 后的向量 |
是 | 定义线性层或 MLP,把 GPT 输出当特征表示 |
| 其他任务(问答 / 信息抽取) | 同文本分类 | 是 | 可自定义 head,支持 token-level 或 span-level 输出 |
推理代码(材料原始示例,GPT-2 base 做 CPU 演示):
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model_name = r"./model/gpt2"          # GPT-2 base,适合 CPU 演示

tokenizer = AutoTokenizer.from_pretrained(model_name, local_files_only=True)
model = AutoModelForCausalLM.from_pretrained(model_name, local_files_only=True)

prompt = "what do you like?"
input_ids = tokenizer(prompt, return_tensors="pt").input_ids

model.to(device)
with torch.no_grad():
    output = model.generate(input_ids.to(device), max_length=100)

print(tokenizer.decode(output[0], skip_special_tokens=True))
材料同时保留了这次运行的输出,这段输出本身就是两个极好的教学素材:
- 警告 1:
The attention mask and the pad token id were not set... Please pass your input's attention_mask to obtain reliable results.,单条输入看不出问题,但 batch 推理时不传attention_mask,padding 位会被当成真实 token 参与注意力。 - 警告 2:
Setting pad_token_id to eos_token_id: 50256 for open-end generation.,GPT-2 的 tokenizer 默认没有 pad token,所以 transformers 退而用eos_token_id=50256充当 pad。这解释了为什么 GPT-2 微调分类任务时经常要手动tokenizer.pad_token = tokenizer.eos_token。 - 生成结果:
"what do you like? I'm not sure. I'm not sure if I like it or not. ..."反复重复同一句。这不是抽取稿写错了,而是未微调的小模型 + 纯贪心解码的典型退化现象,也侧面说明”zero-shot 能跑通”和”能用于生产”之间差着微调和解码策略(重复惩罚 / 采样温度)这一大截。
4.7 扩展:BERT / GPT / ELMo 三者对比
材料第 5 节把 ELMo 拉进来做三方对照,这张表的价值在于把”双向”这个词的历史讲清楚了:
| 模型 | 特征提取器 | 语言模型方向 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|---|
| ELMo | 双层双向 LSTM | 双向(左右单向 LSTM 拼接) | 上下文动态词向量,解决多义词问题 | LSTM 提特征能力弱,特征融合有限 | 目前很少使用 |
| GPT | Transformer Decoder | 单向(只看上文) | 特征提取能力强,自然语言生成能力好 | 单向限制,无法利用未来信息 | 文本生成、对话生成 |
| BERT | Transformer Encoder | 双向(同时看上下文) | 双向上下文理解能力强,多任务预训练(MLM + NSP) | 模型庞大,训练成本高,不适合生成任务 | 文本分类、问答、命名实体识别等理解任务 |
读法:ELMo 的”双向”是把两个方向独立的 LSTM 输出拼起来,每个方向的 LSTM 内部依然是单向的;BERT 的”双向”是在同一层注意力里同时看到左右。前者是”两个单向的拼贴”,后者是”真正的全局可见”,这就是 Transformer 替换 LSTM 的核心理由之一。
五、易错点与常见误解
常见说法:”BERT 没有 mask”
实际上,BERT 有 padding mask,只是没有 causal mask。
为什么:材料的表格写的就是”仅 padding mask”。不定长序列 batch 化必须靠 padding mask 屏蔽补齐位,否则 <pad> 会污染注意力;BERT 缺的是”遮蔽未来”的那一种。
有人以为”BERT 是双向的,所以它是两个单向模型拼起来的”
其实 BERT 的双向来自 Encoder 自注意力里没有因果掩码,每个 token 一层之内就能同时看左右;两个单向 LSTM 拼接是 ELMo 的做法。
原因在于,材料在 2.3 节特意给了”双向”的定义,这句话是的得分点,答成 ELMo 式解释会直接暴露没看懂架构。
常听到的一种说法是:”GPT 用的是标准 Transformer Decoder Block”
真实情况是,GPT 基于 Transformer Decoder,但去掉了 Encoder-Decoder Attention,只保留 Masked Multi-Head Attention + Feed Forward。
背后的道理是,交叉注意力的 K、V 来自 Encoder 输出,而 GPT 没有 Encoder。图里被红框圈出的灰色块就是这个被删掉的部分;删掉之后 Decoder 才能单独当语言模型用。
容易想岔的地方:”mask 加在 softmax 之后就行”
事实正相反,必须加在 softmax 之前,把位置分数设成 -\infty。
之所以如此,softmax 之后置 0 再重新归一化虽然数值上也能凑出类似效果,但标准实现(也是图里画的)是”先 -\infty 再 softmax”,这样被遮位置权重严格为 0 且不需要二次归一化。图里明确标了「Softmax 之前需要 Mask」。
先说一个误解:”BERT 也能做生成,只是效果差一点”
实际上,结构上就不成立,双向注意力在预测当前位置时会看到未来 token,破坏了自回归的因果性。
为什么:材料高频题第 5 题的答案原文就是”双向注意力会看到未来信息,破坏自回归因果性”。生成时每步要预测下一个 token,而 BERT 的表示里已经混进了”下一个 token”本身,等于偷看答案。
常见说法:”GPT 做分类直接用它原生输出就行”
其实需要自定义下游网络:取 last_hidden_state 或自己做 pooling,再接线性层/MLP。
原因在于,GPT 的原生输出是词表上的概率分布(LM head logits),它没有像 BERT [CLS] 那样为”整句表示”预留的位置。材料的下游任务表明确写了文本分类”是否需要自定义下游网络 = 是”。
有人以为”MLM 就是 15% 的词全换成 [MASK]”
真实情况是,15% 是被选中参与预测的比例,其中只有 80% 换成 [MASK],10% 换随机词,10% 保持原词。
背后的道理是,材料把三档比例的原因写得很清楚,80% 学填空、10% 随机词防背位置、10% 原词减少训练与推理的分布偏移。少答那 20% 是常见的扣分点。
常听到的一种说法是:”MLM 的 loss 对所有 token 都算”
事实正相反,只对被 mask 的 token 计算,未 mask 位置用 ignore_index=-100 忽略。
之所以如此,这是材料任务头表最后一行”N 标签多分类(完形填空、MLM)”的原话,也是实际写 CrossEntropyLoss(ignore_index=-100) 时的标准做法。
六、横向对比与研究脉络
6.1 三类架构总表(本次核心,三列并排)
| 维度 | Encoder-only | Decoder-only | Encoder-Decoder |
|---|---|---|---|
| 结构类型 | Transformer Encoder 堆叠 | Transformer Decoder 堆叠(去掉 Encoder-Decoder Attention) | Encoder + Decoder 完整结构 |
| Attention Mask | 仅 padding mask | causal mask(上三角)+ padding mask | Encoder:padding;Decoder:causal + padding |
| 是否可看未来 | 能 | 不能 | Encoder / Decoder (混合) |
| 预训练目标 | MLM + NSP(RoBERTa 等后续变体去 NSP) | next token prediction | 去噪/片段填充式的 seq2seq(材料未展开细节) |
| 输出怎么用 | 取 [CLS](句级)或逐 token 隐状态(token 级)+ 任务头 |
直接使用 LM head logits 生成;分类需自建 pooling + 线性层 | Decoder 逐 token 生成,交叉注意力接受 Encoder 输出 |
| 主要用途 | 文本分类、NER、语义匹配、搜索、抽取式 QA | 对话、写作、代码生成 | 翻译、摘要、生成式 QA |
| 代表模型 | BERT、RoBERTa、DeBERTa、ERNIE | GPT-4、LLaMA、Qwen | T5、BART、mT5 |
一表记法:看”是否可看未来”这一列就够了,能看未来的是理解型(Encoder-only),不能看未来的是生成型(Decoder-only),一半能一半不能的是转换型(Encoder-Decoder)。
6.2 BERT vs GPT 逐项对照
| 对比维度 | BERT | GPT |
|---|---|---|
| 架构来源 | Transformer Encoder | Transformer Decoder(去掉 Encoder-Decoder Attention) |
| 注意力方向 | 双向(无 causal mask) | 单向(causal mask) |
| 预训练任务 | MLM + NSP | next token prediction(因果语言建模) |
| 训练目标 | 恢复被遮蔽的词 / 预测句子关系 | 最大化 L_1(U)=\sum_i \log P(u_i \mid u_{i-k},\cdots,u_{i-1};\Theta) |
| 句子表示取哪 | 句首 [CLS](或 pooler_output) |
句尾最后一个隐状态 h_n(或自定义 pooling) |
| 输出层权重 | 与输入嵌入无关(MLM 头独立) | 与词嵌入矩阵转置共享:P(u)=\mathrm{softmax}(h_L W_e^T) |
| 擅长 | 文本理解(NLU) | 文本生成(NLG) |
| 下游适配方式 | 换任务头即可(分类 / NER / QA / 句对) | 生成任务直接用;判别任务需自建网络 |
| 双向位置编码 | 可学习位置编码 + segment embedding | 位置嵌入 + 文本嵌入,无 segment embedding |
| 典型落地 | 分类、NER、语义匹配、搜索排序 | 对话、写作、代码生成 |
6.3 演进脉络(谁解决了谁的什么问题)
- ELMo(LSTM 时代):解决静态词向量无法区分多义词的问题,但它用”左右两个单向 LSTM 拼接”实现双向,特征提取能力受限于 LSTM。
- Transformer(基础架构):用自注意力替换循环结构,成为通用预训练底座;Encoder 与 Decoder 用不同的 mask 承担不同职能。
- GPT(Decoder 路线):保留因果遮蔽的 Decoder 单干,用 next token prediction 预训练,把”生成”做成架构的原生能力,接口自然进化成 prompt。
- BERT(Encoder 路线):去掉因果遮蔽换来真正的双向表示;为了在双向条件下还能训练,发明 MLM(挖空填词)绕开”不能看未来就不能预测下一个词”的矛盾;再用 NSP 补句间关系。配套的”预训练 + 微调”范式让同一个底座适配多任务。
- BERT 变体群:RoBERTa 证明”去 NSP + 更大数据/batch + 动态 Mask”就够了(等于反过来质疑 NSP 的价值);ALBERT / DistilBERT 解决参数与推理成本;SpanBERT / ELECTRA 分别针对抽取式任务和预训练效率;DeBERTa 用解耦注意力 + 相对位置编码把 Encoder 路线的效果推到顶;MacBERT / ERNIE 针对中文做知识增强。
- Decoder-only 的回归:GPT 系列沿着”更大 + 更单向 + prompt 化”继续走,LLaMA / Qwen 等同路线模型把生成式路线做成主流;而 Encoder-only 依然稳稳占住判别式任务(分类 / NER / 匹配)的性价比位置,两条路线不是替代关系,而是分工关系(材料把 ELMo/GPT/BERT 三种设计放在同一张表里对照,正是这个意思)。
只写有把握的部分:材料没有给出 GPT 各代的具体年份、参数量和榜单分数,本报告也不做补充,避免出现细节错误。
七、在新闻分类项目中的落地
项目里这个知识点出现在哪一步:新闻分类项目的四模型对比路线是「TF-IDF + 随机森林 → FastText → BERT(transformers 微调)→ LLM(DeepSeek API 零样本/少样本分类)」。第三级和第四级正好各站一类架构:BERT 是 Encoder-only + MLM 预训练 + 任务头微调;DeepSeek 是 Decoder-only 的生成式模型,靠 prompt 里塞类别说明做分类。所以这份材料是同时给第三级和第四级做原理背书的收尾课。
第三级(BERT 微调做 10 分类)具体怎么用:
- 数据与格式:训练 18w / 验证 1w / 测试 1w,
标题\t标签。用AutoTokenizer编码成input_ids+attention_mask;单句分类任务不需要token_type_ids。 - 取哪个表示:句子级单标签多分类,按材料表格取
[CLS]最终隐藏状态或pooler_output,接Linear(hidden_size, 10),Softmax + CrossEntropyLoss。如果后续要改成”多标签主题打标”(一篇文章挂多个标签),把激活换成Sigmoid、损失换成BCEWithLogitsLoss即可,材料表格给了这组对应关系。 - 关键参数(直接用材料建议):batch size 16/32;learning rate 2e-5 ~ 5e-5;epoch 3~4(不够再加到 5);
AdamW,weight_decay=0.01。这里最容易踩的坑是学习率照搬 TF-IDF 那级调参的直觉,从零训练常用的 1e-3 量级会把预训练权重直接冲坏。 - 模型选择(按材料落地顺序):Step1 中文 baseline 直接用 MacBERT(比原版 BERT 强,且是材料点名的中文通用基线);Step2 指标卡住再换 DeBERTa 冲效果;Step3 抽标题里的实体/机构这类抽取任务时换 SpanBERT;Step4 上线前做压缩。
- 与压缩环节的衔接:材料列的 DistilBERT = 层数减半 + 知识蒸馏,效果是”40% 参数、60% 速度、精度约 97%”。项目里的模型压缩可以在两条路上走,一是换成蒸馏好的小模型(DistilBERT /
albert-tiny1.8M),二是对自己的 BERT 做动态量化(torch.quantization.quantize_dynamic())、非结构化剪枝(torch.nn.utils.prune.global_unstructured())。顺序上先保指标再压体积,与材料”Step4 资源受限再压缩”一致。
第四级(LLM 零样本/少样本分类)为什么要用 Decoder-only:不用训练、不用标注,把 10 个类别名和判定规则写进 prompt,直接让模型输出类别,这就是 causal LM 的原生能力(生成)。代价是每次调用都要走完整个 prompt 的前向,推理成本和稳定性都不如微调好的小模型,所以项目上的讲法是”LLM 做兜底/冷启动/难例补刀,BERT 做主力高吞吐”。
与前三级的配合关系(可以直接这么讲):
| 级别 | 方案 | 架构 | 在项目里承担的角色 |
|---|---|---|---|
| 1 | TF-IDF + 随机森林 | 无神经网络 | 建立可解释的强基线,验证标签质量 |
| 2 | FastText | 浅层词袋 | 证明”简单模型能做到多少”,作为工程下限 |
| 3 | BERT 微调 | Encoder-only | 主力分类器,要精度和吞吐 |
| 4 | LLM 零样本/少样本 | Decoder-only | 无标注冷启动、新类别快速上线、难例诊断 |
| 5 | 模型压缩 | — | 把第 3 级压到可上线的时延与体积 |
实际坑(来自本课材料能推出来的两个):
- GPT-2 系 tokenizer 没有 pad token:材料跑 GPT-2 生成时的原话警告
Setting pad_token_id to eos_token_id:50256。换成 Decoder-only 模型做 batch 分类时,必须显式设置pad_token_id并传attention_mask,否则 padding 位参与注意力,结果会漂。 - 选错架构会白干:拿 BERT 去做”自动生成新闻摘要”、拿 GPT 去做”高吞吐 NER”都会打得很别扭,前者是因果性被破坏,后者是每个 token 都要自建 head 且没有
[CLS]这种句级表示可用。
八、重点问答
Q1:BERT 与 GPT 的核心架构差异是什么?
A:一句话是”掩码不同,导致能力不同”。BERT 用 Transformer Encoder,自注意力里没有因果掩码,每个 token 同时看左右两侧,是双向的,擅长理解类任务;GPT 用 Transformer Decoder,自注意力带 causal mask(上三角遮蔽),只能看前文,是单向的,擅长生成类任务。所以 BERT 的接口是”喂一段文本拿一个表示”,GPT 的接口是”喂一段前文拿下一个词的概率分布”。这个差别不是设计偏好,而是由 mask 决定的:能不能看未来,决定了它是理解型还是生成型。
Q2:为什么 BERT 做不了生成(不能直接做自回归生成)?
A:因为双向注意力会把未来信息带进来,破坏自回归的因果性。生成任务每一步要预测下一个 token,而 BERT 的表示里每个位置都已经看过左右两侧,等于预测当前位置时已经把”下一个 token”看进去了,属于偷看答案。它还缺两样东西:一个是自回归的解码接口,一个是像 GPT 那样把词嵌入矩阵转置当输出层、直接输出下一个词分布的训练目标。BERT 的 MLM 是”挖空填词”,只在被 mask 的位置上算 loss,天然不是用来逐词往外吐文本的。所以工程上也没人拿 BERT 做生成,需要生成就换 Decoder 路线。
Q3:那为什么 GPT 不适合做分类或者 NER?
A:不是绝对不能做,而是”不是它的原生强项,成本更高”。第一,架构上它是单向的,分类时只有最后一个位置的隐状态看过整句,早期位置信息不全,所以材料里说 GPT 做句子表示要取 h_n 或自己做 pooling,而 BERT 有 [CLS] 这个专门为句级表示准备的位置。第二,它的原生输出是词表上的概率分布(LM head logits),做分类必须自定义下游网络,加线性层或 MLP;NER 这种 token 级任务还得自己搭 token-level 或 span-level 的 head。第三,Masked 双向带来的表示质量对判别式任务更划算:同样的参数量下,BERT 在分类、NER、语义匹配上通常更省算力也更好调。所以工程上的选择是理解任务交给 Encoder-only,生成任务交给 Decoder-only。
Q4:新闻分类项目里为什么选 BERT 而不是 GPT 做分类?
A:因为这是典型的判别式任务,Encoder-only 是更划算的选择。我的任务是把新闻标题分到 10 个类别,输入和标签都固定,不需要生成任何文本,这正好是 BERT 的双向 Encoder 加任务头的主场:取 [CLS] 或 pooler_output,接一层线性到 10 类,Softmax + CrossEntropy 就能训。参数量、推理时延、微调成本都可控,配 batch 16/32、学习率 2e-5~5e-5、AdamW 就够。GPT 我不是不用,而是放在第四级做 LLM 零样本分类:它不需要标注、能靠 prompt 快速上新类别,但每次推理都要过完整个 prompt,成本和稳定性都不如微调好的小模型,所以定位是兜底和补充,主力还是 BERT。
Q5:BERT 的输入是什么?[CLS] 和 [SEP] 各有什么用?
A:输入形式是 [CLS] token1 token2 ... tokenN [SEP],句对任务再拼一个 [SEP] 和 B 句。模型实际吃三个张量:input_ids、attention_mask、token_type_ids(只有句对任务才需要)。[CLS] 标记句子开始,它的最终隐藏状态被当作整句表示,句子级分类就取它;[SEP] 用来分隔句子或文本段、标记结束。另外输入表示是三份 embedding 相加的:token embedding、segment embedding(区分 A/B 句)、position embedding,位置编码在 BERT 里是可学习的。
Q6:BERT 的预训练任务有哪些?为什么要这么设计?
A:两个,MLM 和 NSP。MLM 是为了在双向条件下还能训练,标准语言模型”看左边预测下一个词”天生单向,BERT 想同时看左右,就只能改成挖空填词:随机选 15% 的 token,其中 80% 换成 [MASK]、10% 换随机词、10% 保持原词。三档比例都是有用意的:[MASK] 学上下文填空,随机词防止模型背位置,保原词是为了减少训练和推理之间的分布偏移,毕竟下游根本见不到 [MASK]。NSP 是输入句子对预测 B 是不是 A 的下一句,50% 正样本 50% 负样本,用来建模句间关系。不过后续研究里 RoBERTa 直接去掉了 NSP,说明 MLM 才是主要贡献。
Q7:GPT 的训练目标是什么?它是怎么适配下游任务的?
A:目标就是因果语言建模,next token prediction,最大化”由前文预测当前词”的概率,形式是 L_1(U)=\sum_i \log P(u_i \mid u_{i-k},\cdots,u_{i-1};\Theta)。训练分两阶段:第一阶段无监督预训练,输入 tgt_input 输出 tgt_output,不用标注;第二阶段有监督微调,对输入序列预测标签 y,分类时取最后一个隐藏状态 h_n,过 softmax 得到 P(y\mid x_1,\dots,x_n),最终目标函数是 L_3 = L_2 + \lambda L_1。适配下游时按任务分三类:生成任务直接用 LM head logits,不用自建网络;分类/回归要取 last_hidden_state 或做 pooling 再加线性层/MLP;问答和信息抽取也属于要自定义 head 的那一类。
Q8:深度学习里的 mask 到底有几种?会不会搞混?
A:工程上常打交道的就两种,但作用完全不同。一种是 padding mask,处理不定长序列 batch 化补的 <pad>,所有架构都必须有,属于工程必需品;另一种是 causal mask,把注意力矩阵上三角设成 -\infty,只允许看当前位置及左侧,这是建模选择。关键细节是 mask 必须加在 softmax 之前,加完之后 softmax 里被遮位置权重严格为 0(图里从 -inf 变成 0 就是这个过程)。两类掩码组合起来的分布就是三类架构:Encoder 只有 padding,所以能看未来;Decoder 是 causal + padding,不能看未来;Encoder-Decoder 里 Encoder 和 Decoder 各取一种,所以算混合。
Q9:微调 BERT 的常用参数是什么?为什么要这样设?
A:Batch size 16 或 32,学习率 2e-5 到 5e-5,epoch 3 到 4、不够可以加到 5,优化器 AdamW,weight_decay 一般 0.01。学习率之所以这么小,是因为预训练权重已经是很好的初始点了,学习率一大会把预训练学到的知识冲掉,这是从零训练和微调最容易被搞混的地方。batch 不用太大的原因是 512 长度的序列显存占用高,而且小 batch 往往泛化更好。epoch 少是因为数据量不算大,跑多了容易过拟合,配合早停更稳。
九、延伸阅读
论文(材料中列出的)
- BERT:《BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding》— https://arxiv.org/pdf/1810.04805.pdf
- GPT:《Improving Language Understanding by Generative Pre-Training》(材料 4.1 节列出)
- GPT-2:《Language Models are Unsupervised Multitask Learners》(材料 4.1 节列出)
论文(与第 3 节变体、第 5 节 trio 对照相关的经典标题)
- RoBERTa:《RoBERTa: A Robustly Optimized BERT Pretraining Approach》
- ALBERT:《ALBERT: A Lite BERT for Self-supervised Learning of Language Representations》
- DeBERTa:《DeBERTa: Decoding-enhanced BERT with Disentangled Attention》
- ELECTRA:《ELECTRA: Pre-training Text Encoders as Discriminators Rather Than Generators》
- SpanBERT:《SpanBERT: Improving Pre-training by Representing and Predicting Spans》
- DistilBERT:《DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter》
- MacBERT:《Revisiting Pre-Trained Models for Chinese Natural Language Processing》
- T5:《Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer》
- BART:《BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension》
官方文档与工具
- HuggingFace Transformers 文档(
AutoTokenizer/AutoModelForCausalLM/AutoModelForSequenceClassification/pooler_output与last_hidden_state的返回结构) - HuggingFace Model Hub 上的中英文 Encoder 权重(BERT、RoBERTa、MacBERT、DeBERTa 等)
- PyTorch 量化与剪枝 API 文档(
torch.quantization.quantize_dynamic、torch.nn.utils.prune.global_unstructured),与项目最后一环的模型压缩对应
本系列内相关课时
- 前序:Transformer 结构、注意力机制、词向量与 ELMo(本课第 5 节的对照表依赖这几课的基础)
- 后续:BERT 微调实战、LLM 零样本分类(对应新闻分类项目第三、四级)