一张”DeepSeek 对话补全接口到底返回了什么”的字段字典,搞不懂这张表,就没法写出健壮的大模型调用代码,也算不清成本和缓存收益。
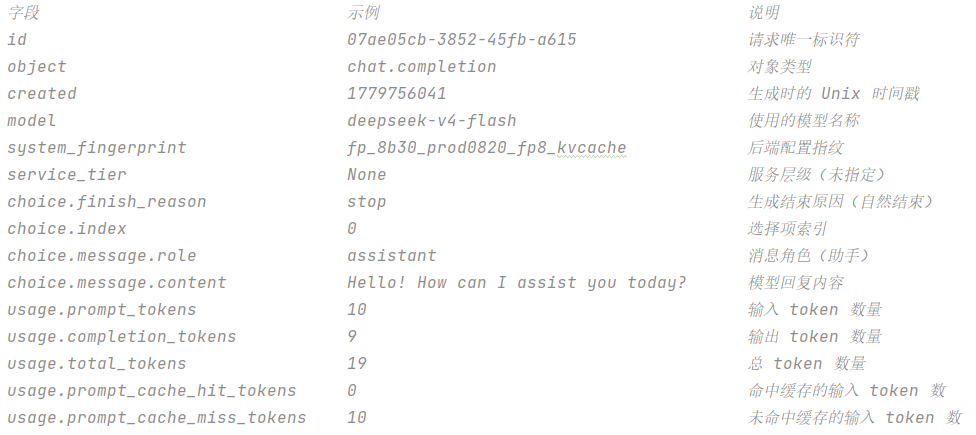
图注:原图是三列对照表,字段 / 示例 / 说明,逐行列出了 DeepSeek chat.completion 返回体里的 14 个字段。下面所有内容都是对这张表逐行展开。注意示例里 model 是 deepseek-v4-flash、finish_reason 是 stop、total_tokens 是 19。
一、这份材料解决什么问题
调用大模型 = 发一次 HTTP 请求,拿回一个 JSON。绝大多数人只从 JSON 里抠 choices[0].message.content 就完事,剩下的字段全丢掉。但真实工程里这些”剩下的字段”决定三件事:
- 能不能稳定地写代码,不知道
finish_reason就分不清”模型回答完了”和”被长度截断了”; - 能不能算钱,不知道
usage的分项就估不准成本,更没法做缓存优化; - 能不能排查线上问题,不知道
id/system_fingerprint就没法把某次报错定位到具体请求和后端配置。
这份材料就是这套字段的完整字典,是新闻分类项目里用 DeepSeek API 做新闻分类那一步的地基。
二、核心结论
- 返回体是三层嵌套:顶层元信息(
id/object/created/model)→ 生成结果(choices,是数组)→ 用量统计(usage)。写代码时三者要分别处理。 choices是列表不是因为会返回多个答案,而是接口沿用了”n 参数可要多个候选”的设计;默认只取choices[0]。finish_reason是最该被检查却最常被忽略的字段:stop表示模型自然结束,length表示被max_tokens截断,后者直接导致下游 JSON 解析失败。usage里prompt_tokens计费的是输入,completion_tokens计费输出,二者单价不同(输出通常更贵)。做成本估算必须分开乘。prompt_cache_hit_tokens/prompt_cache_miss_tokens是省钱的关键:命中缓存的那部分输入 token 单价大幅降低,所以”把稳定不变的内容(system 提示、few-shot 示例)放在提示词前缀”是有真金白银收益的工程习惯。
三、知识地图
| 字段 | 示例 | 说明 |
|---|---|---|
id |
07ae05cb-3852-45fb-a615 |
请求唯一标识符 |
object |
chat.completion |
对象类型 |
created |
1779756041 |
生成时的 Unix 时间戳 |
model |
deepseek-v4-flash |
使用的模型名称 |
system_fingerprint |
fp_8b30_prod0820_fp8_kvcache |
后端配置指纹 |
service_tier |
None |
服务层级(未指定) |
choice.finish_reason |
stop |
生成结束原因(自然结束) |
choice.index |
0 |
选择项索引 |
choice.message.role |
assistant |
消息角色(助手) |
choice.message.content |
Hello! How can I assist you today? |
模型回复内容 |
usage.prompt_tokens |
10 |
输入 token 数量 |
usage.completion_tokens |
9 |
输出 token 数量 |
usage.total_tokens |
19 |
总 token 数量 |
usage.prompt_cache_hit_tokens |
0 |
命中缓存的输入 token 数 |
usage.prompt_cache_miss_tokens |
10 |
未命中缓存的输入 token 数 |
读表要点:这张表有 15 行但实际是 3 个命名空间,无前缀的 6 个是顶层字段,choice.* 的 4 个在 choices 数组元素里,usage.* 的 5 个在用量对象里。示例值 19 = 10 + 9、10 = 0 + 10 这两组加法能自校验,说明缓存字段是 prompt_tokens 的拆分而非额外增量。
四、原理详解
4.1 顶层元信息:这次的请求”是谁、什么时候、用什么后端产生的”
id:一次请求一个 UUID,日志里必须记这个字段。线上出现”用户说答案不对”时,只有id能让你从网关日志反查那次请求的入参。object:固定为chat.completion(对话补全)或chat.completion.chunk(流式返回的每一片)。写通用客户端时拿它做类型判断。created:Unix 秒级时间戳。1779756041换算过来是 2026 年,和示例里model=deepseek-v4-flash的时代对得上。注意它是服务端生成时刻,不是你发请求的时刻,两者差值就是排队+推理耗时。model:实际服务的模型名。这一点很关键,你请求里写的是别名(例如deepseek-chat),返回里是真实部署的版本。做 A/B 或线上归因时以返回值为准。system_fingerprint:fp_8b30_prod0820_fp8_kvcache这种字符串是后端配置指纹。拆开读:8b30像构建批号,prod0820是生产环境 8 月 20 日的配置,fp8_kvcache说明 KV Cache 用了 FP8 存储。它的用途只有一个:同一个提示词昨天输出稳定、今天结果漂移了,先比对system_fingerprint是否变了,变了就是服务端换了配置,不是你的代码问题。service_tier:服务层级,示例是None(未指定)。有些平台提供”标准/弹性/批量”等不同延迟与价格的档位,这一栏告诉你这次走的是哪档。
4.2 choices:为什么是数组
{
  "choices": [
    {
      "index": 0,
      "finish_reason": "stop",
      "message": { "role": "assistant", "content": "Hello! How can I assist you today?" }
    }
  ]
}
请求参数里的 n 表示”要几个候选答案”,默认 1,所以返回数组长度为 1。index 就是候选的序号。
message.role 固定是 assistant。注意角色语义:system/developer 是规则层,user 是提问层,assistant 是输出层,它记录的是模型说过的话,不是给模型的指令。把 assistant 历史当成指令来信任是常见的提示注入入口。
message.content 才是你要的结果。但在实际工程里,深挖顺序应该是:
先看 finish_reason  →  是 length 就直接判失败重试/加长
再看 content 是否为空  →  空内容多半是触发了安全策略或 reasoning 阶段的特殊返回
最后才解析 content 里的结构化数据(如 JSON)
4.3 finish_reason:一个字段决定重试逻辑
| 取值 | 含义 | 工程动作 |
|---|---|---|
stop |
模型自然输出结束(遇到停止符或说完了) | 正常处理 |
length |
达到 max_tokens 被截断 |
判定为不完整,加大 max_tokens 或让模型分段输出 |
content_filter(部分平台) |
内容被安全策略拦截 | 提示用户改问法,不要盲目重试 |
tool_calls(支持工具调用时) |
模型要求调用工具,等待执行结果 | 执行工具并把结果喂回 |
示例值是 stop,说明这次是自然结束,可以放心用。
在新闻分类项目里的实际影响:LLM 做 10 分类时,我们要求模型只输出类别名(比如 __label__体育 或纯 JSON)。一旦被 length 截断,返回内容就带上半个 JSON,json.loads 直接抛异常。所以”先判 finish_reason == 'stop' 再解析”必须在封装函数的第一行。
4.4 usage:成本与缓存的账本
示例的账:输入 10 token,输出 9 token,合计 19 token。缓存命中 0、未命中 10,首次请求没有前缀可复用,全部按原价。
公式:
\text{cost} = \text{prompt\_tokens} \times p_{in} + \text{completion\_tokens} \times p_{out}
缓存生效时,prompt_tokens 拆成两段计价:
\text{cost} = (\text{cache\_hit} \times p_{hit} + \text{cache\_miss} \times p_{in}) + \text{completion\_tokens} \times p_{out},\quad p_{hit} \ll p_{in}
算一个小例子(示意单价,仅说明口径):假设输入 ¥1/百万 token、输出 ¥2/百万 token、缓存命中价是输入价的 1/10。
- 场景 A:system 提示 + 8 个 few-shot 示例共 3000 token,前面 3000 token 完全一样,每次只换最后的标题。首次:3000×1 + 20×2 = 3040 单位;后续命中部 3000:3000×0.1 + (3000−3000 未命中 0)×1 + 20×2 = 340 单位。单次成本降到约 1/9。
- 场景 B:把”示例”和”动态标题”交替拼接,前缀每次都在变 → 命中 0,成本始终按原价。
任务说明、示例、约束这类不变内容必须放在提示词最前面且一字不改;把变量拼在中间会让缓存彻底失效。这是 RAG/分类这类大批量调用场景最容易省下来的一笔钱。
4.5 一次完整的调用示例(把字段用起来)
import os, json, time, logging
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

SYSTEM = (
    "你是新闻标题分类器。类别只能是:"
    "体育、财经、科技、娱乐、社会、军事、国际、汽车、房产、教育。"
    "只输出一个类别名,不要任何解释。"
)
FEWSHOT = [
    ("梅西帽子戏法助球队逆转夺冠", "体育"),
    ("央行宣布下调存款准备金率0.5个百分点", "财经"),
]

def build_messages(title: str):
    msgs = [{"role": "system", "content": SYSTEM}]
    for q, a in FEWSHOT:                      # 稳定前缀:利于缓存命中
        msgs.append({"role": "user", "content": q})
        msgs.append({"role": "assistant", "content": a})
    msgs.append({"role": "user", "content": title})
    return msgs

def classify(title: str, retries: int = 3) -> str | None:
    for i in range(retries):
        t0 = time.time()
        resp = client.chat.completions.create(
            model="deepseek-chat",
            messages=build_messages(title),
            temperature=0.0,          # 分类任务要确定性
            max_tokens=16,            # 只要一个类别名,防跑飞
        )
        dt = time.time() - t0
        ch = resp.choices[0]
        log = {
            "id": resp.id,                          # 出错时可归因
            "model": resp.model,                    # 实际服务的模型
            "fingerprint": getattr(resp, "system_fingerprint", None),
            "finish_reason": ch.finish_reason,
            "prompt_tokens": resp.usage.prompt_tokens,
            "completion_tokens": resp.usage.completion_tokens,
            "total_tokens": resp.usage.total_tokens,
            "latency_s": round(dt, 2),
        }
        logging.info("ds_call %s", json.dumps(log, ensure_ascii=False))

        if ch.finish_reason != "stop":              # 截断/被拦 → 重试
            continue
        label = (ch.message.content or "").strip()
        if label in LABELS:
            return label
return None这段代码体现了这张表的所有字段怎么用:finish_reason 控重试、usage 做成本日志、id+model+system_fingerprint 做可观测性、稳定的 few-shot 前缀吃缓存。
五、易错点与常见误解
| 常见说法 | 正确说法 | 为什么 |
|---|---|---|
choices 是数组,所以一次能拿多个答案 |
默认 n=1,返回长度就是 1;要多个候选必须显式传 n |
数组只是接口的历史设计,别把它当特性 |
content 拿到了就算成功 |
必须先判 finish_reason,再判 content 是否为空 |
length 截断会返回”半个 JSON”,直接 json.loads 必炸 |
total_tokens = prompt + completion 就够了,成本按总数算 |
输入输出单价不同,必须分开乘 | 用总数乘一个平均价,大批量估算会系统性偏低或偏高 |
| 缓存是平台自动优化的,跟我写法无关 | 前缀一字不变才命中;变量拼在前面会让命中率归零 | 提示词结构直接决定成本 |
model 字段就是我请求里写的模型 |
它反映实际服务的模型(可能是别名对应的真实版本) | 归因、对比实验要以返回值为准 |
created 是客户端发起请求的时间 |
是服务端生成响应的时刻 | 两者差值就是排队 + 推理时延 |
system_fingerprint 是给用户看的版本号,可以忽略 |
它变了意味着后端配置变了,输出差异可能来源于此 | 排查”昨天还好今天不一样”的第一现场 |
六、横向对比与研究脉络
不同厂商返回体的字段命名对照(同一层语义,换平台就要换字段名):
| 语义 | DeepSeek / OpenAI 兼容 | 常见差异点 |
|---|---|---|
| 请求唯一标识 | id |
各平台一致 |
| 实际模型 | model |
国内平台常返回带版本号的真实模型名 |
| 结束原因 | choices[0].finish_reason |
部分平台叫 stop_reason(Anthropic 系) |
| 回复内容 | choices[0].message.content |
Anthropic 是顶层 content 数组;Gemini 是 candidates[0].content.parts |
| 用量 | usage.{prompt,completion,total}_tokens |
Anthropic 拆成 input_tokens/output_tokens |
| 缓存分项 | prompt_cache_hit_tokens / prompt_cache_miss_tokens |
这是 DeepSeek 明确暴露缓存收益的设计,OpenAI 系叫 cached_tokens |
| 后端指纹 | system_fingerprint |
并非所有平台都暴露 |
为什么”缓存分项”这类字段值得单列:它把”提示词工程”从玄学变成了可测量指标。你优化提示词顺序之后,prompt_cache_hit_tokens/prompt_tokens 这个比值会直接上升,这是一个可以写进项目汇报的量化收益。
七、在新闻分类项目中的落地
这套新闻分类流水线的最后一环是 LLM 零样本/少样本分类(前三环是 TF-IDF+随机森林、FastText、BERT)。这张表在三处直接决定项目质量:
- 封装调用函数(项目里 LLM 部分的第一步就是”把官网 API 案例封装成函数,再加提示词”):
- 入参只有标题,出参必须是受控的类别名;
- 函数内先判
finish_reason,再校验类别是否在 10 个合法类别里,不合法就重试,这样才有一个能和前三个模型同口径比较的准确率数字。 - 成本与延迟统计:1w 条测试集 × 每条约 20 输出 token。把
usage逐条落库,最后能算出”LLM 方案单次推理成本是 BERT 的 N 倍、准确率高 M 个点”,这就是模型对比章节要的结论。同时记录latency_s,说明 LLM 方案在吞吐上不可用于线上实时。 - 提示词前缀稳定 → 吃缓存:10 个类别的定义 + few-shot 示例是固定不变的,放在
system和最前面的user/assistant对里;变化的标题只放最后一句。批量跑 1w 条时命中率会非常高,直接砍掉大部分输入成本。 - 可观测性:日志记
id+model+system_fingerprint。跑批过程中如果某天准确率突然掉,先看指纹和模型名有没有变,这是把”模型漂移”和”我的代码 bug”区分开的唯一手段。
八、重点问答
Q1:调大模型接口,返回里你最关注哪几个字段?为什么?
A:我关注四个。一是 finish_reason,它告诉我模型是自然结束还是被 max_tokens 截断了,length 意味着返回内容不完整,我必须在解析前就判掉、走重试。二是 usage 的 prompt_tokens 和 completion_tokens,因为输入输出单价不一样,成本必须分开算。三是 model 和 system_fingerprint,前者是实际服务的模型,后者是后端配置指纹,出问题时用它们区分”模型漂移”和”我的 bug”。四是 prompt_cache_hit_tokens,它直接告诉我提示词前缀有没有命中缓存。
Q2:choices 是数组,是不是能一次拿多个答案?
A:默认不能。请求参数 n 默认是 1,所以数组长度就是 1,choices[0] 就是唯一答案。数组是接口的历史设计,只有显式传 n>1 才会返回多个候选,而且多候选会让输出 token 成倍增长,分类任务里完全用不上。
Q3:怎么用接口返回值做成本优化?
A:核心是吃缓存。返回体里的 prompt_cache_hit_tokens 和 prompt_cache_miss_tokens 把输入 token 拆成了两段,命中部分单价远低于未命中部分。所以工程上要保证提示词的稳定前缀一字不变:把任务说明、类别定义、few-shot 示例全放前面,把每条变化的标题只放最后一句话。反过来,如果把变量拼在提示词中间,前缀每次都变,命中率归零,成本直接差一个数量级。
Q4:拿到 content 就直接 json.loads 有什么问题?
A:两个坑。第一,finish_reason 是 length 时会返回被截断的半个 JSON,json.loads 必抛异常;第二,模型可能加上”好的,以下是结果:”这类解释性前缀。所以正确顺序是先判 finish_reason == 'stop',再剥掉 markdown 代码块标记,再解析,最后还要校验解析出的类别是否在合法枚举里,四步都过了才算一次成功调用。
Q5:system_fingerprint 有什么用?
A:它是后端配置的指纹,像示例里的 fp_8b30_prod0820_fp8_kvcache,能看出构建批号、生产配置日期和 KV Cache 用了 FP8 存储。用处是排查输出漂移:同一个提示词昨天稳定今天变了,先比对指纹,变了就是服务端换了配置,不是你的代码问题。
Q6:created 字段是客户端发起请求的时间吗?
A:不是,是服务端生成响应的时刻。所以它和客户端发请求时间的差值,正好等于排队加推理的耗时。要做端到端延迟统计,需要在客户端自己打时间戳,两者相减才是真实时延。
九、延伸阅读
- DeepSeek 官方 API 文档(对话补全接口的请求/响应字段与计费口径)
- 上下文缓存(Context Caching)机制说明,理解
prompt_cache_hit_tokens的前缀匹配规则 - OpenAI Chat Completions 兼容接口规范,对照理解跨平台字段差异
- 本目录《(提示词主课件)大模型 Prompt 工程指南》研究报告,
finish_reason与提示词约束的配合 - 本目录《【了解】中间特征》等模型压缩笔记,KV Cache 与 FP8 量化为什么会影响后端配置指纹