用三个阶段的骨架讲清”大模型不是突然出现的”,把 1950 年至今的技术演进串成一条从”人工写规则 / 统计计数”到”用规模换能力”的因果链,重点不是背年份,而是回答”为什么会有大模型”。
一、这份材料解决什么问题
被问到的最多的不是细节,而是判断:为什么 BERT 之后还要有 GPT?为什么大家都在堆参数?为什么现在又开始讲”推理模型”和”小模型”?
这份材料的价值是给出一条能自洽解释整条技术路线的主轴:
- 语言建模的目标从 1950 年代到今天没变过,预测下一个词(或填空);
- 变的是用什么函数去近似这个概率分布:从查表计数(N-gram)→ 循环网络(RNN/LSTM)→ 纯注意力(Transformer)→ 大规模预训练 + 对齐(GPT/ChatGPT);
- 每一次架构切换,解决的都不是”效果再好一点”,而是上一代方法的一个硬瓶颈:数据稀疏 → 长程依赖 → 并行与可扩展性 → 对齐与可控性。
所以这份材料在求职里的位置是技术叙事的地基:项目里 TF-IDF / FastText / BERT / LLM 四条路线逐级对比,说到底就是这条发展史在一个小数据集上的重演。你只要能讲清”每一代解决了上一代的什么瓶颈”,就能把评审者从”你调过什么 API”拉到”你懂不懂模型”的层面。
二、核心结论
- 主线是”逼近语言概率分布”的手段升级:N-gram(查表+平滑)→ 神经网络(embedding+RNN)→ Transformer(自注意力)→ 大规模预训练(Scaling)。每一代都在拆掉上一代的瓶颈。
- 大模型的直接触发条件是”规模换能力”被验证:课件图上 LeNet-5 约 6 万参数、BERT 约 3 亿、GPT-3 1750 亿,参数量跨了五个数量级,同时能力从”单一任务”变成”零样本/少样本通用”。
- 转折点是 2017 年的 Transformer:它把”串行的循环”换成”可并行的自注意力”,让”用算力堆规模”第一次在工程上算得过来账。没有并行,就没有 GPT-3。
- 两个范式跃迁必须分开记:2018 年的预训练 + 微调(GPT-1 / BERT),2020 年之后的预训练 + 提示 + 对齐(GPT-3 的 In-Context Learning、ChatGPT 的 RLHF)。前者要改参数,后者不改参数就能干活。
- 历史不是单向变大的直线:2024 年之后的走向是”推理(测试时算力)”和”效率(蒸馏/量化/小模型)+ 开源”,即能力、成本、可控性三条线同时优化;国产模型(通义千问、DeepSeek)已经在这条线上占位。
三、知识地图
课件本身只有”了解”权重,结构极简,但每一格背后都有可展开的原理:
1.1 大模型发展史【了解】
├── 学习目标:了解发展史 / 萌芽期 / 沉淀期 / 迅猛发展期
├── 一、发展史概览           → 一张"参数量-时间"曲线图(核心图)
├── 二、萌芽期(1950-2005)  → CNN 的提出与初步实践
│     ├── 1956  达特茅斯会议,麦卡锡提出"人工智能"
│     ├── 1980  福岛邦彦"神经认知机"(感受野,CNN 雏形)
│     └── 1998  LeNet-5(卷积层/池化层/全连接层交替)
│     └── 阶段特点:端到端学习可行,但算力数据受限
├── 三、探索沉淀期(2006-2019)→ 大数据 + GPU 催生深度学习
│     ├── 2012  AlexNet 夺得 ImageNet 冠军
│     ├── 2013  Word2Vec(词向量)
│     ├── 2014  GAN(生成器 vs 判别器博弈)
│     ├── 2017  Transformer(《Attention Is All You Need》)
│     └── 2018  GPT-1 / BERT(预训练 + 微调)
│     └── 阶段特点:找到强架构 + 高效学习范式
├── 四、迅猛发展期(2020-至今)→ 规模突破临界点后能力涌现
│     ├── 2020/05  GPT-3(1750 亿,In-Context Learning)
│     ├── 2022/11  ChatGPT(RLHF,"iPhone 时刻")
│     ├── 2023/03  GPT-4 / Turbo / 4o(多模态)
│     ├── 2023-24  Llama 系列、Mistral Large 2(开源并跑)
│     ├── 2024/09  o1(复杂推理,测试时演算)
│     └── 2024-25  通义千问 2.5/3、DeepSeek-V3 / R1(国产第一梯队)
│     └── 阶段特点:规模涌现 / 多模态 / 开源闭源并行 / 感知→认知
└── 五、本节小结:理论突破 → 工程实现 → 应用爆发;未来竞争在推理、能效、个性化
四、原理详解
0. 为什么会有大模型:先把这张曲线看明白
大模型的出现不是”某天有人想做个大的”,而是三条曲线同时到位:模型参数量(容量)、训练数据量(信息)、可用算力(GPU/TPU)。课件开篇那张图,就是这三条线的结果图。
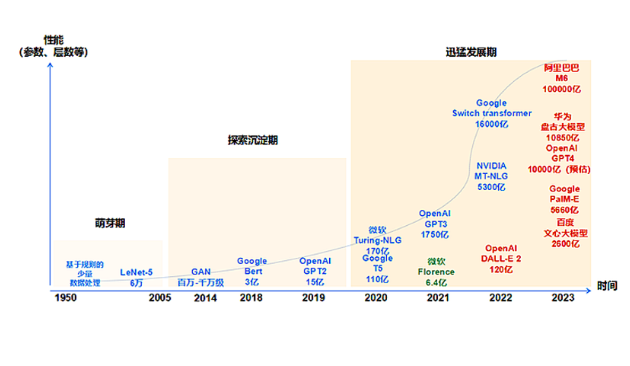
图注:纵轴是”性能(参数、层数等)”,横轴是时间(刻度 1950 / 2005 / 2014 / 2018 / 2019 / 2020 / 2021 / 2022 / 2023),背景分三段标注萌芽期、探索沉淀期、迅猛发展期。沿曲线用蓝字标出代表模型的参数量:起点是”基于规则的少量数据处理”,之后 LeNet-5 6 万、GAN 百万-千万级、Google Bert 3 亿、OpenAI GPT2 15 亿、微软 Turing-NLG 170 亿、Google T5 110 亿、微软 Florence 6.4 亿、OpenAI DALL·E 2 120 亿;曲线陡升段用红字标出更大的模型:百度文心大模型 2600 亿、NVIDIA MT-NLG 5300 亿、Google PaLM-E 5600 亿、OpenAI GPT4 10000 亿(预估)、华为盘古大模型 10850 亿、Google Switch Transformer 16000 亿、阿里巴巴 M6 100000 亿。注意最后一条写着”预估”,GPT-4 的真实参数量官方从未公布。
这张图要记住的三件事:
- 六个数量级的跨度:6 万 → 10 万亿。不是因为硬件便宜了,而是因为”参数越多、loss 越低”这件事在 2020 年被系统性地量化为经验规律(Scaling Law);
- 曲线是平滑的、不是台阶:能力提升大部分时间是连续的,所谓”涌现”只是平滑曲线在某些指标上被不连续的度量方式切成了台阶;
- 参数量不是唯一轴:同一年份里有的模型参数量更大却能力更弱(数据不够、训练不足),这就是后来”数据要和参数同比例增长”这条修正的来由。
1. Transformer 之前:语言模型是怎么做的
N-gram:用”数数”估计概率
语言模型的目标始终是同一个分布:
P(w_1, w_2, \dots, w_n) = \prod_{t=1}^{n} P(w_t \mid w_1, \dots, w_{t-1})
把长历史砍成前 n-1 个词,就是 N-gram 的马尔可夫假设:
P(w_t \mid w_1,\dots,w_{t-1}) \approx P(w_t \mid w_{t-2}, w_{t-1}) \quad(\text{trigram})
实现就是查表加计数(再配 Kneser-Ney、Good-Turing 之类的平滑),代码大概是这样:
from collections import Counter, defaultdict

bigram = defaultdict(Counter)
for sent in corpus:                       # corpus: List[List[str]]
    for w1, w2 in zip(sent, sent[1:]):
        bigram[w1][w2] += 1

def p_next(w1, w2):                       # 加一平滑的二元概率
    total = sum(bigram[w1].values()) + len(vocab)
    return (bigram[w1].get(w2, 0) + 1) / total
它的三个死结,就是后来所有架构要解的问题:
- 数据稀疏:没见过的组合概率归零,只能靠平滑硬凑;
- 维度灾难:要覆盖 5-gram 的组合,语料量级得指数级上升;
- 语义盲:
北京/首都在表里是两个互不相干的符号,猫吃鱼学到的概率完全帮不到猫吃鲈鱼。
神经网络语言模型:从”符号”到”向量”
2003 年 Bengio 等提出用前馈网络 + 词向量预测下一个词(NNLM):先把词映射成低维稠密向量(embedding),再用神经网络拟合 P(w_t \mid \text{前 n-1 个词})。这一步的本质变化是:相似词在向量空间里彼此靠近,模型学到的是连续的语义函数而不是离散的计数表,没见过的组合也能给出合理概率。
RNN / LSTM:能记住上下文,但记不长、也跑不快
RNN 用隐藏状态递归地压缩历史:
h_t = \tanh(W_{hh}h_{t-1} + W_{xh}x_t), \qquad \hat{y}_t = \text{softmax}(W_{hy}h_t)
问题有二:一是梯度沿时间步连乘,长依赖会被梯度消失/爆炸吃掉;二是 h_t 必须等 h_{t-1},训练无法在时间维度并行。
LSTM(1997)用门控缓解了第一点,输入门 i_t、遗忘门 f_t、输出门 o_t 控制细胞状态 c_t 的写入与保留:
c_t = f_t \odot c_{t-1} + i_t \odot \tilde{c}_t
细胞状态提供了一条近似”加法通路”,梯度可以长距离回传,长依赖明显改善(双向 LSTM 再叠加正反两个方向的上下文)。但第二个死结始终没解:序列还是串行的,加上固定维度的 h_t 是所有历史信息的”信息瓶颈”,模型一大就训不动。这就是 2017 年必须换架构的根本原因。
2. 萌芽期(1950-2005):CNN 与”端到端”的可行性
课件把这个阶段的标志定为卷积神经网络(CNN)的提出与初步实践:
- 1956 年,约翰·麦卡锡在达特茅斯会议上首次提出”人工智能”这一术语,AI 作为一个科学领域诞生;
- 1980 年,日本学者福岛邦彦提出”神经认知机”,被视为 CNN 的雏形,它引入了”感受野”概念,模拟生物视觉系统处理信息的方式;
- 1998 年,Yann LeCun 等人发表 LeNet-5,成功用于手写数字识别,奠定了现代 CNN 的基本结构:卷积层、池化层、全连接层交替使用。
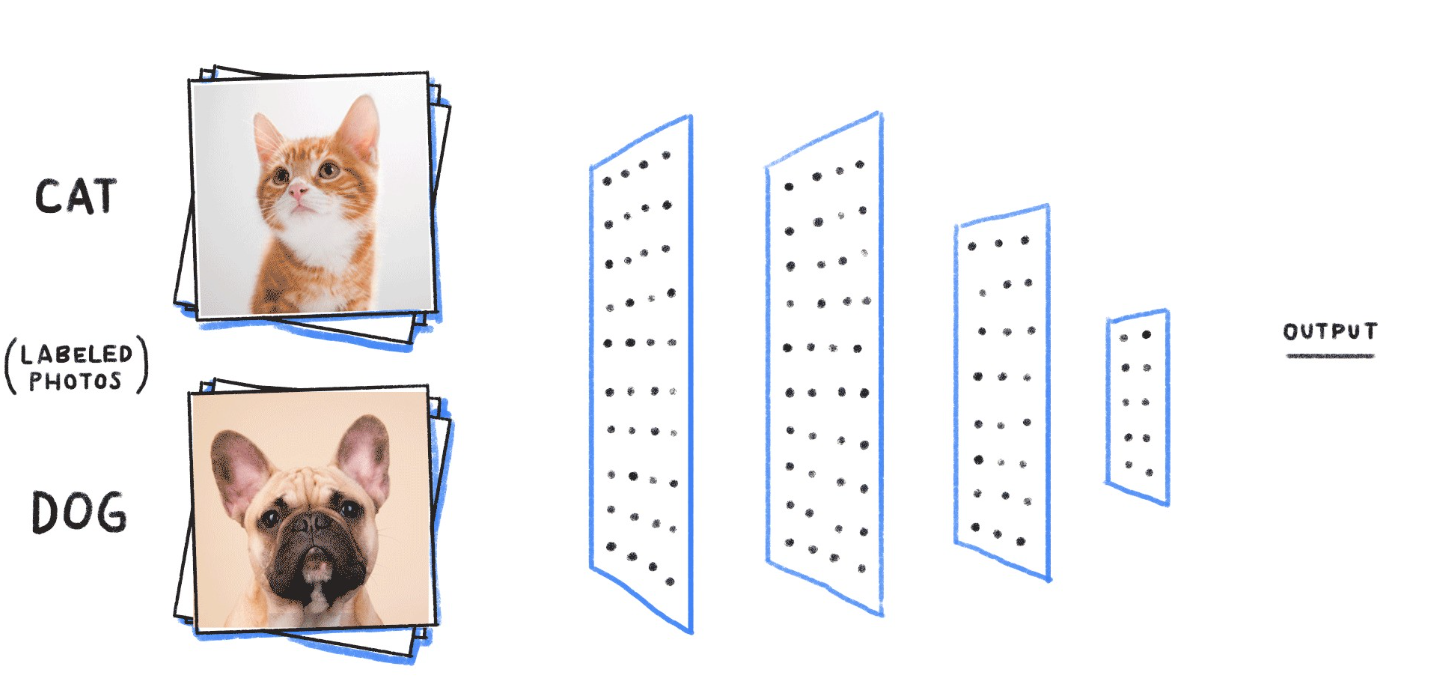
图注:图上左侧是两张带标签的照片,CAT 和 DOG;中间是从左到右逐级变窄的点阵(表示逐层抽取的特征,越往后维度越低);最右侧是输出端 OUTPUT。这张图讲的不是某一层的公式,而是”端到端”:输入是原始像素,中间一层层自己学特征,输出直接是类别标签,不需要人来设计特征。
为什么这一步重要:在此之前做图像识别,主流是人工设计特征(如 SIFT、HOG)。CNN 证明”从原始像素直接到预测结果”是可行的,这就是后来”预训练大模型吃掉所有下游任务”的思想起点。
课件对阶段的判断很克制,值得背下来:受限于计算能力和数据规模,只能处理相对简单的任务(如 MNIST 手写数据集),训练难度大、容易过拟合。但它埋下了种子。
3. 探索沉淀期(2006-2019):算力到位后的架构井喷
课件给这一阶段的定义是”大数据和 GPU 计算的出现,让神经网络焕发新生”,特点不只是 CNN 复兴,而是全新模型架构的井喷。
2012 AlexNet:深度学习的公开亮相
2012 年 AlexNet 在 ImageNet 图像识别挑战赛中以远超亚军的成绩夺冠,正式宣告深度学习浪潮到来。真正的推手是 GPU,同样的网络放到 CPU 上训要慢一个量级以上。
图注:照片中三位研究者并排合影(课件把它放在”2012 年 AlexNet 夺冠”这段正下方)。这张图没有技术信息,但它标记了一个事实:深度学习的转折点是一小撮人 + 一块 GPU 的工程胜利,而不是纯理论突破。
2013 Word2Vec:词向量大众化
Google 的 Word2Vec 通过无监督学习把单词映射为高维空间中的向量,使语义相似的词在向量空间中也彼此接近。它把 NNLM 里”作为副产品的 embedding”变成可以单独训练、单独复用的资产,直到今天,RAG 检索用的向量模型还是这个思想的直系后代。
2014 GAN:生成式路线的开端
Ian Goodfellow 提出生成对抗网络(GAN):一个生成器和一个判别器相互博弈、共同进化,能生成极其逼真的图像、音频等。它的意义是第一次让”生成”变成可训练的目标函数,今天扩散模型、大模型生成文本,都属于同一条”学数据分布”的路线。
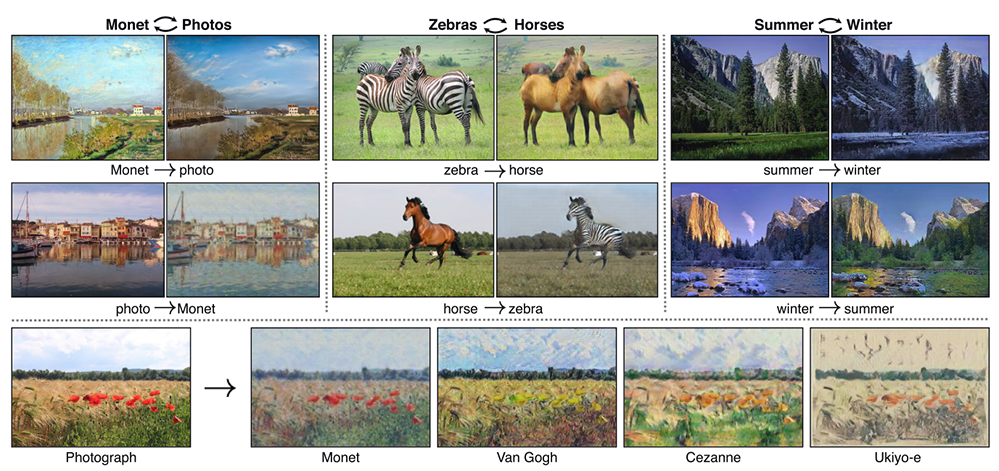
图注:图分四块,每块左右两图由双向箭头连接,表示”可以互相转换”:Monet ↔ Photos(莫奈画作 ↔ 真实照片,右上)、Zebras ↔ Horses(斑马 ↔ 马,左中)、Summer ↔ Winter(夏景 ↔ 冬景,右中)。下方还有一组单向箭头示例,即把输入分别送到不同目标域:Monet→photo、zebra→horse、photo→Monet、horse→zebra、winter→summer;最底部一排是 Photograph 分别转换到 Monet、Van Gogh、Cezanne、Ukiyo-e 四个画风的结果。这张图证明的是 GAN 学到的不是”复制粘贴”,而是域的语义结构(斑马条纹↔马、季节↔树木形态),所以能跨域迁移。
2017 Transformer:把”串行”彻底换成”并行”
Google 发表《Attention Is All You Need》,提出 Transformer 架构:完全摒弃传统的循环(RNN)和卷积结构,核心是自注意力机制,能够并行处理序列数据,并高效捕捉长距离依赖。
自注意力的核心公式(对你来说这就是要能写出来的那三行):
\text{Attention}(Q,K,V) = \text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right)V
直觉解释:每个词都拿着自己的 Query 去和所有词的 Key 做点积(算”我该关注谁”),归一化后当作权重,对所有词的 Value 加权求和。1/\sqrt{d_k} 是防止点积过大把 softmax 推到饱和区、梯度消失。多头(Multi-Head)则是让不同的头学不同的关系(指代、句法、位置),最后拼接。
它一次解决了两件事:训练可并行(时间维度不再有依赖链)→ 规模可以往上堆;任意两个位置的路径长度是 O(1) → 长依赖不再是瓶颈。代价是注意力对序列长度是 O(n^2) 复杂度,这个代价会在后面变成整个行业的显存焦虑,也是长上下文、KV Cache 优化、稀疏注意力等方向的动机来源。
2018 GPT-1 与 BERT:预训练 + 微调
- GPT-1(OpenAI):基于 Transformer,展示了通过海量无标注文本进行预训练,再在特定任务上微调的有效性;
- BERT(Google):通过”掩码语言模型”(MLM)更好地理解上下文语义,在 11 项 NLP 任务上刷新纪录。
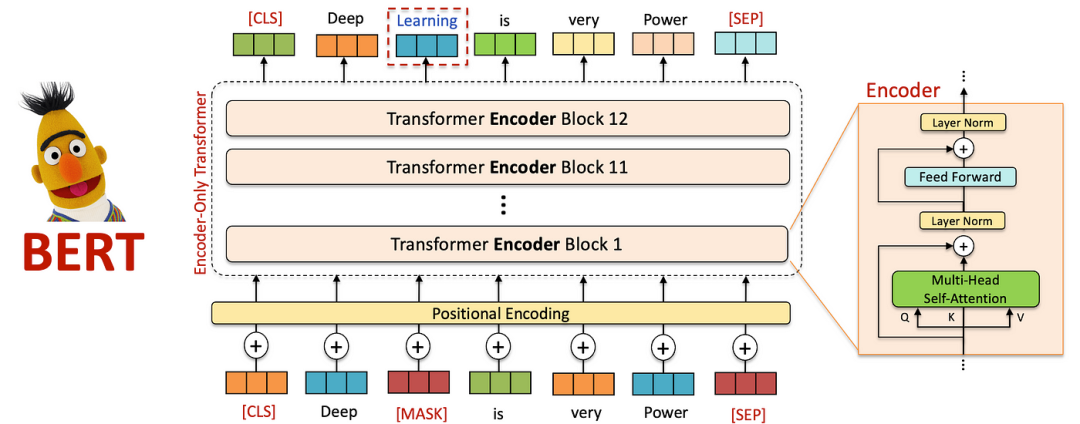
图注:这张图把 BERT 的完整数据流画了出来。顶部一行是输出序列 [CLS] Deep Learning is very Power [SEP];底部一行是输入一行是 [CLS] Deep [MASK] is very Power [SEP],其中一个词被替换成 [MASK](红色高亮),这就是掩码语言模型的训练信号:让模型把它填回来。输入先做 Positional Encoding,再送入竖排的 Transformer Encoder Block 1 … 11、12 共 12 层(图左侧竖排文字标着 Encoder-Only-Transformer,点明了 BERT 是只用编码器的结构)。右侧展开了一层内部模块:Encoder → Multi-Head Self-Attention(接受 Q、K、V 三个输入)→ 残差相加(+)→ Layer Norm → Feed Forward → Layer Norm。每个 token 的最后一层向量(E_{[CLS]}、E_{Deep}、…)就是它的上下文相关表示,[CLS] 位通常拿去做分类。
这张图是理解 GPT 与 BERT 分野的最短路径:BERT 看双向(所以要用 [MASK] 造训练目标),GPT 只能看左边(因果 mask,所以能自回归生成)。同一套 Transformer 骨架,训练目标不同,长出来的能力完全不同。
阶段特点(课件原话):研究者们找到了更强大的模型架构(Transformer)和更高效的学习范式(预训练 + 微调),AI 在视觉高歌猛进,在 NLP 取得突破,为大模型时代做好了全方位准备。
4. 迅猛发展期(2020-至今):规模突破临界点
课件的核心判断一句话:当模型参数、数据量和算力规模突破某个临界点后,会涌现出令人惊叹的新能力。
2020/05 GPT-3:范式从”微调”变成”提示”
OpenAI 推出 1750 亿参数的 GPT-3,展示了强大的上下文学习(In-Context Learning)和指令遵循(Instruction Following)能力,几乎无需微调就能完成各式各样的任务。
这是历史上的一个分水岭:GPT-1/BERT 时代,”换个任务 = 换一批参数”;GPT-3 之后,”换个任务 = 换个提示词”。Prompt Engineering 这门手艺就是从这里开始值钱的,它把一个”改模型”的问题变成了”写接口”的问题,这也是 LLM 应用工程师这个岗位能存在的前提。
OpenAI 自己的版本演进线
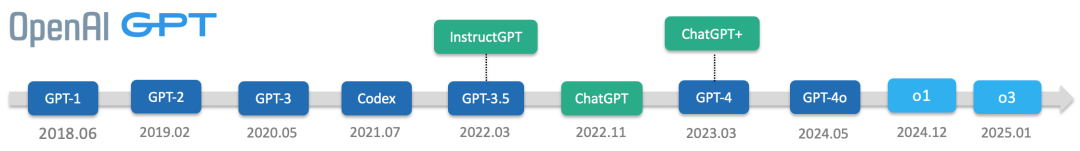
图注:横轴是时间,每个色块下方的日期逐字为 GPT-1 2018.06、GPT-2 2019.02、GPT-3 2020.05、Codex 2021.07、GPT-3.5 2022.03(绿色框标注 InstructGPT)、ChatGPT 2022.11、GPT-4 2023.03(绿色框标注 ChatGPT+)、GPT-4o 2024.05、o1 2024.12、o3 2025.01。注意 GPT-3.5 上面标的是 InstructGPT、GPT-4 上面标的是 ChatGPT+,课件用这两个绿框点出:真正让大众记住的版本,关键动作不是”变大”,而是对齐(alignment)和多模态升级。
把课件正文的叙述补上这条线:
- 2022 年 11 月 ChatGPT:AI 发展史上的”iPhone 时刻”。它通过基于人类反馈的强化学习(RLHF),让大模型能以非常自然、有用、无害的方式与人类对话,使 AI 技术真正走向大众。
- 2023 年 3 月 GPT-4:已不只是语言模型,而是能理解和生成文本、图像的多模态模型,逻辑推理能力大幅提升;随后的 GPT-4 Turbo、GPT-4o 在上下文长度、响应速度和多模态交互上持续优化。
这里有一个考查高频误区要现在就纠正:RLHF 并不会给模型灌进新知识。知识来自预训练语料,RLHF 改变的是输出风格、指令遵循度、有用性与无害性,所以”知识截止日期”这个问题,靠提示词、RAG、联网检索解决,不能靠”再对话几轮把它教明白”。
开源阵营:Llama 与 Mistral
- Meta 的 Llama 系列(Llama-3、Llama 3.1 405B、Llama 3.2)催生了空前活跃的开源社区,降低了前沿技术的使用门槛;
- 法国的 Mistral AI 凭借 Mistral Large 2 等模型,在性能上对标甚至超越了闭源模型。
图注:深色背景的官方宣传图,上方蓝色大字是 “Meta Llama 3” 与白色粗体的 “Llama 3.1″;图中有两只拟人化的羊驼(llama)头像作为形象,另有 Meta 的 logo 与文字标识。这是 Llama 3.1 发布时的官方配图,开源权重模型能做成一件”品牌事件”,本身就是这个阶段的一个信号:前沿能力的获取门槛被公开权重打下来了。
开源对你的实际影响:微调、量化、私有化部署这条路,是因为有了可下载的权重才成立;否则模型压缩那一整章(量化/蒸馏/剪枝)就没有落地对象。
2024/09 o1:从”模式匹配”到”会演算”
OpenAI 的 o1 标志着大模型在复杂推理(尤其数学和科学计算)上达到新的高度:它不再是简单的模式匹配,而是能进行”思考”和”演算”。
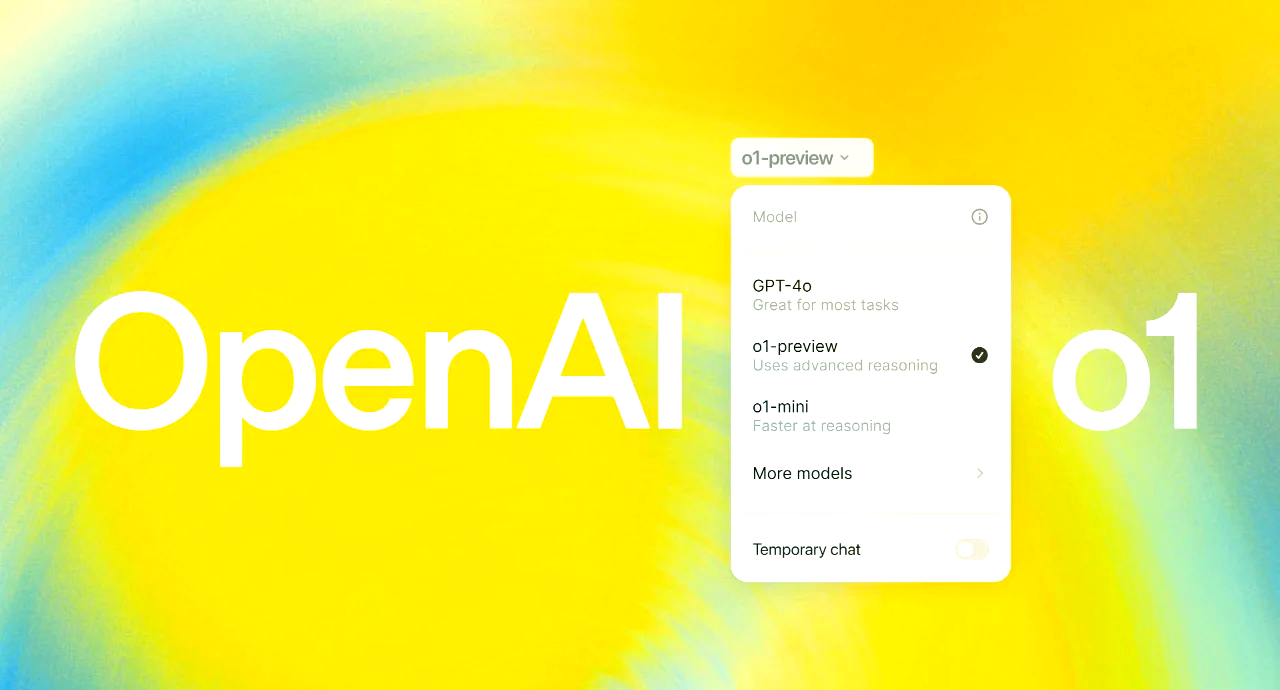
图注:OpenAI o1 的官方宣传图:黄色渐变背景,白色大字 “OpenAI” 与右侧巨大的 “o1″。画面右侧是一个打开的下拉菜单(顶部按钮写着 o1-preview),菜单标题为 Model,三个选项逐字为:GPT-4o / Great for most tasks、o1-preview / Uses advanced reasoning、o1-mini / Faster at reasoning,下方还有 More models 和 Temporary chat。o1-preview 右侧有黑色对勾,表示当前被选中。这张图最有信息量的细节是那句 “Uses advanced reasoning”(使用进阶推理),它说明当时产品形态上已经把”通用对话模型”和”推理模型”并列成两个可选项,而不是用一个大模型全包。
技术上发生的转变:训练侧 Scaling(把模型做大)之外,多了测试时计算(test-time compute)这条新轴,推理时先生成长链条的思考、再给答案,用推理时间换正确率。o1 在数学和代码上的提升,主要来自这条路。这也是”大模型发展史”在 2024 年之后的新分叉,被追问时讲演进方向时必须提到。
国产大模型:通义千问与 DeepSeek
课件的判断是:阿里的通义千问 2.5 及通义千问 3、特别是深度求索的 DeepSeek-V3 和 DeepSeek-R1 的发布,证明了国产大模型已在全球第一梯队中占据重要位置,其中 R1 在数学和代码能力上的表现尤为亮眼。
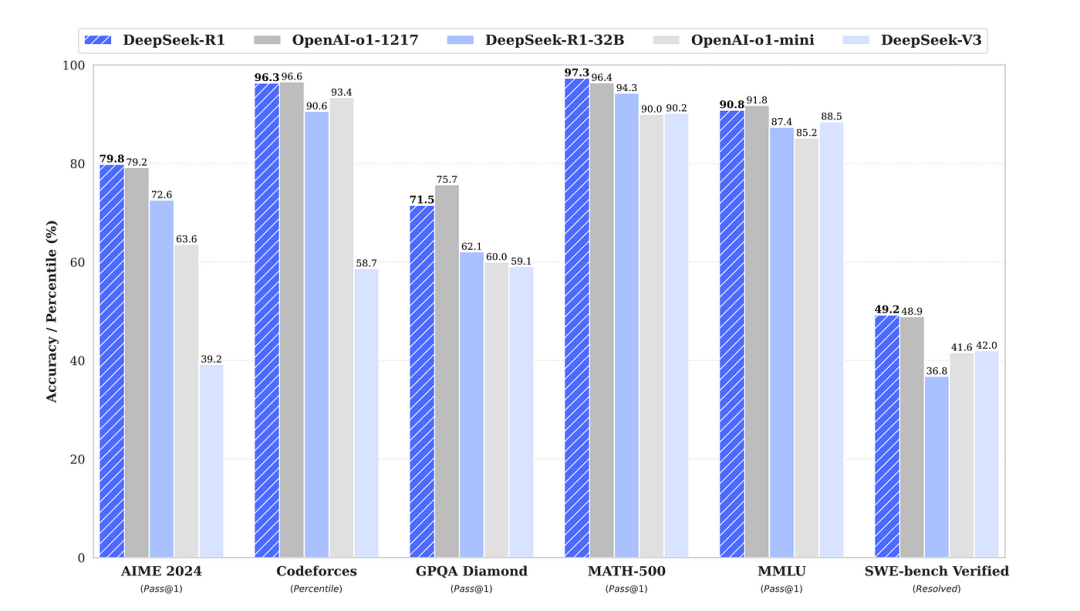
图注:这是一张六榜单对比柱状图。纵轴标 Accuracy / Percentile (%);横轴六个榜单依次为 AIME 2024 (Pass@1)、Codeforces (Percentile)、GPQA Diamond (Pass@1)、MATH-500 (Pass@1)、MMLU (Pass@1)、SWE-bench Verified (Resolved);五种柱子(斜纹 DeepSeek-R1、灰 OpenAI-o1-1217、蓝 DeepSeek-R1-32B、浅灰 OpenAI-o1-mini、更浅的蓝 DeepSeek-V3)。图上读到的关键数值:AIME 2024 上 DeepSeek-R1 79.8 与 OpenAI-o1-1217 79.2 基本持平,而 DeepSeek-V3 只有 39.2(差值 40 分说明推理后训练带来的提升有多大);Codeforces 上 R1 96.3、o1-1217 96.6 同为最高档;Math-500 上 R1 97.3 略高于 o1-1217 的 96.4;SWE-bench Verified 上 R1 49.2、o1-1217 48.9。这张图真正的价值不是”谁第一”,而是”R1-32B 这种小尺寸版本在 GPQA、Math-500 上也能拿到 62.1 / 94.3″,它证明推理能力可以被蒸馏到小模型里,这就是你项目里”模型压缩”那一章要解决的问题。
阶段特点(课件原文,务必背下来)
- 模型规模急剧扩大,能力”涌现”成为常态;
- 技术从”单模态”走向”多模态”融合;
- 开源与闭源路线并行发展,竞争白热化;
- 模型的重点从”感知”走向”认知”和”推理”;
- AI 不再仅仅是工具,而是逐渐成为能够进行创造性协作的伙伴。
5. Scaling Law:把”更大”变成一门可算账的生意
课件没有给公式,但”突破临界点会涌现新能力”这句话背后就是 Scaling Law。被追问时你至少要能说出下面这层意思:
第一版(2020,Kaplan 等):语言模型的交叉熵损失 L 与参数量 N、数据量 D、计算量 C 各呈幂律关系,形式大致是
L(N) \approx L_\infty + \left(\frac{N_c}{N}\right)^{\alpha}, \qquad \alpha \approx 0.07 \text{ 量级}
结论是”把模型做大,loss 平滑下降”,而且曲线在好几个数量级内看不到饱和。这条经验规律是整个”暴力美学”路线的底气:花多少算力、能换多少 loss,事先可以估。
修正版(2022,Chinchilla):给定算力预算,参数量和数据量应该同比例增长(经验上约每个参数配 20 个 token),当时很多大模型是”参数太大、数据不足”,属于欠训练。这一条直接改变了 2023 年之后的训练配比,也解释了为什么后来的模型不再单纯比参数,而开始比”训练了多少 token”。
两个必须知道的反面:
- 幂律是统计趋势,不是保证。它描述的是”平均而言、在算力足够的前提下”。数据质量差、训练过程不稳定、数据重复,都会让实际曲线偏离预估。
- “涌现能力”有一部分是度量假象。当能力用离散的正确/错误指标衡量时,底层连续的 loss 下降会被切成一截一截的台阶,看起来像”突然学会”。所以讲”涌现”时最好带上这个 caveat,评审者会觉得你真的读过东西,而不是背 PPT。
为什么这条线索对求职重要:它同时解释了 GPT-3 为什么可能、以及为什么现在又开始讲小模型。Scaling 把能力上限推高,代价是把成本推高;落到你我的项目里,就变成”用大模型做零样本分类效果好但贵,用蒸馏/量化/剪枝把能力搬到小模型上,才是能交付的方案”。
五、易错点与常见误解
-
常见说法:”Transformer 是第一个用注意力机制的模型”
实际上,Transformer 的贡献是”只用注意力、彻底去掉循环和卷积”,而不是发明注意力。在它之前,注意力已经作为 RNN seq2seq 翻译模型的辅助组件存在。
为什么:把架构创新和方法创新混为一谈,会让你在答”Transformer 为什么重要”时答偏,它的关键在并行性与可扩展性,不在”注意力”这个词。 -
有人以为”BERT 和 GPT 是同一个东西,只是一个大一个小 / 一个中文一个英文”
其实两者共用 Transformer 骨架,但方向相反:BERT 是 encoder-only、双向看、用 MLM 掩码目标训练;GPT 是 decoder-only、只能看左边(因果 mask)、用自回归预测下一个词训练。
原因在于,这直接决定能力边界,BERT 擅长理解与分类(微调后做文本分类),GPT 天生能生成、能做 zero-shot / few-shot。 -
常听到的一种说法是:”大模型就是参数量堆上去的,数据随便喂”
真实情况是,参数量、数据量、算力必须匹配。参数大而数据不足会欠训练,效果不如一个”小一点但喂饱了”的模型;数据质量(去重、清洗)同样直接决定上限。
背后的道理是,Chinchilla 之后,”比参数”基本被”比训练 token 数 + 数据质量”取代了。 -
容易想岔的地方:”参数越多效果一定越好”
事实正相反,Scaling Law 是平均意义上的幂律趋势,不是每个模型、每个任务上的保证;而且推理成本随参数线性上升,工程上经常要主动选小模型。
之所以如此,课件那张图上,同一年份里参数量大的模型不一定更强,曲线画的是趋势,不是每个点。 -
先说一个误解:”GPT-4 是 1 万亿参数,论文里写了”
实际上,OpenAI 从未公开 GPT-4 的参数量、层数、数据量。图上写的”10000 亿(预估)”就是行业估算。
为什么:被追问时把估算值当官方参数说,是硬伤;正确说法是”官方未公开,业界估计在万亿量级”。 -
常见说法:”ChatGPT 这么强,是因为 RLHF 教会了它新知识”
其实 RLHF(基于人类反馈的强化学习)改变的是对齐,输出的有用性、无害性、指令遵循度和对话风格;知识全部来自预训练。
原因在于,这解释了”知识截止日期”和”幻觉”为什么无法通过多轮对话根治,只能靠 RAG / 检索 / 工具调用补外部信息。 -
有人以为”注意力机制 2017 年才出现,之后 RNN/LSTM 就完全没用了”
真实情况是,RNN/LSTM 仍是序列建模的基础语言,理解它才理解”长依赖、梯度消失、状态瓶颈”这些 Transformer 要解决的问题;在流式、边缘设备、小数据场景里循环结构仍有价值(你项目里就有双向 LSTM 做蒸馏的案例)。
背后的道理是,发展史的正确读法是”每一代解决上一代的什么瓶颈”,而不是”新的把旧的淘汰了”。 -
常听到的一种说法是:”N-gram 已经过时,没有任何用处”
事实正相反,在输入法、拼写纠错、语音识别重打分、缓存/召回 fallback 这些场景里,N-gram 依然便宜好用。
之所以如此,讲演进时带上”老方法仍在某些约束下最优”,是工程师口吻;说”过时了”是背 PPT 的口吻。 -
容易想岔的地方:”发展史 = 时间线,把年份背下来就行”
实际上,评审者问发展史,考的是因果:为什么必须换架构、为什么范式会迁移、下一步卡在哪。
为什么:年份 Google 一秒能查,判断力查不到。
六、横向对比与研究脉络
语言建模方法的四代对比
| 代际 | 代表方法 | 核心原理 | 优点 | 缺点 | 典型场景 | 复杂度 |
|---|---|---|---|---|---|---|
| 统计语言模型 | N-gram + 平滑 | 马尔可夫假设 + 极大似然计数 | 实现极简、可解释、零训练成本、推理极快 | 数据稀疏、维度灾难、无语义泛化、n 一旦变长组合爆炸 | 输入法、拼写纠错、ASR 重打分 | 训练 O(N),存储随词表组合增长 |
| 神经网络词向量 | Word2Vec / NNLM | 无监督学 embedding,用向量表达语义 | 稠密低维、相似词相邻、可迁移复用 | 静态向量(一词一向量)、不建模长程上下文 | 文本向量化、检索、特征输入 | 训练 O(N) |
| 循环网络 | RNN / LSTM / BiLSTM | 隐藏状态递归压缩历史,门控保留长依赖 | 天然适配变长序列、参数量小、可流式 | 无法并行、长依赖仍衰减、h_t 是信息瓶颈 | 序列标注、语音、小数据任务 | 单步 O(1),但时间步串行,长序列训练慢 |
| 注意力架构 | Transformer | 自注意力全局加权,O(1) 路径长依赖 | 可并行、长依赖强、易扩展、可堆规模 | O(n^2) 注意力开销、显存吃紧、需大量数据 | 所有现代大模型(BERT / GPT / Llama / R1) | 每层 O(n^2 d) |
预训练范式的三次迁移
| 阶段 | 代表 | 换任务时要做什么 | 关键能力 |
|---|---|---|---|
| 预训练 + 微调(2018) | GPT-1 / BERT | 重新训练下游头或全参微调 | 单任务 SOTA(BERT 刷 11 项 NLP 任务) |
| 预训练 + 提示(2020) | GPT-3 | 只改提示词,不动参数 | In-Context Learning / 少样本 / 指令遵循 |
| 预训练 + 对齐(2022-) | InstructGPT / ChatGPT | 改提示词 + 用对齐后的行为规范 | 有用、无害、自然对话;后续再加多模态与推理 |
演进关系:谁解决了谁的什么问题
N-gram 的数据稀疏与语义盲
        └─→ 神经网络语言模型(embedding + 前馈):连续语义表达
                    └─→ RNN/LSTM:能记住任意长的历史
                                └─→ 长依赖衰减 + 训练不可并行(硬瓶颈)
                                            └─→ Transformer(2017):自注意力,全局可见 + 可并行
                                                        └─→ 预训练+微调(2018:GPT-1 / BERT)
                                                                    └─→ 规模换能力:GPT-3(2020,1750 亿)
                                                                                └─→ 对齐:ChatGPT(2022.11,RLHF)
                                                                                            └─→ 多模态:GPT-4 / 4o(2023-2024)
                                                                                                        └─→ 测试时算力:o1(2024.09),推理模型
                                                                                                                    └─→ 效率与开源:Llama / Mistral / 通义千问 / DeepSeek-R1
一句话记忆:架构解决”能不能学”,数据与算力解决”能学多好”,对齐解决”好不好用”,效率解决”用不用得起”。
七、这份材料在项目/求职中的用法
大模型发展史不是你”新闻分类项目”分类流水线里的一个技术组件,它的用法在表达层,具体到四件事:
1)把项目里”四模型对比”讲成发展史的缩影。
你的路线是 TF-IDF + 随机森林 → FastText → BERT 微调 → LLM 零样本/少样本,这四条线正好对应四代思路:统计计数 → 浅层神经网络 → 预训练 + 微调 → 预训练 + 提示。讲解时用这条骨架串起来,比逐条报指标高一个层级:
“我做的对比其实是一次微缩的发展史复盘。TF-IDF 加随机森林对应 N-gram 时代,靠词频统计,优点是可解释、训得快,缺点是语义盲:’股市大跌’和’沪指跳水’在它的特征空间里毫不相关。FastText 加上了词向量和 n-gram 特征,开始有语义泛化,但仍然是浅层、静态的表示。BERT 用双向 Transformer 编码器和预训练带来的上下文相关表示,把 F1 拉上一个台阶,代价是要微调、要 GPU。LLM 零样本分类最省事,改提示词就能换任务,但成本最高、稳定性最差,所以我最后要靠模型压缩把它收下来。”
2)回答”你为什么用 BERT 不用 LLM / 为什么还要微调”时有历史视角。
2018 年的答案是”预训练 + 微调”;2020 年后的答案是”预训练 + 提示”。你的项目同时用到两者,正好可以说明:不是谁取代谁,而是成本-效果-可控性的三选二。分类 10 个类别、18 万训练样本,BERT 微调的边际收益明显;但换类别、加类别时,LLM 零样本的迭代速度是不可替代的。这段回答能直接证明你理解范式迁移,而不是只会调 API。
3)把”模型压缩”接到发展史的下半段。
Scaling Law 把能力上限推高,同时把推理成本推高,你项目的最后一步(量化 QAT/PTQ/DQ、蒸馏中间层/软标签/硬标签、结构化与非结构化剪枝、低秩分解)就是这条曲线的成本一侧。更好的说法是引用课件那张榜图的细节:R1 用 32B 的小尺寸在 GPQA 上还能拿到 62.1、Math-500 上 94.3,说明”推理能力可以被压进小模型”。这条从”Scaling 到 Compression”的叙事,会让你的压缩章节显得有动机而不是凑章节。
4)答”你怎么看大模型的演进方向”用四轴框架(这是最容易被问的开放题)。
- 训练侧:Scaling Law 仍有效,但重心从”参数”转向”数据配比与质量”(Chinchilla 的教训);
- 推理侧:测试时算力(o1 式的长思考链)成为新轴,用推理时间换准确率,R1 证明了这条路的通用性;
- 形态侧:单模态 → 多模态 → Agent(能调工具、能多步执行),课件小结说的”从感知到认知和推理”就是这个意思;
- 成本侧:蒸馏 / 量化 / 剪枝 / 小尺寸推理模型,让前沿能力落到可部署的价位。
最后补一句自己的判断(评审者想看的是判断,不是复述):未来两三年”会不会用大模型”不再稀缺,”能不能把它做进成本、延迟、准确率都可接受的系统里”才是稀缺能力,这就是你项目里 Flask 服务化 + Streamlit 客户端 + 模型压缩这一段想问的东西。
八、重点问答
Q1:大模型为什么会出现?一句话讲清。
A:我觉得是三条线同时到位的结果。总起来说:目标没变,都是逼近语言的概率分布;变的是用什么函数去逼近,以及敢堆多大。分三点讲:第一,模型这边,Transformer 在 2017 年把 RNN 的串行结构换成可并行的自注意力,训练不再被时间步卡住,规模才堆得上去;第二,数据这边,互联网上的无标注文本是几乎无限的,用”预测下一个词”就能把它们全都变成监督信号,不需要人工标注;第三,算力这边,GPU 让”花更多算力换更低 loss”这件事在经济上能算账,而且 2020 年的 Scaling Law 把这件事变成了可以提前预估的规律。所以大模型不是灵感,是可并行架构 + 海量无标注数据 + 便宜算力三者交点的必然产物。
Q2:Transformer 到底解决了 RNN/LSTM 的什么问题?
A:总的说,解决了两个硬瓶颈:长依赖和不可并行。分开看:RNN 把历史压进一个固定维度的隐藏状态,梯度沿时间步连乘,长依赖很容易被衰减掉;LSTM 用门控和细胞状态缓解了衰减,但第二个问题始终没解,h_t 依赖 h_{t-1},训练在时间维度上是串行的,序列一长就训不动。Transformer 用自注意力让任意两个位置的路径长度变成 O(1),全局可见;同时每个位置的表示可以一次算完,整个序列并行。再补一句代价:注意力是 O(n^2),长上下文的显存和计算开销成了新的瓶颈,所以后面才会有各种高效注意力、KV Cache 优化的工作。
Q3:BERT 和 GPT 有什么区别?为什么一个擅长分类,一个擅长生成?
A:总的说,它们共用同一套 Transformer 骨架,区别在方向和训练目标,而这两点决定了能力边界。分:BERT 是 encoder-only,双向看上下文,所以训练目标只能用掩码语言模型,挖掉一些词让模型填回来,这个信号天然适合”理解”,微调之后做分类、抽取很合适。GPT 是 decoder-only,每个位置只能看到左边,用自回归的方式预测下一个词,这正好就是生成任务本身,所以它能直接接着往下写。再补一层:因为 GPT 的预训练目标和解码过程完全一致,把它放大到 1750 亿之后出现了 In-Context Learning,不改参数、只给几个例子就能干活,这是 BERT 那条线没有的。我项目里的选择也印证这点:新闻分类十类标签,我用 BERT 微调拿到了最好的 F1;而换类别、临时加一类的场景,我会用 LLM 零样本,因为改提示词比重新训一版快得多。
Q4:你怎么看大模型的演进方向?
A:总的说,我认为已经从”单轴变大”变成了”四轴并行优化”。分四点:第一,训练侧 Scaling 依然有效,但重心从堆参数转向数据配比和数据质量,Chinchilla 那篇之后大家都在算”每个参数配多少 token”;第二,推理侧出现了测试时算力这条新轴,像 o1、DeepSeek-R1 这种模型先长出长思考链再给答案,用推理时间换准确率,在数学和代码上提升非常明显;第三,形态上从单模态走到多模态,再往 Agent 走,也就是课件小结说的”从感知走向认知和推理”;第四,成本侧会持续往蒸馏、量化、剪枝、小尺寸推理模型上走,因为能力再强,落不了地就没价值。我的判断:未来两三年”会不会调大模型”不再稀缺,”能不能把它做进成本、延迟、准确率都能接受的系统里”才是稀缺能力,这也是我项目最后专门做模型压缩的原因。
Q5:Scaling Law 是什么?它现在还成立吗?
A:总的说,它是”模型越大、loss 越低”这条经验规律的量化版本,loss 和参数量、数据量、算力各呈幂律关系,而且在好几个数量级内没看到饱和。分两点:第一,2020 年那版认为参数比数据更值得放大,2022 年 Chinchilla 修正了它,说给定算力预算,参数量和数据量应该同比例增长,经验上大约一个参数配二十个 token,当时的很多大模型其实是参数太大、数据不足、欠训练了。第二,要清楚它是统计趋势不是保证:数据质量差、去重没做好、训练不稳定,实际曲线会偏离预估。再补一句:所谓”涌现能力”里有一部分是度量假象,用离散的对错指标去衡量时,底下连续的 loss 下降会被切成一截截台阶,看起来像突然学会。所以我认为 Scaling 还成立,但已经从”堆参数”进化到”堆数据质量 + 堆推理时间”。
Q6:为什么说 2020 年 GPT-3 是个分水岭,而不只是”更大的 GPT-2″?
A:总的说,分水岭不在尺寸,而在范式:从”预训练 + 微调”变成了”预训练 + 提示”。分:GPT-1 和 BERT 时代的逻辑是,换个任务就换一批参数,微调是必须步骤;GPT-3 展示了 In-Context Learning 和指令遵循,把任务用自然语言描述、给几个例子,不改任何参数就能完成。这一下把”改模型”的问题变成了”写输入”的问题。对行业的影响:第一,模型变成了一种通用接口,Prompt Engineering 才有存在价值;第二,能力开始和参数量强绑定,谁有算力谁能拿到更强的基础模型;第三,也埋下了后面要解决的问题,不微调意味着知识和行为都靠输入控制,所以幻觉、知识过时、不稳定这些问题只能靠 RAG 和对齐去补。
Q7:ChatGPT 的 RLHF 做了什么?它解决了什么问题?
A:总的说,RLHF 不提供知识,它做的是对齐:让模型以更有用、更无害、更符合人类偏好的方式说话。分三步理解:第一步,预训练得到一个只会”接着往下写”的模型,你问它问题,它可能给你补一句类似的问题;第二步,用人类对多个候选回答的排序数据训一个奖励模型,学会”人更喜欢哪种回答”;第三步,用强化学习让模型去最大化这个奖励,于是模型开始真的”回答问题”。关键澄清:知识全部来自预训练语料,RLHF 改的是输出风格和遵循度,所以它不会消除幻觉、也不会让模型知道训练截止日期之后的事,要处理这两个问题得靠外部检索、RAG 和工具调用。这也是课件里 ChatGPT 被称为”iPhone 时刻”的原因:技术没变新,但交互方式变成人人可用了。
Q8:国产大模型现在到什么水平了?
A:总的说,已经进入全球第一梯队,而且路线各有特色。分:开源侧 Meta 的 Llama 系列把前沿权重公开出来,Mistral 在性能上对标闭源模型;国内阿里通义千问 2.5 和 3、深度求索的 DeepSeek-V3 与 DeepSeek-R1 都在第一梯队里占位,其中 R1 在数学和代码上表现尤其突出。有数据支撑:课件那张对比图上,AIME 2024 里 DeepSeek-R1 是 79.8、OpenAI-o1-1217 是 79.2,基本持平;而 DeepSeek-V3 只有 39.2,说明推理后训练带来的提升有多大。另一个我觉得更重要的点是同一张图上 R1-32B 这种小尺寸版本在 GPQA 上能拿到 62.1、Math-500 上 94.3,推理能力是可以被蒸馏到小模型里的,这对我们做私有化部署非常有意义,也是我项目里把蒸馏和量化放在最后一步的原因。
九、延伸阅读
论文(按本材料的知识顺序)
- Attention Is All You Need(Vaswani 等,2017),Transformer 原始论文,自注意力与多头注意力的定义来源。arXiv:1706.03762
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(Devlin 等,2018),MLM 与 encoder-only 结构。arXiv:1810.04805
- Language Models are Few-Shot Learners(Brown 等,2020),GPT-3,In-Context Learning 的系统性证明。arXiv:2005.14165
- Scaling Laws for Neural Language Models(Kaplan 等,2020),loss 与参数/数据/算力的幂律关系。arXiv:2001.08361
- Training Compute-Optimal Large Language Models(Hoffmann 等,2022),Chinchilla,参数量与数据量的最优配比。arXiv:2203.15556
- Training language models to follow instructions with human feedback(Ouyang 等,2022),InstructGPT,RLHF 三步流程。arXiv:2203.02155
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(DeepSeek-AI,2025),本材料最后那张榜单图的来源。arXiv:2501.12948
官方文档 / 技术报告
- OpenAI 官方博客与系统卡(GPT-4、GPT-4o、o1 系列的发布说明),注意 GPT-4 的技术报告明确不披露参数量,可作为”官方未公开”的引用依据。
- Meta AI 的 Llama 3 / Llama 3.1 发布博客与模型卡,开源权重与使用许可。
- Mistral AI 的 Mistral Large 2 发布说明。
- 通义千问(Qwen)与 DeepSeek 的官方发布页面与模型卡。
教程 / 可视化(用来补本材料没展开的机制)
- Jay Alammar《The Illustrated Transformer》与《The Illustrated BERT》,课件里那张 BERT 结构图就是这一类可视化风格,配合读能看清 Q/K/V、Add & Norm、12 层堆叠的细节。
- Andrej Karpathy 的 nanoGPT 与 “Let’s build GPT” 系列讲解,从零手写一个 decoder-only Transformer,把”预测下一个词”这件事落到代码。
- Bengio 等 2003 年 A Neural Probabilistic Language Model,神经网络语言模型与词向量的起点,想理解”为什么从查表转向向量”值得一读。
数据集 / 工具(与本材料相关的实践入口)
- ImageNet,AlexNet 夺冠的比赛数据集,理解 2012 年转折点的背景。
- Hugging Face Model Hub,Llama / Mistral / Qwen / DeepSeek 权重与模型卡的实际获取入口。