按结构是否被预先定义把数据切成三类(结构化 / 半结构化 / 非结构化),并给出每一类怎么读、怎么算、配什么算法,整条新闻分类流水线的第 0 步。
一、这份材料解决什么问题
任何 AI 项目的第一步都不是选模型,而是看看手里拿的是什么数据。同样一句”用户信息”,存成 MySQL 表、存成 JSON、还是散落在一份 PDF 合同里,后面要做的事完全不同:前者 SQL 就能算,中者要先写健壮的解析代码,后者必须先过 OCR 与版面还原才能进模型。
这份课件在新闻分类项目里对应数据准备与读取这一环,它决定三件事:
- 读数据的方式:
pd.read_csv()/ SQL 直接读,还是按结构定制化遍历嵌套,还是走”渲染 → 检测 → OCR → 还原”的重流水线; - 特征与算法选型:表格数据可以直接喂给 TF-IDF + 随机森林 / 树模型;自由文本要先分词、去停用词、向量化,再上 FastText / BERT / LLM;
- 评测与坑的位置:结构化数据关心字段缺失与类型,非结构化数据关心阅读顺序、噪声与歧义。
二、核心结论
- 判据不是”有没有格式”,而是”结构是否被预先定义(schema)”:结构化有固定列与类型;半结构化有标签但同类数据结构可以变;非结构化没有预定义模型。
- 非结构化 ≠ 没结构,而是只有隐式结构(文章的段落、视频的帧),计算机难以直接理解其语义,所以必须靠 NLP / CV 把隐式结构显式化。
- 读取难度递增:
pd.read_csv/SELECT→ 定制遍历 + 缺字段兜底 → PDF 解析流水线或多模态大模型。 - 现实世界数据大部分是非结构化的(邮件、报告、社交媒体帖子、照片、录音、录像),这就是 LLM 最大的价值区间。
- 同一个业务实体可以落在任意一类:用户做成 MySQL 表是结构化,做成 MongoDB 文档是半结构化,做成访谈录音就是非结构化。分类决定算法,而不是反过来。
三、知识地图
原材料是 3 页横向对照课件,整体权重为【了解】(认知框架,不含需要背的公式):
-
- 结构化数据
- 特点:有固定的列和数据类型,每行数据都必须遵循相同的结构
- 示例:员工表(Employee)的 ID / Name / Age / Dept
- 优势:易于存储、索引、查询(SQL);数据完整性强(主键、外键、约束);分析计算高效(聚合、连接)
- 典型应用:银行账户、ERP 系统、CRM 系统
- 读取示例:
pandas读 EXCEL/CSV;pymysql读 SQL 数据库 -
- 半结构化数据
- 特点:有标签或标记来区分语义,但同一类数据的结构可以不同(可以缺字段、加字段、嵌套)
- 示例:用户数据的 JSON 数组(张三有
contacts,李四没有但多了address) - 优势:灵活适应变化(无需事先定义所有字段);自描述;层级表达能力强(可表示树/图结构)
- 典型应用:Web API 数据交换、配置文件(JSON / YAML / XML)、NoSQL 数据库(MongoDB)
- 读取要点:根据结构自己定制化读取,处理嵌套层级与缺失字段
-
- 非结构化数据
- 特点:没有预定义的数据模型,内部可能有隐式结构,但计算机难以直接理解语义
- 示例:一篇纯文本文章
- 优势:人类自然理解和创作;蕴含丰富、细微的信息;大部分现实世界数据属于此类
- 典型应用:邮件、报告、社交媒体帖子、照片、录音、录像
-
- 把非结构化变可算的两条路线(同属课件第 3 页)
- 传统流水线:PDF → 转图片(渲染)→ 目标检测(识别区块)→ OCR(提取文字)→ 版面还原(拼接顺序)
- 工具对照:Marker / PDF-Extract-Kit / Unstructured.io / LayoutLMv3
- 多模态大模型路线:渲染成图 → 视觉编码器理解文字、图表、布局,本质是”内置了一个超强 OCR + 版面理解模型”
四、原理详解
4.1 结构化数据:schema 先行的世界
像 Excel 里一张规矩的表,每行是一个对象,每列是一个属性,而且列的含义和类型在数据进来之前就定死了。数据库的”表结构”就是这份契约。
类型已知,系统才能做三件非结构化数据做不到的事,索引(按列快速定位行)、约束(主键唯一、外键引用、非空、类型检查)、集合运算(聚合、连接、分组)。这三件事换来”数据完整性强 + 分析计算高效”。反过来说,这也是列就是特征、传统机器学习几乎不需要特征工程的原因。
课件给的就是一张员工表,
员工表(Employee)
+----+--------+------+---------+
| ID | Name   | Age  | Dept    |
+----+--------+------+---------+
| 1  | 张三   | 30   | 销售部  |
| 2  | 李四   | 25   | 技术部  |
+----+--------+------+---------+
算”技术部平均年龄”,一句 SELECT AVG(Age) FROM Employee WHERE Dept='技术部' 就够了,Age 是数值列可以直接算,Dept 可比较、可建索引。换成一篇散文”张三今年 30 岁,在销售部工作”,同样的聚合得先做 NER 抽实体才能算。
课件还给了两段读取示例,说明结构化数据的读取几乎是零成本的:
# 读取 EXCEL / CSV
import pandas as pd
df = pd.read_csv('部门数据数据.csv')   # 把文件读成表格对象
# 读取 SQL 数据库
import pymysql
conn = pymysql.connect(
host='localhost',
user='root',
password='123456',
database='test_db'
)
sql = "SELECT * FROM orders WHERE status = '技术部'"差别在于:CSV 是”文件即表”,一行 read_csv 拿到 DataFrame;SQL 是”连接 + 查询”,真正的活由数据库引擎干。
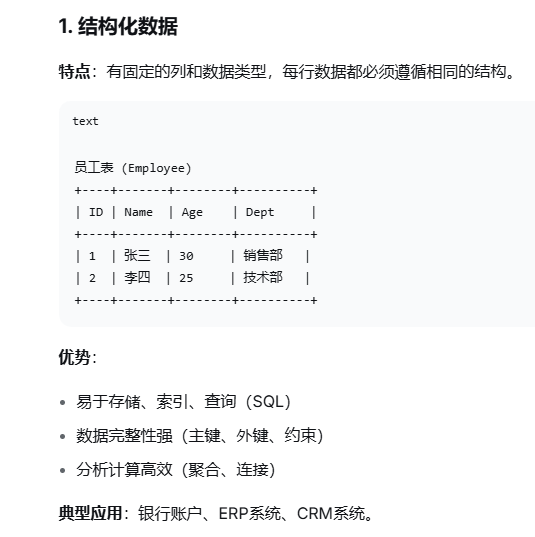
图注:课件第 1 页「1. 结构化数据」。特点一行写明”有固定的列和数据类型,每行数据都必须遵循相同的结构”;中间 text 代码块画的是 员工表(Employee),表头为 ID / Name / Age / Dept,两行数据分别是 1 张三 30 销售部 与 2 李四 25 技术部;下方”优势”列出三条(易于存储、索引、查询(SQL);数据完整性强(主键、外键、约束);分析计算高效(聚合、连接));页脚”典型应用”为银行账户、ERP 系统、CRM 系统。
4.2 半结构化数据:有标签,但没有固定契约
JSON 里的 "name"、"age" 是自描述的标签,所以机器知道每个值是什么;但同一批数据里,不同对象可以长得不一样。
它的”半”就在这儿,标签给语义,schema 不强制。于是天然支持缺字段、加字段、嵌套与树/图结构;代价是查询不能靠固定列,要靠解析器 + 路径 + 代码层兜底。
课件 JSON 数组里,张三有 contacts(email + phone),李四没有 contacts,却多了 address:
// 用户数据 - 允许灵活结构
[
  {
    "name": "张三",
    "age": 30,
    "contacts": {
      "email": "zhang@example.com",
      "phone": "12345678"
    }
  },
  {
    "name": "李四",
    "age": 25,
    // 注意:这个对象没有 contacts,但多了 address
    "address": "北京市朝阳区"
  }
]
后果很直接:读的时候不能写死字段。课件第 2 页点出”需要根据结构自己定制化读取”,并给出遍历要点:
# 半结构化数据的读取:结构要自己适配
for user in data:              # 逐个对象遍历
    n = get_depth(user)        # 获取嵌套数量(层级有多深)
    walk_each_level(user)      # 获取每一层内容
    # 如果没有某个字段 —— 必须兜底,否则 KeyError / None 会一路传到下游
    addr = user.get('address', '未知')
用一个数字体会差别:10 万条用户 JSON 里若有 8% 缺 contacts,直接 user['age'] 会在第几千条上崩;改成 user.get() + 显式默认值 + 统计缺失率,数据质量问题就从”线上事故”变成”可监控指标”。半结构化数据的核心工程动作是容错,不是解析。
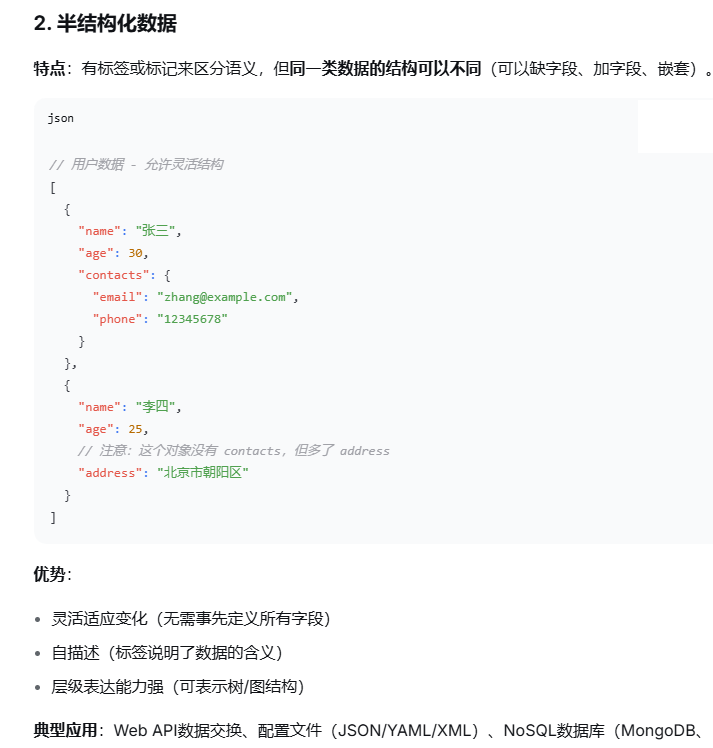
图注:课件第 2 页「2. 半结构化数据」。特点写明”有标签或标记来区分语义,但同一类数据的结构可以不同(可以缺字段、加字段、嵌套)”;json 代码块以注释 // 用户数据 - 允许灵活结构 开头,张三对象含嵌套的 contacts: {email, phone},李四对象带注释”注意:这个对象没有 contacts,但多了 address”,值为 "北京市朝阳区";”优势”三条为灵活适应变化、自描述、层级表达能力强(可表示树/图结构);页脚”典型应用”为 Web API 数据交换、配置文件(JSON/YAML/XML)、NoSQL 数据库(MongoDB)。
4.3 非结构化数据:隐式结构 + 语义鸿沟
一段文字、一张照片,人类一眼就懂,计算机拿到的只是一串字节。它不是没有结构,文章有段落、视频有帧,但这些结构是隐式的,没有 schema 替你标出来。
理解语义必须靠 NLP / CV 把隐式结构显式化(分词、实体、主题)。课件用”苹果”精准点出歧义:单独一个词”苹果”,无法确定是水果还是公司,解歧需要上下文,而上下文正是非结构化数据里最难抽的部分。这也是同样任务在这里的 F1 通常低于结构化数据、且更依赖标注质量的原因。
课件的 text 块就是一句话正文。要回答”主题 / 情感 / 实体关系”,必须先过一遍分词 → 去停用词 → 向量化 → 分类或序列标注。放到新闻分类项目的新闻标题上:苹果发布新一代芯片 里的”苹果”是公司,苹果价格上涨三成 里的”苹果”是水果,同一串字,两种标签。
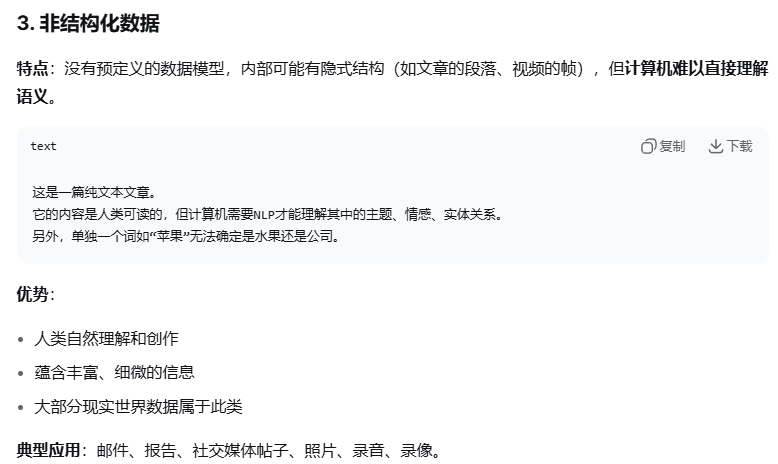
图注:课件第 3 页「3. 非结构化数据」。特点一行写明”没有预定义的数据模型,内部可能有隐式结构(如文章的段落、视频的帧),但计算机难以直接理解语义”;text 代码块里写:这是一篇纯文本文章,它的内容是人类可读的,但计算机需要 NLP 才能理解其中的主题、情感、实体关系;另外,单独一个词如”苹果”无法确定是水果还是公司;”优势”三条为人类自然理解和创作、蕴含丰富细微的信息、大部分现实世界数据属于此类;页脚”典型应用”为邮件、报告、社交媒体帖子、照片、录音、录像。
4.4 把非结构化变可算:两条技术路线
路线一:传统解析流水线(可控、便宜、工程化)
\text{PDF} \rightarrow \text{转图片(渲染)} \rightarrow \text{目标检测(识别区块)} \rightarrow \text{OCR(提取文字)} \rightarrow \text{版面还原(拼接顺序)}
最容易被低估的是最后一步版面还原:OCR 只回答”图上有哪些字”,不回答”该按什么顺序读”。双栏论文若按坐标从上到下硬拼,两栏句子会被缝在一起,所以要先检测标题、正文、表格、公式的区块,再按版面规则拼回阅读顺序。
路线二:多模态大模型(端到端、贵、省人力)
课件的描述是:模型先把 PDF 每页渲染成图片,再用视觉编码器理解图片里的文字、图表、布局;本质是内置了一个超强 OCR + 版面理解模型,只是内嵌进了大模型。它的输出形态课件讲得很实在,多模态最终还是用自然语言描述出复杂 PDF,或者指挥 OCR 去读取特定位置文字。
这就是一条该记住的判断:多模态大模型不是不需要 OCR,而是把 OCR 藏进了模型里。所以选型看成本 vs 结构精度:要严格保住表格行列、公式这类精细结构,显式流水线更稳、可调试;只求读懂大意并抽几个字段,丢给多模态模型更省人力。
课件附的工具对照表:
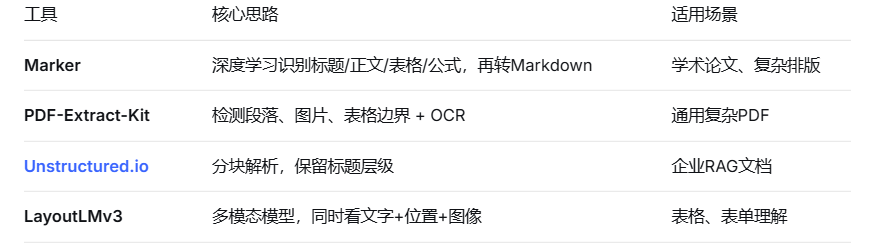
图注:课件第 3 页的工具选型表,表头为「工具 / 核心思路 / 适用场景」,共四行:Marker — 深度学习识别标题/正文/表格/公式,再转 Markdown,适用学术论文、复杂排版;PDF-Extract-Kit — 检测段落、图片、表格边界 + OCR,适用通用复杂 PDF;Unstructured.io — 分块解析,保留标题层级,适用企业 RAG 文档;LayoutLMv3 — 多模态模型,同时看文字 + 位置 + 图像,适用表格、表单理解。
五、易错点与常见误解
-
常见说法:”非结构化数据就是没有结构的数据。”
实际上,没有预定义的数据模型,但内部往往有隐式结构(段落、视频帧),只是计算机难以直接理解语义。
为什么:把”没有 schema”当成”没有规律”,会让人省掉版面还原这一步,直接上图。 -
有人以为”JSON 是结构化数据。”
其实 JSON 属于半结构化数据:有标签区分语义,但同类数据结构可以不同(缺字段、加字段、嵌套)。
原因在于,判据是”结构是否被强制统一”,不是”看起来像不像键值对”。 -
常听到的一种说法是:”CSV 文件一定是结构化数据。”
真实情况是,CSV 只是载体,真正的判据是内容。一整列若是自由文本(评论、标题),本质仍是非结构化内容装在表格壳里。
背后的道理是,这直接决定后续走TF-IDF + 随机森林还是 BERT,被后缀骗了,模型选型就会错。 -
容易想岔的地方:”OCR 出文字就算解析完 PDF 了。”
事实正相反,还差版面还原:把 OCR 结果按区块拼回正确阅读顺序。多栏/表格排版下按坐标硬拼会串行。 -
先说一个误解:”有了多模态大模型就不需要 OCR 了。”
实际上,它本质是内置了超强 OCR + 版面理解模型,输出仍可能是”用自然语言描述 PDF”或”指挥 OCR 去读特定位置”。
之所以如此,理解这点才能算清成本,也才知道何时该退回显式流水线。 -
常见说法:”数据越多越好,不用管类型。”
其实三类的指标含义和清洗动作都不同:结构化看缺失率与类型一致性,半结构化看字段覆盖率,非结构化看标注一致性、噪声与歧义。
六、横向对比与研究脉络
| 维度 | 结构化数据 | 半结构化数据 | 非结构化数据 |
|---|---|---|---|
| 结构契约 | 固定列 + 固定类型,schema 先行 | 有标签标记语义,但结构可变(缺字段/加字段/嵌套) | 无预定义模型,只有隐式结构 |
| 典型格式 | MySQL/PostgreSQL 表、CSV/Excel | JSON、XML、YAML、MongoDB 文档、日志 | 纯文本、PDF、图片、音频、视频 |
| 读取方式 | pd.read_csv()、SELECT ... WHERE,几乎零成本 |
按结构定制化遍历、逐层取内容、缺字段兜底 | 渲染 → 目标检测 → OCR → 版面还原;或多模态模型端到端 |
| 优势 | 存储/索引/查询简单,完整性约束强,聚合与连接高效 | 灵活适应变化、自描述、层级表达能力强 | 人类自然理解和创作、蕴含丰富细微信息、占现实数据大多数 |
| 主要难点 | schema 变更成本高、表达力受限 | 结构不一致、字段缺失、嵌套过深 | 语义鸿沟、歧义、阅读顺序、标注昂贵 |
| 适合的算法 | 树模型(随机森林/XGBoost)、逻辑回归、SVM | 解析展平后转结构化,再交给传统模型 | 文本:TF-IDF+LR/RF、FastText、BERT;文档/图像:检测 + OCR、LayoutLM 类模型、多模态大模型 |
| 典型应用 | 银行账户、ERP、CRM | Web API 交换、配置文件、NoSQL | 邮件、报告、社交媒体帖子、照片、录音、录像 |
演进关系(只写有把握的):
- 非结构化文本:人工规则/正则 → 统计特征(TF-IDF)→ 浅层网络(FastText 把词与 n-gram 向量平均后分类)→ 预训练 + 微调(BERT)→ 大模型零样本/少样本。每一代补上一代的短板:TF-IDF 泛化优于手写规则但不懂词序,FastText 快但语义浅,BERT 语义强但要标注与算力,LLM 把标注成本换成推理成本与可控性问题。
- 非结构化文档:从”纯 OCR”演进到”版面理解”,先检测区块、再提文字、才谈语义;LayoutLMv3 这类模型把文字、位置、图像三路一起看,正是为了补上”位置”这一课。
- 三类的边界并不固定:数据会从非结构化走向半结构化、再走向结构化(论文 → 带层级的 Markdown/JSON → 落库的字段),整条流水线说到底就是”结构化的过程”。
七、在新闻分类项目中的落地
项目数据是 标题\t标签,训练 18w / 测试 1w / 验证 1w,另有 749 个停用词给 TF-IDF 用。对上课件,有四条很具体的结论:
- “表格壳 + 非结构化内容”的典型形态:文件看似两列像结构化数据,但”标题”列是自由文本(课件易错点 3 的实战版),所以不能把列直接当特征,必须先分词、去停用词、向量化。
- 第一档 TF-IDF + 随机森林 = 把非结构化转成结构化:
TfidfVectorizer(stop_words=停用词).fit_transform()把每条标题变成维度固定、稀疏、数值型的矩阵,TF-IDF 就是”非结构化 → 结构化”的桥梁,之后随机森林才能当成表格处理。749 个停用词是这一步的清洗动作。 - 第二档 FastText 换的是数据格式,不是数据本身:同一份文本要转成
__label__标签名 文本的单行格式(train_supervised()/autotuneValidationFile/save_model(),test()返回(样本数, 精确率, 召回率))。__label__本质是一种标签标记,和 JSON 的"name"是同一种思路:用标记告诉机器这段内容的语义角色。 - 第三档 BERT / 第四档 LLM 面对同一批非结构化文本,差别在”要不要标注”:BERT 微调仍需要带标签训练集;LLM(DeepSeek API)零样本/少样本把标注成本换成提示词工程与推理成本。讲项目时这条对照线很加分,同一份非结构化数据,四档模型对应四种”结构化程度 / 成本”的取舍。
顺带,课件三种读取姿势在项目里都用得上:训练数据在文件里 → pd.read_csv 一行读进 DataFrame 再按 标题\t标签 切分;换成数据库/接口来源 → 照第 1 页用 pymysql 连库查询;换成爬来的 JSON → 照第 2 页定制遍历、缺字段兜底。
另外两类任务的落点(常被追问”除了分类你还做过什么”):
- 表格数据任务:特征本身就是结构化的(年龄、消费金额、活跃天数),第一选择是树模型(随机森林/XGBoost),列即特征、无需向量化、对量纲不敏感。这也是新闻分类项目第一档选随机森林的原因:它是结构化数据上的强基线。
- NER 任务:输入是非结构化文本,输出是每个 token 的标签(BIO),属于序列标注而非句子分类,可用 BERT + 序列标注头(可加 CRF)或 LLM 少样本抽取。课件”苹果 = 水果还是公司”就是 NER 的经典考点:没有上下文,实体类型不可判定。
八、重点问答
Q1:结构化、半结构化、非结构化怎么区分?CSV 算结构化吗?
A:我一般用”结构有没有被预先定义”这一条来切。结构化的列和类型固定、每行都得遵循同一套 schema,像数据库的表;半结构化有标签区分语义,但同类数据结构可以不同,能缺字段、加字段、嵌套,典型是 JSON 和 MongoDB 文档;非结构化没有预定义模型,内部只有隐式结构,比如文章段落、视频的帧,计算机不能直接理解语义。CSV 要看内容不能看后缀,像我做的新闻分类,文件虽然是”标题 + 标签”两列,但标题是自由文本,本质是非结构化内容装进了表格壳里,这个区别直接决定我后面走 TF-IDF 加随机森林还是上 BERT。
Q2:非结构化数据怎么变成模型能吃的输入?
A:分两条线。文本这块我用 TF-IDF 把每条标题变成固定维度、稀疏、数值型的矩阵,这一步本质就是把非结构化转成结构化,之后随机森林才能当表格处理;再往上就是 FastText 和 BERT,直接吃分词后的序列。文档这块,PDF 的解析链路是渲染成图片、目标检测切区块、OCR 提文字、最后版面还原拼阅读顺序,顺序这块最容易被漏掉,多栏排版按坐标硬拼是会串行的。
Q3:多模态大模型出来了,还要不要传统 OCR 流水线?
A:我的理解是多模态大模型不是不需要 OCR,而是把 OCR 藏进了模型里。它先把 PDF 每页渲染成图片,再用视觉编码器理解里面的文字、图表和布局,本质是内置了一个超强的 OCR 加版面理解模型;它的输出也常常是用自然语言去描述这份 PDF,或者反过来指挥 OCR 去读特定位置的文字。所以选型我会看成本和对结构精度的要求:要严格保住表格行列和公式这种精细结构,显式的解析流水线更稳、更好调;只是要读懂大意、抽几个字段,直接丢给多模态模型更省人力。
Q4:半结构化数据读取最容易踩什么坑?
A:最容易踩的是把字段写死。JSON 里同一类对象可以缺字段,比如我这份用户数据里张三有 contacts 嵌套,李四没有 contacts 但多了 address,直接取下标就会抛异常,而且往往跑了几万条才炸。所以我会按结构定制化遍历,逐层取内容、统计嵌套深度,缺失字段一律显式兜底,并把字段缺失率当成监控指标,让数据质量问题变成一个能观测的数字,而不是一个线上事故。
Q5:为什么新闻分类项目第一档模型选随机森林?
A:因为随机森林在结构化数据上是强基线。经过 TF-IDF 之后每条标题已经是一个数值型向量,对模型来说就是一行特征,随机森林不需要额外做特征缩放、对量纲不敏感、训练快,很适合作为第一档卡一个可对比的下限。后面换 FastText、BERT、LLM,是在同一份文本数据上逐级加语义表达能力,同时也在换成本结构,这样我能清楚说明每一档的提升到底来自哪里。
Q6:NER 和文本分类有什么区别?
A:输入都是非结构化文本,但输出粒度不一样。文本分类是给整段文本一个标签,比如把新闻标题分成 10 类;NER 是给每个 token 打标签,属于序列标注,通常用 BIO 标注体系,输出实体边界和类型。所以模型结构也不同,NER 一般用 BERT 加序列标注头,有时再加一层 CRF 约束标签转移。课件里”苹果”那个例子最能说明 NER 的难点:单独一个词没法判断是水果还是公司,必须靠上下文。
九、延伸阅读
数据集
– THUCNews(中文新闻文本分类数据集,与新闻分类项目的新闻分类任务同源)
– CLUE / TNEWS(中文短文本分类基准)
– MS MARCO、Natural Questions(检索 / RAG 场景的问答数据)
工具与文档
– pandas 官方文档(read_csv / read_json:结构化与半结构化读取)
– PyMySQL 文档(Python 连接 MySQL)
– MongoDB 文档(文档型数据库,半结构化数据的代表)
– JSON 规范 RFC 8259、YAML 官方规范(半结构化数据格式定义)
– Marker(datalab-to/marker,PDF → Markdown)
– PDF-Extract-Kit(opendatalab/PDF-Extract-Kit,版面检测 + OCR)
– Unstructured.io(分块解析、保留标题层级,常用于 RAG 文档预处理)
– LayoutLMv3(微软的文档理解多模态预训练模型,论文题为 Pre-training for Document AI with Unified Text and Image Masking)
论文方向(按主题检索即可,不必记编号)
– LayoutLM 系列:文档 AI 中文字 + 位置 + 图像的联合建模
– FastText:词与 n-gram 向量平均的快速文本分类
– BERT:预训练 + 微调的文本理解范式
– OCR 与版面分析综述:从文字识别走向版面还原