模型量化最底层的”单位换算表”,一个字节 8 位能表示 256 个数,而 float32 / float16 / int8 分别占 4 / 2 / 1 个字节。搞清这张表,才算真正理解”量化到底省了什么”。
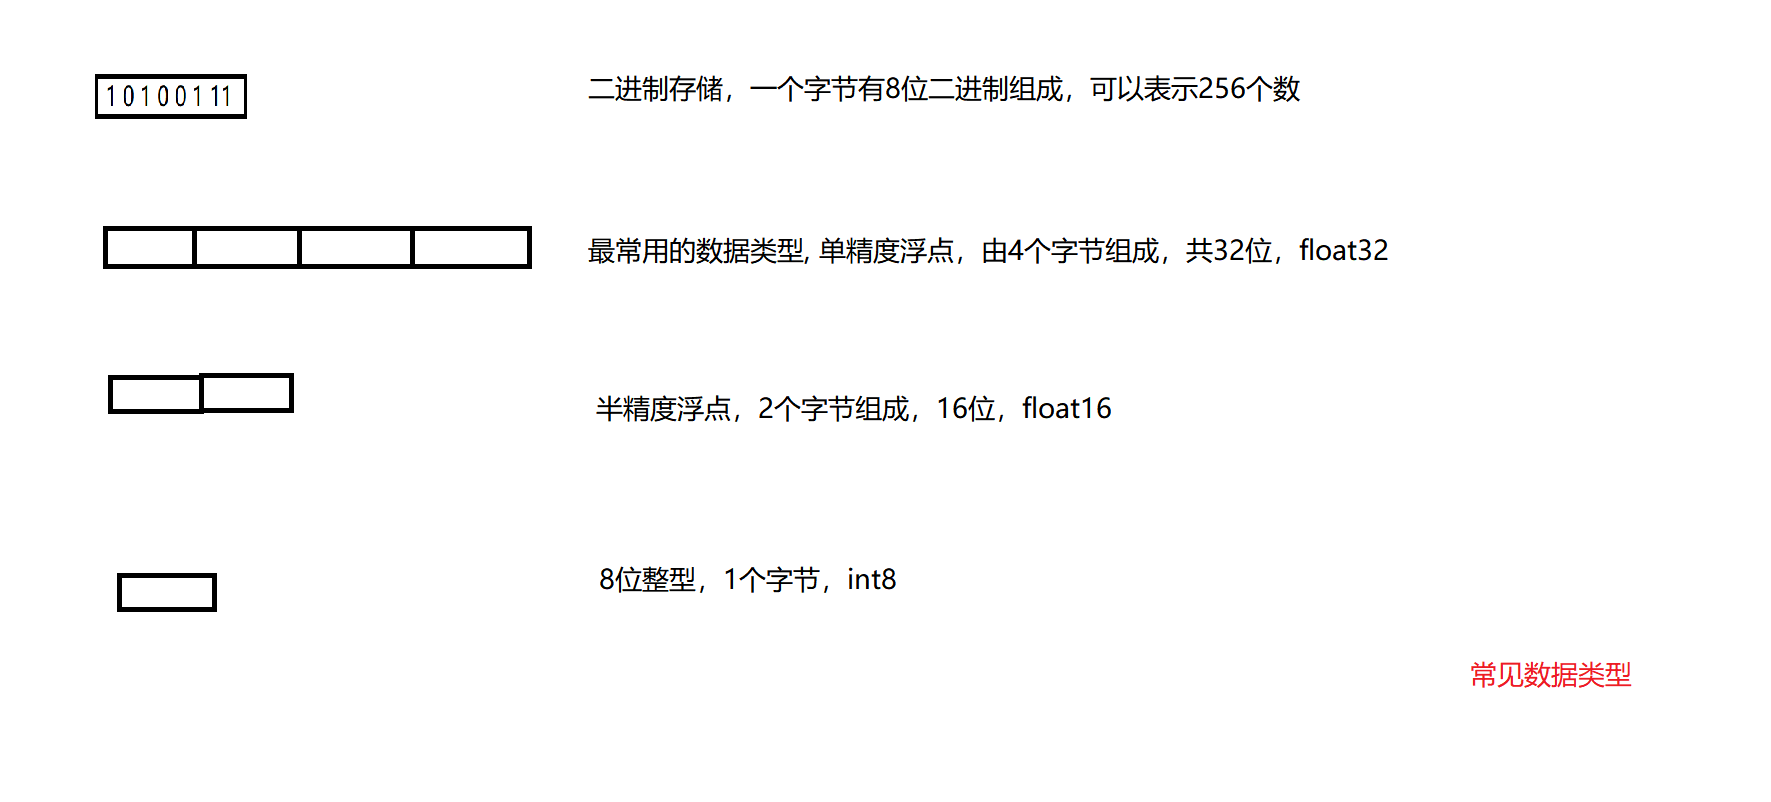
图注:原图左列是逐级变短的方块(8 格 → 4 格 → 2 格 → 1 格),代表不同数据类型占用的字节数;右侧文字依次是四条结论:10100111 一个字节 8 位二进制表示 256 个数;float32 单精度浮点 4 字节 32 位;float16 半精度浮点 2 字节 16 位;int8 8 位整型 1 字节。右下角标注”常见数据类型”。
一、这份材料解决什么问题
模型量化这门课里,所有”省了 4 倍显存””速度提升 2 倍”的说法,最后都要落回一件事:一个参数占几个字节。这张图就是要先把这个最底层的换算关系钉死,后面才谈得上:
- 为什么 float32 → int8 理论上省 4 倍空间;
- 为什么 int8 只能表示 256 个不同的值,于是必须引入
scale和zero_point做到实数域的映射; - 为什么 7B 参数的模型 fp32 要 28 GB、int8 只要 7 GB,这个数字就是部署可行性的分水岭。
它是新闻分类项目模型压缩章节的第一块砖。
二、核心结论
- 1 字节 = 8 位二进制,2^8 = 256,所以一个字节能编码 256 个不同取值,这是量化的粒度上限。
- float32 = 4 字节 = 32 位,是最常用的数据类型,也是绝大多数模型参数的默认存储格式。
- float16 = 2 字节 = 16 位,位宽减半;int8 = 8 位整型 = 1 字节,位宽是 float32 的 1/4。
- 空间占用与位宽严格成正比:参数数量相同的情况下,存储开销比就是位宽比(32:16:8 = 4:2:1)。
- 位宽降下来代价是表示范围与精度:int8 只有 256 个离散值,无法直接表示
0.1234这种小数,必须靠量化公式把实数区间线性映射到整数区间。
三、知识地图
| 图示 | 文字(原图) | 含义 | 位数 | 字节数 |
|---|---|---|---|---|
10100111(8 格小方块) |
二进制存储,一个字节有 8 位二进制组成,可以表示 256 个数 | 最小存储单位 | 8 | 1 |
| 4 格方块 | 最常用的数据类型,单精度浮点,由 4 个字节组成,共 32 位,float32 | 模型默认精度 | 32 | 4 |
| 2 格方块 | 半精度浮点,2 个字节组成,16 位,float16 | 混合精度训练常用的中间精度 | 16 | 2 |
| 1 格方块 | 8 位整型,1 个字节,int8 | 量化后的目标精度 | 8 | 1 |
| — | 常见数据类型 | 全图标题 | — | — |
层级关系:位 → 字节 → 数据类型。图里四个方块都是字节为单位画的格子,所以大方块 4 格 = 4 字节,小方块 1 格 = 1 字节。视觉上”方块变小”= 位宽变小 = 省空间。
四、原理详解
4.1 位与字节:量化的最小刻度
一个字节固定 8 个二进制位,每一位只有 0/1 两种状态,因此能编码 2^8 = 256 个不同模式。原图用 10100111 作例子,这 8 个位就是 8 个开关。
推而广之:
| 位宽 | 可表示的值个数 | 无符号范围 | 有符号范围(补码) |
|---|---|---|---|
| 8 位 | 2^8=256 | 0 ~ 255 | −128 ~ 127 |
| 16 位 | 2^{16}=65536 | 0 ~ 65535 | −32768 ~ 32767 |
| 32 位 | 2^{32}=4294967296 | 0 ~ 4294967295 | ≈ −2.15e9 ~ 2.15e9 |
256 个值与 43 亿个值之间的差别,正是”量化会掉精度”的根本原因。float32 之所以能表达 1e-38 到 1e38 这样宽的范围,是因为它不把这 32 位当整数用,而是拆分成了符号位(1) + 指数位(8) + 尾数位(23);int8 没有指数位,只能是 256 个等距的整数。
4.2 float32:为什么不”浪费”,为什么又要省
float32 = 1 位符号 + 8 位指数 + 23 位尾数。
- 符号位决定正负;
- 8 位指数给出约 2^{\pm127} 的动态范围;
- 23 位尾数给出约 2^{-23}\approx 1.2\times10^{-7} 的相对精度(约 7 位十进制有效数字)。
代价是:表示”很小的数”也占满 4 个字节。而神经网络权重绝大多数都是区间 [-0.1, 0.1] 内的小数,用 float32 存它们,等于用一把能称火车的秤去称药片。
4.3 float16 与 int8:两条不同的省法
| 数据类型 | 位数 | 字节 | 动态范围 | 精度 | 省空间倍数 | 典型用途 |
|---|---|---|---|---|---|---|
| float32 | 32 | 4 | ~10^{\pm38} | 7 位有效数字 | 1×(基准) | 训练、CPU 推理 |
| float16 | 16 | 2 | ~10^{\pm5} | 3~4 位有效数字 | 2× | 混合精度训练、GPU 推理 |
| bfloat16 | 16 | 2 | ~10^{\pm38} | 2~3 位有效数字 | 2× | 训练(范围同 fp32,尾数更短) |
| int8 | 8 | 1 | 整数区间 | 256 级离散 | 4× | 推理量化(PTQ/QAT/DQ) |
两条路线的本质区别:
– 浮点左右压位(fp32→fp16):保留”小数 + 指数”结构,直接砍位宽,实现极简单(改个 dtype 就行),但范围会变小,容易溢出/下溢。
– 浮点转整数(fp32→int8):放弃小数表示,改用线性映射,需要额外存 scale 和 zero_point,且必须做校准(calibration)以确定合适的映射区间,这就是 4.2 里量化三种方式(QAT/PTQ/DQ)的分工来源。
4.4 带数字的算账:一个 7B 模型到底多大
参数量按 7×10⁹ 计,字符集是参考值,实际部署还要加激活值和 KV Cache:
| 精度 | 单参字节 | 权重显存 | 相对 fp32 |
|---|---|---|---|
| float32 | 4 | 7\times10^9 \times 4 = 2.8\times10^{10} B ≈ 26.1 GiB | 1× |
| float16 | 2 | ≈ 13.0 GiB | 1/2 |
| int8 | 1 | ≈ 6.5 GiB | 1/4 |
| int4 | 0.5 | ≈ 3.3 GiB | 1/8 |
(注:7\times10^9 \times 4 = 28\,000\,000\,000 B,除以 1024^3 得 26.08 GiB。)
这张表就是部署的决策表:单张 24 GB 消费级显卡,fp32 直接装不下(26.1 GiB);fp16 勉强;int8 就很宽裕,还能留出空间给激活值和 KV Cache。对新闻分类项目里的 BERT(参数规模远小于 7B),量化的收益直接体现在 CPU 推理速度和 Flask 服务的单机吞吐上。
4.5 从位宽到量化公式:为什么必须有 scale 和 zero_point
int8 只有 256 个值,实数有无限多。要用前者表示后者,只能做仿射映射:
x_{q} = \mathrm{round}\!\left(\frac{x}{\text{scale}} + \text{zero\_point}\right),\qquad
x \approx \text{scale}\times(x_q – \text{zero\_point})
scale决定”一格整数代表多少实数”,也就是分辨率;zero_point是偏移,作用是把实数 0 精确映射到某个整数上,这很重要,因为 ReLU、padding 都会产生大量的 0,若 0 不能精确表示就会引入系统性偏差。
这两个参数怎么算出来,就是下一篇《手算量化 min-max》要做的练习。
五、易错点与常见误解
| 常见说法 | 正确说法 | 为什么 |
|---|---|---|
| 1 个字节能表示 256 个数,所以 int8 范围是 0~255,量化后就不能表示负数 | 可以有符号:int8 是 −128~127,也正好 256 个值 | “256 个数”是模式总数,不是取值范围 |
| float16 比 float32 省一半,所以精度也差一半 | 省的是存储和带宽;精度损失是非线性的,fp16 大约是 3~4 位有效数字 vs fp32 的 7 位 | 浮点精度由尾数位数决定,不是简单的倍数关系 |
| 量化就是把参数四舍五入到整数,不需要额外信息 | 必须额外保存每层(每通道/每块)的 scale 和 zero_point |
反量化靠它们把整数还原到实数域,这部分也有存储开销 |
| fp32 → int8 一定省 4 倍显存 | 权重部分省 4 倍;显存总量还要算激活值、KV Cache 和量化参数 | 大 batch 时激活值可能反而成为瓶颈 |
| float32 有 32 位,所以能精确表示任意 32 位小数 | 23 位尾数决定了它只有约 7 位十进制有效数字,0.1 本身就存不准 |
0.1 在二进制下是无限循环小数 |
六、横向对比与研究脉络
数值精度的取舍三角(省空间 / 保范围 / 保精度,三者不可兼得):
| 方案 | 空间 | 动态范围 | 精度 | 工程代价 |
|---|---|---|---|---|
| fp32 | 最大 | 最大 | 最高 | 无 |
| fp16 | 减半 | 小(易溢出) | 中 | 极低(改 dtype) |
| bfloat16 | 减半 | 大(同 fp32) | 低 | 极低 |
| int8 | 1/4 | 需映射 | 依赖校准 | 中(需 calibration / 量化算子支持) |
| int4 | 1/8 | 更窄 | 更低 | 高(对异常值敏感,常配 per-group 缩放) |
演进脉络:从”直接砍位宽”(fp16/bfloat16,只改 dtype,零算法成本)→ 到”线性映射 + 校准”(int8 PTQ,需要数据样本估区间)→ 到”训练时就模拟量化误差”(QAT,用伪量化算子让模型学会容忍)→ 到”per-channel / per-group 更细粒度的缩放”(把异常通道单独放缩,缓解离群值问题)→ 再到”混合精度”(关键层保 fp16,其余 int8)。每一步都在解决上一步遗留的精度损失问题,而所有讨论的计量单位都回到这张图:位与字节。
七、在新闻分类项目中的落地
- 模型保存格式选择(项目里紧接着讲的下一节):同一个 BERT 模型,保存成 fp32 是 4 份字节、fp16 是 2 份。项目部署用 Flask 单机扛请求,把权重存 fp16 是最零成本的一步优化。
- 量化前后的收益量化:项目要给出”压缩率”这个数字,而压缩率的算法就是本文的字节比,例如
模型体积(fp32) / 模型体积(int8),理论上接近 4,实测通常因为还有嵌入层、LayerNorm 未量化而略低(比如 3.5 倍)。知道理论值 4,才能判断实测值是否合理。 - 三大量化方式的定位(QAT 训练中 / PTQ 静态量化训练后 / DQ 动态量化训练后,
torch.quantization.quantize_dynamic()): - 动态量化(DQ):权重预先转 int8,激活值在运行时才量化,不需要校准数据,一行 API 就能跑,最适合 BERT 这种以 Linear/Embedding 为主的模型,也是项目里最该先试的。
- 静态量化(PTQ):需要一批校准数据提前统计激活值区间,精度通常比 DQ 更好,但要准备数据、改模型结构(插入观察点)。
- QAT:在训练循环里插入伪量化,精度最接近原模型,但要重训,项目里没有重训预算时直接排除。
- 被追问时的一句话总结:位宽是量化的计量单位,int8 的 256 级离散表示能力决定了必须用
scale+zero_point做仿射映射,而映射区间怎么定,就区分出了 QAT / PTQ / DQ 三条技术路线。
八、重点问答
Q1:一个字节能表示多少个数?int8 的范围是多少?
A:一个字节 8 位二进制,2^8 = 256,所以能表示 256 个不同的数。至于是什么范围,取决于怎么解释这 8 位:当无符号整数用是 0~255,当有符号补码用是 −128~127,两种解释都是 256 个值。量化里通常用有符号的 −128~127。
Q2:float32、float16、int8 分别占多少字节?量化到 int8 理论上省多少空间?
A:float32 占 4 字节 32 位,float16 占 2 字节 16 位,int8 占 1 字节 8 位。位宽比是 32:16:8,所以 fp32 到 int8 理论上省 4 倍空间、到 fp16 省 2 倍。一个 7B 参数的模型,fp32 权重约 26 GiB,fp16 约 13 GiB,int8 约 6.5 GiB,这直接决定能不能塞进一张消费级显卡。
Q3:float32 有 32 位,为什么存一个 0.1 都存不准?
A:因为 float32 不是整数,它拆成了 1 位符号、8 位指数、23 位尾数。23 位尾数只能提供约 7 位十进制有效数字,而 0.1 在二进制下是无限循环小数,必然被截断。指数位给的是范围,尾数位给的是精度,两者是两码事。
Q4:为什么量化必须有 scale 和 zero_point,而不是简单地把权重四舍五入?
A:因为 int8 只有 256 个离散值,而权重是连续小数,必须建立一对映射关系。scale 是缩放因子,决定一格整数代表多少实数;zero_point 是偏移,作用是把实数 0 映射到某个整数上。零必须精确表示,因为 ReLU 和 padding 会产生大量 0,如果 0 映射不准会引入系统性偏差。反量化时靠 x ≈ scale × (x_q − zero_point) 还原。
Q5:fp16 和 int8 都是”降精度”,本质区别是什么?
A:fp16 是浮点数位宽减半,保留了指数结构,所以只需要改 dtype,实现成本几乎为零,但动态范围缩小、容易溢出。int8 是浮点转整数,放弃了小数表示,改用仿射映射,需要额外存量化参数,还需要校准数据来确定映射区间,这个校准怎么做,就区分出了 PTQ 和 QAT 两条路线。
Q6:量化后显存一定省 4 倍吗?
A:不一定。省 4 倍只是权重部分的理论值。模型实际占用还包括激活值、KV Cache、以及每层的量化参数,而且嵌入层、LayerNorm 这类通常不量化。所以实测压缩率一般低于 4 倍,比如 3~3.5 倍。另外大 batch 推理时激活值可能成为新瓶颈,量化权重的收益会被稀释。
九、延伸阅读
- IEEE 754 浮点数标准(float32 / float16 / bfloat16 的位域划分)
- PyTorch 官方量化文档(
torch.quantization.quantize_dynamic与动态量化支持的层类型) - 本目录《【掌握】动态静态量化》研究报告,DQ / PTQ / QAT 三条路线
- 本目录《【掌握】手算量化 min-max》研究报告,scale 与 zero_point 的完整推导
- 本目录《【理解】真实部署流程》研究报告,模型保存格式与显存/吞吐的关系