NLP 系列 10 天课件的第一课,只干两件事,先把「NLP 要解决什么、怎么算真的解决了」讲成可验收的标准,再把文本 → 张量这条最底层的流水线(分词 → POS/NER → one-hot → word2vec → Embedding)亲手跑一遍,为后面 RNN / Attention / Transformer / BERT 提供全部前置概念。
一、这份材料解决什么问题
神经网络只会算数,不会读字。NLP 的全部工程量归根到底是一句话:把离散、变长、有歧义的语言符号,变成定长、稠密、可求导的数值矩阵。
这一课处在整条流水线的最上游。它刻意不碰任何模型结构(没有 RNN、没有 Attention、没有损失函数设计),只解决两个问题:
- 把句子切成 token,中文尤其难,因为中文没有词边界;
- 把 token 变成向量,one-hot → word2vec → Embedding 三种表示法逐级演进。
在 10 天课件中的坐标:day01 定概念、定表示法;day02 补数据侧(语料分析、n-gram 特征、长度规范、回译增强);day03 才第一次出现模型(RNN 及其变体);day05-07 Transformer;day11-12 预训练模型与迁移学习。所以这一课学完的能力边界是:”拿到一个中文文本任务,我知道输入应该长什么样”,还不涉及怎么训模型。
在新闻分类项目里的位置:项目的四个模型(TF-IDF+随机森林 → FastText → BERT 微调 → LLM 零样本)没有一个能绕开这一课,因为每个模型的第一行代码都要回答同一个问题,中文标题怎么变成特征。
| 模型 | 它对本课的依赖 |
|---|---|
| TF-IDF + 随机森林 | 必须先分词才能统计词频;词表 + 749 个停用词完全建立在本课的「分词 + 词表」概念上 |
| FastText | 输入是 token 序列(__label__标签 文本),并且用本课的「静态词向量 / subword」思想解决 OOV |
| BERT 微调 | subword 切分 + Embedding 查表 + 序列标注式的分类头,全部是本课概念的放大版 |
| LLM(零样本/少样本) | 不用自己建词表,但「任务类型怎么描述」直接复用本课的应用场景/任务分类框架 |
另一个容易被忽略的点:本课 1.1 节给出的 9 条「什么算理解」维度,是后面所有评估讨论的总纲,包括 LLM 阶段的验收标准。
二、核心结论
- 「说得像人」不等于「理解」。原材料给出的判据是:能在语言变化下,稳定、可泛化、可解释地完成语义任务,并拆成 9 个可验收维度(任务能力 / 语境与常识 / 语义一致性 / 组合与泛化 / 可解释性 / 稳健性 / 对话能力 / 事实与校准 / 跨模态执行)。它既是 NLP 的定义边界,也是被追问时「大模型还差什么」的标准答题框架。
- 中文 NLP 的第一道坎是分词。中文「字、句、段有分界符,但词没有」,分词就是找词的边界;词是语义理解的最小单元,分词质量决定了 POS/NER/分类/检索的上限。jieba 的三种模式本质只是粒度不同,不是「哪个更准」。
- 文本张量表示的演进主线,就是修 one-hot 的两个洞:维度等于词表大小(大语料下内存爆炸)、任意两个词向量正交(内积恒为 0,语义完全割裂)。word2vec 和 Embedding 层分别用「预训练后冻结」和「端到端一起学」两种方式补这两个洞。
- word2vec(静态)vs Embedding 层(动态)是本课最值得背的一组对比:word2vec 先在大语料上无监督训练好词向量,作为固定特征输入下游任务;Embedding 层不提前训练,在下游任务训练过程中与整个神经网络一起端到端学习。二者最终都是同一形状的参数矩阵 V\times d。
- CBOW 与 skip-gram 互为镜像,并且有明确的资源权衡:CBOW 用上下文预测中心词(快、低频词弱),skip-gram 用中心词预测上下文(慢、低频词友好)。本课实跑数据:同一份语料、
dim=100、epoch=10下,CBOW 训练 113.2 秒、skip-gram 训练 184.0 秒,慢约 1.6 倍。
三、知识地图
权重说明:原材料(课件网页)本身没有标注【掌握】/【理解】/【了解】。下表的权重是我按展开深度推断的,有可运行代码 + 真实输出 + API 名的判【掌握】,有机制说明但无代码的判【理解】,只有名称或一句话的判【了解】,便于分配复习时间。
day01_自然语言处理入门
├── 1 自然语言处理入门
│   ├── 1.1 什么是自然语言处理 ...................... 【掌握】定义 + 「9 维理解标准」表
│   ├── 1.2 自然语言处理的发展简史 .................. 【了解】原材料只有标题、无正文(见本报告 4.3 补全)
│   ├── 1.3 自然语言处理的应用场景 .................. 【了解】语音助手 / 机器翻译 / 搜索引擎 / 智能问答
│   └── 1.4 机器翻译 ................................ 【了解】CCTV 案例(课件内嵌视频,无文字知识点)
├── 2 认识文本预处理
│   ├── 2.2 文本预处理及其作用 ...................... 【理解】"转为张量 + 规范尺寸",并指导超参选择
│   ├── 2.3 文本预处理的主要内容(5 类) ............. 【理解】见 4.4 表
│   └── 2.4 说明:只覆盖中文与英文 ................... 【了解】
├── 3 文本处理的基本方法
│   ├── 3.1 分词 ....................... 【掌握】定义 / 中英差异 / jieba 三模式 + 繁体 + 自定义词典
│   ├── 3.2 演示 jieba 分词(demo01~05)..... 【掌握】三种模式 + 繁体 + 自定义词典,附真实输出
│   ├── 3.3 词性标注 POS ................ 【掌握】定义 + 例子(我/rr, 爱/v, 自然语言/n, 处理/vn)
│   ├── 3.4 命名实体识别 NER ............ 【掌握】定义 + 4 个业务场景表(新闻/医疗/电商/金融)
│   ├── 3.5 演示 POS 与 NER ............. 【掌握】jieba.posseg.lcut + "词性表映射实体"的简化 NER
│   └── 3.6 小结 ........................ 【理解】
├── 4 文本张量表示方法
│   ├── 4.1 文本张量表示 ............................ 【掌握】词向量 → 按序组成矩阵
│   ├── 4.2 one-hot 词向量表示 ...................... 【掌握】创建/使用/保存词表 vocab.json
│   ├── 4.3 word2vec 静态预训练词向量 ................ 【掌握】CBOW / skip-gram / 前向传播 / 查表 / fasttext 实跑
│   ├── 4.4 Embedding 层 动态词向量 ................. 【掌握】nn.Embedding + TensorBoard 可视化
│   └── 4.5 小结 .................................... 【理解】
├── 5 扩展 - 新建虚拟环境 ........................... 【了解】conda 建/进/退/删 + PyTorch 与 GPU 自检
├── 6 常见高频题(8 题) ............................. 【掌握】分词/三模式/POS-NER/one-hot/词向量/张量方法/CBOW-skip-gram/FastText
└── 7 代码作业 ...................................... 【掌握】分词 → 按词频建词表 → 逐词打印 one-hot
四、原理详解
4.1 什么是 NLP:把「理解」拆成 9 个可验收的维度
自然语言处理(NLP)是让计算机理解、生成并与人类语言交互的技术。但「理解」这个词太容易糊过去,原材料给了一个很硬的判据:
不是「说得像人」就算理解,而是能在语言变化下,稳定、可泛化、可解释地完成语义任务。
然后把它拆成 9 个维度,这张表几乎是「LLM 现在还不能做什么」的官方清单:
| 维度 | 含义 | 举例 |
|---|---|---|
| 任务能力 | 完成问答、翻译、摘要等任务 | 多类任务上稳定高分 |
| 语境与常识 | 理解隐含信息 | 正确处理指代、否定、歧义 |
| 语义一致性 | 换种说法结论不变 | 改写、反问后答案一致 |
| 组合与泛化 | 应对未见过的表达 | 新组合也能正确理解 |
| 可解释性 | 能给出推理依据 | 指出证据句段或推理路径 |
| 稳健性 | 抗噪声干扰 | 有错别字仍能正确理解 |
| 对话能力 | 多轮上下文跟踪 | 记住历史、能纠错澄清 |
| 事实与校准 | 减少「幻觉」 | 不确定时能说「不知道」 |
| 跨模态执行 | 语言驱动行动 | 结合图像/环境完成指令 |
这张表的正确用法有两个:被追问时用它作为「你怎么评估一个 LLM 应用好不好」的框架(比只说准确率高一档);读论文时用它定位一篇工作到底解决了哪一格。注意最后三格(事实与校准、跨模态、对话能力)在 day01 这一课里就已经点出来了,说明课程设计上把「NLP 的困难」当作定义的一部分,而不是附录。
图注:这是本章的封面配图,不是技术图,木纹背景上摆着三块立体方块,分别拼出蓝、红、橙三色的字母 N、L、P,画面里没有其他文字或标注。它只起到「本章讲 NLP」的定位作用。
4.2 应用场景与五大任务类型
原材料 1.3 节只列了 4 个场景(语音助手、机器翻译、搜索引擎、智能问答)加一个省略号,1.4 节用一段 CCTV 机器翻译系统的视频当例子。这些是「产品视角」。要能在被追问时说清楚,需要把场景翻译成任务类型:
| 任务类型 | 输入 → 输出 | 代表任务 | 原材料里对应的痕迹 |
|---|---|---|---|
| 分类 | 文本 → 单个类别 | 情感分析、新闻分类、意图识别 | SnowNLP「支持情感分析、文本分类」;新闻分类项目 10 分类 |
| 序列标注 | 序列 → 等长标签序列 | 分词、词性标注、命名实体识别 | 3.1 / 3.3 / 3.4 三节全是这一类 |
| 生成 | 文本 → 文本 | 机器翻译、摘要、对话生成 | 1.4 机器翻译(CCTV 案例) |
| 匹配 | 两个文本 → 相似度 / 是否相关 | 检索召回、FAQ 问答、去重 | 「搜索引擎模式…提高召回率」;TensorBoard 近邻词检索 |
| 问答 | 问题(+ 文档)→ 答案 | 抽取式 QA、生成式 QA、RAG | 1.3「智能问答」 |
一句话把五类串起来:五类里只有「分类」是全句一个标签,其余四类都要处理 token 级对齐、顺序或者生成。这就是为什么分词和 POS/NER 是本课的重点,它们不是「预备知识」,而是序列标注任务的样板本身。
对照新闻分类项目:这个项目恰好只做第一类(10 类新闻标题分类),所以它对分词/序列标注的需求是「够用就行」;但评审者常会顺着问「NER 你做过吗」,答案就落在本课第 3.4 节那张业务场景表上。
4.3 发展简史:规则 → 统计 → 深度学习 → 预训练
先说事实纪律:原材料 1.2 节只有标题、没有正文(抽取稿里这一节是空的)。下面按通识补全,只写公认的节点,不写没把握的年份、作者和数字。
| 阶段 | 大致时间 | 核心思想 | 代表方法 | 促使它被换代的问题 |
|---|---|---|---|---|
| 规则时代 | 1950s–1980s | 语言学家写语法规则、维护词典 | 早期机器翻译尝试、模板式对话(ELIZA)、Chomsky 的句法理论 | 规则写不完,覆盖不了真实语言;评测表现差导致机器翻译一度被冷落 |
| 统计时代 | 1990s–2010s | 不写规则,从语料里数概率 | n-gram 语言模型、HMM/CRF 序列标注、统计机器翻译、TF-IDF 检索 | 特征靠人工设计、数据稀疏、长距离依赖建模差 |
| 深度学习时代 | 2013–2017 | 用神经网络自动学特征与表示 | word2vec(本课 4.3 节的原型)、RNN/LSTM、seq2seq + Attention、FastText | 每个任务都要从零训练,标注数据永远不够 |
| 预训练时代 | 2018– 至今 | 先在大规模无标注语料上预训练,再微调或提示 | ELMo / GPT / BERT(2018)、GPT-3(2020)、ChatGPT(2022) | ,尚未解决:常识、事实校准、可解释性、稳健性(正好是 4.1 表里最难的那几格) |
演进主线一句话:每一次换代都在减少「人工投入」,增加「从数据里学到的表示」。规则 → 统计,减少人工规则;统计 → 深度学习,减少人工特征;深度学习 → 预训练,减少对标注数据的依赖。
这条线在本课内部同样成立,而且更有意思:one-hot(维度由人定)→ word2vec(表示从语料学)→ Embedding 层(表示从任务学),和整个 NLP 史是同一个方向的三次压缩。
4.4 文本预处理全景:一张表定边界
原材料 2.3 节用一张表把「文本进模型之前要做的事」分成五类,这是本课最实用的导航图:
| 类别 | 包含内容 | 解决什么约束 | 本课 / day02 分工 |
|---|---|---|---|
| 文本处理基本方法 | 分词、词性标注 POS、命名实体识别 NER | 文本 → 结构化最小单元 | 本课第 3 章 |
| 文本张量表示 | one-hot 编码、Word2vec、Embedding 层 | 符号 → 数值,长度可控 | 本课第 4 章 |
| 语料数据分析 | 标签分布、句子长度分布、词频统计与词云 | 数据不平衡 → 决定权重与阈值 | day02 |
| 文本特征处理 | n-gram 特征、文本长度规范 | 变长输入 → 定长张量 | day02 |
| 数据增强 | 回译数据增强法 | 标注数据不足 | day02 |
原材料还强调了一句容易被忽略的话:「合理的文本预处理可以指导模型超参数的选择,提升模型效果。」 它的意思是,句子长度分布决定 max_len 与截断策略,标签分布决定要不要加权采样,词频分布决定词表要截到多少。这些都是「先看数据、再定超参」,而不是先调参再看数据。
4.5 分词:为什么必须切,怎么切
英文用空格当天然分界符;中文的「字、句、段」都有分界符,唯独词没有,所以分词就是找到词的边界。词是语义理解的最小单元,分词是自动问答、机器翻译、文本生成等一切高阶任务的基础环节。
带数字的小例子(本课真实输出):同一句话
传智教育是一家上市公司,旗下有黑马程序员品牌。我是在黑马这里学习人工智能三种模式的真实分词结果:
# 精确模式(jieba.lcut(text, cut_all=False))→ 19 个 token
['传智','教育','是','一家','上市公司',',','旗下','有','黑马','程序员','品牌','。','我','是','在','黑马','这里','学习','人工智能']

# 全模式(jieba.lcut(text, cut_all=True))→ 25 个 token
['传','智','教育','是','一家','上市','上市公司','公司',',','旗下','下有','黑马','程序','程序员','品牌','。','我','是','在','黑马','这里','学习','人工','人工智能','智能']

# 搜索引擎模式(jieba.lcut_for_search(text))→ 24 个 token
['传智','教育','是','一家','上市','公司','上市公司',',','旗下','有','黑马','程序','程序员','品牌','。','我','是','在','黑马','这里','学习','人工','智能','人工智能']
同一句话切出 19 / 25 / 24 个 token,下游的词表、TF-IDF 维度、序列长度全部跟着变。注意全模式的两个特征行为:它把「传智」拆成了「传」+「智」,还切出了「旗下」和「下有」两个词(后者其实不是词),这就是原材料说的「速度快,不能消除歧义」。
自定义词典的效果(demo05 的真实输出):加载用户词典后同一句话变成
['传智教育','是','一家','上市公司',',','旗下','有','黑马程序员','品牌','。','我','是','在','黑马','这里','学习','人工智能']长词「传智教育」「黑马程序员」被封成一个 token。原材料特意写了机制:词典只按 token 合并,不按 token 拆分,所以自定义词典是「保长词」,不是「改粒度」。
搜索引擎模式到底在干什么(课件的注释给了两个很具体的场景):
- 场景 1:用户输入「程序员」。精确模式只能匹配包含完整「程序员」的文档;搜索引擎模式把「程序员」再切成「程序员/程序/员」,于是「程序」的文档也能命中 → 提高召回率。
- 场景 2(电商搜索):商品标题「小米手机保护壳」。精确模式切成(小米/手机/保护壳),用户搜「小米壳」切成(小米/壳),匹配不上;搜索引擎模式切成(小米/手机/保护/壳),就能匹配上了。
API 记忆点(课件明确标了「需要掌握:精确模式」):
| 模式 | API | 适用 |
|---|---|---|
| 精确模式 | jieba.lcut(text, cut_all=False) |
文本分析、词性标注、信息提取 |
| 全模式 | jieba.lcut(text, cut_all=True) |
关键词提取 |
| 搜索引擎模式 | jieba.lcut_for_search(text) |
搜索引擎、文本匹配 |
| 中文繁体分词 | 同精确模式,输入繁体文本 | 中国香港、台湾地区文本 |
| 自定义词典 | jieba.load_userdict(path),格式 词语 词频 词性(后两项可省) |
生僻词 / 专业术语 |
课件还列了 5 个常见中文分词工具用于横向比较:jieba(Python 最常用,三模式 + 繁体 + 自定义词典)、IK(Java,ElasticSearch 专用)、SnowNLP(基于概率算法,另支持情感分析、文本分类)、pyltp(哈工大)、THULAC(清华,支持分词 + 词性标注)。
4.6 词性标注与命名实体识别:序列标注的最小样板
词性标注(POS):标注一段文本中每个 token 的词性;词性是「以语法特征为主要依据」对词的分类,常见词性有 14 种(名词、动词、形容词等)。课件给的例子:
我爱自然语言处理          ==>    我/rr, 爱/v, 自然语言/n, 处理/vn
(rr 人称代词、v 动词、n 名词、vn 动名词)
真实跑出来的 POS 输出更能说明它的问题(demo 用的是长句):
# 文本:我爱深圳创维创新谷5层506教师的可爱的小伙伴,尤其是欢快的‘胡欢’同学
我:r  爱:v  深圳:ns  创维:n  创新:v  谷:nr  5:m  层:q  506:m  教师:n  的:uj
可爱:v  的:uj  小伙伴:n  ,:x  尤其:d  是:v  欢快:a  的:uj  ‘:x  胡欢:nr  ’:x  同学:n
命名实体识别(NER):识别文本中的人名、地名、机构名等专有名词。课件给的例子:
鲁迅, 浙江绍兴人, 五四新文化运动的重要参与者, 代表作朝花夕拾.
==> 鲁迅(人名) / 浙江绍兴(地名)人 / 五四新文化运动(专有名词) / 重要参与者 / 代表作 / 朝花夕拾(专有名词)
课件还用一张表把 NER 的业务价值讲透了,这是本课最像产品文档的一页:
| 场景 | 输入文本 | NER 提取结果 | 应用价值 |
|---|---|---|---|
| 新闻人物与地点 | 「马斯克表示,特斯拉在上海的工厂进展顺利。」 | 马斯克(人物) 特斯拉(组织) 上海(地点) | 快速生成新闻摘要、知识图谱 |
| 医疗记录 | 「患者头痛,服用布洛芬后缓解。」 | 头痛(症状) 布洛芬(药物) | 结构化病历,辅助诊断与用药分析 |
| 电商评论 | 「这款手机的电池续航太短,但摄像头很棒。」 | 手机(产品) 电池(部件) 摄像头(部件) | 精准定位产品优缺点 |
| 金融监控 | 「报道称腾讯股价因新政策下跌。」 | 腾讯(组织) | 关联风险名单,触发舆情监控 |
课件的 NER 实现思路(很值得记住,因为它是「玩具版」的标准写法):先 jieba.posseg.lcut() 得到 (token, flag),再用一个词性→实体类型的字典映射:
flag_to_entity = {"nr": "PERSON", "ns": "LOCATION", "nt": "ORGANIZATION",
                  "nz": "OTHER",  "t": "TIME",     "m": "NUMBER"}
对上面那句文本,真实输出是:
[('深圳','LOCATION'), ('谷','PERSON'), ('5','NUMBER'), ('506','NUMBER'), ('胡欢','PERSON')]这张输出必须会解读:「创新谷」被切成了「创新/谷」,而「谷」在 jieba 里被标成了 nr(人名),于是误报成 PERSON;数字 5、506 被当成命名实体也很别扭。课件自己也标注了「这是一个简化的 NER 思路」。真实的工业 NER 是序列标注任务(BIO/BIOES 标注 + CRF,或 BERT + 分类头逐 token 打标),靠的是上下文和标注数据,而不是一张词性对照表。知道这条边界,被追问时就不会把「查词性表」说成 NER 的做法。
4.7 one-hot 编码:最简单也最贵的表示
把每个词表示成 n 维向量,只有 1 个位置是 1,其余全 0;不同词为 1 的位置不同。其中 n 的大小是整个语料中不同词的总数(词表大小),这是最容易被记错的一个点。
带数字的小例子(真实输出),词表只有 7 个歌手名:
vocab = {'张信哲':0,'周杰伦':1,'胡欢':2,'王力宏':3,'鹿晗':4,'李宗盛':5,'陈奕迅':6}
张信哲: tensor([1., 0., 0., 0., 0., 0., 0.])
周杰伦: tensor([0., 1., 0., 0., 0., 0., 0.])
...
课件顺手做了工程上正确的一件事:把词表 json.dump 存成 ./model/vocab.json,用的时候再 json.load 回来,保证训练与推理用同一份词表(这一步在项目里就是「词表对齐」的雏形)。
为什么必须换掉它,两个洞,都要算得出数字:
- 维度 = 词表大小。新闻分类项目场景下假设词表 20 万、标题平均 20 个词,单条样本的 one-hot 矩阵形状是 (20, 200000),float32 下占
20 \times 200000 \times 4 \text{ B} = 16{,}000{,}000 \text{ B} \approx 15.3 \text{ MB}
一条样本 15 MB,1.8 万条一批根本放不进内存。这就是原材料说的「大语料库时,会占用巨大内存空间」的具体账。
- 正交性。任意两个不同词的 one-hot 向量内积恒为 0:\mathbf{o}_i^\top \mathbf{o}_j = 0 \ (i \neq j)。也就是说「陈奕迅」和「周杰伦」在向量空间里的距离和「陈奕迅」和「苹果」一样远,模型学不到任何词的相似性,原材料写的「无法表示语义信息」。
唯一但重要的优势:简单,而且可以当索引用。这一点在下一节会变成关键,
\mathbf{e}_w = \mathbf{W}^{\top} \mathbf{o}_w, \quad \mathbf{W} \in \mathbb{R}^{V \times d}
因为 \mathbf{o}_w 里只有一个 1,这个矩阵乘法等价于直接取 \mathbf{W} 的第 \mathrm{index}(w) 行。所以 Embedding 层在实现上就是一次查表(lookup),这也是它能省掉 15 MB 那条账的原因。
4.8 word2vec:静态预训练词向量
核心思想:先在大规模无标注语料上预训练词向量,再把它作为固定特征输入到下游任务模型里。训练是无监督的,靠一个浅层神经网络学表示,其嵌入层参数矩阵 E(V, d) 就是词向量矩阵,词向量就是这个网络的副产品。
两种训练模式:
- CBOW(Continuous Bag of Words,连续词袋):用上下文预测中心词;
- Skip-gram(跳元模型):用中心词预测上下文。
课件给了两张窗口示意图,配上「窗口大小为 9、用前后 4 个词预测中间词」的说明,是本课最直观的两张图:
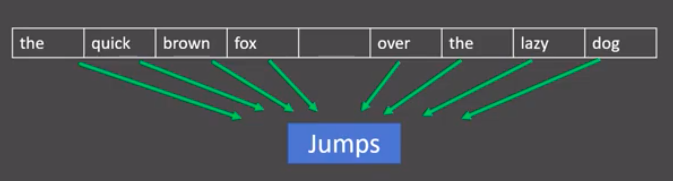
图注:画面上是一行 9 个单词框,依次是 the / quick / brown / fox / (中间空框) / over / the / lazy / dog;中间那个词的位置是空的,取而代之的是下方独立的一个蓝色框「Jumps」,从左边 4 个框和右边 4 个框各引出绿色箭头共同指向「Jumps」,即「用前后 4 个上下文词预测中间词」,对应窗口大小 9。CBOW 的名字(词袋)就体现在这种「把上下文当一个无序集合求和/求均值」的做法上。
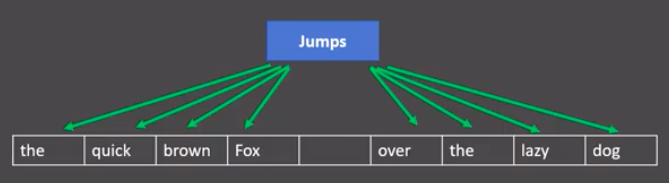
图注:这张是 CBOW 那张图的镜像。上方一个蓝色框「Jumps」,从它引出多支绿色箭头向下散开指向下面那一行 9 个词框(the / quick / brown / fox / 空 / over / the / lazy / dog),即「用中心词预测前后 4 个上下文词」。两张图并排看,就是把「两边推中间」和「中间推两边」的差别一眼看清。
CBOW 的前向传播(课件原图 + 形状推演):
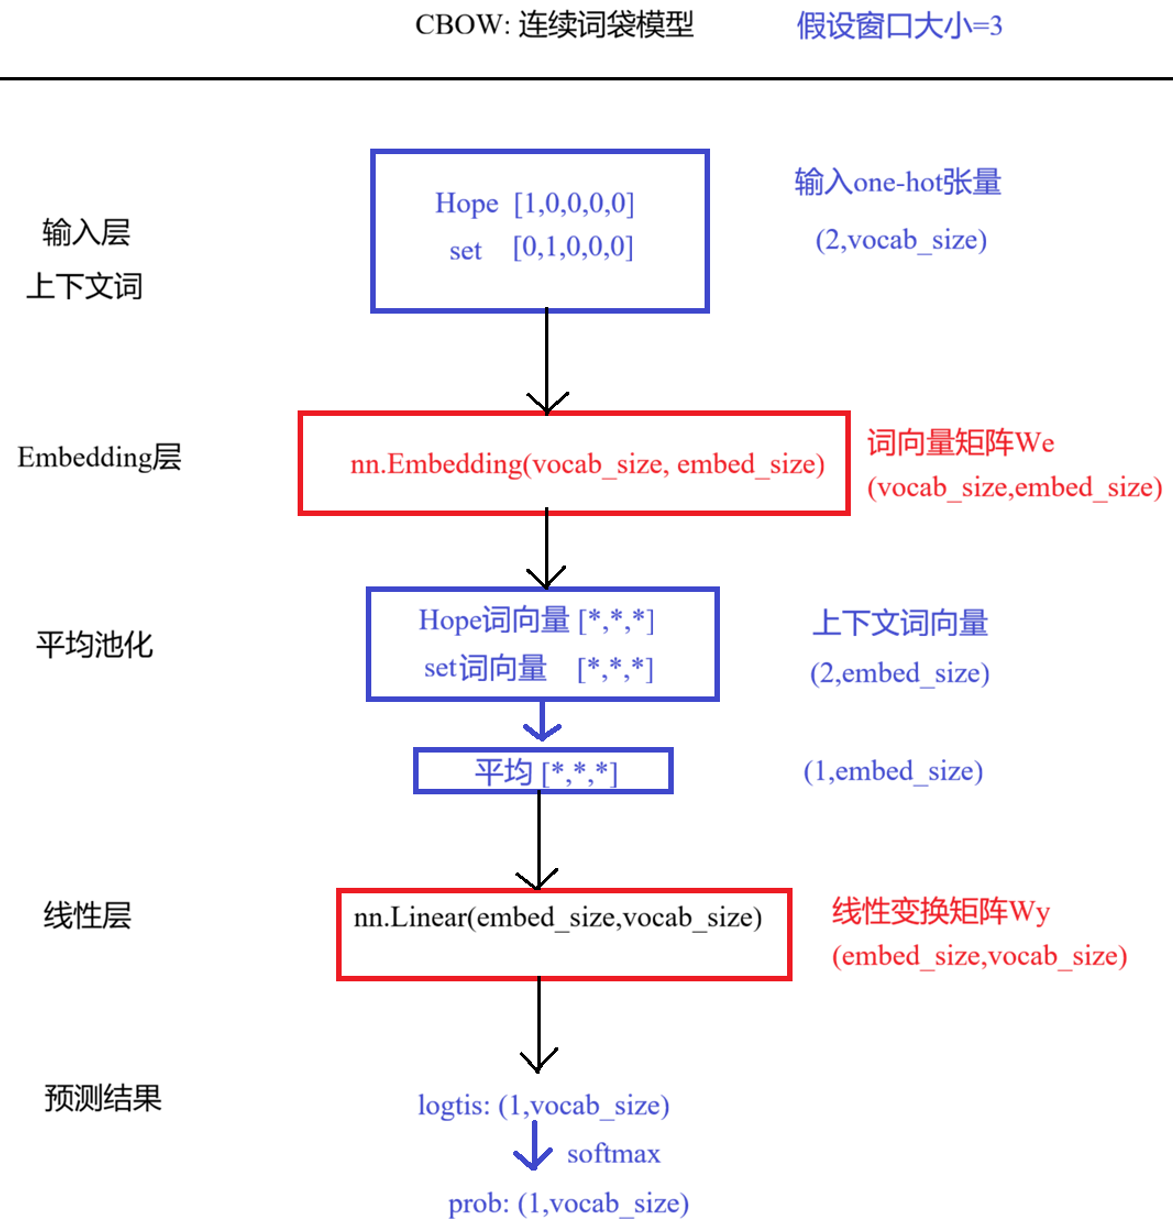
图注:图以「Hope can set you free,窗口大小 = 3」为例,自顶向下五层:输入层是两个上下文词 Hope [1,0,0,0,0] 与 set [0,1,0,0,0] 的 one-hot 张量,标注形状 (2, vocab_size);Embedding 层标 nn.Embedding(vocab_size, embed_size),右侧注出「词向量矩阵 We」形状 (vocab_size, embed_size);平均池化后得到「平均向量 [*,*,*,*]」,标注形状从 (2, embed_size) 变成 (1, embed_size);线性层标 nn.Linear(embed_size, vocab_size),右侧注「线性变换矩阵 Wy」形状 (embed_size, vocab_size);最下方是预测结果 logits:(1,vocab_size) 与 softmax:(1,vocab_size)。整张图说明 CBOW 的一次前向就是「one-hot → 查表 → 求均值 → 线性层 → softmax」。
用公式写下来就是:
\mathbf{h} = \frac{1}{|\text{ctx}|}\sum_{j \in \text{ctx}} \mathbf{e}_{w_j}, \qquad \mathbf{z} = \mathbf{W}_y \mathbf{h} + \mathbf{b}, \qquad \hat{\mathbf{y}} = \mathrm{softmax}(\mathbf{z})
真实目标是中心词 t 的 one-hot,损失就用交叉熵:\mathcal{L} = -\log \hat{y}_t。
skip-gram 的前向传播:
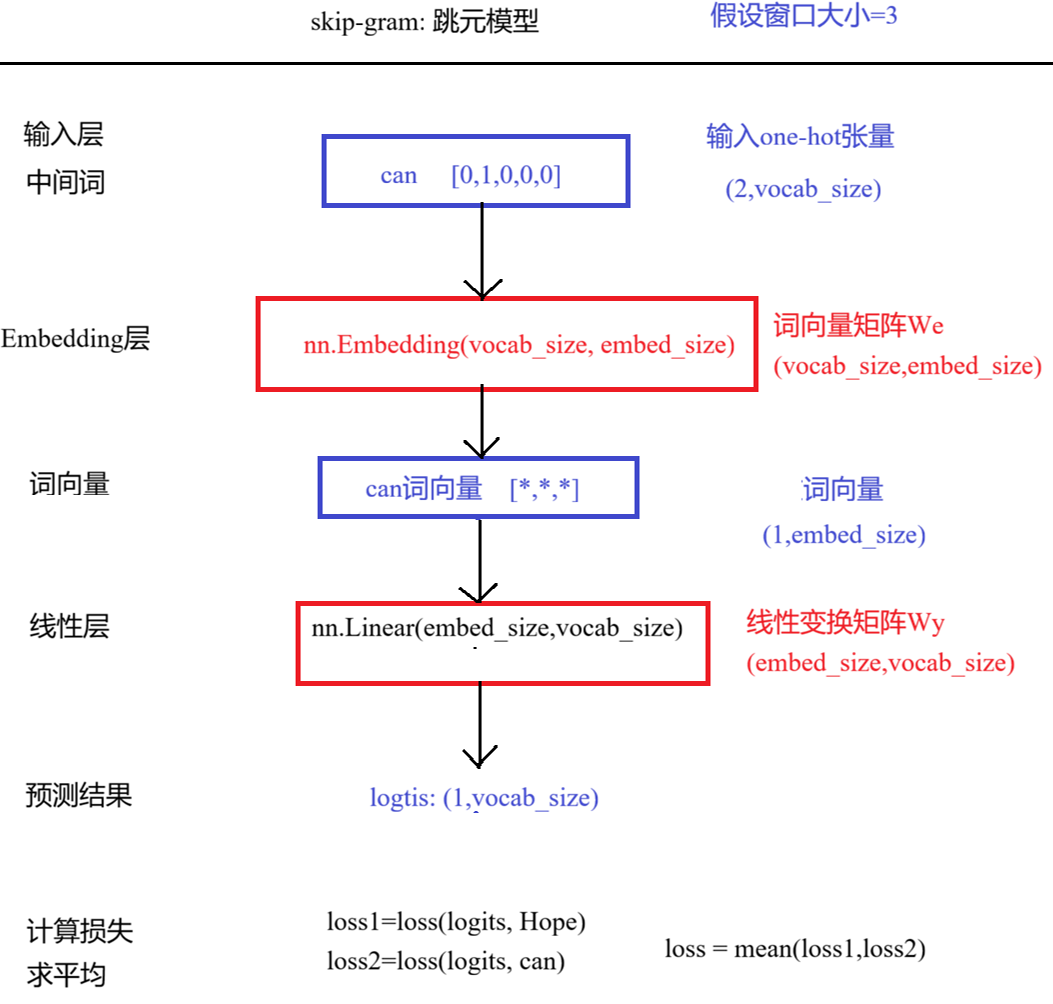
图注:同样「假设窗口大小 = 3」,但方向反过来。输入层/中间词只有一个框 can [0,1,0,0,0],标注「输入 one-hot 张量」,形状写的是 (2, vocab_size)(图里保留了和 CBOW 图一致的标注);Embedding 层标 nn.Embedding(vocab_size, embed_size) + 「词向量矩阵 We (vocab_size, embed_size)」;下一层「词向量」框内写 can词向量 [*,*,*],右侧注「词向量 (1, embed_size)」;线性层标 nn.Linear(embed_size, vocab_size) + 「线性变换矩阵 Wy (embed_size, vocab_size)」;预测结果 logits:(1,vocab_size)。最底层是这张图区别于 CBOW 的关键,「计算损失求平均」:loss1=loss(logits, Hope)、loss2=loss(logits, can)、loss = mean(loss1, loss2)。也就是说 skip-gram 一次前向要对多个上下文目标分别算损失再平均,这也是它更慢的直接原因。
词向量到底怎么取出来,embedding 查表:
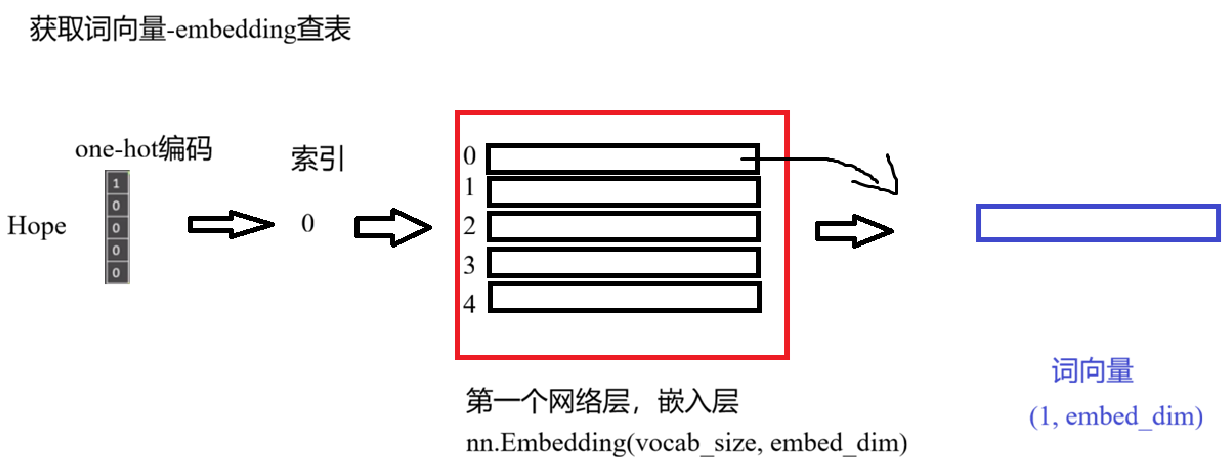
图注:标题「获取词向量-embedding 查表」。左边是单词 Hope 的 one-hot 编码(一个竖向的 5 格小矩阵,最上面一格为 1),一个箭头标「索引」指向数字 0,再一个箭头指向一个红框,框内是 5 行横条(左侧标行号 0、1、2、3、4),框下方写「第一个网络层,嵌入层 nn.Embedding(vocab_size, embed_dim)」;从第 0 行引出一个手绘箭头,指向最右边一个蓝色横向空条,标注为「词向量 (1, embed_dim)」。整张图就是把 4.7 节那个公式 e_w = W^\top o_w 画成了一次按下标取行的操作。
本课用 fastText 实跑出来的数据(很值得记,因为是真实 measured 值):
| 配置 | 结果 |
|---|---|
| 语料 | 英文维基预处理后的 fil9(由 enwik9.zip 经 wikifil.pl 清洗 XML/HTML 得到,约 300M 原始数据) |
train_unsupervised(model='cbow', dim=100, epoch=10, lr=0.02) |
训练耗时 113.23 s |
train_unsupervised(model='skipgram', dim=100, epoch=10, lr=0.02) |
训练耗时 184.03 s |
| 词向量形状 | model.get_word_vector('下雨').shape == (100,),与 dim=100 一致 |
| 近邻检索 | model.get_nearest_neighbors('下雨') → [(0.327,'bimonthly'), (0.320,'monthly'), (0.316,'degrees'), (0.313,'mathematics'), (0.308,'notation'), …] |
最后一行是这一课最有价值的「活教材」:训练语料是英文维基,拿它去查中文词「下雨」,返回的却是一串毫不相关的英文词,相似度还都只有 0.31~0.33。它说明两件事,一是词向量的语义空间完全由训练语料决定,换语料/换领域就换了一套语义空间,不能直接跨域复用;二是 OOV 词靠 subword 兜底也能查出一个向量,但那个向量没有语义意义。原材料的注意点也点明了 fastText 的定位:训练快、只支持 CPU、不支持 GPU 加速。
CBOW vs Skip-gram 的完整对比(课件原表):
| 对比维度 | CBOW | Skip-gram |
|---|---|---|
| 训练目标 | 上下文 → 中心词 | 中心词 → 上下文 |
| 输入形式 | 多个上下文词向量聚合(常用均值) | 单个中心词向量 |
| 损失形式 | 单目标损失(中心词) | 多目标损失(多个上下文词) |
| 训练速度 | 更快,计算开销小 | 更慢,计算开销大 |
| 低频词效果 | 较弱 | 较好(对稀有词更友好) |
| 高频词效果 | 较好 | 稳定 |
| 数据规模适配 | 小中等语料更易收敛 | 大语料下优势更明显 |
怎么选(课件原表):
| 场景 | 推荐 |
|---|---|
| 训练资源有限、希望快速得到可用词向量 | CBOW |
| 关注低频词/长尾词表示质量 | Skip-gram |
| 大规模语料、追求词向量质量上限 | 优先 Skip-gram(可配负采样) |
4.9 Embedding 层:跟着任务一起学的动态词向量
核心思想:不提前训练词向量,而是在具体下游任务训练过程中,与整个神经网络一起端到端学习;实现方式是 nn.Embedding(vocab_size, embedding_size),训练完这层的参数就是词向量矩阵。
真实输出(demo01):把两句中文用 jieba 分词、按词频从高到低建词表(Counter.most_common()),得到的词表是 36 个词,词频第一的是标点 ',':
{',': 0, '我': 1, '你': 2, '的': 3, '是': 4, '从前': 5, '有': 6, ... '悲': 35}
embedding: Embedding(36, 8)
embedding.weight.shape: torch.Size([36, 8])
nn.Embedding(36, 8) 的参数矩阵就是 (V, d) = (36, 8),和 word2vec 的 E(V,d) 形状完全一样,区别只在训练时机。用的时候把 token 的索引序列喂进去,embedding(torch.tensor(index_list)) 直接得到 (N, 8) 的词向量矩阵。
词向量的可视化(TensorBoard Projector):
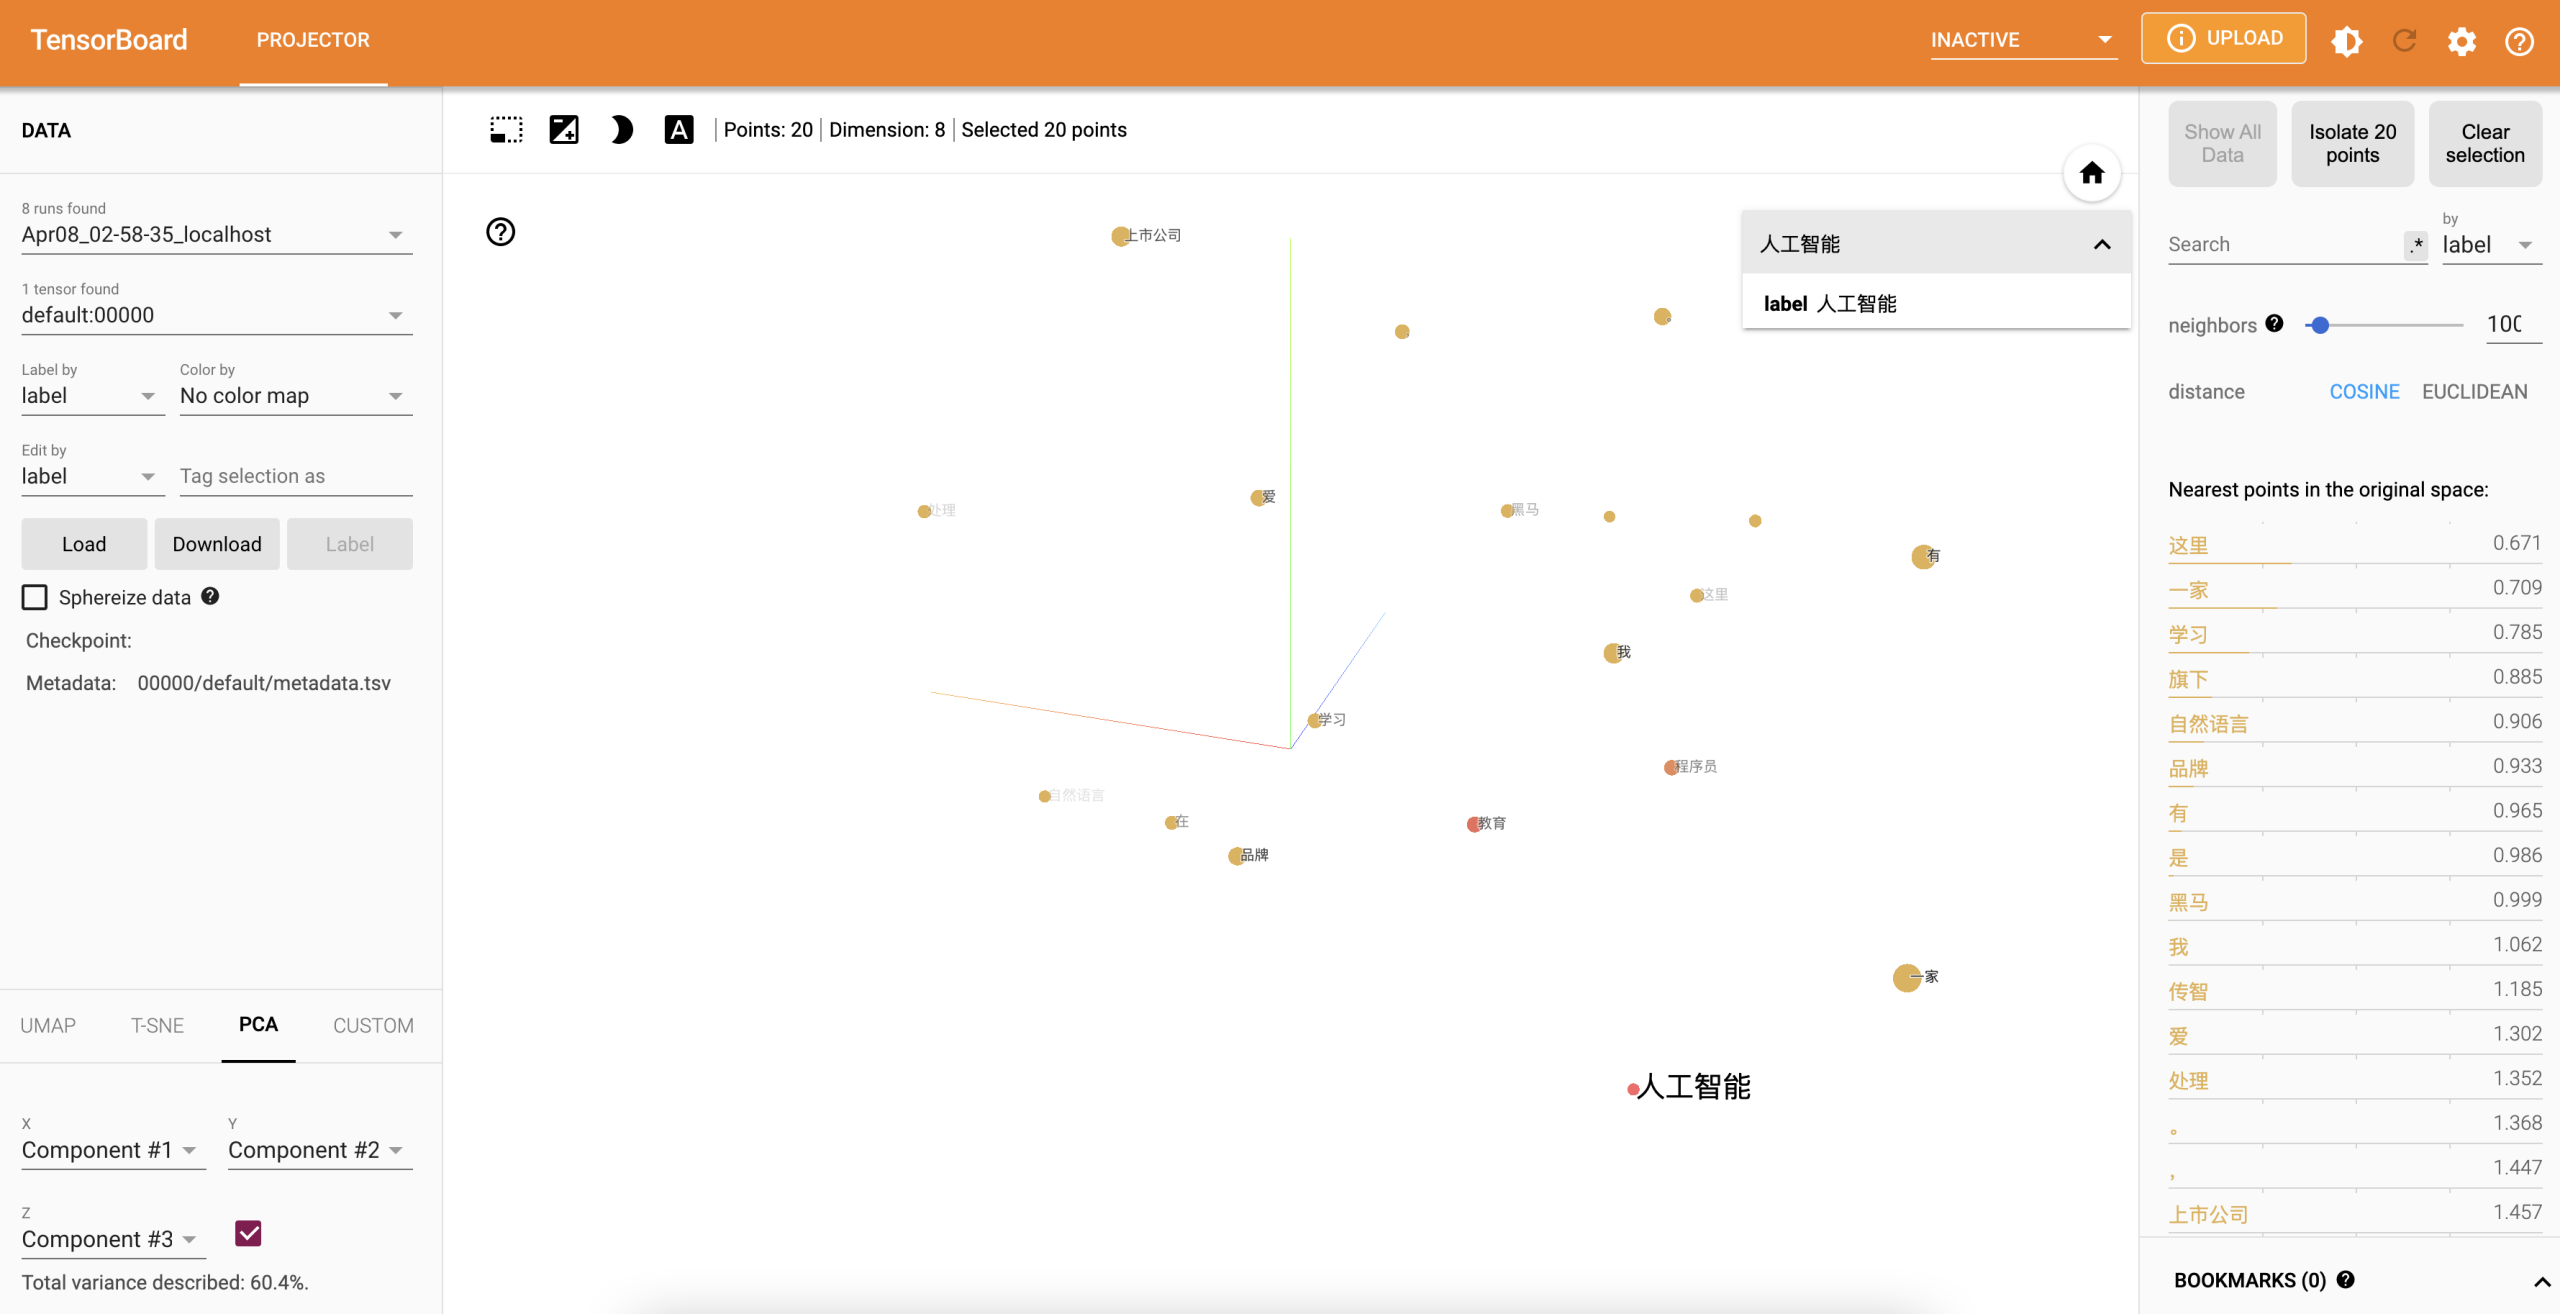
图注:这是 TensorBoard 的 PROJECTOR 面板截图(右上角状态显示 INACTIVE,旁边是橙色 UPLOAD 按钮)。左上 DATA 栏列出本次运行的目录 Apr08_02_58_35_localhost(下面还有 default/00000),有 Show all Data、isolate 20 points、clear selection 三个按钮,以及 Load、Download、Sphereize data 等选项与 Checkpoint: 00000/default/metadata.tsv。主图上方信息条写着 Points: 20 | Dimension: 8 | Selected 20 points;右下在 UMAP / T-SNE / PCA 三个投影里选中了 PCA,并显示 Total variance described: 60.4%,坐标轴可选 Component #1/#2/#3(Component #3 勾选)。图中散点是词语,可见「人工智能」「品牌」「黑马」「自然语言」「上市公司」等中文标签,鼠标悬停在一个点上弹出提示框 label 人工智能。右侧面板 Search ... by label 下面是 neighbors 10、distance 的 COSINE / EUCLIDEAN 切换,以及 Nearest points in the original space 列表:这是 0.671 / 一家 0.709 / 学习 0.785 / 旗下 0.885 / 自然语言 0.906 / 品牌 0.933 / 有 0.965 / 是 0.966 / 黑马 0.999 / 我 1.062 / 传智 1.185 / 要 1.302 / 处理 1.352 / , 1.368 / . 1.447 / 上市公司 1.457。
这张图有两个必须看出来的点,它们是「不要被可视化骗了」的最好教材:
- 图上的 Dimension: 8 和 4.9 节代码里
nn.Embedding(len(vocab), 8)的 8 完全对应;但语料只有几十个词、点只有 20 个。 - 投影的结构不能当结论:PCA 只解释了 60.4% 的方差,最近邻里排第一的「这是」相似度也才 0.671,说明在这个小得可怜的语料上,词向量还没有形成可解释的语义结构。真要做词向量分析,得先有足够大的语料和足够的维度。
word2vec 与 Embedding 层的差别(课件原话):
| 维度 | word2vec(静态) | Embedding 层(动态) |
|---|---|---|
| 什么时候学 | 提前在无监督大语料上独立训练 | 在下游任务训练中一起学 |
| 学完之后 | 冻结,当固定特征用 | 随任务继续更新 |
| 是否无监督 | 是 | 不是(跟着任务的有监督目标走) |
| 向量随上下文变化 | 不变(一词一向量) | 仍然不变(同词同向量,只是任务相关) |
| 典型代码 | fasttext.train_unsupervised() / get_word_vector() |
nn.Embedding(V, d) |
顺带埋一条后面几天的伏笔:这两者都是「一词一向量」的静态表示,无法解决多义词(「苹果」手机 / 苹果水果)。真正的「动态词向量」是 ELMo / BERT 那一类上下文相关的表示,同一句话里不同位置的同一个词会得到不同向量。day11-12 会接上这一段。
4.10 NLP 的三大难点:歧义、上下文、常识
① 歧义。本课给的是可复现的实例,比抽象定义有用得多:
- 分词歧义:全模式把「旗下」切出了「旗下」和「下有」两个词,模型看到的是噪声;反过来,比如「乒乓球拍卖完了」到底是「乒乓球 / 拍卖 / 完了」还是「乒乓球拍 / 卖 / 完了」,不同切法语义完全不同。
- 结构歧义:同一串词可以有不同句法结构(经典例子「咬死了猎人的狗」)。
- 词义歧义:「苹果」是水果还是公司,单看词形无法判定。
② 上下文。一词多义要靠上下文消解;指代(「它」「他」到底指谁)、否定(「不是不好」= 好)、省略(多轮对话里省掉的主语)都要靠上下文。这直接对应 4.1 表里的「语境与常识」和「对话能力」两格。
③ 常识。有些句子在语法、词汇上全对,但需要世界知识才知道真假/因果(例如判断「他打开冰箱,牛奶坏了」的因果方向,或者识别物理上不可能的叙述)。这是 4.1 表里「语境与常识」「事实与校准」两格。
还有一条更工程的难点,本课用代码演示过:数据层面的稀疏与未登录词(OOV)。one-hot 的词表是固定的,语料外的新词完全没法表示,这也是 FastText 用 subword(字符 n-gram)建模的出发点(课件的高频题里明确写了「对未登录词(OOV)和低频词更鲁棒」)。
4.11 怎么评估:从 token 级到语义级
原材料没有专门的评估章节(本节按通识补齐,并与新闻分类项目对齐)。评估的关键是先想清楚任务类型(4.2 节那五类),因为每类的指标完全不同:
| 层次 | 指标 | 适用任务 | 关键点 |
|---|---|---|---|
| token 级 | 分词 P / R / F1、边界准确率 | 分词 | 分词没有唯一正确答案(「传智教育」切不切都合法),所以评测必须先定标注规范 |
| 序列标注 | 实体级 F1(不是 token 级) | NER、POS | 一个实体只要边界错就算错;O(非实体)占比极高时 accuracy 会虚高,必须看 F1 |
| 分类 | accuracy / precision / recall / F1 + 混淆矩阵 | 情感分析、10 类新闻 | 类别不均衡时 accuracy 骗人,要看 macro-F1 与混淆矩阵(新闻分类项目用混淆矩阵分析) |
| 生成 | BLEU / ROUGE + 人工评估 | 机器翻译、摘要 | 本质是 n-gram 重合度,与人觉得「好不好」的相关性有限 |
| 语言模型 | 困惑度 PPL | 预训练、自监督 | \mathrm{PPL} = \exp(\mathcal{L}),\mathcal{L} 是平均交叉熵,PPL 越小越「不吃惊」 |
| 语义级 | 改写一致性、鲁棒性(加噪/错别字) | LLM 应用 | 直接对应 4.1 表的「语义一致性 / 稳健性」 |
| 端到端 | 线上业务指标(灰度准确率、点击率) | 部署 | 离线指标涨了,线上不一定涨 |
一句要背的话:训练 loss 下降 ≠ 任务指标变好,离线指标变好 ≠ 线上变好。再补一条与本课强相关的:one-hot 那种「所有词正交」的表示,模型在训练集上是把词背下来的,遇到没见过的组合就崩,这就是 4.1 表里的「组合与泛化」,也是评估时必须单独设计「未见组合」测试集的理由。
五、易错点与常见误解
| # | 常见说法 | 正确的说法 | 为什么 |
|---|---|---|---|
| 1 | jieba.cut 和 jieba.lcut 只是命名不同 |
cut() 返回生成器(只能消费一次),lcut() 返回 list |
课件里 demo01 特意注释了 list() / for / next() 三种消费方式,并把 print(words) 全部注释掉了 |
| 2 | 全模式「分得更全」,所以更好 | 全模式只是扫描所有可能成词,速度快但不能消歧 | 真实输出里它把「旗下」切成了「旗下」+「下有」,凭空多出噪声 token。它适合关键词提取/倒排召回,不适合做分类输入 |
| 3 | 自定义词典能让分词更「准」 | 词典只做合并,不做拆分 | 课件原话:「分词时只按照词典中 token 合并,不按照词典中 token 拆分」,它是保长词,不是改粒度 |
| 4 | one-hot 的 n 是句子长度 | n 是整个语料不同词的总数(词表大小) | 句子长度只决定矩阵有多少行,词表大小决定有多少列 |
| 5 | word2vec 和 Embedding 层是两种不同的东西 | 两者都是 V \times d 的参数矩阵,区别只在训练时机 | word2vec 先独立预训练再冻结;Embedding 层跟下游网络端到端一起更新 |
| 6 | CBOW 和 skip-gram 结果差不多,随便选 | 速度与低频词质量有系统性差异 | 本课实测:同配置下 CBOW 113.2 s、skip-gram 184.0 s;低频词质量 skip-gram 更好 |
| 7 | get_nearest_neighbors('下雨') 返回的就是「下雨」的近义词 |
返回的是训练语料里出现过的词按向量相似度排序的列表 | 课件语料是英文维基,「下雨」是 OOV,返回 (0.327,'bimonthly') 这类英文词;相似度还都只有 0.3 左右,不是近义词 |
| 8 | 拿词性表就能做 NER | 那张表是玩具版,真实输出里就有误报 | 实测输出出现 ('谷','PERSON')(「创新谷」被切成「创新/谷」)。工业 NER 是序列标注(BIO 标注 + CRF / BERT 微调) |
| 9 | 词表建一次可以到处用 | 词表由语料决定,换语料/换领域要重建 | one-hot 那节的 n = 语料不同词总数;本项目里 749 个停用词是固定的,但 TF-IDF 词表是 fit 出来的 |
| 10 | 停用词/标点无所谓 | 不剔标点,标点会变成高权重特征 | 本课 Embedding demo 的词表里,排名第一的高频词就是标点 ',';这也是项目要准备 749 个停用词的原因 |
六、横向对比与研究脉络
6.1 文本张量表示方法横向对比
| 方法 | 核心思想 | 维度与稀疏性 | 语义相似性 | 训练成本 | 适用场景 | 在新闻分类项目里的位置 |
|---|---|---|---|---|---|---|
| one-hot | 词表下标置 1 | V 维、极稀疏 | 无(任意两词正交) | 无(构造即可) | 教学、极小的词表 | 只用来理解概念,不上线 |
| word2vec-CBOW | 上下文 → 中心词 | d 维(如 100)、稠密 | 有 | 小(实跑 113 s / 100 维 / 10 epoch) | 资源有限、要快速拿到词向量 | 可用 fastText 预训练词向量喂 FastText 分类器 |
| word2vec-Skip-gram | 中心词 → 上下文 | d 维、稠密 | 有,低频词更好 | 大(实跑 184 s,约为 CBOW 的 1.6 倍) | 长尾词多、语料大、追求质量上限 | 标题里长尾词多,更值得选 |
| Embedding 层 | 表示与任务一起端到端学 | d 维、稠密、可训练 | 有,且任务相关 | 跟模型一起付 | 有监督下游任务(分类/标注) | BERT 的 embedding 层就是它的升级版 |
| (对照)TF-IDF | 词频 × 逆文档频率的加权向量 | V 维、稀疏、不是词向量 | 无 | 极低 | 检索、强基线分类 | 项目第一个模型(TF-IDF + 随机森林) |
注意最后一行的区分:TF-IDF 不是「词向量」,它给出的是每个词的权重,两个 TF-IDF 向量相似只说明「用词重叠」,不代表语义相近。把这一点说清楚,被追问时「你为什么用 TF-IDF 又换 FastText」就答得下去了。
6.2 中文分词工具横向对比(课件第 3.2 节原文清单)
| 工具 | 语言/实现 | 特点 |
|---|---|---|
| jieba | Python | 最流行;精确/全/搜索引擎三模式、繁体、自定义词典 |
| IK | Java | ElasticSearch 搜索引擎专用 |
| SnowNLP | Python | 基于概率算法,另支持情感分析、文本分类 |
| pyltp | Python | 哈工大推出 |
| THULAC | — | 清华推出的中文词法分析工具,支持分词与词性标注 |
6.3 演进关系:谁解决了谁的什么问题
one-hot(能算,但没有语义、维度爆炸)
   └─ 分布式假设:上下文相似的词,向量也相似
        └─ word2vec(静态词向量,语义有了;但一词一向量、与任务无关)
             ├─ FastText:加 subword(字符 n-gram),解决 OOV 与低频词
             └─ Embedding 层(动态词向量,与任务一起学;但每个任务都要从头学)
                  └─ 表示本身要能复用 → 预训练 + 微调
                       └─ ELMo / BERT:上下文相关的动态词向量(同词不同句不同向量)
三段因果要记牢:
- one-hot → word2vec:解决「能不能表达语义」。代价是静态,多义词无解。
- word2vec → Embedding 层:解决「表示和任务脱节」。代价是每个任务都要重新学一份向量,样本少就学不好。
- Embedding 层 → 预训练模型(day11-12 的内容):把「学表示」这件事从任务里提到任务之前,用海量无标注语料一次学完,下游只做微调,这一步直接把 NLP 推到了 pre-train/fine-tune 范式。
七、在新闻分类项目中的落地
7.1 这一课是四个模型的公共前置
| 阶段 | 模型 | 本课供给了什么 | 关键参数 / 坑 |
|---|---|---|---|
| ① | TF-IDF + 随机森林 | 精确模式分词 + 词表 + 停用词思想 | TfidfVectorizer(stop_words=停用词).fit_transform();749 个停用词要包含中文标点(否则像本课 demo 那样,, 会变成最高频 token) |
| ② | FastText | token 序列、静态词向量的用法、subword 解决 OOV | 数据格式 __label__标签名 文本;train_supervised();autotuneValidationFile 自动搜参;test() 返回 (样本数, 精确率, 召回率) |
| ③ | BERT(transformers 微调) | Embedding 查表 → 序列表示 → 分类头的整条心智模型 | 词表/分词改用 subword(WordPiece);embedding 层是「动态」的;max_len 决定显存 |
| ④ | LLM(DeepSeek 零样本/少样本) | 4.2 节的「任务类型」框架 + 4.11 的评估表 | 提示词里要写清任务类型(分类)、标签集合、输出格式;评估用混淆矩阵 + 4.1 的 9 维验收 |
7.2 参数怎么调(把本课参数直接映射到项目)
- FastText 词向量:
model='skipgram'(新闻标题长尾词多,低频词质量更值钱)、dim=100(本课实测值,标题短,100~200 足够)、epoch=10~25、lr=0.02。如果不想手调,用autotuneValidationFile让它按验证集搜。 - Embedding 维度与显存账:V \times d 是这类模型最大的一块参数。以 V = 200{,}000、d = 128 为例:
200000 \times 128 = 2.56 \times 10^7 \text{ 个参数} \approx 97.7 \text{ MB (fp32)} \approx 24.4 \text{ MB (int8)}
这正好是最后「模型压缩」阶段量化收益的主要来源之一,动的主要就是 Embedding 矩阵和线性层。
– 别真的构造 one-hot 矩阵:本课算过,词表 20 万、句长 20 时,单条样本 one-hot 要 15.3 MB;换成「1 个 int 索引 + Embedding 查表」只要 20 \times 128 \times 4\text{B} = 10 \text{ KB},差 1500 倍以上。这是本课最实用的一条工程结论。
– 超参由数据决定:day02 的「句子长度分布」决定 max_len,「标签分布」决定要不要加权,先看数据再定参。
7.3 实际坑(都是本课代码里能看出来的)
- 分词粒度必须训练/推理一致。训练用
jieba.lcut(text, cut_all=False),线上也必须一样;一旦为了召回去用全模式或搜索引擎模式,词表立刻错位,模型输出全歪。项目里TfidfVectorizer的vocabulary_就是红线。 - OOV 是 TF-IDF 基线的天花板。one-hot 那个固定词表说明了原因:词表外的词只能丢或映射到
<unk>。所以从 TF-IDF 换到 FastText 时,真正的卖点是 subword(字符 n-gram)能兜住未登录词。 - 标点与停用词:本课 demo 里没有剔停用词,词表第一位就是
,。项目里 749 个停用词是必须做的预处理,而且分词后要再过滤(先切再删,顺序不能反)。 - 词表只能「语料内」用:本课在英文语料上查中文词,得到一堆无意义近邻,说明预训练词向量不能跨语料/跨领域直接搬到中文新闻标题上;要用就用同语料、同领域训练的。
- POS/NER 别和分类标签混着说:本课 3.3/3.4 是「序列标注」这一类任务的样板,新闻分类项目做的是「整句分类」。被追问时把 NER 的简化实现说成工业方案,是最常见的扣分点。
.原文.md里的图片路径:源抽取稿写的是assets/NLP1.png这类扁平路径,而真实文件在assets/day01_自然语言处理入门/下(本报告已按真实位置引用)。
7.4 与其它模块的配合
- 配合 TF-IDF+随机森林:本课提供「分词 + 词表」,那份课件提供「权重公式」;两者合起来才是完整的文本特征管线。
- 配合 FastText:本课第 4.8 节负责「词向量怎么训」,day10 的 FastText 课件负责「分类器怎么用」,本项目里二者是同一个工具。
- 配合 BERT / LLM:本课 4.9 节的 Embedding 层是理解 BERT embedding 的最小入口;4.1 节的 9 维理解标准和 4.11 的评估表,直接可以拿来给 LLM 阶段写验收清单。
- 配合模型压缩:量化(QAT/PTQ/DQ)、蒸馏、剪枝、低秩分解作用的对象,就是本课反复出现的「大矩阵」(词向量矩阵、线性层权重)。理解 V \times d 的账,才理解压缩能省多少。
八、重点问答
Q1:什么是自然语言处理?你怎么判断一个模型是不是真的「理解」了语言?
A:NLP 就是让计算机理解、生成并与人类语言交互的技术。判断标准不是「说得像人」,而是能在语言变化下稳定、可泛化、可解释地完成语义任务。我一般按九个维度去拆:任务能力、语境与常识、语义一致性、组合与泛化、可解释性、稳健性、对话能力、事实与校准、跨模态执行。这九条里,前两条传统模型就能看出一部分,后面几条,尤其是事实校准、稳健性和可解释性,正好是今天大模型还没解决的地方,所以我把它当作评估清单用,而不是当定义背。这也正好解释了 NLP 难在哪:一是歧义,分词层面「旗下」能切出「下有」,词义层面「苹果」既可以是水果也可以是公司;二是上下文,指代、否定、省略都得靠上下文才解得开;三是常识,有些句子语法词汇全对,但要世界知识才能判真假和因果。再叠加一条工程问题,数据稀疏和未登录词,这就是 FastText 用子词、BERT 用 subword 的原因。
Q2:中文为什么必须分词?jieba 三种模式怎么选?
A:英文靠空格就有天然的词边界,中文是「字、句、段都有分界符,但词没有」,所以分词的本质是找词的边界。词又是语义理解的最小单元,所以分词质量会直接传导到下游的词性标注、NER、分类和检索。jieba 三种模式的差别其实是粒度:精确模式切口最保守,适合文本分析、信息抽取和分类输入;全模式把所有可能成词都扫出来,快但不能消歧,同一句话会切出「旗下」和「下有」这种噪声,所以只适合关键词提取;搜索引擎模式在精确模式基础上再把长词切开,比如把「小米手机保护壳」切成(小米/手机/保护/壳),用户搜「小米壳」就能命中,所以它换的是召回率。项目里我固定用 jieba.lcut(text) 精确模式,因为词表必须和训练时一致。
Q3:词性标注和命名实体识别是什么?它们属于哪类任务?
A:它们都属于序列标注,输入一个序列,输出等长的标签序列,每个 token 一个标签。POS 是标注每个词的词性,比如「我/r、爱/v、自然语言/n、处理/vn」,它提供的是句法结构信息,是句法分析和语义理解的基础。NER 是识别人名、地名、机构名这类专有名词,它的价值在于把非结构化文本变成可计算的结构,比如从「马斯克表示特斯拉在上海的工厂进展顺利」里抽出人物、组织、地点,直接支撑摘要、知识图谱和舆情监控。补充一句我踩过的坑:用 jieba 的词性表去映射实体只能算玩具版,我曾经跑出「创新谷」被切成「创新/谷」、然后「谷」被标成人名的误报;工业做法是用 BIO 标注加 CRF 或者 BERT 微调来逐 token 打标。
Q4:one-hot 编码有什么缺点?你项目里怎么绕开的?
A:两个致命缺点。第一,维度等于词表大小,我算过账:词表 20 万、标题平均 20 个词,单条 one-hot 矩阵就是 (20, 200000),float32 下约 15 MB,一批数据根本放不下。第二,任意两个不同词的 one-hot 内积恒为 0,也就是「陈奕迅」和「周杰伦」的距离跟「陈奕迅」和「苹果」一样远,模型完全学不到语义相似性。绕开的方式是换成稠密向量:课里学的是 word2vec(静态)和 nn.Embedding(动态),项目里则是 TF-IDF 做基线、FastText 用 subword 词向量、BERT 用上下文相关的 embedding。更本质的一点是,Embedding 查表其实就是「one-hot 乘矩阵」的优化形式,因为 one-hot 只有一位是 1,矩阵乘法等价于按下标取一行,所以索引 + 查表就够,不用真的构造那个稀疏矩阵。
Q5:word2vec 的 CBOW 和 Skip-gram 有什么区别?你怎么选?
A:它们是互为镜像的两个训练任务。CBOW 是「用上下文预测中心词」,把多个上下文词向量聚合成一个表示(常用均值),只对一个目标算损失,所以训练快、计算开销小,但低频词效果弱。Skip-gram 是「用中心词预测上下文」,一个中心词要对多个上下文词分别算损失再求平均,所以训练慢,但每个上下文词都贡献了梯度,低频词和长尾词的表示更好。我实测过同一份语料、dim=100、epoch=10:CBOW 113.2 秒,Skip-gram 184.0 秒,大概慢 1.6 倍。选的时候看资源:训练资源紧张、想快点拿到可用词向量就用 CBOW;语料大、长尾词多、追质量上限就用 Skip-gram,还可以配负采样。我们的新闻标题长尾词多,我会优先 Skip-gram。
Q6:word2vec 和 Embedding 层的区别是什么?
A:说到底是同一个东西的两种用法。它们最终都得到一个 (V, d) 的参数矩阵,形状一模一样,区别只在训练时机。word2vec 是静态词向量:先在大规模无标注语料上用无监督方法独立训练好,然后冻结,当下游任务的固定特征用,优点是任何任务都能拿来即用,缺点是跟任务无关、一词一向量。Embedding 层是动态词向量:不提前训练,而是在具体下游任务的训练过程中和整个网络一起端到端更新,nn.Embedding(V, d) 这层的参数就是词向量矩阵,优点是任务相关,缺点是每个任务都要从头学、样本少就学不好。我会补一句更进一步的:这两个都还是「一词一向量」,解决不了多义词,真正的上下文相关表示要到 ELMo 和 BERT 那一代。
Q7:词向量的语义到底是从哪来的?为什么不能随便拿一份预训练词向量来用?
A:语义不是标注出来的,是从「上下文分布」里学出来的,分布式假设认为经常出现在相似上下文里的词,语义也相近,所以 CBOW 和 Skip-gram 这两个任务本身就能逼出有语义结构的向量。但也正因为这样,词向量的语义空间完全由训练语料决定。课里有个很直观的实验:训练语料是英文维基,拿它去查中文词「下雨」的词向量,get_word_vector 能返回一个 100 维向量(subword 兜底),但 get_nearest_neighbors('下雨') 返回的是 bimonthly、monthly、degrees 这些英文词,相似度还只有 0.3 左右。这说明 OOV 词虽然能查出一个向量,但它没有语义意义。所以要么用同语料、同领域训练的向量,要么直接用 BERT 这类上下文相关的表示,不要跨语料瞎搬。
Q8:文本表示方法都有哪些?你项目从 TF-IDF 换到 FastText 再换到 BERT,换的到底是什么?
A:主流的有三类:one-hot(高维稀疏,无语义)、预训练的静态词向量(word2vec / FastText,稠密有语义)、Embedding 层(和任务一起端到端学)。另外要单独区分 TF-IDF:它不是词向量,是词权重,两个 TF-IDF 向量相似只说明用词重叠,不代表语义相近。项目里的三次替换,换的是三件不同的事:从 TF-IDF 换到 FastText,换的是表示形式,从稀疏权重换成稠密词向量,并且 subword 让未登录词不再丢分;从 FastText 换到 BERT,换的是表示能力,从静态一词一向量换成上下文相关的动态表示,多义词和语序都能建模;从 BERT 换到 LLM,换的是使用方式,不再训练参数,而是把任务写进提示词做零样本/少样本分类,用同一套混淆矩阵和评估指标做横向对比。
九、延伸阅读
工具与官方文档
- jieba 官方仓库(
fxsjy/jieba):三模式、繁体、自定义词典的权威说明;cut/lcut生成器与列表的区别就在 README 里。 - fastText 官方站点与文档(
fasttext.cc):train_unsupervised、get_word_vector、get_nearest_neighbors、train_supervised、autotuneValidationFile等 API。 - TensorBoard Projector:本课 4.4 节演示的
writer.add_embedding(embedding.weight, metadata=..., tag=...)就是这个面板的数据来源。 - 语言环境:
conda create -n nlp_project python==3.10→conda env list→conda activate;本课实测环境为 PyTorch 2.9.1 + CUDA 12.8,设备选择优先级 cuda > mps > cpu(课件开头那段torch.device判断是通用写法,Mac 上会自动落到 mps)。
数据
enwik9(mattmahoney.net/dc/enwik9.zip):英语维基百科的部分网页信息,约 300M,配合wikifil.pl清掉 XML/HTML 后得到本课用来训词向量的fil9(清洗后是空格分隔的单词)。
论文(只列标题与主题,不引用具体编号)
- Mikolov 等,word2vec 两篇(2013):提出 CBOW 与 Skip-gram 两种训练模式,是现代词向量的起点。
- Vaswani 等,Attention Is All You Need(2017):Transformer,day05-07 的主体。
- Devlin 等,BERT(2018):预训练 + 微调范式,day11-12 的主体。
本目录内的接力材料(同一条知识线,建议连读)
往期知识/nlp-html/day02_文本预处理.原文.md:语料数据分析、n-gram 特征、文本长度规范、回译数据增强,本课 4.4 表里留给它的那三格。往期知识/nlp-html/day03_RNN及其变体、day04_注意力机制、day05_07_Transformer架构:从「表示」进入「模型」。往期知识/nlp-html/day10_FastText工具介绍:本课 4.8 节 fastText 部分的展开版(分类器侧)。往期知识/nlp-html/day11_transformers迁移学习、day12_BERT与GPT架构:接上本报告 6.3 节最后一段「预训练 + 微调」。往期知识/NLP基础总结-研究报告.md:同一批知识的思维导图版,可用来对照复习。- 项目侧对照:
3.1随机森林模型/【理解】TFidf+文本转向量-研究报告.md、3.2Fasttext/【理解】FastText原理-研究报告.md、3.3Bert模型/【掌握】Bert原理结构极速版-研究报告.md、4.1模型压缩/【理解】真实部署流程-研究报告.md。