用 GRU + Attention 的 Encoder–Decoder 从零训练一个英译法 seq2seq 模型,跑通”数据清洗 → 双词表 → 截断填充 → 编码器/注意力/解码器 → teacher forcing 训练 → 自回归推理 → BLEU 评估”的完整闭环,它是 day08「Transformer 英译法案例」的对照组基线。
一、这份材料解决什么问题
这份材料要回答一个很具体的问题:在没有预训练、没有 Transformer 的前提下,一个”纯手写”的序列到序列模型能把翻译做到什么程度?
它的来龙去脉可以这样摆:
- day03 讲了 RNN 及其变体(GRU/LSTM),day04 讲了注意力机制,day05–07 讲透了 Transformer 架构,day08 用
nn.Transformer做了英译法。 - day09 掉头回到 RNN 家族,用 GRU + Attention 的 Encoder–Decoder 把同一份数据、同一个任务、同样 25 个 epoch 再做一遍。
- 于是 day08 和 day09 构成一组严格对照实验:同一份
eng-fra-v2.txt(10593 个句对,两边打印的词表大小完全一致:源 2804、目标 4346,拆分后都是 8474 / 1059 / 1060)。差别只有架构。
它顺带解决的三件工程事,才是被追问时真正值钱的部分:
- 从零训练一个生成式模型的完整工程件怎么写,两个词表、三个特殊符号、padding + mask、
ignore_index、按最小验证损失保存最优模型。 - 自回归模型的两个经典病灶怎么暴露、怎么观测,teacher forcing 与曝光偏差(exposure bias)。
- “指标会骗人”的实证,token 级准确率看着有 0.4985,BLEU 只有 14.03,实际输出是
je ne vais je me ai ai ai ai ai .。
在新闻分类项目的四条技术路线里,这份材料不直接对应任何一个模型,但它提供了整条路线的下限参照:它证明”没有预训练先验”要从 1 万个句对里学英法对齐有多难,这就是后面直接上 BERT 的核心理由(详见第七节)。
二、核心结论
- 这是一个”从零训练”的基线:10593 个句对、源/目标两个词表(2804 / 4346)、GRU 隐藏维 512、25 个 epoch、batch 128。最终测试集 token 准确率 0.4985、测试损失 2.9835、BLEU 14.03。
- 编码器最后一步的隐藏状态
h₉直接当解码器的初始隐藏状态(decoder_hidden = encoder_hidden),整句信息被压缩进一个 512 维向量,这就是 seq2seq「固定长度上下文瓶颈」的物理来源。 - Attention 只加了 3 个 512×512 线性层(约 0.79M 参数,占全模型 10.35M 的 7.6%),却让解码器每一步都能直接看到源句的全部时间步,性价比最高的一次架构升级。
- teacher forcing 是训练期特权:训练时
TEACHER_FORCING_RATIO=0.5,验证/测试/预测必须为 0(自回归)。day08 的对照组给出了落差:同一模型 teacher forcing 模式下测试准确率 0.7431,自回归模式只有 0.6097,前者是虚高的自我安慰。 - 同样 25 个 epoch,Transformer 版 BLEU 35.74 是本版的 2.5 倍(token 准确率 0.6097 vs 0.4985)。差距不来自”GRU 不行”,而来自:时间步无法并行、信息必须沿递归路径传递、参数量只有对方的约 1/3(10.35M vs 约 31.1M,手算)。
三、知识地图
课件自报的学习目标权重如下(【掌握】>【理解】>【了解】):
day09_RNN英译法案例
├── 0. 环境与设备选择(DEVICE: cuda > cpu)                      【了解】
├── 1. 案例描述:Encoder–Decoder(GRU) + Attention 端到端英译法    【理解】
├── 2. 获取数据:data/eng-fra-v2.txt(英文 \t 法文)              【了解】
├── 3. 数据预处理                                                【掌握】
│   ├── 文本清洗(小写化 / 去无效字符 / 只留 . ! ?)
│   ├── 特殊符号 <PAD> <SOS> <EOS>("决定 Seq2Seq 是否能正确工作")
│   └── Padding 与截断到 MAX_LENGTH(PAD 在损失与准确率中必须忽略)
├── 4. 模型结构                                                  【掌握】
│   ├── Encoder:GRU,输出隐藏状态序列
│   ├── Attention:计算对齐权重、加权求和
│   ├── Decoder:逐词生成法文
│   └── 六步实现流程(清洗→词表→数据集→搭网→训练→测试/预测)
├── 5. 训练关键技术                                              【掌握】
│   ├── 5.1 Teacher Forcing(训练 p、推理 0)
│   ├── 5.2 损失函数 CrossEntropyLoss(ignore_index=pad_idx)
│   ├── 5.3 Token-level Accuracy(≠ 翻译质量)
│   └── 5.4 推理流程(编码整句 → 从 <SOS> 起 → 自回归 → 遇 <EOS> 停)
├── 6. 完整代码 + 运行日志 + BLEU 评估                            【掌握】
└── 7. 常见高频题(5 题:seq2seq 思想 / 为何要注意力 / 梯度裁剪 /
                    变长序列处理 / teacher forcing 利弊)          【理解】
四、原理详解
4.1 全局数据流:一张图看懂四个类
模型被拆成四个类,数据流是一条单向链:
源句 (B, S)
  └─ MyEncoder:  Embedding(2804,512) → GRU(512,512) → encoder_output (B,S,512) + h_S (1,B,512)
                                                              │              │
                                    ┌─────────────────────────┘              │ 直接作为初始隐藏状态
                                    ▼                                        ▼
                            MyAttention                        ┌─── MyDecoder ───────────────────┐
                       Q=Wq(h_{t-1})、K=Wk(encoder_output)、   │ Embedding(4346,512) → [embed;C_t]│
                       V=Wv(encoder_output)                     │  → Linear(1024,512) → GRU       │
                       C_t = Σ α V  (B,512)  ──────────────────►│  → Linear(512,4346) → logits    │
                                                                └─────────────────────────────────┘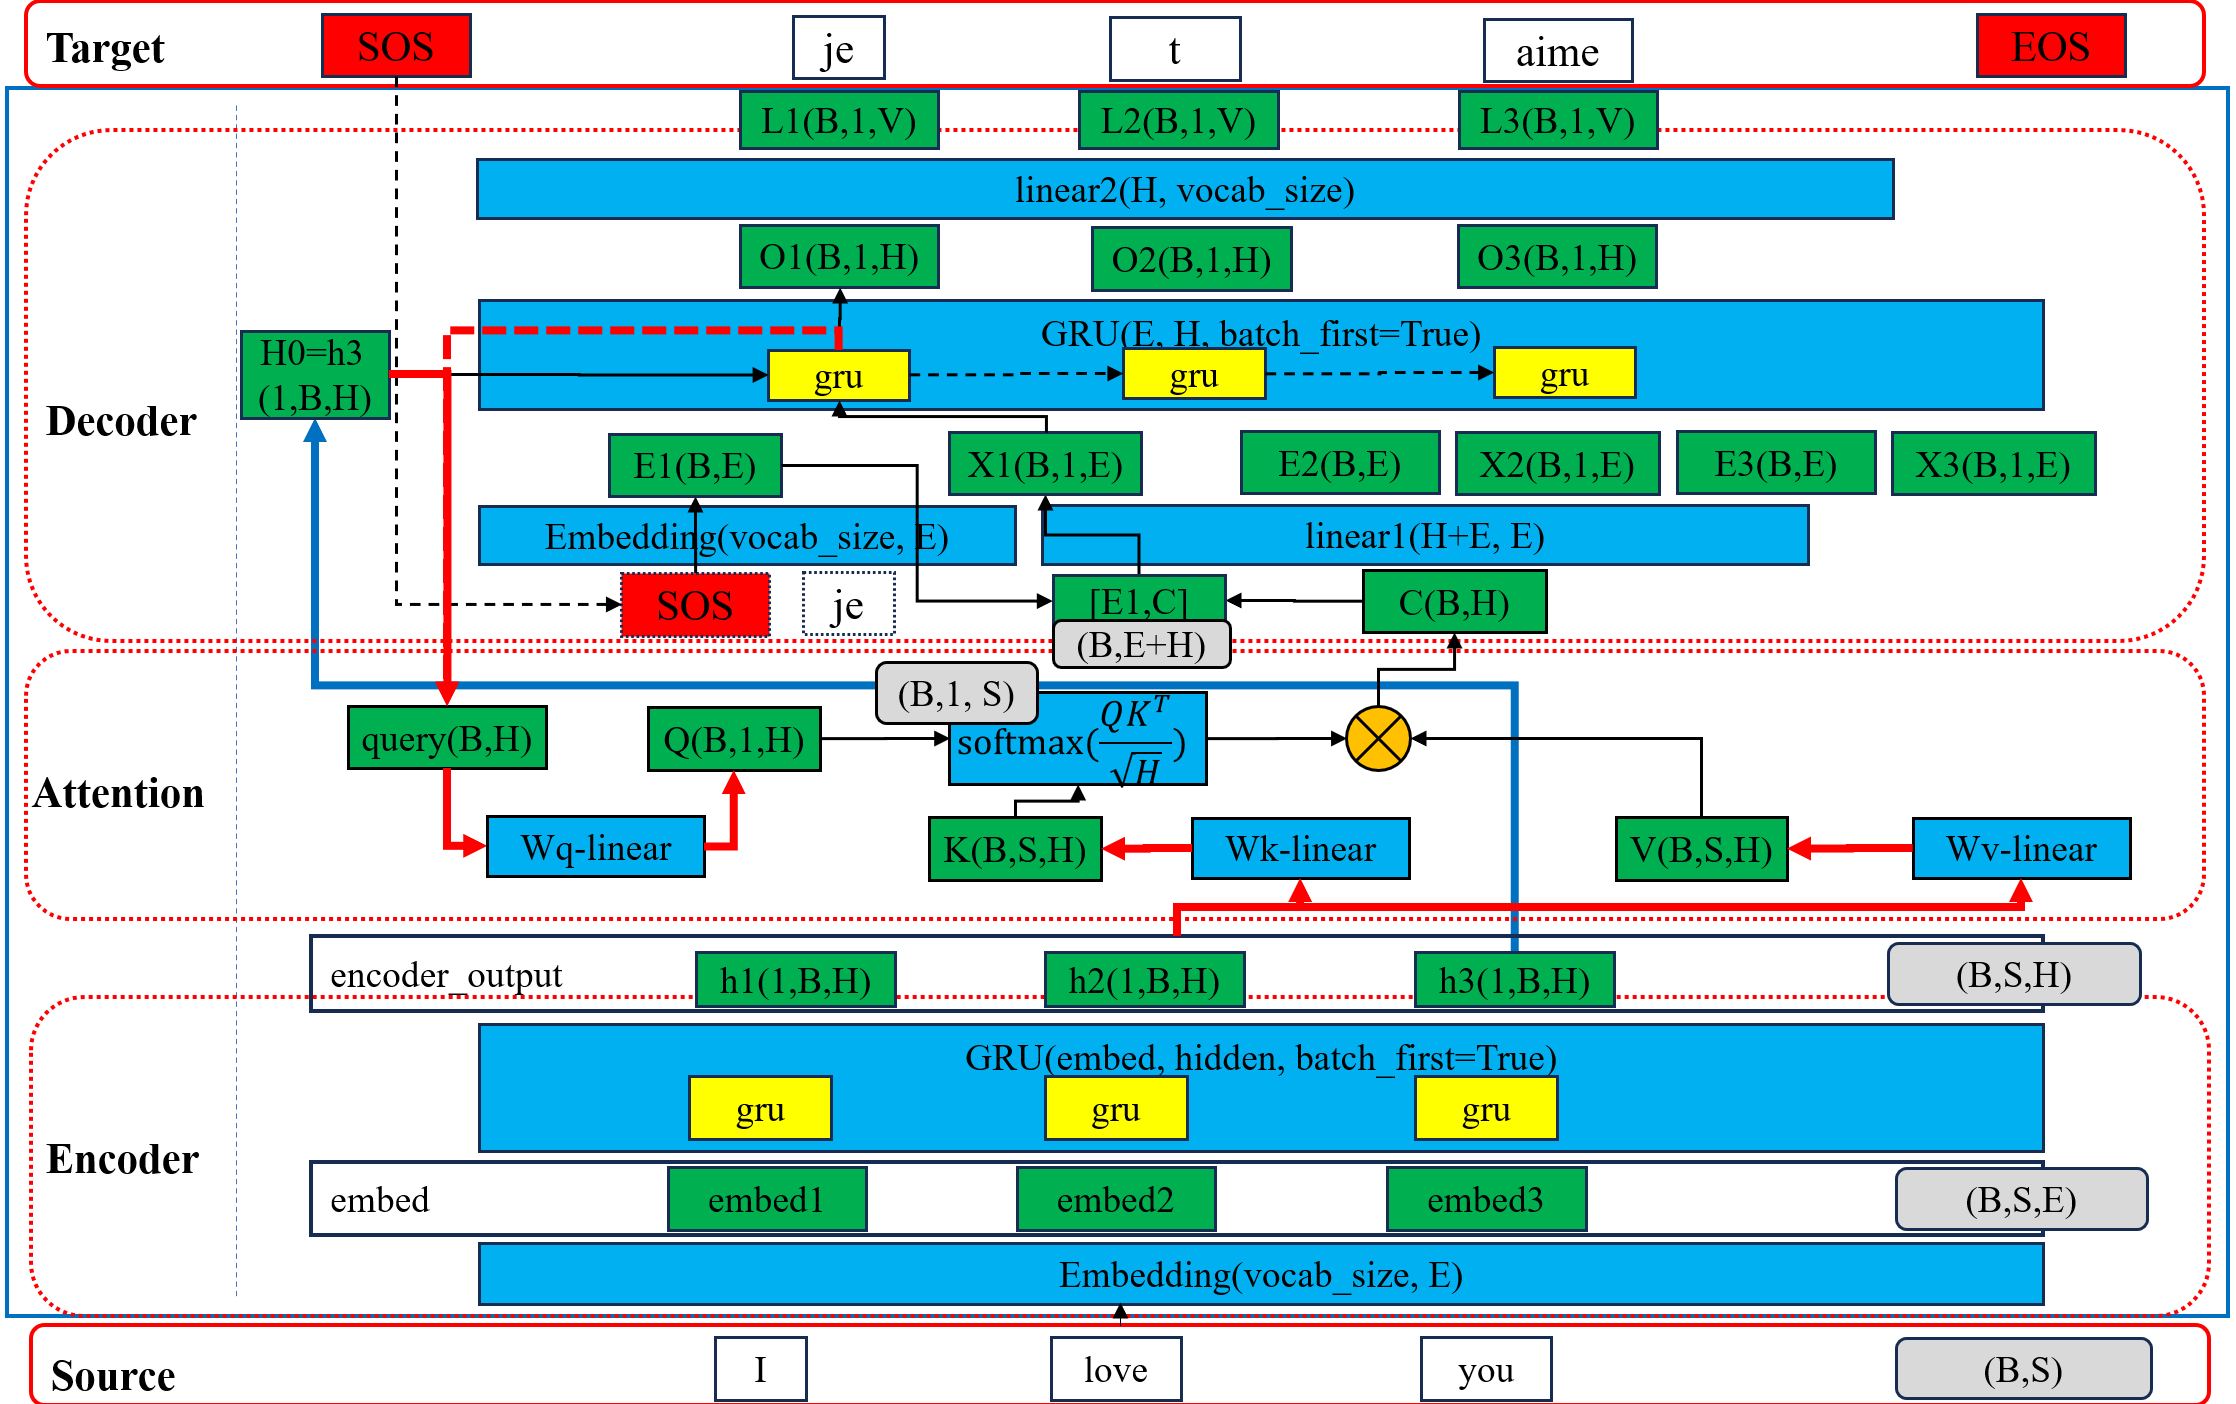
图注:这张图(课件原文件名 day06_attention_seq2seq.png)就是上面四个类的逐张量数据流图,横轴是时间步,右侧灰色小框标注张量形状。自下往上看:Source 行的 I / love / you 形状 (B,S);Encoder 区先过 Embedding(vocab_size, E) 得到 embed1~embed3 (B,S,E),再进 GRU(embed, hidden, batch_first=True)(条带内三个黄色 gru 单元),输出 encoder_output 行的 h1/h2/h3 (B,1,H),整行形状 (B,S,H)。Attention 区里,query(B,H) 经蓝色 Wq-linear 得 Q(B,1,H);encoder_output 用红箭头分别送进 Wk-linear 和 Wv-linear 得到 K(B,S,H)、V(B,S,H);Q 与 K 做 softmax(QKᵀ/√H)(上方灰色 (B,1,S) 就是注意力权重的形状),再与 V 在黄色 ⊗ 处相乘,得到 C(B,H) 回送 Decoder。Decoder 区(红虚线框)里,目标端输入经 Embedding(vocab_size, E) 得 E1(B,E),与 C 拼接成 [E1,C1] (B,E+H),过 linear1(H+E, E) 得 X1(B,1,E),进 GRU(E, H, batch_first=True) 得 O1(B,1,H),最后 linear2(H, vocab_size) 输出 L1(B,1,V);最顶部 Target 行的 SOS / je / t / aime / EOS 与解码器输入行的 SOS + 虚线框 je 用虚线相连,示意”下一步可以喂真实目标词”,也就是 teacher forcing。左侧绿色 H0=h3 (1,B,H) 加一条从 Encoder 顶部指过来的红箭头,正是代码里 decoder_hidden = encoder_hidden 那一行。
4.2 数据与清洗:三条正则定生死
数据是制表符分隔的双语句对(英文 \t 法文),清洗函数只有 4 行但决定了词表规模:
def clean_text(string):
    string = string.strip().lower()                       # 小写 + 去首尾空白
    string = re.sub(r"([.!?])", r" \1 ", string)          # 标点前后补空格,使其独立成词
    string = re.sub(r"[^a-zA-Z.!?]+", r" ", string)       # 其余字符(数字/重音符号/逗号)统一变空格
return string.strip()三条规则的效果:Hello, World!!!!!123 → hello world ! ! ! ! !;法语的 é、à 会被替换为空格,所以输出侧是去重音符号的简化法语(日志里的实际译文就是 je suis desole、a court de temps 这种写法)。清洗后再去重,得到 10593 个句子对。
4.3 两个词表 + 三个特殊符号
SPECIAL_TOKENS = ['<PAD>', '<SOS>', '<EOS>']        # index 0 / 1 / 2
vocab_source = {token: i for i, token in enumerate(SPECIAL_TOKENS)}
vocab_target = {token: i for i, token in enumerate(SPECIAL_TOKENS)}
要点有三:
- 词表是两份,源和目标各建一份(英法词汇无交集,共享词表只会浪费 embedding 行数)。最终源 2804、目标 4346,目标词表更大,因为法语侧的屈折变体更多(日志样本里
je suis desole / desolee、je suis touche / touchee这种男女性变体都算不同的词)。 - 索引 0/1/2 是硬编码进代码的:
padding_idx=0、解码起始get('<SOS>', 1)、循环结束条件== get('<EOS>', 2)。这就是为什么顺序必须先 PAD 再 SOS 再 EOS。 - 词表是从训练+验证+测试全量句子对里构建的(
build_vocab(DATA_PATH)在拆分之前调用)。教学案例可以这么干,工程上这是”信息泄漏”,真实项目要么只用训练集建表,要么承认目标域词表已知。
4.4 截断填充:MAX_LENGTH=12 是怎么来的
def pad_sequence(self, sequence, vocab):
    sequence = sequence[:self.max_length - 2]                      # 先给 SOS/EOS 留 2 个位置
    sequence = [vocab['<SOS>']] + sequence + [vocab['<EOS>']]      # 首尾加标记
    pad_length = self.max_length - len(sequence)
    sequence = sequence + [vocab.get('<PAD>', 0)] * pad_length     # 补齐
    return torch.tensor(sequence, dtype=torch.int64)
日志打印:最长的源句 9 个词、最长的目标句 9 个词。所以 MAX_LENGTH = 12 = 9 + 2(SOS/EOS)+ 1(余量),本数据集里一次截断都不会发生,所有填充都是纯补 PAD。也就是说:这个 12 是”看着数据分布定的”,不是拍的。
填充后的张量长这样(以 5 词句为例,<SOS>=1、<EOS>=2、<PAD>=0):
index_source: [1, 12, 7, 45, 3, 19, 2, 0, 0, 0, 0, 0]   # SOS + 5 词 + EOS + 6 个 PAD
index_target: [1, 88, 5, 91, 2, 0, 0, 0, 0, 0, 0, 0]
4.5 Encoder:读入整句,吐出两样东西
self.embed = nn.Embedding(len(vocab_source), embed_size, padding_idx=vocab_source.get('<PAD>', 0))
self.gru = nn.GRU(embed_size, hidden_size, batch_first=True)   # 512 → 512

def forward(self, source, hidden=None):
    embed = self.embed(source)              # (B, S)     → (B, S, 512)
    output, hidden = self.gru(embed, hidden)  # (B,S,512) → (B,S,512) + (1,B,512)
    return output, hidden
Encoder 只有一个 GRU 层、单向,所以初始隐藏状态可以直接传 None(PyTorch 自动给零初始化)。output 是所有时间步的隐藏状态(后面 Attention 当 K/V 用),hidden 只有最后一步(num_layers=1 所以第一维是 1)。
4.6 隐藏状态如何传递:瓶颈就在这一行
encoder_output, encoder_hidden = self.encoder(source)
decoder_hidden = encoder_hidden            # ← 整句信息压成一个 (1, B, 512) 向量
decoder_input  = torch.full((batch_size, 1), vocab_target.get('<SOS>', 1), dtype=torch.int64)
这行赋值是整份材料最重要的教学点:
- 不加 Attention 时,解码器每一步都只拿着这个
h₉往前走,源句里”哪个词对应哪个词”的位置信息全靠这一个向量携带,一旦句子变长、词多了,512 维里塞不下,翻译就开始丢词、错序。这就是 Sutskever 2014 那篇 seq2seq 论文要”把源句倒序输入”来缓解同一问题的原因。 - 加了 Attention 后,这个
h₉退化成”第一拍的 query 起点”,真正的信息通过encoder_output的S个向量逐步注入。
还有一个硬约束要注意:decoder_hidden = encoder_hidden 能成立,前提是编码器和解码器的 hidden_size 完全相同(这里都是 512)。改了其中一个就必须加线性变换桥接。
4.7 Attention:Q 来自解码器,K/V 来自编码器
def forward(self, encoder_output, decoder_hidden, src_pad_mask=None):
    query = decoder_hidden[-1]                              # (B, H) 取最外层 GRU 的隐藏状态
    Q = self.linear_q(query).unsqueeze(1)                   # (B, 1, H)
    K = self.linear_k(encoder_output)                       # (B, S, H)
    V = self.linear_v(encoder_output)                       # (B, S, H)
    scores = torch.bmm(Q, K.permute(0, 2, 1)) / (self.hidden_size ** 0.5)   # (B, 1, S)
    if src_pad_mask is not None:
        scores = scores.masked_fill(src_pad_mask.unsqueeze(1), -1e9)        # PAD 位置打 -∞
    attention_weights = F.softmax(scores, dim=-1)           # (B, 1, S)
    context = torch.bmm(attention_weights, V)               # (B, 1, H)
    return context.squeeze(dim=1), attention_weights.squeeze(dim=1)
三句话记住它:
- 它是乘法(缩放点积)注意力,不是加法注意力。虽然挂着 Bahdanau 风格的
Wq/Wk/Wv三个投影层,打分方式是QKᵀ/√H+ softmax,属于 Luong 那一支。与 Transformer 的 cross-attention 相比,它只差”多头”和”层数”。 - 掩码是必须的:源句里的 PAD 不该被注意(否则
i love you后面 6 个 PAD 会分走注意力权重),masked_fill(..., -1e9)把它们的分数压到 softmax 后约等于 0。这与 day08 里的src_key_padding_mask是同一件事。 masked_fill用-1e9而不是-inf,是为了避免整行都被 mask 时出现nan,工程惯例。
4.8 Decoder:拼接上下文再进 GRU
embed = self.embed(target).squeeze(1)                    # (B, 1) → (B, 512)
x = torch.cat([embed, context], dim=-1)                  # (B, 512+512) = (B, 1024)
x = self.linear1(x).unsqueeze(1)                         # (B, 1024) → (B, 512) → (B, 1, 512)
output, hidden = self.gru(x, last_hidden)                # (B, 1, 512) + (1, B, 512)
logits = self.linear2(output.squeeze(1))                 # (B, vocab_target=4346)
顺序很重要:先把词向量和上下文拼接、再降维回 512、再进 GRU(不是先 GRU 再拼上下文)。这样 linear1(1024→512) 相当于一个融合门,让 GRU 一次性看到”当前输入词 + 当前该看源句哪里”。
linear1 的参数量 (512+512)×512+512 = 524,800,是解码器里最便宜的部件。
4.9 训练:teacher forcing 与”忽略 PAD”的两处细节
for i in range(1, seq_len):
    context, _ = self.attention(encoder_output, decoder_hidden, src_pad_mask)
    logits, decoder_hidden = self.decoder(decoder_input, decoder_hidden, context)
    all_logits[:, i, :] = logits
    if random.random() < teacher_forcing_ratio:              # 概率 p 用真实词
        decoder_input = target[:, i].unsqueeze(1)            # (B, 1)
    else:
        decoder_input = logits.argmax(dim=-1).unsqueeze(1)   # 用自己上一拍的预测
return {"logits": all_logits}
两个极易看漏的对齐细节:
all_logits初始化成全 0,循环从i=1开始,所以第 0 列永远是占位符,与之匹配的损失计算里必须同时切掉第 0 列:y_logits = y_logits[:, 1:, :]、y = y[:, 1:]。形状对得上,语义也对得上(第 i 拍输入的是<SOS>或 target[i-1],要预测的是 target[i])。- 训练循环在时间维上是串行的:即使 teacher forcing 已经把真实目标词喂进来了,代码仍然一拍一拍地跑 GRU。这既是不加
nn.Transformer就无法并行的直接原因,也是”重复计算 Attention”的地方。
损失与准确率(两者都在 token 级、都忽略 PAD):
loss_fn = nn.CrossEntropyLoss(ignore_index=vocab_target.get('<PAD>', 0))   # PAD 不进损失
mask = y != pad_idx                                                        # 也不算准确率
total_loss   += loss.item() * num_tokens                                   # 按有效 token 加权
total_correct += ((y_logits.argmax(dim=-1) == y) & mask).sum().item()
return total_loss / total_tokens, total_correct / total_tokens
为什么要按 num_tokens 加权而不是按 batch 求平均?因为不同 batch 的有效 token 数不同(短句多的 batch 有效 token 少),直接对 loss 取平均会让”短句 batch”权重过大。加权后再除总 token 数,才是真正的”token 级平均损失”。这一步很多实现会写错。
超参数与优化器:BATCH_SIZE=128、EMBED_SIZE=HIDDEN_SIZE=512、EPOCHS=25、LR=1e-4、AdamW(weight_decay=0.01)、按最小验证损失保存 ./model/my_rnn.pth。
4.10 推理:从 <SOS> 走到 <EOS>
decoder_input = torch.full((batch_size, 1), vocab_target.get('<SOS>', 1), dtype=torch.int64)
for i in range(MAX_LENGTH - 1):
    context, _ = self.attention(encoder_output, decoder_hidden, src_pad_mask)
    logits, decoder_hidden = self.decoder(decoder_input, decoder_hidden, context)
    y_pred = logits.argmax(dim=-1)
    decoder_input = y_pred.unsqueeze(1)                       # 用预测值喂下一拍
    if (y_pred == vocab_target.get('<EOS>', 2)).all():        # 整个 batch 都到 EOS 才停
break注意最后一行:(y_pred == <EOS>).all() 要求整个 batch 同时生成 <EOS> 才跳出循环,否则跑满 MAX_LENGTH-1 = 11 拍。这是一个教学简化,真实的批量推理要给每条样本单独记长度、或用 finished mask 把已结束的样本屏蔽掉。单样本预测(predict())时 batch=1,这个条件才等价于”遇到 EOS 就停”。
另外,predict() 里是 vocab_source.get(token, 0),没有调用 clean_text:直接喂 "I love you" 或带标点的句子,大写词和标点会全部命中兜底的 index 0(也就是 <PAD>),结果直接崩掉。复现实验时先清洗输入。
4.11 实测数据:25 个 epoch 的日志(真实运行输出)
| epoch | train_loss | train_acc | val_loss | val_acc | time |
|---|---|---|---|---|---|
| 1 | 5.8887 | 0.2335 | 4.5594 | 0.2157 | 2.95s |
| 5 | 3.6406 | 0.4155 | 3.7978 | 0.3526 | 2.75s |
| 12 | 2.9674 | 0.5041 | 3.3198 | 0.4495 | 2.86s |
| 20 | 2.5093 | 0.5472 | 3.0965 | 0.4830 | 2.83s |
| 25 | 2.2613 | 0.5773 | 3.0105 | 0.4934 | 2.84s |
(每轮 67 个 batch,即 8474 / 128;训练曲线在课程里另存为 ./image/train_loss02.png,本抽取稿未引用该图。)
- 最优模型出现在第 24 轮:最小验证损失 3.0049,对应验证准确率 0.4905。
- 测试集:准确率 0.4985 / 损失 2.9835,自回归模式(
teacher_forcing_ratio=0.0)。 - 预测演示:输入
i love you→ 输出je ne vais je me ai ai ai ai ai .。 - BLEU:14.03。
这个 ai ai ai ai ai 的重复退化是自回归生成最典型的失败模式,成因是”曝光偏差 + 贪心解码 + 没有长度/覆盖惩罚”三者叠加,而不是单纯的”训练不够”。
五、易错点与常见误解
-
常见说法:课件说按
0.9/0.05/0.05拆分数据集;实际上,实际跑出来是8:1:1。
抽取稿正文和代码注释都写(0.9/0.05/0.05),但代码里split_pairs(pairs, train_ratio=0.8, val_ratio=0.1)的默认值是 0.8/0.1,日志打印的8474 / 1059 / 1060(总数 10593)正是 8:1:1。以运行日志为准。这在被追问时是个加分细节:能说清”文档与实际配置不一致时,看日志”。 -
有人以为 token 准确率 0.4985,说明翻译能看;实际上,完全不能看。
同一模型同一测试集 BLEU 只有 14.03,实际输出je ne vais je me ai ai ai ai ai .。原因:token 级指标里高频功能词(je、ne、.)权重极大,蒙对这些词就能刷分;而且它按位置逐词比对,词序错了、句子不合法都不扣分。翻译质量必须看 BLEU(或 chrF/COMET),并且要人看几条样例。课件自己也标注了”token accuracy ≠ 翻译质量”。 -
常听到的一种说法是:训练和评估都用 teacher forcing;实际上,训练用 0.5,验证/测试/预测必须用 0。
验证集如果也喂真实词,指标会明显虚高,且你永远发现不了曝光偏差。day08 的对照组给足了证据:同一个训练好的模型,teacher forcing 模式测试准确率 0.7431 / 损失 1.4538,自回归模式 0.6097 / 3.2650,13 个百分点的差距全是”作弊”刷出来的。 -
容易想岔的地方:Attention 权重可以直接当”模型为什么这么翻”的解释;实际上,只能当线索,不能当因果。
这里的attention_weights形状是(B, S),是单头、单层的软对齐;权重是”这一拍该看源句哪几个位置”的相关性度量,不是归因证明。被追问”注意力可解释性”时,正确说法是”它提供了可观测的对齐信号,比如可以画出je ↔ I、aime ↔ love的对角线,但不能声称它是推理过程的完整解释”。 -
先说一个误解:
<PAD>也得老老实实参与训练;实际上,padding_idx=0+ignore_index=0+ mask 三件套都要。
padding_idx让 PAD 的 embedding 向量固定为全 0 且不更新梯度;CrossEntropyLoss(ignore_index=0)让 PAD 位置不产生损失;mask 让 PAD 不进准确率。少任何一个,模型都会去学”预测填充符”这种无意义目标,还会污染平均损失。 -
常见说法:未知词会走到
<UNK>;实际上,这份代码里未知词会退化成一个被掩盖掉的 PAD。
SPECIAL_TOKENS只有<PAD>/<SOS>/<EOS>三个符号(没有<UNK>),而所有兜底都写成vocab_source.get(token, 0)、vocab.get('<unk>', 0),也就是兜底到 index 0 =<PAD>。训练时因为词表就是从全量数据建的,不会触发;但predict()里一旦喂进新词,它会被当成 PAD,然后被 Attention 的 mask 挡掉、被损失忽略,表现为”这个词凭空消失”。真实工程必须显式加<UNK>。 -
有人以为梯度裁剪是这套代码的一部分;实际上,课件代码里根本没有梯度裁剪。
第 7 节的高频题自己问了”为什么常用梯度裁剪(防止长序列反传梯度爆炸)”,但train_one_epoch里只有zero_grad → backward → step,没有clip_grad_norm_。这是课件”讲了但没做”的一处落差:本数据集句子最长 9 个词,梯度爆炸不明显,所以能训;换长序列就必须补上。 -
常听到的一种说法是:每轮 2.8 秒说明 RNN 比 Transformer 快;实际上,要看 batch size 和参数量,不是看秒数。
day09 是batch=128、67 个 batch、约 2.75–2.95s/轮;day08 是batch=64、133 个 batch、约 8s/轮(tqdm 计时)。按”每样本耗时”折算,day08 反而慢约 3 倍,因为它有 6 层 512 维、约 3 倍参数量,而句子只有 ≤12 个 token,Transformer 的并行优势根本施展不开。结论:并行性是”序列变长、数据变大时不爆炸”的优势,不是”小玩具上更快”。这个反直觉的点很容易在被追问时翻车。 -
容易想岔的地方:训练时用串行解码是性能问题,只是慢一点;实际上,它是架构性的。
RNN 的h_t依赖h_{t-1},时间维无法并行;代码里训练循环还必须一拍一拍地调 Attention + GRU。Transformer 在 teacher forcing 下可以把整个目标序列一次喂进去算完(配合因果掩码)。这是”同样 25 个 epoch、同样数据,能不能用更大 batch 吃满 GPU”的根本差别。 -
先说一个误解:输入随便写,模型自己会处理大小写;实际上,
predict()不做清洗。
predict()只做text.split()后查表,兜底 index 0。必须自己先clean_text()(或至少.lower())再喂。课件演示用的i love you正好是全小写无标点,才没暴露这个问题。 -
常见说法:课件里 DEVICE 的写法只有一种;实际上,有两套,别混。
课件开头的环境准备示范是cuda > mps > cpu三级回退(照顾 Mac),而案例代码正文里写的是cuda if available else cpu,Mac 上跑会退到 CPU(2.8s/轮也说明日志机器在 GPU 上;测试集进度条 9/9 与 batch 128 吻合)。 -
有人以为
MAX_LENGTH=12太短,肯定被截断;实际上,本数据集最长 9 词,一次都截不到。
但代码是先sequence[:max_length-2]再拼<SOS>/<EOS>,所以一旦数据里出现 11 词以上的句子,尾部会被静默截断(连<EOS>都不给就丢词)。换数据集时必须重新统计长度分布再定MAX_LENGTH,或改成动态 padding +pack_padded_sequence。
六、横向对比与研究脉络
6.1 三列对比:RNN Seq2Seq / RNN+Attention / Transformer
| 维度 | RNN Seq2Seq(无 Attention) | RNN Seq2Seq + Attention(本案例) | Transformer(day08 案例) |
|---|---|---|---|
| 上下文如何给解码器 | 只有最后一步 h₉:一个固定 512 维向量 C |
每拍动态算 C_t = Σ α_t V,K/V 来自全部 encoder_output |
每拍 cross-attention,多头×6 层,K/V 为整个 memory |
| 关键代码差异 | 解码器只接 (target, hidden) |
多一个 MyAttention:context = bmm(attn, V),解码器入口变成 cat([embed, context]) → linear1(1024→512) |
内置 nn.Transformer + 三套 mask:src_key_padding_mask、tgt_key_padding_mask、因果 tgt_mask |
| 隐藏状态传递 | decoder_hidden = encoder_hidden,之后不再变 |
同左,但每拍 query = decoder_hidden[-1] 参与打分 |
无隐藏状态传递;位置信息靠可学习位置编码(max_len=32)显式补进去 |
| 训练时时间维并行性 | 串行(h_t 依赖 h_{t-1}) |
串行,且每拍多一次 Attention 计算 | 编码器完全并行;teacher forcing 下解码器可整段一次算完(因果掩码防偷看) |
| 源端信息的传递路径 | O(T) 步递归 | 1 步(直接连到任意源位置) | 1 步(每层每头都有直连) |
| 位置/顺序信息 | 隐含在递归顺序里 | 同左 | 需显式注入(本课程用 nn.Embedding(max_len, d_model)) |
| 单步复杂度 | O(d²) | O(d² + T·d) | 每层 O(T²d + T·d·d_ff),6 层 |
| 本案例实测规模(手算参数量) | — | 约 10.35M(embedding 3.66M + 两个 GRU 3.15M + Attention 0.79M + linear1 0.52M + linear2 2.23M) | 约 31.1M(6 层×4.20M + embedding 3.66M + 位置编码 0.03M + 输出层 2.23M),约为前者 3.0 倍 |
| 本案例实测效果(同数据、同 25 epoch) | 课件未提供数字 | 自回归测试 acc 0.4985 / loss 2.9835 / BLEU 14.03;i love you → je ne vais je me ai ai ai ai ai . |
自回归 acc 0.6097 / loss 3.2650;teacher forcing 模式 acc 0.7431;BLEU 35.74;i love you → je vous vous . |
| 单轮耗时(本机) | — | 67 个 batch / 约 2.8s | 133 个 batch / 约 8s(batch 64) |
| 适合场景 | 短句、教学演示、理解 seq2seq 思想 | 中等长度序列、需要可观测对齐、数据量小、无法上预训练 | 大数据、长序列、需要并行训练、后续可接预训练(BERT/GPT 家族) |
| 主要痛点 | 固定向量瓶颈,长句崩坏 | 递归无法并行,长程仍要靠 GRU 传递 | 需要更多数据和算力;位置编码/掩码写错就静默失效 |
说明:两个案例的数据完全相同(
eng-fra-v2.txt,10593 对,源词表 2804 / 目标词表 4346,拆分 8474 / 1059 / 1060),因此这一列对照是可比的。参数量为按代码结构手算(环境无 torch,未实际实例化统计),耗时取各自日志/进度条口径,batch 不同已在表内注明。
6.2 为什么中间那一版会赢(它赢的是左边,不是右边)
“RNN + Attention” 相对”纯 RNN Seq2Seq”的胜利,可以拆成三条互不重叠的理由:
- 它把”一个点”换成了”一条可查询的记忆”。纯 Seq2Seq 的
C是固定的:无论解码到第几个词,源句信息都只能从同一个h₉里取。Attention 把encoder_output的S个向量全留在手上,每拍用query去检索一次,解码第 3 个词时可以直接”看”源句第 3 个词,而不是去那个 512 维的压缩包里面猜。 - 梯度路径变短,长程依赖被救回来了。纯 Seq2Seq 里,源句第 1 个词的梯度要穿过 9 步递归才能到输出;加了 Attention 后,
α_{t,1}·V_1是一条”一步到位”的路径,梯度可以直接落到源端每个位置。这是”缓解梯度消失”在架构层面的做法,比换 LSTM 更根本。 - 性价比极高,几乎没有代价。只多了
Wq/Wk/Wv三个 512×512 线性层,约 0.79M 参数,占全模型 10.35M 的 7.6%,解码时每拍多一次bmm((B,1,512)×(B,512,S))。
反过来说,它并没有赢右边的 Transformer:本案例 BLEU 14.03 vs day08 的 35.74。原因不是”Attention 不够好”,而是 Attention 只被装进了一个仍在递归的骨架里:
- 信息依旧要沿 GRU 的递归路径逐拍传递,源端与目标端的直连只在最后那一次注意力里发生;
- 时间维不能并行,训练吞吐被锁死在小 batch 和串行循环上;
- Attention 只有单头、单层,只能表达一种”软对齐”,无法像多头那样同时关注语法位置、词形、语序等不同子空间;
- 没有预训练,两边都是从零训练,谁更快学到语言学规律谁就赢。
一句可以直接背的话:”Attention 解决的是’看得到’的问题,Transformer 解决的是’算得快、并行得起来’的问题;day09 证明了前者能补 RNN 的短板,day08 证明了后者才是终点。”
6.3 演进脉络(只写有把握的)
RNN Encoder–Decoder(Cho et al., EMNLP 2014;Sutskever et al., NIPS 2014)
   问题:固定长度上下文 C 塞不下长句 —— "信息瓶颈"
        │
        ▼   加法注意力(Bahdanau et al., ICLR 2015)/乘法注意力(Luong et al., EMNLP 2015)
RNN + Attention(本案例的架构:GRU 递归 + Wq/Wk/Wv + softmax(QKᵀ/√H))
   问题:递归不可并行、长程依赖仍靠 RNN 传递、层数堆不深
        │
        ▼   只保留注意力,彻底删掉递归
Transformer(Vaswani et al., NIPS 2017)—— 靠多头自注意力 + 位置编码 + 残差/LayerNorm
        │
        ▼   把 Transformer 当"预训练骨架",换任务头
BERT / GPT 家族 → 微调(本项目直接上 BERT 的那一步)
沿着这张图看 day08/day09 的关系就清楚了:day09 是”注意力诞生时”的形态,day08 是”注意力取代递归后”的形态,两者用的是同一份数据和同一套评估(BLEU)。项目里那套 BLEU 评估函数(简化版 corpus BLEU:n-gram 裁剪计数 + 长度惩罚 BP + 平滑)在两个案例里是同一份代码,它本身就是这段演进史留下的工程遗产:BLEU 是 2002 年为统计机器翻译设计的指标,神经网络时代仍在沿用(详见 day08 材料的 BLEU 扩展章节)。
七、在新闻分类项目中的落地
项目背景:类今日头条的新闻分类模块,把标题分成 10 类;数据 18w 训练 / 1w 验证 / 1w 测试,格式
标题\t标签;路线是 TF-IDF + 随机森林 → FastText → BERT 微调 → LLM 零样本/少样本;部署 Flask + Streamlit;最后做量化/蒸馏/剪枝。
这份材料在项目里的角色不是”用得上”,而是”解释了为什么不用它”。
7.1 为什么新闻分类项目直接上 BERT,而不走 Seq2Seq 路线
第一,任务形态根本不同。Seq2Seq 是生成式架构:输入序列 → 输出序列,输出空间是 词表^长度(这里 4346^11),所以它需要自回归解码、需要 BLEU、需要 beam search。新闻分类是判别式任务:输入标题 → 10 个类别之一,输出空间只有 10。用生成式模型解分类,等于把”选一个”硬写成”生成一个标签字符串”,多花几十倍算力去解一个本来有闭式答案的问题(推理要 11 步串行前向,而 BERT 一次前向就够)。
第二,这份材料给出了”从零训练”的代价,而且是实测数字。day09 用 10593 个句对、25 个 epoch、10.35M 参数,从零学英法对齐,最终 BLEU 14.03、输出还在 ai ai ai ai ai 打转;day08 换成 Transformer 也只到 35.74。两者都没有预训练权重,都要靠 1 万句数据自己悟出词形、语序、对齐。对比之下,BERT 是”大规模语料预训练 + 下游一个线性分类头微调”的路线,语义先验是白送的,你只需要教它”这 10 个类怎么分”。项目的 18w 标注数据放在生成任务里是杯水车薪,放在判别式微调里是充足的。
第三,评估指标和业务指标能对上。Seq2Seq 这一路只能拿 token accuracy / BLEU 说话(而且这俩还会互相打架:0.4985 的 token acc 换来 14.03 的 BLEU)。分类任务直接用准确率、宏平均 F1、混淆矩阵,哪个类被误判一目了然,被追问时能把”指标 → 业务含义”讲通,比多刷一个模型更加分。
第四,如果真要在项目里用 Seq2Seq,唯一说得过去的用法是”生成式分类”:把类别名当词去生成(标题 → "体育"),或者用 T5/BART 做”文本到文本”。这条路的问题在于标签词的语义噪声、解码结果不一定是合法类别(要额外做约束解码)、概率校准困难、推理慢,且对 10 类新闻标题这种”特征词强、类别边界清晰”的任务纯属杀鸡用牛刀。被追问时的标准答法是:”我评估过生成式路线,最终选 BERT 是因为这是判别式任务、数据规模在 18w 量级、且我需要概率可校准、推理延迟可控,Seq2Seq 那套在我课程里跑过,10.35M 参数、25 轮、BLEU 14,成本收益不成比例。”
7.2 但它的工程件有四处可以原样搬到项目里
- 数据清洗 → 词表 → Dataset/DataLoader 的作业流。
clean_text的多条正则(小写化、标点独立化、非法字符替换)、”两套词表 + 特殊符号占位 0/1/2″的约定,跟项目里 TF-IDF 的 749 个停用词处理、FastText 的__label__标签名 文本格式,是同一类”把脏文本变成模型可吃的分布”的工作。差别只是词表由build_vocab手写、还是交给TfidfVectorizer/train_supervised内部处理。 - PAD 三件套的思想可以平移。
padding_idx+ignore_index+ mask,在项目里对应的就是”短标题补齐到统一长度后,别让补齐位参与统计”。FastText/BERT 内部替你做了,但被问到”变长序列怎么处理”时,这份材料给了你从pad_sequence到pack_padded_sequence的完整答案。 - 训练循环的”斌子法则”完全一致:加载配置 → 准备数据/模型/损失/优化器 → 外层轮次 + 内层批次 → 前向 → 算损失 → 梯度清零 → 反向 → 更新 → 保存。day09 只是把”保存模型”具体化成按最小验证损失存 best(
if val_loss < min_val_loss: torch.save(state_dict)),这就是项目里 BERT 微调要照抄的一段。 - 超参选型经验:
AdamW(lr=1e-4, weight_decay=0.01)、EMBED=HIDDEN=512、batch 128、25 epochs,配合”学习率小、轮次少、靠验证集挑最优”。BERT 微调通常把 lr 再降一档(2e-5~5e-5 量级)、max_len 取 64~128、batch 16~32,但”小学习率 + 早停 + 存 best”这套骨架是同一套。
7.3 与项目里其它方案的配合关系
- 与 TF-IDF + 随机森林:这条路线是项目最快能跑通的下限基线;day09 提供的是另一个下限, “从零训练的深度模型”的下限。两者合起来说明一件事:没有预训练/没有好特征时,模型再复杂也白搭。
- 与 FastText:FastText 用
train_supervised()在__label__格式上几分钟出结果,test()直接返回(样本数, 精确率, 召回率);day09 要 25 轮 × 67 个 batch 去追一个 14 分的生成指标。这个对比就是”选对任务范式比选对模型结构重要”的最好素材。 - 与 BERT:day08/day09 是”无预训练上限”的实证;BERT 是”预训练免费送你语义先验”。项目里 BERT 微调能到远高于前两条路线的水平,一部分功劳属于数据规模 + 预训练,不完全是”Transformer 更强”,把这一点讲清楚,评审者会觉得你真做过实验。
- 与模型压缩(量化 QAT/PTQ/DQ、蒸馏、剪枝、低秩分解):day09 的 RNN 只有约 10.35M 参数,整体还是参数最少的那个,但它的瓶颈不在参数量而在串行解码延迟,量化/剪枝救不了自回归的 11 步串行前向,这也是项目压缩对象选 BERT(判别式、单次前向)而不是生成模型的隐含理由。项目里 BERT 压缩完仍要接 Flask 服务,用到的”保存格式选择 + 验证集选最优”流程与这里完全一致。
八、重点问答
Q1:Seq2Seq 编码器-解码器的基本思想是什么?
A:一句话概括就是”先把整句话读懂,再一个词一个词地写出来”。编码器是一个 RNN/GRU/LSTM,把源句逐词读进去,最后一个时间步的隐藏状态就当作整句的语义摘要;解码器是另一个 RNN,从这个摘要出发,每一步预测一个目标词,再把预测出的词喂回去,直到生成 <EOS>。训练时要给解码器一个起始符 <SOS>,还要把句子补齐到固定长度、并且把 <PAD> 从损失和准确率里挖掉。这个结构在 day09 里的实现就是四个类:MyEncoder、MyAttention、MyDecoder、MyEncoderDecoder,编码器的 hidden 直接赋给解码器当初始隐藏状态。
Q2:为什么在 RNN 翻译里需要注意力机制?
A:因为纯 Seq2Seq 有一个固定长度上下文瓶颈。源句不管多长,都被压成一个 512 维的向量,解码到第几个词时都只能从这个向量里取信息,句子一长就丢词、错序。加了注意力以后,编码器每一个时间步的输出都留着,解码器每一步用当前隐藏状态当 query,去和所有编码器输出算相似度、softmax 成权重、再加权求和成当步的上下文 C_t。这样第 3 个目标词可以直接”看”源句第 3 个位置,而不是去压缩包里猜。而且它很便宜:本案例只多了三个 512×512 的线性投影,约 0.79M 参数,占全模型 10.35M 的 7.6%。
Q3:训练 RNN 翻译模型时为什么常用梯度裁剪?
A:因为长序列反向传播时梯度要连乘很多次,容易出现梯度爆炸,训练直接发散成 nan。梯度裁剪就是把所有参数的梯度拼起来算一个总范数,超过阈值就整体按比例缩回去,保证单步更新幅度有上界。它是长序列训练的保险丝,配合小学习率和 zero_grad → backward → step 的标准流程用。顺便说一个观察:我课程里这个案例的代码其实没有加裁剪,因为数据最长只有 9 个词,不太会爆;但被问到我会明确说,换成长序列或层数更深的模型就必须补上。
Q4:变长序列训练常见处理方法有哪些?
A:主流是两条路。第一条是 padding + mask:先统计长度分布定一个 MAX_LENGTH,短的补 <PAD>、长的截断,然后在三处把填充位挖掉,embedding 用 padding_idx=0、损失用 CrossEntropyLoss(ignore_index=0)、准确率和注意力分数用 mask。本案例最长句 9 个词,MAX_LENGTH 取 12 就刚好够(9 加 SOS/EOS 加一点余量),一次都没截断。第二条是 pack_padded_sequence / 动态 batch,把同一批里长度相近的句子放在一起,避免为填充位做无效计算。前者实现简单,后者在大 batch 下更省算力。
Q5:Teacher Forcing 在 RNN 翻译中的利弊是什么?
A:好处是训练快、稳定:每一步都喂真实的上一个词,模型不用在早期就学”怎么从自己的错误里爬出来”,收敛明显更快更稳。坏处是训练和推理由此不一致,推理时你只有自己预测的词,一旦早期预测错,误差会沿自回归链放大,这就是曝光偏差;表现出来就是训练 loss 降得很漂亮、自回归测试指标却差一截。本案例训练用 TEACHER_FORCING_RATIO=0.5、验证和测试强制置 0 就是个折中。我在 day08 的对照实验里见过落差:同一个模型 teacher forcing 模式测试准确率 0.7431、自回归只有 0.6097,差 13 个点,所以调模型时必须用自回归指标来选。
Q6:为什么”RNN + Attention”比”纯 RNN Seq2Seq”明显更好?它又比 Transformer 差在哪?
A:赢在三点:把固定向量换成了可随时检索的记忆,解码每一步都能看到源句全部位置;源端到输出多了一条一步直达的梯度路径,长程依赖被救回来;代价只有三个线性层、约 0.79M 参数,性价比极高。但它没赢 Transformer:注意力被装在递归骨架里,时间维不能并行,长程信息仍要沿 GRU 逐拍传递,注意力只有单头单层,而且两边都是从零训练、没有预训练先验。我课程两份材料用的是完全一样的数据和 25 个 epoch:RNN+Attention 的 BLEU 是 14.03,Transformer 是 35.74,token 准确率 0.4985 对 0.6097,参数量约 10.35M 对 31.1M。所以结论是”注意力解决看得到,Transformer 解决算得快”。
Q7:为什么 token 准确率不能当翻译质量的评价指标?
A:因为它只按位置比对词,不看句子是否合法、词序是否通顺。中高频功能词占比很大,蒙对 je、ne、. 就能把分数抬上去。我这个案例的实测就是典型:token 准确率 0.4985 看着还行,BLEU 只有 14.03,而输入 i love you 的实际输出是 je ne vais je me ai ai ai ai ai .,明显是重复退化。真实机器翻译评估要用 BLEU 这类基于 n-gram 重合度加长度惩罚的指标,或者 chrF、COMET,并且一定要人看几条样例。所以我课程里专门实现了简化版的 corpus BLEU:n-gram 裁剪计数、BP 长度惩罚、高阶命中为 0 时加平滑,最后乘 100 输出分数。
Q8:你们项目是新闻分类,为什么不用 Seq2Seq 这套生成式架构,直接上 BERT?
A:因为任务范式不一样。分类是判别式任务,输出空间只有 10 个类别;Seq2Seq 是生成式,输出空间是”词表的长度次方”,还得自回归解码、要 BLEU、推理要好几步串行前向,用生成模型解分类是杀鸡用牛刀,而且解码结果还不保证是合法类别。更关键的是成本:我在课程里跑过 Seq2Seq,10593 个句对从零训练 25 轮,10.35M 参数换来 BLEU 14.03;换成 Transformer 也只有 35.74,都是没预训练的代价。BERT 走的是”大规模预训练 + 下游线性分类头微调”,语义先验是白送的,18w 标注数据在判别式任务里够用,评估用准确率和宏 F1 也直接对得上业务。所以我选 BERT,但我会把所有基线都跑一遍,正是这些基线数字让我能说清这个选择。
九、延伸阅读
经典论文(按演进顺序)
- Cho et al., Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation, EMNLP 2014,提出 RNN Encoder–Decoder 框架与 GRU。
- Sutskever, Vinyals, Le, Sequence to Sequence Learning with Neural Networks, NIPS 2014,奠定”编码一个序列、解码出另一个序列”的范式,并讨论了长句信息瓶颈。
- Bahdanau, Cho, Bengio, Neural Machine Translation by Jointly Learning to Align and Translate, ICLR 2015,加法注意力,对齐与翻译联合学习。
- Luong, Pham, Manning, Effective Approaches to Attention-based Neural Machine Translation, EMNLP 2015,乘法/缩放点积注意力与多种对齐函数,本案例的打分方式属于这一支。
- Vaswani et al., Attention Is All You Need, NIPS 2017,彻底去掉递归,day08 案例的架构来源。
- Papineni et al., BLEU: a Method for Automatic Evaluation of Machine Translation, ACL 2002,BLEU 的原始定义(n-gram 裁剪计数 + 长度惩罚)。
官方文档与工具
- PyTorch
nn.GRU/nn.Embedding文档(注意batch_first、padding_idx与返回的(output, hidden)语义)。 - PyTorch
nn.CrossEntropyLoss(ignore_index的用法)、torch.nn.utils.rnn.pack_padded_sequence/pad_packed_sequence(变长序列的高效实现)。 - PyTorch
torch.nn.utils.clip_grad_norm_(梯度裁剪,本案例未使用)。 torch.utils.data.Dataset/DataLoader、sklearn.model_selection.train_test_split。
数据与配套
- 数据集:
data/eng-fra-v2.txt,制表符分隔的英法句对,10593 对(清洗去重后),句子对风格与 Tatoeba 的 eng-fra 双语语料一致。 - 同目录对照材料:
day08_Transformer英译法案例.原文.md(同一数据、同一评估的 Transformer 版)、day06_attention_seq2seq.png(本报告引用的架构图,标题指向 day06 注意力章节,day09 案例复用它作结构图)、day10_FastText工具介绍.原文.md(分类任务的快速基线)。 - 本案例产出的训练曲线图
./image/train_loss02.png、模型参数文件./model/my_rnn.pth(由代码在运行时生成,未包含在抽取稿的图片清单中)。