把「模型好不好」从一句含糊的准确率,拆成一张能看清「错在哪」的混淆矩阵,以及精确率 / 召回率 / F1 这一整套分类评估语言,被问到「你怎么评估模型」时的标准答案素材。
一、这份材料解决什么问题
模型训练完,屏幕上跳出 accuracy: 0.97,然后呢?这个数字既不能告诉你模型错在哪,也不能告诉你错得有多致命。一份 10 类新闻标题分类任务里,把「娱乐」判成「体育」和把「科技」判成「财经」,业务代价可能完全不同;如果某个类只占测试集的 2%,模型把它整类放弃,准确率照样很好看。
这份材料要解决的就是这个「评估层」的问题,路径是:先看一张错在哪的表(混淆矩阵)→ 拆出四个格子的含义(TP/FP/FN/TN)→ 定义两个互补的指标(精确率 / 召回率)→ 用调和平均合成一个数(F1)→ 再看阈值扫描出来的曲线(PR 曲线)→ 最后回到一张真实的热力图去定位问题类别。
在新闻分类项目这条流水线里的位置非常明确:项目要用 TF-IDF + 随机森林 → FastText → BERT 微调 → LLM(DeepSeek API 零样本/少样本) 四条路线做同一个 10 分类任务,横向对比的唯一「尺子」就是这套指标。FastText 的 test() 直接返回 (样本数, 精确率, 召回率);随机森林和 BERT 要自己拿 y_pred 算;LLM 零样本分类把标签映射回来后,同样要算这套指标才能和前面三个模型放在一张表里。调阈值、设 class_weight、判断模型压缩(量化/蒸馏/剪枝)之后精度掉在哪个类上,全都回到这份材料的基本功。
材料是 6 页的「理解」级课件:一个 4×4 新闻类混淆矩阵、一张 TP/FP/FN/TN 命名表、一张三维 F1 曲面、一张 PR 曲线、一张归一化混淆矩阵热力图。直觉和数值都有,推到工程细节(多分类汇总口径、不平衡数据看哪条曲线)的部分由本报告补齐。
二、核心结论
- 混淆矩阵是评估的「真相表」:行是模型预测,列是真实类别;对角线上是判对的,非对角线是错判且指出了「错到哪去了」。例:材料里 4×4 矩阵的对角线是 10、12、11、15,总共 70 条样本,准确率 48/70 \approx 68.6\%。
- 准确率是全局量,会被大类绑架:1000 条样本里只有 90 条正例时,一个「全部预测为负例」的废模型准确率也有 910/1000 = 91\%,但 F1 = 0。所以不平衡数据上先看混淆矩阵和 F1,再看 accuracy。
- 精确率管误报、召回率管漏报,两者是跷跷板:材料原话是「想抓得更准,就容易漏掉;想抓得更全,就容易抓错」。只调分类阈值的话,提升其中一个必然牺牲另一个;要两个一起涨,只能改模型、加特征、换 loss 或调类别权重。
- F1 是精确率和召回率的调和平均,会惩罚极端:(P,R)=(1.0,0.0) 时 F1 = 0(算术平均还有 0.5),(0.9,0.5) 时 F1 = 0.643 而不是 0.7。它逼着你两边都要拿分。
- 多分类必须说清「怎么平均」:macro(每类等权)/ micro(等于准确率)/ weighted(按样本数加权)在类目倾斜的 10 分类任务上能差出好几个点,这就是新闻分类项目要报 macro-F1 的原因;不平衡的正类检测任务则优先看 PR 曲线 / AUC-PR,而不是 ROC-AUC。
三、知识地图
| 页 | 材料主题 | 关键内容(原始要点) | 考查权重 |
|---|---|---|---|
| 第 1 页 | 混淆矩阵示例 + 公式定义 | 4×4 矩阵(健康 / 金融 / 股票 / 娱乐,行=模型预测、列=真实类别);准确率、精确率、召回率、F1 四个定义式;「每个单独计算,取平均值」;100 人 10 个罪犯的类比 | 【理解】→ 考查重点 |
| 第 2 页 | 四个格子的命名 | 正例(有病)/ 负例(没病)× 正例(预测有病)/ 负例(预测没病)= TP 治对了 / FP 误诊了 / FN 漏诊了 / TN 治对了;字母拆解 T=True、F=False、P=Positive、N=Negative;「正负是相对的」 | 【掌握】 |
| 第 3 页 | 精确率 vs 召回率的直觉 | 精确率是「宁缺毋滥,质量优先」,会让模型不敢预测;召回率是「宁滥毋缺,覆盖优先」,会让模型疯狂预测;两个「不合理情况」:只预测一个健康且对了 → 精确率 100% 但漏一堆;10 个股票全预测出来 → 召回率 100% 但错一堆;所以需要 F1 | 【理解】 |
| 第 4 页 | 阈值与曲线 | 工作中不同类别的精确率 / 召回率关系;「调整分类阈值时,提升精确度必然以牺牲召回率为代价」;Precision-Recall Curve 图 | 【理解】 |
| 第 5 页 | F1 的公式与形状 | F1 = 2 \times (P \times R)/(P+R);F1 三维曲面(x=召回率、y=精确度、z=F1 分数,均取 0\sim1);「F1 会综合召回率和精确度,只有两者同时大的时候,F1 才会更大」;三情形表:不平衡 (1.0, 0.0) → 0;一般 (0.9, 0.5) → 0.64;都好 (0.9, 0.9) → 0.9 | 【掌握】 |
| 第 6 页 | 实战热力图读法 | 归一化混淆矩阵(Confusion Matrix Normalized);「对角线颜色越深说明这个类别分类效果好,不在对角线上的,颜色越深效果越差,得研究研究这个类别了」 |
【掌握】 |
四、原理详解
4.1 混淆矩阵:行是预测、列是真实
混淆矩阵就是给模型做一次「错题本」。它把 \text{真实类别} \times \text{预测类别} 的每一条样本都数进一个格子,于是每一类被「弄混」到哪去了,一眼可见。
材料给的例子是 4 类新闻(健康、金融、股票、娱乐),左侧竖排标签写着「模型预测结果」,顶部横排标签写着「真实类别 labels」,行 = 预测,列 = 真实。列方向求和得到「真实属于该类的样本数」,行方向求和得到「被判为该类的样本数」,这两个数就是后面精确率和召回率的分母。
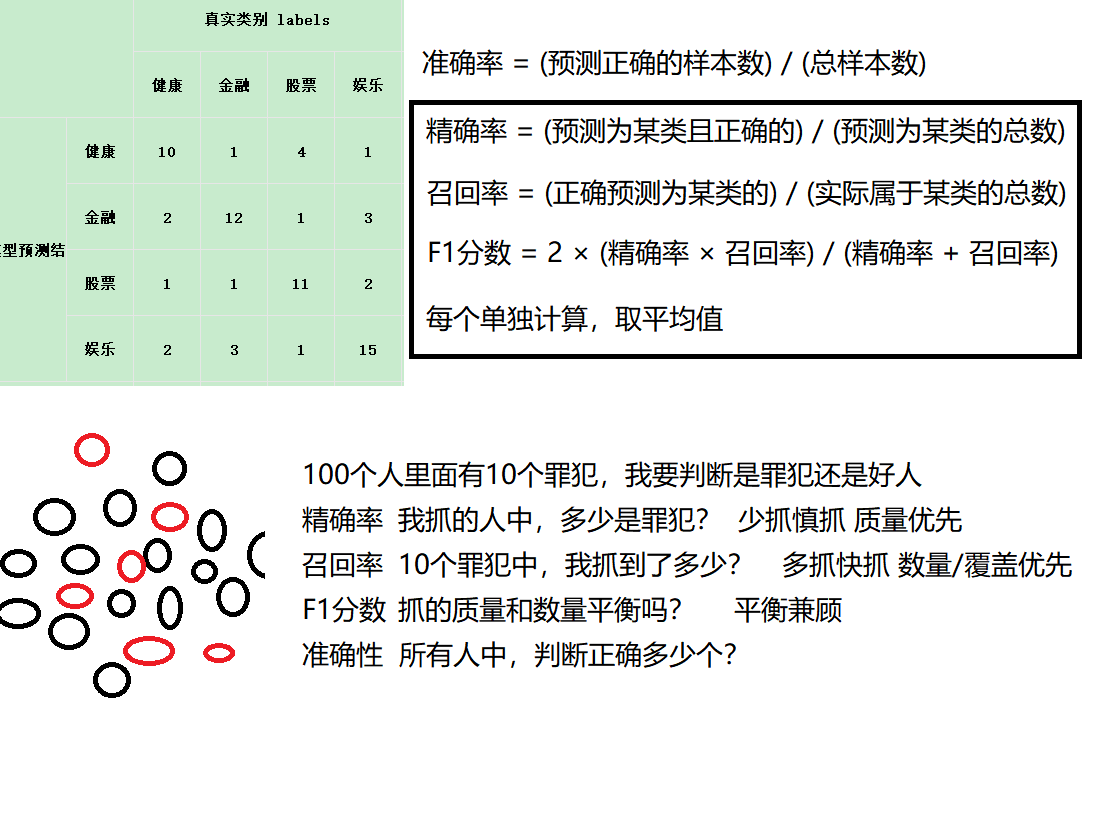
图注:第 1 页的主体。左侧是一张绿底表头的 4×4 混淆矩阵(行=模型预测值、列=真实类别),矩阵右侧贴着四条公式:准确率=(预测正确的样本数)/(总样本数)、精确率=(预测为某类且正确的)/(预测为某类的总数)、召回率=(正确预测某类的)/(实际属于某类的总数)、F1 分数=2×(精确率×召回率)/(精确率+召回率),最下面一行补了一句「每个单独计算,取平均值」。右下角是新闻分类项目里那组类比的原型:100 个人里面有 10 个罪犯,我要判断是罪犯还是好人,精确率「我抓的人中,多少是罪犯?少抓慎抓 质量优先」;召回率「10 个罪犯中,我抓到了多少?多抓快抓 数量/覆盖优先」;F1 分数「抓的质量和数量平衡吗?平衡兼顾」;准确性「所有人中,判断正确多少个?」。矩阵数字:预测为健康 [10, 1, 4, 1]、金融 [2, 12, 1, 3]、股票 [1, 1, 11, 2]、娱乐 [2, 3, 1, 15]。
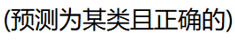
图注:第 1 页公式里「精确率」那一条的分母被单独截出的小图,(预测为某类且正确的),强调精确率的分子只认「预测为该类 且 真实也是该类」的样本。
读图方向提醒(工程上的常见事故):材料这张图是「行=预测、列=真实」,而
sklearn.metrics.confusion_matrix的默认约定恰好相反(行=真实、列=预测)。同一个矩阵按两种方向去读,精确率和召回率会直接互换,结论完全反过来。所以拿到任何一张混淆矩阵,先看轴标题再算数。
4.2 四个格子:TP / FP / FN / TN
二分类里「判断对不对」和「判断成正还是负」是两件独立的事,交叉一下就得到四个格子。材料用医疗场景把它讲透了:有病 / 没病是真实情况,预测有病 / 预测没病是模型行为。
| 正例(有病) | 负例(没病) | |
|---|---|---|
| 正例(预测有病) | TP 治对了 | FP 误诊了 |
| 负例(预测没病) | FN 漏诊了 | TN 治对了 |
字母拆解记忆:T = True(判断正确)、F = False(判断错误)、P = Positive(预测为正例)、N = Negative(预测为负例)。
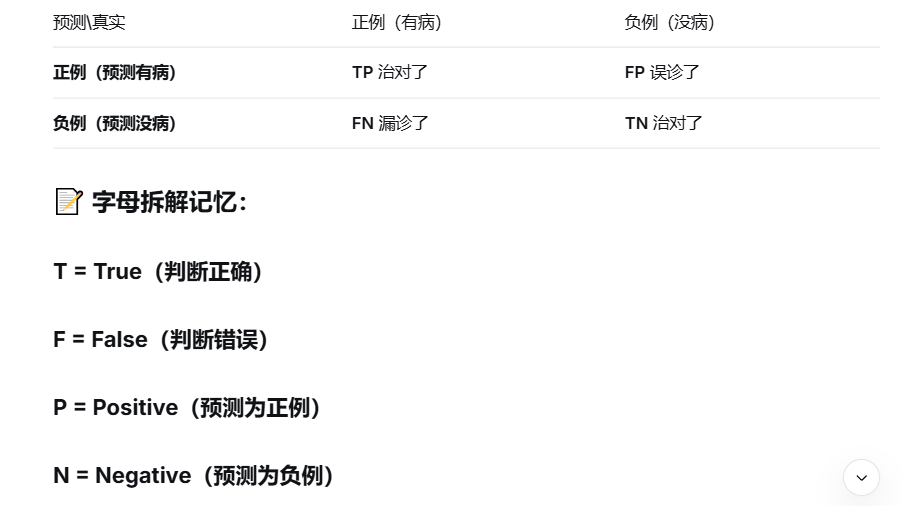
图注:第 2 页的 TP/FP/FN/TN 命名表。左上角表头写作 预测\真实(行=预测结果,列=真实情况),横向两列是「正例(有病)」「负例(没病)」,纵向两行是「正例(预测有病)」「负例(预测没病)」,四个交叉格分别是 TP 治对了、FP 误诊了、FN 漏诊了、TN 治对了;表格下方用四行文字拆字母:T= True(判断正确)、F = False(判断错误)、P = Positive(预测为正例)、N = Negative(预测为负例)。
材料还专门强调了一句关键前提,正负是相对来说的:如果你想预测 A 类,那「模型输出 A」就是正例,模型输出其它任何类都是负例。这一点在多分类里尤其重要:算某一类的精确率/召回率时,永远是把「该类」当正例,其余所有类合并成正例之外的负例,所以 10 分类会得到 10 组 P/R/F1(而不是一组)。
图注:从表格里裁下来的绿色表头单元,真实类别 labels,出现在列方向(横轴),提示横轴读的是「真实类别」。
图注:同一张表格里竖排的绿色表头单元,模型预测结果(截图边缘略有裁切,显示为「型预测结」),出现在行方向(纵轴),提示纵轴读的是「模型预测结果」。这两张碎裂的小图合起来就说明了那 4×4 矩阵两个轴的含义。
4.3 精确率与召回率:误报与漏报的跷跷板
精确率回答「我报出来的,有多少是真的?」;召回率回答「真正该报的,我报出来多少?」。前者怕误报,后者怕漏报。材料用「抓罪犯」把两者的性格写得很传神:
- 精确率 → 宁缺毋滥,质量优先:模型不太敢下判断,免得一抓就错;
- 召回率 → 宁滥毋缺,覆盖优先:模型倾向于疯狂预测,先把东西都捞出来再说。
机制(沿用材料的定义式,注意分母来自哪一边):
\text{Precision} = \frac{TP}{TP+FP} = \frac{\text{预测为该类且正确}}{\text{预测为该类的总数}} \qquad \text{Recall} = \frac{TP}{TP+FN} = \frac{\text{正确预测为该类}}{\text{实际属于该类的总数}}
材料的两个「不合理情况」(为什么单看一个指标会被骗):
- 模型只预测了一个「健康」样本,而且预测对了 → 健康的精确率 = 1/1 = 100\%,可实际上漏了一大堆(召回率极低);
- 标签中一共有 10 个「股票」,模型全都预测出来了 → 召回率 = 10/10 = 100\%,但其中错了一大堆(精确率低)。
一个 100%、另一个惨不忍睹,两个数字单独看都能拿去汇报。所以材料在第 3 页直接给出了动机结论:「综合一下两者,就需要 F1 分数」。
4.4 一条完整的数字演算
先用材料里的 4×4 矩阵全流程算一遍。矩阵(行=预测、列=真实,取自第 1 页 / 第 3 页的表):
| 预测 \ 真实 | 健康 | 金融 | 股票 | 娱乐 | 行合计(预测为该类的总数) |
|---|---|---|---|---|---|
| 健康 | 10 | 1 | 4 | 1 | 16 |
| 金融 | 2 | 12 | 1 | 3 | 18 |
| 股票 | 1 | 1 | 11 | 2 | 15 |
| 娱乐 | 2 | 3 | 1 | 15 | 21 |
| 列合计(实际属于该类的总数) | 15 | 17 | 17 | 21 | 70 |
① 准确率(对角线和 ÷ 总数):
\text{Accuracy} = \frac{10+12+11+15}{70} = \frac{48}{70} \approx 68.6\%
② 以「健康」为例,一步一步算:
- TP = 10(预测健康且真健康,即对角线那一格);
- FP = 1+4+1 = 6(行里除对角线以外的和:真金融 1、真股票 4、真娱乐 1 被判成了健康),所以「预测为健康的总数」= 10+6 = 16;
- FN = 2+1+2 = 5(列里除对角线以外的和:真健康被判成金融 2、股票 1、娱乐 2),所以「实际健康的总数」= 10+5 = 15;
- TN = 70-10-6-5 = 49。
\text{Precision}_{健康} = \frac{10}{16} = 0.625 \qquad \text{Recall}_{健康} = \frac{10}{15} = 0.667 \qquad F1_{健康} = \frac{2 \times 10}{2\times 10 + 6 + 5} = 0.645
③ 四个类别全算完(同一套算法重复四遍):
| 类别 | TP | FP | FN | 精确率 | 召回率 | F1 |
|---|---|---|---|---|---|---|
| 健康 | 10 | 6 | 5 | 0.625 (10/16) | 0.667 (10/15) | 0.645 |
| 金融 | 12 | 6 | 5 | 0.667 (12/18) | 0.706 (12/17) | 0.686 |
| 股票 | 11 | 4 | 6 | 0.733 (11/15) | 0.647 (11/17) | 0.688 |
| 娱乐 | 15 | 6 | 6 | 0.714 (15/21) | 0.714 (15/21) | 0.714 |
| 汇总 | — | — | — | macro 0.685 | macro 0.684 | macro 0.683 |
顺便得到 micro-F1 = accuracy = 0.686、weighted-F1 = 0.686(第 4.7 节解释这三个数的区别)。注意一个直觉验证:准确率 68.6% 恰好等于四个类别召回率的加权平均(按各类真实样本数加权),这不是巧合,而是 micro 指标的定义使然。
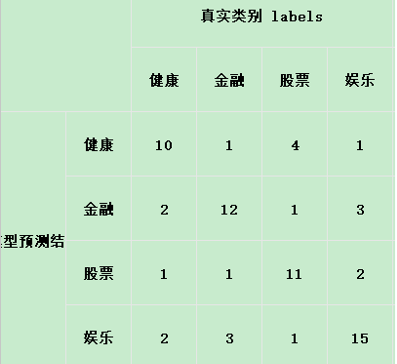
图注:第 3 页重复出现的同一张 4×4 混淆矩阵(绿底表头、顶部「真实类别 labels」、左侧竖排「模型预测结果」,行 健康/金融/股票/娱乐 × 列 健康/金融/股票/娱乐)。数字与第 1 页一致:对角线上 10、12、11、15;行向量分别是 [10, 1, 4, 1]、[2, 12, 1, 3]、[1, 1, 11, 2]、[2, 3, 1, 15]。这一页用它配合上面的「不合理情况」讲为什么要综合 P 和 R。
④ 换成更干净的二分类数字(最易被追问的版本):测试集 1000 条,模型结果为 TP=80、FP=20、FN=10、TN=890。
\text{Accuracy} = \frac{80+890}{1000} = 97\%
\text{Precision} = \frac{80}{80+20} = 80\% \qquad \text{Recall} = \frac{80}{80+10} = 88.9\%
F1 = \frac{2 \times 0.8 \times 0.889}{0.8+0.889} = \frac{2\times 80}{2\times 80+20+10} = \frac{160}{190} = 84.2\%
这里面藏着两个容易被忽略的读数:
- 准确率 97% 听着很漂亮,但 90 个正例里有 10 个被漏掉了(漏报率 1-\text{Recall}=11.1\%),如果正例是「风险新闻」「违规内容」这类需要拦截的样本,漏 10 个的代价要用召回率而不是准确率来汇报。
- 误报只有 20 个,相对 910 个负例是 2.2%(FPR = 20/910 = 2.2\%),这个数字是 ROC 曲线关心的量;而精确率关心的分母是 TP+FP=100。分母不一样,是 PR 曲线和 ROC 曲线在不平衡数据上给出不同结论的根本原因(见 4.6)。
4.5 阈值:唯一能调的那个旋钮
分类器真正输出的是概率(随机森林的 predict_proba、BERT 的 softmax、FastText 的 predict_proba),「判为正例」只是拿一个阈值 \theta 去切。阈值调低 → 更多样本被判为正例 → 召回率涨、精确率跌;阈值调高 → 反过来。材料第 4 页的原话就是:「调整分类阈值时,提升精确度必然以牺牲召回率为代价,反之亦然」。
带数字的扫描(构造的例子:测试集 1000 条,其中 90 条正例,910 条负例;下面是同一个模型在不同阈值下的结果):
| 阈值 \theta | TP | FP | FN | TN | 精确率 | 召回率 | F1 |
|---|---|---|---|---|---|---|---|
| 0.9 | 40 | 5 | 50 | 905 | 0.889 | 0.444 | 0.593 |
| 0.7 | 72 | 20 | 18 | 890 | 0.783 | 0.800 | 0.791 |
| 0.5 | 80 | 20 | 10 | 890 | 0.800 | 0.889 | 0.842 |
| 0.3 | 88 | 120 | 2 | 790 | 0.423 | 0.978 | 0.591 |
| 0.1 | 90 | 400 | 0 | 510 | 0.184 | 1.000 | 0.310 |
同一份预测,什么都没改,只挪了一下阈值:召回了从 0.44 升到 1.00,精确率从 0.89 掉到 0.18。注意 F1 在中间(0.5 附近)最高,这就是 F1 作为「单一权衡指标」的工作方式:它帮你在阈值上挑一个折中点,而不是替你做业务决策(业务上该偏哪边,取决于漏报和误报哪个更贵)。
PR 曲线就是把这整张表画出来:把 \theta 从 1.0 扫到 0.0,每一步得到一个 (\text{Recall}, \text{Precision}) 点,连起来就是 Precision-Recall Curve;曲线越靠右上越好,曲线下面积记作 AUC-PR(平均精度 AP),越大越好。读图技巧:曲线右端「竖直往下掉」说明还剩一批模型拿不准的样本,想再多召回一点,精确率就断崖下跌,这时继续降阈值没有意义,得改模型或补数据。
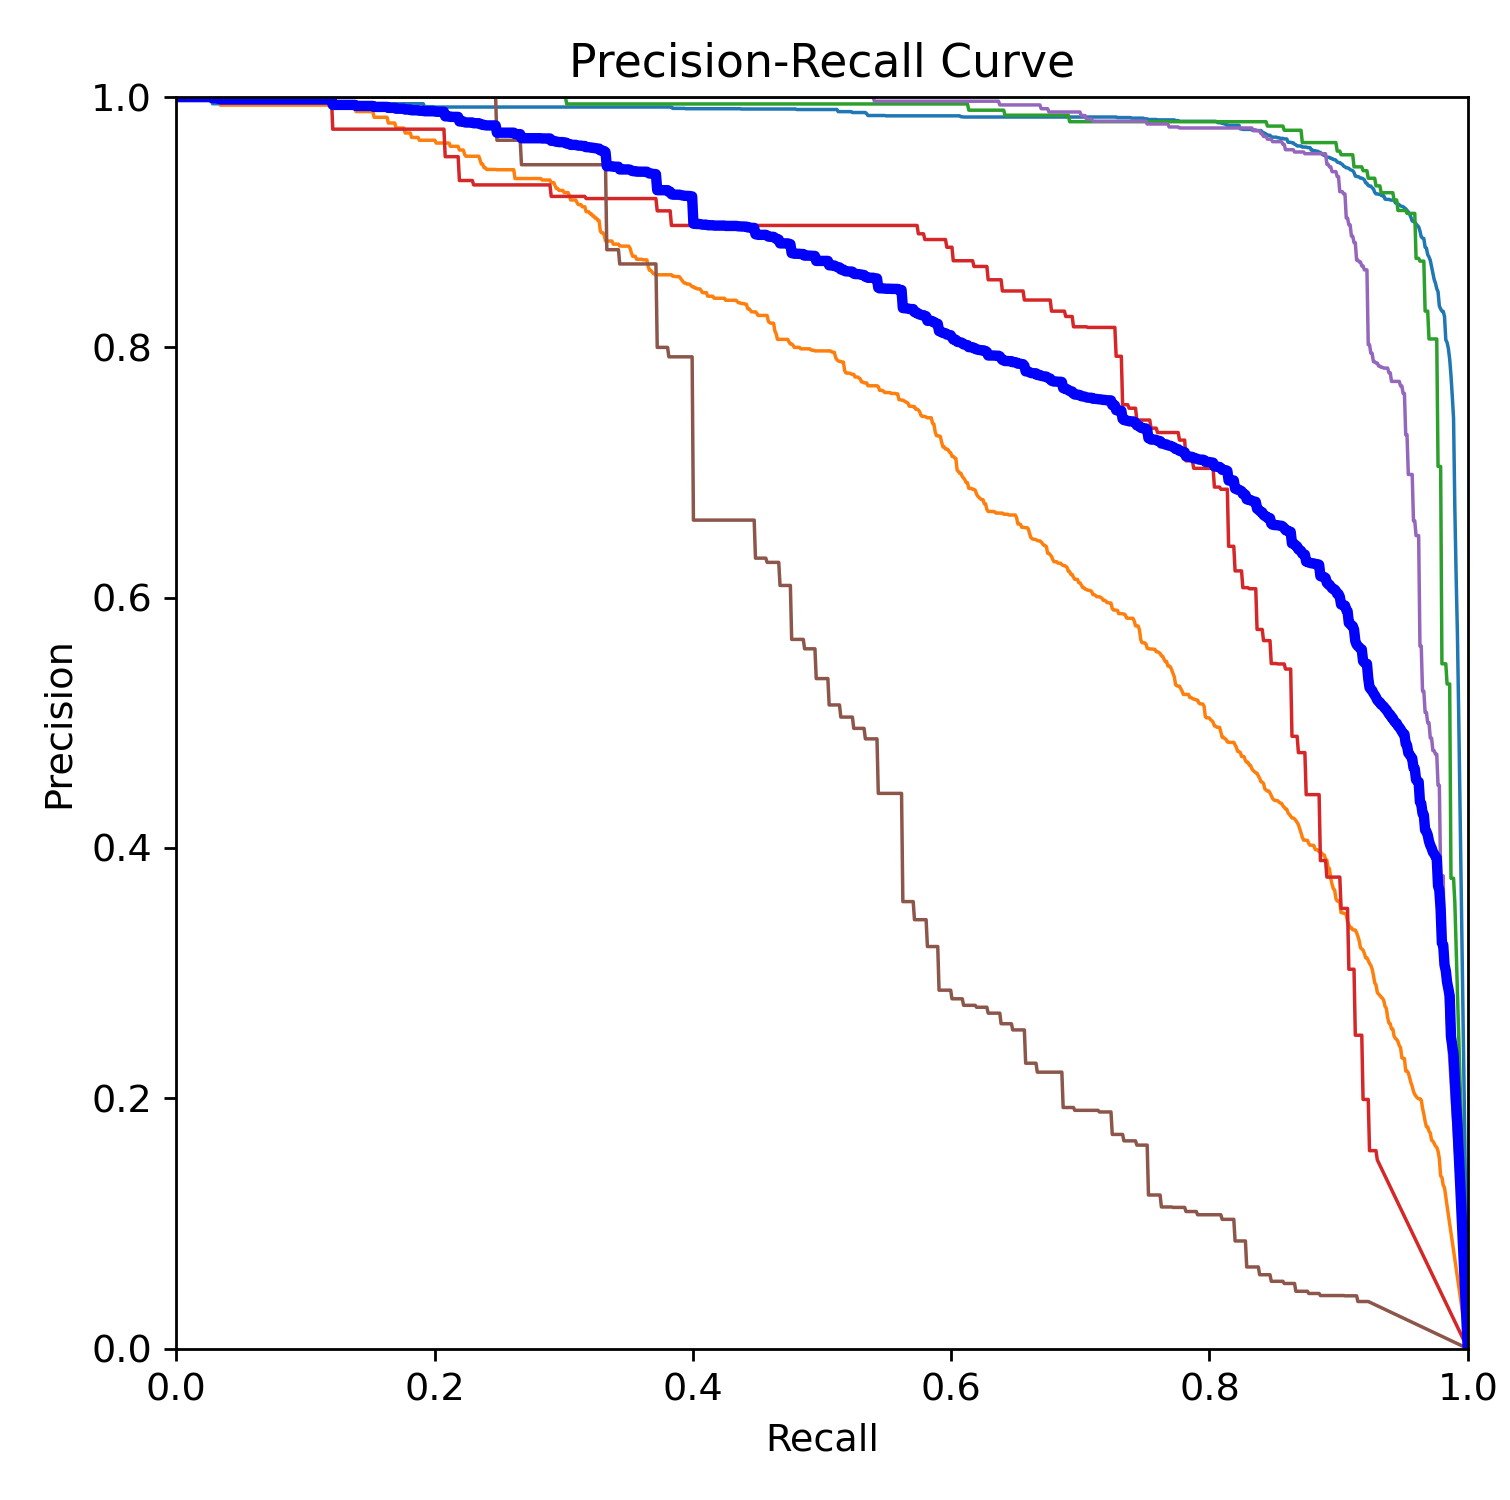
图注:第 4 页的 Precision-Recall Curve。横轴 Recall、纵轴 Precision,两个轴刻度都是 0.0 到 1.0;图里画了六条曲线(一条加粗的深蓝色、一条红色、一条橙色、一条棕色、一条绿色、一条紫色),图中没有图例,所以哪条对应哪个类别/模型需要对着生成它的代码看。形态特征很明显:绿色和紫色两条一直贴着 Precision ≈ 1.0 的水平线走到 Recall 0.9 以上才竖直落下;加粗的蓝色曲线从 Recall 0.1 左右就开始稳步下滑,到 Recall 0.85 时 Precision 只剩 0.6 上下,随后在接近 Recall 1.0 处俯冲;红色曲线在 Recall 0.85 附近断崖式掉到 0.15 以下;橙色曲线大致是一条平滑的斜线,到 Recall 0.95 时 Precision 约 0.35;棕色曲线是最差的一条,Recall 0.3 时 Precision 就只有 0.8 左右,到 Recall 0.7 已跌到 0.4 以下。这张图的教学价值在于:在同一张图上,「哪条曲线包住别人」一眼可辨,比六个 F1 数字好读得多。
4.6 F1 分数:为什么用调和平均,而不是算术平均
精确率和召回率是一对天生的矛盾,需要一个数把它们合成一个「体检总评」。算术平均会让「一个满分、一个零分」拿到 0.5 的中间分,这在业务上显然不对:只说好话但什么都不抓的模型(精确率 100%、召回率 0%),不该得到中等评价。
材料给的公式是
F1 = \frac{2 \times P \times R}{P + R} = \frac{2TP}{2TP+FP+FN}
它其实是 F_\beta 在 \beta = 1 时的特例:F_\beta = \dfrac{(1+\beta^2)PR}{\beta^2 P + R},其中 \beta > 1 更看重召回率,\beta < 1 更看重精确率。调和平均的三个可背性质:
- 只要有一个是 0,F1 就是 0,(1.0, 0.0) \to 0,而算术平均会给 0.5;
- F1 更靠近较小的那个值:(0.9, 0.5) \to 0.643(算术平均 0.7);(0.5, 0.9) \to 0.643(对称);
- 只有两者同时高才高:(0.9, 0.9) \to 0.9、(0.7,0.7)\to 0.7、(0.5,0.5)\to0.5,两者相等时 F1 就等于它们本身,一高一低则被拉向低的那边。
材料第 5 页正是用一张三维曲面把第 2、3 条画了出来。

图注:第 5 页的 F1 公式条:F1分数=2x(精确率×召回率)/(精确率+召回率),与第 1 页公式框里那一条完全一致,专门抽出来配合右边的曲面图讲。
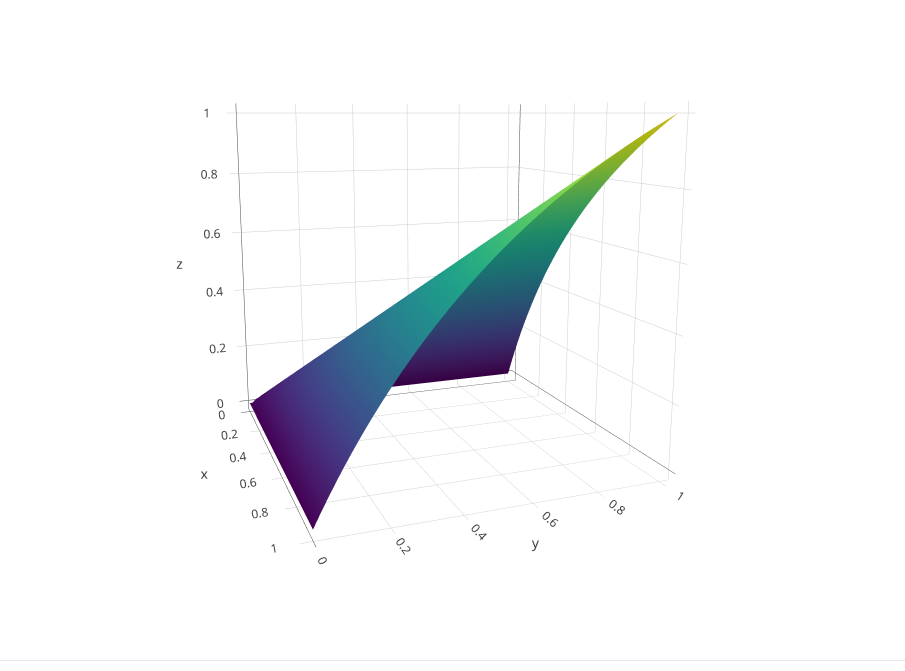
图注:F1 的三维曲面图。三个轴的名字是 x、y、z,范围都是 0 到 1(刻度标 0.2 / 0.4 / 0.6 / 0.8 / 1);结合材料正文明示的对应关系:x = 召回率(0<x<1)、y = 精确度(0<y<1)、z = F1 分数(0<z<1)。曲面用的是 viridis 配色,深紫代表低值、青绿到黄代表高值。形状是这张图真正的信息:曲面在 x=0 和 y=0 两条边上完全贴地(z=0,深紫色的大片「平台」),只在 (x,y) \to (1,1) 的那个角上才翘起到 z=1(顶端的黄色尖角);沿 x \approx y 的对角线方向,曲面的高度大致跟着坐标线性上升。翻译成人话就是:任一维度是 0,F1 必是 0;想让 F1 上去,精确率和召回率必须同时往上走。
材料配的三种情形表(原表):
| 情况 | 精确率 | 召回率 | F1 |
|---|---|---|---|
| 不平衡 | 1.0 | 0.0 | 0 |
| 一般 | 0.9 | 0.5 | 0.64 |
| 都好 | 0.9 | 0.9 | 0.9 |
4.7 多分类怎么把指标汇总起来:macro / micro / weighted
材料第 1 页那句「准确率是总体计算,精确率 召回率 F1 分数 都是分类别的,最后汇总需要取平均值」是这一节的全部动机。10 分类会得到 10 组 P/R/F1,往汇报里放之前必须选一种平均方式,而选哪一种会改变结论:
| 平均方式 | 怎么算 | 隐含的立场 | 什么时候用 |
|---|---|---|---|
| macro | 每个类单独算 F1,再取简单算术平均(每类权重都是 1/C) | 每一类同等重要,稀有类不许被牺牲 | 类别不均衡、每类都要可用时(新闻分类项目10 类新闻就该报这个) |
| micro | 先把所有类的 TP、FP、FN 各自求和,再用总 TP/FP/FN 算一次 | 每个样本同等重要 | 单标签多分类下 micro-F1 \equiv accuracy,所以它没有比准确率多提供信息 |
| weighted | 每个类 F1 乘上该类的真实样本数(support)再求平均 | 按样本数加权,大类说了算 | 只关心整体业务吞吐时的折中口径 |
用 4.4 节的两组数字对比:
| 场景 | macro-F1 | micro-F1(=Accuracy) | weighted-F1 |
|---|---|---|---|
| 材料的 4×4 矩阵(70 条,四个类样本数 15/17/17/21) | 0.683 | 0.686 | 0.686 |
| 下面构造的 10 分类(1000 条,一个 20 条的稀有类全灭) | 0.894 | 0.960 | 0.955 |
10 分类例子(对齐新闻分类项目的 10 类新闻场景):测试集 1000 条,分布是「娱乐(稀有类)20 条、旅游 500 条、科技 200 条、其余 7 类各 40 条」。模型表现是:娱乐类 20 条全部被判成旅游(该类的精确率、召回率、F1 都是 0),旅游类 500 条对了 490 条(另有 10 条科技样本也被误判进旅游),科技对 190 条,其余 7 类全对。算出来:
- 娱乐:P=0、R=0、F1=0;旅游:P=0.942、R=0.980、F1=0.961;科技:P=1.000、R=0.950、F1=0.974;其余 7 类 F1 都是 1.000;
- \text{macro-F1} = (0 + 0.961 + 0.974 + 7\times1.000)/10 = 0.894
- \text{micro-F1} = 960/1000 = 0.960,\text{weighted-F1} = (20\times0 + 500\times0.961 + 200\times0.974 + 280\times1.000)/1000 = 0.955
一个占 2% 的类彻底废掉,accuracy/micro-F1 只掉 4 个点(0.96),weighted-F1 掉 4.5 个点,而 macro-F1 掉了 10.6 个点(0.894)。这就是为什么在新闻分类项目这种类目天然倾斜的 10 分类任务上,报数要报 macro-F1:它是唯一能把「某个类被整体放弃」这件事暴露出来的口径。
工程上对应的 API(zero_division=0 用来避免除零告警):
from sklearn.metrics import (confusion_matrix, classification_report,
                             f1_score, precision_score, recall_score,
                             precision_recall_curve, average_precision_score)
import numpy as np

CLASSES = ["娱乐", "旅游", "科技", "体育", "财经", "房产", "汽车", "教育", "健康", "军事"]

# 1) 混淆矩阵:显式传 labels,保证行列顺序和类别名一一对应
cm = confusion_matrix(y_true, y_pred, labels=CLASSES)                 # 行=真实, 列=预测
cm_true = confusion_matrix(y_true, y_pred, labels=CLASSES, normalize="true")  # 每行和=1,对角线=召回率

# 2) 三种 F1 口径一起报
for avg in ["macro", "micro", "weighted"]:
    print(avg, f1_score(y_true, y_pred, average=avg, zero_division=0))

# 3) 每类一张表(P / R / F1 / support)
print(classification_report(y_true, y_pred, labels=CLASSES, digits=3, zero_division=0))

# 4) 二分类:PR 曲线与 AUC-PR(随机森林取正类的概率)
proba = clf.predict_proba(X_test)[:, 1]
prec, rec, thr = precision_recall_curve(y_test, proba, pos_label=1)
ap = average_precision_score(y_test, proba)   # 这就是 AUC-PR
4.8 看一张真实的热力图,找出该救的类别
材料第 6 页给了一张真实的归一化混淆矩阵,并把读法写成一句话:「对角线颜色越深说明这个类别分类效果好,不在对角线上的,颜色越深效果越差,得研究研究这个类别了。」
三个必须掌握的概念:
- 为什么要归一化:不归一化时,格子里是原始样本数,大类永远是大数字,两个类别没法直接比。归一化之后每一格是比例,才能横向比较。
- 按谁归一化:
normalize='true'让每一列(真实类别)的和为 1,此时格子里的数是 P(\text{预测} = r \mid \text{真实} = c),对角线那一格就是这个类别的召回率;normalize='pred'则让每一行(预测类别)和为 1,对角线变成精确率。两种都常用,但要清楚自己看的是哪一个。 - 怎么读问题:非对角线上的深色格子如果成块出现(某两三个类互相糊在一起),说明是系统性混淆,通常是特征不足或类目本身边界模糊;如果是某一整列(或整行)都深,说明这个类像「黑洞」,把别的样本都吸过去了,或者这个类被打包放弃了,这时要回去看训练样本里有没有类别不平衡。
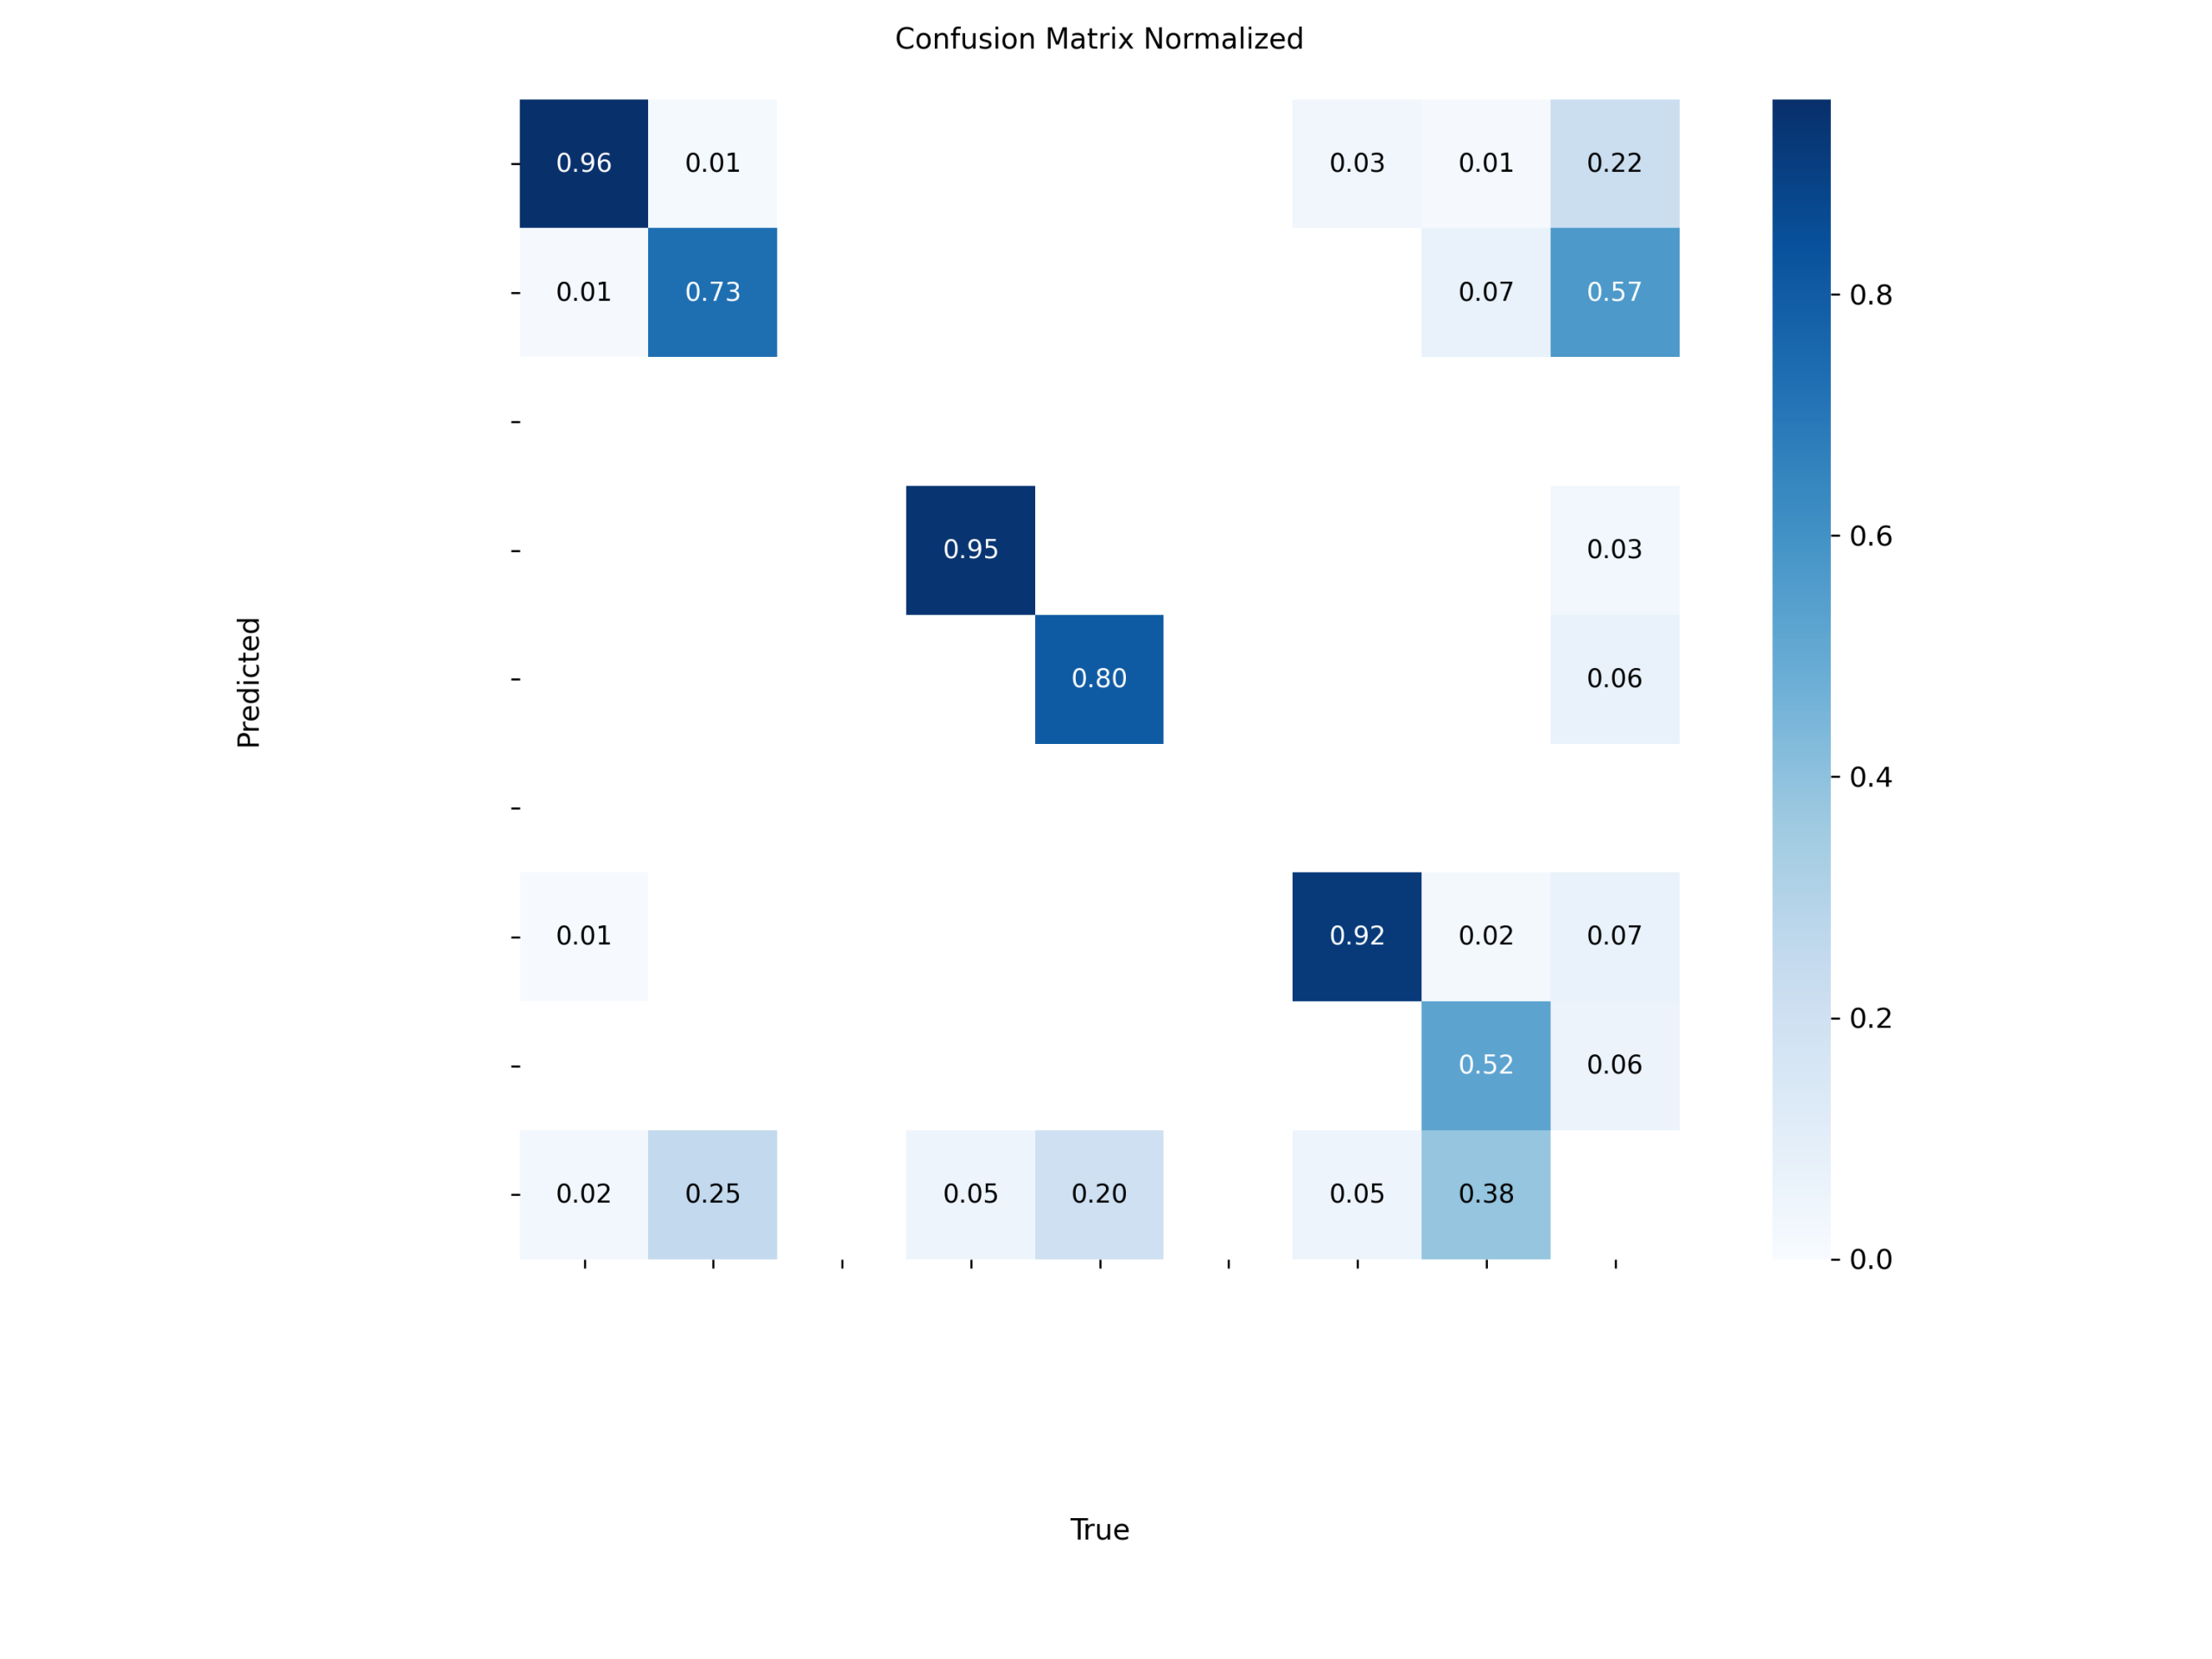
图注:第 6 页的实战图,标题 Confusion Matrix Normalized,纵轴标题 Predicted、横轴标题 True(类别名没有显示出来,只有这两个轴名),右侧色标刻度是 0.0 / 0.2 / 0.4 / 0.6 / 0.8,配色是单色系深蓝(数值越大颜色越深)。可以逐格读到的数字有:对角线上一串深色格子依次是 0.96、0.73、0.95、0.80、0.92、0.52,另有一格低到 0.06;非对角线上的大数字是 0.57、0.38、0.25、0.22、0.20,其余是 0.07、0.06、0.05、0.03、0.02、0.01 这一类零头。这张图的信息量集中在三处:一是有一个类别(0.06 那一格所在的类)几乎全线失守,它的样本被大量判成了另外两类(0.57 与 0.22 两格);二是另有一个类别只有 0.52,意味着一半样本判错;三是有一个「回收站」式的类别(0.22、0.07、0.06 集中的那一列),它同时吸收了好几个类的误判。可以自己验证一件事:把每一列相加,结果都是 1 左右(0.99~1.01),说明这张图按真实类别归一化(等价于 normalize='true'),每格是「该真实类别被判成某类的比例」,对角线即该类召回率。整张图还有大量空行空列(评估数据里只有一部分类别出现),这就是真实项目里第一次画混淆矩阵的典型样子:类目倾斜 + 个别类系统性混淆,和材料那句「得研究研究这个类别了」正好对上。
五、易错点与常见误解
- 常见说法:「准确率 97%,模型很好」;实际上,先看混淆矩阵和 F1。不平衡数据上准确率会骗人:1000 条里 90 条正例时,全判负例的废模型准确率 91%,F1 是 0。准确率的隐含假设是「每个样本一样重要、类目大致均衡」,新闻分类和垃圾识别都不满足。
- 有人以为「精确率和召回率可以一起提上去」;实际上,只调阈值不行。阈值这个旋钮上,两者必然此消彼长(材料原话);要同时涨只能动模型侧,加特征、换模型、调
class_weight、重采样、换 loss。 - 常听到的一种说法是:「F1 就是 P 和 R 的平均」;实际上,是调和平均。 (0.9, 0.5) 的算术平均是 0.7,F1 是 0.643;(1.0, 0.0) 的算术平均是 0.5,F1 是 0。它是「木桶指标」,专门惩罚短板。
- 容易想岔的地方:默认混淆矩阵「行是真实、列是预测」;实际上,先看轴标题。
sklearn的confusion_matrix确实是行=真实、列=预测,但材料这份课件里的 4×4 矩阵是行=预测、列=真实。方向读反,精确率和召回率会互换,整个结论翻转。 - 先说一个误解:多分类只报一个「F1」;实际上,说清楚是 macro / micro / weighted 中的哪一个。在 10 类倾斜数据上三者能差出好几个点;而且单标签多分类下 micro-F1 就等于 accuracy,报它等于没报。
- 常见说法:不平衡数据看 ROC-AUC 就够了;实际上,该看 PR 曲线 / AUC-PR。ROC 横轴是 \text{FPR}=FP/(FP+TN),负例极多时会把误报稀释掉。具体数字:1000 条里 50 条正例、950 条负例,某阈值下 TP=45、FP=200,ROC 上是 TPR 0.9 / FPR 0.21,看着不错;但精确率只有 45/245=0.18,PR 曲线一眼看出抓出来八成是错的。差别就在于精确率的分母 (TP+FP) 不含 TN;PR 的基线是正例占比(这里 5%),不是 ROC 的 y=x。
- 有人以为「某类 F1 有 0.9,这个类就没问题」;实际上,看样本量,也看错到哪去了。测试集里只有 20 条的类,F1 抖动量很大,不能拿它做模型选择;而且 F1 不告诉你去向,定位问题必须回到混淆矩阵。另外材料第 1 页已点明:准确率是总体计算,精确率 / 召回率 / F1 都是分类别的,所以写进报告的任何模型级数字都是聚合值,永远标注平均方式。
六、横向对比与研究脉络
6.1 指标对比
| 指标 | 公式 | 回答什么问题 | 用到的格子 | 对不平衡的敏感度 | 主要坑 |
|---|---|---|---|---|---|
| Accuracy | (TP+TN)/N | 总体判对多少 | 全部四个 | 低(被大类淹没) | 正例极少先别用 |
| Precision(查准) | TP/(TP+FP) | 报出来的有多少是真的(误报) | TP、FP(不看 TN/FN) | 中(对正类误报敏感) | 只报一个类时能被「不预测」刷满 |
| Recall(查全) | TP/(TP+FN) | 该报的报出来多少(漏报) | TP、FN | 中 | 全预测为正例就是 1.0 |
| F1 | 2PR/(P+R) | P 与 R 的综合,惩罚极端 | TP、FP、FN | 中高 | 一个为 0 则 F1 = 0;不区分偏重 |
| F_\beta | (1+\beta^2)PR/(\beta^2P+R) | 偏重召回(\beta>1)或精确(\beta<1) | 同上 | 中高 | 需要业务上先把 \beta 定下来 |
| macro-F1 | 各类 F1 的算术平均 | 每一类是否都被照顾到 | 逐类 P、R | 高 | 稀有类波动会放大 |
| micro-F1 | 全局 TP/FP/FN 汇总后算 | 逐样本视角 | 全部 | 低 | 单标签多分类下 = accuracy |
| weighted-F1 | 各类 F1 按 support 加权 | 整体业务口径的折中 | 逐类 P、R、support | 低 | 稀有类差也看不出来 |
| ROC-AUC | TPR 对 FPR 的曲线下面积 | 阈值无关的整体排序能力 | 四个都用(含 TN) | 低(TN 稀释误报) | 不平衡 + 关心正类时会过于乐观 |
| AUC-PR(AP) | PR 曲线下面积 | 正类抓取能力的阈值无关版 | TP、FP、FN | 高 | 要报基线(正例占比)才有意义 |
6.2 研究脉络(谁解决了谁的什么问题)
- 起点是准确率,很快暴露两个问题:类目不平衡时失真,且「错成什么样」完全不可见。
- 混淆矩阵把「错」展开成表:四个格子把「判断对错」和「预测正负」解耦,成为后续所有指标的公共基础。
- 精确率与召回率沿用自信息检索的评价传统,把误报(FP)与漏报(FN)两种失败代价分开计量;但两者都能被极端策略刷满,所以不能单独当目标函数。
- 需要单一数字 → F-measure(F_\beta,\beta=1 即 F1):加权调和平均合成,天然惩罚短板(材料第 5 页的曲面就是在画这件事);走向多分类时又派生出 macro / micro / weighted 的平均口径,本质是回答「类重要还是样本重要」,单标签多分类下 micro-F1 恒等于 accuracy,这个恒等式也顺便说明「准确率其实是一种 F1」。
- 从单阈值走向全阈值 → 曲线:阈值一挪 P/R 就换一组值,于是把所有阈值连成曲线(先 ROC,后 PR),用曲线下面积表达与阈值无关的整体能力;不平衡数据上 AUC-PR 取代 ROC-AUC 成为更受推荐的口径,因为它不受海量 TN 稀释。
- 补充指标:F1 只用三个格子、忽略 TN,类目极度倾斜时人们还会看 Cohen’s kappa、Matthews 相关系数(MCC)这类把四个格子都用上并扣除随机一致性的指标。
七、在新闻分类项目中的落地
用在哪一步:不是最后一步,而是每一次评估都要走一遍的环节。四条路线(TF-IDF + 随机森林 / FastText / BERT 微调 / LLM 零样本)跑出预测结果后,统一用同一套函数算:混淆矩阵 + classification_report + macro/weighted F1,才能横向对比。此外还有三个复用点:调阈值(随机森林/BERT 的 predict_proba)、模型压缩后的精度回归检查(量化/蒸馏/剪枝后必须重画混淆矩阵,看损失集中在哪类)、以及 bad case 分析(从非对角线的深色格子里捞样本,反推特征/标注问题)。
关键参数怎么调:
- 类别顺序永远显式指定:
labels=CLASSES,并把CLASSES固定成同一个列表贯穿 TF-IDF、FastText、BERT、LLM 四路,否则混淆矩阵的行列会错位,热力图变成一幅谁都看不懂的画。LLM 输出的是中文标签文本,要先做label_text → id的映射再进指标函数,映射表要能覆盖模型「胡说」出的类别(无法映射的单独记成「非法输出」,别静默丢掉)。 average选 macro 作为主口径,weighted 作为辅口径:项目是 10 类新闻、类目天然倾斜,主报 macro-F1;同时带上 weighted-F1 和每类的 support,方便解释「宏观掉分是哪个类拖的」。zero_division=0:某些类在小验证集上可能一次都没被预测到,不设这个参数 sklearn 会给警告并返回 0,读数时要清楚这是「没预测到」而不是「预测错了」。- 交叉验证的预测再画矩阵:用
cross_val_predict(..., cv=5)拿 out-of-fold 预测;否则拿训练集自身的预测画矩阵,只会看到一张漂亮得没有信息量的对角线。 - 不平衡处理与指标一起改:随机森林设
class_weight="balanced"、FastText 用autotuneValidationFile、BERT 微调时调类别权重,动作做完都要重新看 macro-F1 与热力图,通常是小类的 recall 上来了、大类的 precision 掉一点,这就是换来的东西。 - 阈值扫描用代码而不是手感:对每类输出
precision_recall_curve,选出业务上可接受的点(例如小类 recall ≥ 0.8 前提下的最大 precision)。注意 FastText 的test()只返回(样本数, 精确率, 召回率),没有 F1 也没有分类别细节,得自己拿predict()的结果去算。
实际坑:
- 类目倾斜导致「大类比烂模型」:准确率会挑出偏爱大类的模型,这就是必须报 macro-F1 的原因(4.7 节算过:一个 2% 的类全灭,accuracy 只掉 4 个点,macro-F1 掉 10 个点)。
- 标题短文本的跨类混淆:「娱乐 vs 体育」「财经 vs 房产」这类语义相邻类容易成块混淆,热力图上连成一片深色方块。对策是先定位具体混淆对,再决定加关键词特征、扩样本还是合并类目,这也是被追问时最好讲的「用指标驱动决策」的故事。
- 验证集只有 1w、测试集 1w,单类样本少:稀有类的 F1 在 20~50 条样本上波动极大,别用它做模型选择;比较两个模型时优先看它们在同一个混淆对上的差异。
- 混淆矩阵的方向:
sklearn是行=真实、列=预测(课件里的例子是反的),所以画图时一定要像第 6 页那样把Predicted/True轴名写清。 - 压缩之后的回归检查别只看总指标:量化/蒸馏的精度损失往往集中在样本少、边界模糊的类别,总分只掉 0.5 个点,某个类的召回可能掉了 10 个点,必须重画混淆矩阵。
与其它方案怎么配合:TF-IDF + 随机森林快且可解释,它的混淆矩阵就是后面三个模型的「问题清单」;FastText 提供秒级粗对比;BERT 提供精度上限参照;LLM 零样本/少样本验证「不训练能做到什么程度」。四条路线的 macro-F1、每类 F1、混淆矩阵放进同一张对比表,就能正面回答评审者那句「你怎么知道哪个方案更好、好在哪个类上」。
八、重点问答
Q1:什么是混淆矩阵?为什么不能只看准确率?
A:混淆矩阵就是把模型预测和真实标签交叉计数的一张表,行是预测类别、列是真实类别(sklearn 默认反过来:行是真实、列是预测),对角线上是判对的,非对角线上是错判,还能看出错到哪去了。准确率只有一个总数,包含不了「错在哪」这个信息;在类目倾斜的数据上它还会骗人:1000 条里 90 条正例时,一个全判负例的模型准确率也有 91%,但 F1 是 0。所以我评估时先看混淆矩阵和分类别指标,再看整体数字。我在新闻分类项目里做 10 类新闻分类,第一次画混淆矩阵就发现有两个类几乎全糊在一起,这是准确率看不出来的。
Q2:精确率和召回率的区别?业务上怎么选?
A:精确率的分母是「预测为该类的总数」,回答「我报出来的有多少是真的」,管误报;召回率的分母是「实际属于该类的总数」,回答「该报的报出来多少」,管漏报。选哪个取决于哪种错更贵:内容风控这类宁可错杀的场景优先保召回,而「报错一个要付人工成本」的场景优先保精确率,课件里那句话很到位,「想抓得更准,就容易漏掉;想抓得更全,就容易抓错」。工程上关键的一点是:只调阈值的话,一个涨另一个必然跌,想同时提只能改模型侧。
Q3:为什么用 F1 而不是 P 和 R 的算术平均?
A:因为算术平均容忍短板。精确率 100%、召回率 0% 的模型算术平均是 0.5,看着「中等」,实际什么都抓不到;F1 用调和平均,只要一个为 0,F1 就是 0。F1 也更靠近较小的那个值,(0.9, 0.5) 的算术平均是 0.7,F1 只有 0.643。课件用一张三维曲面把这件事画出来了:曲面在精确率为 0 或召回率为 0 的两条边上完全贴地,只有两者都接近 1 的角上才升起来。
Q4:多分类的 macro / micro / weighted F1 有什么区别?你们项目报哪个?
A:区别在权重。macro 是每类各算一个 F1 再取简单算术平均,每类等权,稀有类不会被稀释;micro 是先把所有类的 TP/FP/FN 汇总再算一次,单标签多分类里 micro-F1 恒等于准确率;weighted 是按每类的真实样本数加权平均。我们项目是 10 类新闻、类目天然倾斜,主口径报 macro-F1,同时附 weighted-F1 和每类 support 做解释。举例:一个占 2% 的类被模型整体放弃,accuracy 只掉 4 个点,macro-F1 会掉 10 个点,只有 macro 能暴露「某类被放弃」这件事。
Q5:数据不平衡时怎么办?
A:分训练侧和评估侧两件事。评估侧不能只看准确率,要报 macro-F1、看每类召回率,并把混淆矩阵画出来确认是哪个类在拖后腿;二分类正例稀少时看 PR 曲线和 AUC-PR 而不是 ROC-AUC。训练侧可以设 class_weight="balanced"、做重采样、调阈值偏向稀有类,或者用代价敏感学习。我在新闻分类项目里给随机森林加了类权重,稀有类召回上来了,代价是大类精确率掉一点,这个取舍要从业务上判断能不能接受。
Q6:PR 曲线和 ROC 曲线的区别?什么时候用 AUC-PR?
A:ROC 的横轴是假正例率 FP/(FP+TN)、纵轴是真正例率;PR 曲线的横轴是召回率、纵轴是精确率。关键差别在分母:ROC 用到 TN,负例极多时会把误报稀释掉;精确率的分母是 TP+FP,不含 TN,所以对误报更敏感。具体数字:1000 条里 50 条正例,某阈值下 TP=45、FP=200,ROC 上是 TPR 0.9 / FPR 0.21 看着不错,但精确率只有 45/245=0.18。所以类目严重不平衡、又关心「正类能不能被抓出来」时,我用 PR 曲线和 AUC-PR,并带上基线(正例占比 5%)一起报。
Q7:阈值怎么调?调阈值能同时提高精确率和召回率吗?
A:不能。模型输出的是概率,阈值只决定从哪个概率开始判为正例;阈值调低召回率升、精确率降,调高反之,这是一条固定的 trade-off。我的做法是先用 precision_recall_curve 把整条曲线扫出来,再按业务约束选点,比如「小类召回不低于 0.8」的前提下取精确率最高的阈值;F1 最高的那个点只当默认建议。想在不牺牲精确率的前提下提高召回率,必须改模型侧:加特征、换模型、调类别权重或做数据增强。
Q8:归一化混淆矩阵怎么看?项目里怎么用它定位问题?
A:归一化解决的是「大类数字天然大、没法横向比」的问题。按真实类别归一化时每一列的和是 1,格子是「这个真实类别的样本被判成某类的比例」,对角线就是召回率;按预测归一化时对角线变成精确率。看图我盯两处:对角线哪个类掉下来了,非对角线哪几个格子成块变深,成块说明那几个类系统性混淆。课件第 6 页那张图里有一个对角线格子低到 0.06,样本被大量判成另外两类,另一个类只有 0.52。定位到具体混淆对之后,再决定补数据、加特征还是合并类目,比盯着一个总分调参有效得多。
九、延伸阅读
- scikit-learn 用户指南「Model evaluation: quantifying the quality of predictions」:混淆矩阵、P/R/F1、PR 曲线、ROC 与 AUC 的官方权威口径,含
average参数的完整说明。 - scikit-learn API:
sklearn.metrics.confusion_matrix、ConfusionMatrixDisplay、classification_report、precision_recall_fscore_support、f1_score、fbeta_score、precision_recall_curve、average_precision_score、roc_auc_score(写报告时最好直接从classification_report的输出粘表格)。 - 周志华《机器学习》(西瓜书)第 2 章「模型评估与选择」:查准率/查全率/F1、P-R 曲线、ROC 与 AUC 的中文标准表述,
F_\beta的加权调和平均写法在这里。 - 李航《统计学习方法》中「评价指标」一节:精确率、召回率、F1 与 TP/FP/FN/TN 的形式化定义。
- 可视化工具:
seaborn.heatmap(就是第 6 页那张图的画法:annot=True, cmap="Blues",注意fmt控制小数位)与ConfusionMatrixDisplay.from_predictions。 - FastText 官方文档的 supervised tutorial(
fasttext.cc/docs/en/supervised-tutorial):test()返回(样本数, 精确率, 召回率),是「为什么必须自己补 F1 和分类别指标」的直接例子。 - 练习数据集:
sklearn.datasets.load_digits(10 类、样本均衡,适合先跑通混淆矩阵)与fetch_20newsgroups(20 类文本、严重不均衡,适合演示 macro-F1 与 PR 曲线的差别,也是新闻分类任务最接近的公开数据)。