一份「上手即用」的 FastText 工程课,用 train_supervised() / train_unsupervised() 两个 API 覆盖文本分类与词向量两条线,并在原理层面补上层次化 Softmax 与负采样这两条「高效输出层」路线。
一、这份材料解决什么问题
在新闻分类项目这类新闻标题分类项目里,四段式技术路线是 TF-IDF + 随机森林 → FastText → BERT 微调 → LLM 零样本/少样本。这份材料负责的是第二段:Bert 之前那条「便宜、快、够用」的基线。
为什么需要它,材料给了很清楚的动机:
- 深度学习做文本分类的门槛太高。BERT 微调要 GPU、要几十分钟、要调 learning rate;而 FastText 在 CPU 上几分钟就能训完一个 18w 条数据的模型,先把「这个任务到底有多难」量出来。
- 浅层模型不代表没技术含量。FastText 的「快」不是靠砍功能换来的,而是靠两个精巧设计:监督学习用 wordNgrams 词级 n-gram 补语义、无监督学习用 subword 字符 n-gram 补 OOV;输出层用 层次化 Softmax / 负采样 把 O(V) 打成 O(\log_2 V) 和 O(K)。
- 它是一个可靠的下界(baseline lower bound)。后面 BERT 比它高多少、LLM 零样本比它高多少,都要拿 FastText 的准确率/F1 当参照物;没有这个参照,BERT 的收益就是一句空话。
所以这份材料的学习目标是三件事:了解 FastText 的作用与优势来源 → 掌握安装 → 掌握两条 API 用法(分类 / 词向量)。它的编写定位是工具课而非论文课,参数、命令、返回值这些工程细节是重点。
二、核心结论
- FastText 分类器 = 词向量 + n-gram 的均值 + 一个线性分类器。三层结构(词嵌入层 → 平均池化层 → 线性层),本质是「带 bigram 的词袋模型」,所以它丢掉了语序,这是它快的原因,也是它打不过 Attention 的原因。
- 数据格式是硬约束:
__label__标签名 文本内容,标签在前、__label__是固定前缀、一行可挂多个标签、标签与文本之间用空格分隔。写错格式训练不会报错,只会悄悄学歪。 - 效果由 5 个参数主导:
lr、epoch、wordNgrams、dim、loss。其中loss的选择是任务决定的,单标签用softmax/hs,多标签必须用ova,ns是给词向量的。 model.test()返回三元组(样本数, 精确率, 召回率),不是 F1(课程注释里的「f1 分数」写错了,说出来是加分项)。要看 F1 得自己算 2PR/(P+R)。- 自动调参一行搞定:
train_supervised(input=..., autotuneValidationFile=验证集, autotuneDuration=秒数),FastText 会在给定时间预算内自己搜lr / dim / epoch / wordNgrams / minn / maxn / bucket / loss,只保留验证集上最好的模型。
三、知识地图
| 章节 | 内容 | 权重 |
|---|---|---|
| 1 FastText 介绍 | 核心用途(分类 / 词向量)、核心优势(快、好、抗 OOV)、安装 pip install fasttext-wheel |
【了解】 |
| 2 模型架构 | 三层结构;为什么需要高效输出层;层次化 Softmax + 哈夫曼树;负采样;三者对比表 | 【理解】层次结构,【掌握】对比结论 |
| 3 文本分类 | 分类概念与三种类型;完整流程六步(获取数据→划分→训练→评估→调优→保存加载);train_supervised() 手动调参 / 自动调参;在烹饪数据集上跑 8 组对比实验 |
【掌握】 |
| 4 训练词向量 | train_unsupervised();CBOW / Skip-gram;四步流程 |
【掌握】 |
| 5 词向量迁移 | 预训练词向量表(CommonCrawl+Wikipedia 157 语种 CBOW 300 维 / Wikipedia 294 语种 Skip-gram 300 维);下载解压加载;近邻词验证 | 【理解】 |
| 6 扩展:n-gram 与 subword | 词级 n-gram(分类,wordNgrams)vs 字符级 subword(词向量,minn/maxn) |
【理解】 |
| 7 扩展:层次 Softmax 梯度 | 哈夫曼编码下的 P(D\|X) 连乘、对数似然、\partial L/\partial\theta_i | 【了解】 |
| 8 常见高频题 | OOV、与 word2vec 区别、CBOW vs Skip-gram、分类步骤、为什么快 | 【掌握】 |
| 9 代码作业 | 20 条小数据 2 分类训练 + 余弦相似度计算 | 【掌握】 |
四、原理详解
4.1 三层结构:FastText 到底算什么
把一个句子里所有词(和它们的 n-gram)的向量拿来求平均,得到一个句子向量,再拿这个向量去分类。就这么简单,没有 Attention、没有 RNN、没有位置编码。
- 词嵌入层:为词表中的每个词、以及每个 n-gram 特征,查表得到 d 维 embedding。这一层的权重矩阵尺寸是 V \times d(V 为词表大小,d 为
dim)。 - 平均池化层(充当隐藏层):把一句话里出现的所有词/n-gram 的 embedding 逐维平均,得到定长的句向量 h \in \mathbb{R}^d。
h = \frac{1}{n}\sum_{i=1}^{n} e_{w_i}
- 线性层:h 过一层
Linear(d, C)(C 为类别数)输出 logits,再接 Softmax。
句子 I eat apple,dim=100、wordNgrams=2。参与平均的 token 是 5 个:I、eat、apple、I eat、eat apple。也就是 5 个 100 维向量求平均 → 一个 100 维句向量 → Linear(100, 10) 得到 10 个 logits。注意:这个平均是「集合求平均」,把 I eat apple 和 apple eat I 输入进去得到的句向量一模一样,这是 FastText 最大的能力边界。
对比一下量级:Linear(d, C) 只要 d \times C 个参数(100×10 = 1000),而 embedding 层是 V \times d(V=100 万时就是 1 亿参数)。FastText 的参数几乎全在词表上,不在分类器上,这解释了为什么它的模型文件通常几 MB 到几十 MB,且类别数从 10 涨到 1000 几乎不影响训练时间。
4.2 为什么需要「高效输出层」
如果老老实实做 Softmax,输出层是 Linear(d, V),单样本计算量 O(V),参数更新也是 O(V)。当 V 在 10^4 \sim 10^6 量级(大规模类别分类,或百万词表的词向量训练)时,这一步就是整个训练的瓶颈。
材料给出了明确的两条分叉:
大规模分类
├─ 有监督学习(文本分类):层次化 Softmax,O(log₂V)
└─ 无监督学习(训练词向量):负采样,O(K),K ≪ V
记住这个对应关系很重要:HS 是有监督的加速方案,NS 是无监督的加速方案。这也是后面 loss 参数怎么选的根源。
4.3 层次化 Softmax 与哈夫曼树
核心思想:把「V 类多分类」转成「哈夫曼树上的一条路径,由 \log_2 V 次二分类组成」。每个类别是哈夫曼树的一片叶子,从根走到叶子的路径就定义了这个类别的编码。
哈夫曼树怎么建(材料给的定义与步骤):带权路径长度最小的二叉树;权值(频次)越大的节点离根越近。构建步骤是:统计各类别频次 → 每次挑权值最小的两个节点合并,新节点权值为两者之和 → 重复直到只剩一棵树 → 左 0 右 1,从根到叶的路径即为该叶子的哈夫曼编码。
假设 4 个类别 A、B、C、D,频次分别是 5、9、7、3。
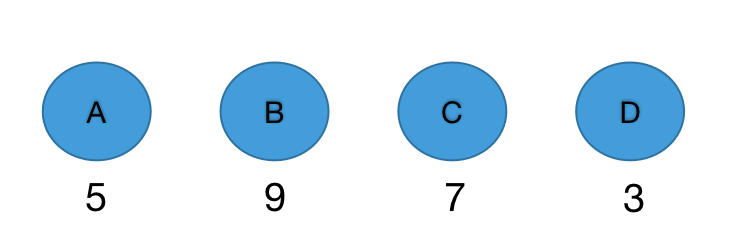
图注:示例的初始状态,4 个独立节点 A、B、C、D,节点下方数字为各自的频次 5、9、7、3(合计 24)。
第一步,挑最小的两个:D(3) 与 A(5) 合并成新节点 8。
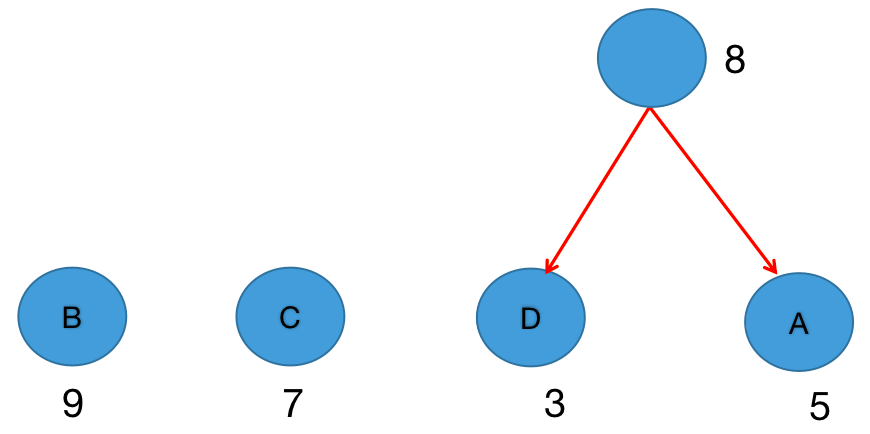
图注:新节点标 8,两条红色箭头指向子节点 D(3) 与 A(5);B(9) 和 C(7) 仍是孤立节点。
第二步,剩下的候选是 8、C(7)、B(9),挑最小的两个:C(7) 与 8 合并成 15。
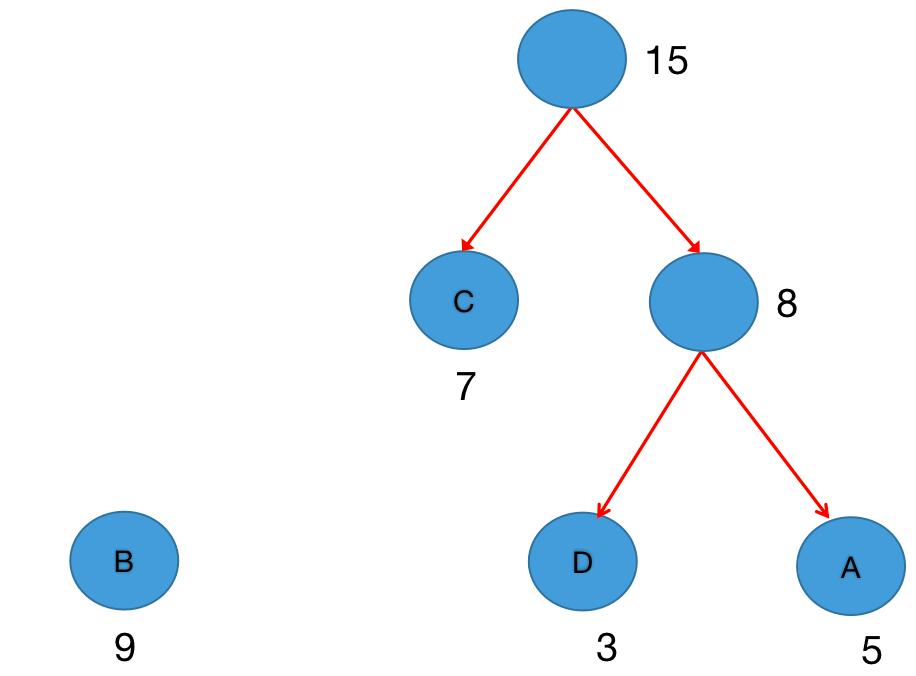
图注:新节点 15 的两条箭头分别指向 C(7) 与 8;此时只剩 B(9) 与 15 两个节点。
最后合并 9 与 15 得到根节点 24,树建成。
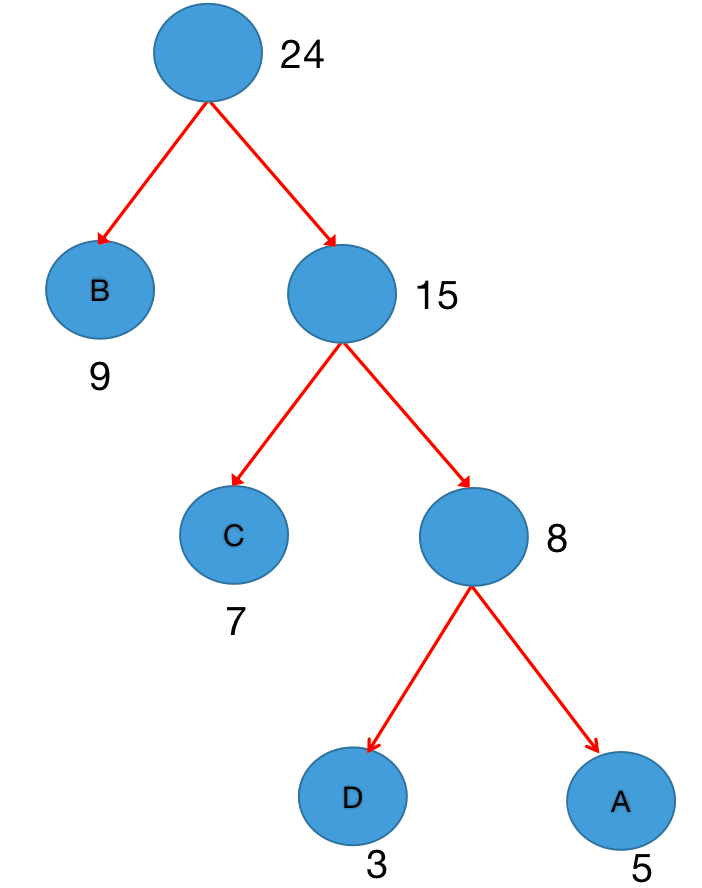
图注:根节点 24;左子树 B(9),右子树 15 → 再分出 C(7) 与 8 → 再分出 D(3) 与 A(5)。B 的频次最高(9),所以离根最近,只走一步。
加上左 0 右 1 的编码后:
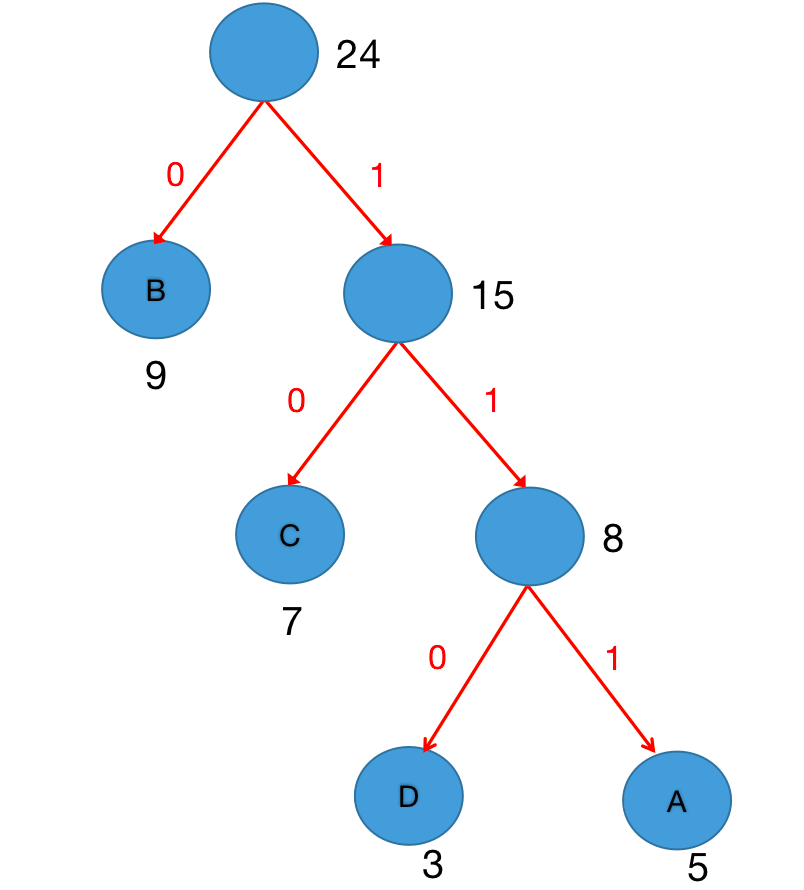
图注:根节点两条边分别标 0(指向 B)和 1(指向 15);15 的两条边标 0(指向 C)和 1(指向 8);8 的两条边标 0(指向 D)和 1(指向 A)。
于是四个类别的哈夫曼编码是:
| 类别 | 频次 | 编码 | 路径长度 |
|---|---|---|---|
| B | 9 | 0 |
1 |
| C | 7 | 10 |
2 |
| D | 3 | 110 |
3 |
| A | 5 | 111 |
3 |
验算一下它省在哪:加权路径长度 = 9\times1 + 7\times2 + 3\times3 + 5\times3 = 47,除以总频次 24 得平均 1.96 次二分类,而普通 4 分类 Softmax 每次要算 4 个 logits。而且频次越高的类别路径越短,高频类被优先照顾,这就是「带权路径长度最小」的实际收益。
概率怎么算(材料 2.4 节):每个内部节点是一个二分类器 Linear(hidden_dim, 1) + Sigmoid,内部节点(非叶子节点)的数量就是需要的 Linear(dim, 1) 个数。类别的条件概率是路径上所有二分类概率的连乘:
P(y \mid x) = \prod_{i \in path(y)} P(d_i \mid x)
四个关键优势:单样本计算量 O(\log_2 V);参数更新只碰路径上的节点;中英文档明确强调它仍然是精确概率模型(不是近似);只是不能直接输出完整的归一化概率分布。
4.4 层次 Softmax 的梯度计算(走一遍 D 类)
材料第 7 节用「类别 D 的编码是 110」把梯度推导完整走了一遍,这张图是理解 HS 的最好一张:
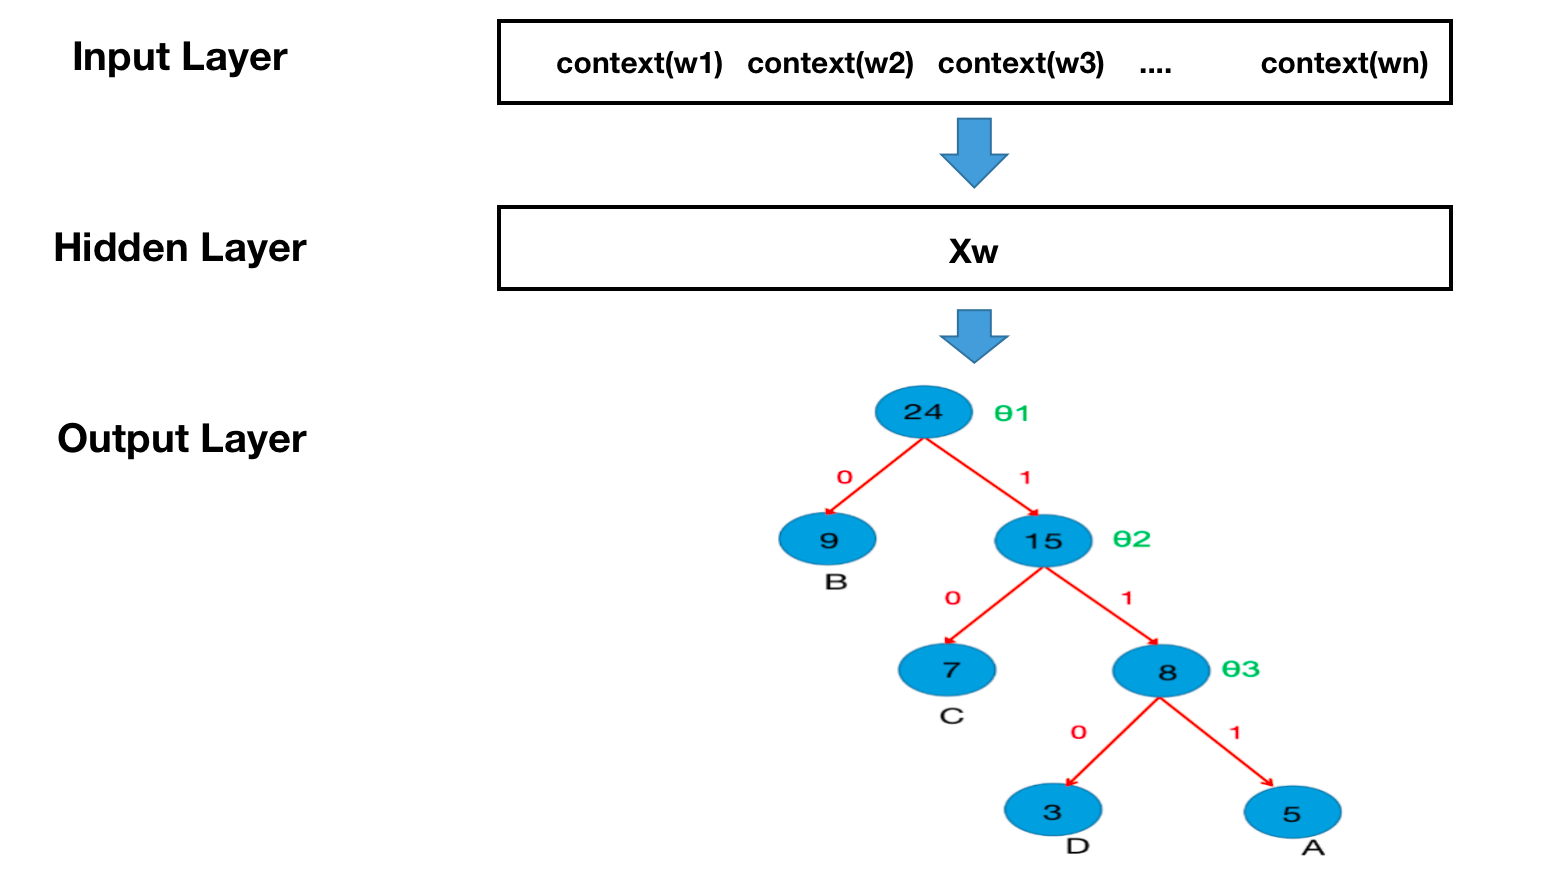
图注:Input Layer 是 context(w1) context(w2) context(w3) … context(wn);Hidden Layer 汇聚为 Xw;Output Layer 是哈夫曼树,根节点 24 标参数 \theta_1,15 标 \theta_2,8 标 \theta_3;边的标注为 24→B 是 0、24→15 是 1、15→C 是 0、15→8 是 1、8→D 是 0、8→A 是 1。可见参数 \theta 挂在非叶子节点上,叶子节点下面是类别字母和频次。
推导链条(约定 0 为负类、1 为正类):
- 走 D 要经过三次二分类,编码 110 → 依次是 \theta_1 上的「1」、\theta_2 上的「1」、\theta_3 上的「0」;
- 正类概率 \sigma(X^T\theta) = 1/(1+e^{-X^T\theta}),负类概率 1-\sigma(X^T\theta);
- 所以 P(D|X) = \sigma(X^T\theta_1)\,\sigma(X^T\theta_2)\,(1-\sigma(X^T\theta_3));
- 取负对数得损失 L(\theta) = -\log\sigma(X^T\theta_1) – \log\sigma(X^T\theta_2) – \log(1-\sigma(X^T\theta_3));
- 梯度形式极干净:
\frac{\partial L}{\partial \theta_i} = (\sigma(X^T\theta_i) – d_i)\cdot X
其中 d_i 是路径编码(0 或 1)。实践含义:梯度只在路径上的节点出现,非路径节点的梯度恒为 0,一次更新只改 \log_2 V 组参数,这就是「仅更新路径节点参数」在数学上的来源。
4.5 负采样(近似高效)
核心思想:负采样本身不定义模型结构,它只定义「如何构造训练样本」。做法是把多分类拆成多个独立的二分类:对每个正样本 (x, y^+),从词表里采样 K 个负样本 \{y_1^-, \dots, y_K^-\},让模型学会「x 和 y^+ 像,x 和这 K 个都不像」。
\text{Loss} = -\Big[\log\sigma(x\cdot y^+) + \sum_{k=1}^{K}\log\sigma(-x\cdot y_k^-)\Big]
\sigma 是 Sigmoid,x \cdot y 是向量相似度(点积)。它是近似的(材料明确标注「以牺牲分类精度为代价提升训练效率」),输出的是相似度分数而不是归一化概率分布;单样本计算量 O(K),K \ll V。适用场景:词向量训练/表示学习,以及类别数极大且不需要精确概率的任务。
4.6 三种输出层对比(这张表要背)
材料 2.6 节给了统一口径的对比表:隐藏层维度 n=300、类别数/词表大小 V=100{,}000。
| 维度 | 原始 Softmax | 层次化 Softmax | 负采样 + 对比学习 |
|---|---|---|---|
| 核心思想 | 一次性对所有类别归一化 | 沿树路径做多次二分类 | 用少量负样本近似训练 |
| 是否精确 | 是 | 是 | 否 |
| 输出层结构 | Linear(n, V) + Softmax |
Linear(n,1)+Sigmoid × (\log_2 V) |
Linear(n,1)+Sigmoid |
| 单样本对应原始样本 | 1 个原始样本 | 1 个原始样本 | 1 个正样本 + K 个负样本 = K+1 个 |
| 单样本计算量 | O(V) | O(\log_2 V) | O(K) |
| 参数更新范围 | 所有类别参数 | 仅路径节点参数 | 正样本 + K 个负样本 |
| 输出含义 | 概率分布 | 类别概率 | 相似度分数 |
| 典型用途 | 小规模分类 | 大规模分类,有监督文本分类 | 表示学习,无监督词向量训练 |
V = 100{,}000 时,O(V) 是 10 万次乘加,O(\log_2 V) 约 16.6 步,差三个数量级。但注意:分类数只有 10 的时候,\log_2 10 \approx 3.3 对 O(10),差距只有 3 倍,还多引入了树上二分类的实现复杂度。所以项目的 10 分类任务不该用 hs,用默认的 softmax 更稳,课程在烹饪数据集上的实测也支持这一点(见 4.8)。
4.7 文本分类流程与数据格式
材料把分类分成三类,这是常被问的分类框架:
| 类型 | 特点 | 示例 |
|---|---|---|
| 二分类 | 两个对立类别 | 好评/差评、垃圾邮件/正常邮件 |
| 单标签多分类 | 多个互斥类别,每条文本仅属一类 | 文本分类为体育/科技/财经 |
| 多标签多分类 | 多个非互斥类别,一条文本可属多类 | 一部电影同时标记:剧情/喜剧/爱情 |
完整流程六步:获取数据 → 划分训练集与验证集 → 训练模型 → 模型评估 → 模型调优 → 模型保存与加载。
数据格式是 FastText 最容易被忽略的细节。材料给的模板(烹饪数据集,Facebook AI 实验室提供):
__label__类别1 文本内容
__label__类别2 文本内容
__label__类别1 __label__类别2 文本内容
__label__类别1 __label__类别2 __label__类别3 文本内容真实数据长这样(head cooking.stackexchange.txt):
__label__sauce __label__cheese How much does potato starch affect a cheese sauce recipe?
__label__food-safety __label__acidity Dangerous pathogens capable of growing in acidic environments
__label__cast-iron __label__stove How do I cover up the white spots on my cast iron stove?
__label__restaurant Michelin Three Star Restaurant; but if the chef is not there
__label__knife-skills __label__dicing Without knife skills, how can I quickly and accurately dice vegetables?
一句话概括格式规则:一行 = 若干 __label__xxx 标签(空格分隔,可多个)+ 空格 + 文本内容。上面第一行就是「标签 sauce 和 cheese,文本 How much does potato starch…」。
划分数据集用 shell 就够了:
$ wc cooking.stackexchange.txt
15404  169582 1401900 cooking.stackexchange.txt   # 行数 / 单词数 / 字节数

$ head -n 12404 cooking.stackexchange.txt > cooking.train   # 前 12404 条训练
$ tail -n 3000  cooking.stackexchange.txt > cooking.valid   # 后 3000 条验证
15404 = 12404 + 3000,切分干净没有重叠。
4.8 train_supervised() 完整参数与 8 组调参实验
材料里那份代码的注释就是参数清单,这里整理成可直接查表的版本:
| 参数 | 课程取值 | 含义与调参直觉 |
|---|---|---|
input |
训练集路径 | 必填,格式必须是 __label__标签 文本 |
lr |
0.1 | 学习率。0.1 起步,效果差就往 0.25 ~ 0.5 提 |
epoch |
5 | 训练轮数。小数据要加大,课程从 5 提到 20 是收益最大的一步 |
wordNgrams |
1 | 词级 n-gram 的 N,可取 1/2/3。加 n-gram 能抓局部短语,但不是无脑加 |
dim |
100 | 词向量维度。小数据加维度收益有限 |
loss |
softmax |
"softmax" 单标签多分类;"hs" 层次 Softmax(单标签,大规模类别);"ova" 多标签多分类;"ns" 负采样+对比学习,一般用于无监督词向量 |
minCount |
1 | 最小词频,低于该值的词直接忽略 |
save_model |
False | 课程自定义的开关,不是 FastText 参数 |
(补充的是 API 里另外常用的 bucket(n-gram 哈希桶数,默认 200 万)、thread(线程数)、verbose(日志级别)、pretrainedVectors(加载预训练词向量初始化),这些在 CLI 里同样可用。)
可运行的训练/保存/加载/预测/评估函数:
import os
import fasttext

def train_fasttext(input_path, test_path, lr=0.1, epochs=5,
                   wordNgrams=1, dim=100, loss="softmax", save_model=False):
    # 1. 训练
    model = fasttext.train_supervised(
        input=input_path, lr=lr, epoch=epochs,
        wordNgrams=wordNgrams, dim=dim, loss=loss,
    )
    # 2. 保存 + 加载
    if save_model:
        os.makedirs(r"./model", exist_ok=True)
        model.save_model(r"./model/fasttext_model202603.bin")
        print("模型保存成功")
        model = fasttext.load_model(r"./model/fasttext_model202603.bin")
        print("模型加载成功")
    # 3. 预测:返回 (标签元组, 概率numpy数组)
    print(model.predict("What is a mild detergent?"))
    print(model.predict("Why would you pinch egg whites when making sunny side up eggs?"))
    # 4. 测试:(样本数量, 精确率, 召回率)
    result = model.test(path=test_path)
    print(result)
    return result

# 自动调参版本:只多两个参数
def train_fasttext_autotune(input_path, test_path):
    model = fasttext.train_supervised(
        input=input_path,
        autotuneValidationFile=test_path,  # 自动调参的参考验证集,由它判断好坏,只保留最优模型
        autotuneDuration=20,               # 自动调参时长,默认 60 秒
    )
    print(model.predict("What is a mild detergent?"))
    return model.test(path=test_path)
model.predict(text) 返回的是 (('__label__xxx',), array([0.0843])) 这种形式:第一个元素是标签元组,第二个是概率数组,取 label[0] / prob[0] 就是 Top-1。
8 组对比实验的真实结果(同样的训练/验证集,逐项调参):
| # | 配置 | 精确率 | 召回率 |
|---|---|---|---|
| 1 | 默认:lr=0.1, epoch=5, dim=100, wordNgrams=1, loss=softmax |
0.1540 | 0.0666 |
| 2 | lr=0.25, epoch=20 |
0.5257 | 0.2273 |
| 3 | 换清洗后数据 cooking.pre.* + 上述配置 |
0.5690 | 0.2461 |
| 4 | 再 dim=512 |
0.5717 | 0.2472 |
| 5 | 再 wordNgrams=2 |
0.5370 | 0.2322 |
| 6 | 换 loss="hs" |
0.5287 | 0.2286 |
| 7 | loss="ova", dim=200, wordNgrams=1 |
0.6103 | 0.2639 |
| 8 | 自动调参(20 秒) | 0.5607 | 0.2425 |
这张表的信息密度很高,值得逐条读出结论:
- 最大的一跳来自
lr和epoch:0.154 → 0.526,涨了 3 倍多。而dim从 100 提到 512 只涨了 0.3 个点(0.5690 → 0.5717),小数据上堆词向量维度是浪费。 wordNgrams=2反而掉了(0.5717 → 0.5370)。这和「n-gram 提升效果」的常识相反,原因是数据只有 1.2 万条:n-gram 让特征空间稀疏化,样本不够支撑。结论是「加特征」必须和「样本量」一起考虑。loss="ova"拿了最好成绩,而且这是唯一让 F1 明显抬头的配置。原因不难想:烹饪数据集每行有多个__label__,是典型的多标签任务,ova才是语义上匹配的 loss。这个实验设计得很有说服力:先用softmax/hs跑,发现 F1 一直上不去,换ova才对。- 自动调参(第 8 组)没有打败手工最好成绩(0.5607 < 0.6103)。原因是自动调参的搜索空间不包含「换 loss」这一项的策略组合,且 20 秒预算偏紧。自动调参省人力,不等于一定最优。
4.9 保存、加载与文件格式
model.save_model(r"./model/fasttext_model202603.bin")   # 保存
model = fasttext.load_model(r"./model/fasttext_model202603.bin")  # 加载
保存下来的是 .bin 二进制模型文件,里面装的是完整模型(词表、超参、输入/输出矩阵),加载后能继续 predict() / test()。
.bin 与 .vec 的区别(工程上经常被混用,必须分清):
.bin |
.vec |
|
|---|---|---|
| 内容 | 完整模型:字典 + 超参 + embedding 矩阵 + 分类器权重(含 subword 桶) | 纯文本词向量表:首行 词数 维度,之后每行「词 + 空格 + d 个浮点数」 |
| 产出方式 | 有监督/无监督训练都会生成;save_model() 存的也是它 |
无监督训练词向量时额外导出的纯文本版本 |
| 加载方式 | fasttext.load_model('x.bin') |
用 numpy/gensim 自己读,或作为 pretrainedVectors 喂给有监督训练 |
| 能做什么 | 预测、评估、get_word_vector()、get_nearest_neighbors()、对 OOV 做 subword 推断 |
只能查表拿向量,OOV 词没有向量 |
| 体积 | 较大(含全部参数) | 较小(只有词向量) |
一句话记法:.bin 是模型,.vec 是词表快照;只有在 .bin 上才能对没见过的词算向量。
4.10 训练词向量与词向量迁移
静态词向量的核心思想(材料 4.1):先在大规模无标注语料上预训练词向量,再把它作为固定特征输入到下游任务模型,「静态」就是指它训练完就冻结,同一个词在任何上下文里都是同一个向量。
- 训练方法:
fasttext.train_unsupervised() - 两种训练模式:CBOW(用上下文预测中间词)和 Skip-gram(用中间词预测上下文)
- 流程四步:获取训练数据 → 训练词向量 → 模型效果检验 → 模型保存与加载
词向量迁移:直接使用在大规模语料上预训练好的词向量作为下游任务的语义表示,不再从零训练,这是「最基础的迁移学习方法」。FastText 官方提供了多语言预训练词向量:
| 数据源 | 语言覆盖 | 训练方式 | 向量维度 | 链接 |
|---|---|---|---|---|
| CommonCrawl + Wikipedia | 157 种语言 | CBOW | 300 | https://fasttext.cc/docs/en/crawl-vectors.html |
| Wikipedia | 294 种语言 | Skip-gram | 300 | https://fasttext.cc/docs/en/pretrained-vectors.html |
下载 → 解压 → 加载 → 验证,中文走 CommonCrawl 那份:
# Linux/macOS
!wget https://dl.fbaipublicfiles.com/fasttext/vectors-crawl/cc.zh.300.bin.gz
!gunzip cc.zh.300.bin.gz

# Windows(没有 gunzip,用 7-Zip / WinRAR 解压 .gz;下载用 curl)
!curl -L -o cc.zh.300.bin.gz "https://dl.fbaipublicfiles.com/fasttext/vectors-crawl/cc.zh.300.bin.gz"
import fasttext
model = fasttext.load_model("cc.zh.300.bin")
print(model.words[:20]) # 前 20 个词
print(len(model.words)) # 2000000 ← 词表两百万
print(model.get_word_vector("音乐").shape) # (300,) ← 300 维model.words 的前 20 个词是 [',', '的', '。', '、', '是', '一', '在', ':', '了', '(', ')', "'", '和', '不', '有', '我', ',', ')', '('],高频虚词排在最前,这本身就是「词频决定词表顺序」的直接证据。
用近邻词验证词向量质量(这是最常用的快速质检手段):
print(model.get_nearest_neighbors("音乐"))
print(model.get_nearest_neighbors("美术"))
print(model.get_nearest_neighbors("周杰伦"))
真实输出(取前几名,格式为 (余弦相似度, 词)):
- 音乐:乐曲 0.6703、音乐人 0.6570、声乐 0.6566、轻音乐 0.6557、音乐家 0.6536
- 美术:艺术 0.7247、绘画 0.7166、(后面是人类姓名与院系名)
- 周杰伦:杰伦 0.6995、周杰倫 0.6967、周董 0.6860、陈奕迅 0.6381、张靓颖 0.6368
三个观察:语义邻居都合理(乐曲/声乐/轻音乐);「周杰伦」的邻居里同时出现简体「杰伦」和繁体「周杰倫」,这就是字符 n-gram 子词建模在起作用,简繁共享大量字符片段,所以向量也接近;相似度普遍在 0.6~0.72 区间,不算高,说明中文预训练词向量的绝对相似度数值本身参考价值有限,看排序更有意义。
4.11 n-gram 与 subword:FastText 的两个「补丁」
传统词向量把「一个词」当作最小单位,三个问题:新词(OOV)没有向量、拼写错误难处理、词形变化(play/playing/played)共享信息少。FastText 用两个机制分别补:
词级 n-gram(用于文本分类,参数 wordNgrams)。以 I eat apple 为例:unigram 是 I、eat、apple;bigram 是 I eat、eat apple。作用是不只看单词还看局部短语,能更好捕捉语义组合(如 not good)。
subword 字符级 n-gram(用于训练词向量,参数 minn/maxn)。FastText 不只学整词向量,还学字符 n-gram 向量再组合成词向量。以 apple(加边界符后写作 <apple>)为例,取若干字符片段如 <ap、app、ppl、ple、le>,词向量 ≈ 这些子词向量的平均。收益:未登录词只要字符片段见过就能表示、低频词更稳、对拼写与词形变化更友好。
| 名称 | 介绍 | 应用 | 示例 | API 参数 |
|---|---|---|---|---|
| n-gram | 词级 n-gram,提取局部短语特征 | 文本分类 | I eat apple:unigram I, eat, apple;bigram I eat, eat apple |
wordNgrams |
| subword | 字符级 n-gram,提取词内部结构,能处理 OOV | 训练词向量 | <apple> 取 <ap, app, ppl, ple, le> 等,词向量 ≈ 子词向量的和/平均 |
minn, maxn |
这是最容易记混的一对:wordNgrams 管分类、minn/maxn 管词向量。minn/maxn 默认是 0,也就是默认不开 subword,所以「FastText 天然抗 OOV」这句话只在词向量训练(或显式开了 minn/maxn)时成立。
五、易错点与常见误解
常见说法:test() 返回的第三个数是 F1 分数。
实际上,是 Recall@1,三元组为 (样本数, Precision@1, Recall@1)。
为什么:课程代码注释写了「(样本数量,准确率,f1 分数)」,但官方语义是精确率与召回率。要 F1 得自己算 F1 = 2PR/(P+R)。被追问时主动指出这一点,说明你真读过返回值而不是照抄注释。
有人以为标签写在文本后面,或者用 label:、# 之类的前缀。
其实必须 __label__标签 文本,双下划线前缀、标签在前、中间一个空格。
原因在于,FastText 是按行做 token 解析的,不认识的格式只会被当作普通文本 token 混进词表,不报错但效果崩掉。这是「静默失败」类错误里最贵的一种。
常听到的一种说法是:wordNgrams=2 一定比 wordNgrams=1 效果好。
真实情况是,不一定,取决于样本量。
背后的道理是,课程的实测里 wordNgrams=2 把精确率从 0.5717 拉低到 0.5370(1.2 万条数据)。n-gram 会显著扩张特征空间,样本不够时是纯噪声。先看样本量再决定要不要加 n-gram。
容易想岔的地方:多标签任务也是用 softmax,加个多标签后处理就行。
事实正相反,多标签任务用 loss="ova"。
之所以如此,softmax 在同一组 logits 上做归一化,天然假设类别互斥;ova(one-vs-all)给每个标签独立的二分类判断,不互相竞争。课程里烹饪数据集(每行多个 __label__)换成 ova 后拿到最高的 0.6103 / 0.2639,就是这个道理。
先说一个误解:类别多的时候一律用 hs 更快,所以项目 10 分类也该用 hs。
实际上,10 分类用默认 softmax 更合适。
为什么:O(\log_2 V) 的优势要 V 足够大才体现;V=10 时是 3.3 对 10,只有约 3 倍差距,而 hs 引入树结构、路径采样和实现复杂度,还牺牲了完整概率分布。实测里 loss="hs"(0.5287)也确实不如 ova 和 softmax 组合。HS 的战场是 10^4 \sim 10^6 类。
常见说法:loss="ns" 可以拿来跑有监督分类。
其实ns 是给无监督词向量训练的(负采样+对比学习),监督分类官方口径是 softmax / hs / ova 三选一。
原因在于,材料自己的参数注释就写着「’ns’,负采样+对比学习训练,一般用于训练词向量-无监督学习」。课程代码里虽然试了 loss="ns" 并且跑出了结果(0.5287),但输出含义是「相似度分数」而不是「类别概率」,语义上对不上分类任务。能跑通 ≠ 用法正确。
有人以为.vec 和 .bin 随便用,反正都是词向量。
真实情况是,.bin 是完整模型(可用 fasttext.load_model 加载、能对 OOV 做 subword 推断),.vec 是纯文本词表快照(只能查表,OOV 无向量)。
背后的道理是,.vec 首行是 词数 维度,后面只是文本;.bin 带着模型参数、超参和 subword 桶。选了 .vec 就等于放弃了 subword 能力,而这正好是 FastText 的核心卖点。
常听到的一种说法是:用 open(...).write("\n".join(data)) 写训练文件没问题。
事实正相反,要补尾换行,或写 "\n".join(data) + "\n"。
之所以如此,课程的作业 1 里,20 条数据切出 4 条做测试集,但 model.test() 报的样本数是 3,并且 Precision/Recall 全是 0.0000(模型把两条测试文本都预测成 __label__科技,而测试集全是体育)。缺尾换行导致最后一行被丢,是这类现象最常见的解释。小数据上少一条就是 25% 的数据,而「预测全部塌向多数类」是样本量过小的典型症状(训练集 16 条里科技 10 条、体育 6 条)。
容易想岔的地方:dim 越大词向量越好。
实际上,收益递减,且和样本量绑定。
为什么:dim 100 → 512 在 1.2 万条数据上只涨 0.27 个点(0.5690 → 0.5717),却让 embedding 矩阵和模型文件同步变大。词向量维度是「表达能力」和「过拟合风险/体积」之间的取舍。
先说一个误解:中文文本不分词直接喂 FastText。
其实中文要先分词再用空格连接(英文本身用空格)。
原因在于,FastText 默认按空格切 token,未分词的整句中文会变成极少数超长 token,wordNgrams 的「词序列」假设直接失效。而 minn/maxn 的 subword 能力只在无监督训练里生效,救不了有监督分类的中文分词问题。
常见说法:numpy 装最新版最省事。
真实情况是,遇到 ValueError: Unable to avoid copy while creating an array as requested. 就固定到 numpy==1.26.x。
背后的道理是,这是 fasttext-wheel 与 numpy 2.x 的已知不兼容(报错信息里提示 np.array(obj, copy=False) 应换成 np.asarray(obj)),课程直接给了解决方案:降级 numpy,必要时 pip install --force-reinstall fasttext-wheel 重装预编译版本。
六、横向对比与研究脉络
输出层三方案对比已在 4.6 给出,这里补上「模型/方案」层面的横向对比,这是被追问时真正会被追问的维度:
| 方案 | 原理 | 优点 | 缺点 | 适用场景 | 复杂度 / 体积 |
|---|---|---|---|---|---|
| TF-IDF + 随机森林 | TF-IDF 统计词权重,随机森林做非线性判别 | 零 GPU、可解释(特征重要性)、对稀疏高维友好、无需分词之外的预处理 | 完全无词序、无语义泛化(近义词无关)、词表外无表达 | 快速基线、特征筛选、小数据 | 训练秒级;模型可到百 MB 级(森林规模决定) |
| FastText(有监督分类) | embedding 平均 + Linear(d, C),wordNgrams 补短语 |
训练分钟级、CPU 可跑、模型小、autotune 开箱即用、原生多标签(ova) |
无位置信息、无上下文相关表示、长文本表达能力弱 | 基线对照、大规模多标签分类、线上低延迟场景 | O(\log_2 V) 或 O(V);模型 MB 级 |
| Word2vec | 词级 CBOW / Skip-gram | 语义表示质量高、工具生态成熟 | 只到词级、OOV 无向量、词表固定 | 词级表示学习 | 无 subword,词表固定 |
| FastText(无监督词向量) | CBOW/Skip-gram + subword 字符 n-gram | 能处理 OOV、低频词稳、对拼写/词形变化友好、多语言预训练向量现成 | 仍是静态词向量,一词一向量,无法区分多义 | 下游任务的初始化、近邻检索、冷启动词 | 训练比 word2vec 略慢(多学 subword);.bin 体积较大 |
| BERT 微调 | Transformer 双向上下文编码 + 微调分类头 | 上下文相关、多义消解、长距离依赖、准确率通常显著更高 | 需 GPU、训练久、模型数百 MB、推理延迟高 | 效果天花板、最终上线的分类器 | O(n^2) attention;百 MB 级 |
演进脉络(只写有把握的部分):
- TF-IDF + 随机森林 → FastText:解决了「稀疏词袋没有语义泛化」和「特征维度爆炸」两个问题。TF-IDF 里「音乐」和「乐曲」是两个正交维度、毫无关系;FastText 的 embedding 让它们天然接近。同时 n-gram 让短语信息以低维稠密特征的形式参与,而随机森林面对的是 10 万维稀疏向量。
- word2vec → FastText(词向量方向):解决了 OOV。word2vec 的词表是封闭的,没见过就是没向量;FastText 加入字符级 subword,未登录词也能由子词拼出向量,这就是材料反复强调的「FastText 与 Word2vec 的核心区别」。
- FastText → BERT:解决了「静态词向量无法区分多义」和「平均池化丢掉语序」两个根本缺陷。FastText 的句向量是词向量集合的平均,对词序不敏感;BERT 用 Self-Attention 让每个词的表示都依赖上下文。代价是算力涨了几个数量级。
- BERT → LLM 零样本/少样本:解决了「每个新任务都要标注数据 + 训练」的问题。在新闻分类项目的四段路线里,最终比的其实是「准确率 / 训练成本 / 推理延迟」这条曲线上的位置,而 FastText 是这条曲线上性价比极高的一档。
CBOW vs Skip-gram(材料高频题 3 的对比,也适用于 FastText 的 train_unsupervised):
| 维度 | CBOW | Skip-gram |
|---|---|---|
| 基本思路 | 上下文预测中心词 | 中心词预测上下文 |
| 适用场景 | 中小规模数据、对训练速度要求高 | 大规模语料、对效果要求高 |
| 低频词表现 | 一般 | 很好 |
| 词向量质量 | 较粗 | 更精细 |
| 特点 | 训练快、效率高、资源消耗低 | 表达能力强、泛化能力好 |
七、在新闻分类项目中的落地
项目语境:类今日头条的新闻标题 10 分类;训练 18w / 测试 1w / 验证 1w,原始格式 标题\t标签;749 个停用词供 TF-IDF 使用。FastText 处在「TF-IDF + 随机森林 → FastText → BERT → LLM」的第二环。
7.1 数据要做的三次转换
FastText 不吃 标题\t标签,也不吃未分词的中文,所以要三步:
import jieba

with open("train.tsv", encoding="utf-8") as fin, \
     open("fasttext_train.txt", "w", encoding="utf-8") as fout:
    for line in fin:
        title, label = line.rstrip("\n").split("\t")
        seg = " ".join(jieba.cut(title))          # 1) 分词(中文必须)
        fout.write(f"__label__{label} {seg}\n")   # 2) 标签前置 3) 每行都补 \n
三个细节别省:标签里的空格要消掉(标签内不能有空格,否则被截断成两个标签);每行都必须以 \n 结尾(包括最后一行);训练/验证/测试用同一份分词逻辑,且 jieba 的词典不要在三个集合之间改变行为。
7.2 10 分类的完整参数与可跑命令
Python API 版(推荐,方便接流水线):
import fasttext

model = fasttext.train_supervised(
    input="fasttext_train.txt",     # 18w 条,__label__标签 分词后的标题
    lr=0.25,                        # 学习率:0.1 起步,效果差提到 0.25~0.5
    epoch=20,                       # 轮数:小数据要加;18w 数据 15~25 足够
    dim=200,                        # 词向量维度:100~200 之间性价比最高
    wordNgrams=2,                   # 词级 bigram,抓「不 好看」这类组合
    loss="softmax",                 # 10 类互斥单标签 → softmax(不是 hs,不用 ova)
    minCount=1,                     # 最小词频
    bucket=2000000,                 # n-gram 哈希桶数(默认值)
    thread=8,                       # 线程数,按 CPU 核数给
    verbose=2,
)

# 评估:三元组 (样本数, 精确率, 召回率)
n, p, r = model.test("fasttext_test.txt")
f1 = 2 * p * r / (p + r) if (p + r) else 0.0
print(f"N={n}  Precision@1={p:.4f}  Recall@1={r:.4f}  F1={f1:.4f}")

# 预测
labels, probs = model.predict("国足 客场 逼平 日本 队")
print(labels[0], probs[0])

# 保存(体积小,可直接进 Flask 服务)
model.save_model("./model/fasttext_news10.bin")
自动调参版(不想手工搜就上这个):
model = fasttext.train_supervised(
    input="fasttext_train.txt",
    autotuneValidationFile="fasttext_valid.txt",  # 1w 条验证集,决定谁是最优
    autotuneDuration=300,                          # 预算 300 秒(默认 60)
    autotuneMetric="f1",                           # 按 F1 选最优
)
model.save_model("./model/fasttext_news10_autotune.bin")
命令行版(CLI,无需写 Python,适合放进 shell 脚本/CI):
# 训练
fasttext supervised \
  -input fasttext_train.txt \
  -output model/fasttext_news10 \
  -lr 0.25 -epoch 20 -dim 200 -wordNgrams 2 \
  -loss softmax -minCount 1 -bucket 2000000 -thread 8

# 评估:输出 N  P@1  R@1 三列
fasttext test model/fasttext_news10.bin fasttext_test.txt

# 预测:-k 3 取 Top-3,-p 输出概率
fasttext predict model/fasttext_news10.bin fasttext_test.txt > preds.txt
fasttext predict-prob model/fasttext_news10.bin -k 3 "国足 客场 逼平 日本 队"

# 自动调参
fasttext supervised -input fasttext_train.txt -output model/news10_auto \
  -autotune-validation fasttext_valid.txt -autotune-duration 300 -autotune-metric f1

# 无监督训练词向量(如领域语料上的中文词向量),会同时产出 .bin 和 .vec
fasttext skipgram -input corpus.txt -output model/zh_news -dim 300 -minn 2 -maxn 5 -epoch 5
参数怎么定(结合课程实测结论):
loss先确定:10 类新闻标题是互斥单标签 →softmax。如果标题要同时打「体育 + 奥运」这类多标签,才换ova。不要用hs:10 类时 O(\log_2 10)\approx3.3 对 O(10) 没有实质收益。lr/epoch是主战场:课程里这两项贡献了最大的一次跃升(0.154 → 0.526)。项目上建议lr=0.25、epoch=20起步,然后在这两个维度上手工扫 3~5 组。wordNgrams=2在 18w 数据上值得开(课程里 1.2w 数据开了反而掉,但 18w 足够支撑 bigram);仍建议做一组 on/off 对比留证据。dim给 100~200,不要一上来 512。课程的dim100→512 只换来 0.27 个点。thread给满 CPU 核数,FastText 是多线程训练的,这是它「快」的工程来源之一。
7.3 实际坑
- 中文不分词:最容易踩,且不报错(见 5 节易错点)。项目里 749 个停用词是给 TF-IDF 的,FastText 训练要不要去停用词要单独做实验,停用词在 FastText 里会参与平均池化,去掉可能让句向量更聚焦,也可能让高频虚词的信息丢失,别默认照搬 TF-IDF 的配置。
- 标签一致性问题:训练集里
__label__体育和__label__体育会被当成两个标签;英文类别名大小写混用同理。转换脚本里先strip()+ 建立标签白名单校验。 - 尾行丢失:任何用
"\n".join()或逐行写文件的地方都要保证末行换行,否则样本数会莫名其妙少几条,18w 数据上可见,20 条数据上直接毁掉模型(作业 1 的 4 条变 3 条就是这个坑)。 - 多标签的评估口径:
test()给的是 P@1/R@1,多标签任务要另设k(model.test(path, k=3))并明确「命中任一正确标签算对」还是「全对算对」,否则和 TF-IDF/BERT 的数字没法并排比较。 - 类别不平衡:
minCountLabel可以扔掉极少见的类别,但新闻 10 分类一般不会遇到;真正要盯的是「模型是否退化成预测多数类」,课程作业 1 里两条预测都是同一个标签 + 置信度 0.89,就是这种退化的典型信号。
7.4 和项目其它方案怎么配合
- 作为 BERT 的下界:先拿到 FastText 的 Precision/Recall/F1,BERT 微调后必须显著超过它才值得多花的那份 GPU 钱和时间。四段路线里这条「逐级对比」的叙事就是项目的方法论亮点。
- 作为 LLM 的对照:DeepSeek API 做零样本/少样本分类,成本和延迟都比 FastText 高好几个量级。用 FastText 证明「便宜方案已经能到多少」,才能说清 LLM 的边际价值在哪。
- 和 TF-IDF + 随机森林比:两者都是 CPU 基线,差别在于 FastText 有语义泛化(近义词共享表示)和更多可用参数(
autotune开箱调参)。留一组同数据集的数字对比,就是「稀疏特征 vs 稠密 embedding」最有说服力的实验。 - 和模型压缩章节的关系:压缩(量化/蒸馏/剪枝)主要针对 BERT 这类大模型;FastText 的定位是压缩前的参照物,它的模型体积和推理延迟就是「轻量」这条线的锚点。蒸馏里「教师-学生」设定同样可以借用这个思路:把 BERT 的软标签蒸馏给一个 FastText 学生模型,看能保住多少准确率,这是低成本高收益的对比实验。
- 部署:FastText
.bin加载后是纯 CPU 前向,可以很自然地挂在 Flask 服务端做在线低延迟分类,和 Streamlit 客户端串起来就是完整的演示链路。
八、重点问答
Q1:什么是 FastText?它的模型结构是什么?
A:FastText 是 Facebook 出的高效文本分类与词向量工具,结构很浅,就三层。第一层是词嵌入层,给词和 n-gram 特征查 embedding;第二层是平均池化层,把一句话里所有 token 的向量逐维平均成一个定长句向量;第三层是线性层,输出类别 logits。所以它说到底是「带 n-gram 的词袋模型 + 一层线性分类器」。这个结构的直接后果有两个:训练极快、模型很小,但丢掉了词序信息,I eat apple 和 apple eat I 学到的句向量一样。
Q2:FastText 为什么快?
A:两点,模型浅 + 输出层做了加速。模型只有三层,参数几乎全在 embedding 上,分类头只有 dim × 类别数 个参数,所以类别数增加几乎不影响训练时间。输出层上,有监督分类用层次化 Softmax,把 O(V) 的多分类变成哈夫曼树上 O(\log_2 V) 次二分类,参数更新只碰路径节点;无监督词向量训练用负采样,每个正样本只采 K 个负样本,复杂度 O(K),K 远小于 V。再加上多线程训练,所以 CPU 上几分钟就能跑完十几万条数据。
Q3:层次化 Softmax 为什么要用哈夫曼树?
A:因为哈夫曼树是带权路径长度最小的二叉树,而 FastText 里节点的权值就是类别频次。这带来两个好处:高频类别离根近、路径短,训练和推理都便宜;同时整棵树的平均路径长度被压到最小。举个具体例子,四个类别 A=5、B=9、C=7、D=3,每次合并最小的两个:3 和 5 合成 8,7 和 8 合成 15,9 和 15 合成根 24;左 0 右 1 后编码是 B=0、C=10、D=110、A=111,平均路径长度 47/24≈1.96 次二分类,比普通 4 分类 Softmax 每次算 4 个 logits 更省。而且它是精确概率模型,不是近似。
Q4:负采样和层次 Softmax 有什么区别?
A:最大的区别是精确性。层次化 Softmax 走的是树路径上的二分类连乘,仍然是精确的概率模型,输出的是类别概率;负采样是把多分类拆成多个独立二分类做对比学习,每个正样本配 K 个负样本,输出的是相似度分数而不是归一化概率,所以它是近似的,用精度换效率。适用场景也不同:层次 Softmax 用于有监督的文本分类,负采样常用于词向量和表示学习。一句话记:HS 给分类,NS 给词向量。
Q5:FastText 和 Word2vec 的核心区别?
A:核心在于 subword。word2vec 只学词级向量,词表是封闭的,遇到没见过的词就没有向量;FastText 在词向量训练时额外学习字符级 n-gram 的子词向量,一个词最终的向量是这些子词向量的平均,所以未登录词只要字符片段见过就能得到表示。另外 FastText 还能做有监督文本分类,而 word2vec 主要是词向量工具。还有一个工程上的差异:中文里简繁、拼写变体因为共享字符片段,向量会很接近,我在预训练向量上验证过,「周杰伦」的近邻里同时出现简体「杰伦」和繁体「周杰倫」。
Q6:FastText 做文本分类的主要步骤?
A:六步。第一步获取数据,格式必须是 __label__标签 文本,中文要先分词;第二步划分训练/验证/测试集;第三步 train_supervised() 训练,重点调 lr、epoch、wordNgrams、dim、loss 这五个参数;第四步用 model.test() 评估,它返回 (样本数, 精确率, 召回率) 三元组,要 F1 得自己算;第五步调优,可以手工扫参也可以直接上 autotuneValidationFile 自动调参;第六步 save_model() 保存、load_model() 加载。注意 loss 的选择由任务决定:单标签用 softmax,类别极多可以考虑 hs,多标签必须用 ova。
Q7:多标签任务上什么 loss,为什么?
A:用 loss="ova",one-vs-all。因为 softmax 会在同一组 logits 上做归一化,隐含假设类别互斥、互相竞争;而多标签任务里一条文本可以同时属于多个类别,需要给每个标签独立的二分类判断,彼此不竞争。我在烹饪数据集上实测过这个现象:数据每行有两三个 __label__,用 softmax 和 hs 时 F1 一直上不去,换成 ova 之后精确率从 0.57 提到 0.61、F1 也抬到最高。所以先看数据是单标签还是多标签,再决定 loss。
Q8:.bin 和 .vec 有什么区别?
A:.bin 是完整模型文件,包含词表、超参、embedding 矩阵、分类器权重和 subword 哈希桶,用 fasttext.load_model() 加载,加载后能做预测、评估,还能对没见过的词做 subword 推断算向量。.vec 是纯文本的词向量表,首行是「词数 维度」,之后每行是「词 + d 个浮点数」,只能用 numpy 之类的工具自己读,OOV 词没有向量。一般是无监督训练词向量时会额外导出 .vec,方便别的框架直接消费。记住一句话:要推理和抗 OOV 就用 .bin。
九、延伸阅读
官方文档与工具
- FastText 官网与文档:https://fasttext.cc/
- 预训练词向量(CommonCrawl + Wikipedia,157 语种,CBOW,300 维):https://fasttext.cc/docs/en/crawl-vectors.html
- 预训练词向量(Wikipedia,294 语种,Skip-gram,300 维):https://fasttext.cc/docs/en/pretrained-vectors.html
- 中文词向量下载:
https://dl.fbaipublicfiles.com/fasttext/vectors-crawl/cc.zh.300.bin.gz - Python 包:
pip install fasttext-wheel(课程采用的预编译版本,免编译器依赖);官方仓库名为fasttext - 中文分词:
jieba
数据集
- 烹饪问答数据集
cooking.stackexchange.txt(Facebook AI 实验室提供,15404 行、多标签);课程中切分为cooking.train(12404 行)与cooking.valid(3000 行)
课程实操清单(复习时按这个顺序重跑一遍)
pip install fasttext-wheel,import fasttext验证head -n 12404/tail -n 3000切分数据集- 跑 8 组调参实验(默认 →
lr/epoch→ 清洗数据 →dim→wordNgrams→loss=hs→loss=ova→ autotune) - 自动调参:
autotuneValidationFile+autotuneDuration - 加载
cc.zh.300.bin,用get_nearest_neighbors()做质检,用余弦相似度算「自然语言处理 / 机器学习 / 深度学习」两两相似度 - 作业 1:自建 20 条、2 类别的
__label__数据,跑通train_supervised()+test()(注意补尾换行)
附:原图存档
本材料的 7 张原图,6 张已按内容位置插入正文并配图注(4.3 哈夫曼树四步构建 + 编码、4.4 层次 Softmax 梯度图);剩余 1 张为装饰性素材:
assets/day10_FastText工具介绍/fasttext-logo-color-web.png,FastText 官方 logo(1890×435),不含技术信息,正文中未展开。