这是从「手写 Transformer」跨到「用 HuggingFace 干活」的那一步,把 transformers 库的三种调用方式(pipeline / AutoModel / 具体模型)、tokenizer 编码、Dataset+collate_fn+DataLoader 供数、BERT 微调五步循环、保存加载与评估预测,用三个可跑通的完整案例(中文分类 / 中文完形填空 / 中文句子关系)从头到尾串了一遍。
一、这份材料解决什么问题
前四天(RNN → 注意力 → Transformer → 英译法案例)走的是从零手写路线:自己定义 nn.Embedding、自己实现多头注意力、自己写训练循环、自己在小语料上从随机初始化学起。这条路把原理讲透了,但它在工程上有个致命短板,没有标注数据就训不出东西,有小数据也训不动。day08 的英译法案例里,模型要在几万条句对上跑很久,才勉强学会一个非常窄的翻译任务。
day10 的 FastText 提供了第一个”不用从零学词向量”的思路(直接用预训练词向量,不更新参数),但那只是词级别的迁移。这份材料要解决的是更大的一步:
- 怎么把在海量无标注文本上训好的 BERT,变成自己任务上的分类器?答案就是预训练 + 微调这套范式;
- 怎么调用这些模型?HuggingFace 把”加载权重、对齐配置、适配任务头、分词、批处理”全部封成了标准 API,而这份材料就是这套 API 的完整实操说明书;
- 怎么把 API 串成一个能跑、能评、能保存、能上线的工程流程?三个案例给出了同一套骨架的三次复用。
它在整条学习链上的位置:
RNN/LSTM/GRU(day03)→ 注意力机制(day04)→ Transformer 架构(day05~07)
    → Transformer 英译法案例(day08,从零手写)
    → FastText(day10,不更新参数的"浅迁移"对照组)
    → transformers 迁移学习(day11,本份:工业化微调)
    → BERT 与 GPT 架构(day12,只取 Encoder / 只取 Decoder)
对新闻分类项目(类今日头条新闻标题 10 分类,路线 TF-IDF+随机森林 → FastText → BERT 微调 → LLM)而言,这份材料就是第三条路线 BERT 的全部代码来源:4.1 迁移学习-中文分类 与项目里的 BERT 微调脚本是同一套骨架,只是把二分类换成 10 分类、把 text 列换成 标题 列。后面第七节会把这条链路逐行对上。
二、核心结论
-
迁移学习 = 预训练模型 + 微调,而微调是”改参数”,不是”用特征”。材料明确区分两种方式:①直接使用预训练模型(不更新参数、直接拿已有表示,典型例子就是 FastText 预训练词向量);②基于微调的迁移学习(重点,在预训练模型基础上继续训练,更新部分或全部参数)。被追问时说”我做了迁移学习”,要能立刻讲清自己做的是哪一种。
-
transformers库有三层应用结构,能力与自由度成反比:pipeline(几行代码出一个任务,适合演示验证)→AutoModel系列(自动匹配结构与配置,适合大多数开发)→ 具体模型类(手动指定,可控性最高)。三者底层是同一套权重和同一套前向逻辑,只是封装层次不同,这是”会用”和”懂”的分界线。 -
tokenizer 的输出是一个字典,不是一串 id。
tokenizer(texts, return_tensors="pt", padding=True, truncation=True, max_length=N)返回input_ids/attention_mask/token_type_ids三个键,形状都是(B, S)。padding决定补齐(True=补到批次内最长,'max_length'=补到固定max_length),truncation决定截断,return_tensors决定是 Python list 还是张量。attention_mask必须原样喂给模型,否则 padding 位置会被当成真实 token 参与注意力计算。 -
微调代码的骨架可以背下来,五个函数就够:
load_data()→collate_fn()+DataLoader→MyBertModel(BertModel + nn.Linear)→train_one_epoch()/evaluate()→train()/test_model()/predict()。训练循环严格走”斌子法则”:前向 → 算损失 → 梯度清零 → 反向 → 更新参数 →(累计指标)。超参数的默认答案:AdamW、lr=1e-5~2e-5、weight_decay=1e-2~1e-3、batch_size=32、epochs=5。 -
三个案例的实测分数,直接说明了”任务设计比模型结构更重要”:中文情感分类(BERT+linear,5 epoch)测试准确率 0.9375;中文句子关系 NSP(先冻结 BERT 后解冻)测试准确率 0.9267;而中文完形填空的测试准确率只有 0.4292,不是因为模型差,而是因为它的标签是随机挖出来的(细节见 4.9)。这三个数字是最好的 mnemonic:同一套代码骨架,任务设计一变,分数就是天壤之别。
三、知识地图
day11 transformers 迁移学习(7 个一级章节)
│
├─ 1 迁移学习概念  ………………………………………………………………………【掌握】
│   ├─ 1.1 学习目标(了解核心概念 / 掌握两种方式)………………【掌握】
│   ├─ 1.2 核心概念:预训练模型(Pretrained Model)、微调(Fine-tuning)
│   └─ 1.3 两种迁移方式:①直接用(不更新参数,FastText 词向量为例)
│                          ②基于微调(更新参数,当前 NLP 最主流)【掌握】
│
├─ 2 NLP 常用预训练模型  …………………………………………………………【理解】
│   ├─ 2.1 主流模型:BERT / GPT / GPT-2 / RoBERTa / DistilBERT / ALBERT /
│   │        Transformer-XL / XLNet / XLM / XLM-R / T5
│   ├─ 2.1 模型参数对比大表(层数 / 特征维度 / 注意力头数 / 参数量 / 语料特点)【理解】
│   ├─ 2.2 选型三问:看任务类型 → 看资源条件 → 看效果与速度平衡  【掌握】
│   └─ 2.3 小结:理解类任务用 BERT 类,生成类任务用 GPT / T5
│
├─ 3 Transformers 库使用  …………………………………………………………【掌握】
│   ├─ 3.1 了解 HuggingFace / transformers 库(官网、Models、Datasets、Docs)
│   ├─ 3.2 三层应用结构:Pipeline / AutoModel / SpecificModel  【掌握】
│   ├─ 3.3 安装:pip 安装 or github 源码安装(clone → checkout v4.19.0 → pip install .)
│   ├─ 3.4 常见 NLP 任务:文本分类 / 特征提取 / 完形填空 / 阅读理解 /
│   │        文本摘要 / NER(含 BIO 标注)【掌握】
│   ├─ 3.5 管道方式完成 6 个任务(pipeline)  ……………………………【掌握】
│   ├─ 3.6 自动模型方式完成 6 个任务(AutoModel + AutoTokenizer)……【掌握】
│   ├─ 3.7 具体模型方式完成 6 个任务(BertModel / BertTokenizer / Bart…)【理解】
│   └─ 3.8 小结
│
├─ 4 迁移学习实践(本份材料的重心)  ……………………………………【掌握】
│   ├─ 4.1 迁移学习-中文分类:load_dataset + collate_fn + DataLoader +
│   │        BertModel+linear + 训练/评估/测试/预测 + 训练曲线 + torch.save
│   ├─ 4.2 迁移学习-中文完形填空:在 collate_fn 里在线挖 [MASK] 造标签
│   ├─ 4.3 迁移学习-中文句子关系(NSP):自定义 Dataset(1 继承 3 重写)+
│   │        在线造负样本 + 冻结 BERT 再逐层解冻
│   └─ 4.4 小结
│
├─ 5 扩展-NLP 中的标准数据集  ………………………………………………【理解】
│   ├─ 5.1 GLUE 是什么、怎么下载(GLUE-baselines)
│   └─ 5.2 GLUE 九个子数据集:CoLA / SST-2 / MRPC / STS-B / QQP /
│            MNLI / QNLI / RTE / WNLI(任务类型 / 输入形式 / 输出 / 指标)
│
├─ 6 常见高频题(原材料给了 4 问:典型流程 / 为什么 AdamW / 为什么分词器必须一致 /
│      灾难性遗忘)(本报告在第八节扩到 8 组)  ………………………【掌握】
│
└─ 7 代码作业(Pipeline 情感分析 4 条 + AutoTokenizer 分词与编码)…【掌握】
四、原理详解
4.1 迁移学习:为什么它成立
直觉。语言本身是有共性的,”苹果”既可以指水果也可以指公司,”打”后面大概率跟具体名词,句子成分之间的依赖关系在任何领域都存在。BERT 在几亿句文本上训过之后,它中间层学到的不是”某个任务的答案”,而是一套通用的语言表示。于是下游任务只需要做两件事:把预训练权重搬过来(当起点,而不是当特征提取器),再在自己那点标注数据上小步继续训练。
机制。材料给出的定义分两个概念:
- 预训练模型(Pretrained Model):在大规模数据集上预先训练好的模型,NLP 领域通常是语言模型(BERT、GPT、RoBERTa、Transformer-XL 等),它学的是通用的语言表示,为下游任务(机器翻译、文本生成、阅读理解)提供特征基础。
- 微调(Fine-tuning):在预训练模型的基础上,改变它的部分参数,或者为其新增部分输出结构,再利用少量标注数据继续训练,使模型适应特定任务。
注意这句里的两个动作,”改部分参数”和”新增输出结构”,后者就是工程上的 nn.Linear(hidden_size, num_labels) 分类头。
两种迁移方式的区别(这是材料 1.3 的核心,也是考查高频点):
| 方式一:直接使用预训练模型 | 方式二:基于微调的迁移学习【重点】 | |
|---|---|---|
| 是否更新参数 | 不更新 | 更新部分或全部参数 |
| 怎么用 | 直接使用已有表示(拿特征,外接模型) | 在预训练模型基础上继续训练 |
| 典型示例 | FastText 预训练词向量 | BERT / RoBERTa 微调 |
| 数据需求 | 极小(只训外接的小模型) | 小到中等(几千~几万条) |
| 地位 | 轻量、快、效果有上限 | 当前 NLP 中最主流的迁移方式 |
带数字的小例子。本份材料的分类案例走的正是方式二:9600 条训练样本,bert-base-chinese 有约 110M 参数(对照 2.1 的大表),学习率压到 2e-5,5 个 epoch、每个 epoch 约 58 秒,就在验证集上从 0.9108 爬到了 0.9300。如果换成从随机初始化的 BERT 在 9600 条上训分类,同样的算力不可能得到这个结果,这就是预训练权重带来的”先验”值多少分的直观量化。
4.2 NLP 常用预训练模型与选型
材料列出的主流模型,按”理解”和”生成”两大阵营分:
- 理解类(Encoder / 双向):BERT(双向编码器,适合文本理解)、RoBERTa(BERT 改进版,训练更充分)、DistilBERT(轻量级)、ALBERT(参数共享,模型更小)、XLNet(结合自回归和自编码优点)
- 生成类(Decoder / 自回归):GPT / GPT-2(解码器,生成式)
- 统一 / 特殊:T5(把一切文本任务统一为生成问题)、Transformer-XL(长文本建模)、XLM / XLM-RoBERTa(多语言)
常见模型参数对比(原表保留,被追问时这张表能直接背出”base 是多少参数”):
| 模型家族 | 模型名称 | 层数 | 特征维度 | 注意力头数 | 参数量 | 训练语料 / 特点 | 典型应用场景 |
|---|---|---|---|---|---|---|---|
| BERT | bert-base-uncased | 12 | 768 | 12 | ≈110M | 英文,不区分大小写 | 文本分类、情感分析、NER |
| BERT | bert-large-uncased | 24 | 1024 | 16 | ≈340M | 英文,不区分大小写 | 高精度文本理解任务 |
| BERT | bert-base-multilingual-uncased | 12 | 768 | 12 | ≈110M | 多语言,不区分大小写 | 多语言分类、跨语种任务 |
| BERT | bert-base-chinese | 12 | 768 | 12 | ≈110M | 中文字级 | 中文分类、NER、匹配 |
| GPT | openai-gpt | 12 | 768 | 12 | ≈110M | 英文,自回归 | 文本生成、语言建模 |
| GPT-2 | gpt2 | 12 | 768 | 12 | ≈117M | 英文 GPT-2 语料 | 对话生成、续写 |
| GPT-2 | gpt2-xl | 48 | 1600 | 25 | ≈1558M | 大规模语料 | 高质量文本生成 |
| Transformer-XL | transfo-xl-wt103 | 18 | 1024 | 16 | ≈257M | 长文本建模 | 长文档建模、语言模型 |
| XLNet | xlnet-base-cased | 12 | 768 | 12 | ≈110M | 排列语言模型 | 文本理解、分类 |
| XLNet | xlnet-large-cased | 24 | 1024 | 16 | ≈340M | 大模型 | 高精度理解任务 |
| XLM | xlm-mlm-en-2048 | 12 | 2048 | 16 | ≈570M | 多语言框架 | 跨语言迁移学习 |
| RoBERTa | roberta-base | 12 | 768 | 12 | ≈125M | BERT 改进版 | 文本分类、匹配 |
| RoBERTa | roberta-large | 24 | 1024 | 16 | ≈355M | 更大规模训练 | 高精度 NLP 任务 |
| DistilBERT | distilbert-base-uncased | 6 | 768 | 12 | ≈66M | 蒸馏模型 | 轻量级文本分类 |
| ALBERT | albert-base-v1 | 12 | 768 | 12 | ≈12M | 参数共享 | 资源受限场景 |
| ALBERT | albert-base-v2 | 12 | 768 | 12 | ≈12M | 改进训练策略 | 高效理解任务 |
| T5 | t5-small | 6 | 512 | 8 | ≈60M | 文本到文本 | 文本生成、摘要 |
| T5 | t5-base | 12 | 768 | 12 | ≈220M | Encoder-Decoder | 翻译、问答 |
| T5 | t5-large | 24 | 1024 | 16 | ≈770M | 大模型 | 高质量生成任务 |
| XLM-R | xlm-roberta-base | 12 | 768 | 12 | ≈125M | 大规模多语言 | 多语言分类、NER |
| XLM-R | xlm-roberta-large | 24 | 1024 | 16 | ≈355M | 多语言大模型 | 跨语种高精度任务 |
表下原文注释:以上模型均基于 Transformer 架构,主要区别在于结构细节和训练数据。
注意这张表里一个容易被忽略的规律:参数量主要由”层数 × 特征维度²”决定。base 的三个数字(12 层 / 768 维 / 12 头)和 large 的三个数字(24 层 / 1024 维 / 16 头)几乎覆盖了被追问时 90% 的提问;而 DistilBERT 是”砍层数”(12→6,参数≈66M)、ALBERT 是”参数共享”(参数掉到 ≈12M 但仍有 12 层),这两条正是后面模型压缩那一环的思路原型。
选型三问(材料 2.2 的原文框架):
- 看任务类型,文本理解任务优先 BERT、RoBERTa、XLNet;文本生成任务优先 GPT、T5;多语言任务优先 XLM、XLM-R。
- 看资源条件,显存和算力充足可选大模型;资源有限优先 DistilBERT、ALBERT。
- 看效果与速度平衡,追求效果选更强的基础模型;追求部署速度选轻量模型。
4.3 transformers 库是什么,以及它的三层应用结构
HuggingFace 是什么。原文定位:一家专注于 NLP 与 AI 工具开发的开源社区,提供海量预训练模型、数据集、教程。官网上三个入口对应三件事:Models(浏览、下载预训练模型)、Datasets(获取公开数据集)、Docs(官方使用文档与代码示例)。域名是 huggingface.co,国内常用镜像 hf-mirror.com。
transformers 库是什么。HuggingFace 推出的 Transformer 架构预训练模型库,特点是:支持 PyTorch 与 TensorFlow 2.0(且支持两个框架互相转换);提供了 NLP 领域大量先进的预训练语言模型;支持快速调用模型、继续预训练、下游任务微调;覆盖 BERT、GPT-2、RoBERTa、XLM、DistilBERT、XLNet、CTRL 等。材料里给的社区热度描述是”被下载超过 1000k 次、GitHub 上超过 150k 个 star”。
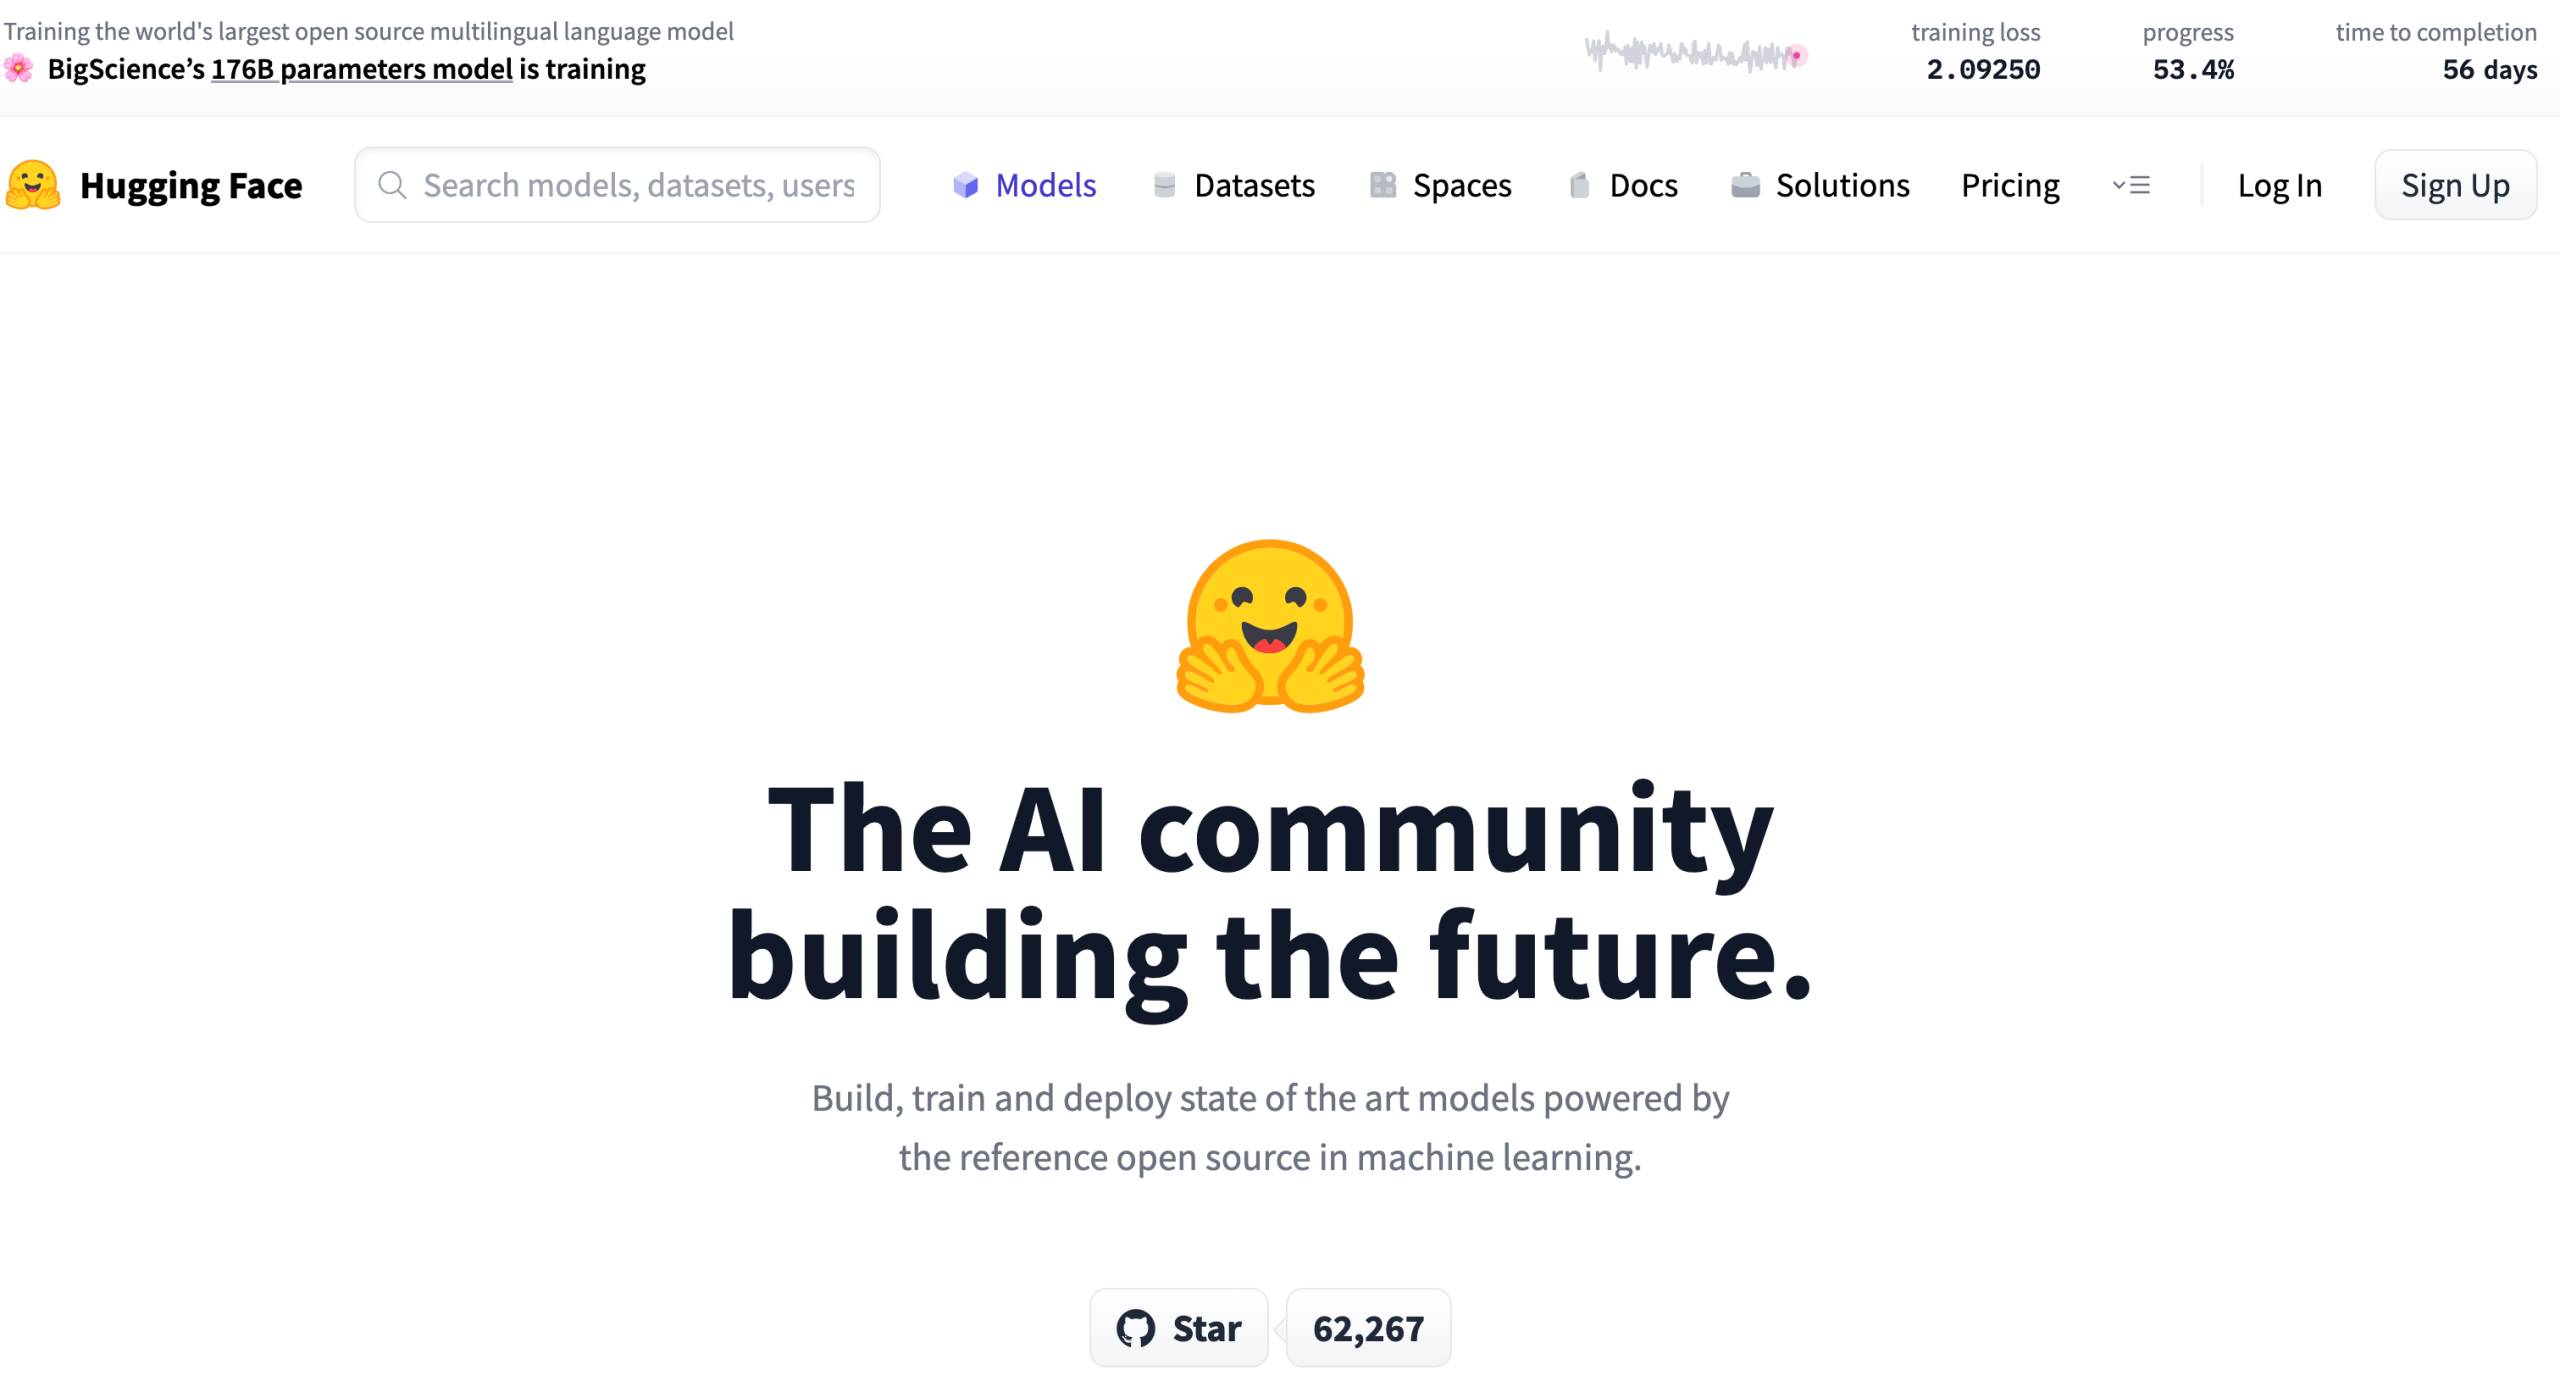
图注:HuggingFace 官网首页截图。顶部黑色横幅是一条模型训练实时进度条,写着 “Training the world’s largest open source multilingual language model / BigScience’s 176B parameters model is training”,右侧三列指标分别是 training loss 2.09250、progress 53.4%、time to completion 56 days。主导航栏从左到右依次是 Hugging Face 笑脸 Logo、搜索框(占位文字 “Search models, datasets, users”)、Models(当前高亮为蓝色)、Datasets、Spaces、Docs、Solutions、Pricing,右侧是 Log In 与 Sign Up。页面正中是黄脸表情 Logo,主标题两行大字 “The AI community building the future.”,副标题 “Build, train and deploy state of the art models powered by the reference open source in machine learning.”,下方是 GitHub Star 按钮和星数 62,267。这张图对应 3.1 小节”HuggingFace 介绍”,Models / Datasets / Docs 就是这份材料里所有代码的资源来源。
三层应用结构(原文表格,本份材料的组织骨架):
| 应用层 | 说明 | 特点 |
|---|---|---|
| 管道(Pipeline) | 高度集成的极简使用方式,几行代码即可实现一个 NLP 任务 | 上手最快,适合快速验证与教学演示 |
| 自动模型(AutoModel) | 自动匹配模型结构,通用简洁,支持 BERT/GPT/T5 等主流模型 | 灵活性与易用性平衡,适合大多数开发场景 |
| 具体模型(SpecificModel) | 需要手动指定具体模型和参数 | 配置更复杂,但可控性最高,适合深度定制 |
三层的能力阶梯可以这样记:pipeline 帮你把 tokenizer + model + 前后处理全包了,你连输入格式都不用管;AutoModel 帮你把”配置匹配”包了,但分词、喂数据、取结果要自己写;具体模型连匹配都自己定,材料在 3.7 里让 BertTokenizer 去加载一个 RoBERTa 权重(NER 案例),能跑通正是因为 roberta-base-finetuned-cluener2020-chinese 与 BERT 结构兼容。
安装(3.3):方法 1 是 pip install transformers datasets;方法 2 是源码安装,git clone https://github.com/huggingface/transformers.git → cd transformers → git checkout v4.19.0 切到指定版本 → pip install . → pip install datasets。原文特意提醒”执行 clone 之前要查看当前在哪个目录下”。
找模型和下载模型的操作路径(3.3 后半段的两张图,是一套可以背下来的”五步法”):
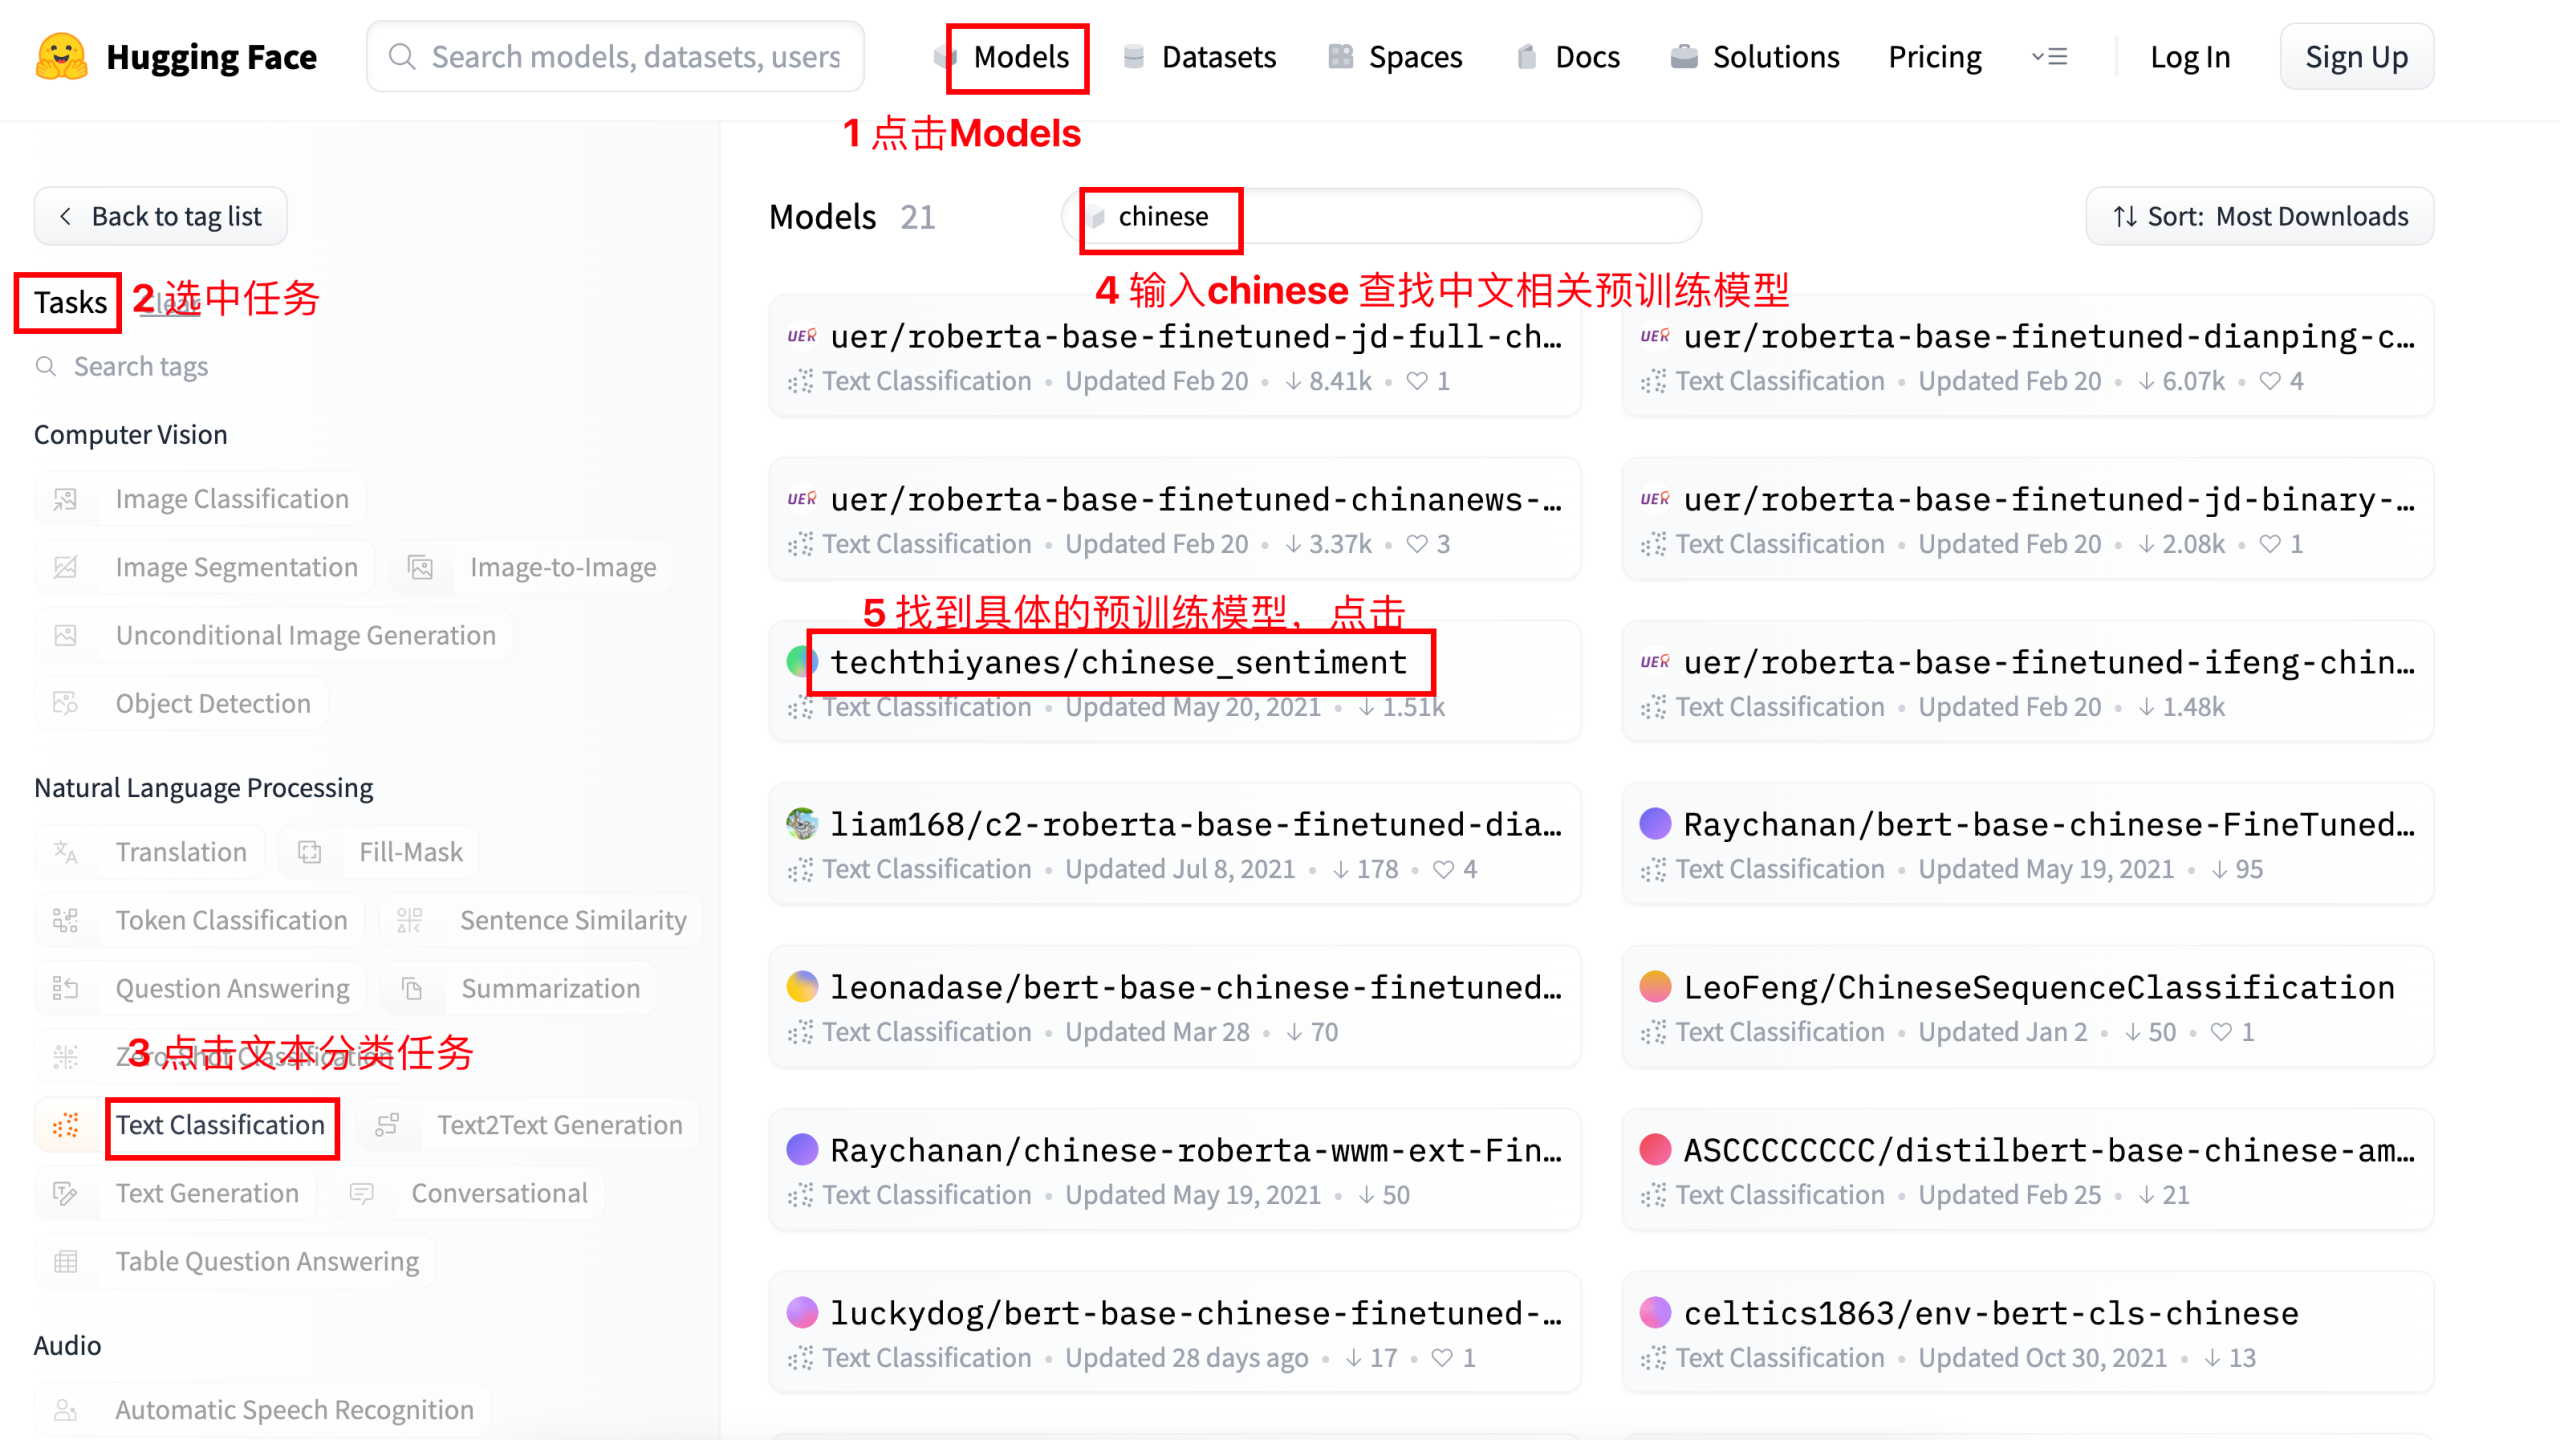
图注:HuggingFace 模型检索页的操作演示,图上有 5 处红色标注按顺序标出了整套流程:①点击 Models(顶部导航的 Models 按钮被红框圈出进入模型库)→ ②选中任务(左侧筛选栏最上方的 Tasks 分组被圈出,展开后可见 Computer Vision 下的 Image Classification、Image Segmentation、Image-to-Image、Unconditional Image Generation、Object Detection,Natural Language Processing 下的 Translation、Fill-Mask、Token Classification、Sentence Similarity、Question Answering、Summarization、Text Generation、Text2Text Generation、Conversational、Table Question Answering,以及 Audio 下的 Automatic Speech Recognition)→ ③点击文本分类任务(在 NLP 分组里选中 Text Classification,红框标注”3 点击文本分类任务”)→ ④输入 chinese 查找中文相关预训练模型(搜索框输入 chinese,结果栏显示 Models 21,右上角排序为 Sort: Most Downloads)→ ⑤找到具体的预训练模型,点击 techthiyanes/chinese_sentiment(该卡片被红框圈出并标注为”#5 upvote”)。结果列表中出现的模型卡片包括 uer/roberta-base-finetuned-jd-full-ch…、uer/roberta-base-finetuned-dianping-c…、uer/roberta-base-finetuned-chinanews-…、uer/roberta-base-finetuned-jd-binary-…、uer/roberta-base-finetuned-ifeng-chin…、techthiyanes/chinese_sentiment、1iam168/c2-roberta-base-finetuned-dia…、Raychanan/bert-base-chinese-FineTuned…、leonadase/bert-base-chinese-finetuned…、LeoFeng/ChineseSequenceClassification、Raychanan/chinese-roberta-wwm-ext-Fin…、ASCCCCCCCC/distilbert-base-chinese-am…、luckydog/bert-base-chinese-finetuned…、celtic1863/env-bert-cls-chinese,每张卡片都带 Text Classification 任务标签、更新日期(如 Updated Feb 20)和下载量/点赞数(如 8.41k、6.07k、3.37k)。
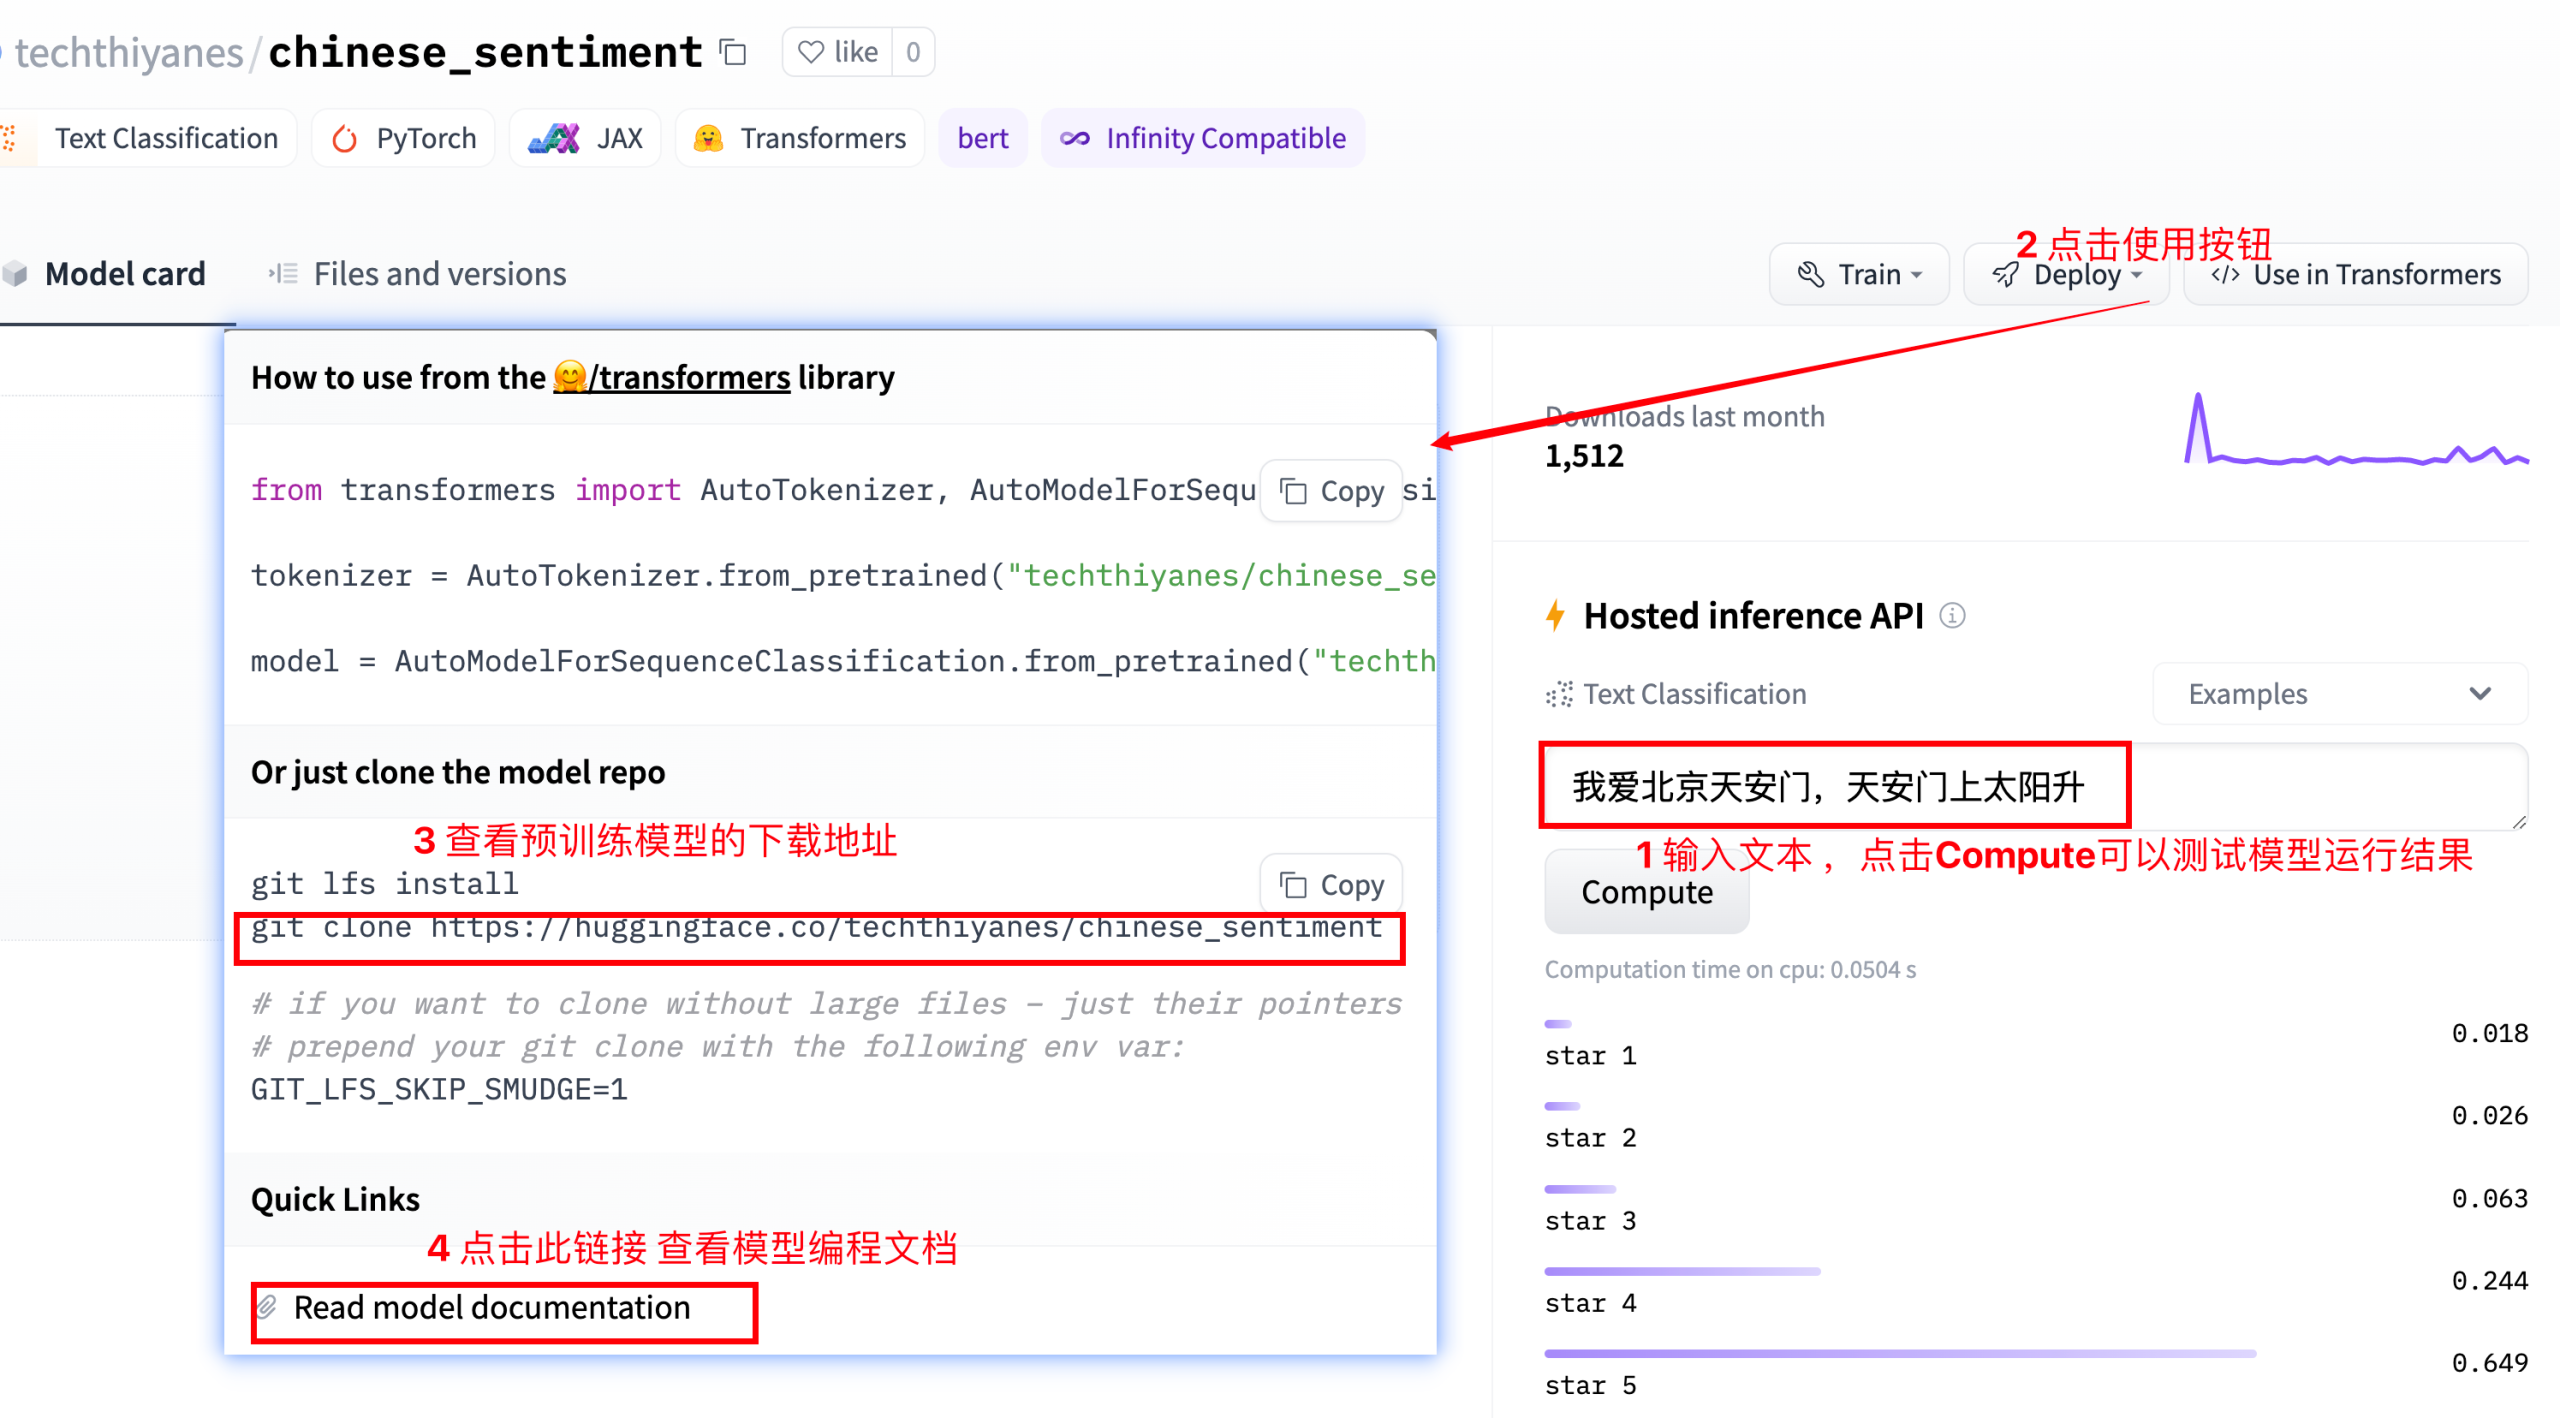
图注:techthiyanes/chinese_sentiment 模型页截图,图上 4 处红色标注解释了”下载并使用一个模型”要看的四件事:①输入文本,点击 Compute 可以测试模型运行结果(右侧 “Hosted inference API” 面板选好 Text Classification 任务,在输入框里填 我爱北京天安门,天安门上太阳升,点 Compute 后显示 Computation time on cpu: 0.0504s,输出的五个类别依次是 star 1 = 0.018、star 2 = 0.026、star 3 = 0.063、star 4 = 0.244、star 5 = 0.649);②点击使用按钮(右上角的 Deploy ▾ 与 Use in Transformers 按钮被圈出);③查看预训练模型的下载地址(Model card 里 “Or just clone the model repo” 区块下的 git lfs install / git clone https://huggingface.co/techthiyanes/chinese_sentiment 被红框圈出,下方还提示了 GIT_LFS_SKIP_SMUDGE=1 只拉取指针文件的技巧);④点击此链接 查看模型编程文档(Quick Links 区的 Read model documentation 被红框圈出)。页面顶部还有模型的标签行 Text Classification / PyTorch / JAX / Transformers / bert / Infinity Compatible、Model card 与 Files and versions 两个页签,以及右侧 “Downloads last month 1,512” 的下载量折线图。关键点:Model card 里那段 “How to use from the Transformers library” 给出的代码模板是 AutoTokenizer.from_pretrained(...) + AutoModelForSequenceClassification.from_pretrained(...),这就是 3.6 节自动模型方式的官方出处。另外这张图还回答了一个实际问题:chinese_sentiment 是 5 分类(star 1~5),不是二分类,所以 4.1 案例里要 preds + 1 才是 1~5 星。
4.4 六种常见 NLP 任务,以及三种调用方式的真实输出对比
材料把要覆盖的任务固定成 6 个,且用同一套函数模板跑三遍(3.5 / 3.6 / 3.7 各一遍):
| 任务 | 核心说明 | 输出形式 / 备注 |
|---|---|---|
| 文本分类 | 对文本内容进行类别判断(情感分类、商品分类),通常属于有监督学习 | 输出类别标签(及概率),结果依赖训练样本标签 |
| 特征提取 | 返回文本的向量表示(语义特征),常作为下游任务输入 | 分为不带任务头(输出隐藏层特征)与带任务头(按任务输出) |
| 完形填空 | 又称遮蔽语言建模(MLM),预测被 [MASK] 遮蔽位置的词 |
输出被遮蔽位置的候选词及概率 |
| 阅读理解 | 又称抽取式问答:输入”上下文 + 问题”,从上下文中抽取答案 | 输出答案文本(通常附带起止位置或置信度) |
| 文本摘要 | 输入长文本,生成简短概括 | 输出摘要文本(可为抽取式或生成式) |
| NER | 命名实体识别,识别人名(PER)、地名(LOC)、组织(ORG)等 | 本质是序列标注/分类任务,常用 BIO 标注:B-(实体开始)、I-(实体内部)、O(非实体) |
方式一:pipeline(3.5)。原文点明的两个关键 API:
my_pipeline = pipeline(
    task=task,          # 任务类型
    model=model,        # 模型路径 or 模型名称(重新下载)
    framework="pt",     # 模型框架, pt-pytorch, tf-tensorflow
)
result = my_pipeline(text, **kwargs)
这里有个只有跑过新版本才会知道的细节,原文以注释形式保留:”transformers 5.x 需要判断是否传入 text”,所以通用函数写成 if text: result = my_pipeline(text, **kwargs) else: result = my_pipeline(**kwargs)。
task 与模型的对应关系(材料里的 6 组,全部用本地 model/ 目录承载):
| # | task | 本地模型目录 | 输入样例 |
|---|---|---|---|
| 1 | sentiment-analysis |
model/chinese_sentiment |
“十一唱的真好,下次别唱了” |
| 2 | feature-extraction |
model/bert-base-chinese |
“是我对你承诺了太多,还是我给的永远都不够” |
| 3 | fill-mask |
model/chinese-bert-wwm |
“停车[MASK]爱枫林晚,霜叶红于二月花” |
| 4 | question-answering |
model/chinese_pretrain_mrc_roberta_wwm_ext_large |
context “孙悟空在蟠桃园吃桃子…” + question “孙悟空在哪里吃桃子” |
| 5 | summarization |
model/distilbart-cnn-12-6 |
BERT 简介的英文段落 |
| 6 | ner |
model/roberta-base-finetuned-cluener2020-chinese |
“我叫胡欢,在清华大学读博士…” |
pipeline 方式的真实输出(原文输出块,可以直接当”效果预期”用):
- 情感分析:
{'label': 'star 2', 'score': 0.3653...},对”十一唱的真好,下次别唱了”这样一句反讽,模型只给了 36% 的置信度,且落在 “star 2″。 - 完形填空:
停车[MASK]爱枫林晚的 top-5 是 最 (0.0739) / 不 (0.0492) / 相 (0.0289) / 偏 (0.0256) / 我 (0.0252),而正确答案是”坐”。这是个非常好的反例:chinese-bert-wwm是 base 预训练权重、没在这个任务上微调过,用 MLM 头直接做填空,最高概率才 7% 且答案是错的。它说明”预训练模型能直接干活”这句话是有条件的。 - 阅读理解:三个问题全部答对且置信度极高,
蟠桃园 (0.9959)、盘子 (0.9979)、桃子 (0.9937)。因为chinese_pretrain_mrc_roberta_wwm_ext_large本身就是在中文机器阅读理解数据上微调过的。对比例 3,结论很清楚:要在某个具体任务上效果好,模型必须在该任务或近似任务上微调过。 - 摘要:能生成合法的英文摘要文本;同时输出了提示
Your max_length is set to 142, but your input_length is only 73...you might consider decreasing max_length manually。 - NER:逐字输出 BIO 标签,
胡=B-name、欢=I-name、清/华/大/学=B/I-organization…、教/授=B/I-position,各标签 score 在 0.44~0.98 之间(北大的 B-organization 只有 0.4438,是最不确定的一个)。 - 还有一个必须认识的警告:加载
chinese-bert-wwm做BertForMaskedLM时输出Some weights of the model checkpoint ... were not used when initializing BertForMaskedLM: ['bert.pooler.dense.bias', 'bert.pooler.dense.weight', 'cls.seq_relationship.bias', 'cls.seq_relationship.weight']。这不是错误,是”预训练权重里有几个头这个任务用不上,丢弃了”,cls.seq_relationship就是 NSP 头。
方式二:AutoModel(3.6)。核心是把”任务”翻译成 AutoModel 子类:
from transformers import (
    AutoConfig,                          # 自动配置
    AutoTokenizer,                       # 自动分词器
    AutoModel,                           # 自动模型(不带任务头,做特征提取)
    AutoModelForSequenceClassification,  # 序列分类
    AutoModelForMaskedLM,                # 掩码语言模型(完形填空)
    AutoModelForQuestionAnswering,       # 问答 / 阅读理解
    AutoModelForSeq2SeqLM,               # 序列到序列(摘要 / 生成)
    AutoModelForTokenClassification      # NER / 词性标注 POS
)
自动模型方式的关键细节被原文自行总结成 4 条(3.6 节开头),每条都是坑:
AutoTokenizer、AutoModelForSequenceClassification既能自动从官网下载,也能加载本地预训练模型;AutoModelForSequenceClassification类管理着分类任务,会根据参数输入选用不同的模型;AutoTokenizer的encode()函数用与不用return_tensors='pt',编码结果不同;encode()用padding='max_length'可以按最大长度补齐,俗称打 padding;调用模型 forward 时传return_dict=False,返回结果也不同。
通用推理函数的写法(这份材料的”上线版”模板,值得直接背):
@torch.no_grad()   # 关闭梯度计算
def demo_auto_model(model, tokenizer, **kwargs):
    inputs = tokenizer(
        **kwargs,
        return_tensors="pt",  # 返回 pytorch 张量
        padding=True,         # 填充到当前批次的最大长度
        truncation=True,      # 截断到最大长度
        max_length=256,       # 最大长度
    )
    # inputs 通常是一个字典,键为:input_ids, attention_mask, token_type_ids
    outputs = model(**inputs)
    return outputs, inputs
六种任务的输出形状与取结果方式(3.6 的真实打印值,这一组数字是被追问时最好用的”我确实跑过”证据):
| 任务 | 模型 | outputs 的形状 |
怎么取结果 |
|---|---|---|---|
| 情感分析 | chinese_sentiment |
logits = (3, 5)(5 类) |
torch.argmax(logits, dim=-1) → tensor([5, 5, 1]),即三条输入分别是 5 星、5 星、1 星 |
| 特征提取 | bert-base-chinese |
last_hidden_state = (3, 15, 768)、pooler_output = (3, 768) |
句子级任务用 pooler_output,token 级任务用 last_hidden_state |
| 完形填空 | chinese-bert-wwm |
logits = (2, 13, 21128)(V=21128) |
argmax(dim=-1) → tensor([3209, 8038])(两条输入各自 mask 位置的预测 id),再 convert_ids_to_tokens |
| 文本摘要 | distilbart-cnn-12-6 |
logits = (1, 236, 50264) |
decode(preds) 出文本 |
| NER | roberta-...-cluener2020-chinese |
logits = (1, 44, 32)(32 个标签) |
argmax(dim=-1) 得到 (44,),再用 my_config.id2label[value.item()] 映射成标签名 |
| 问答 | chinese_pretrain_mrc_..._large |
start_logits/end_logits = (2, 61) |
两个 argmax 得到起止位置,再 decode(inputs.input_ids[i][start:end+1]) |
其中问答那一段的代码几乎是”抽取式问答”的标准答案:
output, inputs = demo_auto_model(
    my_model, my_tokenizer,
    text=questions,                        # 问题列表
    text_pair=[context] * len(questions)   # 上下文列表
)
start_idx = torch.argmax(output.start_logits, dim=-1)
end_idx   = torch.argmax(output.end_logits, dim=-1)
for i, q in enumerate(questions):
    answer = my_tokenizer.decode(inputs.input_ids[i][start_idx[i]:end_idx[i] + 1])
真实结果是 问题:三体2的作者是谁?→ 答案:刘 慈 欣、问题:三体2的主人公有哪些?→ 答案:罗 辑 、 庄 颜 、 郭 正 文 、 章 北 海,注意答案里的空格,这是 char-level 中文 tokenizer 的 decode 行为(每个字之间带空格),需要 replace(" ", "") 处理才好看。
方式三:具体模型(3.7)。把 Auto 系列换成具体类即可:BertConfig / BertTokenizer / BertModel / BertForSequenceClassification / BertForMaskedLM / BertForQuestionAnswering / BertForTokenClassification,摘要任务用 BartForConditionalGeneration + BartTokenizer。代码结构与 3.6 完全一致,唯一区别是类名和”你自己要为选错模型负责”。这也解释了为什么生产环境常用的还是 Auto 系列:写起来一样短,但换模型只需要换路径。
4.5 分词与编码:tokenizer 到底吐出了什么
这是整份材料里最需要精确掌握的一节,因为它决定了训练会不会悄悄变差。
① 一条文本变成 id 的流水线(原文注释原话):文本 → 分词 → token 序列 → 索引序列。
② 输出是一个字典,三个键的意义:
inputs = tokenizer(
    texts,                   # 文本 或 文本列表
    return_tensors="pt",     # 返回张量,pytorch 格式
    padding=True,            # 填充,填充到批次最大长度
    truncation=True,         # 截断,截断到最大长度
    max_length=MAX_LENGTH,   # 最大长度,超参数
)
# inputs.input_ids      : 索引序列张量        (batch_size, seq_len)
# inputs.attention_mask : attention 掩码张量  (batch_size, seq_len) —— 填充掩码
# inputs.token_type_ids : 句子 id / token 类型张量 (batch_size, seq_len) —— 上句 0,下句 1
③ attention_mask 为什么必须有。padding=True 会把一个 batch 里的短句补到最长那句的长度,补出来的位置填充 [PAD]。这些位置本身没有语义,必须通过 attention_mask(1=真实 token,0=PAD)告诉注意力机制”别管它们”。实证:句子关系案例里 collate_fn 用两段式调用 tokenizer(sentence1_list, sentence2_list, ...) 一次性做句对编码,返回的 token_type_ids 才是”上句 0 下句 1″的真正含义。
④ 手工验证一次编码(材料第 7 节的作业 2,是理解这套东西最好的练习)。用 AutoTokenizer.from_pretrained("bert-base-chinese") 编码 今天天气很好,适合出去散步,真实输出为:
input_ids (15 个):
  [101, 791, 1921, 1921, 3698, 2523, 1962, 8024, 6844, 1394, 1139, 1343, 3141, 3635, 102]

token 列表 (15 个):
  ['[CLS]', '今', '天', '天', '气', '很', '好', ',', '适', '合', '出', '去', '散', '步', '[SEP]']

attention_mask:
  [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]

[CLS](101) 在位置: 0  对应 token: '[CLS]'
[SEP](102) 在位置: 14 对应 token: '[SEP]'
三个可以立刻记住的事实:中文 BERT 是字级分词(13 个汉字 + 2 个标点 = 15 个 token,一个汉字一个 id);[CLS]=101 永远在位置 0,[SEP]=102 永远在末尾;[CLS] 位的隐藏状态就是下游分类任务要取的那个向量(作业代码注释原话:”代表整句的分类向量,下游分类任务通常取此位置的隐藏状态作为句子表示”)。
⑤ tokenizer(...) 与 encode/encode_plus/batch_encode_plus(原材料未涉及,按通用知识补充,常被问):
| 调用 | 输入 | 返回 | 说明 |
|---|---|---|---|
tokenizer(...)(即 __call__) |
单条或列表 | 字典(含 input_ids/attention_mask/token_type_ids) |
当前推荐写法。传单条文本时内部走 encode_plus;传列表时内部走 batch_encode_plus 并自动做 padding |
tokenizer.encode(...) |
单条 | List[int](只有 id) |
没有 attention_mask,且会默认带上 [CLS]/[SEP];做训练时不够用 |
tokenizer.encode_plus(...) |
单条 | 字典 | __call__ 的单样本分支,新版本已不推荐直接调用 |
tokenizer.batch_encode_plus(...) |
列表 | 字典 | __call__ 的多样本分支,同样已不推荐直接调用 |
一句话记法:__call__ 是统一入口,encode 只给你 id(不够训练用),encode_plus/batch_encode_plus 是它的内部实现细节,能不用就不用。
4.6 微调实战骨架之供数:load_dataset → Dataset → collate_fn → DataLoader
材料把这条链的意义写在了注释里(4.1 节原文):
Dataset 提供单个样本,collate_fn 将多个样本打包成标准等长批次,Dataloader 自动按批次取数据。
① 数据长什么样。三个 csv(train.csv / validation.csv / test.csv),样式一致,两列 label,text:
label,text
1,选择珠江花园的原因就是方便,有电动扶梯直接到达海边,周围餐馆、食廊、商场、超市、摊位一应俱全。酒店装修一般,但还算整洁。...
1,15.4寸笔记本的键盘确实爽,基本跟台式机差不多了,蛮喜欢数字小键盘,输数字特方便,样子也很美观,做工也相当不错
0,房间太小。其他的都一般。。。。。。。。。
0,"1.接电源没有几分钟,电源适配器热的不行. 2.摄像头用不起来. 3.机盖的钢琴漆,手不能摸,一摸一个印. 4.硬盘分区不好办."
规模是 9600 / 1200 / 1200,batch_size=32 时对应批次数量 300 / 38 / 38。
② 加载。datasets.load_dataset("csv", data_files={"train":..., "valid":..., "test":...}) 返回一个带 split 的字典,直接 dataset["train"] 就是 HF Dataset 对象,它已经实现了 __len__ 和 __getitem__,所以能直接交给 DataLoader,这也是为什么只有 4.3(句子关系)那个案例需要自己写 Dataset 类。
③ collate_fn,把一批”字典样本”变成”一批张量”。分类案例的写法:
def collate_fn(batch, tokenizer=MY_TOKENIZER):
    # 1. 提取文本和标签,batch 形如 [{"text": ..., "label": 0}, ...]
    texts  = [sample["text"]  for sample in batch]
    labels = [sample["label"] for sample in batch]
    # 2. 分词器编码:文本 -> 分词 -> 索引序列
    inputs = tokenizer(texts, return_tensors="pt",
                       padding=True, truncation=True, max_length=MAX_LENGTH)
    # 3. 返回:索引序列字典 + 标签张量
    return inputs, torch.tensor(labels, dtype=torch.long)
④ 组装 DataLoader,注意 collate_fn=lambda x: collate_fn(x, tokenizer=MY_TOKENIZER) 这个 lambda 的写法,因为 DataLoader 只会用默认签名 collate_fn(batch) 调用,想传 tokenizer 就得用 lambda 或 functools.partial 把参数绑进去。另外 shuffle=True 只给训练集,验证/测试集一律 shuffle=False。
⑤ 自定义 Dataset 的”1 个继承、3 个重写”(4.3 句子关系案例)。当你需要在线构造样本(比如随机造负样本)时,就必须自己写 Dataset 类:继承 torch.utils.data.Dataset,重写 __init__、__len__、__getitem__ 三个方法。
class MyDataset(torch.utils.data.Dataset):
    def __init__(self, dataset):          # ① 重写初始化:保存原始数据与长度
        self.samples = list(dataset)
        self.size = len(self.samples)

    def __len__(self):                    # ② 重写 len:返回样本数量
        return self.size

    def __getitem__(self, index):         # ③ 重写 getitem:返回第 index 个样本
        text = self.samples[index]['text']
        sentence1, sentence2 = split_sentence(text)
        if torch.rand(1).item() < 0.5:    # 0.5/0.5 造正负样本
            label = 1                     # 正样本:sentence2 就是原句下半句
        else:
            neg_index = torch.randint(0, self.size, (1,)).item()
            if neg_index == index:        # 越界/自引用保护
                neg_index = (neg_index + 1) % self.size
            _, sentence2 = split_sentence(self.samples[neg_index]['text'])
            label = 0                     # 负样本:从别的句子里随机挑下半句
        return {"sentence1": sentence1, "sentence2": sentence2, "label": label}
这段代码里有三个值得学的工程细节:一是 __init__ 里缓存 len,因为 __len__ 会被 DataLoader 频繁调用;二是 torch.randint 的越界保护(随机到自己的索引就 +1 取模,保证负样本一定是错的);三是在 __getitem__ 里做随机,每个 epoch 重新取样本就会得到不同的负样本组合,等于自带数据增强。
4.7 微调实战骨架之建模:BertModel + nn.Linear
模型类同样固定成”1 个继承、2 个方法”:
class MyBertModel(nn.Module):
    def __init__(self, pretrained_model=PRETRAINED_MODEL, num_labels=NUM_LABELS):
        super().__init__()
        # 1. 初始化预训练 BERT
        self.bert = BertModel.from_pretrained(pretrained_model, local_files_only=True)
        # 2. 定义线性层(下游网络 / 输出头 / 分类头)
        self.linear1 = nn.Linear(self.bert.config.hidden_size, num_labels)
        # 3. 冻结预训练 BERT 参数(可选)
        # for param in self.bert.parameters():
        #     param.requires_grad = False

    def forward(self, input_ids, attention_mask, token_type_ids=None):
        outputs = self.bert(input_ids=input_ids,
                            attention_mask=attention_mask,
                            token_type_ids=token_type_ids)
        # last_hidden_state: (B, S, D) 每个 token 的语义表示 —— token 级任务(POS/NER)
        # pooler_output    : (B, D)     CLS 位置经线性映射后的句子表示 —— 句子级任务(句分类)
        logits = self.linear1(outputs.pooler_output)   # (B, num_labels)
        return logits
为什么句子分类用 pooler_output:原文注释写得很清楚,last_hidden_state 是”所有时间步的隐藏状态,每个 token 的语义表示,(batch_size, seq_len, d_model),用于 token 级任务,比如 POS/NER”;pooler_output 是”CLS 位置的语义表示经过线性映射的结果,当前句子的语义表示,(batch_size, d_model),用于句子级任务,比如句子分类”。用 hidden_size 动态取维度(self.bert.config.hidden_size)是好习惯:换成 bert-large 时 768 会变成 1024,代码不用改。
4.8 微调实战骨架之训练、评估、测试、预测
① 一个轮次(训练),严格按”斌子法则”:
def train_one_epoch(model, train_dataloader, loss_fn, optimizer):
    model.train()                                  # 1. 训练模式
    total_loss = 0.0; total_correct = 0; total_samples = 0
    for x, y in tqdm(train_dataloader, desc="Training"):
        inputs = {k: v.to(DEVICE) for k, v in x.items()}   # 0. 数据迁移到 device
        y = y.to(DEVICE)
        logits = model(**inputs)                   # 1. 前向传播
        loss = loss_fn(logits, y)                  # 2. 计算损失
        optimizer.zero_grad()                      # 3. 梯度清零
        loss.backward()                            # 4. 反向传播
        optimizer.step()                           # 5. 更新参数
        # 6. 累计指标(用 loss.item()*y.size(0) 而不是 loss.item())
        total_loss    += loss.item() * y.size(0)
        total_correct += (logits.argmax(dim=-1) == y).sum().item()
        total_samples += y.size(0)
return total_loss / total_samples, total_correct / total_samples两个细节值得单独记:inputs = {k: v.to(DEVICE) for k, v in x.items()} 这个字典推导式把三个张量一次性搬上 GPU,然后再 model(**inputs) 解包,比手写三个 .to(DEVICE) 干净且不会漏;total_loss += loss.item() * y.size(0) 是加权求平均,因为最后一个 batch 可能不满,直接对 loss.item() 求平均会有偏差。
② 评估:把 @torch.no_grad() 装饰在函数上(省显存、提速),把 model.train() 换成 model.eval(),删掉清零/反向/更新三步,其余一模一样。
③ 训练主函数:loss_fn = nn.CrossEntropyLoss(),optimizer = torch.optim.AdamW(model.parameters(), lr=LR, weight_decay=WEIGHT_DECAY),然后 for epoch in range(EPOCHS) 里”训练一轮 → 验证一次 → 按最小验证损失保存模型”,最后把 4 个 list(train_losses/train_accs/valid_losses/valid_accs)打包成字典 torch.save 下来供画曲线用。
if valid_loss < best_valid_loss:          # 只保存"验证损失最小"的那一次
    best_valid_loss = valid_loss
    torch.save(model.state_dict(), MODEL_SAVE_PATH)
这是整个训练流程里最有价值的一行 if:模型存在磁盘上的永远是最好的一版,而不是最后一版。配合 plot_training_curves()(两个子图:left=loss 曲线,right=acc 曲线)就能一眼看出过拟合发生在哪一轮。
④ 测试与预测:
@torch.no_grad()
def predict(text):
    model = MyBertModel().to(DEVICE)
    model.load_state_dict(torch.load(MODEL_SAVE_PATH, map_location=DEVICE))
    model.eval()
    inputs = MY_TOKENIZER(text, return_tensors="pt", truncation=True,
                          padding=True, max_length=MAX_LENGTH)
    inputs = {k: v.to(DEVICE) for k, v in inputs.items()}
    logits = model(**inputs)
    y_class = logits.argmax(dim=-1)                 # (batch_size,)
    y_probs = F.softmax(logits, dim=-1)             # 预测概率
预测必须走一遍和训练完全一致的 tokenizer 参数(同样的 max_length、同样的 truncation/padding),这是训练/推理不一致(training-serving skew)最常见的来源。
4.9 三个案例的实测结果对比:任务设计 > 模型结构
这是本份材料最容易被读过去、但最出彩的一段。三个案例用同一套骨架(同一个 MyBertModel、同一个 AdamW、同一个”五步循环 + 最小验证损失保存”),只换了任务和标签构造方式,结果差了 0.5:
| 案例 | 任务形式 | 类别数 | 关键超参 | 训练 5 轮后的验证指标 | 测试集指标 |
|---|---|---|---|---|---|
| 4.1 中文分类 | 句子级分类(好评/差评) | 2 | lr=2e-5, wd=1e-2, max_length=80 |
epoch1: 0.9108 → epoch3: 0.9233 → epoch5: 0.9292 | loss 0.1933, acc 0.9375 |
| 4.2 中文完形填空 | token 级分类(预测 [MASK]) |
vocab_size=21128 |
lr=1e-5, wd=1e-3, max_length=80 |
epoch1: 0.2602 → epoch5: 0.4437 | loss 3.9278, acc 0.4292 |
| 4.3 中文句子关系(NSP) | 句对分类(是不是下一句) | 2 | lr=1e-5, wd=1e-3, max_length=80,前 2 轮冻结 BERT |
epoch1: 0.8090 → epoch2: 0.8357 →(解冻)epoch3: 0.9041 → epoch5: 0.9266 | loss 0.2004, acc 0.9267 |
案例一(分类)里的过拟合证据。逐轮记录是:
EPOCH: 1/5 | 训练损失: 0.2901, 训练准确率: 0.8894 | 验证损失: 0.2531, 验证准确率: 0.9108  ← 保存
EPOCH: 2/5 | 训练损失: 0.1617, 训练准确率: 0.9433 | 验证损失: 0.2419, 验证准确率: 0.9183  ← 保存
EPOCH: 3/5 | 训练损失: 0.1034, 训练准确率: 0.9673 | 验证损失: 0.2146, 验证准确率: 0.9233  ← 保存
EPOCH: 4/5 | 训练损失: 0.0624, 训练准确率: 0.9790 | 验证损失: 0.2659, 验证准确率: 0.9300  ← 未保存
EPOCH: 5/5 | 训练损失: 0.0442, 训练准确率: 0.9842 | 验证损失: 0.2884, 验证准确率: 0.9292  ← 未保存
训练损失一路降到 0.0442,训练准确率 0.9842,但验证损失从第 3 轮的 0.2146 掉头回升到 0.2884,这是教科书级的过拟合拐点,best_valid_loss 机制精准地在第 3 轮之后就不再保存了。所以磁盘上的模型是 epoch3 那一版,而测试集 0.9375 略高于 epoch3 的验证 0.9233,属于正常波动。
预测环节的 5 条测试(反讽和低置信度都出现了,是很实用的”模型能力边界”演示):
预测结果: tensor([1, 1, 1, 1, 0]), 预测概率:
  [[0.0885, 0.9115],   # 我非常喜欢这个模型       -> 1, 91.15%
   [0.1673, 0.8327],   # 我非常喜欢胡欢姐姐       -> 1, 83.27%
   [0.4622, 0.5378],   # 芮华哥哥唱歌真好听       -> 1, 只有 53.78%(低置信度)
   [0.2180, 0.7820],   # 月入过亿,就来黑马程序员 -> 1, 78.20%
   [0.5435, 0.4565]]   # 这个电影真好看,下次不来了 -> 0, 54.35%(反讽被识别)
案例二(完形填空)为什么只有 0.4292,这是本份材料最值得深挖的一个坑。它的标签是”在 collate_fn 里在线挖出来的”:
input_ids = inputs["input_ids"]                     # (batch_size, seq_len)
seq_length = input_ids.shape[1]
index_mask = torch.randint(1, seq_length - 1, (1,)).item()   # ← 整个 batch 共用同一个位置
labels = input_ids[:, index_mask].clone()                    # 标签 = 该位置的真实 token
input_ids[:, index_mask] = tokenizer.mask_token_id           # 把该位置替换为 [MASK]
四个问题,层层递进:
torch.randint(...,(1,))只生成了一个位置,整个 batch 共用。也就是说一个 batch 里 32 条句子挖的是同一个列号,这既浪费了 batch 的信息量(等价于样本量被砍到 1/32),也让每步的梯度极其单一。padding=True先补齐到 batch 内最长,随机位置可能落在[PAD]区。短句子的尾部全是[PAD](id 0),这时候labels拿到的就是[PAD]本身,模型只要学会预测[PAD]就能白拿一部分准确率。实测的 top-5 预测第一位恰好就是'[PAD]'(概率 0.0301),与这个推断吻合。- 随机位置不保证是”值得预测”的词。挖到的可能是一个逗号、一个语气词,甚至是已经
[PAD]的位置;真正的 MLM 预训练会挑选 15% 的位置并做 80/10/10 的替换策略,而且屏蔽的是整个 batch 里每条样本各自的位置。 - 类别数是
vocab_size = 21128,也就是要在 2 万多个类上做分类,任务难度天然远高于 2 分类,这也解释了为什么验证损失在 6 附近、准确率只有 0.26~0.44 时就已经收敛。
所以正确的结论不是”BERT 做不了完形填空”,而是:微调时”标签怎么构造”决定了任务难不难;标签错了,再强的预训练权重也救不回来。原文在 model.forward 里其实给了正确的取特征方式(outputs.last_hidden_state[:, index_mask, :] 取对应位置的隐藏状态,而不是 pooler_output),这部分设计是对的;错的只有标签来源。
预测函数 predict 也有一个值得注意的细节,它是从输入里反查 [MASK] 位置的:
mask_positions = torch.where(inputs["input_ids"][0] == MY_TOKENIZER.mask_token_id)[0]
index_mask = mask_positions[0].item()
输入 是我对你[MASK]了太多(期望填”承诺”),返回的 top-5 是 ['[PAD]', '看', '有', '买', '的'],概率全在 3% 以下,这就是”训练目标有缺陷”的直接后果:模型没学会按上下文填空,只学会了把 [PAD] 和几个高频字排在前面。
案例三(NSP)为什么是这份材料里工程价值最高的一段。它是唯一一个做了两阶段训练策略的案例:
class MyBertModel(nn.Module):
    def __init__(self, pretrained_model, num_labels):
        super().__init__()
        self.bert = BertModel.from_pretrained(pretrained_model, local_files_only=True)
        self.linear = nn.Linear(self.bert.config.hidden_size, num_labels)
        for param in self.bert.parameters():      # ← 先全部冻结
            param.requires_grad = False

# 训练主循环里:
for epoch in range(EPOCHS):
    if epoch == 2:                                # 第 3 个 epoch 开始解冻
        print(">>> 解冻 BERT 参数,开始联合微调")
        for param in model.bert.parameters():
            param.requires_grad = True
配合逐轮记录,效果非常直观:
[1/5] 训练损失 0.6111  acc 0.6543 | 训练时间 25.45s | 验证损失 0.4430  验证准确率 0.8090
[2/5] 训练损失 0.4015  acc 0.8276 | 训练时间 24.78s | 验证损失 0.3676  验证准确率 0.8357
>>> 解冻 BERT 参数,开始联合微调
[3/5] 训练损失 0.2763  acc 0.8850 | 训练时间 61.03s | 验证损失 0.2513  验证准确率 0.9041  ← 验证准确率跳了 7 个点
[4/5] 训练损失 0.2118  acc 0.9165 | 训练时间 61.40s | 验证损失 0.1978  验证准确率 0.9183
[5/5] 训练损失 0.1653  acc 0.9365 | 训练时间 60.57s | 验证损失 0.1927  验证准确率 0.9266
两个可直接引用的结论:① 冻结阶段每个 epoch 约 25 秒,解冻后约 61 秒(≈2.4 倍),因为解冻后要算并保存全部 110M 参数的梯度;② 解冻那一刻验证准确率从 0.8357 直接跳到 0.9041,说明”先用冻结状态把随机初始化的分类头训稳,再放开预训练权重做精细调整”这个策略确实有效,而且是缓解灾难性遗忘的标准做法。最终测试集 loss 0.2004 / acc 0.9267。
4.10 保存与加载的两种方式(原材料未涉及 save_pretrained,按通用知识补充)
材料里所有案例用的都是 PyTorch 原生方式:torch.save(model.state_dict(), "model/xxx.pth") 存、model.load_state_dict(torch.load(path, map_location=DEVICE)) 读。这在自己训练、自己推理的闭环里完全够用。但一旦要把模型交付出去(换个人、换台机器、丢进 Flask 服务),HuggingFace 方式更省事:
| 维度 | 原生 state_dict(原材料用法) |
save_pretrained / from_pretrained |
|---|---|---|
| 存什么 | 只有参数张量(OrderedDict) |
权重 + config.json(含 id2label 等)+ 分词器文件 |
| 加载前提 | 必须能重新构造出一模一样的模型类(MyBertModel(pretrained_model, num_labels) 参数要对) |
直接 from_pretrained(dir),配置从磁盘读 |
| 换设备 | 要写 map_location=DEVICE(材料里已写) |
自动处理 |
| 适用场景 | 实验迭代、快速复现 | 交付、部署、上传 Hub、被别人复现 |
| 典型代码 | torch.save(model.state_dict(), p) / model.load_state_dict(torch.load(p, map_location=DEVICE)) |
model.save_pretrained(d) + tokenizer.save_pretrained(d) / AutoModelForSequenceClassification.from_pretrained(d) |
Trainer vs 手写训练循环(同样是补充知识,常被问)。材料整份都是手写循环,这有明确的教学理由:只有手写过,才知道 zero_grad / backward / step 的顺序为什么不能乱、attention_mask 为什么必须传、验证损失该拿什么比。而 Trainer 把这一整套(含梯度累积、混合精度、分布式、日志、断点续训)都封装了:
from transformers import TrainingArguments, Trainer
args = TrainingArguments(output_dir="./out", learning_rate=2e-5,
                         per_device_train_batch_size=32, num_train_epochs=5,
                         weight_decay=1e-2, evaluation_strategy="epoch",
                         save_strategy="epoch", load_best_model_at_end=True)
trainer = Trainer(model=model, args=args,
                  train_dataset=train_ds, eval_dataset=valid_ds,
                  data_collator=collate_fn, compute_metrics=compute_metrics)
trainer.train()
选型结论:学习/讲解讲原理 → 手写循环(能讲清每一步);工业训练大模型 → Trainer(省心、自带最佳实践)。用 Trainer 有一个必须知道的坑:它默认会按模型 forward 的参数名去筛选数据列(remove_unused_columns),自定义 Dataset 返回的额外字段(比如材料里完形填空案例塞进 inputs['index_mask'] 的那个键)可能被悄悄删掉,这时要么显式关掉该行为,要么把额外信息放进模型能接收的字段里。材料里用 index_mask 传给 forward 的做法,正好是从”手写”过渡到”用 Trainer”时最容易踩的地方。
4.11 GLUE:微调效果的公共标尺
材料第 5 章(标记为”拓展资料”)介绍了 GLUE。是什么:GLUE(General Language Understanding Evaluation)是用于评估 NLP 模型能力的基准数据集集合,包含多种典型任务(分类/相似度/推理)。应用:BERT / RoBERTa 等模型的标准评测基准;覆盖主流 NLP 任务类型;工业界与学术界通用 benchmark。下载方式:https://github.com/nyu-mll/GLUE-baselines.git。一句话总结:GLUE 是”多任务 NLP 评测标准,用来衡量模型是否真正理解语言”。
九个子数据集(原文表格):
| 数据集 | 任务类型 | 输入形式 | 输出 | 指标 |
|---|---|---|---|---|
| CoLA | 语法判断 | 单句 | 二分类 | MCC |
| SST-2 | 情感分析 | 单句 | 二分类 | ACC |
| MRPC | 句子相似 | 句子对 | 二分类 | ACC/F1 |
| STS-B | 相似度 | 句子对 | 回归(0-5) | Pearson |
| QQP | 问题重复 | 句子对 | 二分类 | ACC/F1 |
| MNLI | 自然语言推理 | 句子对 | 三分类 | ACC |
| QNLI | 问答推理 | 句子对 | 二分类 | ACC |
| RTE | 推理 | 句子对 | 二分类 | ACC |
| WNLI | 指代推理 | 句子对 | 二分类 | ACC |
这张表对新闻分类项目有一层实际意义:我们的新闻标题 10 分类,说到底是”单句 → 多分类”,和 SST-2 / CoLA 同构,也就是说,如果要把项目方法写成”标准范式”,可以说”输入形式对齐 GLUE 的单句分类子集,指标用 ACC”,这比单说”准确率 93%”更有说服力。
五、易错点与常见误解
1)常见说法:”抽取稿里的 if valid_loss best_valid_loss: 直接抄进编辑器,报 SyntaxError”;实际上,原文件是 if valid_loss < best_valid_loss:。
- 为什么:HTML 在转纯文本时把
<当标签起始符吃掉了。同一份材料里还有另外两处同样的损伤:if len(text) 2:应为if len(text) < 2:、if torch.rand(1).item() 0.5:应为< 0.5,以及句子关系案例里print(">>> 解冻 BERT 参数,开始联合微调 )少了一个引号。看抽取稿时要对”缺了比较运算符”有警觉,这是这个项目所有.原文.md的通病。
2)有人以为”tokenizer 随便选一个中文的就行”;实际上,必须与预训练权重配套使用。
- 原因在于,词表和子词切分方式必须与预训练时完全一致,否则同一个 id 对应的 token 完全错位,等于给模型喂乱码,OOV 也会激增。这是原文第 6 章的第 3 道高频题的答案,也是工程上最容易犯的错(例如用
BertTokenizer配 RoBERTa 权重,材料 3.7 能跑通是因为那个 checkpoint 结构与 BERT 兼容,能跑不等于对)。
3)常听到的一种说法是:”padding 之后直接把 **inputs 喂给模型就行,attention_mask 是自动的”;实际上,attention_mask 必须传,而且训练/推理都要传。
- 背后的道理是,
padding=True补出来的[PAD]位置没有语义,模型靠attention_mask才能忽略它们。忘了传,模型会把 padding 当成真实 token 参与注意力计算,指标会悄悄掉几个点,而且极难 debug。材料里每一次model(**inputs)都是整字典解包,就是刻意的写法。
4)容易想岔的地方:”情感分类输出 tensor([5, 5, 1]),说明标签是 5/5/1″;实际上,模型输出的是 0-based 索引,真实星级要 +1。
- 之所以如此,
chinese_sentiment是 5 分类,模型内部类别是 0~4,材料在打印时写了print(f"{preds+1}(1~5)")。同理,任何argmax出来的结果都要先确认”类别 id 与业务标签的映射表”(材料在 NER 案例里用my_config.id2label[value.item()]做这件事,这是最规范的做法)。
5)先说一个误解:”Some weights of the model checkpoint ... were not used when initializing BertForMaskedLM 是加载失败”;实际上,这是正常提示。
- 为什么:预训练权重里包含一些当前任务用不上的头(例如
cls.seq_relationship就是 NSP 头、bert.pooler.dense是句子级池化层),HuggingFace 会丢掉它们并提示。原文的提示文本自己也解释了”This IS expected if you are initializing … from the checkpoint of a model trained on another task”。
6)常见说法:”微调学习率跟平时训练一样用 1e-3″;实际上,BERT 微调的默认量级是 1e-5 ~ 5e-5。
- 原因在于,预训练权重已经处在很好的解上,学习率过大会”一步踩空”、直接破坏预训练学到的表示,也就是灾难性遗忘。材料里分类案例用
2e-5(注释直接写”BERT 微调的学习率,通常设为 2e-5″),填空和句对案例用1e-5。
7)有人以为”冻结了 BERT 参数,就可以少传几个参数给优化器了”;实际上,冻结后仍应把优化器只绑定到 requires_grad=True 的参数上。
- 背后的道理是,材料句子关系案例里
for param in model.bert.parameters(): param.requires_grad = False之后,优化器仍然是AdamW(model.parameters(), ...),这会把冻结参数也交给优化器。虽然因为梯度是None,AdamW 不会真的更新它们,但会白白占用优化器的状态内存、也让”冻结”变得不彻底(权重的 weight_decay 逻辑仍可能被触及)。规范写法是filter(lambda p: p.requires_grad, model.parameters())。
8)常听到的一种说法是:”padding=True 就是把所有句子补齐到 max_length“;实际上,padding=True 补到的是当前批次内最长句子的长度;要固定长度必须写 padding='max_length'。
- 之所以如此,这一点材料 3.6 的笔记写得很准:”
padding=True,是否填充,填充到当前批次的最大长度”。两者的差别决定了张量形状是(B, batch内最长)还是(B, max_length)。当truncation=True而没给max_length时,还会看到这条警告:Asking to truncate to max_length but no maximum length is provided and the model has no predefined maximum length. Default to no truncation.,截断根本没生效。
9)容易想岔的地方:”完形填空案例的 NUM_LABELS = MY_TOKENIZER.vocab_size,跟前面分类一样接个 pooler_output 线性层就行”;实际上,这是 token 级任务,必须取对应位置的 last_hidden_state。
- 为什么:材料里
forward写的是logits = self.linear(outputs.last_hidden_state[:, index_mask, :]),这是对的;但if index_mask is None: logits = self.linear(outputs.pooler_output)这个分支容易让人误解成”两种都能用”。句子分类要用池化后的句子表示,token 分类必须用那个具体位置的表示,取错了维度对不上((B,D)vs(B,V))。
10)先说一个误解:”完形填空训练出来的模型能用了,测试准确率 0.4292 也不低”;实际上,这个数字几乎全是”标签构造缺陷”贡献的假分。
- 原因在于,如 4.9 分析的,整 batch 共用一个随机 mask 位置、随机位置可能落在
[PAD]区(标签因此变成[PAD])、随机位置不保证可预测。实测 top-1 预测正好是'[PAD]',而输入是我对你[MASK]了太多期望的”承诺”完全没进 top-5。这个案例的价值在于”反面教材”,不在于分数。
11)常见说法:”训练集 shuffle=True,验证集也 shuffle=True 保持一致比较好”;实际上,验证/测试集一律 shuffle=False。
- 背后的道理是,不打乱才能让”每轮验证损失”在不同 epoch 之间可比,也方便定位问题样本。材料里三个 DataLoader 的
shuffle参数分别写的是True / False / False,是标准写法。
12)有人以为”验证准确率一直在涨,说明还能继续训”;实际上,要看验证损失,不是验证准确率。
- 之所以如此,分类案例里 epoch4/5 的验证准确率分别是 0.9300 / 0.9292(看起来还在高位甚至微涨),但验证损失已经从 0.2146 涨到 0.2659 / 0.2884,训练准确率到了 0.9842。模型早就在背训练集了。保存模型用验证损失做判据、并配合早停,就是靠这个信号。
13)常听到的一种说法是:”中文模型对英文文本也能工作,直接拿来跑英文评论”;实际上,会给出没有意义的预测。
- 为什么:材料第 7 章作业 1 的真实输出里,
chinese_sentiment对 “This movie is absolutely fantastic!” 给出star 4 / 0.5832、对 “The service was terrible and I’m very disappointed.” 竟然也给出star 4 / 0.4743(置信度不到 0.5),一条正面一条负面给了同一个标签,就是因为该模型是中文语料上训的、词表里基本没有英文子词。中文任务就老老实实用中文模型。
六、横向对比与研究脉络
6.1 三种调用方式对比
| 维度 | Pipeline | AutoModel 系列 | 具体模型(SpecificModel) |
|---|---|---|---|
| 代码量 | 3 行内 | 10~20 行 | 10~20 行(与 Auto 相同) |
| 配置匹配 | 全自动 | 自动(按 checkpoint 的 config) | 手动指定类 |
| 输入格式 | 原始文本 | 自己 tokenize | 自己 tokenize |
| 前后处理 | 内置(含 task 特定的 argmax/解码) | 自己取 logits / last_hidden_state |
自己取 |
| 可控性 | 最低 | 中 | 最高 |
| 换模型成本 | 改 model= 一行 |
改路径一行 | 要改类名(类不匹配就报错) |
| 适合场景 | 快速验证、教学演示、Demo | 大多数开发场景、微调 | 深度定制、改结构、读源码实验 |
| 本材料对应节 | 3.5 | 3.6 | 3.7 |
一句话:三者是同一模型的不同封装层,效果完全一样(材料用同样的三个中文句子在 3.5/3.6/3.7 里跑出了完全一致的输出);差别只在开发效率和灵活性。
6.2 编码 API 对比
| API | 返回内容 | 是否含 attention_mask |
现状 |
|---|---|---|---|
tokenizer(...) / __call__ |
字典(ids + mask + type_ids) | 是 | 推荐,统一入口 |
tokenizer.encode() |
仅 List[int] |
否 | 可用于快速看 id,训练不够用 |
tokenizer.encode_plus() |
字典 | 是 | 内部实现,官方已不建议直接用 |
tokenizer.batch_encode_plus() |
字典(批量) | 是 | 内部实现,官方已不建议直接用 |
6.3 手写循环 vs Trainer
| 维度 | 手写循环(本材料) | Trainer |
|---|---|---|
| 代码量 | 5 个函数、约 150 行 | 构造参数 + 3 行 |
| 可控性 | 完全可控,每一步都看得见 | 需要在 TrainingArguments 里找开关 |
| 内置能力 | 无(要自己写早停、日志、梯度累积) | 梯度累积、混合精度、分布式、日志、断点续训、自动挑最佳 checkpoint |
| 调试友好度 | 高(断点想打哪儿打哪儿) | 中(回调机制) |
| 隐性陷阱 | 自己别写错顺序 | remove_unused_columns 会删掉数据里的额外字段 |
| 学习价值 | 最高,理解”斌子法则”的唯一途径 | 低 |
| 适合场景 | 学习、讲解、结构简单的任务 | 工业训练、大模型、多卡 |
6.4 保存格式对比
见 4.10 的表格。一句话:实验期用 state_dict(够快够简单),交付期用 save_pretrained(自带 config 和 tokenizer)。
6.5 研究脉络(从”词向量”到”微调范式”)
① 静态词向量(word2vec / GloVe,材料第 1.4 节提到的 FastText 预训练词向量也属这一代)
   —— 迁移的是"词的意思",一个词永远一个向量,不区分上下文;迁移方式:不更新参数
        ↓ 解决不了的问题:多义词、"bank" 在两句里意思不同
② 上下文词向量 / 两阶段范式确立(ELMo,BiLSTM 双向编码)
   —— 第一次明确"先在大语料上预训练、再到下游任务上微调"这个两阶段结构
        ↓ 解决不了的问题:LSTM 无法并行、长距离依赖仍然被稀释
③ Transformer 出现(Attention Is All You Need,2017)
   —— 提供可并行、任意位置直接交互的骨干网络
        ↓ 问题是:怎么用它做"预训练"?只取 Encoder 还是只取 Decoder?
④ Decoder-only 预训练(GPT / GPT-2):自回归语言模型 + 因果掩码
   —— 天生适合生成;单向上下文,理解类任务偏弱
⑤ Encoder-only 双向预训练(BERT,2018)
   —— MLM(双向掩码语言模型)+ NSP(下一句预测),第一次把"双向上下文"做成了可训练目标;
      理解类任务的标配,也是本份材料所有中文案例的底座(bert-base-chinese)
⑥ BERT 的改进与轻量化:RoBERTa(训练更充分)、DistilBERT(6 层,≈66M,蒸馏而来)、
   ALBERT(参数共享,≈12M)、XLNet(排列语言模型,结合自回归与自编码优点)、
   XLM / XLM-R(多语言)
⑦ 统一成生成问题:T5(text-to-text,Encoder-Decoder + ≈60M/220M/770M 三档)
⑧ 工业化落地(HuggingFace transformers 库)
   —— 把 ④~⑦ 全部装进统一 API:AutoModel 负责"配置匹配",from_pretrained 负责"权重加载",
      tokenizer 负责"分词与编码",datasets 负责"数据加载",Trainer 负责"训练循环"
   —— 本份材料正是这一层的完整实操说明书
这条脉络的意义:当被问”你了解哪些预训练模型”时,不要背名字,要按”解决了上一代的什么问题”来讲,这就是 6.5 这条链路的作用。
6.6 GLUE 任务与任务形式的对应
| 上游任务形式 | 对应 GLUE 子集 | 本材料里的等价案例 |
|---|---|---|
| 单句 → 二/多分类 | SST-2、CoLA | 4.1 中文分类(好评/差评) |
| 句对 → 二/多分类/回归 | MRPC、QQP、STS-B、MNLI、RTE、WNLI | 4.3 句子关系 NSP |
| token 级分类 | (GLUE 不含,属 SQuAD / NER 体系) | 4.2 完形填空、NER 案例 |
这张表的作用:把”我自己做的任务”翻译成”学术界认识的任务形式”,被追问时可以说”我的分类任务对齐 GLUE 的 SST-2 形式,指标直接用 ACC”。
七、在新闻分类项目中的落地
新闻分类项目(类今日头条新闻标题 10 分类,路线 TF-IDF+随机森林 → FastText → BERT 微调 → LLM 零样本/少样本,18w/1w/1w 数据、标题\t标签 格式)里,这份材料就是第三条路线 BERT 的全部代码来源。下面把材料的 API 链路逐段对到项目代码上。
1)数据层:load_dataset → 项目自己的 csv/tsv。材料用 load_dataset("csv", data_files={"train":..., "valid":..., "test":...}),对应到项目就是三份 标题\t标签 文件。两种落法:①先转成带 text,label 两列头的 csv 直接复用材料的 load_data();②保持 tsv 原样,写一个极简的 torch.utils.data.Dataset(1 个继承、3 个重写,就是 4.6 节那个 MyDataset),__getitem__ 里读第 index 行、split("\t") 后返回 {"text": 标题, "label": int(标签)}。推荐第 ② 种,因为项目后面还要做类别不均衡检查和 bad case 分析,能自己控制读数更灵活。
2)编码层:collate_fn 的三件套参数就是项目的调参面板。
def collate_fn(batch, tokenizer=TOKENIZER):
    texts  = [s["text"]  for s in batch]
    labels = [s["label"] for s in batch]
    inputs = tokenizer(texts, return_tensors="pt", padding=True,
                       truncation=True, max_length=MAX_LENGTH)
return inputs, torch.tensor(labels, dtype=torch.long)max_length:材料用 80,是因为它的评论文本长(”选择珠江花园的原因就是方便…”那种几十上百字)。项目的输入是新闻标题,中文标题绝大多数在 10~30 字,加上[CLS]/[SEP],max_length=32通常就够,保险可以给 64。这个值直接决定显存和速度(注意力是 O(S^2)),把 80 降到 32 能省下一半以上的注意力算力,对 18w 条数据 × 5 轮的训练时间影响很大。但注意:极端长标题会被truncation=True直接切掉尾部,如果标签线索在标题末尾(今日头条的标题常常把关键信息放后面),就要做长度分布统计再定值。padding=True:补到 batch 内最长,比padding='max_length'更省算力。但别忘了attention_mask会随字典一起进模型(这是材料里{k: v.to(DEVICE) for k, v in x.items()}写法带来的天然好处)。
3)模型层:BertModel + nn.Linear(768, 10)。材料的 MyBertModel 原样可用,只改一个常数:
PRETRAINED_MODEL = r"model/bert-base-chinese"
NUM_LABELS = 10                                # 材料是 2,项目是 10
self.bert = BertModel.from_pretrained(PRETRAINED_MODEL, local_files_only=True)
self.linear1 = nn.Linear(self.bert.config.hidden_size, NUM_LABELS)  # 768 -> 10
logits = self.linear1(outputs.pooler_output)   # 取 [CLS] 句子表示做分类
这里有两个和材料语境不同的注意点:① 类不均衡。10 类新闻的样本量必然不均,nn.CrossEntropyLoss() 默认等权,可以传 weight= 给少数类加权,或者干脆用 CrossEntropyLoss(label_smoothing=...)。② 用 BertModel + 自己的 linear 还是 BertForSequenceClassification:材料用的是前者(自己写头,教学清楚);工程上可以直接用 AutoModelForSequenceClassification.from_pretrained(path, num_labels=10),它内部就是这个结构,但好处是 config.id2label/id2label 会随模型一起保存,做预测时不用再硬编码类别名映射(材料在 NER 案例里用 my_config.id2label[...] 就是这个思路)。
4)训练层:直接照搬”斌子法则”。loss_fn = nn.CrossEntropyLoss(),optimizer = torch.optim.AdamW(model.parameters(), lr=2e-5, weight_decay=1e-2)(材料和二分类都用 2e-5 + 1e-2,可以直接沿用),BATCH_SIZE=32、EPOCHS=5、MAX_LENGTH=32~64。内层批次严格是 前向 → 算损失 → zero_grad() → backward() → step(),指标用 loss.item() * y.size(0) 加权累计。每轮结束用验证损失判据保存最优模型:
if valid_loss < best_valid_loss:
    best_valid_loss = valid_loss
    torch.save(model.state_dict(), MODEL_SAVE_PATH)
18w 训练样本 / batch 32 = 5625 步一轮,5 轮下来一定会看到材料里那个过拟合拐点(训练准确率继续涨、验证损失掉头),这就是项目里该上早停和权重衰减的地方。
5)实际调参建议(按收益排序)。
| 参数 / 手段 | 材料取值 | 项目建议 | 理由 |
|---|---|---|---|
max_length |
80 | 32 或 64 | 标题短,直接决定训练时间(注意力 O(S^2)) |
max_length 过长的代价 |
— | 尾部被截断 | 头条标题的关键词常在后半段,要先看长度分布 |
lr |
2e-5(分类)/ 1e-5(填空、句对) | 2e-5 | 材料注释直接写明”BERT 微调的学习率,通常设为 2e-5″ |
weight_decay |
1e-2(分类)/ 1e-3(填空、句对) | 1e-2 起 | 抗过拟合,配合 AdamW 的解耦权重衰减 |
batch_size |
32 | 32(显存不够就 16 + 梯度累积) | 材料实测 32 每轮约 58 秒(9600 条) |
epochs |
5 | 3~5 + 早停 | 材料 epoch3 之后验证损失就回升了 |
| 冻结/解冻 | 句对案例:前 2 轮冻结,第 3 轮解冻 | 推荐(先把分类头训稳) | 实测解冻后验证准确率 0.8357 → 0.9041,且冻结期每轮快 2.4 倍 |
| 数据增强 | 原文调优建议:回译数据增强、AI 生成同类句 | 可试 | 标题可以做同义改写增强 |
| 学习率调度 | 原文调优建议:周期重启的余弦退火 | 可试 | 材料只列了方向,没给代码 |
6)与项目里其它四种方案怎么配合。材料本身给出了这套 API 的定位,项目里五个方案的关系可以这样讲:
| 方案 | 与本材料的 API 关系 | 在项目里的角色 |
|---|---|---|
| TF-IDF + 随机森林 | 完全无关(无神经网络、无 embedding、无 tokenizer) | 基线,量化”上神经网络值多少分”;749 个停用词就是给它用的 |
| FastText | 对应材料 1.3 的方式一(用预训练词向量、不更新参数) | 轻量基线,证明”有词向量还不够(没有上下文)” |
| BERT 微调 | 本材料的 4.1 案例就是它的实现 | 主力模型,10 分类精度担当 |
| LLM(DeepSeek API 零样本/少样本) | 材料未涉及(无 API 调用),但材料 3.6 的”通用推理函数”是同一个思路:不训练,只前向,直接取结果 |
无标注数据 / 新增类别的快速兜底 |
| 模型压缩(量化/蒸馏/剪枝) | 材料 2.1 表里的 DistilBERT(6 层 / ≈66M)与 ALBERT(参数共享 / ≈12M)就是压缩后的成品形态 | 上线前把 BERT 做小做快 |
7)部署衔接。项目用 Flask(服务端)+ Streamlit(客户端)。材料 predict() 函数就是 Flask 里那个推理接口的原型:加载 state_dict → tokenizer(text, return_tensors="pt", truncation=True, padding=True, max_length=MAX_LENGTH) → model.eval() → logits.argmax(-1) + F.softmax。三个必须保持一致的地方:① MAX_LENGTH 训练/推理必须同值;② 模型 forward 的参数名必须与 collate_fn 产出的键一致(否则 **inputs 直接 TypeError);③ 类别 id → 类别名的映射表要跟着模型一起存(材料 NER 案例用 config.id2label 的做法值得学)。如果最终要交付模型文件,把 4.10 的 save_pretrained 用起来比只存 .pth 更省事,config.json 和词表会一起打包。
8)叙述模板(把这份材料的语言变成项目语言)。
我的新闻标题分类项目一共比了四个模型。TF-IDF + 随机森林是纯统计基线;FastText 是轻量神经网络基线,属于材料里说的”直接使用预训练词向量、不更新参数”的方式一迁移;BERT 是方式二,基于微调的迁移学习,用
bert-base-chinese的 110M 预训练权重,只换一个nn.Linear(768, 10)的分类头,用AdamW+lr=2e-5+weight_decay=1e-2微调,训练循环严格走前向→损失→梯度清零→反向→更新五步,按验证损失保存最优模型。因为标题短,max_length压到 32,把注意力那部分 O(S^2) 的开销省下来;同时借鉴了先冻结 BERT 训分类头、后解冻联合微调的策略。最后一档是调用 DeepSeek API 做零样本分类,用来处理没有标注数据的新类别,也是我理解”预训练 + 提示”与”预训练 + 微调”两条路线差异的对照实验。
八、重点问答
Q1:什么是迁移学习?它的两种方式有什么区别?你项目里用的是哪种?
A:迁移学习的本质是”把在大规模数据上学到的通用语言表示,搬到自己的小任务上”。它有两种方式:一种是直接使用预训练模型,不更新参数,只拿它输出的表示去喂自己的小模型,比如用 FastText 的预训练词向量,这种方式快、数据要求低,但效果有上限;另一种是基于微调的迁移学习,在预训练权重的基础上继续训练、更新部分或全部参数,这是当前 NLP 最主流的做法。区别就在”参数要不要动”:不动参数等于把预训练模型当特征提取器,动参数才是真正把它的知识往下游任务上”挪”。我项目里的 BERT 用的是第二种,bert-base-chinese 的 110M 预训练权重,加一个 nn.Linear(768, 10) 的分类头,用 AdamW、学习率 2e-5 微调,FastText 那一档对应的是第一种,正好形成一个对照。
Q2:transformers 库的三层应用结构是什么?生产里你会选哪一层?
A:三层是管道 Pipeline、自动模型 AutoModel、具体模型 SpecificModel,往上封装越多、自由度越低。Pipeline 用 pipeline(task=..., model=...) 几行就跑通一个任务,前后处理全内置,适合快速验证和演示;AutoModel 系列用 AutoTokenizer + AutoModelForXxx 自动匹配配置,分词、喂数据、取结果要自己写,是大多数开发场景的选择;具体模型就是要手动指定 BertModel/BertTokenizer 这类类名,可控性最高但容易选错。三者的底层是同一套权重和同一套前向逻辑,效果完全一样,课程里我用同样的三句中文在三种方式下跑出了完全一致的输出。生产里我用 AutoModel 层:写起来和具体模型一样短,但换模型只需要改路径一行,不用改类名。
Q3:tokenizer(...) 返回的是什么?三个键分别是什么意思?encode 和它有什么区别?
A:返回一个字典,形状都是 (batch_size, seq_len)。input_ids 是文本经”分词 → token 序列 → 索引序列”得到的 id 张量;attention_mask 是填充掩码,1 表示真实 token、0 表示 padding 出来的 [PAD],必须原样传给模型,否则 padding 位置会被当成真实 token 参与注意力计算,指标会悄悄掉点;token_type_ids 是句子 id,单句任务全是 0,句对任务里上句 0、下句 1,是给 NSP 这类任务用的。return_tensors="pt" 决定返回 PyTorch 张量还是 Python list。tokenizer.encode() 只返回 id 列表、没有 attention_mask,做训练不够用;tokenizer(...) 这个 __call__ 是统一入口,传单条时内部走 encode_plus、传列表时内部走 batch_encode_plus 并自动做 padding,新版本里 encode_plus 和 batch_encode_plus 已经不推荐直接调用了。
Q4:padding、truncation、max_length 到底怎么配合?怎么验证一个中文 BERT 的编码是对的?
A:padding=True 是补齐到当前批次内最长那句的长度,padding='max_length' 才是补到固定的 max_length;truncation=True 是超长截断,但它要配合 max_length 才生效,只写 truncation=True 不给 max_length,会看到 Asking to truncate to max_length but no maximum length is provided 的警告,实际根本没截断。max_length 是决定计算量的大头,因为注意力是 O(S^2),所以标题这种短文本我会把它压到 32 而不是用默认的 128。验证编码我做过一个标准练习:用 bert-base-chinese 编码”今天天气很好,适合出去散步”,得到 15 个 token,input_ids 是 [101, 791, 1921, 1921, 3698, 2523, 1962, 8024, 6844, 1394, 1139, 1343, 3141, 3635, 102],token 列表是 ['[CLS]','今','天','天','气','很','好',',','适','合','出','去','散','步','[SEP]']。三个结论:中文 BERT 是字级分词(一个汉字一个 token)、[CLS] id 101 永远在位置 0、[SEP] id 102 永远在末尾,而下游分类要取的就是 [CLS] 位置的隐藏状态。
Q5:微调 BERT 的完整流程是什么?请把代码骨架说出来。
A:我把它拆成五块。第一块供数:load_dataset 加载 train/valid/test,写一个 collate_fn 把一批 {"text":..., "label":...} 用 tokenizer 批量编码成 padding=True, truncation=True, max_length=N 的张量字典,再用 DataLoader(dataset, batch_size=32, shuffle=True, collate_fn=lambda x: collate_fn(x, tokenizer=TOKENIZER)) 包起来,验证和测试集 shuffle=False。如果要在线上造样本,比如句对任务要随机造负样本,就自己写 Dataset,继承 torch.utils.data.Dataset 并重写 __init__、__len__、__getitem__ 三个方法。第二块建模:class MyBertModel(nn.Module),__init__ 里 BertModel.from_pretrained(...) 加 nn.Linear(self.bert.config.hidden_size, num_labels),forward 里 model.bert(...) 然后取 outputs.pooler_output(句子级)或 last_hidden_state[:, pos, :](token 级)。第三块训练:CrossEntropyLoss + AdamW(model.parameters(), lr=2e-5, weight_decay=1e-2),每个 batch 走前向、算损失、zero_grad()、backward()、step() 五步,指标用 loss.item()*y.size(0) 加权累计。第四块保存:if valid_loss < best_valid_loss 才 torch.save(model.state_dict(), path),保证磁盘上永远是最优那版。第五块测试预测:@torch.no_grad() + model.eval(),预测时用和训练完全一样的 tokenizer 参数,logits.argmax(-1) 出类别、F.softmax 出概率。
Q6:为什么微调要用 AdamW,为什么学习率必须压到 2e-5 这种量级?
A:先答 AdamW。AdamW 是 Adam 的改进版,核心是解耦了权重衰减和梯度更新:原始 Adam 把 L2 正则直接加进梯度里,结果权重衰减项会和自适应学习率耦合在一起,参数尺度大的一更新就被过度惩罚,训练不稳;AdamW 把 weight decay 从梯度更新里拆出来、直接作用在参数上,训练更稳定、泛化也更好。所以在 transformers 微调里 torch.optim.AdamW 基本是默认选择,我项目里用的是 lr=2e-5, weight_decay=1e-2。再答学习率。预训练权重已经处在一个很好的解上,微调只是在这个解附近做精细调整;如果还用 1e-3 这种从头训练的量级,一步就会把预训练学到的表示破坏掉,也就是灾难性遗忘,表现是损失先炸一下、然后很难恢复到微调前的水平。所以 BERT 微调的默认区间是 1e-5 到 5e-5,课程里分类任务用 2e-5、完形填空和句对任务用 1e-5,都是这个道理。顺便说一句,这也是为什么微调通常只需要 3~5 个 epoch:不是模型还要学很多东西,而是它只需要”适应一下”。
Q7:微调时怎么防止灾难性遗忘?冻结参数和逐层解冻具体怎么做?
A:有几个层次的手段。最直接的是冻结:在 __init__ 里 for param in self.bert.parameters(): param.requires_grad = False,只训新加的分类头,这样预训练权重一个数都不会被改,绝对安全,但上限也低。更好的是两阶段,先冻结后解冻:前 2 个 epoch 只训分类头,等它稳定了,在第 3 个 epoch 开始 for param in model.bert.parameters(): param.requires_grad = True,让 BERT 和分类头联合微调。这个策略我实测过:解冻那一刻验证准确率从 0.8357 直接跳到 0.9041,5 轮后测试集 92.67%;代价是每个 epoch 的时间从 25 秒涨到 61 秒,因为要算并保存全部 110M 参数的梯度,大概是 2.4 倍。其它配套手段:把学习率压小、加 warmup、用权重衰减、用早停(监控验证损失而不是验证准确率)、逐层解冻(从顶层往底层一层层放开)。还有一个工程细节必须提:冻结之后优化器最好只绑定 requires_grad=True 的参数,写 filter(lambda p: p.requires_grad, model.parameters()),别把冻结参数也交给优化器,虽然梯度是 None 时 AdamW 不会真的更新它,但会白占优化器状态内存,也让”冻结”不够彻底。
Q8:模型保存用 torch.save(model.state_dict()) 还是 save_pretrained?手写训练循环和 Trainer 怎么选?
A:保存方式看用途。torch.save(model.state_dict(), path) 只存参数字典,加载时必须能重新构造出一模一样的模型类(我的 MyBertModel 要重新传 pretrained_model 和 num_labels),还要写 map_location=DEVICE 处理设备差异,这条路线简单、快,适合实验迭代,课程里三个案例都是这么做的。但一旦要交付或部署,model.save_pretrained(dir) + tokenizer.save_pretrained(dir) 更省事:它会把权重、config.json(里面带 id2label 这种类别映射)和分词器文件一起打包,对方用 AutoModelForSequenceClassification.from_pretrained(dir) 直接就能加载,不用知道你原来的类长什么样。我项目做 Flask 服务时会用后者,因为类别名映射跟着模型走,服务端不用硬编码。训练方式看目的。手写循环(就是”前向 → 损失 → 梯度清零 → 反向 → 更新”这一套)的优点是每一步都看得见、随时能打断点,而且只有手写过才知道 zero_grad 的顺序为什么不能乱、attention_mask 为什么必须传、模型该按验证损失还是验证准确率来存;缺点是早停、日志、混合精度、分布式都得自己写。Trainer 用 TrainingArguments + Trainer(model, args, train_dataset, eval_dataset, data_collator, compute_metrics) 把这些全包了,还自带 load_best_model_at_end,适合正式训练大模型。选法:学习和讲解讲原理用手写循环,工业训练用 Trainer。用 Trainer 要注意一个坑,它默认会按模型 forward 的参数名筛数据列(remove_unused_columns),自定义 Dataset 返回的额外字段可能被悄悄删掉,这就是手写循环里可以自由往 inputs 里塞额外键(比如完形填空案例塞的 index_mask)在 Trainer 下会失效的地方。
九、延伸阅读
官方文档与资源
- HuggingFace 官网:https://huggingface.co/
- Transformers 官方文档(本材料 3.1 的 Docs 入口):https://huggingface.co/docs/transformers
- Datasets 官方文档:https://huggingface.co/docs/datasets
- 国内镜像 HF-mirror(材料 3.1 明确列出):https://hf-mirror.com/models
- transformers 源码仓库:https://github.com/huggingface/transformers.git
- GLUE-baselines(材料 5.1 给出的下载地址):https://github.com/nyu-mll/GLUE-baselines.git
本材料实际用到的中文 / 多语言模型(可直接 git clone 下载到本地 model/ 目录)
| 用途 | 模型 | 材料里的下载地址 | 输出维度 |
|---|---|---|---|
| 中文情感分析(5 分类) | techthiyanes/chinese_sentiment |
https://huggingface.co/techthiyanes/chinese_sentiment | logits (B,5),label 为 star 1~5 |
| 中文特征提取 / 微调底座 | google-bert/bert-base-chinese |
https://huggingface.co/google-bert/bert-base-chinese | last_hidden_state (B,S,768)、pooler_output (B,768) |
| 中文完形填空(MLM) | hfl/chinese-bert-wwm |
https://huggingface.co/hfl/chinese-bert-wwm | logits (B,S,21128) |
| 中文阅读理解(抽取式问答) | luhua/chinese_pretrain_mrc_roberta_wwm_ext_large |
https://huggingface.co/luhua/chinese_pretrain_mrc_roberta_wwm_ext_large | start_logits / end_logits |
| 英文摘要(Seq2Seq) | sshleifer/distilbart-cnn-12-6 |
https://huggingface.co/sshleifer/distilbart-cnn-12-6 | logits (B,S,50264) |
| 中文 NER(CLUENER2020 微调) | uer/roberta-base-finetuned-cluener2020-chinese |
https://huggingface.co/uer/roberta-base-finetuned-cluener2020-chinese | logits (B,44,32),32 个标签,用 config.id2label 映射 |
| 中文情感分析(作业提示里的备选) | uer/roberta-base-finetuned-jd-binary-chinese |
见材料第 7 章作业 1 提示 | 二分类 |
数据集
- GLUE 九个子集(CoLA / SST-2 / MRPC / STS-B / QQP / MNLI / QNLI / RTE / WNLI),下载方式见上;
- 材料自带的中文情感数据:
train.csv(9600) /validation.csv(1200) /test.csv(1200),两列label,text,标签 0=差评、1=好评; - HuggingFace Datasets Hub:https://huggingface.co/datasets
论文(对应第六节研究脉络)
- Attention Is All You Need(Vaswani et al., 2017,arXiv:1706.03762),Transformer 架构本身,day05~07 的来源;
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(Devlin et al., 2018,arXiv:1810.04805),双向预训练 + MLM/NSP,本材料所有案例的底座。
工具链
transformers、datasets(pip install transformers datasets,或 clone 后git checkout v4.19.0 && pip install .)torch/torch.optim.AdamW、tqdm、matplotlib(材料用SimHei字体画训练曲线)huggingface-cli/git lfs(从 Hub 拉取大模型文件;材料图 3 里还提到了GIT_LFS_SKIP_SMUDGE=1只拉指针文件的技巧)