用「信息熵 → 信息增益 → 信息增益率 → 基尼指数」四条主线讲透 ID3 / C4.5 / CART 三代决策树,补齐连续值处理、回归树、剪枝三块工程细节,最后自然过渡到随机森林,也就是新闻分类项目里 TF-IDF + 随机森林 那条基线的单棵树底座。
一、这份材料解决什么问题
决策树是整个树模型家族的原子单元。随机森林、GBDT、XGBoost、LightGBM 全部由决策树堆叠而成;搞不清单棵树的生长规则,后面所有集成方法的参数(max_depth、min_samples_leaf、n_estimators)都只能靠猜。
这份课件要回答的是一个非常朴素的问题:
已知一张表格(若干特征 + 一个标签),我应该先拿哪个特征来提问?
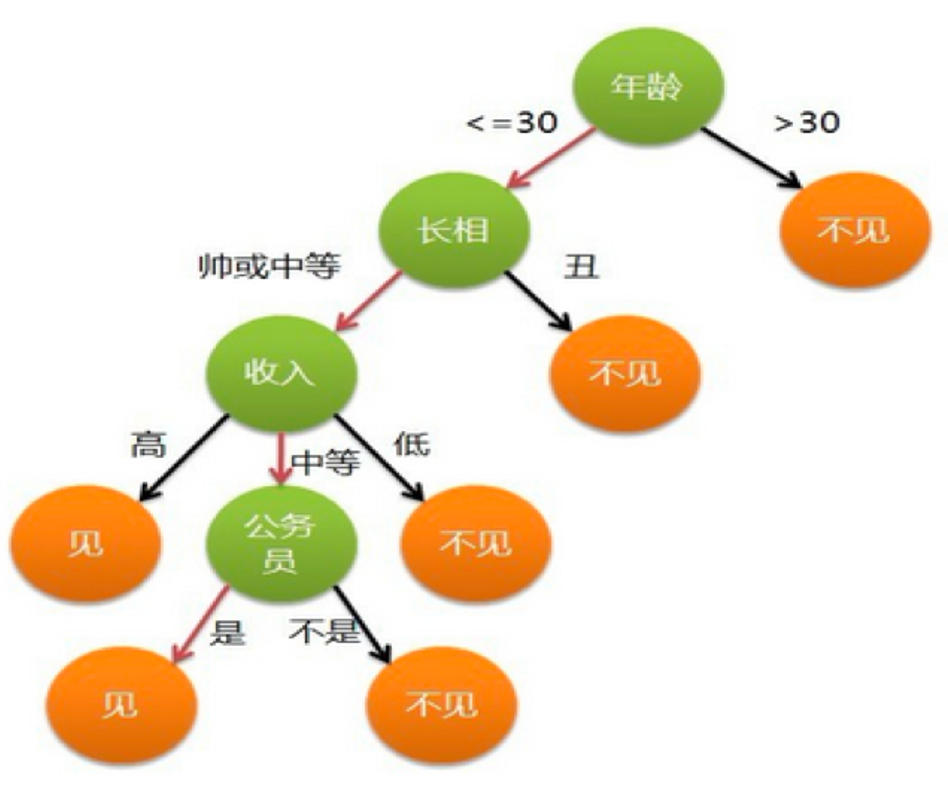
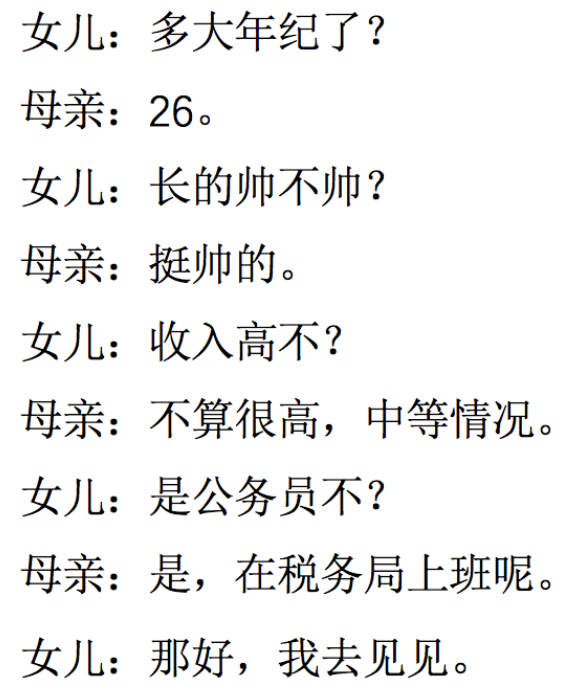
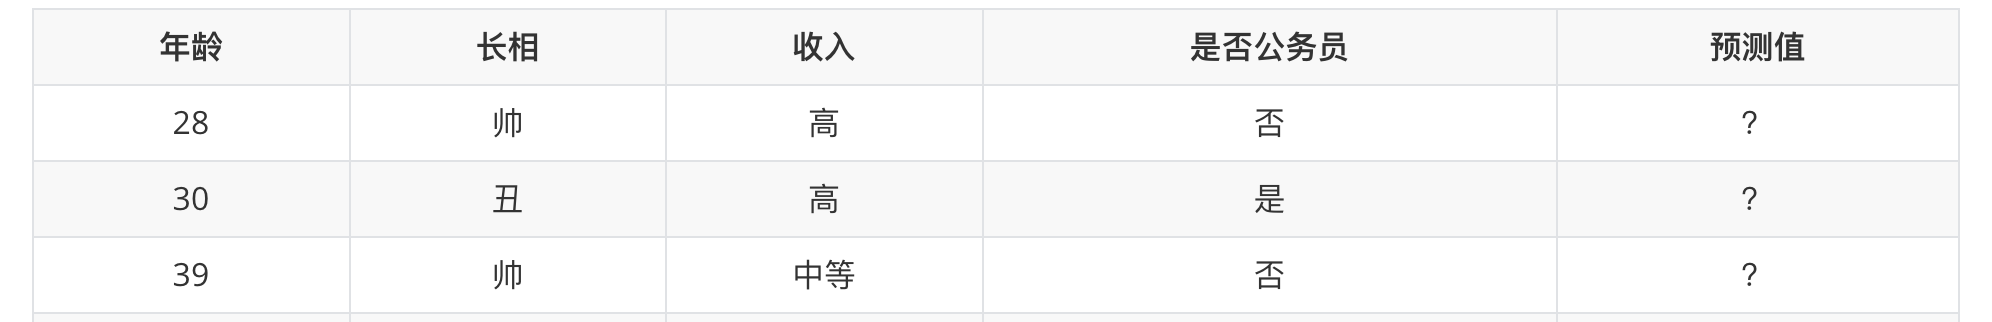
女孩相亲时按「年龄 > 长相 > 收入 > 是否公务员」排序自己的关注点(第 4~6 页);机器学习里则是「选择数据集中的哪些特征进行分裂,会更好呢?」(第 6 页)。两者的本质完全一样,排序的依据,就是这份材料的全部内容:
| 算法 | 排序依据 | 越大越优还是越小越优 |
|---|---|---|
| ID3 | 信息增益 | 越大越优 |
| C4.5 | 信息增益率 | 越大越优 |
| CART 分类树 | 基尼指数 | 越小越优 |
| CART 回归树 | 平方损失 | 越小越优 |
在新闻分类流水线里的位置。项目技术路线是 TF-IDF + 随机森林 → FastText → BERT → LLM 四级对比,随机森林是第一级基线模型。评审者问「你的随机森林是怎么工作的」,标准追问链是:
随机森林 → 它由很多棵决策树组成 → 这些树是怎么长出来的 → 用基尼指数选分裂特征 → 树长太深会过拟合怎么办 → 剪枝 /
max_depth限制
这条链上的每一环,这份课件都覆盖了。另外决策树天然输出特征重要性,在项目里可以直接解释「TF-IDF 的哪些词最能区分 10 个新闻类别」。
二、核心结论
- 决策树 = 递归地挑「最能区分样本」的特征做分裂。三代算法的差别只在用哪个指标衡量「区分能力」:ID3 用信息增益(越大越好)、C4.5 用信息增益率(越大越好)、CART 用基尼指数(越小越好)。
- 信息增益 = 熵 − 条件熵,即「用特征 A 划分后,不确定性减少的程度」。它的致命弱点是偏爱取值多的特征,极限情况下每个样本一个取值,增益直接拉满,但这是纯粹的过拟合。C4.5 用「除以特征自身的熵 IV(a)」来惩罚。
- 基尼系数不含 log,只有平方和,计算量比熵小,但实际划分效果通常和熵相当,这是 CART 成为工业默认选择的重要原因。
- 连续特征不是枚举每个取值,而是排序后取相邻值的中点作为候选切分点,逐个算指标选最优;CART 无论特征是什么类型,一定生成二叉树。
- 剪枝是决策树的正则化。预剪枝「边建边判」,快、省算力,但有欠拟合风险;后剪枝「先建完再自底向上剪」,慢,但泛化性能通常更好。sklearn 的
max_depth/min_samples_leaf是工程化的预剪枝,ccp_alpha对应代价复杂度后剪枝。
三、知识地图
课件共 7 章、66 页,各章开头的「学习目标」页给出了掌握权重,整理如下:
决策树(66 页,7 章)
├── 0. 决策树简介(第 1~6 页)
│   ├── 【理解】决策树算法的基本思想
│   │       树形结构:内部节点 = 一个特征上的判断;分支 = 判断结果的输出;叶子 = 一种分类结果
│   └── 【掌握】构建决策树的步骤
│           ① 特征选择(选分类能力强的特征)→ ② 决策树生成 → ③ 剪枝(缓解过拟合)
│
├── 1. ID3 决策树(第 7~20 页)
│   ├── 【理解】信息熵的意义
│   ├── 【理解】信息增益的作用
│   └── 【掌握】ID3 树的构建流程(4 步)
│
├── 2. C4.5 决策树(第 21~27 页)
│   ├── 【理解】信息增益率的意义(修正 ID3 的偏好多值特征问题)
│   └── 【掌握】C4.5 树的构建方法
│
├── 3. CART 决策树(第 28~39 页)
│   ├── 【理解】基尼指数的作用
│   ├── 【掌握】CART 特征选择方法(基尼指数最小化)
│   └── 【理解】分类决策树的特点(一定是二叉树、可处理连续值)
│
├── 4. 案例:泰坦尼克号乘客生存预测(第 40~45 页)
│   ├── 【掌握】分类决策树 API(DecisionTreeClassifier)
│   └── 【掌握】完整案例流程(读数据 → 缺失值 → one-hot → 划分 → 训练 → 评估 → 可视化)
│
├── 5. CART 回归树(第 46~55 页)
│   ├── 【了解】回归决策树的构建原理(平方损失最小化)
│   └── 【掌握】DecisionTreeRegressor 的使用
│
└── 6. 决策树剪枝(第 56~66 页)
    ├── 【理解】什么是剪枝、剪枝的作用(防止过拟合、提升泛化)
    ├── 【掌握】预剪枝与后剪枝的方法
    └── 【了解】两种剪枝方法的优缺点对比
课件在第 19/20/27/39/55/65 页设置了随堂测验;第 37 页给出了三种分类树的对比表(本报告第六节据此展开)。
四、原理详解
4.1 信息熵:怎么量化「乱」的程度
直觉。熵越大 → 数据的不确定性越高、越混乱、包含的信息越多;熵越小 → 数据越纯、越集中(第 9 页)。
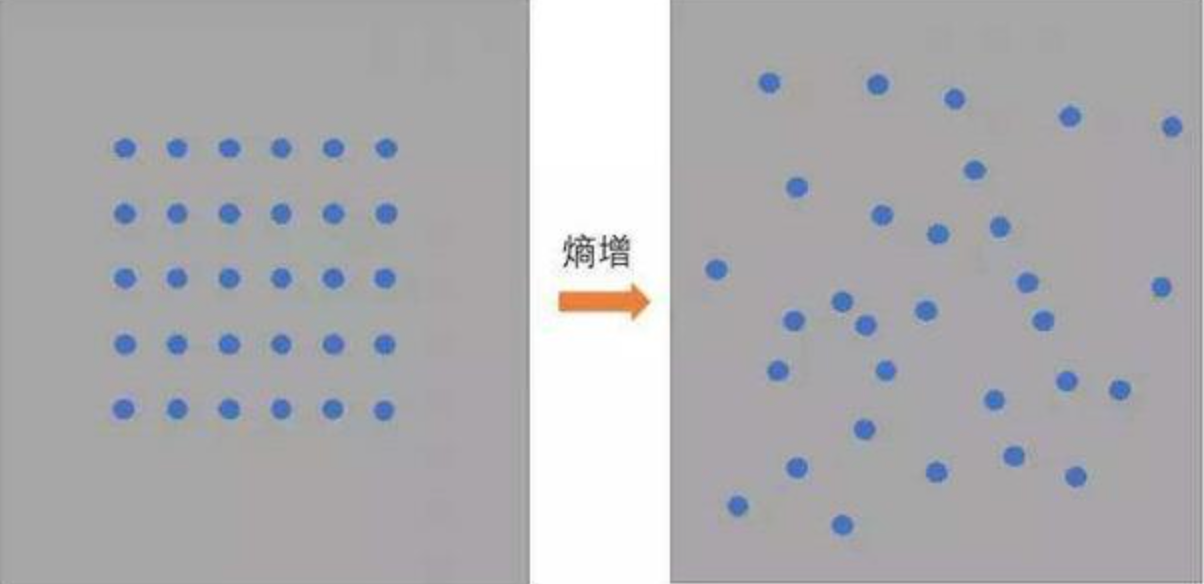
图注:左右两个面板都由蓝色小点构成。左 panel 的点按规则网格整齐排列(有序、可预测),右 panel 的点随机散落(混乱、不可预测),中间标有「熵增」箭头,直观说明「同一个数量的样本,排列越随机 → 熵越大」。
公式。信息论中代表随机变量不确定度的度量:
H(x) = -\sum_{i=0}^{n} P(x_i)\log_2 P(x_i)
其中 P(x_i) 表示数据中第 i 个类别出现的概率。

图注:课件的熵公式原图,求和号下标为 i=0,上标为 n,对数底数为 2,整体带负号,即「各取值的概率 × 概率的 log₂ 再求和、最后取负」。
手算例 1:课件第 10 页的原例
数据 α = ABCDEFGH(8 个样本,8 种类别,每类概率 1/8):
H(\alpha) = -8 \times \left(\frac{1}{8}\log_2\frac{1}{8}\right) = -8 \times \frac{1}{8} \times (-3) = 3\ \text{bit}
数据 β = AAAABBCD(8 个样本,A 出现 4 次、B 出现 2 次、C 与 D 各 1 次):
H(\beta) = -\frac{1}{2}\log_2\frac{1}{2} – \frac{1}{4}\log_2\frac{1}{4} – \frac{1}{8}\log_2\frac{1}{8} – \frac{1}{8}\log_2\frac{1}{8} = 0.5 + 0.5 + 0.75 + 0.75 = 1.75\ \text{bit}
同样 8 个样本,α 有 8 种可能 → 熵 3;β 只有 4 种可能且高度集中在 A → 熵 1.75。类别越集中,熵越小。这就是「纯度高 = 熵小」的量化含义。
手算例 2:三种类别分布的熵对比(课件第 11 页)
| 类别分布 | 熵公式展开(log₂,单位 bit) | 熵值 |
|---|---|---|
| {1/3, 1/3, 1/3} | -\frac13\log_2\frac13\times3 | 1.585 |
| {0.1, 0.2, 0.7} | -0.1\log_2 0.1-0.2\log_2 0.2-0.7\log_2 0.7 | 1.157 |
| {1, 0, 0} | -1\log_2 1 | 0 |
三行说明了熵的三条性质:均匀分布熵最大;越偏斜熵越小;完全纯净熵为 0。
课件第 11 页给出的数字是 1.0986 与 0.8018,这是用自然对数 ln 算的(\ln 3 = 1.0986)。对数底数只改变熵的数值尺度,不改变排序,但在同一棵树的迭代过程中必须自始至终用同一个底数。课件第 13 页明确写了
math.log(x, 2),ID3 的标准写法也是 log₂,建议统一按 log₂ 记忆。
4.2 信息增益与 ID3:熵减多少,就用哪个特征
直觉。特征 A 的信息增益 = 「划分之前的不确定性」减去「用 A 划分之后的不确定性」。减少得越多,说明 A 越会分。
公式(第 12 页)。
g(D, A) = H(D) – H(D\mid A)
H(D\mid A) = \sum_{v=1}^{n}\frac{|D^v|}{|D|}H(D^v)
其中 D^v 是特征 A 取第 v 个值时对应的样本子集,\frac{|D^v|}{|D|} 是该子集的权重。上式即条件熵。
手算例 1:课件第 13 页的极简例子(6 个样本)
| 特征 a | 目标值 |
|---|---|
| α | A |
| α | A |
| β | B |
| α | A |
| β | B |
| α | B |
第 1 步:算整个数据集 D 的熵。目标是 3 个 A、3 个 B:
H(D) = -\frac36\log_2\frac36-\frac36\log_2\frac36 = 0.5+0.5 = 1.0
第 2 步:按特征 a 划分子集。
– α 分支:4 个样本(编号 1,2,4,6),目标值 AAAB → 3 个 A、1 个 B
H(D^{\alpha}) = -\frac34\log_2\frac34-\frac14\log_2\frac14 = 0.3113+0.5 = 0.8113
- β 分支:2 个样本(编号 3,5),目标值
BB→ 全 B,完全纯
H(D^{\beta}) = -\frac22\log_2\frac22 = 0
第 3 步:算条件熵(加权平均)。
H(D\mid a) = \frac46 \times 0.8113 + \frac26 \times 0 = 0.5408
第 4 步:算信息增益。
g(D, a) = 1.0 – 0.5408 = 0.459 \approx 0.46
手算例 2:课件第 15~17 页的论坛客户流失率案例(15 条样本)
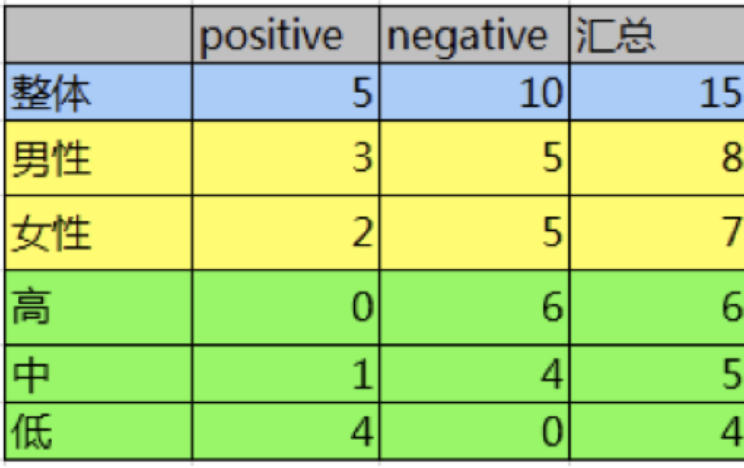
课件给出的原始数据(uin 为编号,act_info 为活跃度,is_lost 为是否流失,1 = 流失):
| uin | 性别 | 活跃度 | is_lost |
|---|---|---|---|
| 1 | 男 | 高 | 0 |
| 2 | 女 | 中 | 0 |
| 3 | 男 | 低 | 1 |
| 4 | 女 | 高 | 0 |
| 5 | 男 | 高 | 0 |
| 6 | 男 | 中 | 0 |
| 7 | 男 | 中 | 1 |
| 8 | 女 | 中 | 0 |
| 9 | 女 | 低 | 1 |
| 10 | 女 | 中 | 0 |
| 11 | 女 | 高 | 0 |
| 12 | 男 | 低 | 1 |
| 13 | 女 | 低 | 1 |
| 14 | 男 | 高 | 0 |
| 15 | 男 | 高 | 0 |
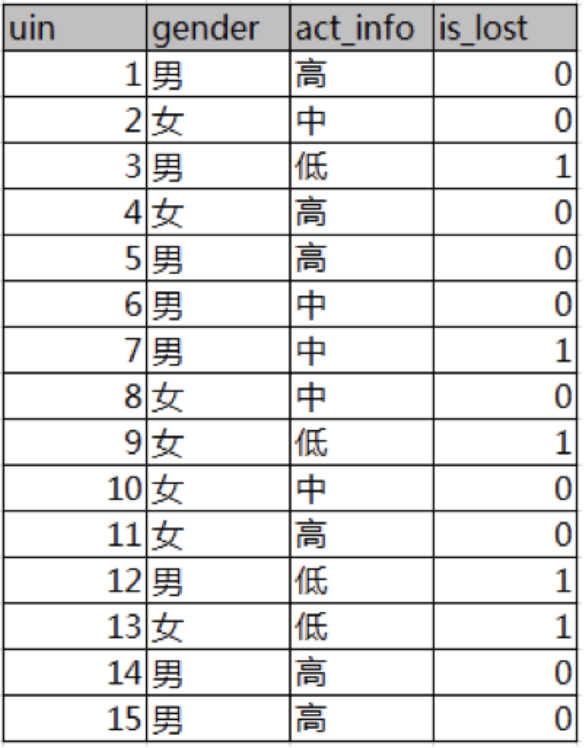
图注:课件中的原始数据表,列依次为 uin(用户编号 1~15)、gender(性别 1=男 / 2=女)、act_info(活跃度:低 / 中 / 高)、is_lost(是否流失 0/1)。共计 15 条样本,其中 5 条流失(1)、10 条未流失(0)。
第 1 步:算总熵。5 个正样本、10 个负样本:
H(D) = -\frac{5}{15}\log_2\frac{5}{15}-\frac{10}{15}\log_2\frac{10}{15} = 0.5283+0.3900 = 0.9183
课件第 16 页此处印的是 0.9812,与它自己后面算出的 0.0064 对不上(应为 0.9183 的数字颠倒笔误)。反推验证:若 H(D)=0.9812,则性别增益 = 0.9812 − 0.9118 = 0.0694,与页面上的 0.0064 矛盾。按 log₂ 重算恰好得到课件的 0.0064 与 0.6776,可以确认 0.9812 是笔误。被追问时按 0.9183 讲。
第 2 步:算「性别」的条件熵。
– 男:8 个样本(1,3,5,6,7,12,14,15),3 个流失、5 个未流失
H(D^{男}) = -\frac38\log_2\frac38-\frac58\log_2\frac58 = 0.5306+0.4238 = 0.9544
- 女:7 个样本(2,4,8,9,10,11,13),2 个流失、5 个未流失
H(D^{女}) = -\frac27\log_2\frac27-\frac57\log_2\frac57 = 0.5164+0.3467 = 0.8631
H(D\mid \text{性别}) = \frac{8}{15}\times0.9544 + \frac{7}{15}\times0.8631 = 0.5090+0.4028 = 0.9118
第 3 步:性别信息增益。
g(D, \text{性别}) = 0.9183 – 0.9118 = 0.0065 \approx 0.0064
第 4 步:算「活跃度」的条件熵。
– 高:6 个样本(1,4,5,11,14,15),0 个流失 → H = 0(完全纯)
– 中:5 个样本(2,6,7,8,10),1 个流失、4 个未流失 → H = -0.2\log_2 0.2-0.8\log_2 0.8 = 0.7219
– 低:4 个样本(3,9,12,13),4 个全流失 → H = 0(完全纯)
H(D\mid \text{活跃度}) = \frac{6}{15}\times0+\frac{5}{15}\times0.7219+\frac{4}{15}\times0 = 0.2406
g(D, \text{活跃度}) = 0.9183 – 0.2406 = 0.6777 \approx 0.6776
结论(课件第 17 页原文):活跃度的信息增益(0.6776)远大于性别的信息增益(0.0064),说明活跃度对用户流失的影响比性别大得多,性别几乎分不动,活跃度是两个极端(高活跃零流失、低活跃全流失)。
ID3 树构建流程(第 14 页,4 步循环)
- 计算每个特征的信息增益;
- 使用信息增益最大的特征将数据集拆分为子集;
- 使用该特征作为决策树的一个节点;
- 使用剩余特征对子集重复上述过程(递归),直到子集纯净或无特征可用。
# ID3 的递归骨架(对数用 log2)
def id3(D, features):
    if len(set(D.labels)) == 1 or not features:      # 纯了 / 没特征了 -> 叶节点
        return Leaf(majority_class(D.labels))
    best = max(features, key=lambda a: info_gain(D, a))   # 选增益最大的特征
    node = Node(feature=best)
    for v, Dv in split(D, best):
        node.children[v] = id3(Dv, features - {best})    # 用剩余特征递归
    return node
4.3 信息增益率与 C4.5:给「取值多」加一道惩罚
ID3 的不足(第 23 页):偏向于选择取值种类多的特征作为分裂依据。
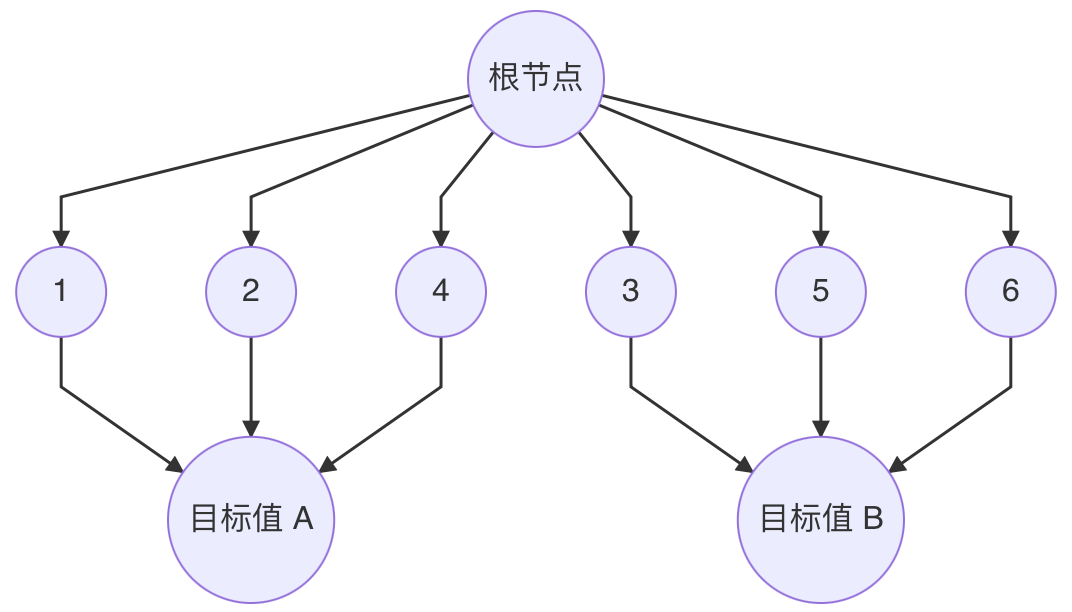
课件的构造例子:同一个 6 样本数据集里,「特征 a」只有 2 个取值(α / β),而「特征 b」有 6 个取值(1~6,每个样本一个)。
- 用 b 做分裂特征:6 个取值各自成一个子集,每个子集只有 1 个样本 → 每个子集的熵都是 0 → 条件熵为 0 → 信息增益 = 1.0(满分);
- 但这棵树过于依赖这一个特征(只根据少数特征进行学习),对新样本毫无泛化能力 → 严重过拟合。
信息增益率 = 信息增益 ÷ 特征熵,本质是给信息增益乘一个惩罚系数:
\text{Gain\_Ratio}(D, a) = \frac{\text{Gain}(D,a)}{IV(a)},\qquad IV(a) = -\sum_{v=1}^{n}\frac{|D^v|}{|D|}\log_2\frac{|D^v|}{|D|}
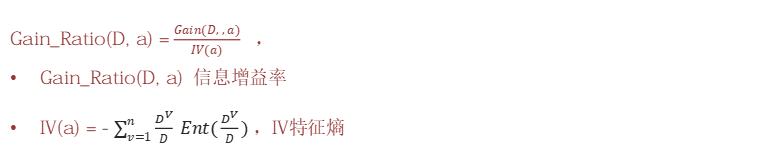
图注:课件给出的信息增益率定义图。左侧是 Gain_Ratio(D, a) = Gain(D,a) / IV(a),右侧下方是 IV(a) = -Σ (D^v/D) log₂(D^v/D),求和号上下标为 v=1 到 n。分母 IV(a) 只由特征自身的取值分布决定,完全不看标签,所以它是一个纯粹的「特征复杂度」度量。
惩罚逻辑(第 24 页原文):特征取值个数越多 → IV(a) 越大 → 惩罚系数越小(分母越大,商越小);取值个数越少 → 惩罚系数越大。
手算例:沿用上面那个 6 样本数据集
数据集(与 4.2 手算例 1 相同,只是多了一列有 6 个取值的特征 b):
| 特征 b | 特征 a | 目标值 |
|---|---|---|
| 1 | α | A |
| 2 | α | A |
| 3 | β | B |
| 4 | α | A |
| 5 | β | B |
| 6 | α | B |
(1)特征 a 的信息增益率
- 信息增益(已在 4.2 算出):g(D,a) = 1 – 0.5408 = 0.459 \approx 0.46
- 特征 a 的固有值:a 取 α 共 4 次、取 β 共 2 次
IV(a) = -\frac46\log_2\frac46-\frac26\log_2\frac26 = 0.3900+0.5283 = 0.9183 \approx 0.92
- 信息增益率:\text{Gain\_Ratio}(D,a) = 0.459 / 0.9183 = \mathbf{0.5}
(2)特征 b 的信息增益率
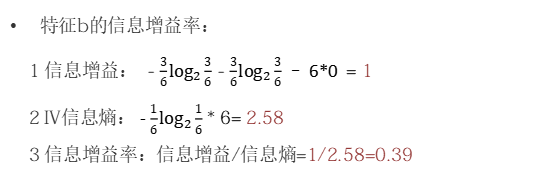
- 信息增益:6 个子集各含 1 个样本,每个子集熵为 0 → H(D\mid b)=0,故 g(D,b) = 1 – 0 = 1
- 特征 b 的固有值:6 个取值各占 1/6
IV(b) = -6\times\frac16\log_2\frac16 = \log_2 6 = 2.585 \approx 2.58
- 信息增益率:\text{Gain\_Ratio}(D,b) = 1 / 2.585 = \mathbf{0.387 \approx 0.39}
结论(第 25 页原文):特征 a 的信息增益率(0.5)大于特征 b(0.39),按信息增益率应该选特征 a 分裂,ID3 会错误地选 b,C4.5 纠正了这个错误。
C4.5 相比 ID3 的三点增强(第 37 页):
1. 缓解了 ID3 总喜欢偏向选择取值较多属性的问题;
2. 可处理连续数值型属性,也增加了对缺失值的处理方法;
3. 只适合于能够驻留于内存的数据集,大数据集无能为力。
最后一条是 C4.5 的局限而非优点,它需要把整个数据集读进内存反复排序,无法处理超出内存的数据。
4.4 基尼指数与 CART 分类树
CART = Classification and Regression Tree,一棵树同时支持分类与回归:分类用基尼指数最小化,回归用平方误差最小化(第 30 页)。
直觉(第 31 页):基尼值 Gini(D) = 从数据集 D 中随机抽取两个样本,其类别标记不一致的概率。所以 Gini(D) 越小,数据集 D 的纯度越高。
Gini(D) = \sum_{k=1}^{|y|}\sum_{k’\neq k}p_k p_{k’} = 1-\sum_{k=1}^{|y|}p_k^2
Gini\_index(D, a) = \sum_{v=1}^{V}\frac{|D^v|}{|D|}Gini(D^v)
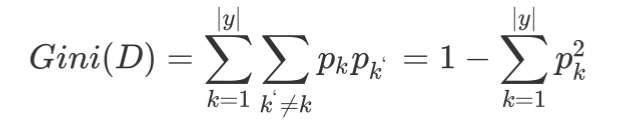
图注:课件给出的基尼值定义图,写成最原始的「不一致概率」形式:\text{Gini}(D)=\sum_{k=1}^{|y|}\sum_{k’\neq k}p_k p_{k’},即对类别 k 与任意另一个类别 k’(k’\neq k)的「抽中 k 又抽中 k’」概率求和。
Gini_index(D,a) 的形式与条件熵完全同构,只是把「子集熵 H」换成了「子集基尼值」,选择使划分后基尼指数最小的属性作为最优化分属性。
方向要记牢:信息增益 / 信息增益率越大越好,基尼指数越小越好。
手算例:课件第 32~36 页的「是否拖欠贷款」数据集(10 条样本)
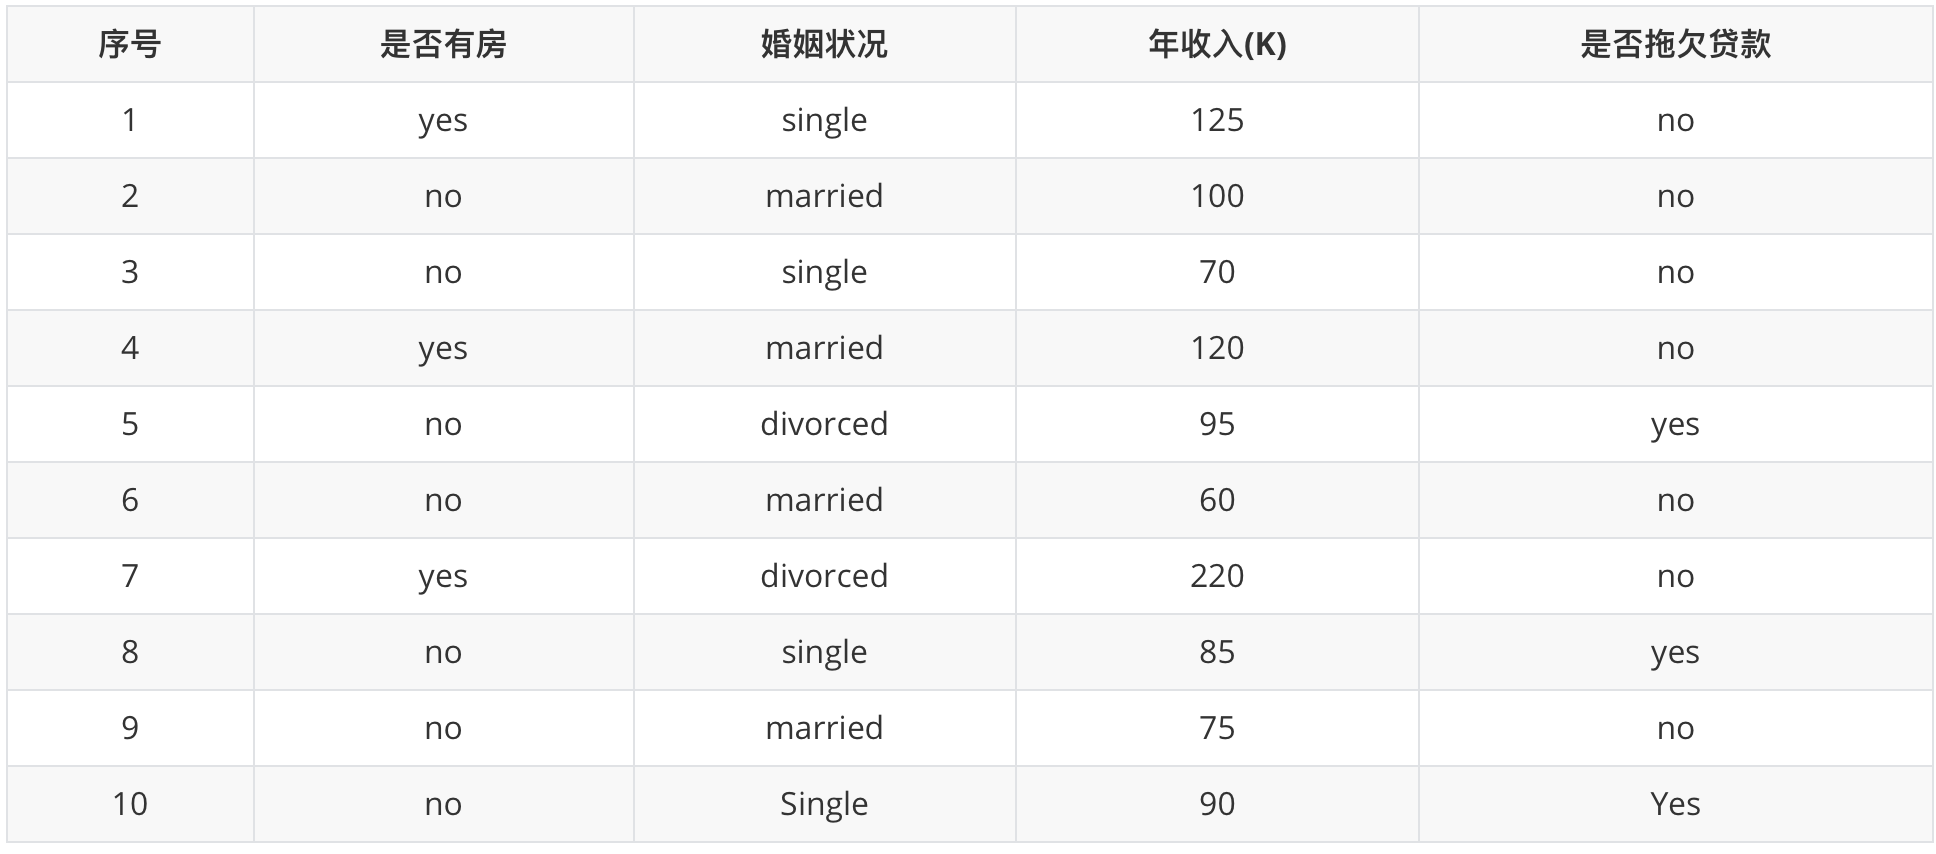
图注:课件的数据集原图,列为 序号 | 是否有房 | 婚姻状况 | 年收入 | 是否拖欠贷款,共 10 行;其中 3 行 是否有房 = yes(序号 1、4、7),年收入 为连续数值(60 ~ 220),目标 是否拖欠贷款 共 7 个 no、3 个 yes。
| 序号 | 是否有房 | 婚姻状况 | 年收入(K) | 是否拖欠贷款 |
|---|---|---|---|---|
| 1 | yes | single | 125 | no |
| 2 | no | married | 100 | no |
| 3 | no | single | 70 | no |
| 4 | yes | married | 120 | no |
| 5 | no | divorced | 95 | yes |
| 6 | no | married | 60 | no |
| 7 | yes | divorced | 220 | no |
| 8 | no | single | 85 | yes |
| 9 | no | married | 75 | no |
| 10 | no | single | 90 | yes |
(A)特征「是否有房」,取值只有 yes / no,天然是二叉划分。
有房 = yes:序号 {1, 4, 7},3 个样本全部为 no
Gini(有房) = 1-\left(\frac03\right)^2-\left(\frac33\right)^2 = 1-0-1 = 0
有房 = no:序号 {2,3,5,6,8,9,10},7 个样本中 4 个 no、3 个 yes
Gini(无房) = 1-\left(\frac47\right)^2-\left(\frac37\right)^2 = 1-0.3265-0.1837 = 0.4898
- 加权合成(3/10 与 7/10 是两部分的样本占比):
Gini\_index(D, 是否有房) = \frac{3}{10}\times0 + \frac{7}{10}\times0.4898 = \mathbf{0.343}
(B)特征「婚姻状况」,有 3 个取值,CART 要枚举它的三种二分方式:
| 划分方式 | 左子集(样本 / 目标) | 左 Gini | 右子集(样本 / 目标) | 右 Gini | 基尼指数 |
|---|---|---|---|---|---|
| {married} | {single, divorced} | {2,4,6,9} → 4 no | 0 | {1,3,5,7,8,10} → 3 no / 3 yes | 0.5 | \frac{4}{10}(0)+\frac{6}{10}(0.5)=\mathbf{0.300} |
| {single} | {married, divorced} | {1,3,8,10} → 2 no / 2 yes | 0.5 | {2,4,5,6,7,9} → 5 no / 1 yes | 0.2778 | 0.367 |
| {divorced} | {single, married} | {5,7} → 1 no / 1 yes | 0.5 | {1,2,3,4,6,8,9,10} → 6 no / 2 yes | 0.375 | 0.400 |
以 {married} 为例的逐步计算:
Gini(\text{married}) = 1-\left(\frac04\right)^2-\left(\frac44\right)^2 = 0
Gini(\text{非 married}) = 1-\left(\frac36\right)^2-\left(\frac36\right)^2 = 1-0.25-0.25 = 0.5
Gini\_index = \frac{4}{10}\times 0 + \frac{6}{10}\times 0.5 = 0.3
该特征的最终基尼指数为 0.3,预选分裂点为 {married} 和 {single, divorced}(第 34 页结论)。
(C)特征「年收入」,连续值,见下一小节 4.5。
第 1 轮汇总(第 36 页):
| 候选划分 | 基尼指数 |
|---|---|
| 是否有房 | 0.343 |
| 婚姻状况(分裂点 married) | 0.300 |
| 年收入(分裂点 97.5) | 0.300 |
第 2 轮:样本 {2,4,6,9} 的类别全是 no(纯度已达最大),该节点停止分裂;右子树数据集变为 {1,3,5,7,8,10},在该子集上重新计算各特征的基尼指数,继续选最小者分裂,重复直到建完整棵树。
4.5 连续值处理与 CART 的完整构建过程
连续特征的标准做法(C4.5 与 CART 通用):
- 将该特征的所有取值升序排序;
- 取相邻两个值的中点作为候选切分点(共 n-1 个);
- 逐个候选点计算划分指标(CART 用基尼指数,C4.5 用信息增益率);
- 选指标最优的那个点。
课件第 34 页的例子:年收入排序后为 60 / 70 / 75 / 85 / 90 / 95 / 100 / 120 / 125 / 220,相邻中点即 9 个待定分裂点。
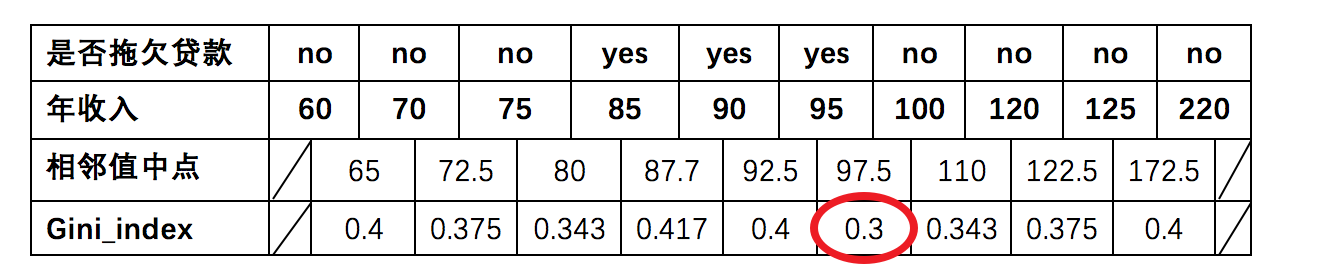
图注:课件的候选分裂点表。表格两行分别是「是否拖欠贷款」(no no no yes yes yes no no no no)与排序后的「年收入」(60 70 75 85 90 95 100 120 125 220);中间行列出 9 个相邻中点 65 / 72.5 / 80 / 87.5 / 92.5 / 97.5 / 110 / 122.5 / 172.5;再往下是对应算出的 Gini_index 序列 0.4 / 0.375 / 0.343 / 0.417 / 0.4 / 0.3 / 0.343 / 0.375 / 0.4,其中 97.5 对应的 0.3 被圈出,即该特征的最优切分点。
以 s = 97.5 为例的手算:
- 左子集 = {60, 70, 75, 85, 90, 95},目标
no no no yes yes yes→ 3 no / 3 yes
Gini_L = 1-\left(\frac36\right)^2-\left(\frac36\right)^2 = 0.5
- 右子集 = {100, 120, 125, 220},目标
no no no no→ 全 no
Gini_R = 1-\left(\frac44\right)^2 – 0 = 0
Gini\_index = \frac{6}{10}\times0.5+\frac{4}{10}\times0 = \mathbf{0.3}
第 1 轮 CART 树(第 36 页)
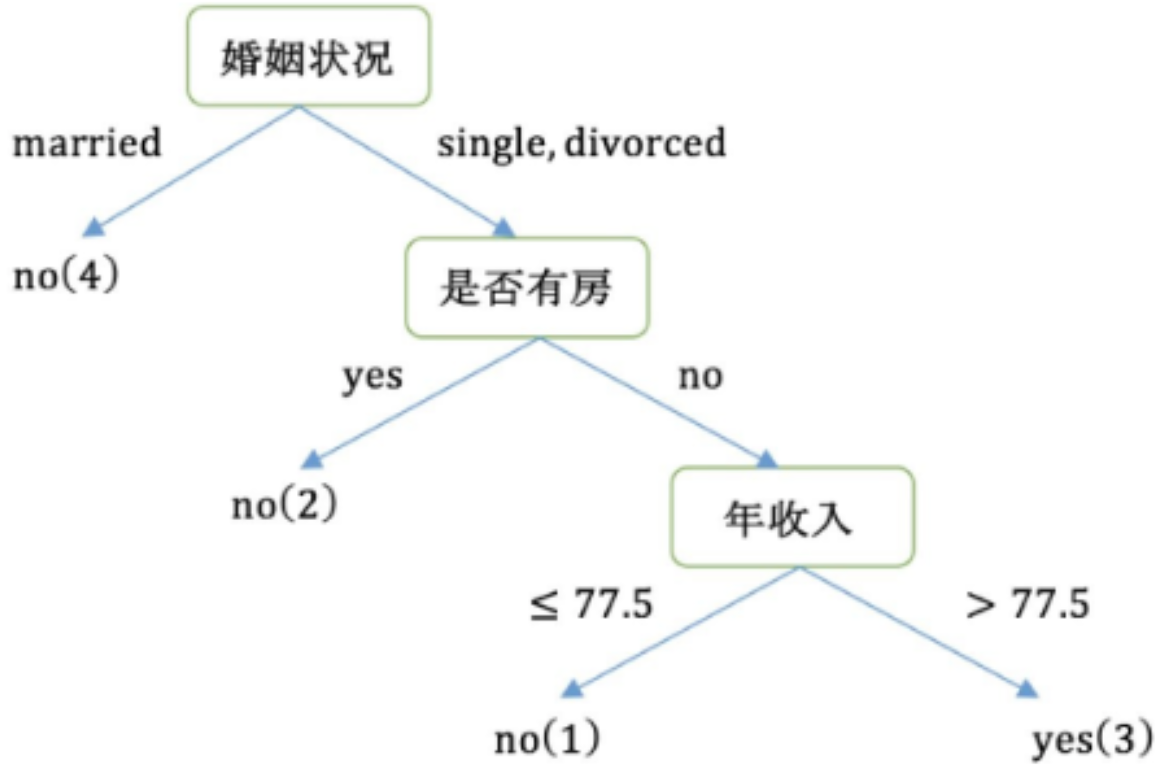
图注:课件画出的第 1 轮分裂结果。根节点按 婚姻状况 分裂:married 分支的 4 个样本全部为 no,直接作为叶节点 no(4);single, divorced 分支继续按 是否有房 分裂,有房 = yes 的 2 个样本全为 no,得到叶节点 no(2);有房 = no 的 4 个样本再按 年收入 分裂(图中标注切分为 ≤77.5 与 >77.5),左叶标注 no(1)、右叶标注 yes(3)。
由此可以提炼出 CART 分类树的三个固有特点:
- 一定是二叉树,即使特征有 3 个以上取值(如婚姻状况),CART 也只会做「属于某集合 / 不属于该集合」的二分;
- 连续值与离散值通吃,连续值靠相邻中点切分,离散值靠枚举二分方式;
- 计算量比熵小,基尼指数只用平方和,不需要算 log。
4.6 CART 回归树:叶子输出的是均值,不是类别
与分类树的四点区别(第 48 页)
| 维度 | CART 分类树 | CART 回归树 |
|---|---|---|
| 预测输出 | 离散值(类别) | 连续值 |
| 划分依据 | 基尼指数最小化 | 平方损失最小化 |
| 叶子输出 | 叶子节点里的多数类别 | 叶子节点里所有样本的均值 |
| 典型 API | DecisionTreeClassifier |
DecisionTreeRegressor |
损失函数(第 48 页)
\text{Loss}(y, f(x)) = (f(x) – y)^2
构建时的目标是最小化两个子区域内的平方误差之和,即对特征 j 与切分点 s 求解:
\min_{j,s}\left[\min_{c_1}\sum_{x_i\in R_1(j,s)}(y_i-c_1)^2+\min_{c_2}\sum_{x_i\in R_2(j,s)}(y_i-c_2)^2\right]
其中 c_1, c_2 是左右区域内 y 的均值(对平方损失求导即得,均值就是最优常数输出)。
手算例:课件第 48~51 页的回归树完整推导
数据只有 1 个特征 x,目标值 y:
| x | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| y | 5.56 | 5.70 | 5.91 | 6.40 | 6.80 | 7.05 | 8.90 | 8.70 | 9.00 | 9.05 |
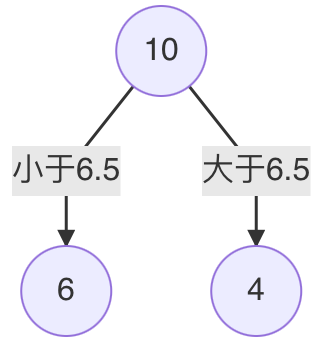
第 1 步:对 x 排序(已是升序),取相邻均值作候选划分点:1.5, 2.5, 3.5, 4.5, 5.5, 6.5, 7.5, 8.5, 9.5(共 9 个)。
第 2 步:逐个算平方损失 m(s)。以 s = 1.5 为例:
- 左子树只有 x=1,c_1 = 5.56
- 右子树 x=2~10,c_2 = (5.70+5.91+6.40+6.80+7.05+8.90+8.70+9.00+9.05)/9 = 7.5011
- m(1.5) = (5.56-5.56)^2 + \sum_{i=2}^{10}(y_i-7.5011)^2 = \mathbf{15.7231}
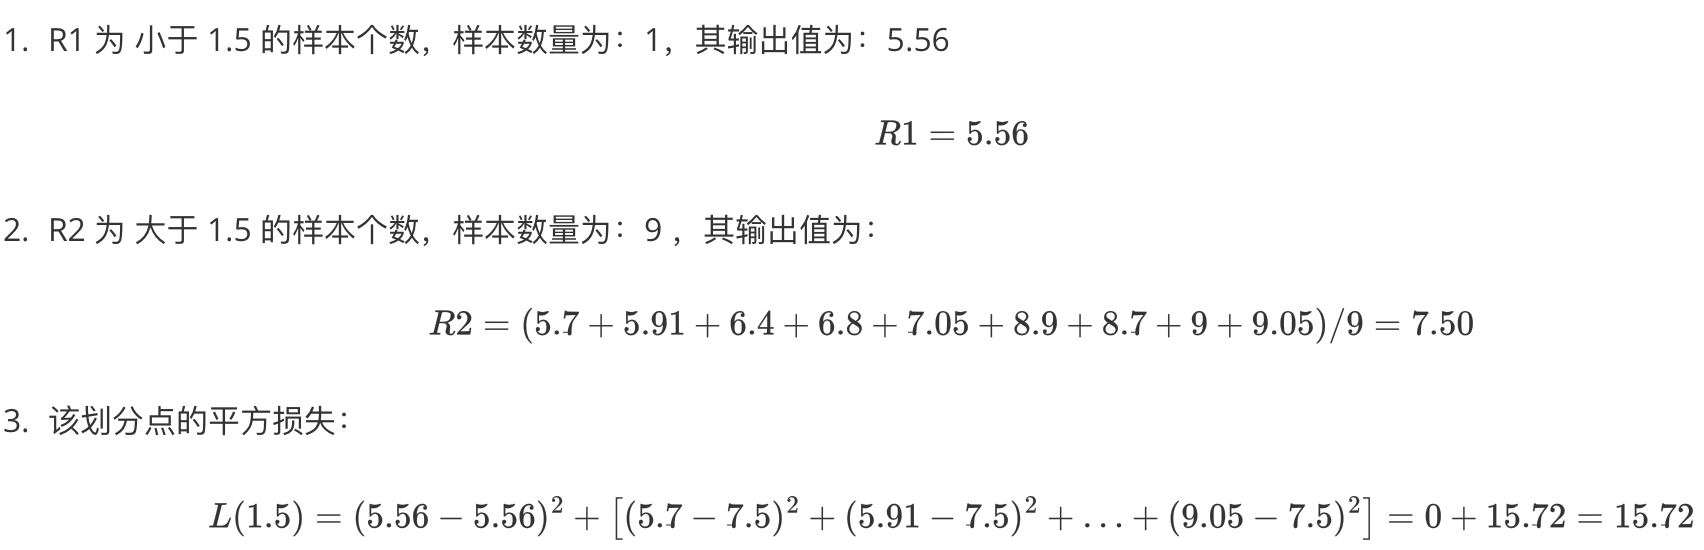
图注:课件画出的「按照 1.5 划分」示意图。横轴上 10 个样本点分成左右两段,左段只有 x=1 一个点,标注预测值 5.56;右段为 x=2~10 的 9 个点,标注预测值 7.50;图旁文字给出目标值并注明左子树 / 右子树与各自的均值输出,直观体现「回归树用区域均值当预测值」。
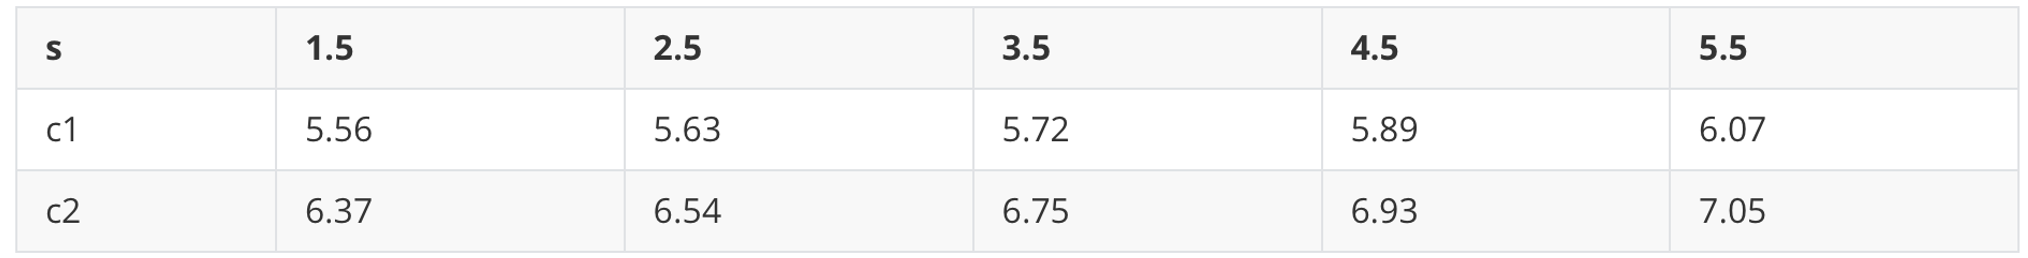
第 3 步:所有候选点的 m(s) 如下(第 50 页的表格):
| 划分点 s | 1.5 | 2.5 | 3.5 | 4.5 | 5.5 | 6.5 | 7.5 | 8.5 | 9.5 |
|---|---|---|---|---|---|---|---|---|---|
| c_1(左均值) | 5.56 | 5.63 | 5.72 | 5.89 | 6.07 | 6.24 | 6.62 | 6.88 | 7.11 |
| c_2(右均值) | 7.50 | 7.73 | 7.99 | 8.25 | 8.54 | 8.91 | 8.92 | 9.03 | 9.05 |
| m(s) | 15.72 | 12.08 | 8.37 | 5.78 | 3.91 | 1.93 | 8.01 | 11.74 | 15.74 |
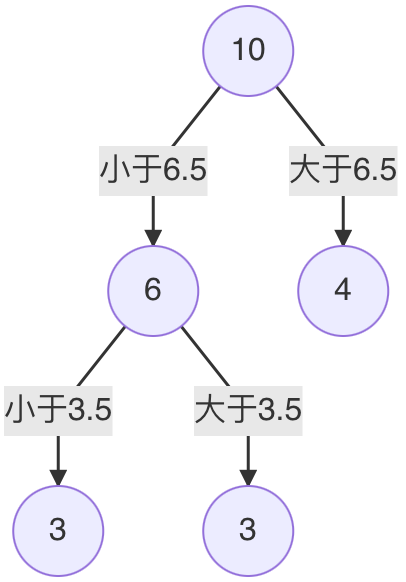
s = 6.5 时 m(s) = 1.93 最小 → 第 1 个划分变量确定:特征 X,切分点 6.5。
第 4 步:对左子树的 6 个节点(x = 1~6)重复上述过程:
| 划分点 s | 1.5 | 2.5 | 3.5 | 4.5 | 5.5 |
|---|---|---|---|---|---|
| m(s) | 1.3087 | 0.7540 | 0.2771 | 0.4367 | 1.0643 |
s = 3.5 时 m(s) = 0.2771 最小 → 左子树继续以 3.5 分裂。
第 5 步:假设生成 3 个区域后停止划分,到此就是最终的回归树,每一个叶子节点的输出 = 挂在该节点上的所有样本均值。
回归树构建过程小结(第 51 页,6 步):
- 选一个特征,把该特征的值排序,取相邻点均值作为待划分点;
- 对每个划分点,把数据集分成 R1、R2 两部分;
- 把 R1、R2 两部分的平方损失相加作为该切分点的平方损失;
- 取最小平方损失的划分点作为当前特征的划分点;
- 用同样方式计算其他特征的最优划分点及损失值;
- 在所有特征的划分点中,选出最小平方损失的那个,作为当前树的分裂点。
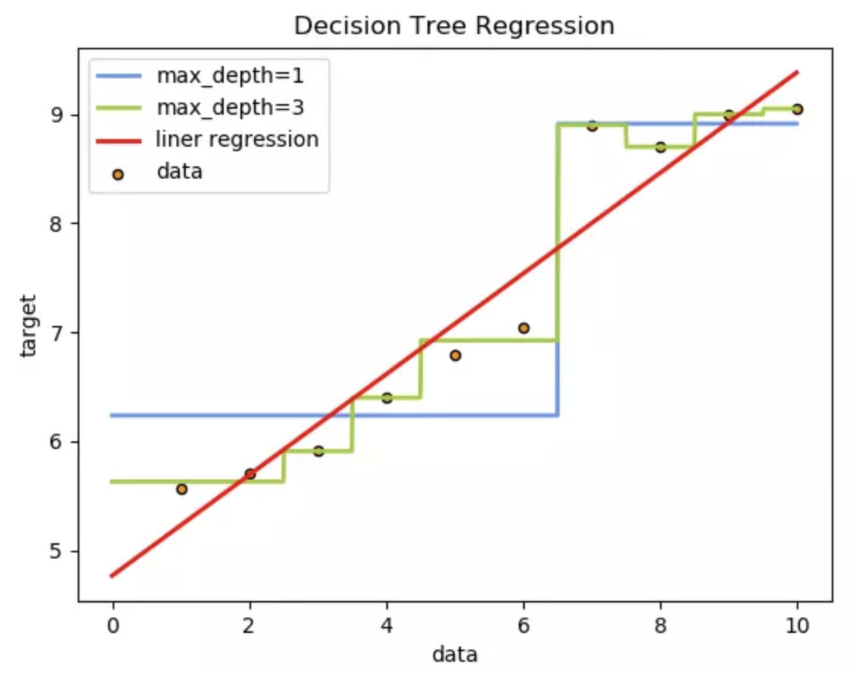
回归树 vs 线性回归(第 52~54 页)
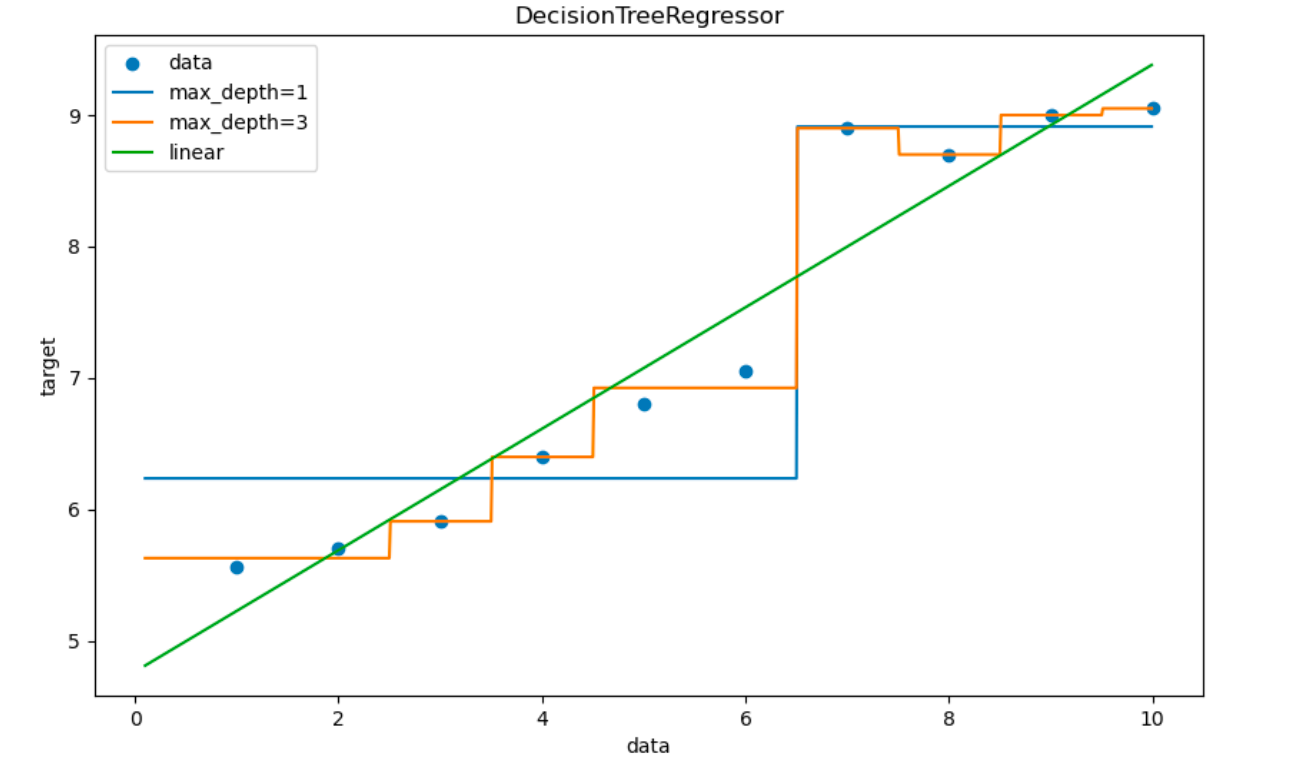
图注:DecisionTreeRegressor 的对比图,标题为 DecisionTreeRegressor,横轴 data、纵轴 target,图例含四条:蓝色散点 data、max_depth=1、max_depth=3、linear。max_depth=1 是一条只有一个台阶的分段常数线(x < 6.5 时约为 6.24,x > 6.5 时跳升到约 8.91);max_depth=3 是多级阶梯(x≈2、2.5、4、4.5、6.5 处逐级跳升,x≈8 处略有回落);linear 是一条平滑的绿色直线。三条线说明:线性回归只能给直线,回归树给的是阶梯曲线,深度越大阶梯越细、拟合能力越强、也越容易过拟合。
课件给出的三点结论:① 线性回归是一条直线;② 决策树是曲线;③ 树的拟合能力很强,易过拟合。
import numpy as np
from sklearn.tree import DecisionTreeRegressor     # 回归决策树
from sklearn.linear_model import LinearRegression

x = np.array(list(range(1, 11))).reshape(-1, 1)
y = np.array([5.56, 5.70, 5.91, 6.40, 6.80, 7.05, 8.90, 8.70, 9.00, 9.05])

model1 = DecisionTreeRegressor(max_depth=1)   # 深度 1:只有一个切分点
model2 = DecisionTreeRegressor(max_depth=3)   # 深度 3:阶梯更细
model3 = LinearRegression()
for m in (model1, model2, model3):
    m.fit(x, y)

x_test = np.arange(0.0, 10.0, 0.01).reshape(-1, 1)
y_pre1, y_pre2, y_pre3 = model1.predict(x_test), model2.predict(x_test), model3.predict(x_test)
4.7 剪枝:决策树的正则化
为什么要剪枝(第 58 页):决策树易过拟合,剪枝是一种防止决策树过拟合的正则化方法,目的是提高泛化能力。做法是把子树的节点全部删掉,用叶子节点来替换。
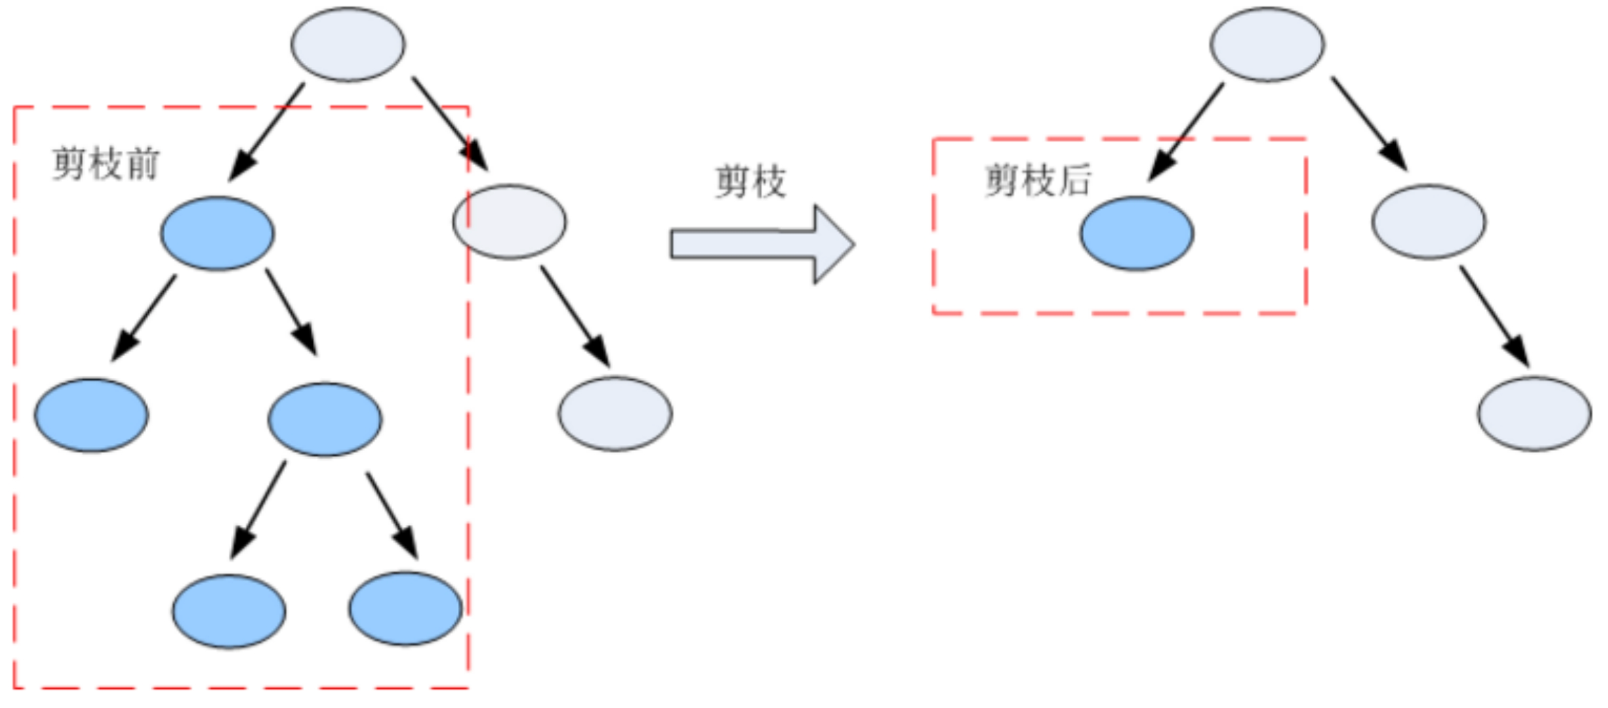
图注:课件的剪枝示意图,分左右两幅。左幅「剪枝前」用红色虚线框圈出一整个子树(一个内部节点 + 其下的分支节点与 4 个叶子),右幅「剪枝后」该子树被替换成一个单独的蓝色叶子节点,两幅之间用箭头标注「剪枝」。图直观对应第 58 页的定义,剪枝 = 用叶子节点替换整棵子树。
两种剪枝的定义(第 58 页原文)
- 预剪枝:在决策树生成过程中,对每个节点在划分前先进行估计,若当前节点的划分不能带来决策树泛化性能提升,则停止划分并将当前节点标记为叶节点。
- 后剪枝:先从训练集生成一棵完整的决策树,然后自底向上地对非叶节点进行考察,若将该节点对应的子树替换为叶节点能带来决策树泛化性能提升,则将该子树替换为叶节点。
逐数字走一遍:西瓜数据集 3.0α 的预剪枝与后剪枝
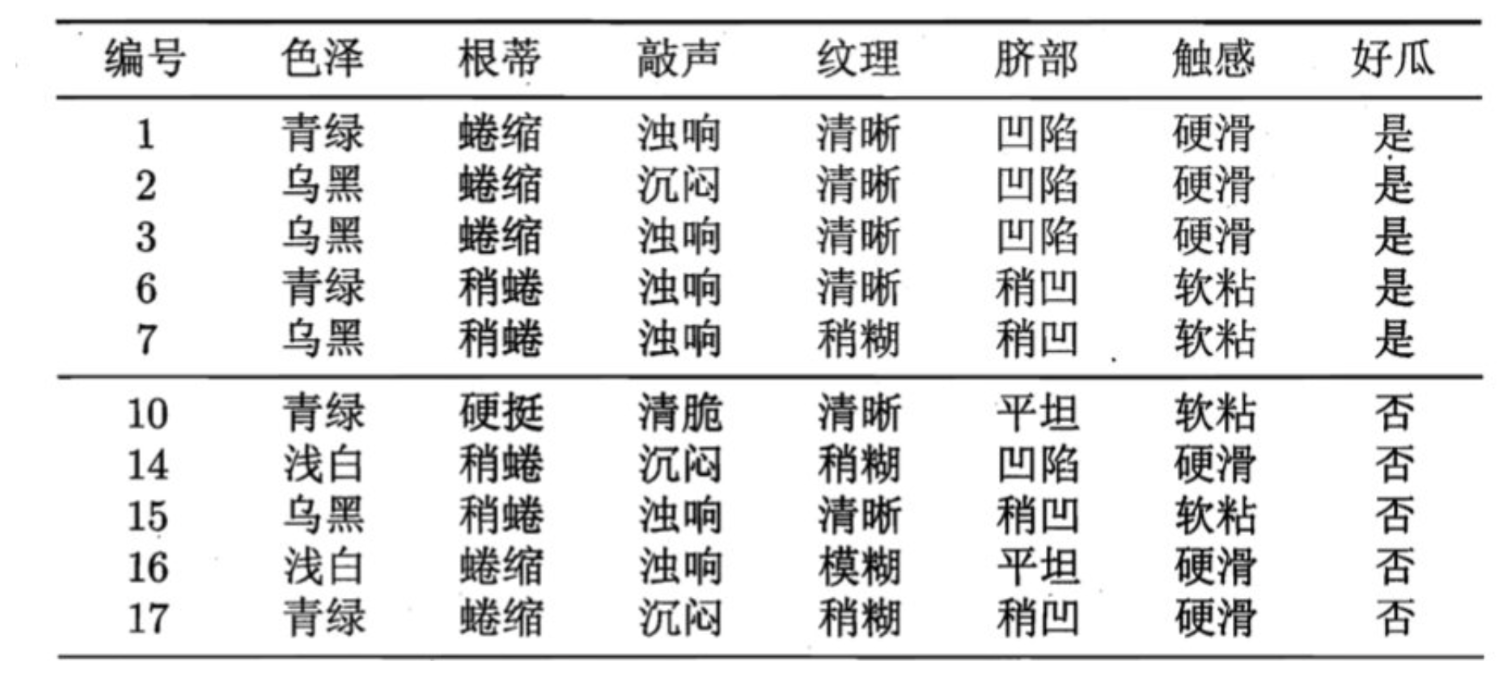
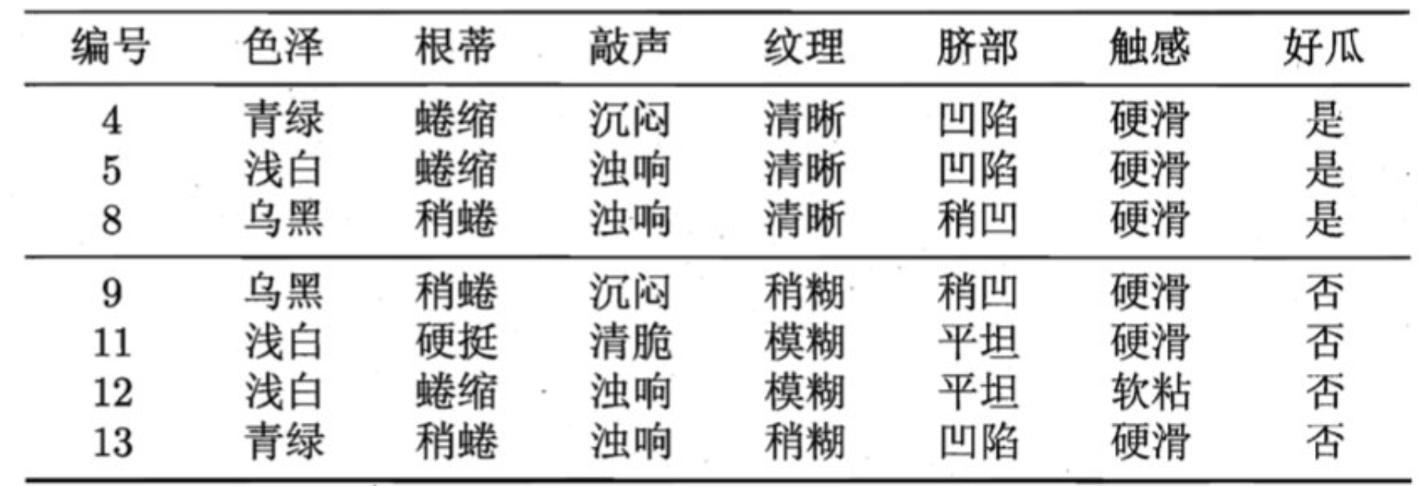
课件把数据划成训练集 10 条、验证集 7 条(第 59 页),用验证集精度判断「这个分支要不要留」。
验证集(7 条):
| 编号 | 色泽 | 根蒂 | 敲声 | 纹理 | 脐部 | 触感 | 好瓜 |
|---|---|---|---|---|---|---|---|
| 4 | 青绿 | 蜷缩 | 沉闷 | 清晰 | 凹陷 | 硬滑 | 是 |
| 5 | 浅白 | 蜷缩 | 浊响 | 清晰 | 凹陷 | 硬滑 | 是 |
| 8 | 乌黑 | 稍蜷 | 浊响 | 清晰 | 稍凹 | 硬滑 | 是 |
| 9 | 乌黑 | 稍蜷 | 沉闷 | 稍糊 | 稍凹 | 硬滑 | 否 |
| 11 | 浅白 | 硬挺 | 清脆 | 模糊 | 平坦 | 硬滑 | 否 |
| 12 | 浅白 | 蜷缩 | 浊响 | 模糊 | 平坦 | 软粘 | 否 |
| 13 | 青绿 | 稍蜷 | 浊响 | 稍糊 | 凹陷 | 硬滑 | 否 |
(训练集 10 条为编号 1、2、3、6、7、10、14、15、16、17,其中 1/2/3/6/7 是好瓜,10/14/15/16/17 不是。)
从训练集生成的完整决策树(未剪枝,第 60/62 页)
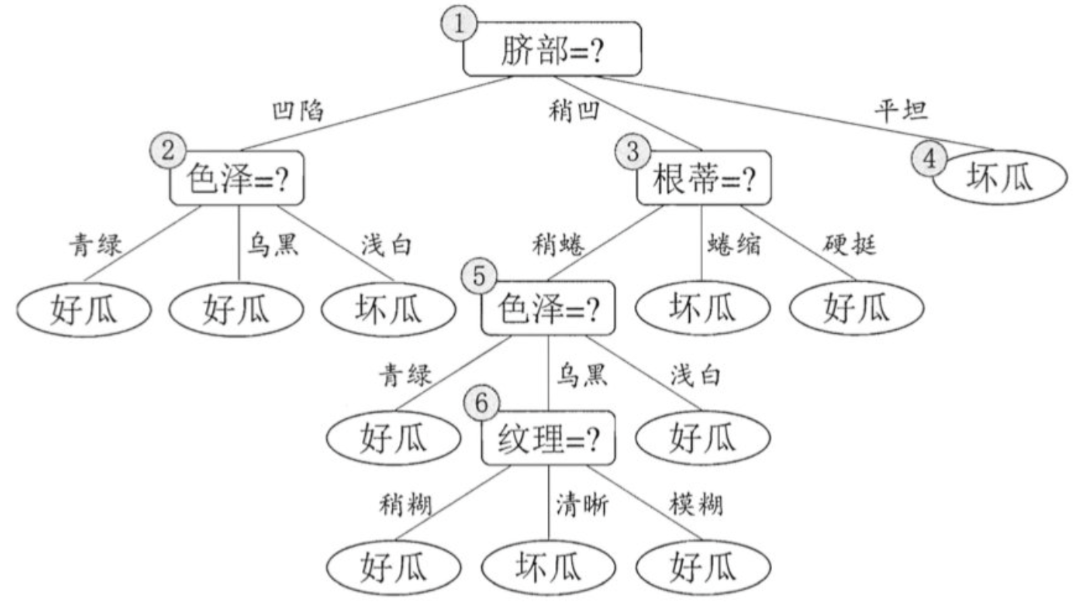
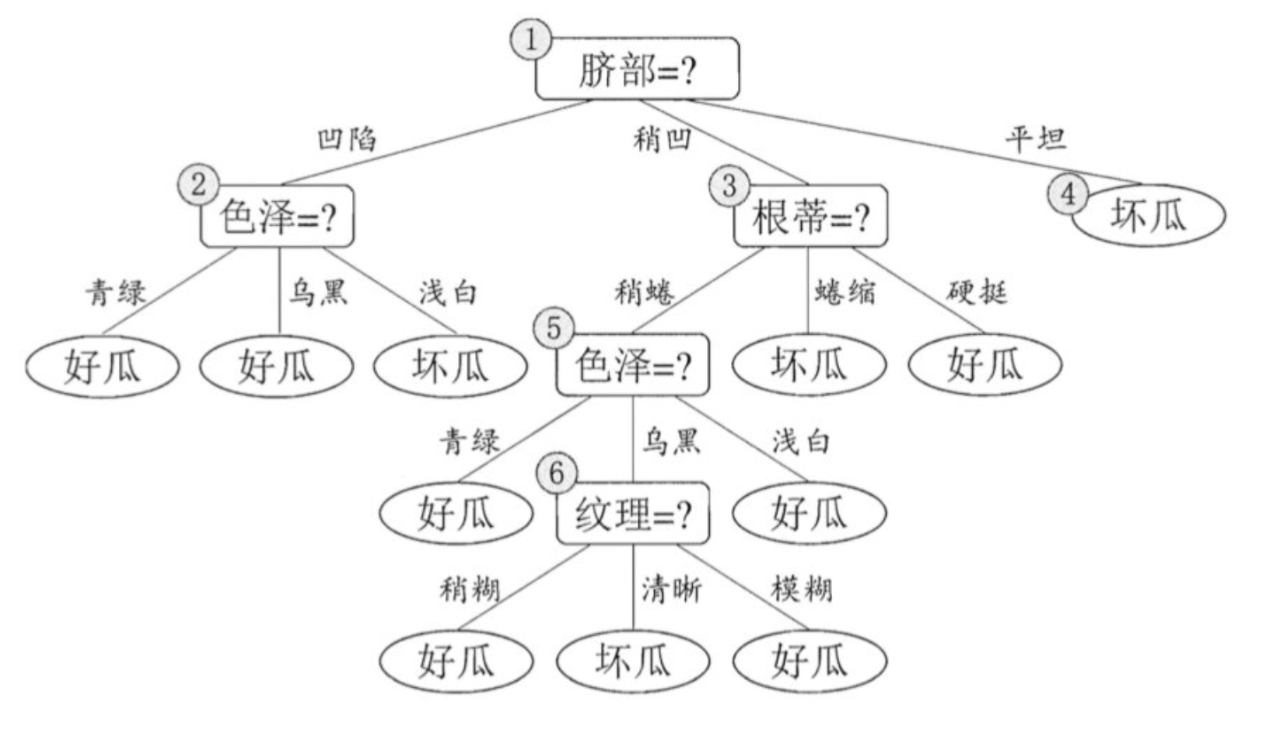
图注:课件给出的未剪枝完整树。根节点「脐部=?」,三条分支为 凹陷 / 稍凹 / 平坦;凹陷 下接节点「色泽=?」(青绿→好瓜、乌黑→好瓜、浅白→坏瓜);稍凹 下接节点「根蒂=?」(稍蜷→节点「色泽=?」、蜷缩→坏瓜、硬挺→好瓜),其中「色泽=?」下 乌黑 又接节点「纹理=?」(稍糊→好瓜、清晰→坏瓜、模糊→好瓜);平坦 直接得到一个叶节点「坏瓜」。如果没有剪枝,树会一直长到叶子都纯为止。
预剪枝结果(第 61 页):边划分边用验证集检验,三个节点的决策如下
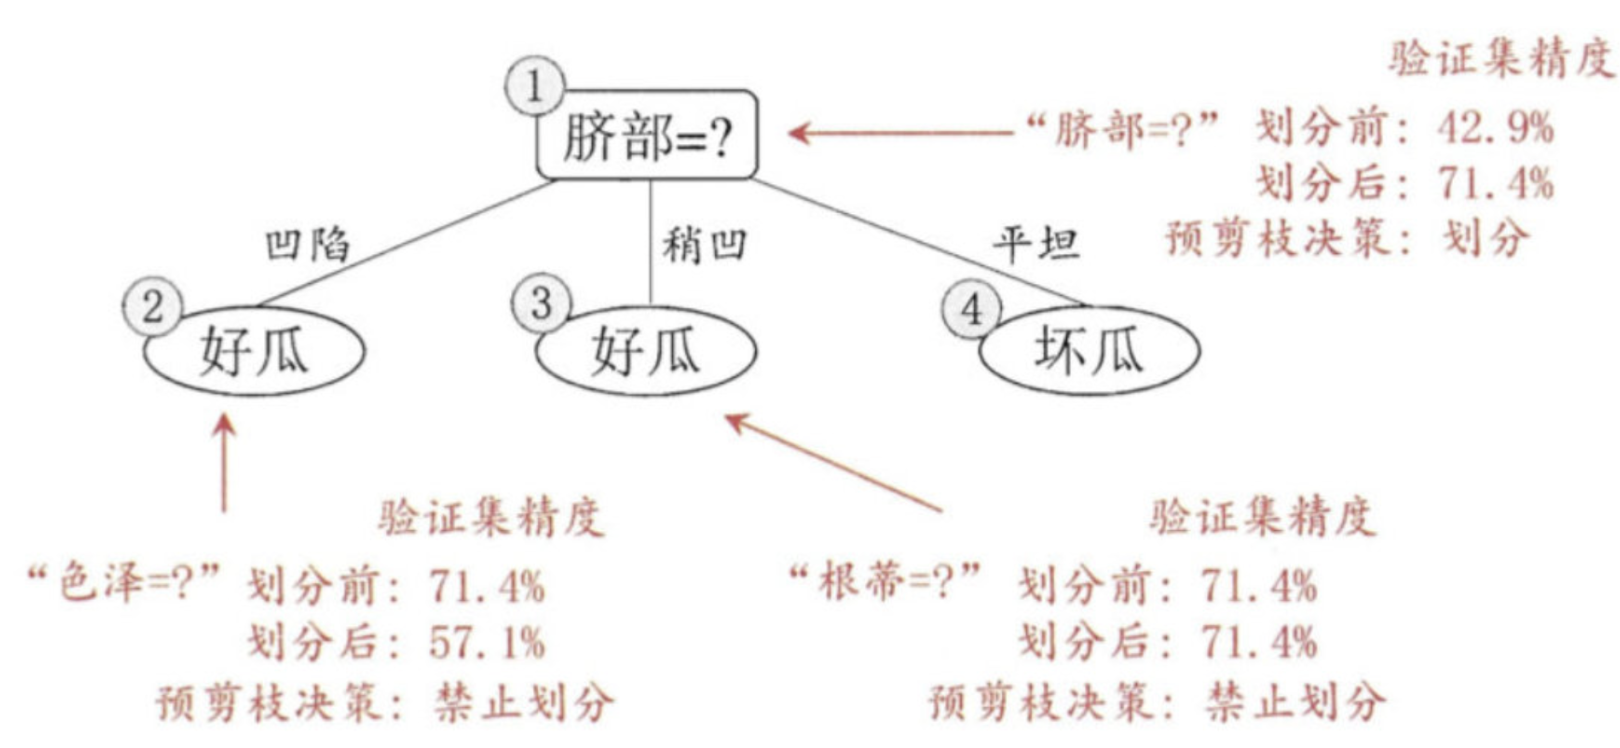
图注:课件的预剪枝结果树,只有根节点「脐部=?」一层分裂,凹陷 → 好瓜(节点②)、稍凹 → 好瓜(节点③)、平坦 → 坏瓜(节点④)。图旁三处旁注是预剪枝的判据:「脐部=?」划分前 42.9%、划分后 71.4%,预剪枝决策:划分;「色泽=?」划分前 71.4%、划分后 57.1%,预剪枝决策:禁止划分;「根蒂=?」划分前 71.4%、划分后 71.4%,预剪枝决策:禁止划分。
- 42.9% = 3/7:整棵树把所有样本都判成「好瓜」(训练集好瓜占多数)时,验证集只对 3 条;
- 71.4% = 5/7:按「脐部」分裂后,
凹陷叶判好瓜(验证集 4、5 正确、13 错误)、稍凹叶判好瓜(8 正确、9 错误)、平坦叶判坏瓜(11、12 都正确),合计 5/7。
一次分裂就把验证精度从 42.9% 拉到 71.4%,所以允许划分;再往下分(色泽、根蒂)都不能再提升,一律禁止,最终预剪枝树只有一层,验证集精度 71.4%。
后剪枝结果(第 62 页):先让树长完整,再自底向上逐个非叶节点考察「把它变成叶节点,验证精度会不会上升,上升就剪」
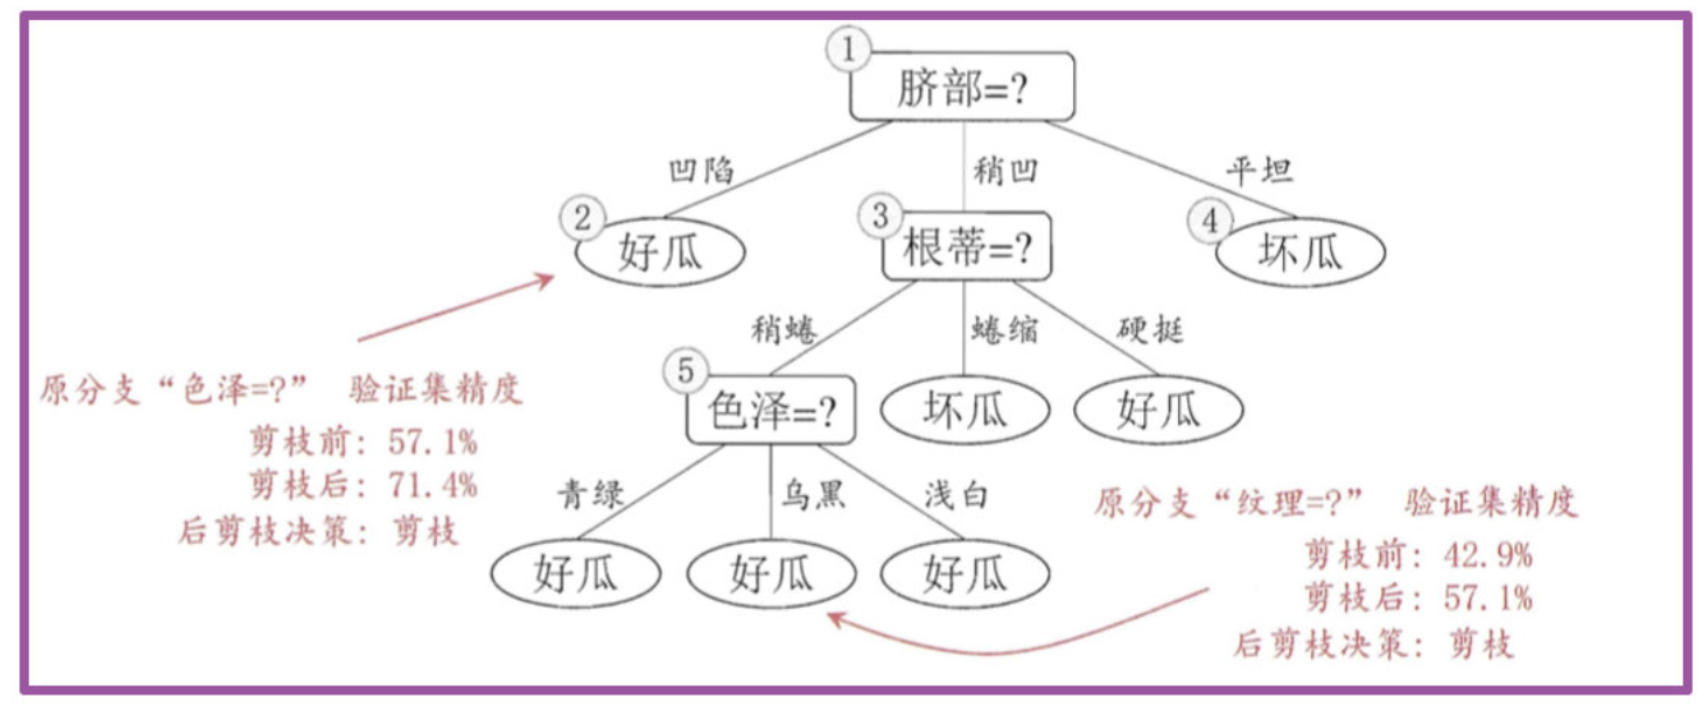
图注:课件的后剪枝结果树。原始完整树有多个内部节点(图中节点编号 ①②③⑤⑥),逐层考察后的旁注为:原分支「纹理=?」,剪枝前 42.9%、剪枝后 57.1%、后剪枝决策:剪枝;原分支「色泽=?」,剪枝前 57.1%、剪枝后 71.4%、后剪枝决策:剪枝。图中节点②「色泽=?」子树已被替换成叶节点「好瓜」,箭头指出了这次替换;根节点仍是「脐部=?」,凹陷 → 好瓜、稍凹 → 根蒂=?(稍蜷→色泽=?,蜷缩→坏瓜,硬挺→好瓜)、平坦 → 坏瓜。
后剪枝的考察顺序是自底向上:先看最靠下的「纹理=?」(42.9% → 57.1%,上升,剪掉),再看「色泽=?」(57.1% → 71.4%,上升,剪掉),最终验证集精度也是 71.4%,但后剪枝保留了更多分支,泛化性能一般优于预剪枝。
两种剪枝的优缺点(第 63 页原文)
| 预剪枝 | 后剪枝 | |
|---|---|---|
| 优点 | 使决策树的很多分支没有展开,不单降低了过拟合风险,还显著减少了决策树的训练、测试时间开销 | 比预剪枝保留了更多的分支;一般情况下后剪枝决策树的欠拟合风险很小,泛化性能往往优于预剪枝 |
| 缺点 | 有些分支的当前划分虽不能提升泛化性能,但后续划分却有可能导致性能的显著提高;预剪枝决策树也带来了欠拟合的风险 | 先生成、后剪枝,自底向上地对树中所有非叶子节点进行逐一考察,训练时间开销比未剪枝的决策树和预剪枝的决策树都要大得多 |
sklearn 里对应的工程化参数(第 42 页 API)
class sklearn.tree.DecisionTreeClassifier(
    criterion='gini',       # 'gini' 基尼系数(CART)/ 'entropy' 信息增益(ID3 思路)
    max_depth=None,         # 树的最大深度 —— 最常用的"预剪枝"手段
    min_samples_split=...,  # 内部节点再划分所需的最小样本数 —— 预剪枝
    min_samples_leaf=...,   # 叶子节点最少样本数 —— 预剪枝
    random_state=None,
)
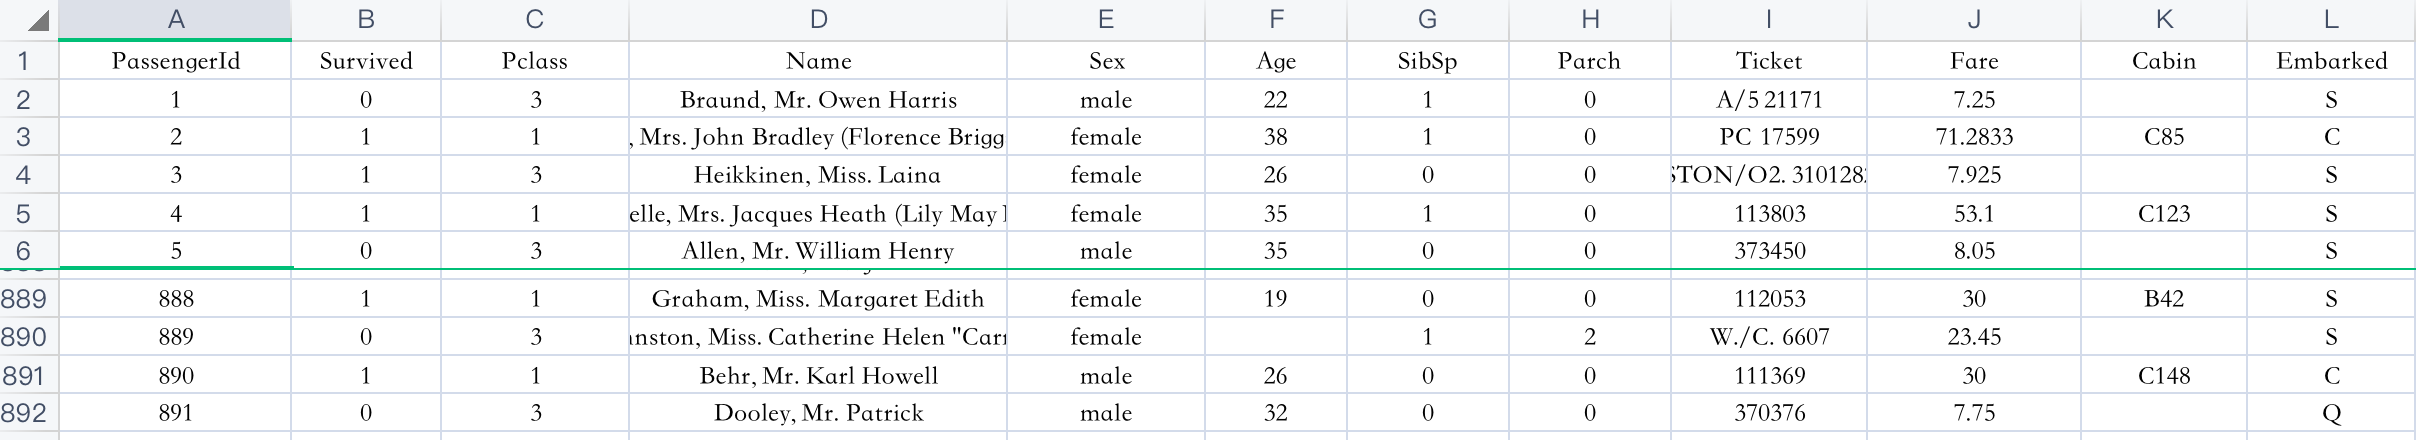
课件的泰坦尼克号案例(第 44 页)把完整流程走了一遍:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, plot_tree
from sklearn.metrics import classification_report

taitan_df = pd.read_csv("./data/titanic/train.csv")
x = taitan_df[['Pclass', 'Age', 'Sex']]
y = taitan_df['Survived']
x['Age'].fillna(x['Age'].mean(), inplace=True)   # 缺失值用均值填充
x = pd.get_dummies(x)                            # Pclass 等类别型特征 one-hot 编码
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.20, random_state=33)

estimator = DecisionTreeClassifier()
estimator.fit(x_train, y_train)                  # 训练
y_pred = estimator.predict(x_test)               # 预测
print(estimator.score(x_test, y_test))           # 准确率
print(classification_report(y_pred, y_test, target_names=['died', 'survived']))

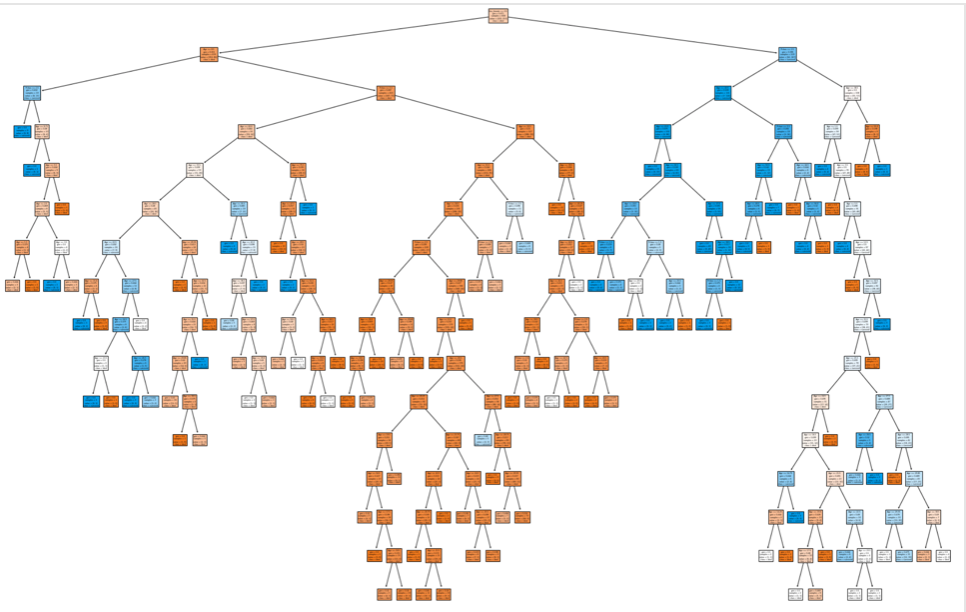
plot_tree(estimator, max_depth=10, filled=True,
          feature_names=['Pclass', 'Age', 'Sex_female', 'Sex_male'],
          class_names=['died', 'survived'])      # 可视化
4.8 从单棵树到随机森林(延伸:为什么树模型要「集成」)
课件本身停在剪枝,但下一步的分叉点非常关键,单棵树的问题,正是随机森林存在的理由:
| 单棵决策树的毛病 | 随机森林的解法 |
|---|---|
| 对训练数据极度敏感,换个随机种子树形变化很大(高方差) | Bagging:有放回地抽样(bootstrap)产生不同的训练集,从而训练不同的学习器 |
| 贪心地选最优特征,容易过拟合 | 限制每棵树的候选特征数量(随机挑选 n 个特征,n 小于总特征数量) |
| 单棵树预测噪声大 | 平权投票,多数表决输出最终预测结果 |
按同目录《集成学习》课件的定义:随机森林是基于 Bagging 思想实现的一种集成学习算法,采用决策树模型作为每一个弱学习器。
构建过程(5 步):
- 随机选数据,从训练集有放回地抽样,得到一个与原始集同规模的 bootstrap 样本;
- 随机选特征,从全部特征中随机挑出 n 个(n < 特征总数);
- 训练弱学习器,在这个子数据集 + 子特征上训练一棵决策树;
- 重复 1~3 共 n_estimators 次,得到 n 棵树;
- 平权投票,分类场景按多数表决输出预测结果(回归场景取均值)。
from sklearn.ensemble import RandomForestClassifier

rfc = RandomForestClassifier(max_depth=6, random_state=9)   # 每棵树都是 CART,max_depth 控制单树复杂度
rfc.fit(x_train, y_train)
rfc.score(x_test, y_test)
三个「为什么」(《集成学习》课件的思考题)
- 为什么要随机抽样训练集?不随机抽样的话每棵树的训练集都一样,训练出的树分类结果也完全一样,集成就没有意义。
- 为什么要有放回地抽样?不放回的话每棵树的训练样本没有交集,每棵树都是”有偏的”;有放回抽样使各树训练样本既有交集也有差异,更容易发挥投票表决的效果。
- 为什么单树反而可能比随机森林在训练集上”更好”?单树可以无限长到每个叶子都纯(训练集 100% 准确),这是过拟合;随机森林靠「多棵高方差树平均」把方差降下来,换来更好的泛化。
这就是新闻分类项目基线模型的理论来源:
TF-IDF + 随机森林中的随机森林不是黑盒,而是「Bagging + 很多棵 CART 分类树 + 平权投票」,每棵树的生长规则由这份课件完整定义。
五、易错点与常见误解
-
关于熵的方向
-
常见说法:「熵越大,系统的混乱程度越小。」
- 熵越大,混乱程度越大。
-
为什么:熵是随机变量不确定度的度量,数据越集中、越有序,熵越小;完全纯净时熵为 0。课件第 19 页的判断题正是用这句错误表述做干扰项。
-
关于特征选择的方向
-
有人以为「基尼指数值越大,则说明优先选择该特征。」
- 信息增益、信息增益率越大越好;基尼指数越小越好。
-
原因在于,增益衡量的是「不确定性减少了多少」(越大越好),基尼衡量的是「划分后还剩多少不纯度」(越小越好)。两者方向相反,是最容易记混的一点。
-
关于「决策树不能给出特征重要性」
-
常听到的一种说法是:「通过决策树不能明确特征的重要性程度。」
- 决策树必须依据特征重要性进行分裂,选谁当分裂节点,就是用信息增益 / 信息增益率 / 基尼指数在给特征排序;sklearn 还会汇总每个特征在分裂中贡献的不纯度下降量,输出
feature_importances_。 -
背后的道理是,课件第 19 页这道题的标准答案就是 D(该说法错误)。
-
关于「信息增益对类别数多的特征青睐」
-
容易想岔的地方:「消除的不确定性越大,信息增益越小,表示这个特征越不重要。」
- 消除的不确定性越大 → 信息增益越大 → 特征越重要。同时要补一句:信息增益确实对类别数较多的特征比较青睐(这就是 C4.5 要修正的缺陷)。
-
之所以如此,这两句是课件第 20 页多选题的正确选项,容易只记住一半。
-
关于「ID3 的偏好多值特征」
-
先说一个误解:「取值多的特征信息增益大,说明它更会分类。」
- 取值多的特征容易把数据集切得很碎,每个子集都很纯(甚至 1 个样本 1 个取值,增益 = 1),这是伪优势,会导致树过拟合,C4.5 才引入 IV(a) 做惩罚。
-
为什么:见 4.3 的手算例,特征 b(6 个取值)增益 = 1 却被增益率判为不如特征 a。
-
关于 CART 的形态
-
常见说法:「CART 只能用于分类。」
- CART = Classification And Regression Tree,分类和回归都能做;分类用基尼指数最小化,回归用平方误差最小化。
-
原因在于,名字里的 “R” 就是 Regression,课件第 30、38 页都强调了这一点。
-
关于「回归树的分裂点怎么选」
-
有人以为「回归树根据信息增益 / 基尼指数选择最佳分割点。」
- 回归树根据均方误差(平方损失/均方误差)选择分割点。
-
背后的道理是,目标值是连续值,算熵和基尼都需要「类别」,只有平方损失对连续值有意义。
-
关于剪枝的时机
-
常听到的一种说法是:「预剪枝和后剪枝都是等树建好之后再删节点。」
- 预剪枝是一边生成一边验证(划分前先估计,不行就停下当叶子);后剪枝才需要等树构建完成后再自底向上遍历节点。
-
之所以如此,课件第 65 页多选题的 C、D 两个选项分别描述了这两者。
-
关于对数的底数
-
熵的对数底数可以取 2(单位 bit)、e(单位 nat)或 10,只要在整棵树的迭代里保持一致就没有区别;但课件第 11 页用了自然对数(得出 1.0986、0.8018),第 10、13 页用的是 log₂。统一说 log₂(信息增益的原始定义)最稳。
-
关于课件第 16 页的 H(D) = 0.9812
-
这个数字是笔误,按 15 条样本 5 正 10 负、取 log₂ 应为 0.9183。用课件自己的其他数字可以交叉验证:0.9183 − 0.9118 = 0.0064(性别增益)、0.9183 − 0.2406 = 0.6776(活跃度增益),两个都与页面上印的结果完全吻合。背 0.9183。
六、横向对比与研究脉络
6.1 三种分类树的对比(课件第 37 页原表的展开)
| 名称 | 提出时间 | 分支方式 | 特点 |
|---|---|---|---|
| ID3 | 1975 | 信息增益 | ① 只能对离散属性的数据集构成决策树;② 倾向于选择取值较多的属性 |
| C4.5 | 1993 | 信息增益率 | ① 缓解了 ID3 总喜欢偏向选择值较多属性的问题;② 可处理连续数值型属性,也增加了对缺失值的处理方法;③ 只适合于能够驻留于内存的数据集,大数据集无能为力 |
| CART | 1984 | 基尼指数 | ① 可以进行分类和回归,可处理离散属性,也可以处理连续属性;② 采用基尼指数,计算量减小;③ 一定是二叉树 |
6.2 按工程维度再对比一次
| 维度 | ID3 | C4.5 | CART |
|---|---|---|---|
| 分裂指标 | 信息增益 | 信息增益率 | 基尼指数(分类)/ 平方损失(回归) |
| 指标方向 | 越大越好 | 越大越好 | 越小越好 |
| 是否含 log | 含(log₂) | 含(两次 log₂) | 不含,纯平方和 |
| 特征类型 | 仅离散 | 离散 + 连续 | 离散 + 连续 |
| 树的形态 | 多叉 | 多叉 | 一定是二叉树 |
| 缺失值 | 不处理 | 有处理方法 | sklearn 中需先自行填充 |
| 回归能力 | 无 | 无 | 有 |
| 主要短板 | 偏好多值特征 | 需全量数据驻留内存 | 单树方差大、需集成 |
| sklearn 对应 | criterion='entropy'(近似) |
无直接实现 | criterion='gini'(默认) |
注意最后一行的措辞:sklearn 的
DecisionTreeClassifier(criterion='entropy')用的是信息增益(ID3 的思路),而不是 C4.5 的信息增益率;sklearn 根本没有实现 C4.5。被追问时说「sklearn 的决策树底层都是 CART,entropy只是把分裂准则换成熵」比说「sklearn 支持 C4.5」准确得多。
6.3 演进脉络(谁解决了谁的什么问题)
1975 ID3(Quinlan)
   │  问题:信息增益偏爱取值多的特征 → 伪优势 → 过拟合
   ▼
1993 C4.5(Quinlan)
   │  解法:信息增益 ÷ 特征固有值 IV(a) 做惩罚;顺带支持连续值二分与缺失值
   │  遗留:需要全量数据驻留内存;仍然多叉、不支持回归
   ▼
1984 CART(Breiman 等,与 C4.5 是并行分支而非后继)
   │  解法:改用基尼指数(去掉 log,计算量下降);一律二叉;统一支持回归(平方损失)
   ▼
1990s-2000s 集成学习
   │  Bagging + CART  → 随机森林(降方差)
   │  Boosting + CART → AdaBoost / GBDT / XGBoost / LightGBM(降偏差)
   ▼
2017  XGBoost / LightGBM 成为工业表格数据的默认选择
一句话概括:ID3 立框架,C4.5 修指标,CART 定工业标准,集成学习把它变成 SOTA。
七、在新闻分类项目中的落地
7.1 用在哪一步
这是一个类今日头条的新闻分类模块(10 个类别,训练 18w / 测试 1w / 验证 1w,标题\t标签 格式,749 个停用词)。四级模型对比的第一级就是:
TF-IDF 向量化(TfidfVectorizer(stop_words=停用词).fit_transform())
        ↓
RandomForestClassifier          ← 这一层完全由本课件的知识支撑
        ↓
FastText → BERT 微调 → LLM(DeepSeek API)
随机森林 = Bagging + 多棵 CART 分类树 + 平权投票,所以:
- 每棵树的每个节点,都在用基尼指数(sklearn 默认
criterion='gini')从 TF-IDF 的几万个词维度里挑「最能区分新闻类别」的那个词; - 由于每棵树只随机看一部分特征,所以能天然对抗 TF-IDF 高维稀疏带来的过拟合;
- 训练完可以直接
feature_importances_打印出最有区分度的词,这在项目被追问时是很好的可解释性素材(「体育」这个词把体育类和娱乐类分开的贡献最大,等等)。
7.2 关键参数怎么调
| 参数 | 作用 | 在 18w 新闻数据上的建议 |
|---|---|---|
criterion |
'gini'(默认,CART)/ 'entropy' |
保持 'gini',与「CART」叙述一致;想对比可以跑一版 'entropy' |
n_estimators |
树的棵数 | 100~200 起步;再多收益递减、推理变慢 |
max_depth |
单树最大深度(最重要的预剪枝旋钮) | 5~15。18w 样本下不限制深度单树会极深、严重过拟合 |
min_samples_leaf |
叶子最少样本数(预剪枝) | 设成 5~20,防止长出只包含 1~2 个样本的叶子 |
min_samples_split |
内部节点再划分的最小样本数 | 常与 min_samples_leaf 配合 |
max_features |
每个节点随机考虑的特征数 | 'sqrt'(默认)在高维稀疏 TF-IDF 上很关键 |
class_weight |
类别权重 | 若 10 类不均衡,用 'balanced' |
random_state |
随机种子 | 必须固定,否则实验复现不了 |
配合 GridSearchCV(param_grid={'n_estimators': [...], 'max_depth': [...]}, cv=...) 做网格搜索(同目录《集成学习》课件的泰坦尼克案例就是这个套路:n_estimators: [40,50,60,70] × max_depth: [2,4,6,8,10])。
7.3 实际坑
- 不限制深度 = 过拟合。18w 训练样本、几万维特征,单棵不剪枝的树在训练集上几乎 100% 准确,测试集掉一大截。
max_depth和min_samples_leaf必须调。 - TF-IDF 的稀疏矩阵直接喂给树,速度慢。决策树按特征逐个尝试切分,稀疏矩阵虽然省内存,但遍历时仍要扫全部特征 → 用
max_features='sqrt'限制每节点考察的特征数,或先用卡方/方差做特征选择降维。 - 树不需要归一化,但需要处理缺失值和类别编码。课件泰坦尼克案例里就是
Age用均值填充、Pclass用get_dummies()one-hot,TF-IDF 本身输出稠密/稀疏数值,这一步在新闻项目里由TfidfVectorizer代劳。 - 「标签 \t 文本」的解析。RandomForest 的
y必须是整数标签,10 个类别要先LabelEncoder。 - 随机森林不能外推。树是分段常数,对训练集范围之外的数值不会外推,新闻分类是分类任务,这个缺陷影响不大,但如果做「预测阅读量」这类回归任务就要注意。
- 推理延迟。
n_estimators=500+ 深树会让线上推理变慢,这也是项目最后要做模型压缩的原因之一。
7.4 和项目里其它方案怎么配合
| 方案 | 决策树知识在其中的角色 |
|---|---|
| TF-IDF + 随机森林 | 直接由本课件支撑:CART 分类树 + 基尼指数 + Bagging 集成 |
| FastText | 对比项。要能说清差异:FastText 是线性 + n-gram 哈希,训练快、可在线更新;随机森林是非线性、可解释、需要特征工程 |
| BERT 微调 | 对比项。BERT 用 Attention 建模上下文,能处理「苹果」(水果 vs 公司)这种歧义;TF-IDF + 随机森林只能看词袋 |
| LLM(DeepSeek 零样本/少样本) | 对比项。强调「随机森林推理毫秒级、LLM 需要 API 调用」,成本/延迟/效果三角 |
| 剪枝 & 模型压缩 | 剪枝是同一种正则化思想在两个层面的体现:决策树剪枝剪「子树」,模型压缩剪「权重/通道」。项目里非结构化剪枝用 torch.nn.utils.prune.global_unstructured(),结构化剪枝剪整个通道 / 层,而它们的动机完全一致:用一点点精度换回大量参数与推理时间 |
被追问时可以这样串起来:「我们从 TF-IDF + 随机森林这条可解释的基线出发,随机森林的每一棵树都是 CART,靠基尼指数选分裂特征,靠 max_depth/min_samples_leaf 做预剪枝控制复杂度;拿到基线分数后,再逐级上 FastText、BERT 和 LLM,最后用剪枝、量化、蒸馏把大模型压回可部署的体积,剪枝这个动作,从决策树一路做到了深度网络。」
八、重点问答
Q1:什么是信息熵?为什么决策树要用它?
A:信息熵是信息论里度量随机变量不确定度的量,公式是 H(x)=-\sum P(x_i)\log_2 P(x_i)。我的理解是:熵越大,数据越乱、越不确定;熵越小,数据越纯。举个例子,数据集 ABCDEFGH 八种类别各占 1/8,熵是 3;数据集 AAAABBCD 只有四种且 A 占一半,熵只有 1.75。决策树要解决的问题是「用哪个特征划分最好」,所以需要一个能刻画「划分前有多乱、划分后有多纯」的量化指标,熵正好就是。
Q2:信息增益是怎么算的?为什么 ID3 用它?
A:信息增益 = 划分前的熵 − 划分后的条件熵,也就是「用特征 A 划分后,不确定性减少了多少」。条件熵是各个子集熵的加权平均,权重是子集占总样本的比例。我在课件里算过一个 15 条论坛用户流失数据:整体 5 正 10 负,熵是 0.9183;按性别划分的条件熵是 0.9118,增益只有 0.0064;按活跃度划分的条件熵是 0.2406,增益是 0.6776。结论很直观,性别几乎分不动,活跃度才是关键,所以 ID3 会先拿活跃度做分裂。信息增益越大越好。
Q3:信息增益有什么缺陷?C4.5 怎么改的?
A:最大缺陷是偏爱取值多的特征。极端情况下如果某个特征每个样本一个取值,划分后每个子集只有一个样本、熵全是 0,信息增益直接等于 1 拉满,但这棵树对新样本毫无泛化能力,是纯粹的过拟合。C4.5 的修正是除以特征自身的固有值 IV(a),得到信息增益率。IV(a) 只由特征取值分布决定、不看标签,取值越多 IV(a) 越大,惩罚越重。课件里那个 6 样本的例子:特征 a 两个取值,增益率 0.5;特征 b 六个取值,增益是满分 1,但 IV(b)=2.58,增益率只有 0.39,所以应该选 a,ID3 会选错,C4.5 纠正了它。
Q4:基尼系数是什么?请一步步算一遍基尼指数。
A:基尼值 Gini(D) 的直觉是「从数据集里随机抽两个样本,它俩类别不一致的概率」,写成公式是 1-\sum p_k^2,越小说明数据越纯。基尼指数就是把各子集的基尼值按样本占比加权求和,CART 选基尼指数最小的特征分裂。我用课件里 10 条「是否拖欠贷款」数据分三步算一遍。第一步算子集基尼值:是否有房 = yes 对应序号 1、4、7 共 3 条,目标全是 no,所以 Gini = 1-(0/3)^2-(3/3)^2 = 0;是否有房 = no 对应剩余 7 条,4 个 no、3 个 yes,所以 Gini = 1-(4/7)^2-(3/7)^2 = 1-0.3265-0.1837 = 0.4898。第二步按占比加权:两部分分别占 3/10 和 7/10,Gini\_index = 0.3\times0+0.7\times0.4898 = 0.343。第三步对比其他特征:婚姻状况以 {married} 划分时,married 那 4 条全 no(基尼 0),非 married 那 6 条 3 no 3 yes(基尼 0.5),加权后 0.4\times0+0.6\times0.5=0.3,比 0.343 小;年收入取相邻中点 97.5 划分也能到 0.3。所以第 1 轮分裂点就在婚姻状况和年收入之间选。CART 用基尼而不用熵的原因也很直接:它不含对数运算、只有平方和,计算量更小,而划分效果和熵相当。
Q5:决策树怎么处理连续值特征?
A:不枚举每个取值,而是排序后取相邻值的中点作候选切分点。比如年收入排序是 60、70、75、85、90、95、100、120、125、220,就得到 9 个候选点:65、72.5、80、87.5、92.5、97.5、110、122.5、172.5。然后逐个算划分指标,CART 算基尼指数,C4.5 算信息增益率,取最优的那个点。课件里算下来最优是 97.5,基尼指数 0.3。要注意的是 CART 切完就是「≤s」和「>s」两个分支,一定是二叉树;而 C4.5 因为是多叉树,对连续值仍然是二分处理。
Q6:CART 回归树和分类树有什么区别?
A:主要有四点不同。第一,预测输出:分类树输出离散类别,回归树输出连续值。第二,划分依据:分类树用基尼指数最小化,回归树用平方损失(均方误差)最小化,损失函数就是 (f(x)-y)^2。第三,叶子输出:分类树取叶子里的多数类别,回归树取叶子内所有样本的均值,因为均方损失下均值就是最优常数输出。第四,分裂点选择方式相同,都是排序 + 相邻中点 + 选损失最小的。另外从拟合形态看,线性回归给的是直线,回归树给的是阶梯曲线;树的拟合能力更强、也更易过拟合,所以要靠 max_depth 控制。
Q7:为什么要剪枝?预剪枝和后剪枝怎么选?课件里是怎么用数字判断的?
A:决策树如果不加限制会一直长到每个叶子都纯,训练集准确率接近 100%,但泛化很差,剪枝就是决策树的正则化,本质是用叶子节点替换整棵子树,降低复杂度。预剪枝在生成过程中做:划分前先估计这次的划分能不能提升泛化性能,不能就停下把当前节点标记为叶节点;优点是很多分支压根没展开,训练和测试的开销都小;缺点是可能欠拟合,因为有些划分当下没提升、后续却能显著提升。后剪枝是先把完整树建出来,再自底向上考察每个非叶节点,把子树换成叶子后精度上升就剪;优点是保留了更多分支、欠拟合风险小、泛化通常更好;缺点是训练开销大得多。课件用西瓜数据集(10 条训练、7 条验证)把这套逻辑数字化了:整棵树把所有样本判成「好瓜」,验证集精度只有 3/7 = 42.9%;预剪枝时根节点按「脐部」划分后升到 71.4%(5/7)所以放行,但「色泽」划分后降到 57.1%、「根蒂」划分后仍是 71.4% 没提升,两个都禁止划分,最后预剪枝树只有一层;后剪枝则自底向上看,「纹理」分支剪掉后从 42.9% 升到 57.1% 就剪,「色泽」分支剪掉后从 57.1% 升到 71.4% 也剪。两种方法最终都是 71.4%,但后剪枝保留了更多分支。我实际做的时候会先用 max_depth、min_samples_leaf 这类预剪枝参数快速收敛,再考虑代价复杂度剪枝 ccp_alpha。
Q8:决策树和随机森林什么关系?为什么随机森林效果更好?
A:随机森林是基于 Bagging 思想的集成算法,用决策树(sklearn 里是 CART 分类树)当弱学习器。构建过程是:有放回地抽样产生不同的训练集,每个节点再随机挑一部分特征,训练出一棵树;重复 n_estimators 次;预测时分类任务用平权投票、多数表决。它比单树好在两点:一是单树对训练数据极度敏感、方差很大,多棵树平均能显著降方差;二是「随机抽数据 + 随机抽特征」让树之间既有交集也有差异,投票才有效果,如果不放回抽样,每棵树样本完全没交集,每棵树都是有偏的,集成反而没用。我在项目里就是拿它当 TF-IDF 之后的基线模型。
九、延伸阅读
教材与经典文献
- 周志华.《机器学习》(西瓜书). 清华大学出版社,第 4 章「决策树」,本课件剪枝部分用的西瓜数据集 3.0α 就出自这里。
- 李航.《统计学习方法》,第 5 章「决策树」,信息增益 / 信息增益率的数学推导最规范。
- Quinlan, J. R. Induction of Decision Trees(ID3,课件标注 1975 年)。
- Quinlan, J. R. C4.5: Programs for Machine Learning(课件标注 1993 年)。
- Breiman, L., Friedman, J., Olshen, R., Stone, C. Classification and Regression Trees(CART,课件标注 1984 年)。
官方文档与 API
- scikit-learn 决策树用户指南:https://scikit-learn.org/stable/modules/tree.html
sklearn.tree.DecisionTreeClassifier/DecisionTreeRegressor/plot_treesklearn.ensemble.RandomForestClassifier/RandomForestRegressor(本课件未展开,见同目录《集成学习》)sklearn.model_selection.GridSearchCV(超参搜索)
数据集与工具
- 泰坦尼克号生存预测数据集(课件案例用,
train.csv,字段Pclass / Age / Sex / Survived) - 西瓜数据集 3.0α(剪枝示例,10 训练 + 7 验证)
- 论坛客户流失率数据(信息增益示例,15 条)
- 是否拖欠贷款数据(基尼指数示例,10 条)
- Graphviz /
plot_tree(决策树可视化)
附录:原图存档
本报告正文已就地插入 14 张最核心的原图(公式图、数据表、构建过程图、剪枝示意图)。以下为其余 45 张原图,按课件内容顺序分主题列出;每张图都注明了它在讲什么,需要回看细节时直接点开。
说明:
s19_01(随堂测验页的红蓝几何背景图)在课件第 19/20/27/39/55/65 页被重复用作装饰背景,属纯装饰性素材,本报告只列一次、不展开解读。另外有 5 张图被多页复用:s04_01(第 4/5/6 页)、s15_01(第 15/16/17 页)、s16_02(第 16/17 页)、s48_02(第 48/52 页)、s50_03(第 50/51 页),下面只在首次出现的主题里列出。
【主题 1】生活中的决策树与「树」的定义(第 4~6 页),用女孩相亲的决策树照片与手绘树,直观说明「内部节点 = 特征上的判断、分支 = 判断结果、叶子 = 分类结论」。
【主题 2】信息熵的随堂算例(第 10~11 页),熵公式的逐项展开与结果、ABCDEFGH 与 AAAABBCD 两个数据集的熵计算、以及 {1/3,1/3,1/3}、{1/10,2/10,7/10}、{1,0,0} 三种分布的熵对比。
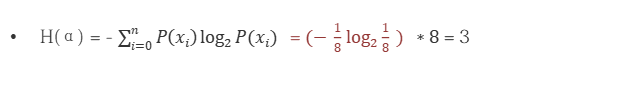
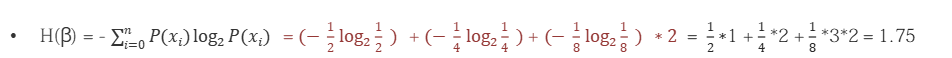
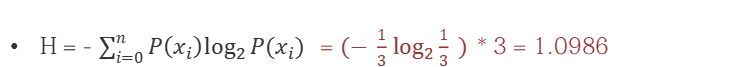
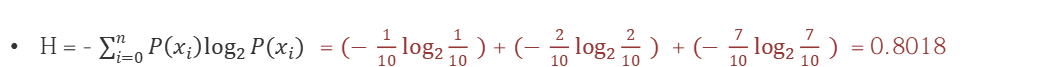
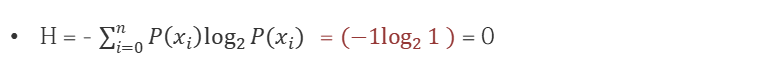
【主题 3】条件熵公式(第 12 页),给出的条件熵展开式 H(D|A)=\sum (D^v/D)H(D^v)=\sum (D^v/D)\sum (c^{kv}/D^v)\log(c^{kv}/D^v),是信息增益公式的分母部分。
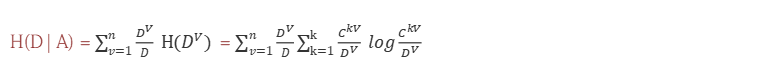
【主题 4】ID3 客户流失率案例的全部计算式(第 16~17 页),熵 0.9812(笔误,应为 0.9183)、性别条件熵、性别信息增益 0.0064、活跃度条件熵、活跃度信息增益 0.6776 的每一步算式截图。
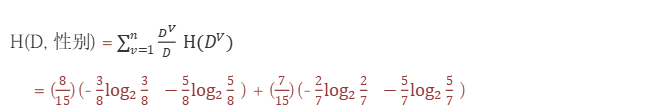
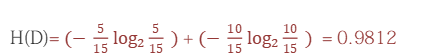
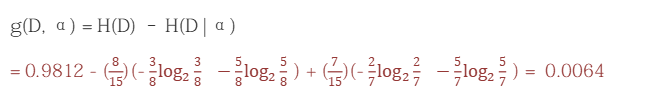
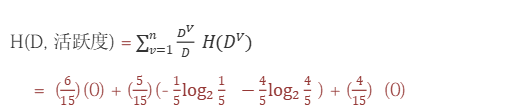
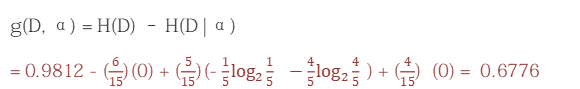
【主题 5】随堂测验页背景(第 19/20/27/39/55/65 页),纯装饰性底图。
【主题 6】ID3 缺点的构造例子(第 23 页),手绘的 6 样本数据集与「特征 b 有 6 个取值」的树形示意,说明用 b 分裂会得到深度 2 但过度依赖单一特征、易过拟合的树。
【主题 7】信息增益率的两步算例(第 25 页),特征 a 与特征 b 的信息增益、IV 信息熵、增益率(0.5 vs 0.39)的算式截图。
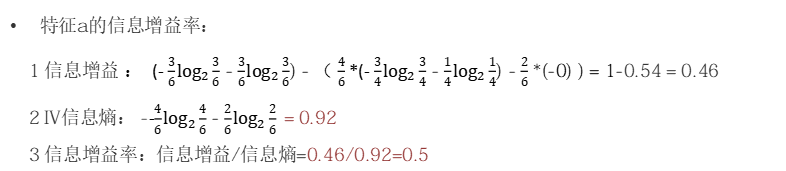
【主题 8】基尼指数公式(第 31 页),划分后基尼指数的加权求和式 Gini\_index(D,a)=\sum (D^v/D)Gini(D^v)。
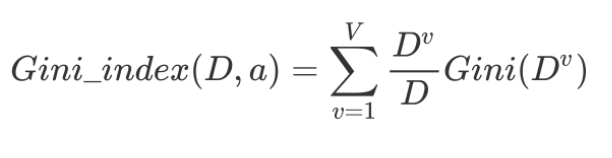
【主题 9】CART「是否有房」基尼算例(第 33 页),逐步算出有房基尼值 0、无房基尼值 0.4898、最终基尼指数 0.343,并给出 3/7 的样本占比拆分示意。
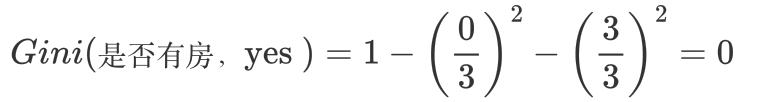
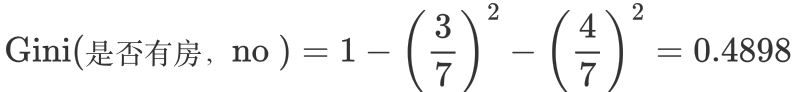
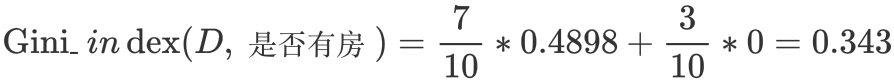
【主题 10】CART「婚姻状况」三种二分方式的基尼算例(第 34 页), {married}、{single}、{divorced} 三种划分的基尼指数计算与最终 0.3 的结论。
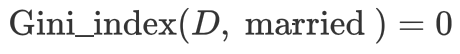
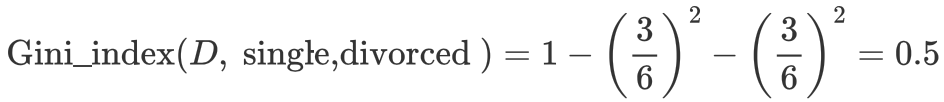
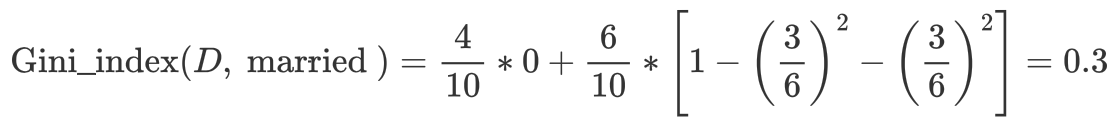
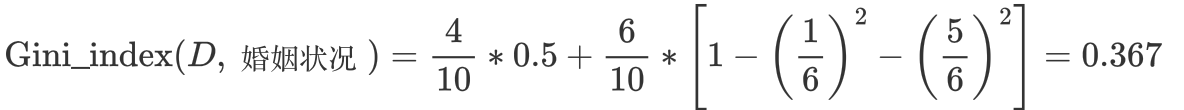
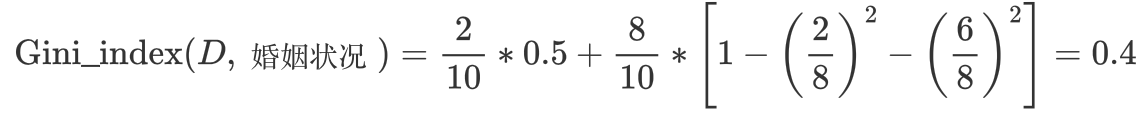
【主题 11】年收入连续值的分裂示意(第 35 页),以年收入 65 为切分点把样本分成两部分的图解。
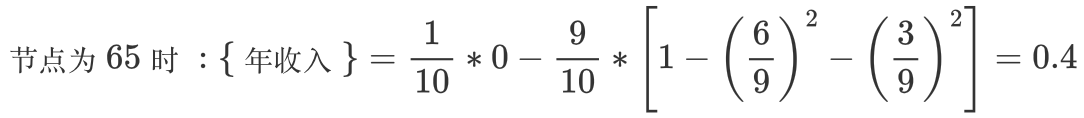
【主题 12】CART 第 1 轮结果汇总表(第 36 页),三个特征各自最优基尼指数(是否有房 0.343 / 婚姻状况 0.3 / 年收入 0.3)的对比表。
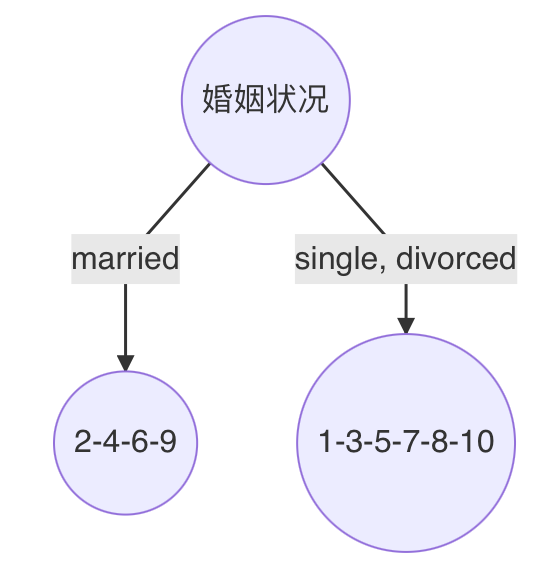
【主题 13】泰坦尼克号案例的数据与树可视化(第 43、45 页),原始数据表(含 Age 缺失)与 plot_tree 输出的多色决策树(节点颜色由橙到蓝代表类别分布,节点大小代表样本数)。
【主题 14】回归树的损失公式与数据集(第 48、52 页),平方损失 Loss(y, f(x)) = (f(x) - y)² 的公式图,以及只有 1 个特征 x 的回归示例数据表。
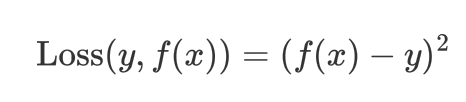

【主题 15】回归树划分点与平方损失的完整推导(第 49~51 页),候选划分点表、各划分点的 m(s) 数值表(1.3087 / 0.754 / 0.2771 / 0.4368 / 1.0644)、左子树以 3.5 继续分裂的图示,以及最终 3 区域回归树。




【主题 16】预测值图线(第 52 页),用 1000 个 [0, 10] 之间的测试点画出的线性回归 / 回归树预测曲线。
【主题 17】剪枝用的训练集与验证集(第 59 页),西瓜数据集 3.0α 的 10 条训练样本与 7 条验证样本(编号 4/5/8/9/11/12/13,其中 4/5/8 是好瓜)。
【主题 18】后剪枝的完整树(第 62 页),后剪枝操作之前的未标注完整树,供与正文中的剪枝后版本对照。