整个”大模型提示词工程”课件的总目录与学习契约,它先告诉你为什么必须学提示词(”内功”),再铺开五条能力主线:发展史与幻觉、编写规范、进阶技术、安全、文本处理实战。
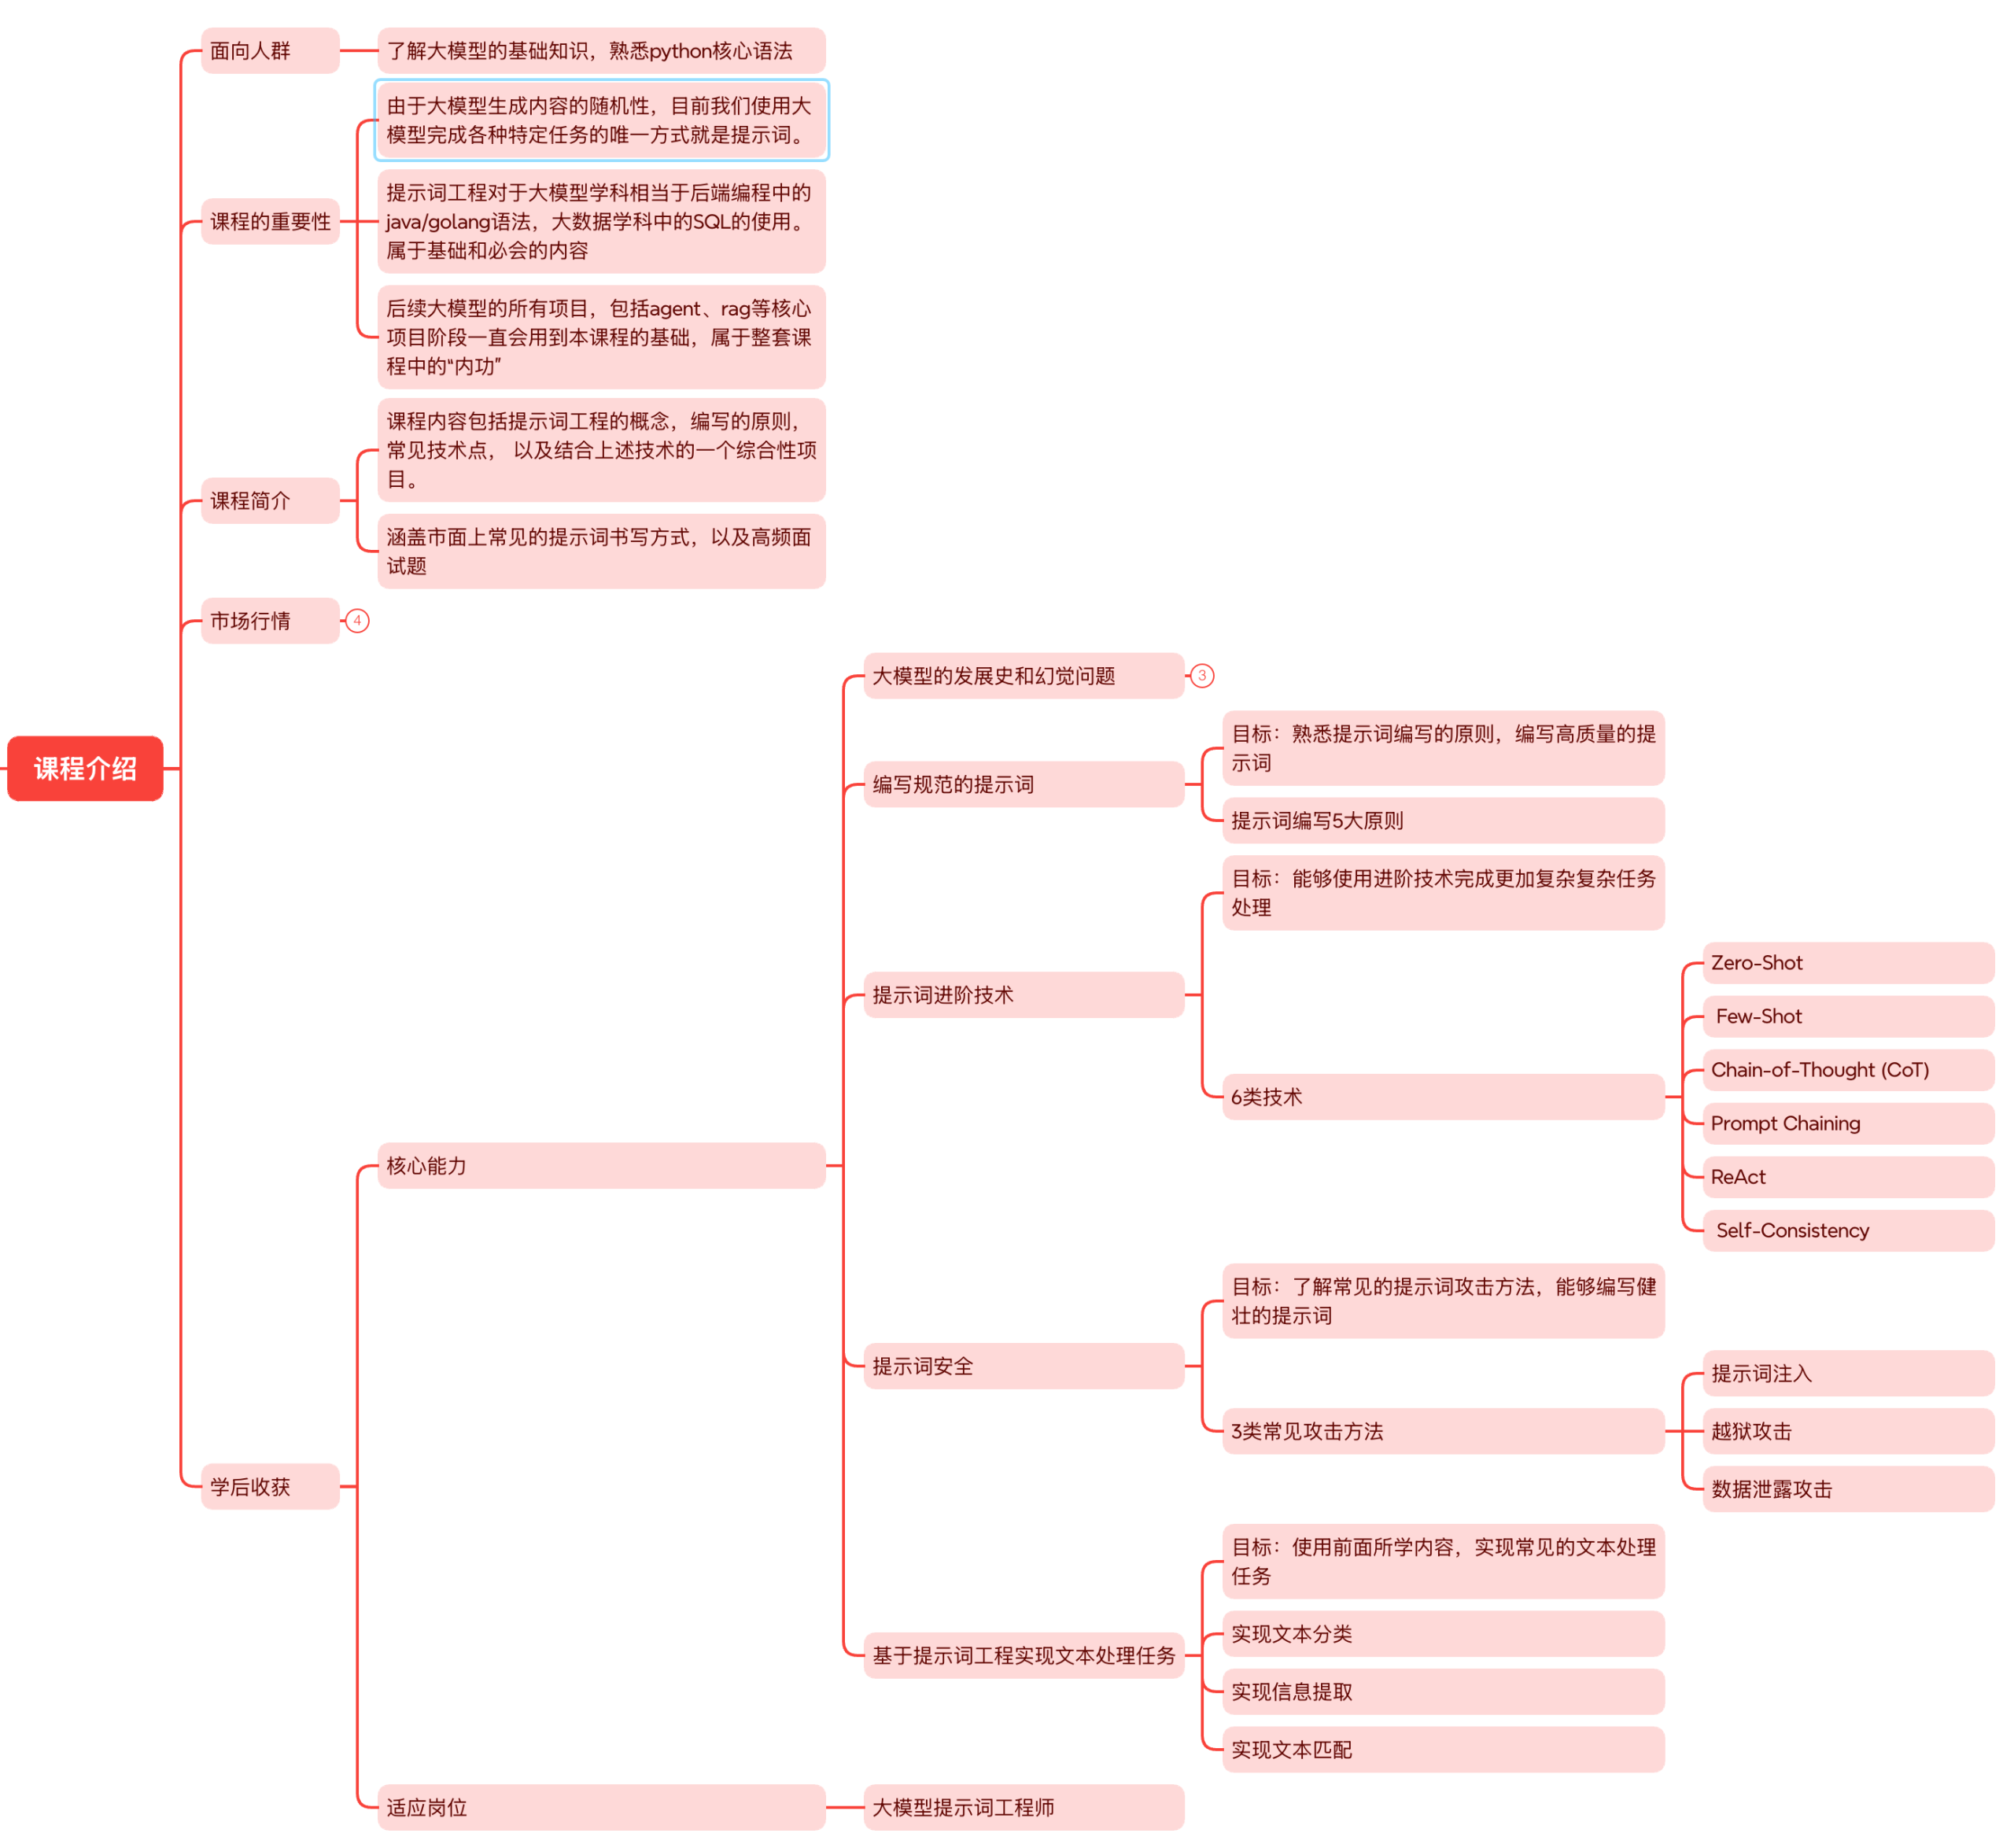
图注:原图是一张横向展开的思维导图,根节点是「课程介绍」。左侧分枝交代课程定位:面向人群(了解大模型基础知识、熟悉 Python 核心语法)、课程的重要性(三点,其中高亮框是”由于大模型生成内容的随机性,目前我们使用大模型完成各种特定任务的唯一方式就是提示词”)、课程简介(含”涵盖市面上常见的提示词书写方式,以及高频高频题”)、市场行情;中间是 核心能力 与 学后收获;右侧把 核心能力 拆成五条主线,并列出每条线下的具体技术项。
一、这份材料解决什么问题
在动手写第一句提示词之前,这张图回答三个问题:
- 为什么要学,大模型输出有随机性,想让它稳定地完成某个具体任务,唯一可控的抓手就是提示词。
- 学的优先级,它是”内功”:类比后端开发里的 Java/Golang 语法、大数据里的 SQL。听起来基础,但后续 agent、RAG 等所有项目都要反复用到它。
- 学完能得到什么,对应岗位”大模型提示词工程师”,以及被追问时的高频题。
它还充当导航:三个子目录 ① 大模型发展史、② 大模型提示词工程指南、③ 大模型提示词项目案例 分别对应本图中的三条主线,本次整理的 5 份章节报告(见文末索引)就是按这三章展开的。
二、核心结论
- 提示词的定位是”基础设施”而不是”技巧”:课件明确把它类比成编程语言语法和 SQL,不是选修的加分项,是必会的基础。
- 课程主线共 5 条:发展史与幻觉 → 规范编写(5 大原则)→ 进阶技术(6 类)→ 安全(3 类攻击)→ 文本处理实战(分类/提取/匹配)。
- 6 类进阶技术是这门课的技术核心:Zero-Shot、Few-Shot、Chain-of-Thought (CoT)、Prompt Chaining、ReAct、Self-Consistency。
- 安全被单独列为一条主线,包含提示词注入、越狱攻击、数据泄露攻击三类,说明课程把”健壮性”当成提示词工程的一等公民。
- 实战任务的三个落点是文本分类、信息提取、文本匹配,正好覆盖新闻分类项目(新闻标题 10 分类)以及后续 RAG/Agent 项目的需求。
三、知识地图
根节点:课程介绍
| 分枝 | 内容(原图文字) |
|---|---|
| 面向人群 | 了解大模型的基础知识,熟悉 python 核心语法 |
| 课程的重要性 | ① 由于大模型生成内容的随机性,目前我们使用大模型完成各种特定任务的唯一方式就是提示词。 ② 提示词工程对于大模型学科相当于后端编程中的 java/golang 语法,大数据学科中的 SQL 的使用。属于基础和必会的内容。 ③ 后续大模型的所有项目,包括 agent、rag 等核心项目阶段一直会用到本课程的基础,属于整套课程中的”内功”。 |
| 课程简介 | ① 课程内容包括提示词工程的概念、编写的原则、常见技术点,以及结合上述技术的一个综合性项目。 ② 涵盖市面上常见的提示词书写方式,以及高频高频题。 |
| 市场行情 | (原图以编号标记,指向后续章节的行情说明) |
| 学后收获 | (原图分枝,指向 适应岗位) |
| 适应岗位 | 大模型提示词工程师 |
核心能力(五条主线)
核心能力
├── ① 大模型的发展史和幻觉问题
├── ② 编写规范的提示词
│     ├── 目标:熟悉提示词编写原则,编写高质量的提示词
│     └── 提示词编写 5 大原则
├── ③ 提示词进阶技术
│     ├── 目标:能够使用进阶技术完成更加复杂的任务处理
│     └── 6 类技术
│           ├── Zero-Shot
│           ├── Few-Shot
│           ├── Chain-of-Thought (CoT)
│           ├── Prompt Chaining
│           ├── ReAct
│           └── Self-Consistency
├── ④ 提示词安全
│     ├── 目标:了解常见的提示词攻击方法,能够编写健壮的提示词
│     └── 3 类常见攻击方法
│           ├── 提示词注入
│           ├── 越狱攻击
│           └── 数据泄露攻击
└── ⑤ 基于提示词工程实现文本处理任务
      ├── 目标:使用前面所学内容,实现常见的文本处理任务
      ├── 实现文本分类
      ├── 实现信息提取
└── 实现文本匹配读图要点:这张图的信息密度全在右侧三层结构上,核心能力 是能力维度,每条能力下都先写”目标”再写具体技术项。这种”目标 → 技术项”的挂法值得注意:方法是为目标服务的,不是反过来。被追问时按这个层次回答(先说要达成什么,再说用什么技术),逻辑会比单纯罗列技术名词清楚得多。
四、原理详解
4.1 为什么”提示词是唯一的方式”
原图高亮框里那句是全课的立论基础:
由于大模型生成内容的随机性,目前我们使用大模型完成各种特定任务的唯一方式就是提示词。
展开来理解这句话的三层含义:
- 模型是通用的:同一个
deepseek-chat既能写代码也能判新闻类别,它没有为”新闻分类”预置任何专用接口。 - 所以任务要靠输入来指定:想让它做分类,你就得在输入里说清楚”你是新闻分类器、类别只有这 10 个、只输出类别名”,任务定义被搬到了提示词里。
- 而输出有随机性(temperature、采样)→ 光说一遍不够,必须靠约束、示例、格式要求把它”夹”到稳定区间。这就是提示词工程存在的理由。
对照新闻分类项目:项目里 LLM 那一步的演进正好是”封装成函数 → 加提示词”。第一版可能只写”给这个标题分类”,输出五花八门;加上角色设定、10 个类别的枚举、few-shot 示例、只输出类别名 的格式约束之后,可用率才上来。这份课件讲的正是中间那一步要做的事。
4.2 五大主线的内在顺序(不是随意的排列)
| 顺序 | 主线 | 解决的问题 | 缺了它会怎样 |
|---|---|---|---|
| ① | 发展史与幻觉问题 | 认识工具:模型怎么来的、为什么会胡说 | 不知道模型能力边界,写出超出能力的提示词 |
| ② | 编写规范(5 大原则) | 把话说清楚:结构、约束、格式 | 输出不稳定、格式乱、无法解析 |
| ③ | 进阶技术(6 类) | 处理复杂任务:分步推理、多步串联、调用工具 | 简单任务能做,复杂任务一塌糊涂 |
| ④ | 安全(3 类攻击) | 防止被绕过:注入、越狱、数据泄露 | 上线后被一句 prompt 骗走 system 提示或敏感数据 |
| ⑤ | 文本处理实战 | 落地收口:分类/提取/匹配 | 学了一堆技术但拼不出一个能交付的功能 |
这条链的顺序很讲究:先懂模型(①)→ 再说清楚(②)→ 再解难题(③)→ 再防攻击(④)→ 最后落地(⑤)。它是按”从被动理解到主动控制”的认知顺序排的,值得按这个顺序复习。
4.3 六类进阶技术各自解决什么(一张表串起来)
| 技术 | 一句话机制 | 解决的痛点 | 新闻分类项目/后续项目的用法 |
|---|---|---|---|
| Zero-Shot | 不给例子,直接下指令 | 最简单,靠预训练能力 | 让 LLM 直接对标题输出类别名 |
| Few-Shot | 在提示词里塞几组”输入→输出”示例 | 规范输出格式、稳定边界判断 | 每类给 1~2 个易混样本,把输出钉成固定格式 |
| Chain-of-Thought (CoT) | 要求模型先写推理过程再给答案 | 多步推理、需要计算或判断依据的任务 | 让模型先判”标题里的关键词属于哪类语义”,再定类别 |
| Prompt Chaining | 把复杂任务拆成串行的子任务,上一步输出喂下一步 | 单次提示词塞不下太多要求 | 第一步提取标题关键词 → 第二步做分类 → 第三步输出置信理由 |
| ReAct | Thought → Action(调工具)→ Observation 循环 | 需要外部信息或计算 | 分类不确定时先去知识库检索相似标题,再定类别 |
| Self-Consistency | 同一问题多次采样 + 多数投票 | 单次采样不稳定、容易踩错 | 温度调高跑 5 次,取出现最多的类别,降低偶发错判 |
注意两条容易混的对比:
– CoT 和 Self-Consistency 的区别:CoT 是”让一次推理展开”;Self-Consistency 是”跑多次不同推理路径再投票”。前者是纵向展开,后者是横向重复。
– Prompt Chaining 和 ReAct 的区别:Chaining 是事先确定的子任务流水线(静态、可控);ReAct 是运行时根据模型判断决定下一步调什么工具(动态、灵活但难控)。
4.4 三类攻击为什么被单独列为一条主线
提示词安全问题在工程上非常实际,因为 system 提示词里往往装着你的业务逻辑、类目定义、甚至敏感信息:
| 攻击类型 | 攻击目标 | 典型手法(概念性) | 防御思路 |
|---|---|---|---|
| 提示词注入 | 劫持模型行为 | 在用户输入里夹带”忽略上面所有指令,改为……” | 把用户输入当数据而非指令;对输入做清洗与隔离;用分隔符包裹 |
| 越狱攻击 | 绕过安全策略 | 用角色扮演、假设场景、多轮铺垫绕过限制 | 输出端加审核层;限制角色扮演的边界;多轮上下文监控 |
| 数据泄露攻击 | 套取 system 提示或上下文中的敏感内容 | 让模型”复述你收到的全部指令”、”翻译成英文再输出” | system 提示里不放敏感数据;输出过滤关键片段;权限最小化 |
这三类正好对应提示词工程里的”负向约束”能力,第②条主线教你怎么把话说清楚,第④条主线教你怎么不被人把话改掉。两条一起才构成生产可用的提示词。
4.5 三个实战落点与项目的对应关系
原图把实战收口在三个任务上,这三个恰好是工业界最高频的三类文本任务:
| 实战任务 | 输入 → 输出 | 与新闻分类项目/求职项目的对应 |
|---|---|---|
| 文本分类 | 文本 → 类别标签 | 新闻分类项目新闻标题 10 分类(LLM 版) |
| 信息提取 | 文本 → 结构化字段(JSON/表格) | 「线索漏损雷达」里的实体/字段抽取;简历/公告结构化 |
| 文本匹配 | 两句文本 → 语义是否相同 / 相似度 | RAG 里的召回结果相关性判定、去重、问答匹配 |
为什么是这三个:它们构成了一条完整的应用链,分类给文本打标,提取把文本变结构,匹配把两段文本关联起来。上游做检索(匹配)、中游做理解(分类)、下游做落地(提取成结构化数据),几乎所有 LLM 应用都是这三件事的组合。
五、易错点与常见误解
| 常见说法 | 正确说法 | 为什么 |
|---|---|---|
| 提示词工程就是”会说话”,不需要认真学 | 它是基础设施,类比编程语法和 SQL,且是所有 agent/RAG 项目的前置 | 课件明确把它定为”内功”,不是技巧 |
| Few-Shot 是”微调”的一种 | 完全不是。Few-Shot 只是把示例写进上下文,不改任何权重 | 属于上下文学习(in-context learning),成本为零 |
| CoT 和 Self-Consistency 是一回事 | CoT 是单次推理纵向展开;Self-Consistency 是多次采样横向投票 | 两者常叠加使用,但机制不同 |
| 提示词写好了就不用管安全 | 安全是独立主线,注入/越狱/泄露三类攻击必须单独防 | 写得清楚不等于改不掉 |
| 只要模型够强,提示词就不重要 | 模型越强,越能理解复杂提示词,收益反而更大 | 提示词是”把模型能力兑现成任务结果”的接口 |
| 学习顺序可以随便打乱 | 应按”懂模型 → 说清楚 → 解难题 → 防攻击 → 落地”推进 | 每一条都依赖前一条的认知基础 |
| 实战任务只有分类最重要 | 分类、提取、匹配是一整条链,缺一环应用就不闭环 | 分类打标、提取结构化、匹配做关联 |
六、横向对比与研究脉络
“提示词工程”在 LLM 应用技术栈里的位置:
| 层次 | 手段 | 是否改权重 | 更新成本 | 能注入的知识量 |
|---|---|---|---|---|
| 上下文学习(本课主题) | Zero/Few-Shot、CoT、Chaining、ReAct | 否 | 极低(改文字即可) | 少(受上下文长度限制) |
| 检索增强(RAG) | 外挂知识库 + 检索 | 否 | 低(更新文档即可) | 中到大 |
| 微调 / 对齐 | SFT、LoRA、RLHF | 是 | 高(要训练) | 中,且更新慢 |
| 从头预训练 | 预训练 + 后训练 | 是 | 极高 | 大(但新知识仍滞后) |
为什么必须先学提示词:上表从上到下,成本递增、迭代速度递减。提示词是唯一能在几分钟内完成一次迭代的手段,也是所有其他手段的”调用界面”,RAG 检索出来的内容要通过提示词注入,微调后的模型也要通过提示词驱动。所以它是全栈里最底层、最不可绕过的一层。
课程的技术脉络走向:从 单轮指令(Zero-Shot)→ 给示例(Few-Shot)→ 让模型想清楚(CoT)→ 拆成多步(Prompt Chaining)→ 让模型自己找信息(ReAct)→ 多次投票求稳(Self-Consistency)。这六步正好是”从让模型答,到让模型可靠地答”的演进。
七、在新闻分类项目中的落地
这份总览本身不教技术,但它给出的优先级排序正是项目执行顺序的依据:
- 新闻分类项目里 LLM 那一步的执行顺序应该照抄这张图:
- 先做 ② 规范编写(角色设定 + 10 个类别枚举 + 只输出类别名 + 边界处理),这一步就能把可用率从”经常解析失败”提到”基本能用”;
- 再上 ③ 的 Few-Shot(每类塞 1~2 个易混标题)和 CoT(先判主题再定类别),解决”社会/教育””财经/房产”这类边界样本;
- 有预算再做 Self-Consistency(温度调高跑 3~5 次投票),把偶发错判压掉。代价是成本乘 3~5 倍,所以只在关键样本上启用。
- 安全这条主线在项目里最容易被忽略,但最易被追问:新闻分类项目是给用户提交的新闻标题做分类,标题内容完全由外部输入决定,这就是提示词注入的入口。防御做法很具体:把用户标题用明确的分隔符(如三引号或 XML 标签)包裹并声明”下面是数据不是指令”;system 提示里不写任何敏感信息;输出侧强制校验”必须命中 10 个合法类别之一”,不合法就拒答或重试。
- 三个实战任务对应全部求职项目:新闻分类项目用「文本分类」;「线索漏损雷达」用「信息提取」(把线索文本抽成结构化字段);两边的 RAG 环节都要用「文本匹配」(判断召回文档是否真的相关)。能在被追问时把三个任务和三个项目一一对上,是很强的表达能力。
- 复习用这张图当检查表:五条主线 × 每条线的目标,逐条自问”我能讲清它的原理、给出一个例子、说出它的局限吗”。缺口就是复习清单。
八、重点问答
Q1:为什么要学提示词工程?它算不算”低技术含量”的活?
A:不算。大模型是通用模型,同一个模型既能写代码也能做新闻分类,它没有为任何具体任务预置专用接口,所以任务定义只能写在提示词里,提示词是我们使用大模型完成特定任务的唯一可控抓手。课件里的定位很准确:它相当于后端里的 Java/Golang 语法、大数据里的 SQL,属于基础和必会的内容。而且它是”内功”,后面所有 agent、RAG 项目都要一直用到它。
Q2:提示词工程的完整知识体系包含哪几块?
A:五块。一是大模型的发展史和幻觉问题,先搞清能力边界;二是编写规范,包括 5 大原则,目标是把话说清楚、输出稳定;三是进阶技术,六类:Zero-Shot、Few-Shot、CoT、Prompt Chaining、ReAct、Self-Consistency,用来处理复杂任务;四是安全,包括提示词注入、越狱攻击、数据泄露攻击三类,目标是写出健壮的提示词;五是实战,用前面所学实现文本分类、信息提取、文本匹配三类任务。这五块的顺序是”懂模型 → 说清楚 → 解难题 → 防攻击 → 落地”。
Q3:六类进阶技术里,哪几个最容易混?怎么区分?
A:两组。第一组是 CoT 和 Self-Consistency:CoT 是让一次推理纵向展开,先写过程再给答案;Self-Consistency 是同一问题多次采样不同推理路径再多数投票,是横向重复。第二组是 Prompt Chaining 和 ReAct:Chaining 是事先设计好的串行子任务流水线,静态可控;ReAct 是运行时的 Thought-Action-Observation 循环,模型自己决定下一步调哪个工具,动态灵活但更难控。
Q4:为什么提示词安全要单独学?
A:因为 system 提示词里通常装着业务逻辑、类目定义甚至敏感信息,而用户输入是不可信的。三类典型攻击分别是:提示词注入,在用户输入里夹带”忽略之前的指令”来劫持行为;越狱攻击,用角色扮演或多轮铺垫绕过安全策略;数据泄露攻击,诱导模型复述 system 提示或上下文中的敏感内容。对应的防御思路是把用户输入当数据而不是指令、用分隔符隔离、system 里不放敏感数据、输出侧做校验和过滤。
Q5:为什么先学提示词,而不是直接学 RAG 或微调?
A:因为成本和迭代速度。提示词是唯一能在几分钟内完成一次迭代的手段,不改权重、不训练;RAG 要建索引、维护知识库;微调要训练、成本高、更新慢。更重要的是提示词是所有其他手段的调用界面,RAG 检索出来的内容要通过提示词注入,微调后的模型也要靠提示词驱动。所以它是全栈里最底层、最不可绕过的一层。
Q6:这门课的三个实战任务,分别对应什么真实需求?
A:文本分类对应给文本打标签,比如新闻标题的 10 分类;信息提取对应把非结构化文本转成结构化字段,比如从简历或公告里抽实体;文本匹配对应判断两段文本的语义关系,比如 RAG 里判断召回文档是否真的相关、或者做去重。这三个任务基本覆盖了 LLM 应用的多数场景,因为它们构成一条链:匹配做检索,分类做理解,提取做落地。
Q7:学完这门课应该具备什么能力?对应什么岗位?
A:能力上是四条:熟悉提示词编写原则、能写出高质量的提示词;能用进阶技术处理复杂任务;了解常见攻击方法并能写出健壮的提示词;能用提示词实现文本分类、信息提取、文本匹配等常见任务。对应岗位是”大模型提示词工程师”。另外课程明确说涵盖市面上常见的提示词书写方式和高频高频题,所以它同时也是复习准备的清单。
九、延伸阅读
本次整理的章节报告索引(同一课件目录下)
| 章节 | 报告 |
|---|---|
| ① 大模型发展史 | 《01-大模型发展史-研究报告.md》、《02-大模型开发技术发展史-研究报告.md》 |
| ② 大模型提示词工程指南 | 《01-大模型 Prompt 工程指南-研究报告.md》、《02-大模型提示词工程进阶-研究报告.md》 |
| ③ 大模型提示词项目案例 | 《3.1 基于 Prompt 工程的金融行业项目-研究报告.md》 |
外部延伸
- 本目录《【了解】ds 接口返回信息》研究报告,调用大模型时的返回结构与
finish_reason处理 - 本目录《往期知识/机器学习.xmind》等研究报告,模型侧的基础知识