把「字符串 → 数字向量」这一步讲透,用 TF-IDF 给「词在当前文档的重要性」打一个可计算的分数,从而让随机森林这类只能做加减乘除和矩阵运算的算法能吃下文本;同时暴露这套稀疏、符号化表示的边界(语义丢失、维度灾难、OOV),为后面 FastText / BERT 的对比埋下伏笔。
一、这份材料解决什么问题
新闻分类项目的技术路线是四模型逐级对比:TF-IDF + 随机森林 → FastText → BERT 微调 → LLM(DeepSeek API 零样本/少样本)。这条路线的第一级台阶不是模型,而是特征:随机森林本身只会做数值比较和数学运算,它看不懂任何汉字。
所以整个项目在真正训练之前,必须先回答一个前置问题:一段中文新闻标题,怎么变成一串数字?课件第 1 页把这件事说得非常直白,所有算法(随机森林、神经网络)的底层都是「加减乘除、矩阵运算、概率计算」,输入必须是数字,字符串没法参与计算。
一个自然的偷懒方案是写规则:
if '机器' or '算法' in 新闻:
    return '科技新闻'
课件明确否定了这条路,并列出三条死因:
- 无法体现不同的词贡献不同,标题里出现「的」和出现「全息屏」,对判断类别的价值天差地别,
in判断一视同仁。 - 无法体现不同上下文中词义不同,同一个词在不同语境下含义会变。
- 无限多的排列组合,关键词表写不完,写出来的也覆盖不住真实语料。
TF-IDF 就是在「规则完全不行」和「上神经网络」之间的那块地基:廉价、可解释、几十行代码能跑,在「标题短、类别固定、关键词信号强」的新闻分类场景里效果不可忽略。它要解决的,就是把「一个词有多重要」变成一个数字。
二、核心结论
- 文本向量化的本质是「给词打分」,不是「给词编号」。One-Hot / 词袋只回答「这个词在不在 / 出现几次」,TF-IDF 进一步回答「这个词有多重要」,分数 = 局部频率 × 全局稀有度。
- TF 和 IDF 是一对「互相纠偏」的视角。TF 只站在当前这一篇内部看(这个词在本文里反复出现 → 大概率是本文的主题);IDF 只站在整个语料库看(这个词在别处到处都是 → 大概率是没有区分度的虚词)。两者相乘,才能把「本文高频」和「全局罕见」两个条件同时满足的词顶上去。
- TF-IDF 高 = 本文件词频高 且 别处罕见。课件第 3 页的四象限是这份材料的核心记忆点:屏幕(TF 高、IDF 高)→ 关键词;的(TF 高、IDF 低)→ 不独特,被压到接近 0;猫(TF 低、IDF 低)→ 无关;耄耋(TF 低、IDF 高)→ 罕见词,单次出现也带分,但因为出现次数少,总贡献有限。
- log 不改变大小关系,只压平变化幅度。IDF 用 log 是为了防止「总文档数 / 出现文档数」这个比值在极端情况下过大或过小;换成一条直线函数也「能跑」,只是效果会变差。这是被追问时最能体现「你懂原理而不是背公式」的一句话。
- TF-IDF 天生是稀疏高维向量,且不携带语义。词表多大,向量就多少维,一条标题只激活其中十几个维度;「爱」和「喜欢」在 TF-IDF 空间里是两个正交维度(余弦相似度为 0),语义相似性必须靠 word2vec / FastText / BERT 那一步才能补上。它同时也是 OOV 的:新词只要不在训练时建好的词表里,就被直接丢掉。
三、知识地图
原文件标题即标注了权重:【理解】,要求「看懂、能对比、能讲清为什么」,而不是「能默写实现」。5 页结构如下:
【理解】TFidf+文本转向量                                          【理解】
├── 1. 计算机程序如何处理文字?(动机)
│   ├── 反例:if '机器' or '算法' in 新闻 → 规则法的三条死因
│   │   ├── 无法体现不同词的贡献不同
│   │   ├── 无法体现不同上下文中词义不同
│   │   └── 无限多的排列组合
│   ├── 根因:随机森林/神经网络底层只有加减乘除、矩阵运算、概率计算 → 输入必须是数字
│   └── 目标:文本 → 向量(爱→[0.7,0.8,0.4,0.9,0.5]、喜欢→[…0.4]、仇恨→[0.1,0.4,0.9,0.2,0.2])
│       └── 三个要求:语义近则向量近 / 能体现词的重要性 / 能处理不同长度的文字
├── 2. TF-IDF 的两个组成部分(各自的目的)
│   ├── IDF:从全部文本统计 → 衡量这个词是不是「的」「和」「你」这种到处都是的虚词
│   └── TF :从当前句子/文档统计 → 计算词在当前句中的频率,高频词通常对本文更有价值
├── 3. 公式与直觉
│   ├── IDF = log(总文档数 / 包含该词的文档数)   ← log 防止太大太小
│   │   ├── 例:100 篇中「的」出现在 80 篇 → log(1.25) = 0.1,分低、独特性低
│   │   └── 例:100 篇中「早茶」出现在 5 篇 → log(20) = 1.3,分高、独特性高
│   ├── TF = 词在当前句中出现的次数 / 当前句总词数
│   │   └── 例:「我 喜欢 你,真的 很 喜欢」总词数 6 → TF(我)=1/6、TF(喜欢)=2/6
│   ├── TF-IDF = IDF × TF
│   └── 四象限(以科技类文档为例)
│       ├── 屏幕:TF 高、IDF 高 → 高   ← 关键词
│       ├── 的  :TF 高、IDF 低 → 低   ← 不独特
│       ├── 猫  :TF 低、IDF 低 → 低   ← 无关
│       └── 耄耋:TF 低、IDF 高 → 低   ← 罕见词
└── 4./5. 两条「取值性质」的辅助材料
    ├── 第 4 页:log 函数简化速记(曲线图 + 「不影响大小对比、只是让变化更平缓、可换成直线函数但效果差」)
    └── 第 5 页:TF-IDF 值函数图像(三维曲面 + 0 < TF < 1、IDF > 0、TF-IDF > 0、同时大最终值才更大)
四、原理详解
4.1 从字符串到数字:为什么必须向量化
把模型想象成一台只会做四则运算和矩阵乘法的计算器。你给它「全息屏」三个字,它连加都加不了;你给它 [0.17, 0, 0, 0.10, …],它立刻能算。
这是「特征工程」在 NLP 里的具体形态。课件把要求写得很清楚,不是随便塞一串数字,而是要满足三个性质:
| 要求 | 含义 | TF-IDF 满足吗 |
|---|---|---|
| 语义相似的词,向量距离近 | 爱 / 喜欢 应该挨着,仇恨 应该远 | 不满足,必须靠词向量 |
| 能体现不同词的重要性 | 「的」应该被压低,「全息屏」应该被抬高 | 这是 TF-IDF 的主业 |
| 能处理不同长度的文字 | 一句话和一段话都能变成同一个空间里的向量 | TF 的分母 + 后期归一化 |
课件第 1 页给的示例向量是 爱 → [0.7, 0.8, 0.4, 0.9, 0.5]、喜欢 → [0.7, 0.8, 0.4, 0.9, 0.4]、仇恨 → [0.1, 0.4, 0.9, 0.2, 0.2]:爱和喜欢只在最后一维差 0.1,仇恨则几乎每一维都对不上,这才是「理想的文本向量」该有的样子(它是词向量的形态)。记住这张图,后面就能一眼看出 TF-IDF 差在哪。
4.2 三种朴素向量化的定位:One-Hot → 词袋 → TF-IDF
在正式进入 TF-IDF 之前,把它的前两代看清,才知道它为什么必须存在。
One-Hot(独热编码):建一个大小为 V 的词表,第 i 个词就是长度为 V、只有第 i 位是 1 的向量。
\text{的} = [1,0,0,0,\dots],\quad \text{屏幕} = [0,1,0,0,\dots]
- 任意两个不同词内积恒为 0(完全正交),「爱」和「喜欢」的距离,和「爱」和「猫」的距离一模一样,语义信息为零;维度 = 词表大小。
- 如果以「文档」为单位做 one-hot,就得到词袋(Bag of Words)。
词袋(BoW,CountVectorizer):每个维度放该词在本文中的原始计数,\text{“屏幕 屏幕 屏幕 的”} \rightarrow [\text{屏幕}:3,\ \text{的}:1,\ \dots]。它立刻暴露两个问题:① 丢语序(「我打你」和「你打我」的词袋完全一样);② 计数不反映重要性(「的」出现 5 次、「全息屏」出现 1 次,计数向量会大声告诉你这篇是「的」的文档)。
TF-IDF:在词袋的骨架上把计数换成「加权后的分数」,保留稀疏结构、只换权重。这就是它们三个属于同一家族的三代、而不是三条平行路线的原因。
4.3 TF:站在「这一篇」内部看
一个词在当前这句话/这篇文档里反复出现,那它大概率就是这篇东西在讲什么。
公式(课件第 3 页的定义,注意分母是当前文档的总词数,不是语料库):
\text{TF}(t, d) = \frac{\text{词 } t \text{ 在文档 } d \text{ 中出现的次数}}{\text{文档 } d \text{ 的总词数}}
课件原例:对 我 喜欢 你,真的 很 喜欢 这句话,总词数 = 6,于是
\text{TF}(\text{我}) = \frac{1}{6} \approx 0.167,\qquad \text{TF}(\text{喜欢}) = \frac{2}{6} \approx 0.333
课件对结论的表述是:「喜欢」的频率越高,出现这个词很可能关于青春小说。
为什么分母要除以总词数:这是这一步唯一的技巧。不除,长文档里每个词的计数都天然更大,一篇 1000 字的文章会在所有维度上碾压一篇 10 字的标题,分类器学到的就是「长度」而不是「内容」。除以总词数后,TF 落在 (0, 1) 区间,这就是第 5 页那张三维曲面图 x 轴取 [0,1] 的原因。
4.4 IDF:站在「整个语料库」上看
如果某个词在几乎所有文档里都出现,那它出现在这里也不代表什么,「的」「和」「你」就是这种词;反过来,如果一个词罕见地只出现在少数几篇里,它一旦出现就是强信号。
公式(课件第 3 页):
\text{IDF}(t) = \log\!\left(\frac{\text{总文档数}}{\text{包含该词的文档数}}\right) = \log\frac{N}{df(t)}
课件明确标注了 log 的用途:「防止太大太小」,N 和 df 的比值在最极端时可以达到几万倍,取 log 后变化被压到可控范围。
课件原例(N = 100):
| 词 | 包含该词的文档数 | 计算 | 结果 | 课件解读 |
|---|---|---|---|---|
| 的 | 80 | \log(100/80) = \log 1.25 | 0.1 | 分低、独特性低,大概率类似「的」「和」「你」 |
| 早茶 | 5(出现在 5 篇广东报纸中) | \log(100/5) = \log 20 | 1.3 | 分高、独特性高,出现这个词很可能关于饮食 |
关于底数的一个细节(值得记住):课件这两个数字 log(1.25)=0.1、log(20)=1.3 对应的是常用对数(以 10 为底):\log_{10}1.25 = 0.0969 \approx 0.1,\log_{10}20 = 1.301 \approx 1.3。而 \ln 20 = 3.0、\log_2 20 = 4.32,都对不上。所以课件的 IDF 数值口径是以 10 为底。
底数重要吗?只在数值刻度上重要,在结论上不重要:任何底数得到的 log 曲线都是单调递增且越走越平缓的,排序结果完全一致。这一点在第 4 页的曲线图里还会有更细的观察。真正需要记住的是 sklearn 用的是自然对数 \ln 且加了平滑(见 4.10),所以自己手算的数字和 sklearn 输出的数字不会一模一样,这是正常的。
4.5 TF-IDF = TF × IDF:四象限 + 完整手算
TF 和 IDF 是一对互相纠偏的过滤器。TF 会错误地抬高虚词,IDF 会错误地抬高罕见词;两者同时高,才说明「这个词本文反复强调,而且别的地方很少见」,这才是关键词。
\text{TF-IDF}(t, d) = \text{TF}(t,d) \times \text{IDF}(t)
课件第 3 页的四象限(以一篇关于计算机的文档为例):
| 词 | TF | IDF | TF-IDF | 课件解释 |
|---|---|---|---|---|
| 屏幕 | 高 | 高 | 高 | 本文出现很多 + 其他文章很少出现 → 关键词 |
| 的 | 高 | 低 | 低 | 本文出现多,所有类别文章也多 → 不独特 |
| 猫 | 低 | 低 | 低 | 本文出现少,其他文章多 → 对科技类不重要 |
| 耄耋 | 低 | 高 | 低 | 本文出现少,其他文章也少 → 罕见词 |
原材料的表格行是「猫」,下面一行的解释文字写成了「美:本文出现少,其他文章多 → 对科技类不重要」。按上下文(都是「本文少、别处多」的低分代表)应为同一个词,这里按「猫」处理。
课件的落地结论是:因此,如果出现「全息屏」,我们就认为这很可能是科技类。
手算小例子:5 篇文档,从头算一遍
下面这个例子沿用课件的口径(以 10 为底、不做平滑),语料是 5 条「标题」(N = 5),已经分好词:
| 编号 | 分词后的文本 | 词数 |
|---|---|---|
| d1 | 全息屏 屏幕 屏幕 屏幕 清晰度 亮度 的 | 7 |
| d2 | 屏幕 的 亮度 很 高 | 5 |
| d3 | 分辨率 高 的 手机 很 清晰 | 6 |
| d4 | 猫 的 猫 很 可爱 | 5 |
| d5 | 耄耋 老人 的 生活 很 悠闲 | 6 |
第 1 步:数 df(每个词出现在几篇文档里),共 16 个不重复的词:
| 词 | df | \text{IDF} = \log_{10}(5/df) | 词 | df | \text{IDF} |
|---|---|---|---|---|---|
| 全息屏 | 1 | 0.699 | 猫 | 1 | 0.699 |
| 清晰度 | 1 | 0.699 | 可爱 | 1 | 0.699 |
| 分辨率 | 1 | 0.699 | 耄耋 | 1 | 0.699 |
| 手机 | 1 | 0.699 | 老人 | 1 | 0.699 |
| 清晰 | 1 | 0.699 | 生活 | 1 | 0.699 |
| 屏幕 | 2 | 0.398 | 悠闲 | 1 | 0.699 |
| 亮度 | 2 | 0.398 | 很 | 4 | 0.097 |
| 高 | 2 | 0.398 | 的 | 5 | 0.000 |
注意最后两行:「的」出现在全部 5 篇里,df = N,于是 \text{IDF} = \log_{10}1 = 0,它在无平滑的 TF-IDF 里权重被彻底清零。这就是 IDF 想干的事。
第 2 步:算 d1 的 TF(分母 = d1 总词数 7)
| 词 | 次数 | TF | IDF | TF-IDF |
|---|---|---|---|---|
| 屏幕 | 3 | 3/7 = 0.429 | 0.398 | 0.171 |
| 全息屏 | 1 | 1/7 = 0.143 | 0.699 | 0.100 |
| 清晰度 | 1 | 1/7 = 0.143 | 0.699 | 0.100 |
| 亮度 | 1 | 1/7 = 0.143 | 0.398 | 0.057 |
| 的 | 1 | 1/7 = 0.143 | 0.000 | 0.000 |
| 猫 / 耄耋 / … | 0 | 0 | 0.699 | 0.000 |
第 3 步:读结果,四个象限全部对上:
- 屏幕(TF↑ IDF↑):出现 3 次、只在这 5 篇里的 2 篇出现 → 0.171,全篇最高,被正确识别为关键词。
- 全息屏、清晰度(TF↓ IDF↑):只出现 1 次,但只此一家 → 0.100,靠 IDF 把分数拉到了和「出现 3 次的屏幕」差不多的量级。这是 TF-IDF 比词袋强的地方:词袋只会给它 1,权重只有屏幕的 1/3。
- 亮度(TF↓ IDF 中):1 次、2 篇出现 → 0.057,中等偏低。
- 的(TF↓ IDF=0):出现 1 次却拿 0 分,彻底出局。
- 猫、耄耋(TF=0):无论 IDF 多高,TF 为 0 就一点分都没有,罕见词「耄耋」的 IDF 0.699 很高,但它不在本文里,贡献是 0。这就是四象限里「耄耋:TF 低、IDF 高 → 低」在真实计算里的样子。
把 d1 的向量写全(未归一化,16 维,按词表顺序):
亮度:0.057  全息屏:0.100  分辨率:0  可爱:0  屏幕:0.171  很:0  悠闲:0  手机:0
清晰:0  清晰度:0.100  猫:0  生活:0  的:0.000  老人:0  耄耋:0  高:0
16 维里只有 4 个非零,稀疏性第一次露头。
4.6 log 的作用:只压平变化,不改变大小关系
课件第 4 页的标题是「关于本项目中 log 函数 简化速记」:
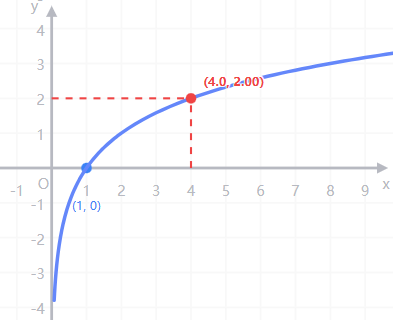
图注:一张对数函数的示意曲线图。y 轴刻度 −4 到 4,x 轴刻度 −1 到 9;只有一条蓝色曲线,它只存在于 x>0 一侧(x \le 0 无定义),从左侧贴近 y 轴处急剧上升,穿过 (1, 0) 之后越走越平缓。图上用两个红点标出了两个关键位置并配了红色虚线辅助线:(1, 0) 和 (4.0, 2.00)。这两点透露了一个细节,x=1 时 y=0 是所有底数的对数都成立的,而「4 对应 2」说明这条曲线画的是以 2 为底的对数(\log_{10}4 \approx 0.602、\ln 4 \approx 1.386 都不是 2)。但底数在这里无关紧要:任何底数的 log 曲线都过 (1,0)、都单调递增、都越来越平缓,只是刻度不同。图要传达的就是这个形状。
课件在图下的那句话是本节的核心,值得逐字记住:
log 不影响 大小对比,只是让变化更平缓,你甚至可以换成 一个简单的直线函数,虽然效果不太行。
把它拆开:
- 「不影响大小对比」,\log 是单调递增函数,a > b \Leftrightarrow \log a > \log b。所以 IDF 的排序和裸比值 N/df 完全一致,取 log 不会改变「哪些词更独特」的结论,只会改变差距的倍数。
- 「只是让变化更平缓」,裸比值下,df=1 和 df=100 的词权重差 100 倍,这会压垮整个向量,让少数罕见词独占全部权重;取 log 后差距被压缩到个位数倍。
- 「甚至可以换成直线函数,虽然效果不太行」,这句话很重要:log 不是魔法,它只是本领域一个方便、平缓的非线性压缩。理解到这一层,你就不会把 log 当成必须背下来的教条。
4.7 TF-IDF 的取值空间:为什么必须「同时大」
课件第 5 页只有一张图和一个四行的结论:
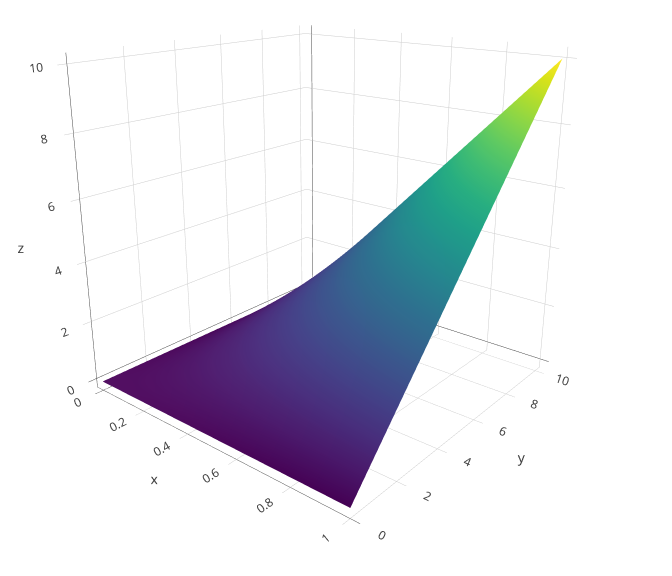
图注:一张 TF-IDF 取值的三维曲面图。x 轴是 TF,刻度约从 0 到 1(标注 0.0、0.2、0.4、0.6、0.8、1);y 轴是 IDF,刻度 0 到 10;z 轴是 TF-IDF 值,刻度 0 到 10。曲面颜色由低处的深紫渐变到高处的青绿、黄绿。形状是一块贴着地板的斜面:x 接近 0 时(TF 很小)无论 y 多大,z 都压在 0 附近;x 和 y 同时增大时曲面才抬起来,最高点出现在 x \approx 1、y = 10 处,z \approx 10。这与 z = \text{TF} \times \text{IDF} 完全一致,任何一个因子接近 0,乘积就接近 0。
课件在图下列出四条性质:
0 < \text{TF} < 1 \qquad \text{IDF} > 0 \qquad \text{TF-IDF} > 0 \qquad \text{同时大,最终值才会更大}
- 0 < \text{TF} < 1 来自 TF 的定义(次数 / 总词数),当词出现 ≥ 1 次时严格落在 0 和 1 之间。
- \text{IDF} > 0:因为 df \le N,所以 N/df \ge 1,log 之后 \ge 0,取不到负数(无平滑时 df = N 恰好等于 0)。
- \text{TF-IDF} > 0(严格说 \ge 0):两个非负数相乘。
- 「同时大」是这张图唯一的结论,也是四象限的几何版本:TF 小(词不在本文里)或 IDF 小(词哪都有),曲面都贴着零。
顺带说一个图上的示意性细节,避免误读:「耄耋」这类词在真实语料里的 IDF 可以远大于 10(N 到 18 万时,\log 的取值空间是很大的)。图上 y 轴画到 10 只是为了把曲面画出来,不是 IDF 的上限。
4.8 归一化:把「长短文」的尺度拉平
课件第 1 页明确要求向量化方案要「能处理不同长度的文字」。TF 的分母解决了一部分(每篇文档的 TF 加起来是 1),但文档之间仍然不可比:一条 6 个词的标题在某个维度上拿到 0.17,一条 30 个词的标题可能在四个维度上都拿到 0.1,两条向量的长度(范数)不一样。
做法:把整条向量按它的 L_2 范数缩放,使每一行成为单位向量:
\hat{x}_i = \frac{x_i}{\sqrt{\sum_j x_j^2}}, \qquad \|\hat{x}\|_2 = 1
接 4.5 的手算例子,对 d1 的未归一化向量做 L_2 归一化:
\|x_{d1}\|_2 = \sqrt{0.100^2 + 0.171^2 + 0.100^2 + 0.057^2} = \sqrt{0.05226} \approx 0.2286
| 词 | 归一化前 | 归一化后 |
|---|---|---|
| 屏幕 | 0.171 | 0.746 |
| 全息屏 | 0.100 | 0.437 |
| 清晰度 | 0.100 | 0.437 |
| 亮度 | 0.057 | 0.249 |
| 的 | 0.000 | 0.000 |
归一化不改变同一篇文档内部的相对大小(都除以同一个数),但让不同长度的文档落到了同一个球面上。它的直接红利是:两个 L_2 归一化向量的内积就等于它们的余弦相似度,这就是 sklearn 文档里对默认参数 norm='l2' 的说明。
顺手验证一下「语义距离」这件事。用同样的方法处理 d2,然后独立地用余弦相似度比较 d1 与 d2:
\cos(d1, d2) = \frac{x_{d1}\cdot x_{d2}}{\|x_{d1}\|\,\|x_{d2}\|} = 0.569
d1(全息屏/屏幕/清晰度)和 d2(屏幕/亮度/高)共享了「屏幕」「亮度」两个词,得到一个中等偏高的 0.569;而 d1 与 d4(猫/可爱)、d5(耄耋/老人/生活)没有任何共同词,相似度必然为 0。这就是 4.1 节里「TF-IDF 不满足语义相似」的具体证据:相似度完全由字面共享词决定,与语义无关。
4.9 停用词:IDF 的「人工加速版」
课件第 2 页把 IDF 的目的说得很直白:
IDF 目的:是从全部文本统计的角度,衡量这个词是不是「的」「和」「你」,这种词每个文章都一大堆的,显然没有太多价值。
也就是说,IDF 本来就是用来自动发现停用词的。那为什么项目里还要额外准备一份 749 个停用词的表?因为自动发现不够干净、不够彻底:
- IDF 只能压低,不能删除。上一节手算里「的」拿到 0 是因为用了无平滑的公式;sklearn 默认加了 +1 平滑(见 4.10),「的」的 IDF 会变成 1.0 而不是 0,它在向量里仍然占着一个维度、贡献着权重。停用词表能把它直接删掉(
stop_words参数),词表变小、矩阵变稀、噪声特征消失。 - 自动统计在语料不足或领域不均衡时会漏。749 词这种人工词表能一次把语气词、代词、连词、标点残留等一批处理掉,而且在训练集/测试集上口径完全一致。
- 中文还有额外一层:分词之后会出现大量单字虚词(的、了、是、在),这些在英文里天然不会作为一个词出现,中文必须显式处理。
实践口径:分词阶段先用一个集合过掉停用词,再把同一份词表传给 TfidfVectorizer(stop_words=...) 作第二道保险。
4.10 sklearn 实战:TfidfVectorizer 的用法与三个必须知道的坑
4.10.1 最小可用代码
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.ensemble import RandomForestClassifier

STOP = {w.strip() for w in open("stopwords_749.txt", encoding="utf-8") if w.strip()}

def cut(title: str) -> str:                      # 1) 中文先分词 + 过停用词
    return " ".join(w for w in jieba.cut(title) if w.strip() and w not in STOP)

vectorizer = TfidfVectorizer(
    token_pattern=r"(?u)\S+",   # 2) 已用空格分开,必须改(见 4.10.3 坑一)
    stop_words=list(STOP),      # 第二道保险
    min_df=2,                   # 丢弃只出现 1 次的词,压小词表
    max_features=50000,         # 词表上限
)

X_train = vectorizer.fit_transform([cut(t) for t in train_titles])  # 3) 建词表 + 算 idf_
X_test  = vectorizer.transform([cut(t) for t in test_titles])       # 只复用训练集的词表

clf = RandomForestClassifier(n_estimators=200, n_jobs=-1)           # 4) 稀疏矩阵直接喂树模型
clf.fit(X_train, y_train)
4.10.2 fit_transform 与 transform 的区别(考查高频)
| 方法 | 做什么 | 用在哪 |
|---|---|---|
fit(X) |
扫一遍语料,建词表(vocabulary_)并算出每个词的 idf_ |
只在训练集上做一次 |
transform(X) |
用已有的词表和 idf_ 把文档映射成向量 |
训练集、验证集、测试集、线上推理 |
fit_transform(X) |
fit + transform,一步到位 |
仅训练集 |
- 在测试集上误用
fit_transform会犯两个错:①列对不上(测试集的词表不同,向量长度可能都不一样);②数据泄漏,idf_被测试数据的分布污染了,报告出来的指标不可信。 transform是新词黑洞:词表外的词(OOV)在transform时被静默丢弃,不报错。如果一条文本的所有词都是生词,你会得到一个全 0 向量(nnz=0),sklearn 不会拦你。fit时如果所有内容都被stop_words过滤掉了,会直接抛ValueError: empty vocabulary; perhaps the documents only contain stop words,这是自己调试停用词表时最容易撞到的报错。
4.10.3 坑一:默认 token_pattern 会吃掉中文
TfidfVectorizer 的默认分词正则是 (?u)\b\w\w+\b,它要求 token 至少两个字符。对中文来说这有两个后果:
- 中文没有空格,一整句话会被当成一个 token;
- 即使你已经用 jieba 分好了词,所有单字(我、你、的、猫、高)都会被直接丢掉。
实测(同一份输入):
输入(未分词): "我喜欢你,真的喜欢你也喜欢我好不好"
默认词表结果  : {'我喜欢你': …, '真的喜欢你也喜欢我好不好': …}   ← 整句成了一个词

输入(已分词): "我 喜欢 你 真的 喜欢 你 也 喜欢 我 好 不 好"
默认词表结果  : {'喜欢', '真的', '也'}                          ← 单字全被丢掉了
改用 (?u)\S+  : {'我','喜欢','你','真的','也','好','不', …}     ← 单字全部保留
所以中文场景的标配是:先 jieba 分词 → 空格拼接 → token_pattern=r"(?u)\S+"。
4.10.4 坑二:sklearn 的 IDF 和你手算的不一样(这是正常的)
TfidfTransformer 的文档写得很清楚,sklearn 默认 smooth_idf=True,IDF 公式是
\text{idf}(t) = \ln\frac{1 + n}{1 + df(t)} + 1
和课件的 \log(N/df) 有三处差别:自然对数 \ln(不是 \log_{10})、分子分母各 +1(相当于假设多了一篇包含所有词的文章,避免分母为 0)、最后 +1(保证在全部文档里都出现的词 idf 不为 0,不会被完全压制)。
用同一个语料实测(TfidfVectorizer,sklearn 1.9):
| 词 | df | sklearn idf_ |
\ln\frac{1+5}{1+df}+1 |
|---|---|---|---|
| 的 | 5 | 1.0000 | \ln(6/6)+1 = 1 |
| 很 | 4 | 1.1823 | \ln(6/5)+1 |
| 屏幕 / 亮度 / 高 | 2 | 1.6931 | \ln(6/3)+1 |
| 全息屏 / 耄耋 / 猫 / … | 1 | 2.0986 | \ln(6/2)+1 |
对照手算结果可以看得很清楚:
| 词 | 手算 IDF(\log_{10},无平滑) | 手算 TF-IDF(未归一化) | 手算 + L_2 归一化 | sklearn IDF | sklearn TF-IDF |
|---|---|---|---|---|---|
| 屏幕 | 0.398 | 0.171 | 0.746 | 1.693 | 0.819 |
| 全息屏 | 0.699 | 0.100 | 0.437 | 2.099 | 0.338 |
| 清晰度 | 0.699 | 0.100 | 0.437 | 2.099 | 0.338 |
| 亮度 | 0.398 | 0.057 | 0.249 | 1.693 | 0.273 |
| 的 | 0.000 | 0.000 | 0.000 | 1.000 | 0.161 |
两列结论一致(屏幕最高、的 最低),但数值不同,原因有三层:
① 底数不同(\ln vs \log_{10}),整体放大,不改排序;
② sklearn 的 TF 默认用原始计数(sublinear_tf=False,tf 就是词频计数 3),不做「次数/总词数」这个除法,它把长度归一化推迟到最后用 L_2 范数完成;0 < \text{TF} < 1 是课件的定义,不是 sklearn 的默认行为;
③ sklearn 输出的是 L_2 归一化之后的结果(默认 norm='l2'),而手算那一列没有归一化。
「的」的对比最值得记住:无平滑手算时它是 0(被彻底清零),而 sklearn 因为 +1 平滑给了它 1.0,L_2 归一化后仍占 0.161。这就是为什么在 sklearn 里更需要显式的 stop_words,IDF 自动降权在这一步是不够彻底的。
4.10.5 坑三:稀疏矩阵不是「格式问题」,是「内存问题」
fit_transform 返回的不是 numpy.ndarray,而是 scipy.sparse 的 csr_matrix。实测同一语料:
type: <class 'scipy.sparse._csr.csr_matrix'>   shape: (5, 16)   nnz: 26
密度: 32.5%
5 篇文档 × 16 维词表,156 个格子里只有 26 个非零。文档越短、词表越大,密度越低。量级估算:18 万条标题、平均每条 12 个词,如果词表是 5 万维,那么单条向量的非零项占比只有 0.024%;按稠密矩阵存这批数据(18 万 × 5 万 × 8 字节)约 67 GB,稀疏存储是唯一可行的选择,不是可选优化。
配套 API:
X.shape          # (n_docs, n_features)
X.nnz            # 非零元素总数
X[0].toarray()   # 把某一行转成稠密数组(调试用,别整矩阵转)
vectorizer.get_feature_names_out()   # 第 i 列对应哪个词
维度灾难也来自这里:词表维度 V 随语料增长而增长,而单条文本只激活十几个维度。向量空间中「几乎所有点都互相远离」,距离度量变得不可靠,这就是后面的 FastText(低维稠密)和 BERT(768 维上下文向量)要解决的问题。
五、易错点与常见误解
常见说法:「TF-IDF 就是统计词频。」
实际上,TF-IDF = TF(局部频率) × IDF(全局稀有度),两个因子缺一不可。
为什么:只看频率就是词袋,会把「的」顶到最高;只看 IDF 会把只出现过一次的错别字顶到最高。相乘之后,只有「本文高频 + 全局罕见」才拿高分(4.5 节的四象限)。
有人以为「IDF 里的 log 是为了让分数更大 / 是某种魔法。」
其实 log 只做单调压缩:不改变词的排序,只把极端比值(几万倍)压到可控范围,让变化更平缓。
原因在于,\log 单调递增,a>b \Leftrightarrow \log a > \log b。课件甚至明说「可以换成直线函数,虽然效果不太行」,它的作用是压幅度,不是制造区分度。
常听到的一种说法是:「IDF = log(N/df) 是唯一正确的公式。」
真实情况是,这是教科书定义。sklearn 默认是 \ln\frac{1+n}{1+df}+1,多了平滑和 +1。
背后的道理是,+1 的目标是两件事,分母不为 0,以及「在全部文档里都出现的词」不被完全清零。理解差别才能解释「为什么我手算和 sklearn 输出对不上」。
容易想岔的地方:「sklearn 的 TfidfVectorizer 输出的 TF 也在 0 到 1 之间。」
事实正相反,sklearn 默认 tf 是原始计数(sublinear_tf=False),不做「次数/总词数」这一步;它靠最后的 L_2 归一化把尺度拉回来。
之所以如此,实测中「屏幕」的 tf 是 3,乘 idf 1.693 得 5.079,归一化后才变成 0.819。0 < TF < 1 是课件的定义,不是 sklearn 的默认行为。
先说一个误解:「TF-IDF 能把语义相近的词映射到相近的向量。」
实际上,完全不能。TF-IDF 是符号化(lexical)表示:语义相似度 = 字面共享词的多少,「爱」和「喜欢」如果不同时出现在同一篇文档里,它们的余弦相似度就是 0。
为什么:课件第 1 页画的 爱 → [0.7,0.8,0.4,0.9,0.5]、喜欢 → [0.7,0.8,0.4,0.9,0.4](两个词几乎重合)是词向量的理想形态,不是 TF-IDF 能达到的效果。要拿到那个性质,必须换词向量。这是整份材料最容易被误读的地方。
常见说法:「停用词表是多余的,IDF 会自动把虚词降下去。」
其实 IDF 只能压低,不能删除;而且 sklearn 的 +1 平滑让「的」保住了 idf = 1.0。
原因在于,实测「的」在无平滑公式里是 0,在 sklearn 里归一化后仍占 0.161 的权重。749 词表是为了直接删维度,词表更小、矩阵更稀疏、训练更快,且避免噪声特征进入随机森林的候选切分点。
有人以为「中文直接用 TfidfVectorizer 就行。」
真实情况是,必须先分词并改 token_pattern,否则默认正则 (?u)\b\w\w+\b(要求 ≥ 2 字符)会把整句话当成一个词,同时丢掉所有单字。
背后的道理是,实测「我喜欢你,真的喜欢你也喜欢我好不好」在默认配置下只产出 {'我喜欢你', '真的喜欢你也喜欢我好不好'} 两个「词」。
常听到的一种说法是:「测试集上再 fit_transform 一次比较保险。」
事实正相反,测试集必须用训练集 fit 出来的 vectorizer 去做 transform。
之所以如此,fit_transform 会重建词表(列对不上)并重新估计 idf_,等于让测试数据参与训练,属于数据泄漏,指标会虚高。
容易想岔的地方:「新词进来了模型也能处理。」
实际上,词表外的新词(OOV)在 transform 时被静默丢弃;极端情况下整条文本都是生词,会得到全 0 向量且不报错。
为什么:TF-IDF 的词表是训练时冻结的,没有任何泛化到未登录词的能力。要处理 OOV 得靠 FastText 的 subword n-gram 或 BERT 的 subword tokenizer。
先说一个误解:「TF-IDF 丢语序,所以它一无是处。」
其实在「标题短、类别靠关键词决定」的新闻分类里,语序的边际信息量很小,而它便宜、可解释、可复用的优势是真实的。
原因在于,课件第 1 页只是指出语序/上下文有信息量,并不等于这份材料没用,说清它在什么条件下够用,比背它的缺点更重要。
六、横向对比与研究脉络
6.1 五种文本表示方案对比
| 维度 | One-Hot | 词袋(BoW / CountVectorizer) |
TF-IDF | word2vec / FastText | BERT 类上下文向量 |
|---|---|---|---|---|---|
| 表示单位 | 词 | 文档 | 文档 | 词(可平均成文档/句) | 词/句(随上下文变) |
| 向量维度 | 词表大小 V | 词表大小 V | 词表大小 V | 固定低维(常 100~300) | 固定(如 768) |
| 稠密/稀疏 | 极稀疏(1 个非零) | 稀疏 | 稀疏 | 稠密 | 稠密 |
| 能体现词的重要性 | 所有词等价 | 只体现次数 | TF × IDF 加权 | 语义权重隐含在向量里 | 隐含 |
| 语义相似性 | 任意两词正交 | 同左 | 同左 | 「爱/喜欢」距离近 | 且区分多义词 |
| 语序 / 上下文 | 否 | 否 | 否 | (词级别无上下文) | 是 |
| OOV 处理 | 无 | 无 | 无(新词直接丢弃) | 部分(subword n-gram) | 子词切分 |
| 训练成本 | 无 | 无(只需统计) | 无(只需统计) | 中(需在语料上训练) | 高(预训练 + 微调) |
| 可解释性 | 高 | 高 | 高(可直接看权重最高的词) | 低 | 极低 |
| 适用场景 | 教学 / 类别极少 | 快速基线 | 短文本分类基线、关键词抽取、检索 | 需要语义泛化的中量级任务 | 追求精度上限 |
一句话总结这张表:从 One-Hot 到 BERT,本质是在用「更高的计算成本和更低的可解释性」去换「语义信息」。TF-IDF 站在最便宜、最可解释、也最没有语义的那一端。
6.2 演进脉络:谁解决了谁的什么问题
规则关键词(if '机器' in 新闻)
  └─ 问题:贡献不分权重、上下文无关、组合爆炸            ← 课件第 1 页三条死因
     ↓
One-Hot(词 → 只有一位为 1 的长向量)
  └─ 让计算机「能算」了;但任意两词正交,维度 = 词表大小
     ↓
词袋 BoW(文档 = 词频计数向量)
  └─ 把「文档」塞进向量,能算相似度、能喂分类器
     问题:高频虚词支配一切,长文档天然占优
     ↓
TF-IDF(计数 → TF × IDF 加权)
  └─ 解决:把「每个词有多重要」编码进权重
     ├─ TF 除以总词数 → 缓解文档长度影响
     ├─ IDF = log(N/df) → 压低到处都有的虚词
     └─ + L2 归一化 → 让不同长度的文档落在同一尺度上
     遗留:稀疏高维、无任何语义(爱⊥喜欢)、丢语序、OOV 无法处理
     ↓
word2vec(Mikolov 等,2013:CBOW / Skip-gram)
  └─ 解决:用上下文训练出稠密低维向量,语义相近的词自动靠近
     遗留:一个词只有一个向量(多义词不分)、OOV 未处理
     ↓
FastText(Joulin 等,Efficient Text Classification)
  └─ 解决:① subword n-gram → 缓解 OOV ② 词向量平均 + 线性分类器,速度极快
     遗留:词向量仍是静态的,深层语义与语序拿不到
     ↓
BERT 类预训练模型(上下文相关表示 + 微调)
  └─ 解决:同一个词在不同句子里得到不同向量,真正吃进语序与长距离依赖
     遗留:成本高、需要 GPU、推理慢、可解释性差
     ↓
LLM(DeepSeek API 零样本/少样本分类)
     └─ 不训练也能分类,适合做精度上限对照
这条脉络正好就是新闻分类项目四级模型的顺序:TF-IDF + 随机森林(跑通流程、拿到基线)→ FastText(补 OOV、大幅提速)→ BERT 微调(精度上限)→ LLM(零样本对照),最后再用模型压缩把参数量/体积压下来。TF-IDF 那一级不是「随便试一下」,它是整条对比曲线的锚点,没有它,后面三个模型的收益就无从比较。
七、在新闻分类项目中的落地
7.1 它在流水线的哪一步
TF-IDF 是整条路线的第一个可交付基线,落在「数据 → 特征 → 模型 → 评估」这条链的特征环节:
标题\t标签(训练 18w / 验证 1w / 测试 1w)
   ↓ 1. 读取、切分标题与标签
   ↓ 2. jieba 分词 + 749 停用词过滤        ← 4.9 节
   ↓ 3. TfidfVectorizer.fit_transform → csr 稀疏矩阵   ← 本材料
   ↓ 4. RandomForestClassifier 训练 + 验证集调参
   ↓ 5. 测试集评估(混淆矩阵 / 精确率 / 召回率 / F1)
   ↓ 6. 把这组指标作为后三级的对照基线
训练集才 fit_transform,验证/测试集只 transform,而且线上的 Flask 服务必须复用同一个 vectorizer(通常和模型一起 pickle 保存),否则列空间对不上,预测会静默出错。
7.2 关键参数怎么调
| 参数 | 建议 | 理由 |
|---|---|---|
token_pattern |
r"(?u)\S+" |
中文必须改,否则整句成一个 token 且单字被丢(实测见 4.10.3) |
stop_words |
项目自带的 749 词表 | +1 平滑让「的」idf=1.0 保住了权重,必须显式删除 |
min_df |
2 或 3 | 出现 1 次的词几乎没有泛化价值,清掉能显著缩小词表 |
max_features |
几万量级 | 控制维度上限,直接决定随机森林的训练时间和内存 |
ngram_range |
先 (1,1),再试 (1,2) |
二元组能捕捉「全息 屏」这类局部搭配,但维度会翻倍 |
sublinear_tf |
试 True |
用 1+\log(tf) 替代原始计数,抑制单词在标题里重复刷分 |
norm |
保持默认 l2 |
让内积即余弦相似度,抵消标题长度差异 |
RandomForestClassifier |
n_estimators 从 200 起,配 n_jobs=-1 |
高维稀疏特征下树模型容易过拟合,逐步加 max_depth 限制 |
7.3 实际坑在哪
- 分词一致性是最大的隐性坑。训练时用什么分词器、什么停用词表、什么 jieba 版本,线上必须完全一致;换了词表,向量空间就悄悄错位,指标莫名掉且不报错。
- 稀疏矩阵 + 树模型的效率问题。随机森林能吃 csr,但高维稀疏会让候选切分点变多、训练变慢。用
min_df/max_features先压维度,比调树参数见效快。 - OOV 静默丢词。训练词表外的词被直接丢掉;标题只有十几个词,丢两三个影响不小,这也是后面切到 FastText 的具体动机之一。
transform返回全 0 向量不报错。全生词的标题会让模型拿到零向量,输出一个「看起来很合理」但毫无依据的类别。工程上应加一条「非零维度 = 0 则走兜底」的检查。- 别整矩阵
toarray()。18 万 × 几万维转稠密会直接爆内存(4.10.5 估算:几十 GB 量级)。
7.4 和项目里其它方案怎么配合
| 阶段 | 模型 | TF-IDF 在这里的角色 |
|---|---|---|
| 第 1 级 | TF-IDF + 随机森林 | 主角:跑通全流程、产出第一个基线准确率 |
| 第 2 级 | FastText | 对照组:证明「加语义 + 加 subword」比纯词表统计强多少;且训练/推理快到能反衬 BERT 的代价 |
| 第 3 级 | BERT 微调 | 精度上限:TF-IDF 的准确率是它「值得多花几天 GPU」的论据 |
| 第 4 级 | LLM(DeepSeek API) | 零样本/少样本对照:说明「不训练能做到什么程度」以及 API 成本 |
| 收尾 | 模型压缩(量化/蒸馏/剪枝/低秩) | TF-IDF 的可解释性也是卖点:能直接看「哪些词把这条标题推到科技类」,这在蒸馏时可以作为「教师解释性」的参照 |
这一节最有价值的表述是:TF-IDF 那一级不是凑数的,它定义了后面三个模型「改进量」的坐标系,没有基线,就没有对比。
八、重点问答
Q1:为什么文本一定要先转成向量?
A:一句话,因为所有算法底层只会做数学运算。随机森林、神经网络这些模型的内部全是加减乘除、矩阵乘法和概率计算,输入必须是数字,字符串根本没法参与运算。所以文本向量化不是「可选的预处理」,而是「模型能不能跑起来」的前提。至于怎么转,最省事的做法是写关键词规则,比如 if '机器' in 新闻,但这有三条死路:体现不出不同词的贡献不同、体现不出不同上下文里词义不同、关键字的排列组合是无限的。TF-IDF 就是在这三条死路和上神经网络之间那块地基:便宜、可解释、几十行能跑。
Q2:TF-IDF 里的 TF 和 IDF 分别在解决什么问题?
A:它们是两个互相纠偏的视角,一个看局部、一个看全局。TF 是站在当前这一篇文档内部看,词在本文里出现得越多,越可能是本文的主题,所以它天然会抬高「的」这种虚词。IDF 是站在整个语料库看,一个词如果哪篇文章都有,它就没有区分度,所以 IDF 会把「的」压下去。两个分数相乘,只有「本文高频 + 全局罕见」的词才能拿高分,这样就把虚词和无关词同时过滤掉了。
Q3:IDF 公式里的 log 起什么作用?去掉行不行?
A:log 只做单调压缩,不影响词的排序,只把差距从「倍数级」压到可控范围。因为 log 是单调递增的,谁大谁小完全不变,所以取 log 不改变「哪些词更独特」的结论。它的真正作用是防止「总文档数 / 出现文档数」这个比值太离谱,一百篇语料里,只出现一次的词的比值是 100,到处都出现的词是 1,差一百倍,不压的话整个向量会被少数罕见词独占。我们课件里说得很直接:log 不影响大小对比,只是让变化更平缓,你甚至可以换成一个直线函数,虽然效果不太行。
Q4:请手算一下「我 喜欢 你,真的 很 喜欢」里「喜欢」的 TF。
A:先数总词数,这句话分词后有 6 个词:我、喜欢、你、真的、很、喜欢。「喜欢」出现了 2 次,所以 TF 就是 2/6,约等于 0.333;「我」出现 1 次,TF 是 1/6,约等于 0.167。分母用总词数而不是原始次数,是为了让不同长度的文档可比,不然一篇一千字的文章在每个维度上都会碾压一条短标题,模型学到的就是长度而不是内容。TF 落在 0 到 1 之间,这也是课件里写 0 < TF < 1 的原因。
Q5:什么样的词 TF-IDF 会很高?请举一个四象限的例子。
A:是「本文里反复出现,但在别的地方很少见」的词。课件里用一篇科技类文档举了四种情况:屏幕是 TF 高、IDF 高,本文出现很多、别的文章很少出现,所以是关键词;的是 TF 高、IDF 低,本文出现多、所有类别文章也多,所以不独特;猫是 TF 低、IDF 低,本文出现少、其他文章多,对科技类不重要;耄耋是 TF 低、IDF 高,本文出现少、其他文章也少,它是罕见词但贡献有限。所以课件最后说:只要出现「全息屏」,我们就认为这很可能是科技类。
Q6:fit_transform 和 transform 有什么区别?为什么测试集不能再用 fit_transform?
A:fit 是扫一遍语料、建词表、算每个词的 idf;transform 是拿已经建好的词表和 idf,把文档映射成向量;fit_transform 就是两步一起做,只能用在训练集。测试集再用 fit_transform 会犯两个错:一是列空间变了,测试集的词表和训练集不一样,向量长度、每一列的含义都可能对不上;二是数据泄漏,idf 被测试数据的分布影响了,跑出来的指标会虚高。正确做法是训练集 fit_transform,验证集、测试集和线上服务一律 transform,并且复用同一个 vectorizer。
Q7:TF-IDF 有什么局限?
A:主要四条。第一,它完全没有语义,纯粹看字面共享了多少词,「爱」和「喜欢」在 TF-IDF 空间里是两个正交的维度,余弦相似度是 0,必须要靠 word2vec、FastText 或者 BERT 才能把语义补上。第二,它是稀疏高维的,词表多大向量就多少维,一条标题只激活十几个维度,维度灾难就来自这里。第三,它丢语序,「我打你」和「你打我」的向量一样。第四,词表在训练时就冻结了,OOV 的词在 transform 时会被静默丢掉,极端情况下整条文本都是生词,就得到一个全零向量,而且 sklearn 不会报错。
Q8:项目里为什么要额外准备 749 个停用词?用 sklearn 做中文 TF-IDF 的第一个坑是什么?
A:因为 IDF 只能压低权重、不能删除维度,而且 sklearn 默认带平滑。我实测过:无平滑公式里「的」的 IDF 正好是 0,被彻底清零;但 sklearn 默认 smooth_idf=True,「的」会拿到 1.0,归一化后仍占 0.161 的权重,还占着一个维度,所以要给一份 749 词的停用词表把它直接删掉。第二个必踩的坑是 token_pattern 的默认值 (?u)\b\w\w+\b,它要求 token 至少两个字符:中文没空格,整句话会被当成一个词;即使已经 jieba 分好词,所有单字,我、你、的、猫,也会被丢掉。实测未分词时「我喜欢你,真的喜欢你也喜欢我好不好」只产出两个特征。正确做法是 jieba 分词后用空格拼回去,再配 token_pattern=r"(?u)\S+"。
九、延伸阅读
官方文档 / 工具
– scikit-learn TfidfVectorizer API 文档:https://scikit-learn.org/stable/modules/generated/sklearn.feature_extraction.text.TfidfVectorizer.html (重点看 smooth_idf、sublinear_tf、norm、token_pattern 四个参数的说明)
– scikit-learn 用户指南「Feature extraction → Text feature extraction」:https://scikit-learn.org/stable/modules/feature_extraction.html#text-feature-extraction (tf-idf 项里给出了标准公式与 sklearn 平滑公式的对比)
– TfidfTransformer 文档字符串(help(TfidfTransformer)):sklearn 把「教科书定义」与「本库定义」的差别写在文档里,是最权威的一手依据
– scipy.sparse 文档(csr_matrix):https://docs.scipy.org/doc/scipy/reference/sparse.html
– jieba 分词:https://github.com/fxsjy/jieba
– 中文停用词表(多份常用表可对照):https://github.com/goto456/stopwords
论文(已核对存在)
– Mikolov, Chen, Corrado, Dean. Efficient Estimation of Word Representations in Vector Space, 2013,CBOW 与 Skip-gram,word2vec 的原始来源:https://arxiv.org/abs/1301.3781
– Joulin, Grave, Bojanowski, Mikolov. Bag of Tricks for Efficient Text Classification,fastText 用于文本分类的原始论文,明确对比了 TF-IDF 基线:https://arxiv.org/abs/1607.01759
同项目内可对照的材料
– 3.1随机森林模型/【理解】机器学习快速回顾.pptx(随机森林为什么需要数值特征、如何做切分)
– 3.1随机森林模型/【理解】混淆矩阵模型指标.pptx(拿到 TF-IDF + 随机森林的结果后怎么评估)
– 3.2Fasttext/(补语义、补 OOV 的下一级)