讲清楚”模型训完之后”那段最容易在被追问时露怯的工程路,保存成什么格式、怎么用 ONNX 走到目标平台、怎么用 Flask + 客户端把它变成可被调用的服务,以及换格式 + 降精度究竟能换回多少延迟。
一、这份材料解决什么问题
绝大多数课程教到 model.eval() 就结束了,好像模型一训完就自动”上线”了。这份材料补的是中间那段空档:
- 环境不是同一个环境。实验室里是 Windows + conda 虚拟环境 + Python + PyTorch,可以随便改结构、打断点、动 batch;部署环境可能是 Linux 服务器、手机、摄像头、无人机、边缘计算盒子,往往要求 C++ 实现、固定输入尺寸、INT8/FP16 精度,还要处理多线程、负载均衡、异步推理。
- 模型不是同一个文件。
model.pt、model.pkl、model.safetensor、model.ckpt是四种不同的”保存哲学”;跨平台还要先转成通用中介model.onnx,再转成特定平台的model.engine(TensorRT)、ncnn 等格式。 - 调用不是一次函数调用。真实场景里模型是要被”服务化”的:一个服务端进程持有模型、暴露 HTTP 接口,客户端(Web、手机 App)发请求拿结果。
它在新闻分类流水线里的位置很明确:四个模型(TF-IDF+随机森林 / FastText / BERT / LLM)训完、压缩(量化、蒸馏、剪枝)做完之后,最后一步就是把它包成一个 Flask 服务 + Streamlit 客户端给别人演示。这份材料就是那一步的方法论。
二、核心结论
- 训练环境和部署环境优化的是两个不同的目标:前者优化”迭代速度”(收敛快、改得动),后者优化”单次延迟、吞吐、稳定性、资源占用”。同一份代码不可能同时最优。
- 部署产物与硬件强绑定、天然不通用:同一个模型部署给手机和无人机,是两份互不兼容的工程(算子、精度、内存布局、工具链全不一样)。
- 默认只存
state_dict,不要 pickle 整个模型:state_dict是纯参数字典,可移植、可审计;整模型 pickle 依赖类定义和代码路径,跨环境加载极易失败。 - 跨框架/跨平台的第一站是 ONNX:ONNX 把”训练框架”和”部署目标(CPU/GPU/FPGA/NPU)”解耦成多对多关系,再由各平台的运行时(ONNX Runtime / TensorRT / OpenVINO / ncnn)吃掉它。
- 收益的大头来自”格式 + 精度”,而不是模型变小:同一张卡上,从 PyTorch eager 换到 TensorRT INT8,单张推理耗时能降到约 1/4~1/5;换成半精度(FP16)通常已经能拿到大部分收益。
三、知识地图
【理解】真实部署流程(3 页)
├── 第 1 页:实验室环境 vs 部署环境(为什么不是一回事)
│   ├── 实验室侧:windows / 虚拟环境 / python / pytorch / 模型训练 / 调参 / 量化 / 剪枝 / 蒸馏
│   ├── 部署侧:linux、手机、摄像头、无人机、边缘计算盒子……
│   │   ├── 代码常用 C++ 实现;模型转通用格式 onnx,再转 TensorRT / ncnn 等指定格式
│   │   └── 推理端要考虑多线程、负载均衡、异步推理;硬件相关、软硬结合
│   └── 模型的四种文件形态 + ONNX 作为"通用的中介"
│       ├── model.pt / model.pkl / model.safetensor / model.ckpt
│       └── model.onnx / model.engine
├── 第 2 页:部署不可通用(同样模型,不同目标就是不同工程)
│   ├── 实验室环境 vs 部署环境逐项对照(关注点 / 硬件 / 框架库 / 允许的操作 / 精度)
│   └── 实拍:服务化 demo(手机客户端 → 局域网 Flask 服务)、边缘设备、板卡、产线场景
└── 第 3 页:部署环境为什么快
    ├── 运行速度快很多倍、资源占用低
    └── 不必要的内部功能都会被去除
原 PPT 三页均标注为【理解】层级,不要求你手写 TensorRT 插件,但要求你能讲清”为什么必须有这一步”。
四、原理详解
4.1 模型走出实验室的第一站:保存格式与通用中介
torch.save 有两个完全不同的用法,很多人用它俩的时候根本没意识自己在选择”存参数”还是”存程序”。
| 写法 | 存的是什么 | 加载时要什么 | 风险 |
|---|---|---|---|
torch.save(model.state_dict(), "model.pt") |
有序字典(参数名 → 张量) | 需要先构造出同样的模型结构,再 load_state_dict |
推荐做法;结构改动时可能 key 不匹配 |
torch.save(model, "model_full.pt") |
整个 nn.Module 对象(pickle) | 需要原类定义所在的模块路径可导入 | 换机器/改目录/改类名/换版本就加载失败 |
.pkl |
Python pickle,sklearn/joblib 生态常用 | 同 pickle | 反序列化会执行代码,安全性差 |
.safetensors |
只存张量的文件格式:头部是 JSON 描述,后面是裸数据 | 直接 mmap 读取,零拷贝 | 不存优化器状态、不存代码,加载快、无任意代码执行风险 |
.ckpt |
检查点习惯用法(常含参数 + 优化器状态,PyTorch Lightning / TF 常用) | 依赖训练框架 | 体积大,含训练态信息,不适合直接上线 |
# 推荐:只存参数(新闻分类项目里"保存模型/参数字典"就是这一步)
torch.save(model.state_dict(), "model.pt")

# 加载:结构由代码定义,参数从文件灌入;map_location 决定加载到哪块设备
model = NewsClassifier(vocab_size=30000, num_classes=10)
state = torch.load("model.pt", map_location="cpu")   # 无 GPU 机器上也能加载
model.load_state_dict(state)
model.eval()
CPU / GPU 设备映射(部署现场最常踩的一脚):训练机存的是 CUDA 张量,加载机没有 GPU 时,torch.load 会尝试恢复原设备并直接报错。map_location 就是显式的”搬运目的地”:
torch.load("model.pt", map_location="cpu")                     # 一律拉到 CPU
torch.load("model.pt", map_location=torch.device("cuda", 1))    # 指定第 1 块卡
model.to(device).eval()                                         # 再把整个模型搬到目标设备
导出成通用中介(ONNX):ONNX 的定位就是这张图,左边是各家训练框架,右边是 CPU / GPU / FPGA / NPU 各种部署目标,中间是 ONNX + ONNX Runtime。没有它,就是 M 个框架 × N 个目标平台的手工适配;有了它,框架只需要”导得出 ONNX”,平台只需要”吃得下 ONNX”。
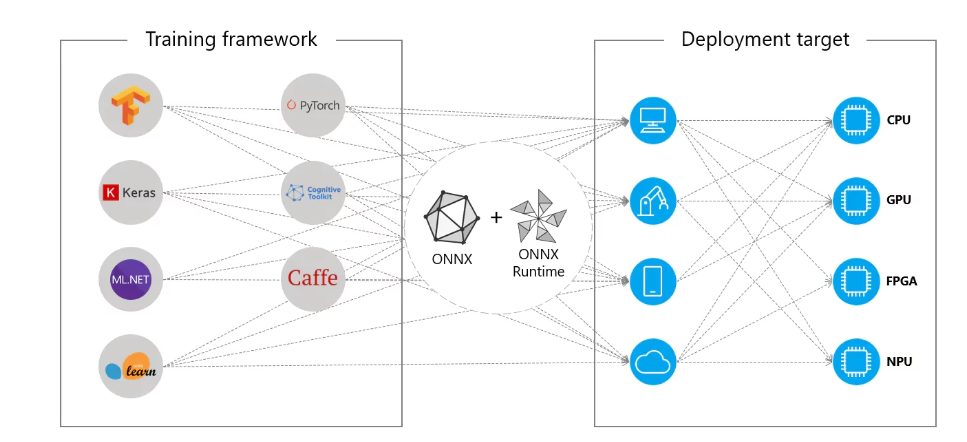
图注:ONNX 生态的总览图。左侧 “Training framework” 框内列出 TensorFlow、PyTorch、Keras、Cognitive Toolkit、ML.NET、Caffe 以及一个脚本字体的 leaf 框架 logo;中间大圆标注 “ONNX + ONNX Runtime”;右侧 “Deployment target” 用桌面机、移动端、云服务器等图标表示部署目标。左右之间是多条点状连线(多对多),说明任意训练框架都能导出到任意部署目标,这就是”通用的中介”的含义。
# 导出:给一个样例输入(dummy input),PyTorch 会"跑一遍"并记录成静态图
dummy = torch.randn(1, 128)
torch.onnx.export(
    model, dummy, "model.onnx",
    input_names=["input_ids"], output_names=["logits"],
    dynamic_axes={"input_ids": {0: "batch"}, "logits": {0: "batch"}},  # 只放开 batch 维
    opset_version=17,
)

# 验证:用 onnxruntime 跑一遍,和 PyTorch 输出比对(不比对就等于没导出成功)
import onnxruntime as ort
sess = ort.InferenceSession("model.onnx", providers=["CPUExecutionProvider"])
print(sess.get_inputs()[0].name, sess.get_outputs()[0].name)
TorchScript 是另一条路(不依赖 Python 解释器,直接序列化图):torch.jit.trace(model, dummy) 记录执行路径,torch.jit.script(model) 直接编译源码。注意 trace 只记录样例输入实际走过的分支,模型里有 if 控制流时,trace 出来的图会把条件固定死,这也是后面 4.5 节对照表里”部署环境不支持动态控制流”的典型来源。官方近年在服务端主推 torch.compile、端侧主推 ExecuTorch,TorchScript 更多见于存量项目和移动端导出。
一带数字的小例子:BERT-base 约 1.1 亿参数,FP32 权重约 440 MB;换成 FP16 是 220 MB,INT8 动态量化是 110 MB。部署到一块 2 GB 显存的边缘卡上,FP32 只是把模型装进去就吃掉 1/5 以上显存,而 INT8 只剩 1/20,这就是”能不能装得下”级别的差别,跟精度损失是否可接受是两回事。
4.2 部署现场长什么样:边缘盒子、开发板与”温度在屏上”
课程里”部署”两个字很抽象,实拍图能立刻让它落地:部署环境往往就是一张工作台、一台工控显示器、一块贴着散热片的板子或一个黑色金属盒子。
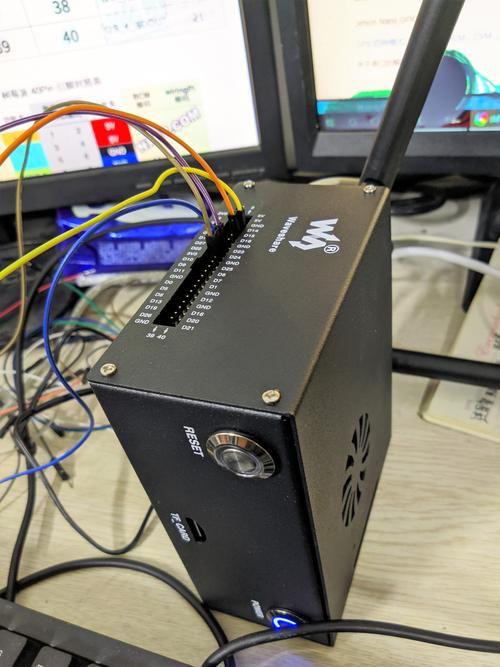
图注:部署现场实拍。背景两台显示器,左侧屏幕上是一张按日期排列的数据表格(可见 38、40、39 等读数和”℃”字样),右侧屏幕是一张曲线图;前景桌面放着连着杜邦线的开发板,以及一台黑色金属外壳的边缘设备,盒子顶面露出 40-pin GPIO 排针(丝印为 GND、D18、D21 等经典引脚名),侧面有 RESET 按键、TF CARD 卡槽与圆形镜头/按键,顶上有天线,板上可见厂商 logo。这类”带摄像头 + TF 卡 + GPIO 的盒子”就是 PPT 里说的”摄像头、边缘计算盒子”级别目标的真实样子:你要在别人的机器上跑,还得接受它的供电、散热、接口和驱动。
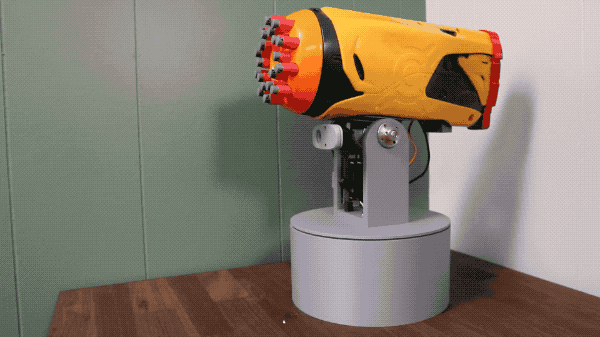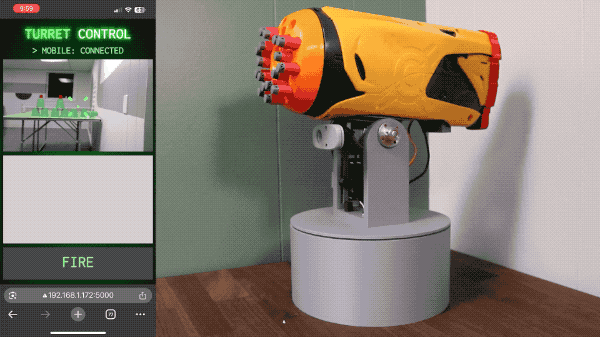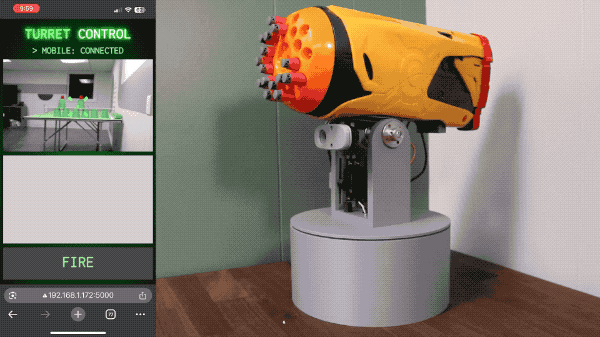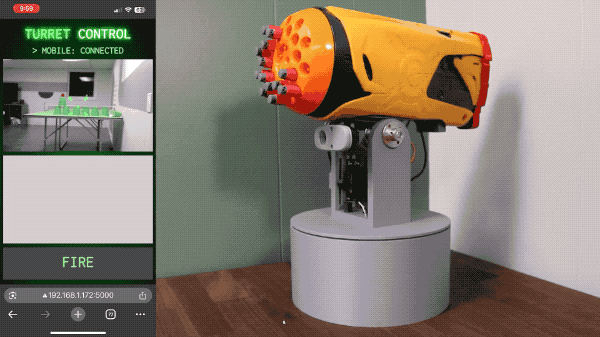
图注(动图,共 199 帧,此处描述其内容):一个”Flask 服务端 + 手机客户端”的最小可用部署 demo。左半部分是手机浏览器打开的页面:绿色终端风格,页头写着 TURRET CONTROL,下一行状态是 > MOBILE: CONNECTED,中间是一路实时视频画面(画面里是桌面上一排绿色玩具士兵和一个红色目标),下方是占满整行的大按钮 FIRE;手机底部浏览器的地址栏显示 192.168.1.172:5000(并标注 Not Secure)。右半部分是实拍的一台桌面自动炮塔(橙色机身、弹匣里插着软弹)。随动画推进,炮塔仰角/朝向发生变化,画面内容随之改变。关键信息是地址栏里那个 :5000,5000 是 Flask 的默认端口,也就是说这个 demo 的后端就是一个监听在局域网上的 Flask 服务,手机在同一网段直接调它。
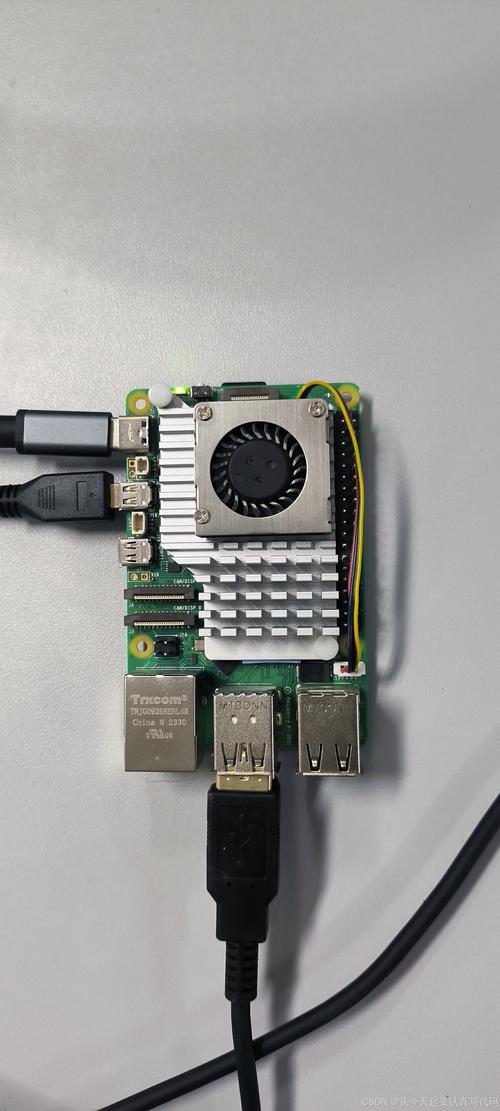
图注:目标平台板卡实拍。一块树莓派级别的单板机:大面积金色散热片 + 黑色风扇压在 SoC 上,可见两个 Tricom 网口、USB 3.0 接口、microSD 卡槽、40-pin 排针与 CSI 摄像头排线接口,USB 3.0 口上插着一个 U 盘;水印为 CSDN 作者标识。这块板子就是”同样的模型,部署给手机和部署给无人机完全不通用”的实物注脚,同一份权重,在 x86 服务器上能跑多线程批推理,在这里要先考虑算力、功耗、散热和算子支持。
4.3 把模型变成服务:Flask 服务端 + 客户端
模型文件是”死”的,服务是”活”的。要让别人用你的模型,最起码要有三件事:一个持有模型的进程(不能每个请求都重新加载)、一个约定好的输入输出接口、一套出错时说得清的错误响应。
服务端设计要点(这四条是的采分点):
- 模型懒加载(lazy loading)+ 全局单例:不要在每个请求里
torch.load(一个请求几百毫秒到几秒全废在这);也不建议在模块顶层加载(配置/权重路径错了,整个 import 就炸,连/health都起不来)。正确姿势是首次请求时加载一次并缓存。 - 请求校验:字段是否存在、类型是否正确、文本是否为空、是否超长(超长请求是压垮服务的常见原因)。
- 错误处理:参数错 → 400;超长 → 413;显存不足 → 503(并
empty_cache());未知异常 → 500 且记日志,绝不把 traceback 直接返回给客户端。 - 并发模型:Flask 自带服务器是单进程多线程(
threaded=True),CPU 推理会被 GIL 拖住;生产上用gunicorn -w N --preload起多进程,--preload让每个 worker fork 之前只加载一次模型。GPU 显存小时,多进程各自持有一份模型会 OOM,这时反过来要”单进程 + 线程池 + 动态 batch”。
# serve.py —— 可运行的完整示例(Flask 服务端)
import os
import logging

import torch
from flask import Flask, jsonify, request

from model_def import NewsClassifier, LABELS, encode   # 模型结构与分词封装

app = Flask(__name__)
logging.basicConfig(level=logging.INFO)

MODEL_PATH = os.environ.get("MODEL_PATH", "model.pt")
DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")
MAX_LEN = 512

_model = None  # 全局单例,进程内只加载一次


def get_model():
    """懒加载:第一个请求到达时才把权重读进内存。"""
    global _model
    if _model is None:
        model = NewsClassifier(vocab_size=30000, num_classes=10)
        state = torch.load(MODEL_PATH, map_location=DEVICE)  # 存的是 state_dict
        model.load_state_dict(state)
        model.to(DEVICE).eval()
        _model = model
        app.logger.info("model loaded: %s on %s", MODEL_PATH, DEVICE)
    return _model


@app.get("/health")
def health():
    """就绪探针:模型还没加载也要能回 200,方便 k8s / 负载均衡判断进程活着。"""
    return jsonify(status="ok", device=str(DEVICE), model_loaded=_model is not None)


@app.post("/predict")
def predict():
    data = request.get_json(silent=True)
    if not isinstance(data, dict) or "text" not in data:
        return jsonify(error="缺少字段 text"), 400

    text = data["text"]
    if not isinstance(text, str) or not text.strip():
        return jsonify(error="text 必须是非空字符串"), 400
    if len(text) > MAX_LEN:
        return jsonify(error=f"text 超长,最长 {MAX_LEN} 字符"), 413

    try:
        model = get_model()
        with torch.inference_mode():                       # 关掉 autograd,省显存省时间
            ids = encode([text]).to(DEVICE)
            logits = model(ids)
            prob = torch.softmax(logits, dim=-1)
            conf, idx = prob.max(dim=-1)
        return jsonify(label=LABELS[idx.item()],
                       confidence=round(float(conf.item()), 4))
    except torch.cuda.OutOfMemoryError:
        torch.cuda.empty_cache()
        return jsonify(error="显存不足,请稍后重试"), 503
    except Exception:
        app.logger.exception("inference failed")            # 详细栈只进日志
        return jsonify(error="internal error"), 500


if __name__ == "__main__":
    # 生产启动方式:
    #   gunicorn -w 4 -k gthread --threads 4 --preload -b 0.0.0.0:5000 serve:app
    app.run(host="0.0.0.0", port=5000, threaded=True)
客户端(Streamlit,只做界面与 HTTP 调用,绝不把模型塞进前端进程):
# client.py —— Streamlit 客户端,调用上面的 Flask 后端
import requests
import streamlit as st

API = st.sidebar.text_input("后端地址", "http://127.0.0.1:5000")

text = st.text_area("新闻标题", "国产大模型开源生态迎来新版本")
if st.button("分类"):
    try:
        r = requests.post(f"{API}/predict", json={"text": text}, timeout=3)
        r.raise_for_status()
        d = r.json()
        st.success(f"{d['label']} 置信度 {d['confidence']}")
    except requests.Timeout:
        st.error("后端超时(3s)——很可能是首次请求正在加载模型")
    except requests.HTTPError as e:
        st.error(f"后端返回 {e.response.status_code}:{e.response.text}")
    except requests.ConnectionError:
        st.error("连不上后端:确认 Flask 已启动、地址端口正确、防火墙放行")
启动两条命令即可复现整个 demo:
python serve.py                       # 后端:http://0.0.0.0:5000
streamlit run client.py               # 前端:默认 http://localhost:8501
为什么这套结构就是”真实部署流程”的缩影:它把四件事都摆到了明面上,模型以什么格式落盘、以什么设备加载、以什么接口暴露、出错了怎么办。PPT 里提到的”多线程、负载均衡、异步推理”就是把这条链路放大到生产规模后必然遇到的下一层问题。
4.4 部署环境到底”多了什么”:实验室 vs 生产逐项对照
实验室环境是”一次只跑一个实验、只求结果对”;部署环境是”同时服务一万人、只求每次都稳”。两个目标的取舍在每一层都不一样。
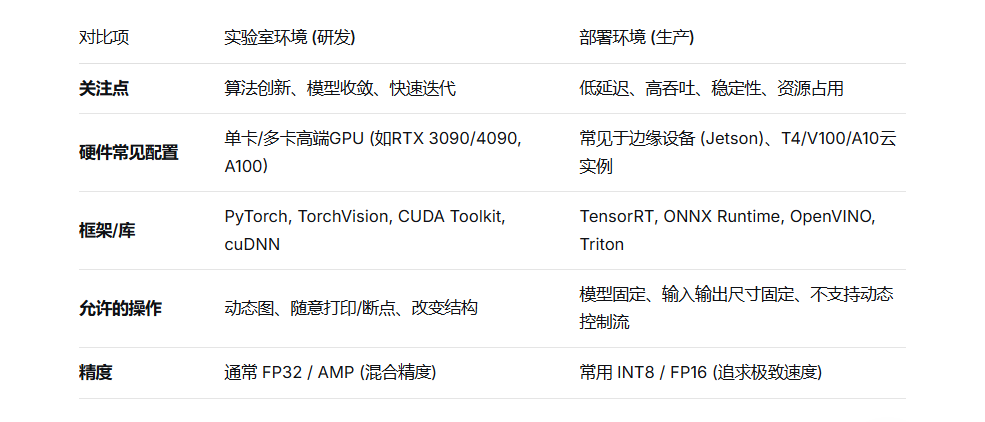
图注:实验室环境(研发)与部署环境(生产)逐项对照表,共 5 行。①关注点:算法创新、模型收敛、快速迭代 | 低延迟、高吞吐、稳定性、资源占用;②硬件常见配置:单卡/多卡高端 GPU | 常见于边缘设备(如 Jetson)、云上的推理卡实例;③框架·库:PyTorch、TorchVision、CUDA Toolkit、cuDNN | TensorRT、ONNX Runtime、OpenVINO、Triton;④允许的操作:动态图、随意打印/断点、随时改变结构 | 模型固定、输入输出尺寸固定、不支持动态控制流;⑤精度:通常 FP32 / AMP 混合精度 | 常用 FP16 / INT8 追求极致速度。这张表基本就是”部署工程师”和”算法工程师”的分工线。
其中”输入输出尺寸固定”必须单独强调:动态图里 batch 和序列长度随便变,导出成静态图时如果没声明 dynamic_axes,ONNX 会把维度写死;线上来了一个长度不同的请求,就只能 pad 或重导。这是导出环节最容易漏的一步。
4.5 为什么部署不可通用:场景决定工程
PPT 原文说得很直白:部署环境和硬件、软件环境强相关,部署完成后只针对特定场景,是不通用的;同样的模型,部署给手机或者部署给无人机,两者完全不通用。两张实拍图说明了”场景”这个词有多宽:
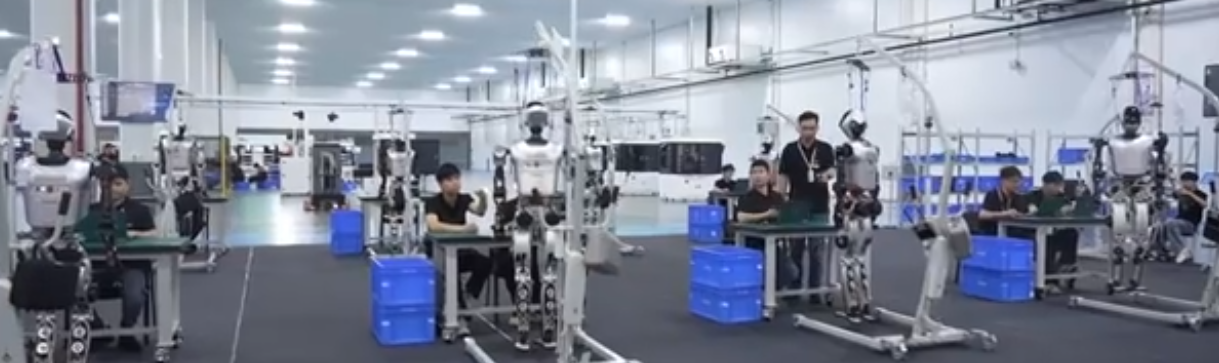
图注:人形机器人装配/测试产线现场。车间内多台双足人形机器人被吊装在测试支架上(防止跌倒摔坏本体),每台机器人前方是一个调试工位:工程师坐在工位前对着笔记本,桌上有蓝色周转箱与工具。这类场景的部署约束是实时控制频率、功耗与安全,模型必须在固定时间窗内出结果,晚一帧就是摔倒。
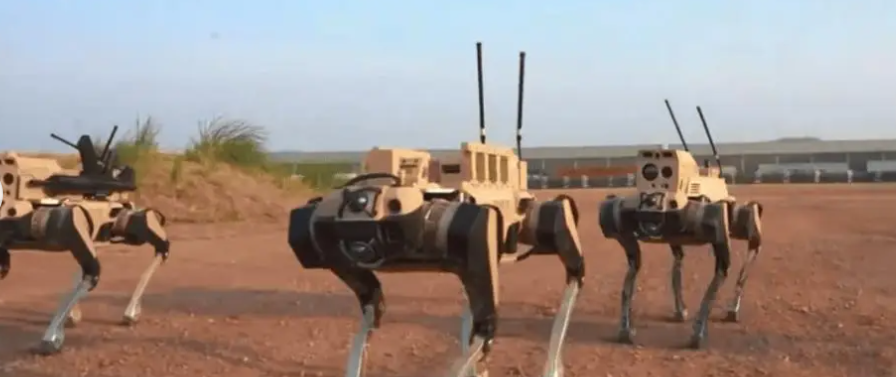
图注:四足机器人(机器狗)户外试验场。多台沙色/军绿色四足机器人(机背带两根天线,机身前后装有传感器与任务载荷支架)在土路上列队,背景是厂房与草丘。同一个”目标检测/步态”算法搬到这类平台上,散热、供电、振动、离线运行、算子支持全都要重新做一遍,这就是”不通用”的具体含义。
4.6 换格式 + 降精度:部署收益有多大
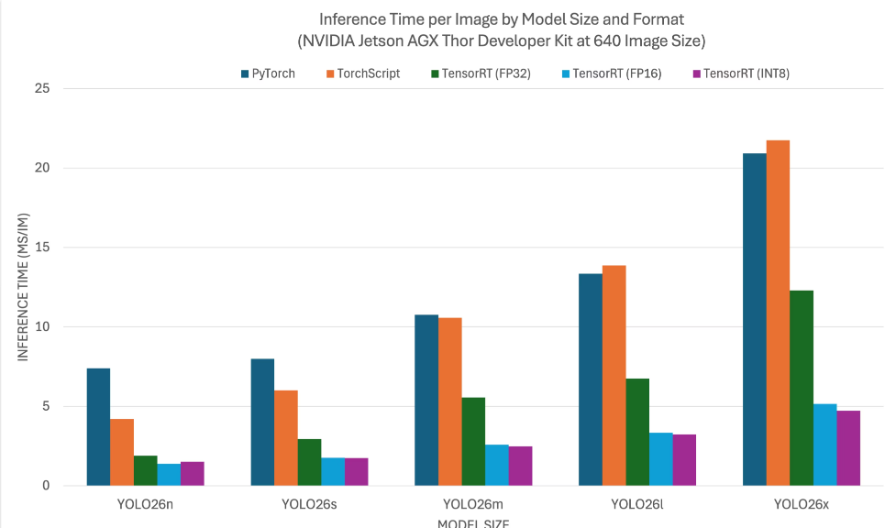
图注:推理耗时对比柱状图,标题为 “Inference Time per Image by Model Size and Format(NVIDIA Jetson AGX Thor Developer Kit at 640 Image Size)”,纵轴 INFERENCE TIME (MS/IM),量程 0~25;横轴按模型规模分 5 组:YOLO26n / YOLO26s / YOLO26m / YOLO26l / YOLO26x;每组 5 根柱子,图例为 PyTorch、TorchScript、TensorRT (FP32)、TensorRT (FP16)、TensorRT (INT8)。读图近似值:
| 模型规模 | PyTorch | TorchScript | TRT-FP32 | TRT-FP16 | TRT-INT8 |
|---|---|---|---|---|---|
| YOLO26n | ≈7.5 ms | ≈4.3 ms | ≈2.0 ms | ≈1.5 ms | ≈1.5 ms |
| YOLO26s | ≈8.0 ms | ≈6.0 ms | ≈3.0 ms | ≈2.0 ms | ≈2.0 ms |
| YOLO26m | ≈10.8 ms | ≈10.5 ms | ≈5.5 ms | ≈2.7 ms | ≈2.6 ms |
| YOLO26l | ≈13.3 ms | ≈14.0 ms | ≈7.5 ms | ≈3.3 ms | ≈3.3 ms |
| YOLO26x | ≈21.0 ms | ≈22.0 ms | ≈12.3 ms | ≈5.2 ms | ≈4.9 ms |
(数值为读图近似;趋势明确,绝对值不必记。)
三个可以直接背下来的读图结论:
- 换运行时(PyTorch → TensorRT)的收益,通常大于换模型规模。YOLO26m 的 PyTorch 耗时(≈10.8 ms)比 YOLO26n 的 PyTorch 耗时(≈7.5 ms)只差约 3 ms;但把 YOLO26m 换成 TRT-FP16(≈2.7 ms),比 YOLO26n 的 PyTorch 还快一倍多。先优化部署链路,再考虑换小模型,是工程上更划算的顺序。
- FP16 贡献了大部分收益,INT8 再小幅收尾。n/s/m 三组里 FP16 与 INT8 几乎重合,l/x 上 INT8 只再快零点几毫秒,所以”能不能上 FP16″往往比”能不能上 INT8″更关键,而 INT8 还额外要求校准集/量化感知训练(对应模型压缩章节的 PTQ / QAT / DQ)。
- 模型越大,格式优化的绝对收益越大。YOLO26x 从 ≈21 ms 降到 ≈4.9 ms,省下 16 ms;n 只省下 6 ms。这解释了为什么大模型服务化对 TensorRT / ONNX Runtime 这类运行时如此依赖。
对应 PPT 第 3 页的原文结论:部署环境的运行速度能比实验室环境快很多倍,资源占用也更低,因为不必要的内部功能都会被去除。 “被去除的功能”具体是:Python 解释器与动态图调度、autograd 反向图、未使用的算子与分支、可变的输入形状、调试/打印逻辑,FP16/INT8 又顺手把 4 字节的 FP32 压成 2/1 字节,直接反映为带宽和显存占用下降。
五、易错点与常见误解
① 常见说法:”保存模型就是 torch.save(model, ...)“;实际上,默认只存 state_dict。
为什么:torch.save(model) 走 pickle,把类的引用路径一起序列化;部署环境里目录结构一变、类名一改、PyTorch 版本一升,加载就报 Can't get attribute ...。state_dict 只存张量,结构由部署代码自己 import,可控可审计。
② 常见说法:”模型能加载就能跑,设备无所谓”;实际上,map_location 必须显式处理。
原因在于,GPU 上保存的张量默认按原设备反序列化,无 GPU 的机器或卡号不同的机器会直接失败。加载侧统一 map_location="cpu" 再 model.to(device),是跨环境部署的标准写法。
③ 常见说法:”导出 ONNX 成功 = 部署成功”;实际上,必须做数值对齐验证。
背后的道理是,torch.onnx.export 是用样例输入”跑一遍”记录算子,可能漏掉分支、可能某个算子被拆成低效实现。部署前要用 onnxruntime 跑同样输入,和 PyTorch 输出比最大绝对误差;有偏差就得换 opset、改写法或使用自定义算子。
④ 常见说法:”Flask 里每个请求现加载一次模型最保险”;实际上,懒加载 + 全局单例。
之所以如此,反复 torch.load 会让 P99 延迟爆炸,显存还可能碎片化。同时也不该在模块顶层无条件加载,那样配置错误会导致进程连健康检查都回不了。
⑤ 常见说法:”TorchScript 就是 ONNX 的替代品”;实际上,两者定位不同。
为什么:TorchScript 序列化的是 PyTorch 自己的图/模块(省掉 Python 解释器开销,但仍在 PyTorch 运行时里跑);ONNX 是跨框架的交换格式,交给非 PyTorch 的运行时(TensorRT / OpenVINO / ncnn)执行。要跨到 C++、手机、DSP 时,ONNX 这条线才是通用解。
⑥ 常见说法:”模型压缩完就一定能加速”;实际上,加速取决于目标硬件是否真支持该精度。
原因在于,INT8 的动态量化在支持 INT8 指令的硬件上才有倍数收益;在没有相应加速单元的老 CPU 上,量化还可能因为反量化开销而变慢。图里 FP16 和 INT8 几乎重合,也说明收益往往被”运行时/算子库”卡住,而不是被数值精度卡住。
⑦ 常见说法:”Streamlit 里直接加载模型最省事”;实际上,前后端分离。
背后的道理是,Streamlit 每次交互都会重跑脚本,把模型放进去会反复加载/反复占显存,而且一个客户端卡死整个页面。正确做法是后端一个进程持有模型,前端只发 HTTP(这也是 PPT 里”Flask 服务端 + Streamlit 客户端”的意义)。
六、横向对比与研究脉络
6.1 部署格式与推理运行时
| 方案 | 出身/定位 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| PyTorch eager | 训练框架本体(动态图) | 灵活、好调试 | 带解释器与自动微分开销,延迟最高 | 实验室、离线批处理 |
| TorchScript | PyTorch 自带的图序列化 | 不依赖 Python 源码即可执行,改造量小 | 仍绑定 PyTorch 运行时;trace 会固定控制流 |
服务端/移动端的 PyTorch 内生部署 |
| ONNX + ONNX Runtime | 开放交换格式 + 跨平台推理引擎 | 框架无关、平台覆盖广(CPU/GPU/移动端) | 算子覆盖受 opset 限制,需版本对齐 | 跨框架、跨平台分发的第一站 |
| TensorRT(.engine) | NVIDIA GPU 专用 | 融合算子、FP16/INT8 加速,收益最大 | 只认自家 GPU,engine 与显卡/驱动/TensorRT 版本强绑定 | NVIDIA 服务器与 Jetson 边缘设备 |
| OpenVINO | Intel 系(CPU/iGPU/VPU) | Intel 平台上开箱即用 | 生态偏向 Intel 硬件 | x86 推理服务、Intel 边缘盒子 |
| ncnn | 面向移动端/嵌入式的轻量推理框架 | 无第三方依赖、体积小、适合手机与 MCU 级设备 | 算子集相对小,需自行扩展 | Android/iOS、嵌入式设备 |
脉络:PyTorch eager 解决”训练要灵活”→ TorchScript/ONNX 解决”部署要摆脱 Python”→ ONNX 解决”框架与硬件多对多爆炸”(即 4.1 那张图)→ TensorRT / OpenVINO / ncnn 各自解决”在特定硬件上榨出极限性能”→ Triton / TorchServe 这类推理服务器再把”多模型、动态批、版本管理、指标”从业务代码里抽出来。每一次演进的驱动力都是同一个:训练侧要灵活,部署侧要确定,中间的交换格式就是这个矛盾的调和产物。
6.2 服务框架
| 框架 | 与模型的关系 | 适合场景 | 代价 |
|---|---|---|---|
| Flask | 自己写路由与生命周期 | 教学、demo、小规模内部服务;新闻分类项目就是它 | 无动态批、无模型版本管理、并发要自己配 gunicorn |
| FastAPI | 同上,但是 async + 自动生成 API 文档 | 需要异步 IO、接口规范的项目 | 推理是 CPU/GPU 密集,async 收益有限 |
| TorchServe / Triton | 专为推理服务设计 | 多模型、多版本、动态批(dynamic batching)、指标暴露 | 学习与部署成本高,需要理解其配置体系 |
(Flask/FastAPI 本身只是”HTTP 外壳”,真正的性能提升来自运行时与批处理策略,别把框架当成加速手段。)
七、在新闻分类项目中的落地
用在哪一步:项目最后一个环节,四个模型(TF-IDF+随机森林 / FastText / BERT / LLM)和压缩版本都训好之后,用 Flask 做一个统一推理服务,Streamlit 做对比界面,现场演示”同一句标题,四个模型给出什么结果、各自耗时多少”。
具体接法:
- 一个后端,多条分支:
/predict里按model字段分发,tfidf_rf走joblib.load()的.pkl;fasttext走fasttext.load_model()加载.bin;bert走AutoModelForSequenceClassification.from_pretrained()(safetensors 权重);llm走 DeepSeek API。四种都懒加载进各自的全局缓存。 - 参数字典复用:TF-IDF 的
vocab/停用词、标签映射(10 类的 id↔名称)统一存成一个labels.json+ 权重文件,model.load_state_dict(torch.load(..., map_location="cpu"))先跑 CPU,验证通过再切 GPU。 - 前端做对照实验:Streamlit 侧边栏选模型、主区输入标题,
requests.post(..., timeout=...)拿结果,把每个模型的延迟(time.perf_counter()前后差)也打出来,这就是 4.6 那张柱状图的”迷你版”,被追问时可以直接讲。 - 压缩版本接入:BERT 的量化/蒸馏/剪枝产物分别导出成一份
bert_ptq.onnx/bert_scripted.pt,在同一接口下加format=onnx|torchscript,用同一批标题对拍延迟与准确率,形成”压缩收益表”。
关键参数与坑:
torch.load(..., map_location="cpu")+.eval()+torch.inference_mode():三项缺一项,延迟结果就不可信(.eval()影响 BN/Dropout,inference_mode影响 autograd 开销)。gunicorn -w 4 --preload -b 0.0.0.0:5000 serve:app:--preload让模型只加载一次被 worker 共享,否则 4 个 worker 各占一份内存。GPU 显存不够时反过来用-w 1 -k gthread --threads 4。- 放 5000 端口的隐患:Flask 默认端口就是 5000,macOS 上这一端口常被系统服务占用,本地演示若报端口冲突,换端口或关掉对应服务;Streamlit 默认是 8501,两个服务别配成同一个端口。
- 首次请求慢(cold start):上线前主动发一次 dummy 请求预热,或在启动脚本里显式加载模型,避免演示时”第一次点击卡 5 秒”。
- FastText 的
.bin需要与同名.vec文件同目录;BERT 用 safetensors 加载时确认model.safetensors与config.json在同一目录。 - LLM 分支要单独设超时与降级:API 超时时返回”回退到 BERT 结果”,而不是让整个页面转圈(这就是”错误处理”在项目里的价值)。
与项目其它方案怎么配合:TF-IDF+随机森林提供最省资源的基线(.pkl 只有几 MB,适合 CPU 边缘),FastText 提供单句毫秒级基线,BERT 是准确率上限的工程版本,LLM 是零样本能力展示;部署层把它们收进同一个接口,压缩层负责把 BERT 这一档的成本压到可接受范围,整条故事线在被追问时是连贯的。
八、重点问答
Q1:训练好的模型要上线,第一步做什么?
A:第一步是”选保存格式”。我默认只存 state_dict,也就是 torch.save(model.state_dict(), "model.pt"),因为它是纯参数字典,部署侧自己定义结构再 load_state_dict,可移植也可控。不推荐 torch.save(model),它走 pickle 会把类的引用路径写进文件,换环境、改类名、升版本就容易加载失败。加载时一定显式写 map_location,GPU 存的权重拉到 CPU 上要 map_location="cpu",否则无卡机器直接报错。
Q2:CPU/GPU 设备映射要注意什么?
A:三点。一是保存端和加载端的设备可能不同,map_location 就是搬运目的地,不写就可能尝试恢复原设备而失败。二是跨卡要注意编号,map_location=torch.device("cuda", 1) 指定具体卡,多卡机器上建议先统一拉到 CPU 再 model.to(device)。三是别忘了 .eval(),只在训练时开 train 模式,推理带上 Dropout/BN 的 train 行为会让结果不稳定。
Q3:ONNX 是什么,为什么需要它?
A:ONNX 是一个开放的模型交换格式,作用是当”通用的中介”。因为训练框架有 PyTorch、TensorFlow、Keras 等好几家,部署目标又有 CPU、GPU、FPGA、NPU 好几类,如果两两适配就是 M×N 的工程量;有了 ONNX,框架只要导得出 ONNX,平台只要吃得下 ONNX,就变成 M+N。导出用 torch.onnx.export(dummy_input, ...),注意声明 dynamic_axes 放开 batch 维,导完必须用 onnxruntime 跑一遍和 PyTorch 对数值。
Q4:ONNX 和 TorchScript 怎么选?
A:看目标平台。TorchScript 是把 PyTorch 的图序列化下来,不依赖 Python 源码但要靠 PyTorch 运行时跑,适合 PyTorch 生态内部的部署;ONNX 是跨框架的交换格式,可以喂给 TensorRT、OpenVINO、ncnn 这些非 PyTorch 的引擎,适合要上 C++、手机、边缘盒子。还有一个坑:torch.jit.trace 只记录样例输入走过的分支,有动态控制流时要用 script,而部署环境一般是不支持动态控制流的,这也是部署表里明确写”模型固定、输入尺寸固定”的原因。
Q5:Flask 那套服务怎么设计才不踩坑?
A:我总结成四件事。第一是懒加载加全局单例,第一次请求时加载一次模型,之后复用,绝不每个请求重新 torch.load。第二是请求校验,text 字段是否存在、是否非空、长度是否超过上限,错误码分清楚,参数问题 400、超长 413。第三是错误处理,显存不足回 503 并 empty_cache(),未知异常记日志回 500,绝不把 traceback 返给客户端。第四是并发,开发用 threaded=True,生产用 gunicorn -w N --preload,让每个 worker 共享一份模型。
Q6:Streamlit 客户端为什么不直接加载模型?
A:因为 Streamlit 每次交互都会重跑整个脚本,模型放进去就会被反复加载、反复占显存,一个请求卡住整个页面也卡住。前后端分离以后,后端一个进程持有模型,前端只发 HTTP 请求,还能顺手做超时、重试、降级。我们的 demo 就是前端 requests.post(API + "/predict", json=..., timeout=3),后端 Flask 在 5000 端口。
Q7:为什么说部署环境比实验室快很多倍?
A:因为部署时会把”训练/研发才需要的东西”整个删掉:Python 解释器和动态图调度、autograd 反向图、没用到的算子与分支、可变的输入形状、调试打印逻辑,全都去掉,再配合算子融合和 FP16/INT8 量化,单张推理耗时能降到原来的四分之一到五分之一。我见过的一张对比图上,同一个检测模型从 PyTorch 换到 TensorRT INT8,单张耗时从约 21 毫秒降到约 5 毫秒;而且收益主要体现在大模型上,小模型省的绝对值有限。
Q8:为什么说同一个模型部署给手机和无人机是两份工程?
A:因为部署环境和硬件、软件强绑定。手机要考虑算力、内存、功耗和 Android/iOS 的算子支持;无人机要考虑实时性、离线运行、振动与散热,可能还要用 C++ 写前处理。同一份权重,工具链(TensorRT / OpenVINO / ncnn)、精度(FP16 / INT8)、输入尺寸、线程模型都不一样,所以部署完成后只针对特定场景,是不通用的,这也是为什么会有”部署工程师”这个越老越吃香的岗位。
九、延伸阅读
- PyTorch 官方文档:
torch.save/torch.load的 “Serialization semantics”(讲state_dict与整模型 pickle 的区别、map_location)、《ONNX》导出页与torch.jit(TorchScript)章节、torch.quantization动态量化 API。 - ONNX / ONNX Runtime 官方文档:算子与 opset 版本表、ONNX Runtime 的 execution provider(CPU / CUDA / TensorRT)。
- NVIDIA TensorRT 开发者文档:FP16/INT8 与
.engine的构建,以及 NVIDIA Jetson 开发者套件的部署指南(本报告 4.6 那张对比图就是 Jetson 平台上的测试)。 - OpenVINO 与 Tencent ncnn 官方仓库:分别在 Intel 平台与移动端/嵌入式的部署路径。
- Flask / gunicorn / Streamlit 官方文档:路由与错误处理、
gunicorn -w/-k/--preload的并发与内存行为、Streamlit 的脚本重跑模型与部署方式。 - Hugging Face
safetensors仓库:格式设计(JSON 头 + 裸张量)与相对 pickle 的安全/速度优势;以及transformers的save_pretrained/from_pretrained加载流程。 - Triton Inference Server / TorchServe 文档:动态批处理、多模型版本管理、指标暴露,这套东西是 Flask 手写服务在生产环境的下一站。