把「Encoder–Decoder 只给一个 C」这个瓶颈讲透,然后从中拆出 Attention 的 Q/K/V 三要素与「打分 → 归一化 → 加权求和」三步,落到缩放点积公式 \text{softmax}(QK^\top/\sqrt{d_k})V 上,这一页是 RNN 时代通往 Transformer 的那道门。
一、这份材料解决什么问题
RNN 做机器翻译的标准套路是 Encoder–Decoder(seq2seq):Encoder 把整句英文吃掉,吐出一个固定长度的向量 C;Decoder 拿着这个 C,一个词一个词地吐中文。
这份课件用一句话就把这条路线的死穴钉住了:”所有输出词,都使用同一个向量表示”。翻译 The cat eats fish → 猫 吃 鱼 时,生成”鱼”最该看的是 fish,但 Encoder 早就把 The、cat、eats、fish 一起揉成了一个 C,Decoder 无从区分”重点”和”非重点”。原文给的判断很直白:”模型无法区分’重点’和’非重点’,这就是 Attention 要解决的问题:学会’看重点'”。
所以这份材料回答的问题不是”Attention 的公式长什么样”,而是三层递进:
| 层次 | 问题 | 材料给出的答案 |
|---|---|---|
| 动机层 | 为什么一个 C 不够? | 信息瓶颈(长句塞不下)+ 相关性缺失(所有输入词影响力被强行拉平) |
| 机制层 | 凭什么”看得准”? | 给每个 target 词单独算一组权重分布,加权求和出自己的 C_i |
| 计算层 | 权重怎么算出来? | 打分(Q·K)→ 归一化(softmax)→ 加权求和(×V) |
在新闻分类项目流水线里的位置:这条链是项目四段式技术路线的分水岭。TF-IDF + 随机森林和 FastText 都属于”词与词之间没有交互”的表示方式;BERT 之所以能把 10 类新闻标题分得比它们好,根子上就是它每一层都在做多头自注意力,让标题里的每个 token 动态地去看标题里其它 token。不把这一页的 Q/K/V 和 \sqrt{d_k} 讲清楚,后面 BERT 那一步就只能背 API。
二、核心结论
- Attention 的本质是”加权平均”:输出不是新造的东西,而是对 Value 的凸组合,权重非负、每行和为 1,所以输出一定落在各 v_i 张成的凸包内。整套机制只做了一件事:决定每个位置分到多少权重。
- 三步走,一步都不能少:\text{score}=\text{score}(Q,K) → \alpha=\text{softmax}(\text{score}) → \text{context}=\sum_i \alpha_i v_i。所有 Attention 变体(加法/乘法/自注意力/交叉注意力)的差别只在第一步的 score 函数和 Q/K/V 从哪来,后两步永远不变。
- Q/K/V 是三种角色,不是三种数据:Query=当前在问什么,Key=每个位置拿出来匹配的标签,Value=匹配上之后真正取走的内容。它们常是同一批隐藏状态经三组不同线性变换投影而来(W_Q/W_K/W_V),维度 d_k 与 d_v 可以不同。
- \sqrt{d_k} 是在控方差,不是在防溢出:当 q_i,k_i 独立同分布于 \mathcal N(0,1) 时,\mathrm{Var}(QK^\top)=d_k,d_k 越大分数波动越剧烈 → softmax 被推向 one-hot → 梯度 p(1-p)\to 0。除以 \sqrt{d_k} 把方差拉回 1,让 softmax 工作在梯度健康的区间。
- 自注意力是”公式不变、来源变了”:Q/K/V 全来自同一序列,好处是任意两个 token 一步建立联系(不受距离影响)且全并行;代价是注意力矩阵 T\times T,算力/显存复杂度 \mathcal O(T^2d),这也是今天长上下文贵、要做 KV cache 和 FlashAttention 的根源。
三、知识地图
原材料的层级结构与掌握权重(权重取自课件里的【重点】【了解】★ 标注):
day04 注意力机制
├─ 1 注意力机制的由来 ........................【理解】
│   └─ The cat eats fish → 猫 吃 鱼:不同输出词关注不同输入位置
├─ 2 注意力机制是什么 ........................【理解】
│   ├─ 2.1 核心思想(生物学灵感 → 动态权重)
│   └─ 2.2 有无 Attention 的 Encoder-Decoder 对比
│       ├─ 无 Attention:单一 C、信息瓶颈        【重点:理解痛点】
│       └─ 有 Attention:$C_i=\sum_j a_{ij}v_j$   【重点】
├─ 3 计算过程 ................................【掌握】
│   ├─ 3.1 统一公式 Attention(Q,K,V)=softmax(score)·V  【掌握】
│   ├─ 3.2 分类:软/硬注意力、普通/自注意力      【软注意力重点,硬注意力了解】
│   ├─ 3.3 Soft Attention 三步 + Q/K/V 三个生活例子  【掌握·重点】
│   ├─ 3.4 Self Attention                     【掌握】
│   └─ 3.5 两种实现:乘法 Luong ⭐ / 加法 Bahdanau   【掌握·乘法优先】
├─ 4 计算公式 ................................【掌握】
│   ├─ 4.1 统一公式
│   ├─ 4.2 常见规则(拼接 / 加法 / 缩放点积)    【缩放点积:重点】
│   ├─ 4.3 为什么除以 $\sqrt{d_k}$(含 3×4 例子)  【重点·必背】
│   ├─ 4.4 bmm / matmul 批量矩阵乘法            【掌握 matmul】
│   └─ 4.5 缩放点积注意力的代码实现              【掌握】
├─ 5 总结 ....................................【理解】
│   └─ 当代关键技术:多头注意力 / 掩码 / 位置编码 / FlashAttention
└─ 6 常见高频题 + 7 代码作业 ..................【必练】| 类型 | 权重形式 | 可导 | 训练方式 | 工程现状 |
|---|---|---|---|---|
| 软注意力 Soft / Global ★主流 | 连续值 ∈ [0,1] 且归一化 | 是 | 反向传播 | 工业标准:Transformer / BERT / GPT |
| 硬注意力 Hard / Local(了解) | 离散 0/1,只选一处 | 否 | 强化学习 / 采样 | 几乎不用,早期研究 |
现代深度学习里 99% 用的是软注意力;Transformer 的突破公式是 软注意力 + 自注意力 + 并行计算。
四、原理详解
4.1 先看痛点:一个 C 扛不动整句话
无 Attention 的框架里,Encoder 与 Decoder 之间只有一条数据通路:
- Encoder 把输入序列 X_1\cdots X_m 压缩成一个中间语义表示 C=\mathrm{GRU}(X_1,\dots,X_m);
- Decoder 复用同一个 C 生成每一步:y_1=f(C),y_2=f(C,y_1),y_3=f(C,y_1,y_2)……
课件直接推导出结论:”不论生成 target 中哪个目标单词 y_i,中间语义表示 C 都是一样的,也就是 source 中任意单词对目标单词 y_i 的影响力都是相同的”。两个问题随之而来:
- 信息瓶颈:句子一长,固定长度的 C 存不下全部信息(课件原话:”长句子时,一个向量无法存储所有信息”);
- 相关性缺失:”猫”本该看
cat、”吃”看eats、”鱼”看fish,但框架给三个词喂的是同一个 C,无法体现不同词之间的相关性。
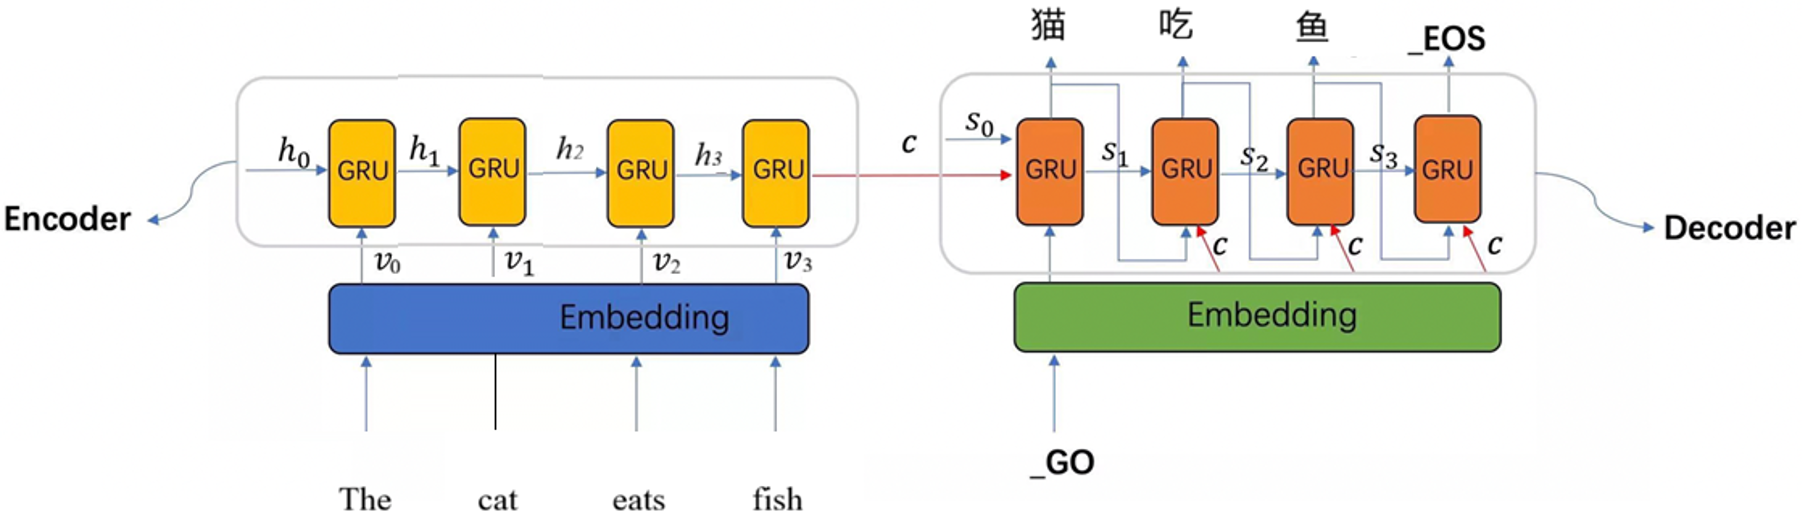
图注:无 Attention 的 Encoder–Decoder 结构示意。左侧 Encoder 链把整句输入压成单一中间语义向量,右侧 Decoder 每一步都从这同一个向量取上下文,图上只有一条从编码到解码的”主干”,没有任何按位置分叉的回连,这就是”所有输出词共用一个 C“的图形化表达。
4.2 加 Attention:把固定的 C 换成动态的 C_i
加了注意力之后,中间语义表示不再恒定,而是每生成一个 target 词就现算一个专属的 context 向量:
C_i=\sum_{j=1}^{L_x}a_{ij}v_j
- v_j:source 中第 j 个词的语义表示(一般为词向量经线性映射的结果);
- a_{ij}:source 第 j 个词对 target 第 i 个词的注意力概率分布;
- L_x:source 句子的长度。
生成过程也随之变成 y_1=f_1(C_1,h_0)、y_2=f_1(C_2,h_0,h_1)、y_3=f_1(C_3,h_0,h_1,h_2),下标跟着输出词走。课件给的数字例子(source 是 The cat eats fish):
\begin{aligned}
C_1&=0.2v_1+0.6v_2+0.1v_3+0.1v_4 \quad(\text{生成”猫”})\\
C_2&=0.1v_1+0.2v_2+0.6v_3+0.1v_4 \quad(\text{生成”吃”})\\
C_3&=0.1v_1+0.1v_2+0.2v_3+0.6v_4 \quad(\text{生成”鱼”})
\end{aligned}
注意三行权重的”峰”分别是第 2、第 3、第 4 个位置,正好对应 cat、eats、fish;每行权重之和都是 1.0。
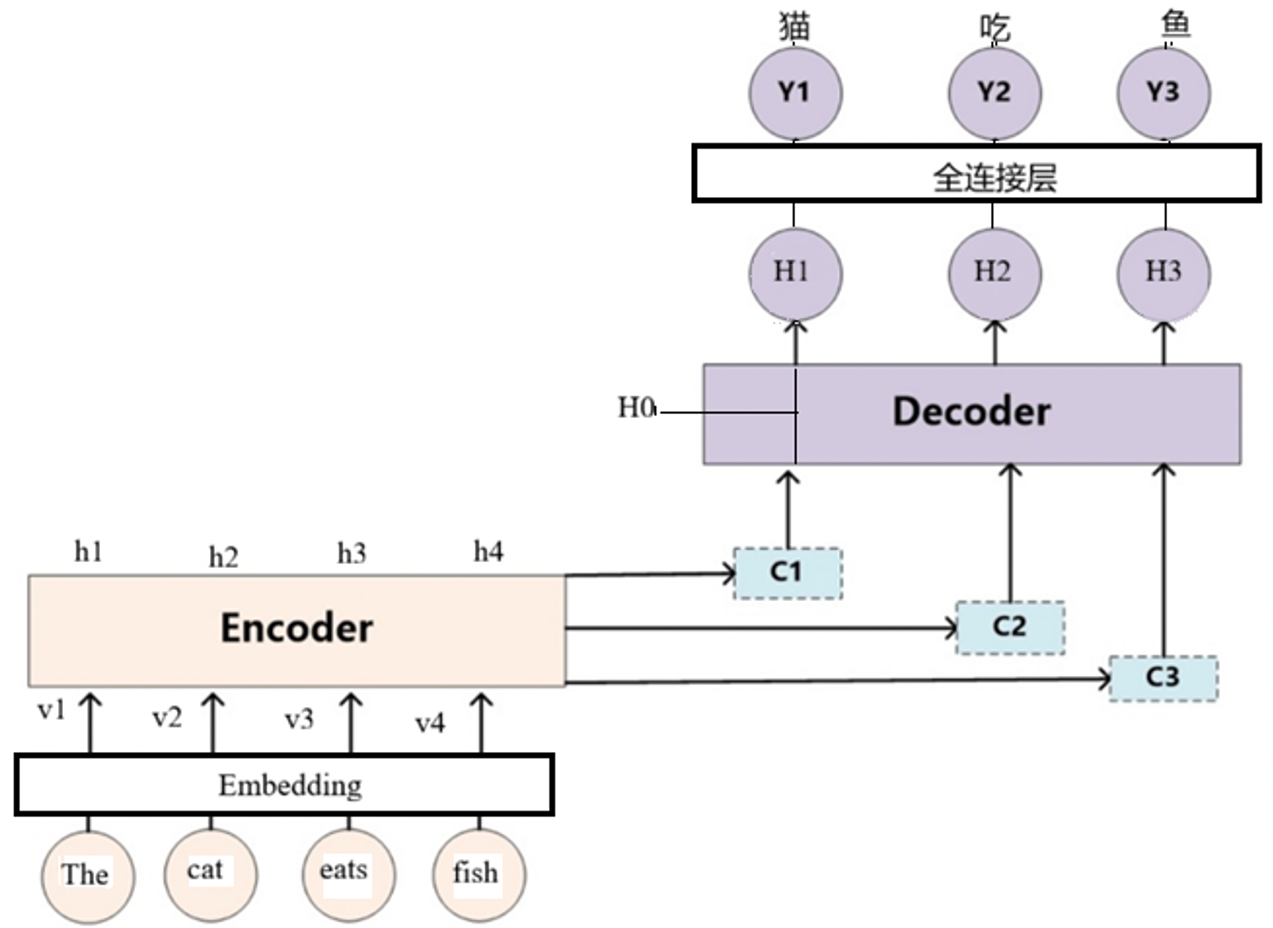
图注:加了注意力机制的 Encoder–Decoder 框架。与上层”单一 C“结构相比,编码器各时间步的输出被保留下来(不再只交出最后一个状态),解码器每一步通过一条额外的注意力通路拿到按权重加权后的 C_i,同一个 Encoder,Decoder 每步取到的上下文向量却是不同的。
4.3 三要素 Q / K / V:换三个生活场景来记
这套机制并不是凭空造出来的。课件的引入方式是”人的注意力”,先给出一张信息拥挤的街景:
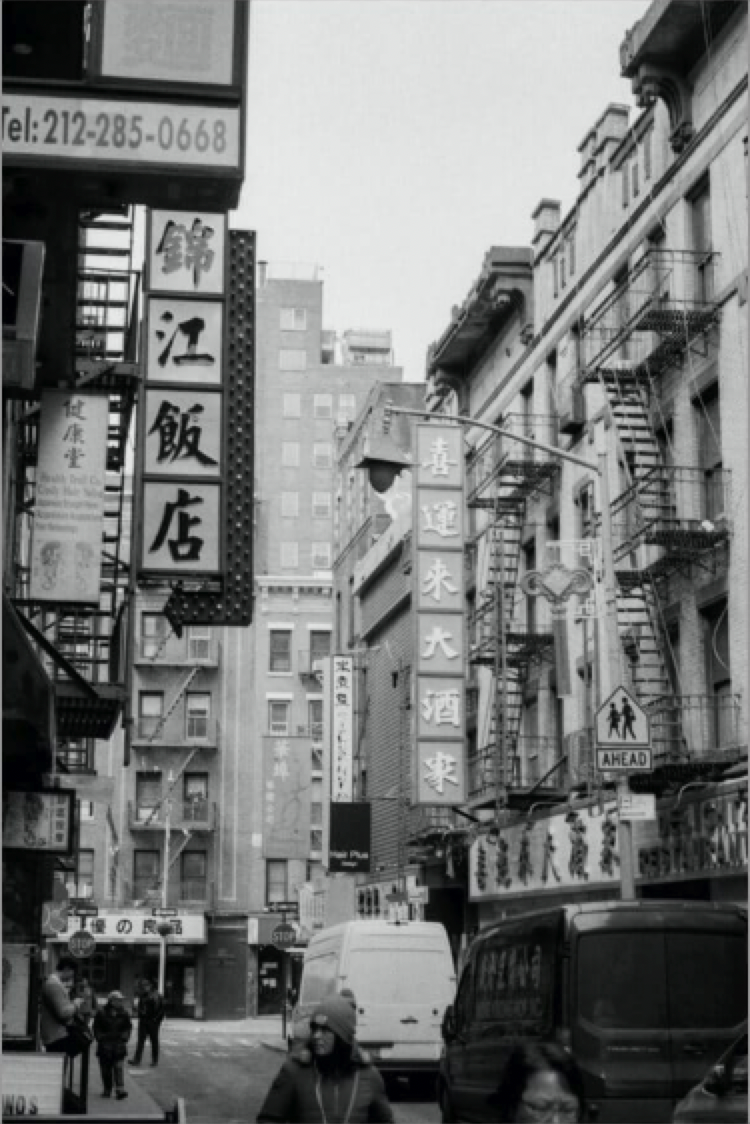
图注:一张信息量很大的黑白街景照片(”锦江饭店””喜运来大酒家”等竖排招牌、”喜运来大酒楼”字样与 Tel:212-285-0668 的灯箱、人行道上的行人和车辆),作为”人在观察复杂场景时可以看的东西很多”的原始场景。
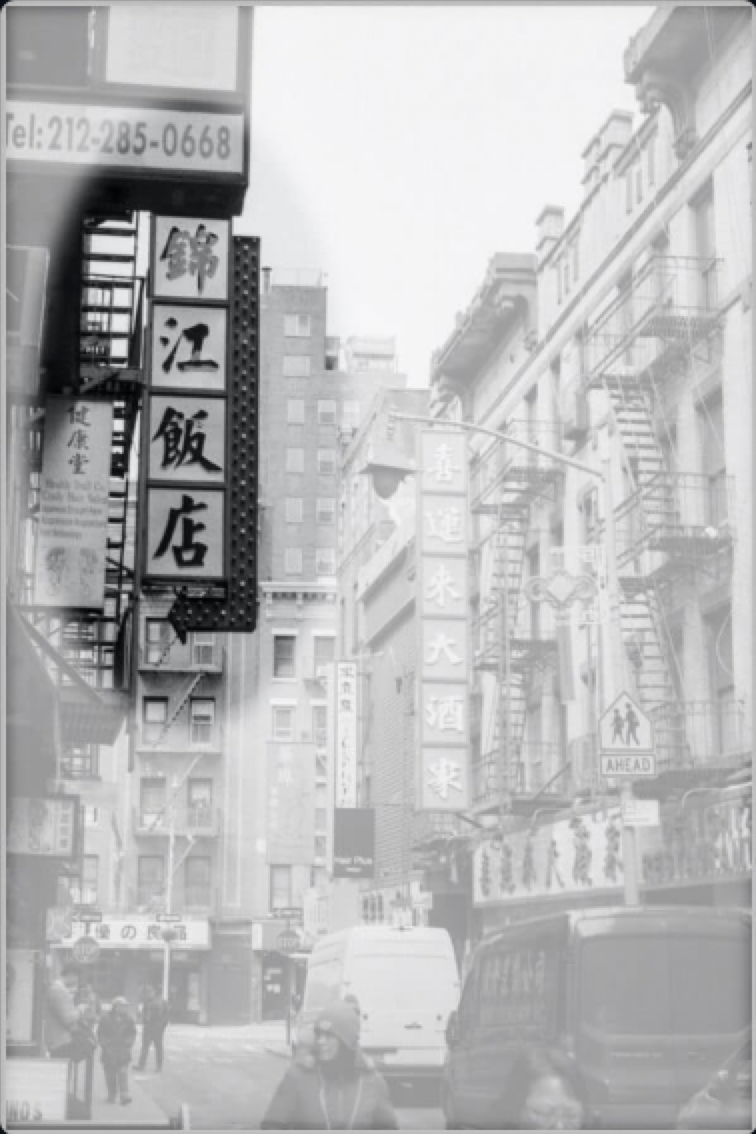
图注:同一张照片经过”外围淡化、关注点保留”处理后的版本,画面整体被虚化/褪白,唯有左侧”锦江饭店”的竖排大招牌仍清晰可辨。这就是课件说的”在短时间内处理信息时,大脑注意力只关注吸引人的部分”:看待处理的像素没变,变的是各区域被赋予的权重。这也解释了课件里为什么用”锦江饭店”做 Query/Key/Value 例子的素材。
课件用三个例子把”角色”和”数据”分开,这套类比在被追问时非常好用:
| 场景 | Query(我在问什么) | Key(拿来匹配的标签) | Value(匹配上后取走的内容) | Attention 的结果 |
|---|---|---|---|---|
| 大脑看图 | 当前关注点”我想看这里” | 图中各物体的特征提示(”锦江饭店””行人”) | 各物体的完整信息(像素、颜色) | 看到的重点信息(”锦江饭店”被放大) |
| 搜索引擎 | 用户输入的关键词 | 网页文档的关键特征 | 完整的网页内容 | 最相关的网页排前面 |
| 机器翻译 | 当前要生成的词在 Decoder 中的表示 | 源语言各词在 Encoder 中的表示 | 源语言各词的完整信息 | 生成当前词时源语言最相关词的加权融合 |
课件特别强调一句:”Q/K/V 通常是词向量、隐藏状态或其线性变换,不一定是原始句子”;在工程实现中通常先对 Q、K、V 做线性变换到合适维度,再批量计算。
4.4 核心:一个 3×3 注意力的完全手算
课件先用一张图把三步落到具体数字上:
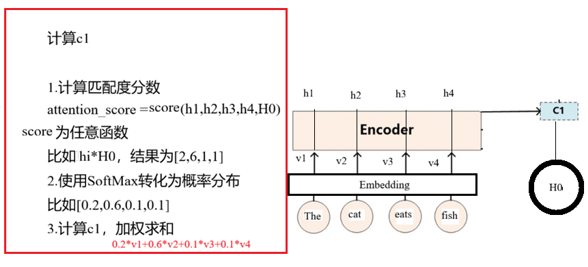
图注:课件原图的”计算 C_1“过程,右侧是 Encoder 对 The cat eats fish 的四个隐藏状态 h_1,h_2,h_3,h_4,左上角是当前解码状态 H_0。三步写得逐字可见:1.计算匹配度分数 attention_score = score(h1,h2,h3,h4,H0)(图中注明”score 为任意函数,比如 h_i\cdot H_0“),得到 [2, 6, 1, 1];2.使用 SoftMax 转化为概率分布,得到 [0.2, 0.6, 0.1, 0.1];3.计算 c1,加权求和 0.2v_1+0.6v_2+0.1v_3+0.1v_4,箭头指向结果 C_1。
下面这份手算把三道工序的每一个中间矩阵都写出来。设定:3 个 token(T=3)、d_k=4、d_v=2、batch=1。
Step 0 准备 Q、K、V(Q,K 是 3\times4,V 是 3\times2,故意让 d_v\ne d_k 以说明两者可以不同)
Q=\begin{bmatrix}1&0&1&0\\0&1&0&1\\1&1&0&0\end{bmatrix}_{3\times4}\quad
K=\begin{bmatrix}0&1&0&1\\1&0&1&0\\1&1&1&1\end{bmatrix}_{3\times4}\quad
V=\begin{bmatrix}1&0\\0&2\\2&1\end{bmatrix}_{3\times2}
Step 1 打分 S=QK^\top(逐元素点积,3\times4 与 4\times3 相乘得 3\times3)
\begin{aligned}
s_{11}&=1\cdot0+0\cdot1+1\cdot0+0\cdot1=0 & s_{12}&=1\cdot1+0\cdot0+1\cdot1+0\cdot0=2 & s_{13}&=1\cdot1+0\cdot1+1\cdot1+0\cdot1=2\\
s_{21}&=0\cdot0+1\cdot1+0\cdot0+1\cdot1=2 & s_{22}&=0\cdot1+1\cdot0+0\cdot1+1\cdot0=0 & s_{23}&=0\cdot1+1\cdot1+0\cdot1+1\cdot1=2\\
s_{31}&=1\cdot0+1\cdot1+0\cdot0+0\cdot1=1 & s_{32}&=1\cdot1+1\cdot0+0\cdot1+0\cdot0=1 & s_{33}&=1\cdot1+1\cdot1+0\cdot1+0\cdot1=2
\end{aligned}
S=QK^\top=\begin{bmatrix}0&2&2\\2&0&2\\1&1&2\end{bmatrix},\qquad \text{形状 }(T_q,T_k)=(3,3)
Step 2 缩放,除以 \sqrt{d_k}=\sqrt4=2
S’=\frac{S}{\sqrt{d_k}}=\begin{bmatrix}0&1&1\\1&0&1\\0.5&0.5&1\end{bmatrix}
Step 3 softmax 逐行归一化(每一行单独做,分母是该行 3 个 e^{s’} 之和)
\begin{aligned}
\text{第1行}&:\ e^{[0,1,1]}=[1,\ 2.7183,\ 2.7183],\ \text{和}=6.4366 \Rightarrow [0.1554,\ 0.4223,\ 0.4223]\\
\text{第2行}&:\ e^{[1,0,1]}=[2.7183,\ 1,\ 2.7183],\ \text{和}=6.4366 \Rightarrow [0.4223,\ 0.1554,\ 0.4223]\\
\text{第3行}&:\ e^{[0.5,0.5,1]}=[1.6487,\ 1.6487,\ 2.7183],\ \text{和}=6.0157 \Rightarrow [0.2741,\ 0.2741,\ 0.4519]
\end{aligned}
A=\text{softmax}(S’)=\begin{bmatrix}0.1554&0.4223&0.4223\\0.4223&0.1554&0.4223\\0.2741&0.2741&0.4519\end{bmatrix},\qquad \text{每行和}=1.0000\ (\text{三行皆如此})
Step 4 加权求和 O=AV(3\times3 乘 3\times2 得 3\times2)
\begin{aligned}
o_{11}&=0.1554\times1+0.4223\times0+0.4223\times2=1.0000 & o_{12}&=0.1554\times0+0.4223\times2+0.4223\times1=1.2669\\
o_{21}&=0.4223\times1+0.1554\times0+0.4223\times2=1.2669 & o_{22}&=0.4223\times0+0.1554\times2+0.4223\times1=0.7331\\
o_{31}&=0.2741\times1+0.2741\times0+0.4519\times2=1.1779 & o_{32}&=0.2741\times0+0.2741\times2+0.4519\times1=1.0001
\end{aligned}
O=\begin{bmatrix}1.0000&1.2669\\1.2669&0.7331\\1.1779&1.0001\end{bmatrix}=\text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right)V
这个例子里值得盯住的四个细节:
- 形状对得上:O 是 3\times2,第一维跟 Q 的 token 数一致(每个 query 得到一个输出),第二维跟 V 的特征维 d_v 一致(d_v=2\ne d_k=4,输出维度由 V 决定)。
- 每行输出是 V 各行的加权平均:比如第 1 行 o_1 是 [1,0],[0,2],[2,1] 按 (0.1554,0.4223,0.4223) 混合的结果,天然落在三者构成的凸包内。
- o_{11} 恰好是 1.0000 不是巧合:该行权重和为 1,而 V 第一列是 (1,0,2),且第 2、3 个权重相等(都是 0.4223),于是 0.1554\times1+0.4223\times2=0.1554+0.4223+0.4223=1。这是”归一化 + 加权”机制的结构性结果。
- 不缩放会明显变尖:同一组矩阵直接用 \text{softmax}(S) 得到 \begin{bmatrix}0.0634&0.4683&0.4683\\0.4683&0.0634&0.4683\\0.2119&0.2119&0.5761\end{bmatrix},第 3 行的最大权重从 0.4519 涨到 0.5761,只是 d_k=4 的差距,d_k=64 时这个差距会大到接近 one-hot。
4.5 为什么非要除以 \sqrt{d_k}
问题根源:点积的方差随维度线性增长。设 q_i,k_i 独立、零均值、单位方差,则
s=\sum_{i=1}^{d_k}q_ik_i,\qquad \mathrm{Var}(s)=\sum_{i=1}^{d_k}\mathrm{Var}(q_ik_i)=d_k
所以未缩放分数的标准差是 \sqrt{d_k}:d_k=64 时典型波动是 \pm8。用 2 万组随机向量对实测(q,k\sim\mathcal N(0,1)):
| d_k | 4 | 16 | 64 | 512 |
|---|---|---|---|---|
| \mathrm{Var}(QK^\top) | 4.00 | 16.08 | 63.41 | 505.47 |
| \mathrm{Var}(QK^\top/\sqrt{d_k}) | 1.00 | 1.01 | 0.99 | 0.99 |
后果不是”数值溢出”,而是 softmax 饱和。以两个分数、差距 s 为例,\text{softmax}([0,s])=[1/(1+e^{s}),\ e^{s}/(1+e^{s})],饱和程度和梯度 p(1-p) 如下:
| s | 0 | 1 | 2 | 4 | 8 | 16 |
|---|---|---|---|---|---|---|
| 大者概率 | 0.5000 | 0.7311 | 0.8808 | 0.9820 | 0.99967 | ≈1.0000 |
| p(1-p)(梯度量级) | 0.2500 | 0.1966 | 0.1050 | 0.0177 | 0.00034 | ≈0 |
分数一饱和,softmax 输出逼近 one-hot,对绝大多数位置 \partial\text{softmax}/\partial s\approx0,梯度传不回去;而且权重饱和后模型也失去了”随输入变化调整注意力”的能力。解决办法:
\mathrm{Var}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right)=\frac{\mathrm{Var}(QK^\top)}{d_k}=1
\qquad\Longrightarrow\qquad
\text{Attention}(Q,K,V)=\text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right)V
收益是三条:使注意力分数的方差与特征维度无关 + 保持 softmax 的梯度稳定 + 模型收敛更稳定。
课件自带的 3\times4 手算(Q,K 同上面这个结构,d_k=4)也印证了这点:QK^\top=\begin{bmatrix}0&2&2\\2&0&2\\1&1&2\end{bmatrix} 未缩放时方差约 d_k=4;除以 \sqrt{d_k}=2 后得 \begin{bmatrix}0&1&1\\1&0&1\\0.5&0.5&1\end{bmatrix},方差回到约 1,softmax 分布更均匀、梯度更稳。
一句话版本(可直接用):除以 \sqrt{d_k} 是把点积的方差从 d_k 拉回 1,防止 softmax 饱和成 one-hot、导致梯度消失。
维度账本(对应课件 4.2「常见注意力计算规则」里的公式说明):
| 张量 | 形状 | 含义 |
|---|---|---|
| Q | (batch, tgt_seq_len, d_k) |
查询向量,来自 Decoder 隐藏状态或自注意力中的同一序列 |
| K | (batch, src_seq_len, d_k) |
键向量,特征维 d_k 与 Q 相同 |
| V | (batch, src_seq_len, d_v) |
值向量,特征维 d_v(通常等于 d_k) |
| QK^\top | (batch, tgt_seq_len, src_seq_len) |
注意力分数矩阵 |
| 输出 | (batch, tgt_seq_len, d_v) |
上下文向量 |
注意:通常 d_k=d_v=d_{model},输入输出维度一致,这样层与层才能直接堆叠。
4.6 自注意力 vs 交叉注意力
公式一个字母都不变,变的是 Q/K/V 的来源:
| 类型 | Q 来源 | K / V 来源 | 并行性 | 典型结构 | 工程应用 |
|---|---|---|---|---|---|
| 普通 / 交叉注意力(Cross) | 解码器 | 编码器 | 部分并行(解码仍受自回归限制) | Encoder–Decoder Attention | 机器翻译、图文检索 |
| 自注意力(Self) | 同一序列 | 同一序列 | 全并行 | Transformer Self-Attention | BERT、GPT、ViT |
Self Attention 可理解为”Source = Target 的 Attention”,它的优势课件列了四条:任意两个 token 一步建立联系、不受序列距离影响、支持并行计算、更适合长序列建模(Transformer 的核心)。
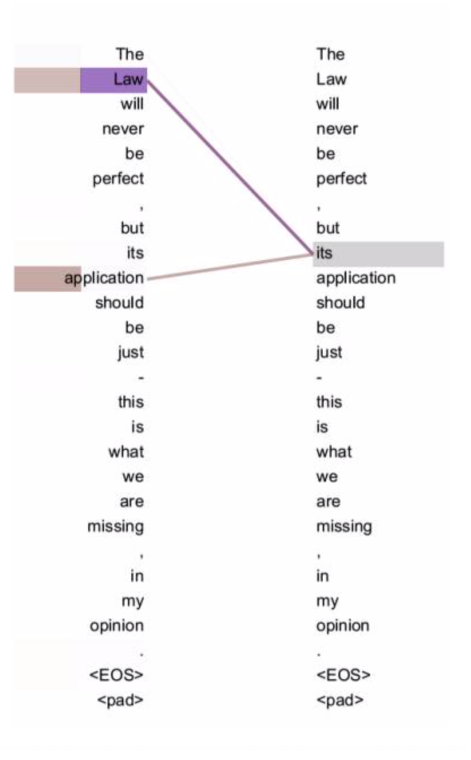
图注:一张真实的自注意力权重可视化,同一句话同时画在左右两侧,彩色竖条的长度表示权重,连线标出互相关注的 token 对。图中右侧的 its 与左侧的 Law、application 之间连线最强:模型用一层自注意力就抓住了代词与它真正的所指(同指消解),而这在 RNN 里需要跨越十几个时间步才能勉强传递到。注意左右两侧是同一序列,这就是自注意力的定义。
4.7 多头注意力:为什么要拆维度
课件在总结里把多头注意力列为注意力之后的第一项关键技术,它的动机就是”单一组 Q/K/V 的注意力只能表达一种关系”。
做法(标准 Transformer 配置):设 d_{model}=512,头数 h=8,则每个头的维度 d_k=d_v=d_{model}/h=64。
\text{MultiHead}(Q,K,V)=\text{Concat}(\text{head}_1,\dots,\text{head}_h)W^O,\qquad \text{head}_i=\text{Attention}(QW_i^Q,\ KW_i^K,\ VW_i^V)
维度切分的账:Q/K/V 先各自经线性层投影,再把最后一维均分成 h 份(等价于 h 组独立的 W_i^Q/W_i^K/W_i^V,每头输出 64 维);每头独立做一次缩放点积注意力,得到 h 个 T\times64 的输出;Concat 拼回 T\times512,最后经 W^O 融合。
为什么这样设计:
- 多子空间:不同头可以学不同的关系,有的头盯语法(主谓、指代),有的头盯位置邻近,有的头盯稀有词。单头注意力只有一套权重分布,只能表达一种”相关性”。
- 算力不涨:每头 d_k=64,单头注意力的计算量是 \mathcal O(T^2\cdot d_{model}),h 头合计仍是 \mathcal O(T^2\cdot d_{model}),总维度和单头一样,只是被切成小块并行算。这也是”多头比单头强但不更贵”的关键。
- 工程上可解释、可裁剪:注意力头是天然的粒度,模型压缩里的结构化剪枝可以整头删掉(比删单个权重更省显存、更快),蒸馏时也可以让学生学教师的注意力分布。
4.8 两种实现:加法(Bahdanau)与乘法(Luong)
| 步骤 | 乘法注意力(Luong) | 加法注意力(Bahdanau) |
|---|---|---|
| Step 1 打分 | score(Q,K)=Q\cdot K^\top | score(Q,k_i)=\boldsymbol v^\top\tanh(\boldsymbol W_Q Q+\boldsymbol W_k k_i) |
| Step 2 归一化 | \alpha=\text{softmax}(score) | \alpha=\text{softmax}([score_1,\dots,score_T]) |
| Step 3 加权求和 | context=\sum_i\alpha_i v_i | context=\sum_i\alpha_i v_i |
关键区别:乘法注意力用向量点积算分数,一次矩阵乘法就能并行算完 Q 与所有 K 的分数,效率高;加法注意力用含可学习参数 \boldsymbol W_Q,\boldsymbol W_k,\boldsymbol v 的前馈网络逐个 (Q,k_i) 算对齐分数,多了一个前馈网络,计算较慢。两者的后两步完全一样,再次印证”变体只在第一步”。
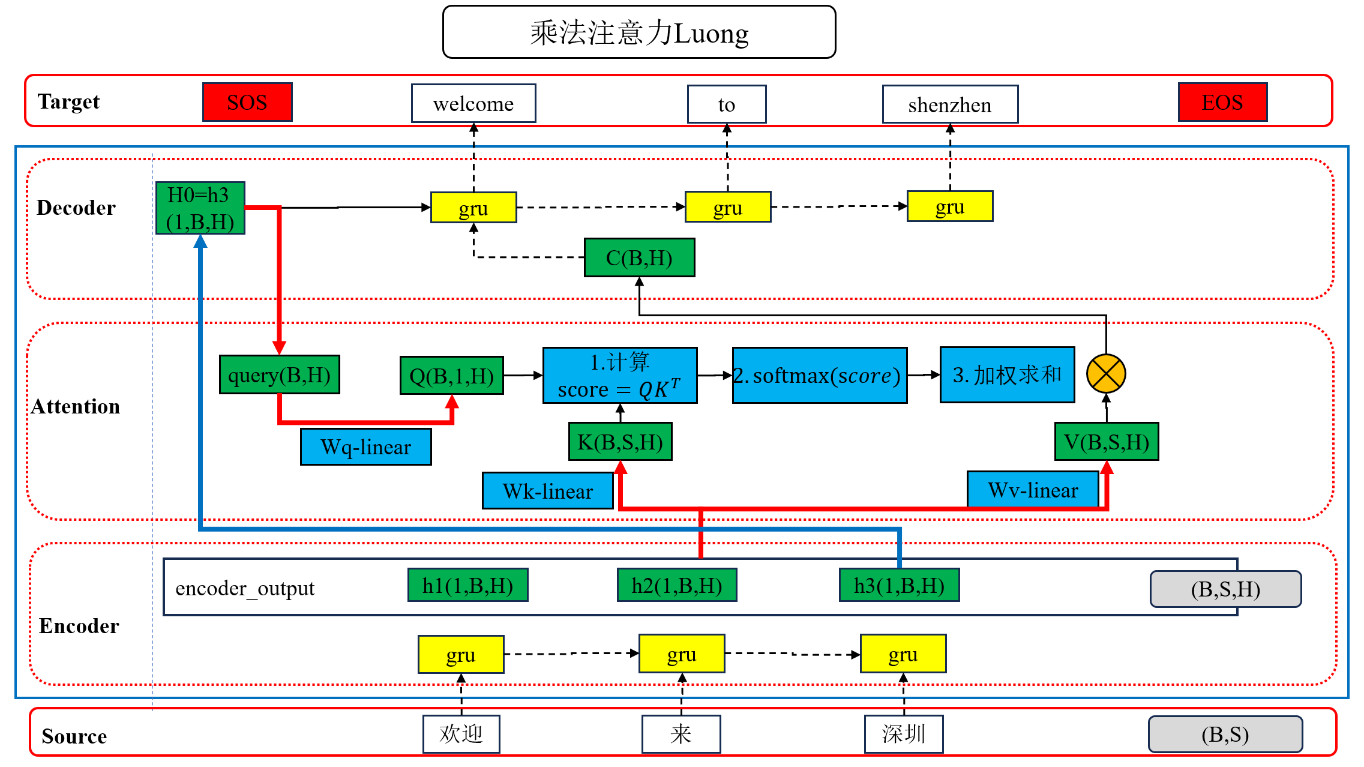
图注:乘法注意力 LuongAttention 在 seq2seq 里的完整数据流(源句 欢迎 来 深圳 → 目标 welcome to shenzhen),自下而上分三层:Encoder 三个 GRU 输出 h_1,h_2,h_3(形状 (1,B,H)),汇总为 encoder_output (B,S,H);Attention 层里 Q 由 h_3 经 Wq-linear 得到 (B,1,H)、K 由编码输出经 Wk-linear 得到 (B,S,H)、V 经 Wv-linear 得到 (B,S,H),中间三个蓝框依次是”1. 计算 score=QK^\top → 2. softmax(score) → 3. 加权求和”,加权结果再与 V 做逐元素相乘(⊗)得到 context C;Decoder 把 C 送进 GRU 生成 welcome,并把 GRU 状态回传作为下一次的 query H_0,注意红色粗线标出的就是”上一步解码状态 → 本步 query”这条自回归回路。
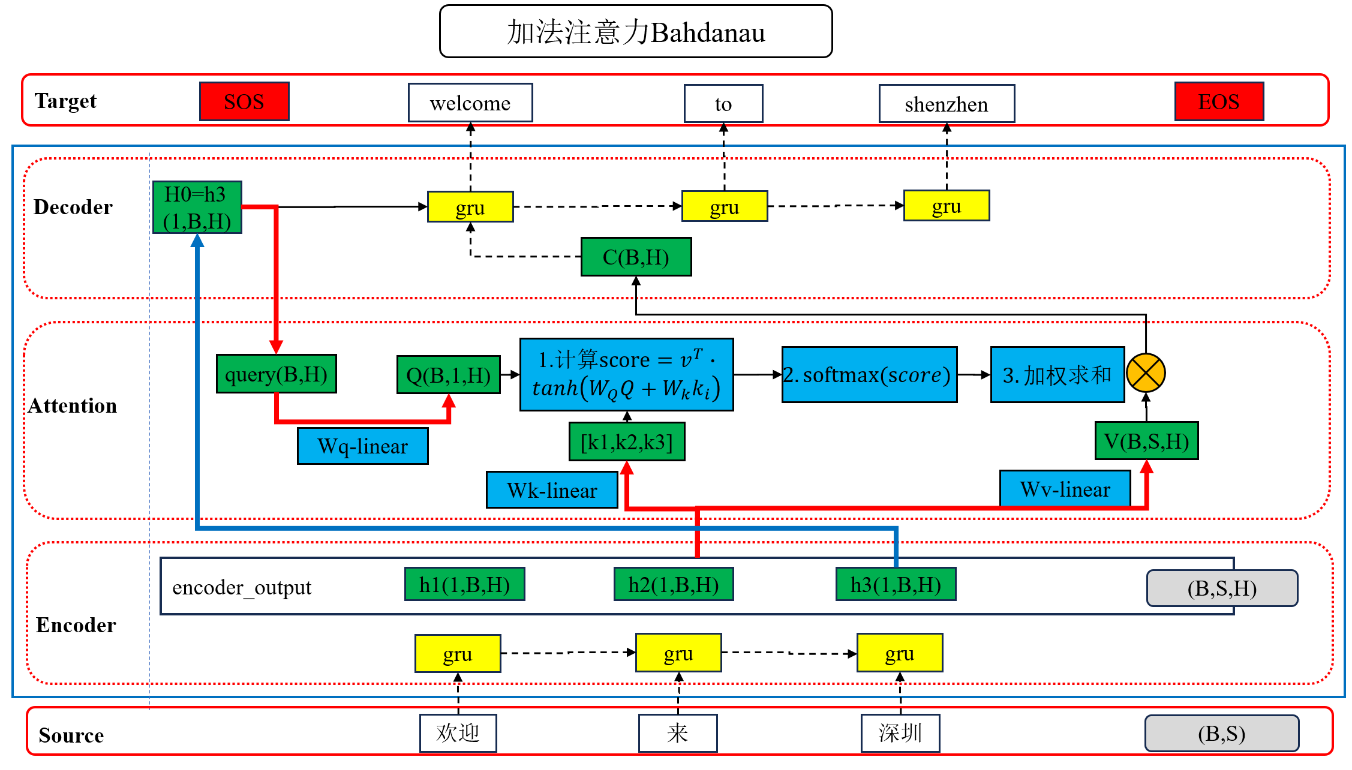
图注:加法注意力 Bahdanau 的同一张流程图。与 Luong 版对比最明显的一处:注意力层中间那个蓝框写的不是点积,而是 1.计算 score = 𝒗ᵀ · tanh(𝑾_Q Q + 𝑾_k k_i),多了 \tanh 前馈网络和可学习参数 \boldsymbol v,\boldsymbol W_Q,\boldsymbol W_k;框下方有 [k1 k2 k3] 标出”逐时间步算出的分数被拼起来”,随后才进入 2.softmax(score) 与 3.加权求和。其余结构(Wq/Wk/Wv 线性层、Encoder 的 h1/h2/h3 与 encoder_output (B,S,H)、Decoder 里 H0=h3 (1,B,H) 的 query 回路)与 Luong 版一致。
4.9 代码实现:先认清 bmm,再写注意力
课件在写模型前专门插了一节 bmm 批量矩阵乘法,因为注意力的每一步都是批量矩阵乘法:
torch.bmm:批量矩阵乘法,用于 3D 张量的矩阵乘法,做了一些优化,可以加速计算 5%
  3D: A(batch_size, m, n), B(batch_size, n, m)

torch.matmul / @:PyTorch 中通用的矩阵乘法,用于多维张量
  运算规则: A @ B 就是 A.shape[-2:] @ B.shape[-2:],前面的轴不变
  3D: A(batch_size, m, n), B(batch_size, n, m)
  4D: A(batch_size, d, m, n), B(batch_size, d, n, m)
需要掌握的: torch.matmul / @课件实测:t1(2,3,4) @ t2(2,4,3) → (2,3,3);而 4D 张量只能用 matmul/@,bmm 会报错,t1(3,2,3,4) @ t2(3,2,4,3) → (3,2,3,3)(多头注意力里两头维度一叠就是 4D,所以工程代码基本都写 @)。
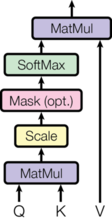
图注:缩放点积注意力在网络中的图形表示,Q 与 K 先做矩阵乘法(MatMul)得到分数矩阵,经缩放(Scale,即除以 \sqrt{d_k})后进入 SoftMax 得到注意力权重,最后与 V 再做一次 MatMul 得到输出。四个蓝色算子与公式 \text{softmax}(QK^\top/\sqrt{d_k})V 的四个步骤一一对应。
课件给出的实现把公式四步直译成四行代码:
class MyScaledDotProductAttention(nn.Module):
    def __init__(self, d_k, dropout=0.1):
        super().__init__()
        self.d_k = d_k
        self.dropout = nn.Dropout(dropout)

    def forward(self, Q, K, V):
        # 1. 打分 + 缩放: (B, tgt_len, d_k) @ (B, d_k, src_len) -> (B, tgt_len, src_len)
        scores = Q @ K.permute(0, 2, 1)
        scores = scores / self.d_k ** 0.5
        # 2. 归一化: 对最后一维(src_len)做 softmax
        attention_weights = F.softmax(scores, dim=-1)
        # 3. 加权求和: (B, tgt_len, src_len) @ (B, src_len, d_v) -> (B, tgt_len, d_v)
        output = attention_weights @ V
        return output, attention_weights
课件用 batch_size=2, tgt_seq_len=3, src_seq_len=4, d_k=32, d_v=64 跑出来,三个形状恰好验证了维度账本:scores (2,3,4) → attention_weights (2,3,4) → output (2,3,64),并且 attention_weights.sum(dim=-1) 全部是 1.0000。作业版又补上了掩码与 scale 的写法:
def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = Q.size(-1)
    scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(d_k)  # 打分 + 缩放
    if mask is not None:
        scores = scores.masked_fill(mask == 0, float('-inf'))       # 掩码
    attn_weights = F.softmax(scores, dim=-1)                        # 归一化
    output = torch.matmul(attn_weights, V)                          # 加权求和
    return output, attn_weights
课件列的两种掩码:Padding Mask(忽略填充位)与 Causal Mask(保证生成时不看未来)。实现细节上要注意掩码值填的是 -inf 而不是 0,softmax(0)=e^0=1 是个正经概率,填 0 会让 padding 位置照样分到权重。
4.10 复杂度为什么是 \mathcal O(T^2d)
单头(长度 T、特征维 d)的账:
| 步骤 | 运算 | 开销 |
|---|---|---|
| QK^\top | (T\times d)(d\times T) | T^2d 次乘加 |
| 缩放 + softmax | 对 T\times T 矩阵逐元素 / 逐行 | \mathcal O(T^2) |
| AV | (T\times T)(T\times d) | T^2d 次乘加 |
后两项被第一项和第三项吞掉,所以单头是 \mathcal O(T^2d);多头把 d 切成 h 份,每头 \mathcal O(T^2\cdot d/h),h 头合计仍是 \mathcal O(T^2d)。显存上要额外存 T\times T 的注意力矩阵(每头一份,h 头就是 h\cdot T^2),这就是长上下文吃显存的原因。
直观感受一下 d=512 的一层单头:
| 序列长度 T | 128 | 512 | 1024 | 4096 |
|---|---|---|---|---|
| 注意力矩阵元素数 T^2 | 1.6 万 | 26 万 | 105 万 | 1678 万 |
| T^2d(百万次乘加) | 8.4 | 134.2 | 536.9 | 8589.9 |
T 翻倍,算力翻 4 倍,这就是课件总结里把 FlashAttention(IO 感知的高效实现)列为当代关键技术的原因,也是工程上”别往提示词里塞无关上下文”的量化依据。
五、易错点与常见误解
-
常见说法:”Q/K/V 就是三个词向量”
实际上,Q/K/V 通常是词向量、隐藏状态或它们的线性变换,不一定是原始句子;工程里一般先用三组不同的线性层(W_Q,W_K,W_V)投影到合适维度再批量计算。
为什么:三者是角色而不是三份数据。同一个隐藏状态可以同时充当 Q、K、V(自注意力),只是各自乘了不同的参数矩阵。 -
有人以为”除以 \sqrt{d_k} 是为了防止数值溢出”
其实真正的目的是把点积的方差从 d_k 拉回 1,避免 softmax 饱和成 one-hot 导致梯度消失。
原因在于,d_k=64 时分数标准差是 8,softmax 输出已经逼近 0/1,梯度 p(1-p) 掉到 10^{-4} 量级(见 4.5 的表),梯度传不回去,训练不稳定。 -
常听到的一种说法是:”自注意力是一种新公式”
真实情况是,自注意力和交叉注意力的公式完全一样,区别只在 Q/K/V 的来源:自注意力三者来自同一序列,交叉注意力 Q 来自解码器、K/V 来自编码器。
背后的道理是,课件原话是”计算公式不变,仅计算对象发生变化”,可理解为 Source = Target 的 Attention。 -
容易想岔的地方:”硬注意力更高效,所以长文本该用硬注意力”
事实正相反,99% 的工程场景用软注意力;硬注意力是离散的 0/1 选择、不可导,需要强化学习或采样来训练,工程上几乎不用。
之所以如此,软注意力的权重是连续值且归一化,可以直接反向传播,这才是它能成为工业标准的原因。 -
先说一个误解:”attention_weights 每行和是 1,说明模型学到了合理的注意力”
实际上,行和为 1 只是 softmax 的定义性质,随机初始化的模型同样满足。
为什么:课件里attention_weights.sum(dim=-1)全部为1.0000只能验证实现正确(归一化没写错),判断注意力是否有意义要看下游指标和可视化。 -
常见说法:”输出维度由 Q 的 d_k 决定”
其实输出的最后一维等于 V 的 d_v,第二个维度等于 Q 的 token 数;d_k 与 d_v 可以不同。
原因在于,4.4 的手算里 d_k=4、d_v=2,输入 3\times4 的两个矩阵最终输出 3\times2;课件的代码例子里也是 d_k=32、d_v=64 → 输出(2,3,64)。 -
有人以为”mask 就是把 padding 位置填 0″
真实情况是,要填-inf(或加一个极大负数),让 softmax 后该位置的权重精确为 0。
背后的道理是,e^0=1 是个有效分数,填 0 相当于告诉模型”这里也有一定相关性”,padding 位置会分走权重。作业代码用的是masked_fill(mask == 0, float('-inf'))。 -
常听到的一种说法是:”4D 张量也能用
torch.bmm”
事实正相反,bmm只吃 3D 张量,4D 要用torch.matmul/@(规则是A.shape[-2:] @ B.shape[-2:],前面所有轴不变)。
之所以如此,多头注意力拼接后是 4D,所以工程代码里基本统一写@。
六、横向对比与研究脉络
(1)分数函数 / 实现方式对比
| 方法 | 原理(打分函数) | 可学习参数 | 计算效率 | 优点 | 缺点 | 典型场景 |
|---|---|---|---|---|---|---|
| 拼接注意力 Linear(了解) | \text{Linear}([Q,K]) | 有 | 中 | 形式简单,可直接学相似度 | 表达力弱于 tanh 版 | 早期/教学 |
| 加法注意力 Bahdanau(了解) | \boldsymbol v^\top\tanh(\boldsymbol W[Q,K]) | 有(\boldsymbol W,\boldsymbol v) | 低(逐时间步过前馈网络) | 灵活,对不同维度容忍度高、小维度时更稳 | 慢、不能一次矩阵并行 | 早期 NMT、短序列 |
| 乘法注意力 Luong ★ | Q\cdot K^\top | 无/少 | 高(一次矩阵乘法) | 快、可并行 | 未缩放时维度一高就不稳 | 主流 NMT |
| 缩放点积注意力(Transformer 核心)★ | QK^\top/\sqrt{d_k} | 无 | 高 | 快 + 方差稳定 + 可并行 | \mathcal O(T^2)、需要 Mask 处理 | Transformer / BERT / GPT |
(2)注意力类型对比
| 类型 | 权重 | 可导 | 训练难度 | 实用性 | 主要用途 |
|---|---|---|---|---|---|
| 软注意力 | [0,1] 连续 | 是 | 易 | ★★★ | 几乎所有任务 |
| 硬注意力 | {0,1} 离散 | 否 | 难 | ★ | 理论研究 |
| 自注意力 | [0,1] 连续 | 是 | 易 | ★★★★★ | Transformer、BERT、GPT 等 |
(3)多头 vs 单头
| 维度 | 单头注意力 | 多头注意力 |
|---|---|---|
| 表达能力 | 一套权重分布,只能表达一种相关性 | h 组子空间,可同时表达语法/位置/语义多种关系 |
| 计算量 | \mathcal O(T^2\cdot d_{model}) | \mathcal O(T^2\cdot d_{model})(不变) |
| 额外参数 | 无(或 1 组 W) | h 组 W_i^Q/W_i^K/W_i^V + 输出投影 W^O |
| 工程价值 | 难以为解释性/剪枝提供粒度 | 可逐头可视化、可按头剪枝、可蒸馏注意力分布 |
(4)演进脉络(谁解决了谁的什么问题)
词袋/词向量:词能算了,但词与词之间零交互
        ↓ 序列建模需要顺序信息
RNN / LSTM / GRU Encoder-Decoder:有了时序建模能力,但整句被压成一个固定的 C
        ↓ 一个 C 存不下长句、也拉平了所有输入词的影响力(信息瓶颈)
Bahdanau 加法注意力(2014):每步动态算一个 C_i,权重由前馈网络输出——瓶颈破了,但逐个时间步算,慢
        ↓ 效率问题
Luong 乘法注意力(2015):用点积代替前馈网络,一次矩阵乘法算完全部分数
        ↓ 点积随 d_k 增大而方差膨胀,softmax 饱和、梯度消失
Transformer(2017):除以 √d_k 修好稳定性,再用自注意力扔掉 RNN 的循环依赖,配上多头与位置编码实现全并行
        ↓ 并行 + 预训练(BERT 双向 / GPT 因果)
大模型时代:Self-Attention 成为骨架,代价是 O(T²d) —— 催生掩码工程、KV cache、FlashAttention 等高效实现
七、在新闻分类项目中的落地
(1)它出现在流水线的哪一步
新闻分类项目的四个模型是 TF-IDF + 随机森林 → FastText → BERT 微调 → LLM 零样本。本页内容集中在第三个模型:把 标题\t标签 喂给 transformers 的 BERT,做 10 分类。而 BERT 的每一层编码器 = 多头自注意力 + 前馈网络,所以:
- 微调时真正被优化的东西里,就包含每一层、每个头的 W_i^Q/W_i^K/W_i^V 与 W^O,这一页的公式就是 BERT 里那个算子的公式;
- 分类头读的是
[CLS]位置的输出表示(该位置作为 Query 去 attend 标题里所有 token 后聚合出来的向量),这就是为什么 BERT 分类不需要额外设计特征; - 一个标题里的搭配关系(球队名与”惨败”、品类词与情感词)是靠自注意力在一步之内建立的,不依赖相对距离。
(2)和项目里其它方案的具体差别
| 方案 | 词与词之间有没有交互 | 权重性质 | 换成 BERT 后的变化 |
|---|---|---|---|
| TF-IDF + 随机森林 | 无(只看词频×逆文档频率) | 全局静态:一个词在语料里的权重固定,与句子无关 | 权重变成上下文动态:同一个词在不同标题里分到的注意力不同 |
| FastText | 弱(词向量平均/池化,位置信息被抹平) | 静态词向量 | 不再把整句揉成一个平均向量,而是每个 token 得到一个”看过上下文”的表示 |
| BERT 微调 | 强(每层多头自注意力) | 动态、可微、可可视化 | ,本页知识点的主战场 |
| LLM(DeepSeek API 零样本) | 强(causal self-attention + KV cache) | 动态 | 上下文越长,注意力计算越贵;这页的 \mathcal O(T^2) 直接对应 API 的延迟和 token 计费 |
(3)关键参数与实际坑
max_length:新闻标题很短,128 足够,没必要按 512 截断,序列长度直接进 T^2 的账。attention_mask必须传(Padding Mask):batch 内长短不一要动态补齐,忘了传 mask,padding 位会被当成正常 token 分走注意力权重。- 别加 causal mask:BERT 是双向编码器,加了因果掩码等于把模型能力砍掉;Causal Mask 是 GPT 类生成模型才需要的。
- 多头数/层数不要自己改:用预训练权重自带的配置微调;自定义头数会让权重对不上。
- 学习率:微调用 2e-5 量级的小学习率,注意力层的参数已经在预训练里训得很好了,大 lr 会把它冲掉。
- 可解释性材料:把某一层某个头的 T\times T 注意力矩阵画成热力图(就是 4.6 那张图的做法),能作为被追问时”我真的理解自注意力”的证据。
(4)与模型压缩环节的衔接
项目的最后一步是压缩,注意力机制给了三个天然的着力点:
- 剪枝:多头注意力里”整头删除”是典型的结构化剪枝,比删单个权重更省显存、对硬件更友好,与项目里的结构化/非结构化剪枝对照着讲;
- 量化:注意力矩阵(T\times T 的分数/权重)是量化(QAT/PTQ/DQ)的重点对象之一;
- 蒸馏:软标签蒸馏里,除了让学生拟合最终 logits,还可以让学生拟合教师的注意力分布(注意力蒸馏),这正好复用本页的公式,教师的 \alpha 就是一份监督信号。
(5)自测清单(对应课件的代码作业)
课题作业要求不用任何注意力 API,手写一个输入形状 (batch=2, seq_len=5, d_k=16) 的 scaled_dot_product_attention,打印权重矩阵形状与每行权重之和(应近似 1.0)。这份作业正好对应 4.4 的手算过程:能默写出 3\times3 那四步矩阵,代码就写得出;能写出代码,被追问到”\sqrt{d_k} 是干嘛的”就答得顺。
八、重点问答
Q1:为什么要发明 Attention?
A:总的说,是为了修掉 Encoder–Decoder 的信息瓶颈。分三点:一是传统 seq2seq 把整句输入压成一个固定向量 C,句子一长就存不下信息,而且所有输出词共用这一个 C,模型无法区分哪个输入词更重要;二是翻译时不同目标词该关注的源词不同,比如生成”鱼”最该看 fish,但单一 C 把所有输入词的影响力拉平了;三是注意力让模型在生成每个目标词时动态算一组权重、加权求和得到专属的 C_i,从而”学会看重点”,长句翻译质量明显改善。
Q2:请讲一下 Attention 的计算过程。
A:总的是三步:打分、归一化、加权求和。第一步用打分函数算 Query 和每个 Key 的相似度,得到注意力分数;第二步对分数做 softmax,变成一组和为 1 的注意力权重;第三步用这组权重对 Value 做加权求和,得到上下文向量。Q 是”当前要查什么”,K 是”每个位置拿来匹配的标签”,V 是”匹配上之后真正取走的内容”。所有注意力变体,加法、乘法、自注意力、交叉注意力,差别只在第一步的分数函数和 Q/K/V 的来源,后两步永远一样;写成公式就是 \text{Attention}(Q,K,V)=\text{softmax}(\text{score}(Q,K))\cdot V。
Q3:缩放点积注意力的公式是什么?为什么除以 \sqrt{d_k}?
A:公式是 \text{softmax}(QK^\top/\sqrt{d_k})V。原因是控制方差:假设 Q、K 的元素独立同分布于标准正态,那么点积 \sum q_ik_i 的方差正好是 d_k,也就是分数的标准差是 \sqrt{d_k},d_k=64 时典型波动是 ±8。分数一大,softmax 就被推到接近 one-hot:两个分数差 8 的时候,大的那方概率已经 0.9997,导数 p(1-p) 掉到 10^{-4},梯度基本传不回去,训练不稳。除以 \sqrt{d_k} 把方差拉回 1,让 softmax 工作在梯度健康的区间,这也是我实测过的:d_k 从 4 到 512,未缩放分数的方差从 4 涨到 505,缩放后始终接近 1。
Q4:加法注意力和乘法注意力有什么区别?
A:总的说,区别只在打分函数,后两步一样。加法注意力(Bahdanau)用 \boldsymbol v^\top\tanh(\boldsymbol W_Q Q+\boldsymbol W_k k_i),带着可学习的前馈网络逐个 (Q,k_i) 算对齐分数,表达灵活但慢,很难一次并行算完;乘法注意力(Luong)直接算点积 QK^\top,一次矩阵乘法就得到全部分数,效率高、天然并行,缺点是维度一高分数方差就大、需要缩放。工程上主流是乘法,Transformer 用的就是它加上 \sqrt{d_k} 缩放。实际代码里通常先把 Q、K、V 线性变换到合适维度再批量算。
Q5:自注意力和交叉注意力有什么区别?
A:公式完全一样,区别只在 Q/K/V 从哪来。自注意力的 Q、K、V 全部来自同一个序列,可以理解成 Source = Target 的注意力,好处是任意两个 token 一步就能建立联系、不受距离影响,而且完全不依赖上一步、能全并行;交叉注意力的 Q 来自解码器、K 和 V 来自编码器,是标准的 Encoder–Decoder 结构。BERT 和 GPT 里堆的都是自注意力,机器翻译解码器里会用交叉注意力去读编码器的输出。
Q6:多头注意力为什么要拆成多个头?
A:总的是”同样的算力,更多的表达视角”。每个头把 d_{model} 切成 d_{model}/h 维(比如 512 切成 8 个 64 维),各自做一次独立的注意力,算完 concat 起来再过一个输出投影 W^O。这样不同的头可以学到不同的关系,有的盯语法、有的盯指代、有的盯邻近位置;而计算量并不会增加,因为每头维度小了、总维度没变,还是 \mathcal O(T^2d_{model})。另外多头在工程上还有附加值:头是一个天然的粒度,可以做逐头可视化、按头剪枝,蒸馏时也能直接让学生学教师的注意力分布。
Q7:Attention 的计算复杂度是多少?为什么长文本这么贵?
A:单头是 \mathcal O(T^2d)。算账是这样:QK^\top 是 T\times d 乘 d\times T,T^2d 次乘加;softmax 是 T^2 量级;最后权重乘 V 又是 T^2d,所以 T^2d 主导。多头把 d 切成 h 份,每头 \mathcal O(T^2 d/h),加起来不变。真正的痛点还有显存:T\times T 的注意力矩阵每头存一份,T 从 512 涨到 4096,矩阵元素数从 26 万涨到 1678 万,T^2d 从 134 百万次乘加涨到 8590 百万。这就是为什么长上下文要上 KV cache、FlashAttention 这类 IO 感知的实现,也是提示词里不该塞无关内容的原因。
Q8:注意力里的 Mask 有哪些?怎么实现?
A:主要有两种。Padding Mask 用来忽略补齐出来的填充位,同一 batch 里句子长短不一时必须加;Causal Mask 是上三角掩码,保证生成第 t 个词时只能看到前 t-1 个位置,GPT 这类自回归模型必须加,而 BERT 这种双向编码器不加。实现上都是给要屏蔽的位置填负无穷(scores.masked_fill(mask == 0, float('-inf')))再 softmax,这样被屏蔽位置的权重精确为 0。注意不能填 0,e^0=1 是个有效分数,padding 位置会照样分到权重。
九、延伸阅读
论文
- Bahdanau, Cho, Bengio. Neural Machine Translation by Jointly Learning to Align and Translate — arXiv:1409.0473(加法注意力的原始论文)
- Luong, Pham, Manning. Effective Approaches to Attention-based Neural Machine Translation — arXiv:1508.04025(乘法/点积注意力,含 global/local 对比)
- Vaswani et al. Attention Is All You Need — arXiv:1706.03762(缩放点积注意力、多头注意力、位置编码)
- Devlin et al. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding — arXiv:1810.04805(双向自注意力 +
[CLS]分类) - Dao et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness — arXiv:2205.14135(\mathcal O(T^2) 显存瓶颈的高效实现)
教程 / 可视化
- Jay Alammar, The Illustrated Transformer(把 Q/K/V 和多头画成图,配合本页 4.6 那张自注意力可视化看效果最好)
- Jay Alammar, Visualizing A Neural Machine Translation Model (Mechanics of Seq2seq Models With Attention)(Bahdanau 注意力的逐词对齐动画)
- Lilian Weng, Attention? Attention!(注意力机制的分类与变体综述)
- Harvard NLP, The Annotated Transformer(附可运行代码的逐行实现)
工具 / 文档
- PyTorch 官方文档:
torch.matmul/torch.bmm(批量矩阵乘法与广播规则)、torch.nn.MultiheadAttention、torch.nn.functional.softmax transformers文档:AutoModelForSequenceClassification与output_attentions=True(直接取回每层每头的注意力权重做可视化)
原图存档(9 张,均已就近插入正文)
| 序号 | 文件 | 所在小节 | 内容 |
|---|---|---|---|
| 1 | assets/day04_注意力机制/atten_02.png |
4.3(Q/K/V 生活例子的图源) | 黑白街景照片(”锦江饭店””喜运来大酒家”招牌),作为”人看复杂场景时会自动聚焦关键信息”的原始场景 |
| 2 | assets/day04_注意力机制/atten_03.png |
4.3(同上,紧随其后) | 同一张街景图的”模糊外围、只保留关注点”版本,”锦江饭店”竖排招牌被保留、其余被淡化,对应”大脑注意力只关注吸引人的部分” |
| 3 | assets/day04_注意力机制/atten_01.png |
4.1 无 Attention 的 Encoder–Decoder | 单一中间语义向量 C 共享给所有输出词的框架图 |
| 4 | assets/day04_注意力机制/atten_06.png |
4.2 加 Attention 的 Encoder–Decoder | 每步动态计算 C_i 的注意力框架图 |
| 5 | assets/day04_注意力机制/atten_07.png |
4.4 三步计算 | 注意力计算三步的可视化:score=h_i·H0 得 [2,6,1,1] → softmax 得 [0.2,0.6,0.1,0.1] → 加权求和 0.2v_1+0.6v_2+0.1v_3+0.1v_4 得 C_1 |
| 6 | assets/day04_注意力机制/atten_13.png |
4.6 自注意力 | 一句话的 self-attention 权重可视化,its 与 Law/application 之间连线最强 |
| 7 | assets/day04_注意力机制/atten_14.png |
4.8 乘法注意力 | LuongAttention 完整数据流(源句 欢迎来深圳 → welcome to shenzhen) |
| 8 | assets/day04_注意力机制/atten_15.png |
4.8 加法注意力 | BahdanauAttention 完整数据流,打分框为 \boldsymbol v^\top\tanh(\boldsymbol W_Q Q+\boldsymbol W_k k_i) |
| 9 | assets/day04_注意力机制/110.png |
4.9 代码实现 | 缩放点积注意力的网络实现图:MatMul → Scale → SoftMax → MatMul |
其中第 1、2 张(
atten_02/atten_03)在抽取稿中位于 2.1「注意力机制的核心思想」一节;为保持论证链完整,本文把它们与 4.3 的 Q/K/V 生活例子合并呈现(选取 Query/Key/Value 类比的语境一致)。另外atten_06.png在抽取稿中被 2.2.2 与 3.3 两处引用,本文只在 4.2 插入一次,避免重复占版。