研究定位
目标检测都在预测类别和边界框,但“谁负责预测一个目标”不同:anchor-based 由预设框负责,anchor-free 由位置/中心负责,DETR 则由 object query 负责。
方法演化
YOLOv3:多尺度 anchor-based 检测
YOLOv3 在多个特征尺度上预测 anchor 的位置偏移、objectness 与类别。大特征图偏向小目标,小特征图偏向大目标;推理后通常需要 NMS 删除重复框。
FCOS:位置直接回归四条边
特征点预测到目标框四边的距离 (l,t,r,b),centerness 抑制偏离目标中心的低质量预测。它取消了 anchor 的尺寸比例设计,但仍需要正负样本分配规则。
Cascade R-CNN / HTC:逐级精修
多阶段检测头使用逐渐提高的 IoU 阈值,把候选框一步步修准。HTC 又让框与 mask 分支跨阶段交互。精度导向明显,但推理链更重。
DETR:把检测改写为集合预测
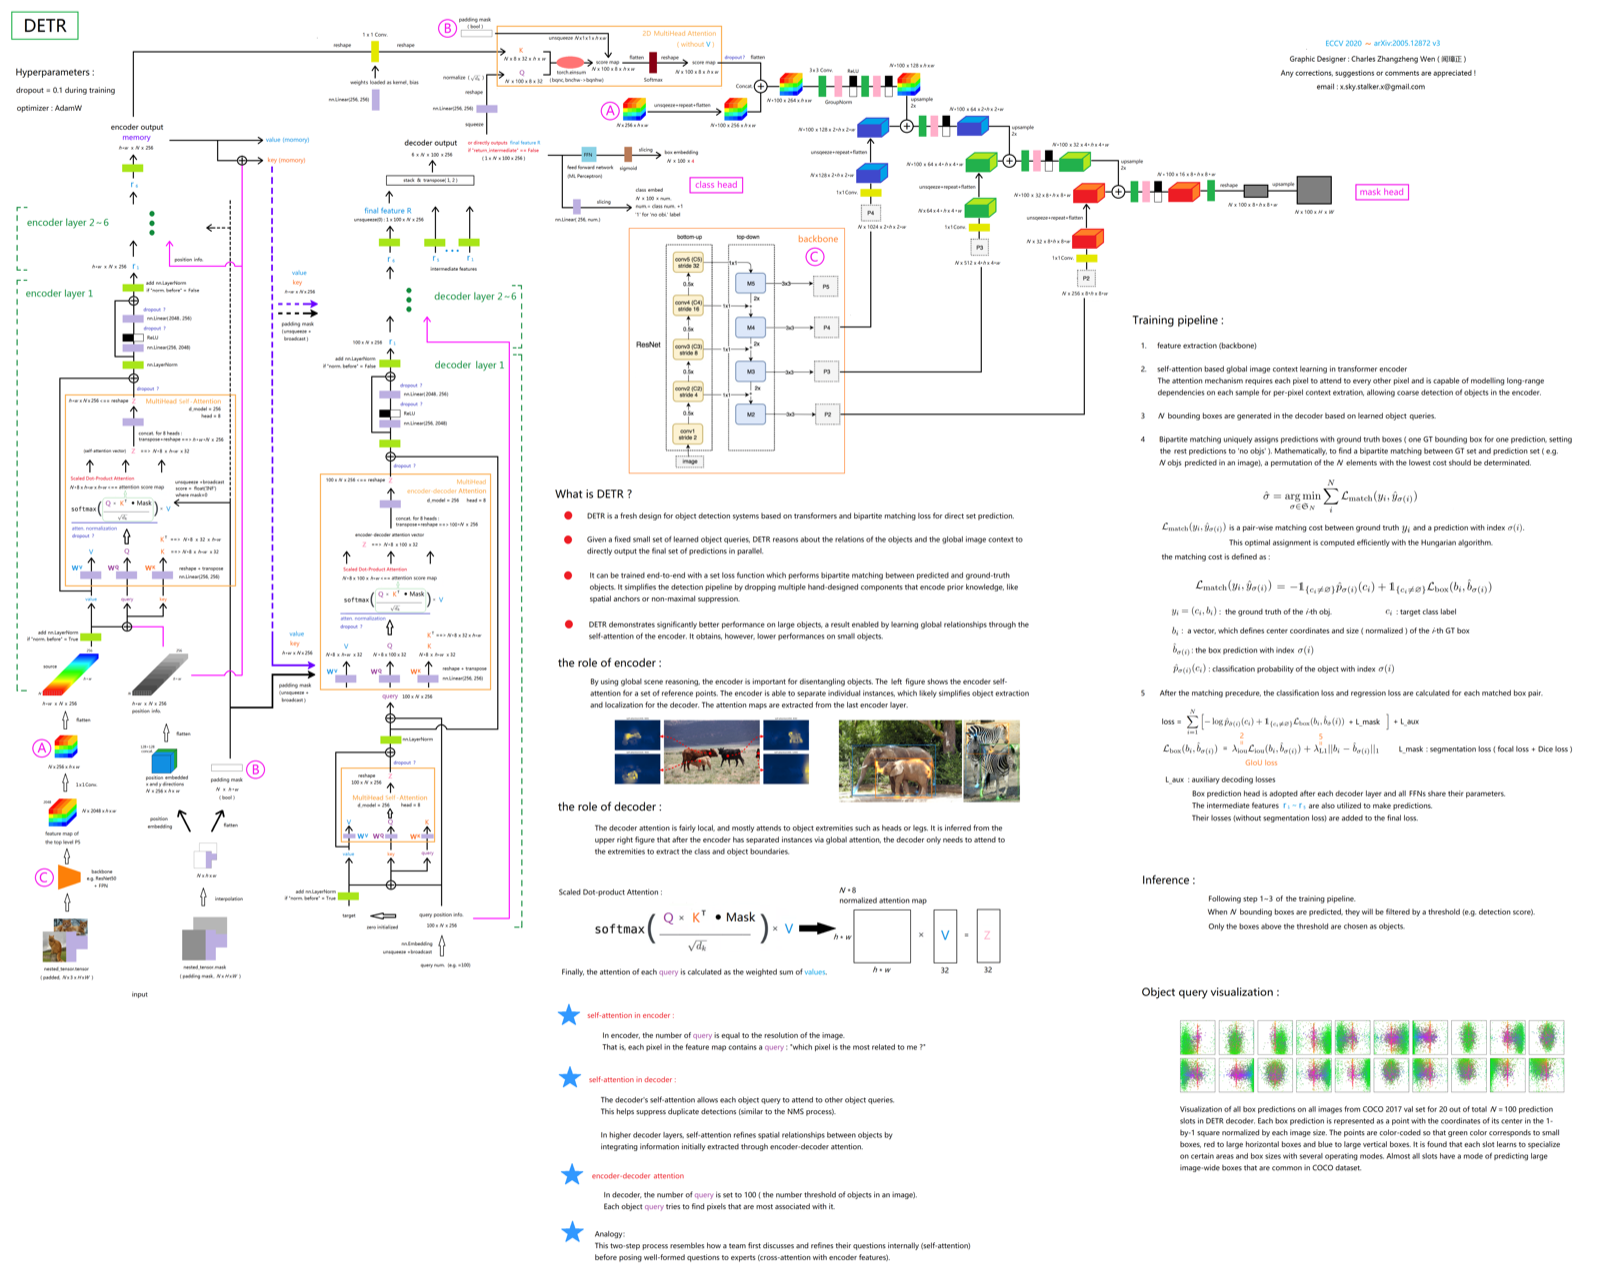
固定数量 object queries 经过 Decoder 后输出类别、框或 no-object,再通过匈牙利算法做一对一匹配:
σ̂ = arg minσ∑iℒmatch(yi, ŷσ(i))
因为一对一监督直接约束重复预测,经典 DETR 不依赖传统 NMS。问题是收敛慢、小目标能力较弱。
Deformable DETR 与检测版 DINO
Deformable Attention 不和整张高分辨率特征图所有位置比较,而是围绕参考点在多尺度特征上学习少量采样点,改善效率、收敛和小目标表现。检测版 DINO 再通过去噪训练、query 初始化和逐层框精修稳定训练。
其他图片可以放回同一张地图:BorderDet 显式利用边界;MimicDet 用强分支指导轻分支;DCL 处理旋转角度的周期性;SaccadeNet 拆分中心定位与目标描述。
研究小结
检测模型一直在回答三个问题:候选由谁产生、正负样本怎样分配、重复结果怎样处理。沿着这三点阅读模型,比只罗列模块名称更稳定。
研究延伸
目标检测可以按三个研究问题继续整理:候选如何生成,正负样本如何分配,重复预测如何消除。YOLO、FCOS、Cascade R-CNN、DETR、Deformable DETR 和检测版 DINO 都可以放进这个框架。
建议补充实验维度:小目标、密集目标、长尾类别、推理延迟和后处理成本。检测论文中的 AP 提升往往依赖数据集、尺度、增强策略和训练时长,单独摘数值容易误导。