研究定位
计算图就是一张“变量之间如何计算”的账本;前向传播计算结果,反向传播沿着账本用链式法则计算梯度。
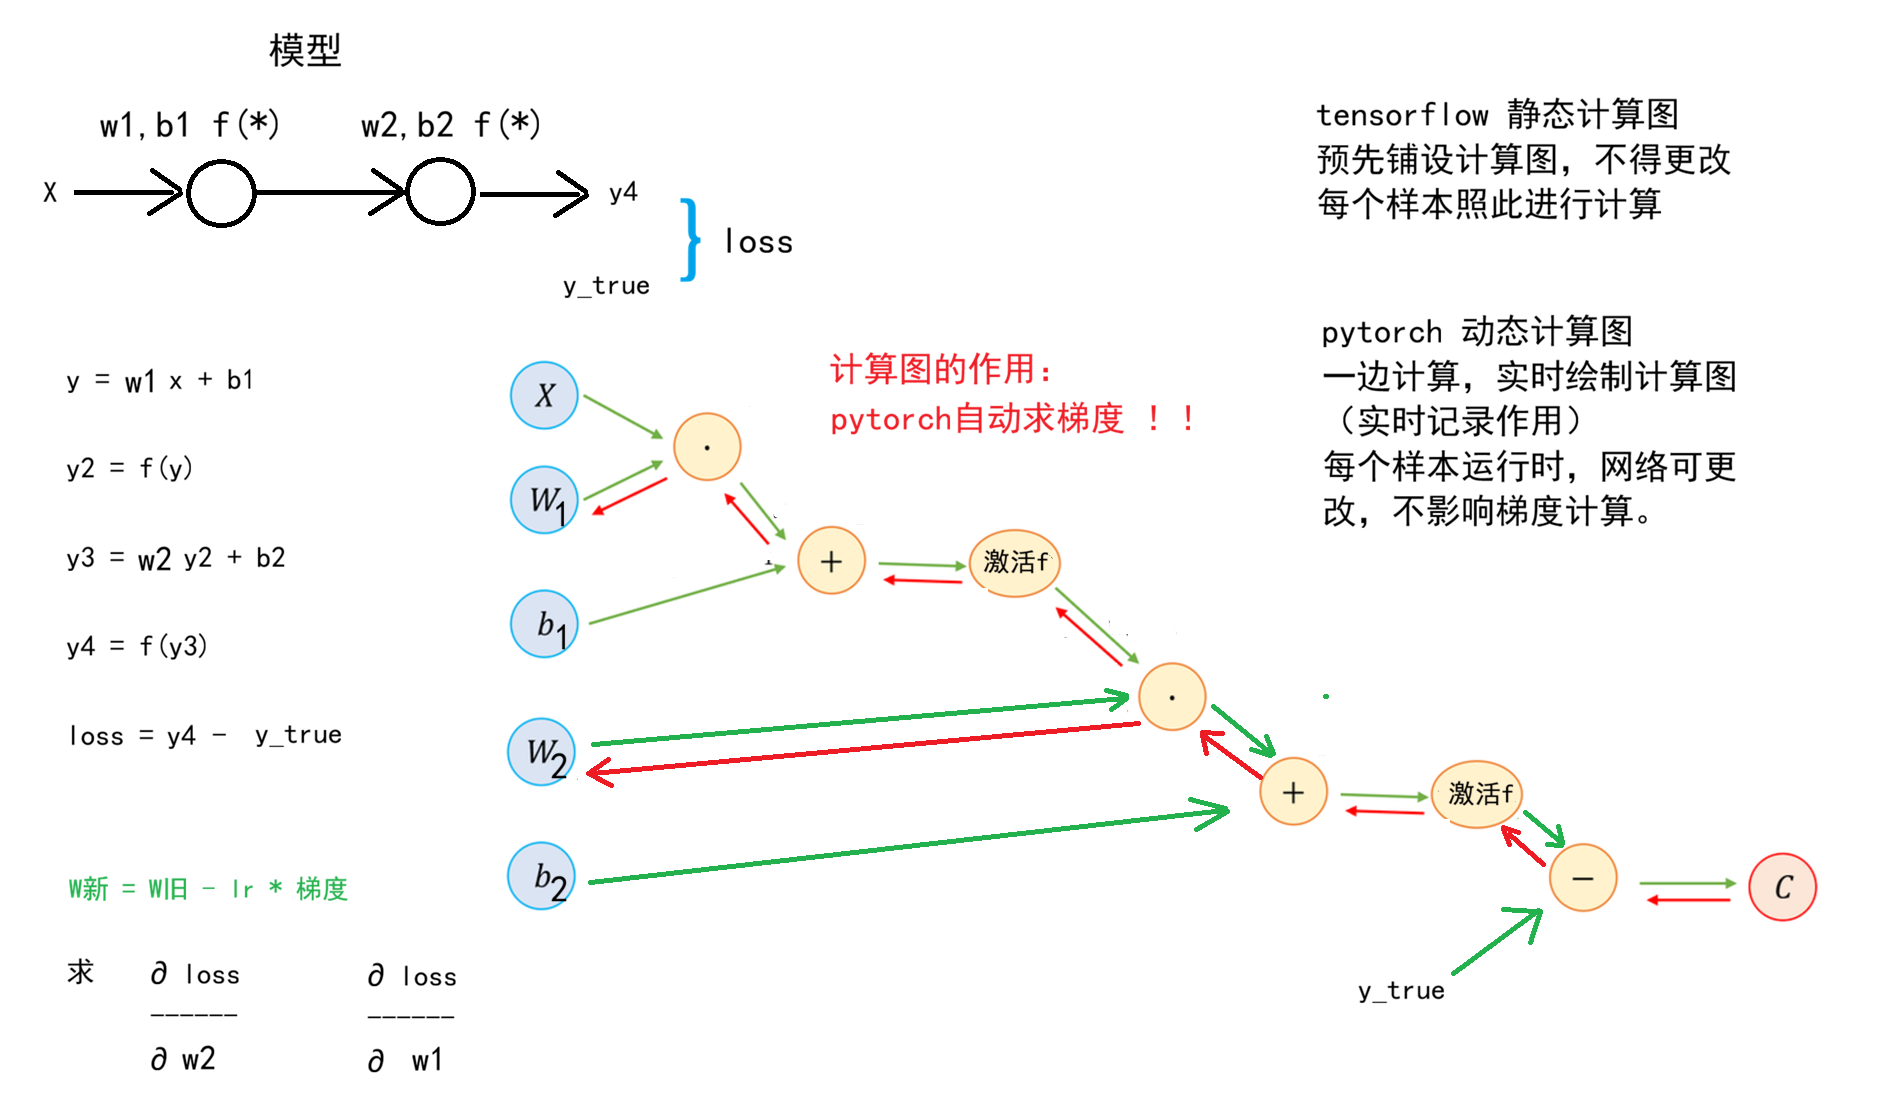
数据流与机制
设两层模型:
z1 = w1x + b1, h = f(z1), ŷ = w2h + b2
L = (ŷ − y)2
前向是 x → z₁ → h → ŷ → L。反向则从损失开始:
$$
\frac{\partial L}{\partial w_1}
=\frac{\partial L}{\partial \hat y}
\frac{\partial \hat y}{\partial h}
\frac{\partial h}{\partial z_1}
\frac{\partial z_1}{\partial w_1}
$$
PyTorch 中完整训练步骤是:
optimizer.zero_grad()
logits = model(x)
loss = criterion(logits, y)
loss.backward()
optimizer.step()backward()计算梯度,不更新参数。step()才根据梯度更新参数。- 梯度默认累积,所以普通训练每轮先清零。
CrossEntropyLoss通常接收原始 logits,不先做 Softmax。model.eval()只改变部分层行为;推理还应使用no_grad()或inference_mode()。
资料中的 FigureCanvasInterAgg 报错属于 IDE 绘图后端与 Matplotlib 版本契约问题,不能直接归因于模型。先验证脚本是否可以 savefig(),再检查 IDE、插件和后端版本。
研究小结
数据 → 模型 → logits → loss → backward → gradient → step 是后续所有深度学习模型共同的训练骨架。模型再复杂,也没有跳出这条主线。
研究延伸
计算图不仅是训练步骤说明,也是分析深度学习系统的统一工具。后续可以补充三类实验:梯度消失/爆炸的数值观察、不同优化器对同一 loss surface 的路径差异、no_grad() 与 inference_mode() 对显存和速度的影响。
读论文时也可以沿着计算图追问:哪些张量需要保存给反向传播?哪些操作阻断梯度?显存峰值来自激活、参数、梯度还是优化器状态?