研究定位
并行主要解决两个不同问题:模型能放进单卡但训练太慢,或者模型本身已经放不进单卡。前者优先想到数据并行,后者才需要切模型。
并行策略与代价
数据并行:复制模型,切分 batch
GPU0: 模型 M + batch₀ → grad₀ ┐
GPU1: 模型 M + batch₁ → grad₁ ├→ All-Reduce → 参数保持一致
GPU2: 模型 M + batch₂ → grad₂ ┘
若单卡 batch 为 b,卡数为 n,全局 batch 通常为 B = nb。它提高吞吐,但会增加梯度通信;全局 batch 变化还可能要求调整学习率。
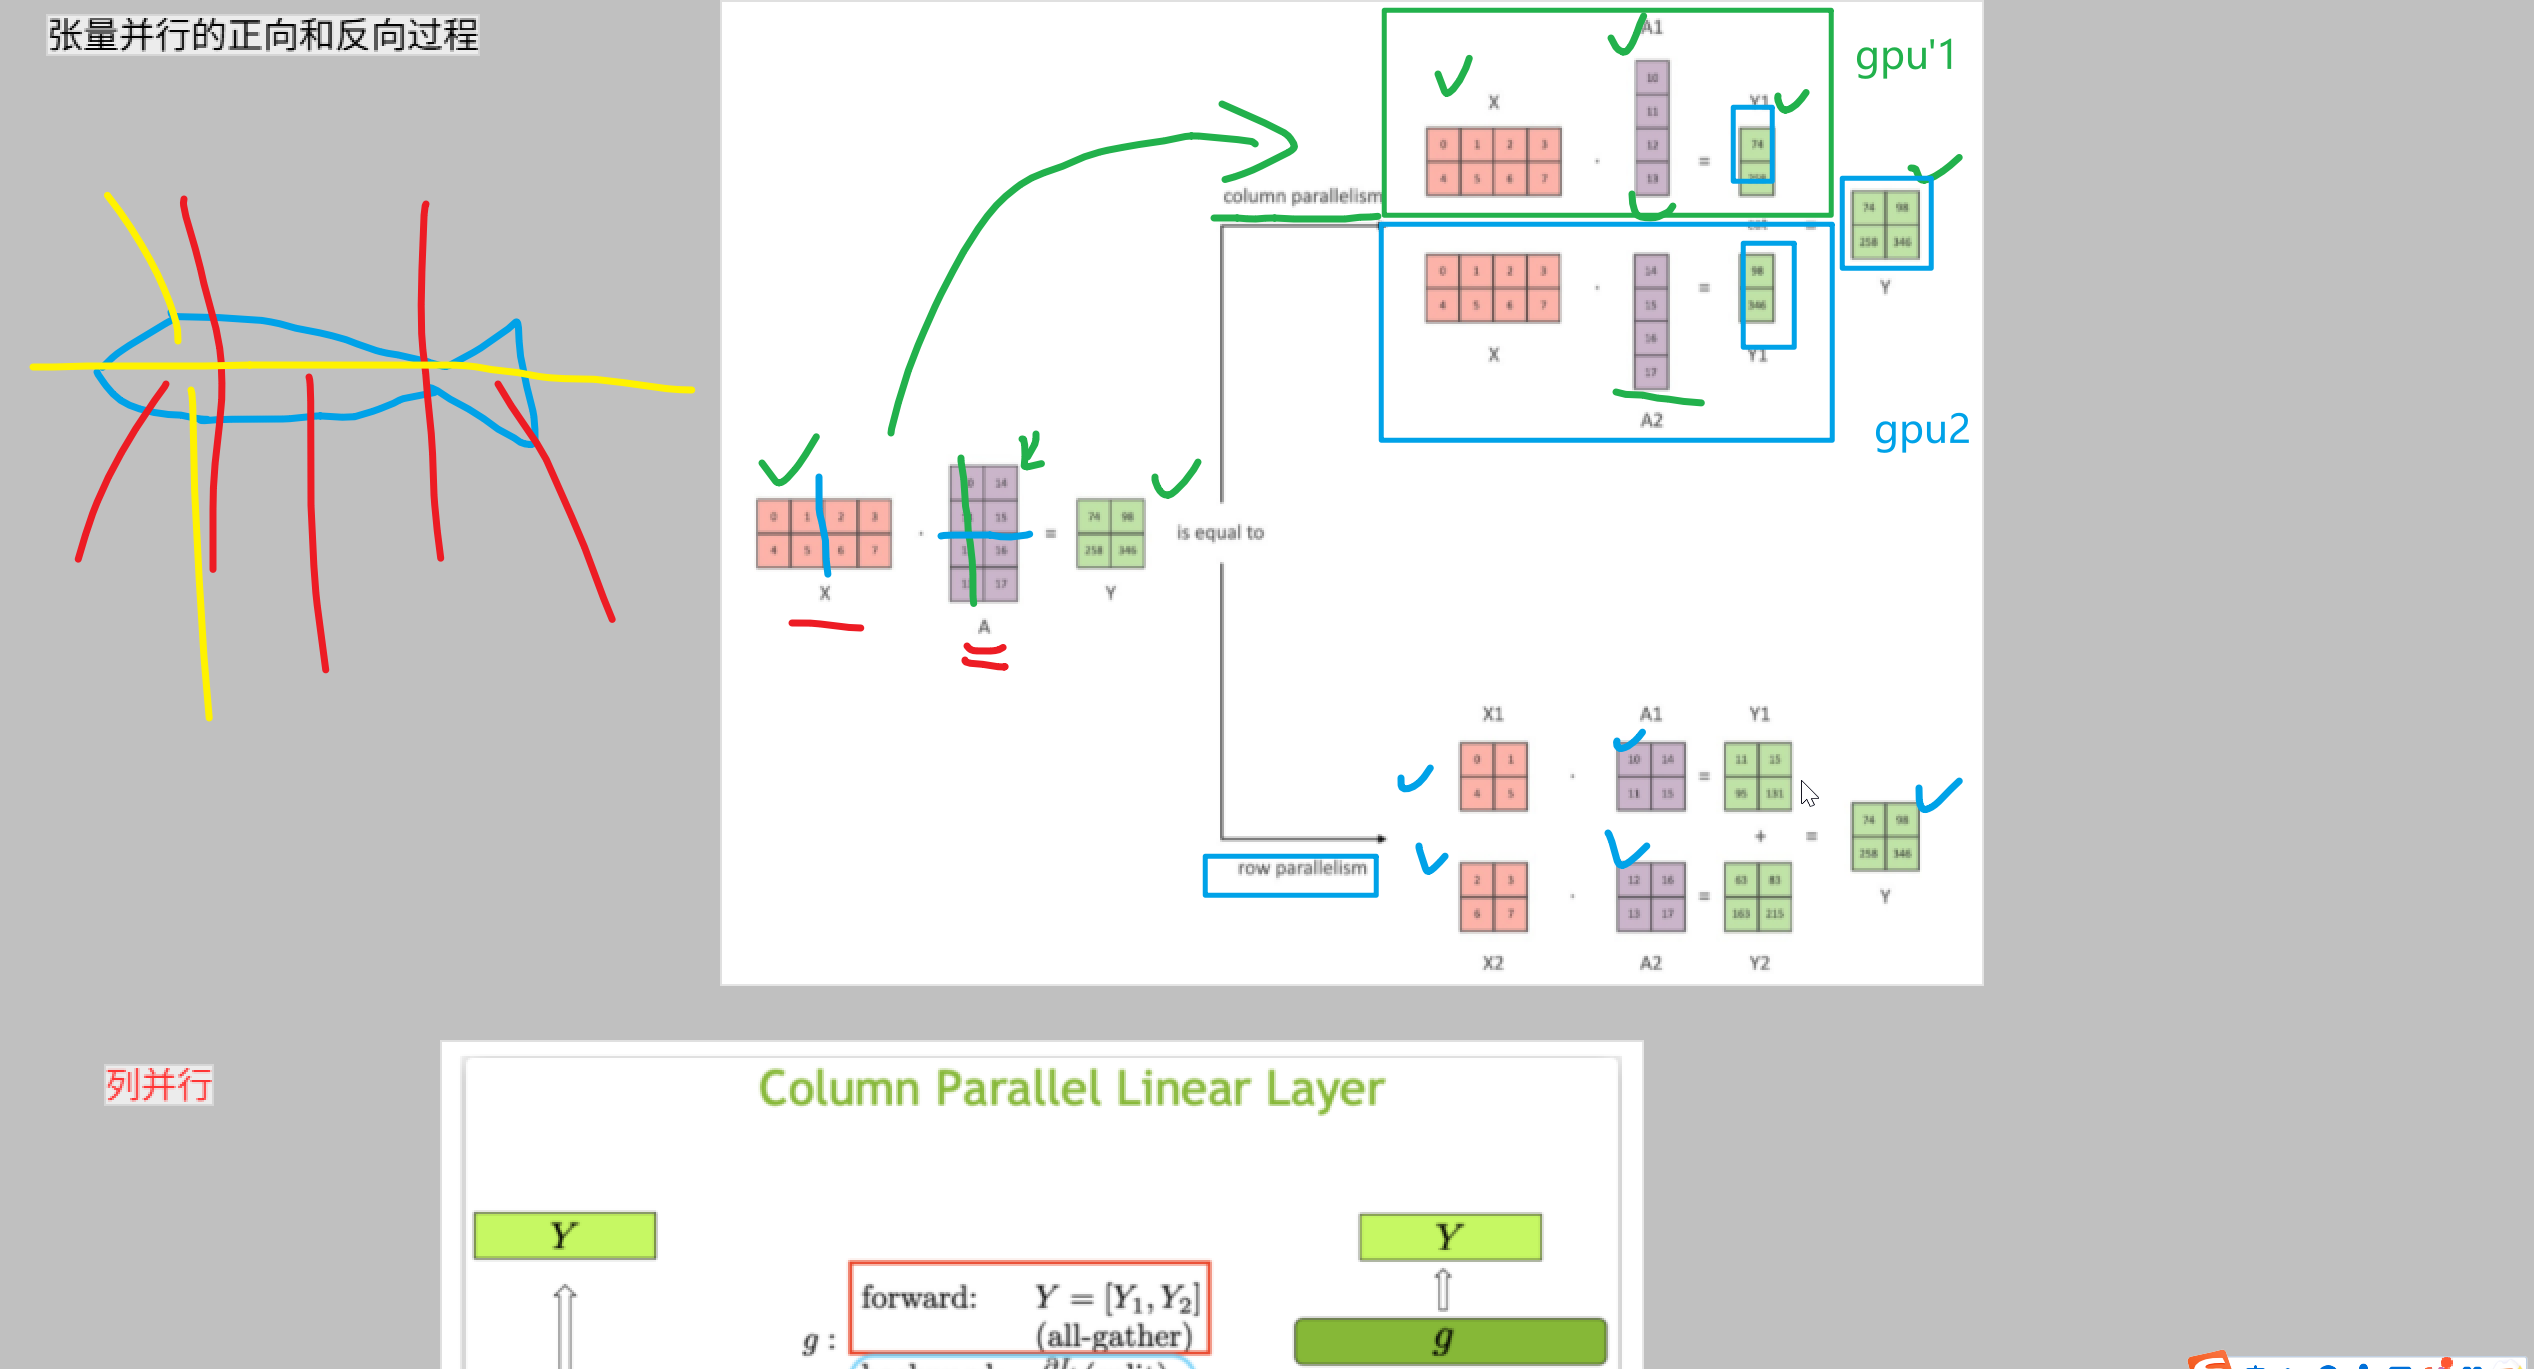
张量并行:切分一层的矩阵
Y = XW, W = [W1, W2, …, Wn]
列并行让各卡计算 Yi = XWi 后拼接;行并行则让各卡计算部分和,再归约。它适合单层权重就很大的模型,但层内通信更频繁。
继续扩展
- 流水线并行:不同 GPU 放不同层或阶段。
- ZeRO/FSDP:分片参数、梯度与优化器状态。
- 混合并行:数据、张量、流水线往往组合使用。
资料里的 KMP_DUPLICATE_LIB_OK=TRUE 只是 OpenMP 重复加载的临时绕过,不是修复。更可靠的方法是统一 Python 解释器与包来源,并在最小新环境中复现;不要随意删除 DLL。
研究小结
- 模型放得下,只缺吞吐:数据并行。
- 模型或单层放不下:张量/流水线并行。
- 优化器状态也放不下:参数与状态分片。
- 多卡不等于线性加速,通信和负载均衡决定实际收益。
研究延伸
并行策略的研究重点不是“能不能切”,而是通信、显存和计算之间的交换。后续可以补一个小表:数据并行、张量并行、流水线并行、ZeRO/FSDP 分别切分什么,通信发生在什么时刻,瓶颈随 batch size 和模型规模如何变化。
实验上可记录单卡、DDP、多卡梯度累积的吞吐和显存曲线。只看是否跑通不够,应该把利用率、通信等待和收敛差异一起写下来。