用「房价 / 红豆绿豆」这类最小例子,把 KNN → 线性回归 → 逻辑回归 → 决策树 → 随机森林 五个模型串成一条「从单点到集成」的主线,是 3.1 随机森林模型的前置基础课。
一、这份材料解决什么问题
这份材料是「3.1 随机森林模型」这一节的前置总复习。它不追求完整覆盖机器学习,而是回答一个很具体的问题:一个只会写代码、没系统学过 ML 的工程师,要理解随机森林为什么有效,最少必须先懂哪些模型?
课件的答案是一条最短的阶梯:
- KNN,最朴素的「看邻居」:分类靠投票,回归靠取平均。它让人先建立「样本 + 距离 + 标签」的直觉。
- 线性回归,把「找规律」变成「拟合一条直线 y = ax + b」,第一次出现参数和损失。
- 逻辑回归,线性回归 + Sigmoid + 交叉熵,把回归的输出压到 (0,1) 当概率用,于是回归的壳子里装进了分类。
- 决策树,换一套完全不同的思路:不拟合参数,而是不断切分特征空间,判据是「切完两边尽可能纯净」。
- 随机森林,单棵决策树容易过拟合、方差大,于是「三个臭皮匠赛过诸葛亮」:样本随机采样 + 特征随机采样,训练多棵不同的树,多数表决。
在新闻分类项目流水线里,这条阶梯的终点就是第一个基线模型:TF-IDF 向量化 → 随机森林分类(10 类新闻标题)。也就是说,这份课件讲的全是那条基线背后每一步「为什么可以这么做」。被追问「你的基线模型为什么选随机森林、它的准确率可信吗、你怎么知道没调过头」,答案都在这里。
二、核心结论
- 分类与回归的差别只在输出空间:输出是离散类别(大房/小房)就是分类,输出是连续数值(房价多少万)就是回归。同一个算法两副面孔,KNN 既能分类(投票)也能回归(取均值),逻辑回归名字里带「回归」却是分类算法。
- KNN 没有训练过程:它把全部工作推到预测时(懒惰学习),预测要算新样本和所有训练样本的距离,因此特征必须先归一化,否则量纲大的特征会单方面决定「谁近」。
- 逻辑回归 = 线性回归 + Sigmoid + 交叉熵损失,输出是「属于正类的概率」,按 0.5 阈值判类;决策边界仍是线性的。(PPT 原句,也是这句的标准拆解)
- 决策树的核心是纯度:在所有特征、所有切分点里,选纯度提升最大的那一刀先切,让树尽量矮。纯度用熵/信息增益或基尼不纯度度量。它是贪心算法,只保证每一步局部最优,不保证全局最优。
- 随机森林 = Bagging + 特征随机 + 多数表决:样本有放回抽样(bootstrap)让每棵树看到约 63% 的不同数据,特征子集让每棵树的「看问题角度」不同,最后投票。目的是降方差,所以它比单棵树更稳、更不容易过拟合,代价是失去单棵树的可解释性。
三、知识地图
按课件 6 页的原有顺序整理(这份材料整体权重是【理解】,即要求懂原理、能说清为什么,不要求手推公式):
- 第 1 页 KNN 分类【理解】
- 有标签数据 → 新数据看离谁近 → 少数服从多数(投票)
- 第 2 页 KNN 回归【理解】
- 流程与分类一致,最后不是投票,而是「根据最近的几个点得到数值」
- 第 3 页 线性回归【理解】
- 找一条最佳直线 y = ax + b 拟合已知点;新数据代入直线方程得预测值(例子:面积 → 价格,100 平)
- 第 4 页 逻辑回归【理解】
- 本质是分类算法:找一条最佳直线划分数据点 → 代入 Sigmoid 变成 0~1 → 大于 0.5 判大房、小于 0.5 判小房
- 公式化表达:逻辑回归 = 线性回归 + Sigmoid 函数 + 交叉熵损失
- 第 5 页 决策树【理解】
- 寻找划分方式,使划分后两边「尽可能纯净」
- 在所有特征中选「纯度提升最大」的特征作为第一个分裂点,让树尽可能矮
- 训练是渐进的:一开始可能按「大小」分(效果一般),后来才找到按「颜色」分(效果好)
- 例子:50 颗红豆 + 50 颗绿豆,比较「颜色 / 大小 / 形状」三种划分的纯度
- 第 6 页 随机森林【理解】
- 数据集随机采样 + 特征也随机采样 → 训练不同的决策树 → 若干树同时分类 → 投票,少数服从多数
- 结论:结果更稳定、更可靠
- 课件未展开、但考查重点的补全【通识补充】
- 监督 / 无监督 / 半监督;分类 / 回归 / 聚类
- 过拟合与欠拟合、偏差-方差分解
- 训练集 / 验证集 / 测试集划分与交叉验证
四、原理详解
4.0 先把任务全景图补齐(通识补充)
课件直接从模型开始讲,但被问到的第一个问题通常是「机器学习分几类」。按标签有无切:
| 类型 | 训练数据 | 任务 | 代表算法 |
|---|---|---|---|
| 监督学习 | 有标签 (x, y) | 分类、回归 | KNN、线性/逻辑回归、决策树、随机森林、SVM、神经网络 |
| 无监督学习 | 只有 x,无标签 | 聚类、降维、密度估计 | K-Means、DBSCAN、层次聚类、PCA |
| 半监督学习 | 少量有标签 + 大量无标签 | 分类(利用无标签数据提升) | 自训练(伪标签)、标签传播、一致性正则 |
再看输出类型:
- 分类:输出离散类别,如「大房 / 小房」、10 个新闻类别。评价用准确率、精确率、召回率、F1、混淆矩阵。
- 回归:输出连续数值,如房价 5 万/平。评价用 MSE、RMSE、MAE、R^2。
- 聚类:无标签下把样本分组,类是自己「长」出来的,不是预定义的。评价用轮廓系数、ARI 等。
一句话记忆:有无标签决定学习范式,输出离散还是连续决定任务类型。聚类和分类最大的区别不是算法,而是监督信号在不在。
4.1 KNN 分类:不训练,只看邻居投票
判断一个新样本属于哪一类,就看它周围最近的 K 个「已知答案」的样本,谁多听谁的。这就是课件第 1 页那句「先提供一批有标签数据,然后新数据看和哪些点近,少数服从多数」。
给定距离度量(一般用欧氏距离)
d(x, x_i) = \sqrt{\sum_{j=1}^{D}(x_j – x_{ij})^2}
取距离最小的 K 个训练样本 N_K(x),分类输出为
\hat{y} = \arg\max_{c} \sum_{x_i \in N_K(x)} \mathbb{1}(y_i = c)
KNN 属于懒惰学习(lazy learning):没有显式的训练阶段、没有参数要学,代价全在预测时,每预测一条数据要算 O(ND) 次距离运算。这也是它在 18 万条训练数据上不适合做线上推理的原因之一,但在小数据、低维、特征已归一化的场景里非常能打。
要判一套 100 平的房子是大房还是小房,K = 5 的邻居是「大、大、小、大、小」,投票 3:2 → 判为大房。把 K 改成 1,就退化成「最近邻说了算」,对噪声极敏感;K 取太大则会把远处的异类拉进来,边界被抹平。K 一般取奇数以避免平票,实践中用验证集或交叉验证选。
坑:距离对量纲敏感。如果特征里同时有「面积(几十~几百)」和「房间数(1~5)」,面积会完全支配距离,必须做标准化(Z-score)或归一化(Min-Max)。
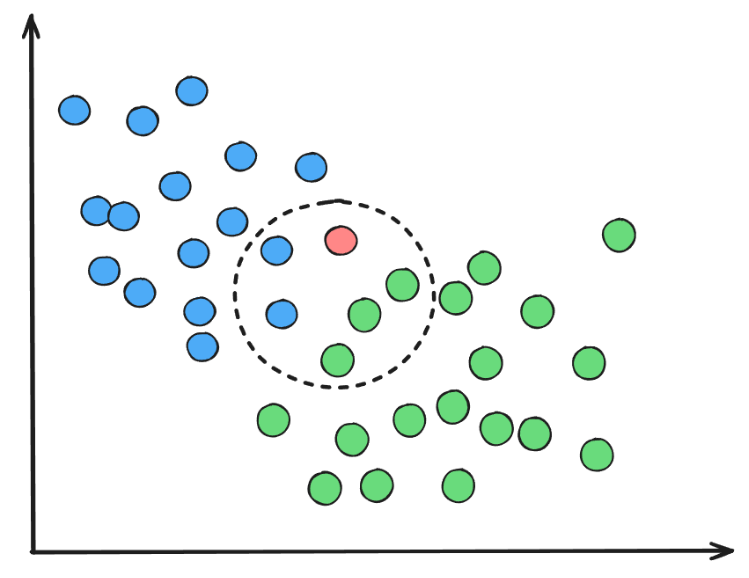
图注:二维平面上散布着两类训练样本(蓝色与绿色圆点,用颜色而非坐标轴区分;横纵轴只画了箭头,没有刻度数字)。中间红色的圆点是待预测的新样本,围绕它的黑色虚线圆圈标出「近邻范围」;从红点引出若干条实线连到圆内的近邻点上,示意「看和哪些点近」。这就是课件所讲的「少数服从多数」投票机制的可视化,把线连到的邻居标签数一数,多的一方就是预测类别。抽取稿第 4 页复用了同一张图(同一文件名),此处不重复插入。
4.2 KNN 回归:把「投票」换成「取平均」
直觉与机制:流程和分类完全一致,找最近的 K 个邻居,唯一区别在最后一步:分类是投票选类别,回归是把邻居的标签值取平均得到预测数值:
\hat{y} = \frac{1}{K}\sum_{x_i \in N_K(x)} y_i
(更通用的做法是加权平均,按距离的倒数给近的邻居更大权重,但这已超出本页范围。)
课件第 2 页原文写的是「根据最近的几个点的平均距离得到一个数值」。这里要修正为邻居标签值的平均:距离只用来挑邻居,不用来算预测值;对距离取平均得到的是「离我多远」,不是「值多少」。这一点在被追问时答错,会被认为没真正跑过算法。
课件第 2 页给的原始素材是「大房 5 万 / 中房 3 万」(每平米价格,单位按课件原文)。若某套待估房子的最近 5 个邻居价格是 5、5、3、5、3(万),则预测价为
\hat{y} = \frac{5+5+3+5+3}{5} = 4.2 \text{ 万}
同一批数据、同一个 K,把投票换成求均值,就完成了「分类 → 回归」的切换。
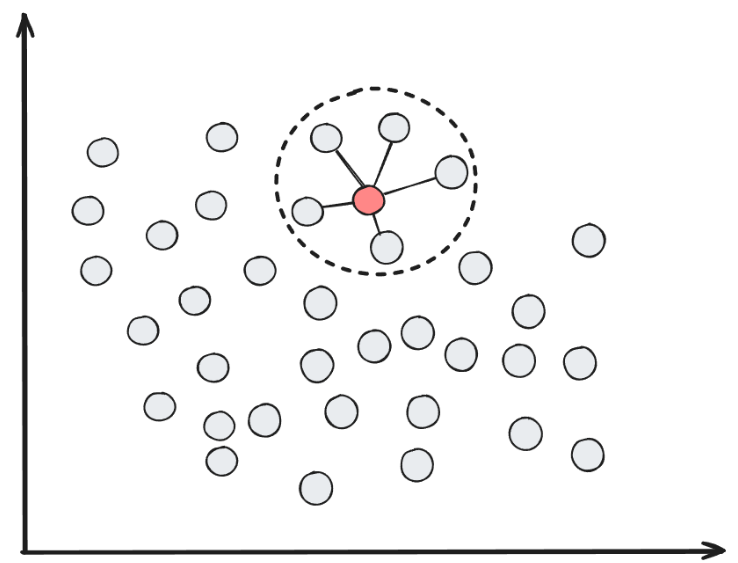
图注:这张图刻意不给点标类别,所有样本都画成灰色圆点(连续空间的点没有类别颜色之分),表达「回归任务里标签是数值而不是类别」。中间红点是待预测样本,虚线圆圈圈出近邻范围,从红点引出的实线连到圆内的 5 个最近邻居,与「K 近邻取平均」的机制对应;圆外散落的其他灰点被虚线圆排除在外,说明 K 值直接决定了参与平均的样本集合。坐标轴同样只有箭头、无刻度。
4.3 线性回归:从「看邻居」到「学参数」
不再依赖局部邻居,而是假设输入和输出之间存在一条全局直线,找到「最佳」的那条。
模型形式 y = ax + b(多维时是 \hat{y} = w^\top x + b)。「最佳」的定义是残差平方和最小(最小二乘):
\min_{a,b} \sum_{i=1}^{N}\left(y_i – (a x_i + b)\right)^2,\qquad \text{MSE} = \frac{1}{N}\sum_{i=1}^{N}(y_i – \hat{y}_i)^2
直线本身有闭式解(正规方程),也可以用梯度下降求;本项目里梯度下降的「公式五步」是后面深度学习训练脚本的基础。
带数字的小例子(按课件第 3 页):以「面积(横轴)→ 价格(纵轴)」为例,训练出直线后,把 100 平 代入方程直接算出预测价,这就是课件说的「新数据代入直线方程,算出预测值」。与 KNN 对比:KNN 对 100 平的预测取决于那一片区域里实际有哪些邻居,线性回归则用全量数据拟合出的单一斜率外推,外推更平稳,但也更容易被离群点带偏。
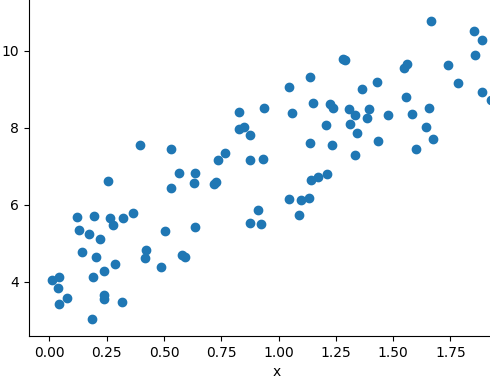
图注:这是线性回归一页配的散点图(matplotlib 风格),横轴标注为 x,刻度从 0.00 到 1.75 左右,纵轴刻度约 4~10 且无轴标签(图中未给出「面积/价格」的字样),所有样本点画成同一颜色的蓝色圆点。点云整体呈明显的正相关上升趋势,正是「用一条直线去拟合」的适用场景。需要如实说明:这张配图里只有数据点,并没有画出拟合出的直线,也没有 100 平对应的标注,直线与代入计算是课件文字部分描述的内容。
4.4 逻辑回归:名字叫回归,干的是分类
线性回归的输出是 (-\infty, +\infty) 的任意实数,没法当概率。没关系,把直线输出整个塞进 Sigmoid,压到 (0,1),它就有了「属于正类的概率」的语义。
z = w^\top x + b,\qquad \sigma(z) = \frac{1}{1 + e^{-z}} \in (0,1)
\text{交叉熵损失} = -\frac{1}{N}\sum_{i=1}^{N}\left[ y_i \log \hat{y}_i + (1-y_i)\log(1-\hat{y}_i) \right]
预测时取阈值 0.5(可按业务调整):\hat{y} \ge 0.5 判正类,否则判负类。注意打分函数是线性的,所以决策边界(\sigma(z)=0.5 即 z=0)仍然是一条直线,想表达「大房/小房」这种线性可分的问题足够,非线性边界要靠特征交叉或核方法/神经网络。
这里还有一个常被忽略的细节:Sigmoid 把实数映到概率,交叉熵损失则保证「概率偏离真实标签越多,惩罚越大」,两者搭在一起才能用梯度下降稳定收敛,只剩 Sigmoid 不带交叉熵(比如配 MSE)会出现梯度消失、训练极慢。
带数字的小例子(按课件第 4 页):样本面积为 99 平、121 平、64 平、71 平;某条数据代入后 \sigma(z) = 0.59。因为 0.59 > 0.5,判定为大房,课件原文即「大于 0.5 大房子,小于 0.5 小房子」。可以看到 0.59 距离阈值很近,说明这是个「拿不准」的样本,真实业务里可以调整阈值来权衡精确率与召回率。
课件给的一句话总结值得直接背下:逻辑回归 = 线性回归 + Sigmoid 函数 + 交叉熵损失。
4.5 决策树:把「纯度」当作分裂的判据
不再拟合一条线,而是不停地问「用哪个特征的哪个取值把数据切成两半,能让两边尽可能纯」。
纯度用熵(信息熵越小越纯)或基尼不纯度度量。熵定义为
H(D) = -\sum_{c=1}^{C} p_c \log_2 p_c
用特征 A 划分后按子集大小加权求和,得到条件熵 H(D|A),则
\text{信息增益} = H(D) – H(D|A)
每个节点都算一遍所有特征的增益,选增益最大的那一刀先切(这就是课件说的「纯度提升最大的特征作为第一个分裂点」),递归下去直到纯度满足要求或达到停止条件。让树尽量矮的动机是:树越矮,需要分裂的次数越少,叶子越少,越不容易「记住噪声」。
必须说清楚的一点:这是贪心算法,每一步只选当前最优的那一刀,不保证全局最优(局部最优 ≠ 全局最优,是决策树和后面梯度提升类算法公认的局限)。
带数字的小例子(课件第 5 页的红豆绿豆):50 颗红豆 + 50 颗绿豆,当前节点的熵是 H = -0.5\log_2 0.5 – 0.5\log_2 0.5 = 1 bit(最不纯)。试三种划分:
| 划分特征 | 左子集 | 右子集 | 纯度表现 |
|---|---|---|---|
| 颜色 | 浅色:绿豆 50、红豆 0 → 纯度 1.0 | 深色:红豆 50、绿豆 0 → 纯度 1.0 | 一刀切干净,增益最大 |
| 大小 | 小个:绿豆 40、红豆 10 | 大个:绿豆 10、红豆 40 | 两边都不纯,还得继续分 |
| 形状 | 圆形:绿豆 50、红豆 50 | 方形:0 / 0 | 什么都没切开,完全没用 |
于是「颜色」拿到最大信息增益,成为根节点的分裂特征;「形状」的增益为 0,被排除。课件还提到训练过程的渐进性:训练刚开始可能只会按「大小」这种效果一般的特征分,随着分裂推进,才慢慢找到「颜色」这种好特征,这就是树在逐层降低不确定性的过程。
4.6 随机森林:用随机性换稳定性
单棵决策树有两个毛病,方差大(训练数据稍微一变,树的结构就大变)、容易过拟合(只要长得够深,可以把训练集背到 100%)。既然一棵树不稳,那就训练很多棵不一样的树,让它们投票。
机制(三重随机 → 一票表决):
- 样本随机(Bagging / 自助法):从 N 条训练数据中有放回地抽 N 条,每棵树用一份不同的自助样本集。每棵树平均只见到约 1 – (1-1/N)^N \approx 63.2\% 的原始样本,剩下约 36.8% 是袋外样本(OOB),天然可以当验证集用。
- 特征随机:每个节点分裂时不是在所有特征里挑最好的,而是先在随机抽出的特征子集里挑(分类常取 \sqrt{D} 个特征)。这一条是随机森林区别于普通 Bagging 的关键,它进一步拉开了树之间的相关性,树越不相关,投票降方差的收益越大。
- 多数表决:所有树各投一票,票多的类别胜出(回归任务则取所有树输出的平均)。
数学上,若每棵树的方差是 \sigma^2、两两相关系数是 \rho,则 B 棵树集成后的方差约为
\rho \sigma^2 + \frac{1-\rho}{B}\sigma^2
第二项随树的数量增大而趋近 0,但第一项 \rho\sigma^2 无论如何都消不掉,这就是为什么「特征随机」不可省:只有把 \rho 压低,集成才有意义。
10 个类别、3 棵树,对某条新闻标题分别预测为「体育 / 体育 / 财经」→ 投票结果「体育」(2:1)。树越多,投票结果越稳定,但收益递减:树从 10 棵加到 100 棵通常还有提升,100 → 1000 棵基本只增加推理耗时。
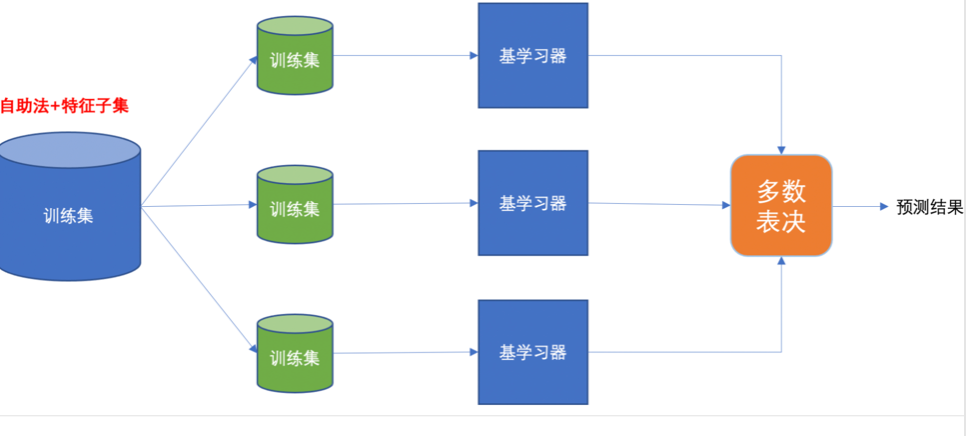
图注:这是一张标准的随机森林结构流程图,从左到右、从上到下共四列。最左侧一个较大的蓝色圆柱体代表原始训练集,旁边用红字标注了整个采样过程的关键词「自助法+特征子集」;从它引出三条分叉箭头,指向三个较小的绿色圆柱体,每个都标着「训练集」,对应「有放回采样出多份子训练集」;每个绿色圆柱再向右指向一个蓝色矩形,三个矩形都写着「基学习器」(即三棵决策树);三条箭头最终汇入一个橙色圆角矩形「多数表决」,再向右引出一支箭头得到「预测结果」。图里画的是 3 个基学习器,实际工程里是几十到几百棵;结构清晰体现了课件那句「数据集随机采样、特征也随机采样,训练不同的决策树,最后投票」。
4.7 过拟合、欠拟合与偏差-方差(课件未展开,考查重点)
- 欠拟合:模型太简单(树太浅、特征太少、训练不足),训练集和测试集表现都差,高偏差。
- 过拟合:把训练集的噪声也学进去了(树太深、特征太多、样本太少),训练集极好而测试集明显掉,高方差。
- 期望泛化误差可分解为 偏差² + 方差 + 不可约噪声,三者此消彼长,这就是偏差-方差权衡。
| 现象 | 训练集准确率 | 测试集准确率 | 偏差 | 方差 | 常见对策 |
|---|---|---|---|---|---|
| 欠拟合 | 低 | 低 | 高 | 低 | 加特征、加复杂度、减小正则 |
| 刚好 | 高 | 高 | 低 | 低 | — |
| 过拟合 | 极高(可接近 100%) | 低 | 低 | 高 | 加数据、简化模型、正则化、剪枝、集成(随机森林) |
随机森林之所以能治过拟合:它不改变单棵树的偏差(每棵树仍然很深),而是靠「平均」把方差压下来,这就是「三个臭皮匠赛过诸葛亮」的统计学含义。
4.8 数据划分与交叉验证
| 集合 | 作用 | 能不能用来训练 |
|---|---|---|
| 训练集 | 学参数(树的结构、w 和 b) | 是 |
| 验证集 | 调超参数、选模型、早停,不参与参数学习 | (只用来看表现) |
| 测试集 | 最终评估泛化能力,全程只碰一次 | 否 |
验证集的作用一句话:它是「没有作弊的考场」,每一次用测试集来指导选型,测试集就被间接「看过」了,它给出的分数会越来越乐观;所以调参必须在验证集上做,测试集留到最后只报一次数。
K 折交叉验证:把训练集切成 K 份,每次留 1 份当验证、其余 K-1 份训练,跑 K 次取平均,K 常取 5 或 10。作用是让「验证分数」不依赖某一次划分的运气,尤其在数据量不大时比单次留出法稳得多。数据量很小时(如每类样本极少),还可以用分层 K 折保证每折的类别比例与整体一致。
五、易错点与常见误解
-
常见说法:KNN 回归是「对最近的几个点的平均距离求值」;实际上,是对最近几个邻居的标签值取平均。
为什么:距离只承担「选出邻居」的职责;预测的目标是数值标签,不是距离本身。这是课件第 2 页原文表述容易误导的地方,被追问一句就露馅。 -
有人以为逻辑回归是回归算法(名字里有回归);实际上,它名字来自「用回归的思路处理分类」,本质是分类算法。
原因在于,输出经过 Sigmoid 后是类别概率,按阈值判类;损失函数是交叉熵而不是 MSE,评价指标用准确率/F1 而不是 RMSE。课件那句「实际上是分类算法」是纠正这点,必须记住。 -
常听到的一种说法是:逻辑回归能拟合任意非线性边界;实际上,它的决策边界是线性的。
背后的道理是,\sigma(z) = 0.5 \Leftrightarrow z = w^\top x + b = 0 是一条超平面;Sigmoid 只改变输出尺度,不改变边界的形状。 -
容易想岔的地方:决策树的「纯度提升最大」是全局最优;实际上,是逐节点的贪心最优。
之所以如此,每次只挑当前最好的一刀,后面可能因此错过更好的组合。所以决策树往往需要剪枝或继承集成来补救。 -
先说一个误解:KNN 不需要数据预处理;实际上,距离度量对量纲极其敏感,必须标准化/归一化。
为什么:量纲大的特征在距离里占的权重高得多,会直接支配近邻选择。这是 KNN 最经典的实战坑。 -
常见说法:随机森林的树越多越好;实际上,精度收益递减,成本线性增长。
原因在于,方差公式里 \rho\sigma^2 是下限,树多到一定程度只是重复投票;线上推理时棵数直接乘以耗时,需要按延迟预算取舍。 -
有人以为「数据集随机采样」就是随便挑一部分;实际上,是有放回抽样(bootstrap)。
背后的道理是,有放回才让每棵树的样本集不同且大约只覆盖 63.2% 的原始数据;无放回切分只会让每棵树看得更少、更弱。 -
常听到的一种说法是:训练集准确率 99%、测试集 70%,是「测试集太难」;实际上,典型的过拟合信号。
之所以如此,模型把训练集噪声也记住了。正确动作是加数据/降复杂度/剪枝/正则,而不是继续调参刷训练集分数。 -
容易想岔的地方:用测试集来反复调参;实际上,调参用验证集,测试集只用一次。
为什么:每次拿测试集反馈一次,你就向它过拟合了一点,最终报出的分数不再代表真实泛化能力(数据泄漏的一种)。
六、横向对比与研究脉络
6.1 五个模型的对比
| 模型 | 核心原理 | 优点 | 缺点 | 适用场景 | 训练/预测复杂度 |
|---|---|---|---|---|---|
| KNN | 找最近的 K 个邻居,分类投票 / 回归取均值 | 无需训练、零假设、天然多分类 | 预测慢、怕高维和量纲、必须存全量数据 | 小数据、低维、推荐相似度 | 训练 O(1);预测 O(ND) |
| 线性回归 | 最小二乘拟合 y=ax+b | 快、可解释(系数即影响)、有闭式解 | 只能线性、对离群点敏感 | 房价、销量等连续值预测 | 训练 O(ND^2) 量级(正规方程);预测 O(D) |
| 逻辑回归 | 线性打分 + Sigmoid + 交叉熵,按 0.5 判类 | 输出可解释为概率、训练快、工业界文本分类基线 | 只能线性边界、需特征工程 | 二分类/多分类(one-vs-rest 或 softmax) | 与线性回归同量级 |
| 决策树 | 按纯度增益贪心分裂特征空间 | 可解释到「规则」级别、不需要归一化、天然处理非线性 | 高方差、极易过拟合、对数据抖动敏感 | 规则可解释场景、特征重要性探查 | 训练约 O(ND\log N)(排序);预测 O(\text{深度}) |
| 随机森林 | Bagging + 特征随机 + 多数表决(决策树的集成) | 抗过拟合、稳、几乎不用调参、可出特征重要性 | 失去单树可解释性、模型体积和推理耗时成倍、对极端不平衡仍钝 | 表格数据的强基线、10 类文本分类 | 约为单树的 B 倍 |
6.2 演进脉络(每个新模型解决了前一个的什么痛)
- KNN → 线性回归:KNN 把答案「存」在邻居里,无法总结规律、无法外推;线性回归改为用全局参数概括规律,能外推、可解释。
- 线性回归 → 逻辑回归:线性回归输出无界实数,不能表达「概率/类别」;加一层 Sigmoid 并换成交叉熵损失,同一套线性打分就能做分类。
- 逻辑回归 → 决策树:逻辑回归的边界是线性的,复杂非线性关系需要人工做特征交叉;决策树用递归切分特征空间自动表达非线性与特征交互,且不需要归一化。
- 决策树 → 随机森林:单树高方差、严重过拟合;用 Bagging(样本随机)+ 特征随机造出多棵低相关的树再投票,把方差压下来,代价是牺牲可解释性。这条路线的本质是「弱可解释的高方差模型 → 集成 → 稳定的强 baseline」。
- 随机森林的下一步(本项目路线里的后续):串行纠错的 Boosting 家族(GBDT/XGBoost/LightGBM)通过「每棵树拟合前面残差」进一步降偏差;再往后就是表示学习(FastText → BERT → LLM),从「人工特征 + 树」转向「端到端学习表示」。
七、在新闻分类项目中的落地
(1)它是第一个基线模型的全部理论依据。项目四模型路线是 TF-IDF + 随机森林 → FastText → BERT → LLM。第一个模型就是本课件第 5、6 页的内容:TF-IDF 把标题变成稀疏特征向量(对应「特征」),随机森林用多棵树投票出 10 个类别之一。理解这份材料,等于理解了基线为什么成立、它在哪里会输给后面的模型。
(2)训练/验证/测试的用法(18w / 1w / 1w)。项目的数据划分正好可以对应本课件 4.8 节:
– 18w 训练集:喂给 RandomForestClassifier 学树结构;
– 1w 验证集:只用来调超参数,n_estimators(树的数量,先 100~300,看分数是否还在涨)、max_depth(控制过拟合,本项目文本特征稀疏,通常需要限深或限 min_samples_leaf)、max_features(默认 sqrt,与课件「特征随机」对应)、min_samples_leaf(抑制噪声叶子);
– 1w 测试集:只在模型定稿后跑一次,报准确率/精确率/召回率/F1,用来和 FastText、BERT、LLM 四个模型横向对比。
(3)实际会踩的坑。
– train/test 差距大:如果训练集准确率接近 100%(树不限制深度时几乎必然发生)、测试集只有 80% 出头,就是 4.7 节的过拟合,先限 max_depth/min_samples_leaf,再考虑加数据或换模型,别急着调 n_estimators。
– 类别不平衡:10 类新闻天然不均,看准确率会被多数类带偏,必须同时看每类的精确率/召回率和混淆矩阵(与本目录另一份《混淆矩阵模型指标》材料直接衔接),必要时加 class_weight='balanced'。
– 推理成本:随机森林的预测耗时 ≈ 单棵树 × 树的数量,且模型文件大(几十到几百 MB 量级),这就是项目最后要做模型压缩的动因,树模型方向上主要是限深/减树(近似结构化剪枝),和 4.4 节「模型剪枝」的思路一致。
– 稀疏高维特征:TF-IDF 通常上万维,随机森林在 max_features='sqrt' 下每棵树只用一个小的特征子集,反而更吃得消稀疏数据,这是它比 KNN(在稀疏高维里距离失效)更适合文本的原因。
(4)和其它模型的配合方式。
| 环节 | 谁上 | 与这份材料的关系 |
|---|---|---|
| 特征层 | TF-IDF(749 个停用词过滤) | 课件第 5 页「选什么特征来切」在文本上的落地:TF-IDF 的权重就是「这个词对区分类别有多有用」 |
| 基线模型 | 随机森林 | 本课件全部内容(第 5、6 页为主) |
| 升级一 | FastText | 用 embedding 平均代替 TF-IDF 稀疏向量,解决「词的语义相似性」,树模型做不到 |
| 升级二 | BERT 微调 | 上下文表示,理解「不是/未」等否定与语序,突破线性与词面匹配的局限 |
| 升级三 | LLM(DeepSeek API 零样本/少样本) | 无需训练数据即可分类,作为对照实验证明「数据 + 微调」的价值 |
| 收尾 | 模型压缩(量化/蒸馏/剪枝) | 随机森林这条线的压缩手段就是减树/限深,与剪枝章节呼应 |
(5)叙述模板(30 秒版):我的第一个基线是 TF-IDF + 随机森林,TF-IDF 把标题变成稀疏向量,随机森林用样本随机 + 特征随机的多棵树投票出 10 类。它在验证集上给出了第一个可信的准确率,也暴露了纯词面特征的天花板:语义相近但用词不同的标题会被分错,所以后面才依次上 FastText、BERT 和 LLM 做对比。
八、重点问答
Q1:为什么模型在训练集上准确率很高,测试集上却掉得厉害?
A:总的来说这是典型的过拟合,模型把训练集里的噪声和偶然规律也当成知识记下来了。分三层看:一是模型容量太大,比如决策树不加限制可以长到把每条训练样本都分对,叶子节点几乎一叶一样本;二是特征太多或样本太少,两者比例失衡时模型很容易「背答案」;三是验证方式有问题,比如用测试集反复调参,或者训练集和测试集分布不一致。判断方法很直接,盯训练集和验证集的差距:差距小且都低是欠拟合,差距大是过拟合。对应的动作是加数据、降复杂度(限制树深、加 min_samples_leaf)、加正则化,或者干脆换成随机森林这类集成模型,用平均把方差压下来。
Q2:验证集到底是干什么用的?能不能直接看测试集?
A:一句话,验证集是调参和选模型的考场,测试集是最终的验收考试。我要调 n_estimators、max_depth、学习率这类超参数,每试一组就去看一次那个集合的分数,这个集合就必然被我的选择「污染」了;所以这个角色只能由验证集来担任,我得保证它不参与参数学习、也不进入最终汇报。测试集必须全程只碰一次,用来报最终泛化能力。如果连验证集都不够用或者数据量小、划分运气影响太大,我会用 K 折交叉验证,把训练集切 K 份轮着当验证取平均,让分数不依赖某一次划分;类别不平衡时用分层 K 折保证每折类别比例一致。
Q3:分类和回归到底有什么区别?KNN 和逻辑回归算哪一类?
A:核心区别是输出的空间:输出是离散类别就是分类,输出是连续数值就是回归。KNN 两种都能做,找最近的 K 个邻居,分类就投票、回归就把邻居的标签值取平均,区别只在最后一步。逻辑回归名字里有回归,但它本质是分类算法:线性打分之后接 Sigmoid 压到 0~1,再用 0.5 之类的阈值判类,损失用交叉熵,评价看准确率/F1。另外还可以从评价指标上区分:分类看准确率、精确率、召回率、F1 和混淆矩阵,回归看 MSE、RMSE、MAE、R^2。还有一点要强调,聚类和分类的区别不在算法而在有没有标签。
Q4:随机森林比单棵决策树好在哪?为什么它不容易过拟合?
A:好在稳定性。单棵树是高方差模型,训练数据抖一下,根节点选的特征可能就变了,整棵树结构跟着全变,而且树够深就能把训练集刷到接近 100%,泛化很差。随机森林用两重随机性造出很多棵互不相同的树:一是有放回抽样(bootstrap),每棵树只看大约 63% 的样本,剩下的当袋外样本;二是每个节点只在随机抽出的特征子集里选分裂特征。最后大家投票。数学上,集成的方差约为 \rho\sigma^2 + (1-\rho)\sigma^2/B,第二项随树数增大而消失,但第一项取决于树之间的相关性 \rho,这就是特征随机存在的理由。所以它比单棵树更稳、更耐噪声,代价是失去单棵树那种「if-else 规则」级别的可解释性,模型体积和推理耗时也成倍上升。
Q5:决策树怎么决定先切哪个特征?
A:判据是纯度提升最大,也就是信息增益最大。先算当前节点的熵 H(D) = -\sum p_c\log_2 p_c,然后对每个特征的每个可能切分点算划分后的加权条件熵 H(D|A),两者之差就是信息增益,选最大的那一刀作为分裂点。课件里的红豆绿豆例子很直观:50 红 + 50 绿,按「颜色」切,两边各自纯度都是 1.0,增益最大;按「大小」切,两边都还剩 10 颗异类,还得继续分;按「形状」切完全没切开,增益为 0。要注意这是贪心算法,每一步只保证当前最优,不保证全局最优的树结构;而且不加限制时它必然过拟合,所以实际工程里要限深、限叶子样本数或做剪枝。
Q6:KNN 听起来最简单,实际用起来要注意什么?
A:三个坑。第一是必须归一化,KNN 靠距离,如果特征里同时有「面积」和「房间数」,面积会完全支配距离,所以要 Z-score 或 Min-Max 标准化。第二是 K 值要调,K=1 太敏感、K 太大把远处的异类也拉进来抹平边界,一般取奇数避免平票,用验证集或交叉验证选。第三是预测很慢,KNN 是懒惰学习,没有训练阶段,每次预测都要和全部训练样本算距离,复杂度 O(ND),维度一高还会遇到距离失效(维度灾难)。所以它适合小数据、低维、相似度检索这种场景;换成 18 万条、上万维 TF-IDF 的文本分类,我就不会选它,而是选随机森林这类能吃稀疏高维特征的模型。
Q7:监督、无监督、半监督分别是什么?
A:按有没有标签分。监督学习用带标签的数据学映射,解决分类和回归;无监督学习只有特征没有标签,做聚类、降维、密度估计,典型的像 K-Means、PCA;半监督学习介于两者之间,少量有标签 + 大量无标签,用无标签数据补充数据结构信息来提升效果,常用的做法是给无标签样本打伪标签(自训练)或做一致性正则。在新闻分类项目里我们用的是监督学习,18 万条 标题\t标签 的训练数据;如果标签很贵、只有几千条有标签,就可以考虑先无监督预训练或半监督那套思路。
Q8:怎么判断模型是不是过拟合/欠拟合,怎么处理?
A:看训练集和验证集的差距。两个都差、训练集甚至也不高,是欠拟合,属于高偏差,处理办法是加特征、加复杂度、减小正则、加训练轮次。训练集很好、验证集明显掉,是过拟合,属于高方差,处理办法是加数据、降复杂度(限树深、减特征)、加正则化(L1/L2、Dropout)、做集成。还有一招是早停:盯验证集损失,一旦不降反升就停下,这也说明为什么必须有验证集。理论上这是偏差-方差权衡:偏差² + 方差 + 不可约噪声构成期望泛化误差,两边此消彼长,我要做的是找那个总误差最低的平衡点,而不是把训练集分数刷到最高。
九、延伸阅读
- scikit-learn 官方文档(https://scikit-learn.org):
KNeighborsClassifier/Regressor、LinearRegression、LogisticRegression、DecisionTreeClassifier、RandomForestClassifier的参数页;其中RandomForestClassifier的n_estimators/max_features/max_depth/oob_score说明与 4.6 节一一对应。 - scikit-learn 用户指南的 Supervised learning、Decision Trees、Ensemble methods 三章:特征重要性与袋外误差的权威解释。
- 《The Elements of Statistical Learning》:第 7 章(偏差-方差、交叉验证)、第 15 章(Random Forests),进阶查阅即可,不必从头读。
- 《Pattern Recognition and Machine Learning》(Bishop):第 4 章逻辑回归与 Sigmoid 推导。
- scikit-learn 自带数据集:
load_iris、load_digits、load_breast_cancer,用来亲手复现课件的分类/回归/纯度概念。 - UCI Machine Learning Repository(https://archive.ics.uci.edu):经典表格数据集,适合练随机森林调参。
- Kaggle:Titanic(分类)、House Prices(回归)两个 Playground 竞赛,可直接套用本课件的 KNN、逻辑回归、随机森林做对比实验。