FastText 是「人工设计特征 + 只有两层可训练参数」的极速文本工具,它全部的性能红利都押在三件事上,子词 n-gram 的 Hash 桶、CBOW 式向量平均、层级 Softmax。
一、这份材料解决什么问题
在新闻分类项目的四棒接力里,TF-IDF + 随机森林 → FastText → BERT → LLM 是一条成本递增、精度递增的阶梯。FastText 这一棒要回答的是一个工程上非常现实的问题:能不能用近乎免费的训练成本,拿到接近深度模型的分类精度?
课件开篇给了定位:FastText 是 Facebook(现 Meta)开源的一个词向量计算和文本分类模型,输入一个词的序列(一段文本),输出这段文本属于不同类别的概率;可训练的部分只有词嵌入层和分类全连接层,中间的分词方式、n-gram 切分、向量相加求平均等都需要人工设计。课件因此把它定性为「人工设计 + 少量可训练的模型,介于深度学习和传统算法之间」。
这句话是本份材料的题眼。它意味着两件事:
- 评审者问「FastText 为什么快」,正确答案不是「模型小」这么含糊,而是因为它在输入侧用平均池化替代了序列建模、在输出侧用层级 Softmax 替代了全类归一化;
- 评审者问「FastText 为什么还能处理没见过的词」,答案也不在深度网络上,而在字符级子词 + Hash 桶这套人工设计的表示。
二、核心结论
- 可训练参数只有两块:词嵌入矩阵 + 分类全连接层;分词、切子词、向量平均全是人工规则。所以它是「流水线上的浅层模型」,不是深层网络。
- 子词靠 Hash 桶存:把词拆成字符 n-gram,每个 n-gram 用哈希函数映射到固定大小(默认
bucket = 2 000 000)的桶里,词向量 = 各 n-gram 向量之和。这带来 OOV(未登录词)能力与形态丰富语言的鲁棒性,代价是有损的哈希冲突和固定的显存/内存开销。 - 训练极快的三件套:CBOW 式平均(把一句话压成一个点,没有 RNN/Attention 的序列计算)+ 层级 Softmax(Huffman 树,把 O(Kd) 的归一化压到 O(d\log K))+ 哈希技巧与多线程 C++ 实现。
- 分类用法极简:数据格式是
__label__标签 文本,入口是train_supervised()(或命令行fasttext supervised),test()返回(样本数, P@1, R@1)。 - 词向量和有监督分类是两条产线:
skipgram/cbow模式产出的.vec/.bin是无标签的预训练词向量;supervised产出的是分类模型。有监督模式默认minn=0, maxn=0(子词关闭),无监督模式默认minn=3, maxn=6(子词开启),这是最容易踩的坑。
三、知识地图
【理解】FastText原理(6 页)
├─ 第1页 【理解】FastText 是什么
│   ├─ 定位:词向量计算 + 文本分类;输入词序列 → 输出类别概率
│   ├─ 结构:只有 词嵌入层 + 分类全连接层 可训练
│   └─ 性质:人工设计流程 + 少量可训练参数,介于深度学习与传统算法之间
├─ 第2页 【理解】训练与预测各干什么
│   ├─ 训练:embedding 学「怎么用向量表示词」,全连接层学「向量 → 类别」,反向传播联合优化
│   └─ 预测:句子里每个词查表 → 得到一个整体平均向量 → 分类
├─ 第3页 【理解】核心思想:人工设计特征提取
│   ├─ 多尺度细分(词内切成片段)+ 组合多个词(n-gram 拼短语)
│   ├─ 收益:未登录词(如「北京天安门」)可由已知片段组合出向量;捕捉不同颗粒度的上下文
│   └─ 流程示例:输入「我爱北京天安门,我要去首都」→ jieba 分词 → 片段切分 → n-gram 组合
├─ 第4页 【理解】表示层的具体形态
│   ├─ "apple" → _ap/_app/_ppl/_ple/_le → 相加/平均 → 词向量
│   └─ 词嵌入矩阵:每行一个词,列是维度(课件示意图画到 300 维)
├─ 第5页 【了解】调参哲学:抓主要矛盾,分阶段试错
│   └─ 阶段1 收敛矛盾(lr) → 阶段2 泛化矛盾(weight_decay/dropout) → 阶段3 速度-精度矛盾(batch/momentum) → 阶段4 结构矛盾
└─ 第6页 【了解】参数清单与自动调参
    ├─ lr 0.1 / dim 100 / ws 5 / wordNgrams 1 / loss softmax / minn 0 / maxn 0
    └─ 自动搜索:参数重要性分析 → 调整方向 → 已探索区域精调 + 未探索区域采样
权重说明:本份文件是【理解】级别,第 3、4 页的表示层机制(子词与平均)必须能讲清;第 5、6 页的调参属【了解】,能说出「抓主要矛盾」和几个关键参数默认值即可。
四、原理详解
4.1 模型结构:只有两层是可学的
课件第 1 页给出的模型结构可以拆成四段:
- 输入层:一段文本的词序列(原始字符串);
- 人工流程:分词(中文常配 jieba)→ 词内切片段(子词 n-gram)→ 跨词组合(word n-gram);
- 词嵌入层(可训练):一个大小为
(词表大小 + bucket) × dim的矩阵,查表得到每个特征的向量;一句话的所有向量相加/求平均,得到固定维度的句向量; - 分类全连接层(可训练):句向量 → K 个类别的打分 → 概率。
只有第 3、4 步带参数。分词、切分、平均、n-gram 窗口这些「特征提取规则」都是人定的,模型不学。这就是课件说的「没有强大的神经网络,人工设计特征提取规则,让模型在人工设计的简单方法中高效学习语义」。
图注:fastText 官方 logo,红色手写体 “fast” 加一个蓝色方块点(第 1 页的标题配图,纯装饰性标识)。
图注:课件第 1 页配的示意照片,一台白色的协作机械臂在流水线上作业,画面中央是机械臂压在绿色电路板(PCB)上的末端夹具,背景是几位穿浅蓝工装、戴工帽的工人在工位前操作。它对应的正是课件那句「模型能力有限,只能人工嚼碎再喂饭」:FastText 像一条人工设计好每一道工序的装配线,机械臂(可训练的两层)只负责拧关键的两颗螺丝。
4.2 训练与预测:embedding 和全连接层各学什么
把 FastText 想成一个两级压缩器。第一级把「词」压成向量(embedding 层负责),第二级把「一堆向量平均成的句向量」压成类别(全连接层负责)。
训练目标就是最小化分类的交叉熵(课件第 2 页的说法是「让 embedding 层学会如何更好地用向量表示一个词,让全连接层更好地把向量转化为分类结果,两者通过反向传播联合优化」)。形式上,句子 x 的表示是它所有特征嵌入的平均:
\bar{v}=\frac{1}{n}\sum_{i=1}^{n} u_{x_i},\qquad P(y\mid x)=\frac{\exp(W_y\cdot \bar{v})}{\sum_{j=1}^{K}\exp(W_j\cdot \bar{v})}
损失为 -\frac{1}{N}\sum_{n}\log P(y_n\mid x_n)。注意这里没有隐藏层、没有非线性激活,除了嵌入查表和最后的归一化,整条前向路径就是「查表 + 加法 + 一次内积」。
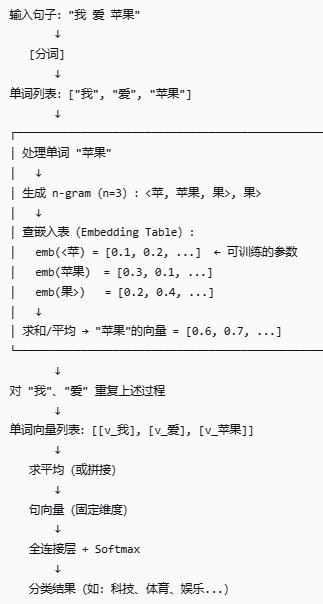
图注:课件第 4 页的端到端流程图,从左到右依次是:① 输入句子(示例「我 爱 苹果」)→ ② 分词 → ③ 单词列表([“我”,”爱”,”苹果”])→ ④ 对单个词展开:以「苹果」为例生成 n-gram(n=3):<苹、苹果、果> → ⑤ 查嵌入表 Embedding Table:列出 emb(<苹>)=[0.1, 0.2, ...]、emb(苹果)=[0.3, 0.1, ...]、emb(果>)=[0.2, 0.4, ...],并特别标注这一层是「可训练的参数」 → ⑥ 求和/平均,得到「苹果」的向量 → ⑦ 对「我」「爱」重复上述过程,得到单词向量列表 → ⑧ 求平均(或拼接)得到固定维度的句向量 → ⑨ 全连接层 + Softmax → ⑩ 输出分类结果(示例类别:科技、体育、娱乐…)。整张图就是「人工流程(分词/切 n-gram/平均)+ 两处可训练参数(Embedding Table、全连接层)」这句话的可视化。
预测过程(课件第 2 页口径):把一个句子拆开揉碎,分析每个词的意思与词之间的意思,再组合成句子整体的平均向量,最后看它落在哪个类别。课件的原话很形象:「模型能力有限,不嚼碎不行啊,只能人工嚼碎再喂饭」。代价是词序信息的丢失,平均是对称的,「猫追狗」和「狗追猫」平均出来的向量一样。弥补手段就是下一节的 word n-gram。
4.3 子词 n-gram + Hash 桶:OOV 与形态丰富语言的解法
一个词的意义可以由它的「零件」推断出来。没见过 北京天安门 这个完整短语没关系,只要见过 北京、天安门 这些片段,就能拼出一个合理的向量;同理,没见过的 神经网络的训练 只要片段都在,就能表示。
机制(三步):
- 切分子词:给词加上边界符(论文用
<和>,课件里画成_ap、_app这类下划线形式)后,取长度在minn~maxn之间的所有字符 n-gram,同时把整词本身也算作它的一个特征。论文的例子:where在 n=3 时表示为<wh, whe, her, ere, re>加上整词序列。 - Hash 到桶里:字符 n-gram 的数量随语料/语言近乎无穷(中文、德语复合词、黏着语的词缀变化都会爆炸),不可能给每个 n-gram 分配一行。FastText 的做法是用哈希函数把它映射到固定数量的桶(默认
bucket=2 000 000行):
\text{idx}(g)=\text{nWords}+\big(\text{hash}(g)\bmod B\big),\qquad B=\texttt{bucket}
例如词表有 5 万个词、bucket=2 000 000,那么嵌入矩阵就是 205 万行;<ap 和 <Ap 很可能落到不同桶,而两个罕见片段可能撞进同一行。
3. 词向量 = 子词向量之和:论文给出的打分函数是
s(w,c)=\sum_{g\in \mathcal{G}_w} z_g^{\top} v_c,\qquad u_w=\sum_{g\in \mathcal{G}_w} z_g
即「词 = 它的 n-gram 集合的向量之和」。课件的 apple 例子就是这个式子:_ap [0.45, 0.67, -0.12 …]、_app [0.3, 0.4, -0.2 …]、_ppl [0.1, 0.6, 0.0 …]、_ple [0.4, 0.3, 0.1 …]、_le [0.2, 0.2, 0.3 …],把这些行按维度相加(课件把结果示意为 [1.2, 2.0, 0.1, …])就得到 apple 的词向量。
为什么解决 OOV:哪怕整词行从未被更新过,它的每个子词行都是训练过的,相加之后仍是一个「有语义的」向量;相邻词、相似词因为共享子词而在向量空间里靠得近。官方文档给了一组真实对比(accomodation 是 accommodation 的常见拼错):
- 无子词(
maxn=0)时最近邻是sunnhordland (0.775)、administrational (0.753)、laponian (0.752),基本是噪声; - 有子词时最近邻变成
accomodations (0.963)、accommodation (0.942)、accommodations (0.915)、accommodative (0.848),还带出了语义相关的amenities (0.730)、catering (0.726)。
为什么对形态丰富语言重要:德语复合词、土耳其语/芬兰语的黏着词缀会产生天文数字的词形,纯词级词表会让大量词形变成罕见到学不动;子词把参数共享到词缀上,等于用有限的桶覆盖了近无限的词形。
哈希冲突到底多严重:默认 B=2\times10^6,若语料里不同子词恰好也是 2\times10^6 个,则平均每个桶 1 个(\lambda=1),约 26.4% 的桶会装到 2 个以上不同的子词,期望撞桶对数约 100 万对。所以它是有损压缩,用「少量冲突 + 固定内存」换掉「无冲突但无限大的哈希表」。内存账也直接:光输入嵌入矩阵就是 (nWords+B)\times dim\times 4 字节,B=2\times10^6、dim=100 时约 763 MB;把 bucket 降到 500 000 就只剩约 191 MB。这就是小数据要调小 bucket 的原因。
4.4 两种 n-gram 粒度,别混
课件第 3 页给的流程是:
输入 "我爱北京天安门,我要去首都"
① 分词(如 jieba): 我 | 爱 | 北京天安门 | 我要 | 去 | 首都
② 词内片段(maxn 限制长度): 北 京 天 北京 天安门 北京天 京天安 安门
③ 词间组合 wordNgrams:
   n=3 → (我,爱,北京天安门) (爱,北京天安门,我要) (北京天安门,我要,去) (我要,去,首都)
   n=2 → (我,爱) (爱,北京天安门) (北京天安门,我要) (我要,去) (去,首都)
这里必须分清两个参数(课件把它们都叫成了「n-gram」,很容易记串):
| 参数 | 层级 | 作用 | 默认值 |
|---|---|---|---|
minn / maxn |
词内(字符级子词) | 把分词继续切成不大于 maxn 的片段,理解词自身的构成与形态 |
有监督 0/0(关闭);无监督 3/6 |
wordNgrams |
词间(词级) | 把连续 N 个分词拼成一个特征,理解词与词的搭配,识别短语 | 1(即只用单词) |
课件说「maxn 用来理解分词本身的意思,n-gram 用于理解词之间关系」,指的就是这两层。它们的组合让一句话产生大量不同粒度的特征:「一句话就能产生很多不同片段,从而更好地提取文本的语义和上下文关系」。课件也提醒:这些原理都是内部底层实现,项目里直接调 API 其实看不到这些,但被追问的正是这些。
4.5 为什么训练极快:平均 + 层级 Softmax
三个因素叠加:
(1) 输入侧没有序列计算。词向量的组合方式是「平均」,不是 RNN 的逐时刻递推、也不是 Transformer 的注意力矩阵。前向传播只有查表(O(1) 索引)和向量加法,复杂度对句长线性 O(nd),而且可以多线程并行。
(2) 输出侧用层级 Softmax 近似。课件第 6 页的 loss 参数写作「损失函数 {hs, softmax},default softmax,还是分层 softmax」。官方文档对层级 Softmax 的解释是:构造一棵二叉树,叶子是标签,每个中间节点有一个可训练的二分类激活(如 sigmoid),决定往左还是往右;一个输出单元的概率 = 从根到该叶子的路径上所有中间节点概率的乘积。fastText 用的是 Huffman 树,高频标签路径短,因此输出层的平均查询时间最优。复杂度对比:
| 输出层方案 | 一次预测的计算量 | 直觉 |
|---|---|---|
全量 softmax |
O(K\cdot d) | 每个类别都要算一遍内积再归一化 |
负采样 ns |
只更新 1 正 + neg 个负样本 |
靠采样近似,牺牲精确归一化 |
层级 hs |
O(d\cdot \log K) | 走一条树路径;论文给的测试复杂度是 O(h\log_2 k) |
ova |
K 个独立二分类 | 多标签友好,但更慢 |
(3) 工程层的省法:n-gram 特征用哈希技巧映射到固定数量的桶(论文里说只考虑 bigram 时用 10M bins,否则 100M bins),省掉了维护超大特征词表的开销;实现是 C++ 且默认多线程(thread 默认 12)。论文给出的实测口径:多核 CPU 上 10 分钟内训练 10 亿词以上,1 分钟内给 50 万句、31.2 万个类做分类。这是「CPU 上秒到分钟级」这一印象的来源。
4.6 分类用法与 __label__ 数据格式
FastText 用标签前缀区分「什么是标签、什么是词」,默认前缀是 __label__(可改 label 参数)。每一行是「一个或多个标签 + 文本」:
__label__体育 国足 客场 逆转 取胜
__label__科技 新一代 折叠屏 手机 发布
__label__财经 央行 宣布 降准 释放 流动性
要点:每行至少一个标签;多标签就写多个前缀(配合 loss='ova');文本需要预先分好词(fastText 不自动分词),UTF-8 编码,建议统一小写并在标点前后加空格。
import fasttext

# 有监督训练:数据格式 __label__标签 文本(已分词)
model = fasttext.train_supervised(
    input="train.txt",
    lr=0.1, dim=100, epoch=10,
    wordNgrams=2,        # 词级 bigram,抓短语
    minn=2, maxn=4,      # 字符级子词,中文建议打开
    bucket=500000,       # 子词哈希桶数(小数据调小省内存)
    loss="softmax",      # 类别少 → softmax;类别极多 → hs / ns
    thread=8, seed=0,    # 固定 seed 便于复现
)

model.save_model("model.bin")          # 保存模型
print(model.predict("国足 客场 逆转 取胜", k=3))   # (label, prob) top-3
n, p1, r1 = model.test("valid.txt")    # 返回 (样本数, P@1, R@1)
自动调参(课件第 6 页讲的「类似随机搜索和遗传算法」的落地入口):
model = fasttext.train_supervised(
    input="train.txt",
    autotuneValidationFile="valid.txt",  # 给了验证集才启动 autotune
    autotuneMetric="f1",                 # 目标指标,默认 f1
    autotuneDuration=600,                # 搜索时长(秒),默认 300
)
4.7 预训练词向量 vs 有监督分类(两条产线)
| 无监督词向量(skipgram / cbow) | 有监督分类(supervised) | |
|---|---|---|
| 输入数据 | 纯文本,不带标签 | __label__标签 文本,每行必须带标签 |
| 输出 | 词向量(每词一行) | 分类模型(可 predict) |
| 默认子词 | minn=3, maxn=6(开启) |
minn=0, maxn=0(关闭) |
| 默认 lr / 其他 | lr 0.05,minCount=5 |
lr 0.1,minCount=1 |
| 典型文件 | xxx.vec(文本)、xxx.bin(二进制模型) |
model.bin,量化后 model.ftz |
.vec 与 .bin 的区别:.bin 是完整的二进制模型,可以重新加载、可以继续用 API 查 OOV 词的向量;.vec 是纯文本词表快照,第一行是「词数 维度」的表头,之后每行「词 + 空格分隔的浮点数」,按词频从高到低排列:
218316 100
the -0.10363 -0.063669 0.032436 -0.040798 0.53749 ...
of -0.0083724 0.0059414 -0.046618 -0.072735 0.83007 ...
.vec 里只有出现在词表里的整词向量,没有子词/桶向量。所以未登录词在 .vec 里查不到,但在 .bin 里可以,因为它的向量是子词向量之和,「只要未登录词由已知子词组成,就有表示」:官方演示里,把拼错的 enviroment 喂给 print-word-vectors,依然能拿到一个向量。实践上的分工是:要词向量做特征/初始化 → 用 .vec(或 get_word_vector);要在线预测或处理 OOV → 用 .bin。
4.8 调参:先抓主要矛盾,再交给自动搜索
课件第 5 页讲的不是 FastText 专有技巧,而是一套调参方法论:不可能所有参数同时最优,要抓住当前阶段的主要矛盾(对目标影响最大、最不平衡的参数组合),集中资源解决它;解决后主要矛盾转移,再转向下一组矛盾,这就是「调参工程师」「炼丹」这个说法的由来。课件给的四个阶段是:收敛矛盾(调 lr,如 1e-4 → 1e-2,先圈出最佳区间)→ 泛化矛盾(固定 lr,调 weight_decay/dropout)→ 速度-精度矛盾(调 batch_size/momentum)→ 结构矛盾(调层数,再微调 lr 与 dropout)。
课件第 6 页列出 FastText 的关键参数与默认值:lr=0.1、dim=100、ws=5(窗口太小片面、太大引入噪声)、wordNgrams=1、loss=softmax(或分层 softmax)、minn=0、maxn=0,并给出自动搜索的三步原理:① 分析参数重要性(变化引起结果剧变的 → 重要参数);② 确定调整方向(5→10 分数涨了就继续往大调);③ 精调已探索区域 + 探索新区域(在已知最优点附近细搜,同时采样没试过的区域防止局部最优)。
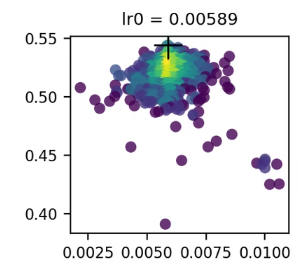
图注:这张散点图是自动调参过程的可视化(课件第 6 页配图,横轴「参数 a」、纵轴「参数 b」是通用的坐标示意)。图上方标题是搜索到的最优学习率 lr0 = 0.00589;横轴刻度为 0.0025 / 0.0050 / 0.0075 / 0.0100,即 lr 的搜索范围;纵轴刻度 0.40 / 0.45 / 0.50 / 0.55,是验证集上的评估分数。散点用深紫 → 黄绿的色带着色(图中没有 colorbar/图例),颜色与纵轴高度强相关:亮黄绿的点集中在 lr≈0.0050~0.0065、纵轴 0.51~0.53 的密集区,深紫的点则是散落在右侧(lr 偏大)和低分区(0.40~0.47)的离群点;黑色十字标记指向峰值位置(与其上方 lr0 = 0.00589 一致)。这张图直观说明了第 6 页讲的自动搜索三件事,采样(撒点)、判断方向(分数随 lr 的变化趋势)、在已探索的最好处附近精调;也说明 lr 就是「主要矛盾」,光是它在 0.0025~0.01 之间的取值,就能让分数在 0.40 到 0.53 之间摆动。
五、易错点与常见误解
-
常见说法:「FastText 默认就用了子词」
实际上,有监督模式默认minn=0, maxn=0,子词是关闭的;只有无监督(skipgram/cbow)默认才用 3~6 的字符 n-gram。
为什么:课件第 6 页参数表里minn/maxn默认值就是 0,官方-help输出也印证了这一点。中文任务想吃到 OOV 红利,必须手动把minn/maxn打开(如 2/4)。 -
有人以为「
minn/maxn是分词参数」
其实它们管的是词内字符级 n-gram,前提是词已经被切出来了;分词要你自己做(中文配 jieba)。
原因在于,FastText 内部的 tokenize 只做通用处理(按空白切分,并把标点、非字母数字字符单独拆出来),不含任何语言相关的分词逻辑;官方教程也要求你在训练前自己把大小写归一化、在标点前后补空格。 -
常听到的一种说法是:「
wordNgrams也是子词」
真实情况是,它是词级 n-gram,把相邻的 N 个词拼成一个特征,用来识别短语;和字符级子词是两层不同的粒度。
背后的道理是,课件第 3 页把两者都写成「n-gram」,一个限制「分词被切到多长」,一个限制「最多连接几个分词」。 -
容易想岔的地方:「FastText 是深度模型,有隐藏层做特征提取」
事实正相反,默认结构就是「查表 → 平均 → 线性 + Softmax」,没有隐藏层和非线性;论文里为对照实验加过一个 h=10 的小隐层,但项目里调用的 fastText 就是这两层。
之所以如此,课件明确强调「可训练的部分只有词嵌入层和分类全连接层」,特征提取靠人工设计。 -
先说一个误解:「
.vec文件里有所有子词向量」
实际上,.vec只有词表里的整词向量(且按词频降序),子词与桶向量只在.bin里;OOV 词的向量必须通过.bin/API 现算。
为什么:.vec是给人看的纯文本快照,(.bin)才是包含哈希桶、超参数、输出层的完整模型。 -
常见说法:「层级 Softmax 比全量 Softmax 更准」
其实它是近似,解决的是算得快,不是算得准;类别数不多(如 10 类)时全量 softmax 更精确,类别上百万时才必须上hs/ns。
原因在于,Huffman 树的路径概率之积是对真实归一化概率的近似,类别少时省下的算力本来就不多。 -
有人以为「FastText 快是因为模型小 / 用了 GPU」
真实情况是,快来自算法与实现:平均池化省掉序列计算、层级 Softmax 把输出复杂度降到 O(d\log K)、哈希技巧省掉大特征表、多线程 C++、无 GPU。
背后的道理是,「10 亿词 10 分钟内」「50 万句 / 31.2 万类 1 分钟内」都是论文在标准多核 CPU 上给出的口径。 -
常听到的一种说法是:「调参就是把所有参数网格搜索一遍」
事实正相反,抓主要矛盾、分阶段推进:先lr、再正则化、后批大小/动量、最后结构。
之所以如此,参数之间存在耦合(改了结构,最优 lr 就变了),一次性全网格既贵又容易在噪声上过拟合验证集。 -
容易想岔的地方:「课件第 4 页画的 300 维就是 FastText 的词向量维度」
实际上,300 只是课件示意图里的列数;FastText 的dim默认是 100(无监督教程里说 100~300 都常见)。
为什么:第 4 页下方那张「词嵌入矩阵」图末尾标注了... 300,是通用画法,不要当成默认值背。
六、横向对比与研究脉络
| 维度 | TF-IDF + 随机森林 | FastText(有监督) | word2vec + 下游分类器 | BERT 微调 | LLM 零样本 |
|---|---|---|---|---|---|
| 文本表示 | 稀疏词袋 + IDF 权重 | 稠密子词向量平均 | 稠密词向量再池化 | 上下文相关向量 | 提示词 + 生成 |
| 子词/OOV 能力 | 无(未登录词直接丢弃) | 有(字符 n-gram + 哈希桶) | 无(查表,OOV 只能跳过) | 有(WordPiece/BPE) | 极强 |
| 词序建模 | 无 | 弱(靠 wordNgrams 局部补) |
无 | 强(自注意力) | 强 |
| 训练成本 | 秒级(sklearn,CPU) | 秒~分钟级(CPU,多线程) | 小时级(大语料) | 小时级(GPU) | 无需训练 |
| 推理成本 | 极低 | 极低(单次前向 = 查表 + 平均 + 内积) | 低 | 中高(GPU) | 高(API 计费) |
| 精度上界 | 基线 | 接近浅层深度模型 | 中 | 高 | 高(受提示影响大) |
| 典型场景 | 快速基线、可解释特征 | 大数据量基线/兜底、类别极多的场景 | 预训练词向量供下游用 | 精度优先 | 少样本、新类别冷启动 |
演进脉络(每一步都在解决上一步的痛点):
- 词袋 + 线性模型:简单快,但词表之间不共享统计量,稀疏且不共享参数;
- word2vec(CBOW / Skip-gram):用稠密向量表示词,解决稀疏问题;但每个整词一个向量,罕见词学不好、未登录词完全没有表示;
- FastText 子词版(Bojanowski 等,TACL 2017):把词拆成字符 n-gram 的集合,词向量 = 子词向量之和 → 解决 OOV 与形态丰富语言;论文同时指出,引入字符 n-gram 后训练大约比纯 Skip-gram 基线慢 1.5 倍(单线程约 105k 词/秒 vs 145k 词/秒),「慢一点」换来的是「能表示未见词」;
- FastText 分类版(Joulin 等,EACL 2017):把上述表示接上线性分类器 + 层级 Softmax + 哈希 n-gram,得到一个精度接近深度学习、速度快几个数量级的分类基线;
- BERT / 后续预训练模型:用自注意力带来上下文相关表示与词序建模,精度更高但需要 GPU、推理更贵;
- LLM 零样本/少样本分类:连训练都省了,代价是推理成本与稳定性。
被追问时最有用的落点是中间那一环:FastText 证明了「便宜的表示 + 便宜的池化 + 便宜的输出层」在文本分类上常常够用,这也是今天它仍然被当作强基线的原因。
七、在新闻分类项目中的落地
它是第二棒。项目路线是 TF-IDF + 随机森林 → FastText → BERT → LLM,数据 18w 训练 / 1w 验证 / 1w 测试,格式 标题\t标签,10 个类别。这一棒的具体动作:
① 数据格式转换(这是最容易翻车的地方)。原始是 标题\t标签,FastText 要的是 __label__标签 已分词标题:
import jieba
for line in open("train.txt", encoding="utf-8"):
    title, label = line.rstrip("\n").split("\t")
    # 注意:__label__ 和正文之间用空格分隔,正文各词之间也必须是空格
    print(f"__label__{label} {' '.join(jieba.lcut(title))}")
坑:必须自己分词;标签里不要带空格;文本里的 \t、换行要清掉;验证集/测试集转换方式必须和训练集完全一致。
② 关键参数怎么定(按第 4.5、4.6 节的机制推):
| 参数 | 建议 | 理由 |
|---|---|---|
lr |
从 0.1 起,小数据试 0.01~0.05 | 官方默认 0.1;18w 条不算大,0.01~0.1 之间都值得扫一遍(第 4.8 节的散点图显示 lr 对分数的影响很大) |
epoch |
5 → 10~25 | 默认 5 往往欠拟合;小数据多跑几轮更充分 |
wordNgrams |
2 | 新闻标题里「折叠屏 手机」「客场 逆转」这类短语很关键,bigram 是性价比最高的一档 |
minn/maxn |
2 / 4(中文建议打开) | 默认 0 关掉了子词,标题里常有新词、专有名词、错别字,子词能兜住 |
dim |
100(10 类任务不必更大) | 类别少、数据 18w,100 维足够;论文的分类实验也只用到 10~50 维级别的小模型 |
bucket |
500 000 ~ 1 000 000 | 内存账:bucket×dim×4B,默认 200 万 × 100 维 ≈ 763 MB,调到 50 万只剩 ~191 MB;小数据用不上大桶 |
loss |
softmax(10 类) |
类别数少,全量 softmax 更准;hs/ns 是给几十万类准备的 |
minCount |
1~2 | 保留更多低频词,中文标题词汇量有限 |
thread / seed |
核数-1;seed 固定 | 复现结果:每次实验记录 seed,否则对比 TF-IDF/BERT 时说不清提升来自哪里 |
| 自动调参 | autotuneValidationFile=验证集、autotuneMetric='f1'、autotuneDuration=600 |
直接把第 1w 验证集丢进去省手工试错;对 10 类不均衡数据看 f1 比看 accuracy 更靠谱 |
③ 实际坑(都是这份原理直接推得出来的):
- 模型容量不在网络深度上,而在特征上:FastText 的精度上限几乎被「分词质量 + n-gram 粒度」锁死。标题里有大量新词(明星名、产品名),
minn/maxn打开与否能差出可观精度,这就是为什么要先把原理搞懂再调参。 - 平均会丢词序:「3 比 1 胜」和「1 比 3 胜」向量相同,靠
wordNgrams=2缓解;要更强调词序就得换 BERT,这也正好构成项目里「为什么还要上第三棒」的表达话术。 - 不要和 TF-IDF 用同一套停用词逻辑:749 个停用词是给
TfidfVectorizer(stop_words=停用词)用的;FastText 里删词不是必需的(它靠 n-gram 与哈希桶处理),如果两边预处理不一致,对比实验就不公平。 - 类别不均衡:
softmax下模型偏向大类;用 f1 做选择指标,必要时上loss='ova'看多标签/开集表现。 - 压缩阶段可以直接复用:fastText 自带
quantize命令,能把模型量化成.ftz(还有cutoff裁掉低频词/ngram、retrain微调嵌入、qout量化分类器、dsub子向量维度等参数),正好和项目后面「量化(QAT/PTQ/DQ)、剪枝、低秩分解、蒸馏」这一章呼应,FastText 是最容易讲清「量化后内存降多少、精度掉几个点」的对照模型,比拿 BERT 讲量化轻量得多。 - 可以当蒸馏的 teacher 或软标签来源:10 类的 fastText 输出概率足够平滑,做硬标签/软标签蒸馏的对照都很方便。
④ 与其它三棒的配合:
- 对 TF-IDF + 随机森林:同样 18w 数据,FastText 用稠密子词表示,预期在长尾标题上更稳;两者对比是「稀疏特征 vs 稠密特征」的经典论据。
- 对 BERT:FastText 提供「精度的下界 + 成本的下界」,BERT 带来词序与上下文;被追问时用「FastText 秒级 vs BERT 小时级、精度差多少个百分点」来量化收益。
- 对 LLM:
pretrainedVectors可以把 fastText 的预训练词向量喂给有监督训练;反过来,LLM 做零样本分类时,fastText 常作为「便宜的先筛一遍」的路由器,10 类里先用 fastText 出一版预测,低置信度的样本再交给 DeepSeek API 复核。 - 部署:Flask 服务端加载
model.bin(或量化后的.ftz),Streamlit 客户端传标题;FastText 单次预测就是查表 + 平均 + 内积,CPU 上延迟可以忽略,适合和 BERT 服务做降级兜底。
八、重点问答
Q1:FastText 是什么?它的模型结构长什么样?
A:一句话说,它是 Meta 开源的词向量计算 + 文本分类工具,核心特点是「人工设计特征 + 极少的可训练参数」。结构上只有两块是可学的:一个词嵌入矩阵(查表)和一个分类全连接层。前向就是「分词 → 查表 → 向量平均 → 全连接 → softmax」,中间的分词、字符 n-gram、word n-gram、平均都是人定的规则,没有隐藏层和非线性。所以它介于传统算法和深度学习之间:靠人工把特征嚼碎,再让两层参数去学怎么用这些特征。
Q2:为什么 FastText 能处理没见过的词(OOV)?
A:因为它不把词当成最小单位,而是把词拆成字符 n-gram 的集合。具体做法是给词加上边界符、取出长度在 minn~maxn 之间的所有片段,每个片段用哈希函数映射到一个固定大小的桶里,词的向量就是这些片段向量的和。这样即使整词从没出现过,只要它的片段在训练中见过,相加之后仍然是一个有语义的向量。官方文档里有个很直观的例子:拼错的 accomodation,开子词后最近邻是 accommodation、accommodations 这些词;关掉子词就变成一堆不相干的噪声词。对德语复合词、土耳其语这种形态丰富的语言,子词还解决了词表爆炸的问题。
Q3:Hash 桶是什么?冲突了怎么办?
A:字符 n-gram 的数量近乎无穷,不可能给每个片段分配一行参数,所以 FastText 用哈希把它映射到固定数量的桶,默认 bucket 是 200 万,索引就是 词表大小 + hash(片段) % bucket。冲突是故意接受的有损设计:默认桶数下平均每桶一个片段,大约 26% 的桶会装上两个以上不同片段,相当于让它们共享一个向量。工程上这笔账是划算的,用一点点表示精度换来「内存固定、不用维护超大哈希表」,而且实践中冲突的影响可以靠调大 bucket 或调小 minn/maxn 来平衡。顺带一个实用的内存公式:输入嵌入矩阵大约 (词表 + bucket) × dim × 4 字节,默认 200 万桶、100 维就是约 763 MB。
Q4:FastText 为什么训练这么快?
A:三个层面。第一,输入侧用平均池化代替序列建模,没有 RNN 的递推也没有注意力,一句话的表示就是若干个向量的加法,复杂度对句长线性,还能多线程并行。第二,输出侧用层级 Softmax 近似全量 Softmax,Huffman 树让高频标签路径短,复杂度从 O(K·d) 降到 O(d·log K),类别极多的时候差距是数量级的。第三,工程实现上用了哈希技巧省掉大特征表、C++ 实现、默认多线程。论文给的口径是标准多核 CPU 上 10 亿词十分钟内训完、31 万个类一分钟内分类 50 万句,全部不依赖 GPU。
Q5:层级 Softmax 的原理是什么?
A:它把多分类拆成一串二分类。做法是建一棵二叉树,叶子是标签,每个中间节点有一个可训练的二分类激活函数,决定往左还是往右走;某个标签的概率等于从根到它那条路径上所有节点概率的乘积。fastText 具体用的是 Huffman 树,高频标签路径更短,所以输出层的平均查询时间是最优的。要强调的是它是近似、不是更准:类别数少的时候全量 softmax 更精确,只有类别数到几十万时层级 Softmax 才是必需的。
Q6:有监督分类的数据格式和常用 API 是什么?
A:数据是每行「一个或多个标签 + 文本」,标签用默认前缀 __label__ 标识,比如 __label__体育 国足 客场 逆转 取胜;每行至少要有一个标签,文本要预先分好词。代码上,入口是 fasttext.train_supervised(input=...),之后 model.save_model() 保存、model.predict(text, k=3) 预测 top-k、model.test(valid) 评估,test 返回的是 (样本数, P@1, R@1) 三个值。想做自动调参就给 autotuneValidationFile 传验证集,autotuneMetric 默认 f1,autotuneDuration 控制搜索时长。多标签用 loss='ova',类别数极多再考虑 hs 或 ns。
Q7:预训练的 fastText 词向量和有监督分类模型有什么区别?
A:是两条产线。无监督模式(skipgram/cbow)吃纯文本、不带标签,产出的是词向量,默认开启子词(minn=3, maxn=6),输出 .vec 文本词表和 .bin 二进制模型;有监督模式吃 __label__ 格式的带标签数据,产出的是分类器,默认关闭子词(minn=maxn=0)。文件用途也不同:.vec 是纯文本,第一行是「词数 维度」的表头,之后按词频降序排列整词向量,子词和桶向量不在里面;.bin 才是完整模型,可以重载、可以给未登录词现算向量、可以做量化压缩成 .ftz。
Q8:拿到一个新任务,你怎么调 FastText 的参数?
A:先定「主要矛盾」,再分阶段试。第一步永远是解决收敛问题,先扫 lr(默认 0.1,小数据试 0.01~0.05),把分数随 lr 的变化画出来找最佳区间;第二步固定 lr,再调泛化相关的 epoch、wordNgrams;第三步调表示层,中文一定把 minn/maxn 打开(比如 2/4),再按内存预算定 bucket;最后才动 dim 这种改结构的参数,因为结构一变最优 lr 也会变。有验证集的时候直接上 autotuneValidationFile,它的原理就是「分析参数重要性 → 判断调整方向 → 在已探索的最优点附近精调 + 采样未探索区域」,比盲目网格搜索省时间。所有实验固定 seed 和 thread,否则复现不了。
九、延伸阅读
官方文档与代码
- fastText 官网文本分类教程:https://fasttext.cc/docs/en/supervised-tutorial.html (
__label__格式、train_supervised、test返回(N, P@1, R@1)、层级 Softmax 的 Huffman 树说明、多标签ova用法) - fastText 官网词向量教程:https://fasttext.cc/docs/en/unsupervised-tutorial.html (
.vec/.bin的区别、minn/maxn默认 3~6、OOV 与accomodation对比实验、nn最近邻) - 参数列表(含全部默认值):https://fasttext.cc/docs/en/options.html
- 命令速查表(含
quantize与autotune用法):https://fasttext.cc/docs/en/cheatsheet.html - 预训练词向量(官方发布的 294 种语言 wiki 词向量):https://fasttext.cc/docs/en/pretrained-vectors.html
- 源码仓库:https://github.com/facebookresearch/fastText
论文
- Piotr Bojanowski, Edouard Grave, Armand Joulin, Tomas Mikolov. Enriching Word Vectors with Subword Information. TACL, vol. 5, pp. 135–146, 2017. arXiv:1607.04606,字符 n-gram + 边界符 + 词 = 子词向量之和的来源。
- Armand Joulin, Edouard Grave, Piotr Bojanowski, Tomas Mikolov. Bag of Tricks for Efficient Text Classification. EACL 2017 (Short Papers), pp. 427–431. arXiv:1607.01759,线性分类器 + 哈希 n-gram + 层级 Softmax 的「高效分类」配方。
- Tomas Mikolov 等,word2vec 原始工作(CBOW / Skip-gram,arXiv:1301.3781),是理解第 4.5 节「CBOW 式平均」的前置。
同目录配套材料
【了解】fastText参数示例.原文.md(对应【了解】fastText参数示例.xlsx):26 个参数的中文默认值、取值范围与调优建议表,与本报告第 4.6、4.8、七节互为补充,调参时按它查表最省事。