用「BERT = 3 个可训练 Embedding 输入层 + 多层 Transformer Encoder 堆叠,再在第一个位置接一个 fc」这一句话,把 BERT 的输入表示、Encoder-only 双向结构、两大预训练任务(MLM / NSP)和微调范式一次讲清,并直接落到本项目 BertModel + nn.Linear(768, 10) 的代码上。
一、这份材料解决什么问题
在新闻分类项目的四棒技术路线(TF-IDF + 随机森林 → FastText → BERT 微调 → LLM 零样本/少样本)里,BERT 是第三棒,也是唯一一个真正的上下文相关(contextual)模型:前两棒(TF-IDF、FastText)拿到的都是”一个词一个固定向量”,不管上下文怎么变,”苹果”都是同一个向量。而 BERT 的输出是每个 token 在具体句子里的上下文嵌入,同一个词在不同句子里得到不同的向量,这就是它能大幅拉开分类指标的原因,也是评审者最想听的那句话。
这份课件要回答三个层层递进的问题:
- 文字怎么变成向量?从自编码器(把图片压成一个 latent 向量再重建)这个直觉切入,建立”一切理解都始于 embedding”的认知。
- BERT 到底是什么结构?它不是一个”分类器”,而是一个输入文字、输出向量的网络结构,3 层 Embedding 相加,再堆 N 层 Transformer Encoder。
- 怎么用它做分类?取第一个位置(
[CLS])的输出,课件明确指出”只有这里的输出包含句子全部意思”,再接一个带 softmax 的全连接层,输出 10 个类别的概率。
课件的态度非常鲜明,值得原样记住:「Bert 只是一个网络结构,你甚至可以把它当成一个全连接层!只不过这个网络结构输入的是文字,输出的是向量。那么具体你怎么训练这个网络、你怎么用这个网络,那是你的事情。」 预先训练(MLM / NSP)与下游微调(句子分类)是两件事,不同的训练方法服务不同的目的。
图注:课件首页配图(装饰性),Google 标识与《芝麻街》里 Bert 的玩偶形象,BERT 的命名正来自这个布偶角色。它不承载技术信息,但点明了”Google 提出”这一出处。
二、核心结论
- BERT = 3 个可训练 Embedding 输入层 + 多层 Transformer Encoder 堆叠。课件原文:”Bert 就是一个由 3 个可训练 Embedding 输入层 + 多层 Transformer 编码器堆叠的网络结构。”
- 输入嵌入是”相加”不是”拼接”:
输入向量 = 词向量(Token)+ 句子向量(Segment)+ 位置向量(Position),三者逐元素相加,维度都是 768。 [CLS]位置的输出是句子级表示。它是唯一”包含整个句子完整语义”的位置,其他位置只对应各自那个词的语义;序列内用[SEP]分隔句子 A / B 并标记结尾。- 两个预训练任务的定位不同:MLM(完形填空)逼模型学上下文语义,NSP(句子关系判断)逼
[CLS]学会聚合整句信息,正因为有 NSP,[CLS]才天然适合做句子分类。 - 微调 = 预训练 BERT 本体 + 一个 fc 分类头。
nn.Linear(768, 10)把 768 维语义向量映射成 10 类分数,只训练下游任务的目标,不需要重新设计网络。
三、知识地图
| 层级 | 知识点 | 课件权重 | 对应页 |
|---|---|---|---|
| 定位 | BERT 是 Google 提出的、基于 Transformer 的预训练语言模型;自动学习词间关系与上下文 | 【掌握】 | P1 |
| 定位 | 核心思想:深层 Transformer 自动学语义与上下文,无需人工设计特征规则 | 【掌握】 | P1 |
| 直觉 | 从自编码器理解”文字 → 向量 → 输出” | 【理解】 | P2、P3 |
| 结构 | 3 个 Embedding 层(词向量 / 区分句子的向量 / 位置向量)相加 | 【掌握】 | P4 |
| 结构 | 多层 Transformer Encoder 堆叠(Trm 块,全连接式双向注意力) |
【掌握】 | P4、P5 |
| 结构 | [CLS] / [SEP] 的作用与位置 |
【掌握】 | P4、P5 |
| 结构 | 第一个位置输出含全句语义 → 接 softmax 全连接得到句子分类概率 | 【掌握】 | P5、P7 |
| 训练 | 心态:BERT 只是网络结构,怎么训练是使用者的事 | 【掌握】 | P6 |
| 训练 | 预训练任务:Masked Language Model(完形填空) | 【理解】 | P6 |
| 训练 | 预训练任务:Next Sentence Prediction(句子关系判断) | 【理解】 | P6 |
| 训练 | 不同下游任务取不同位置的输出(句子分类 / 序列标注 / 问答 / 相似度) | 【理解】 | P6 |
| 落地 | 本项目只做分类:取第一个位置输出 + fc(768→10) | 【掌握】 | P7、P8 |
| 落地 | BertClassifier:BERT 本体 + 分类用 fc,forward 返回 10 类预测 |
【掌握】 | P8 |
| 落地 | utils.py:文本格式转化 + 封装成 PyTorch 的 train_dataloader 迭代器 |
【掌握】 | P9 |
四、原理详解
4.1 先建立直觉:一切”理解”都始于把输入压成向量
课件用自编码器(Autoencoder)打地基:一张人脸照片送进网络,被压缩成一串很短的数值(latent 表示),再从这串数值重建出人脸。压缩出来的那串数值里,每一个维度其实是某种可解释的语义属性,课件在图上标了”眼睛大小、头发颜色、鼻子大小……”。
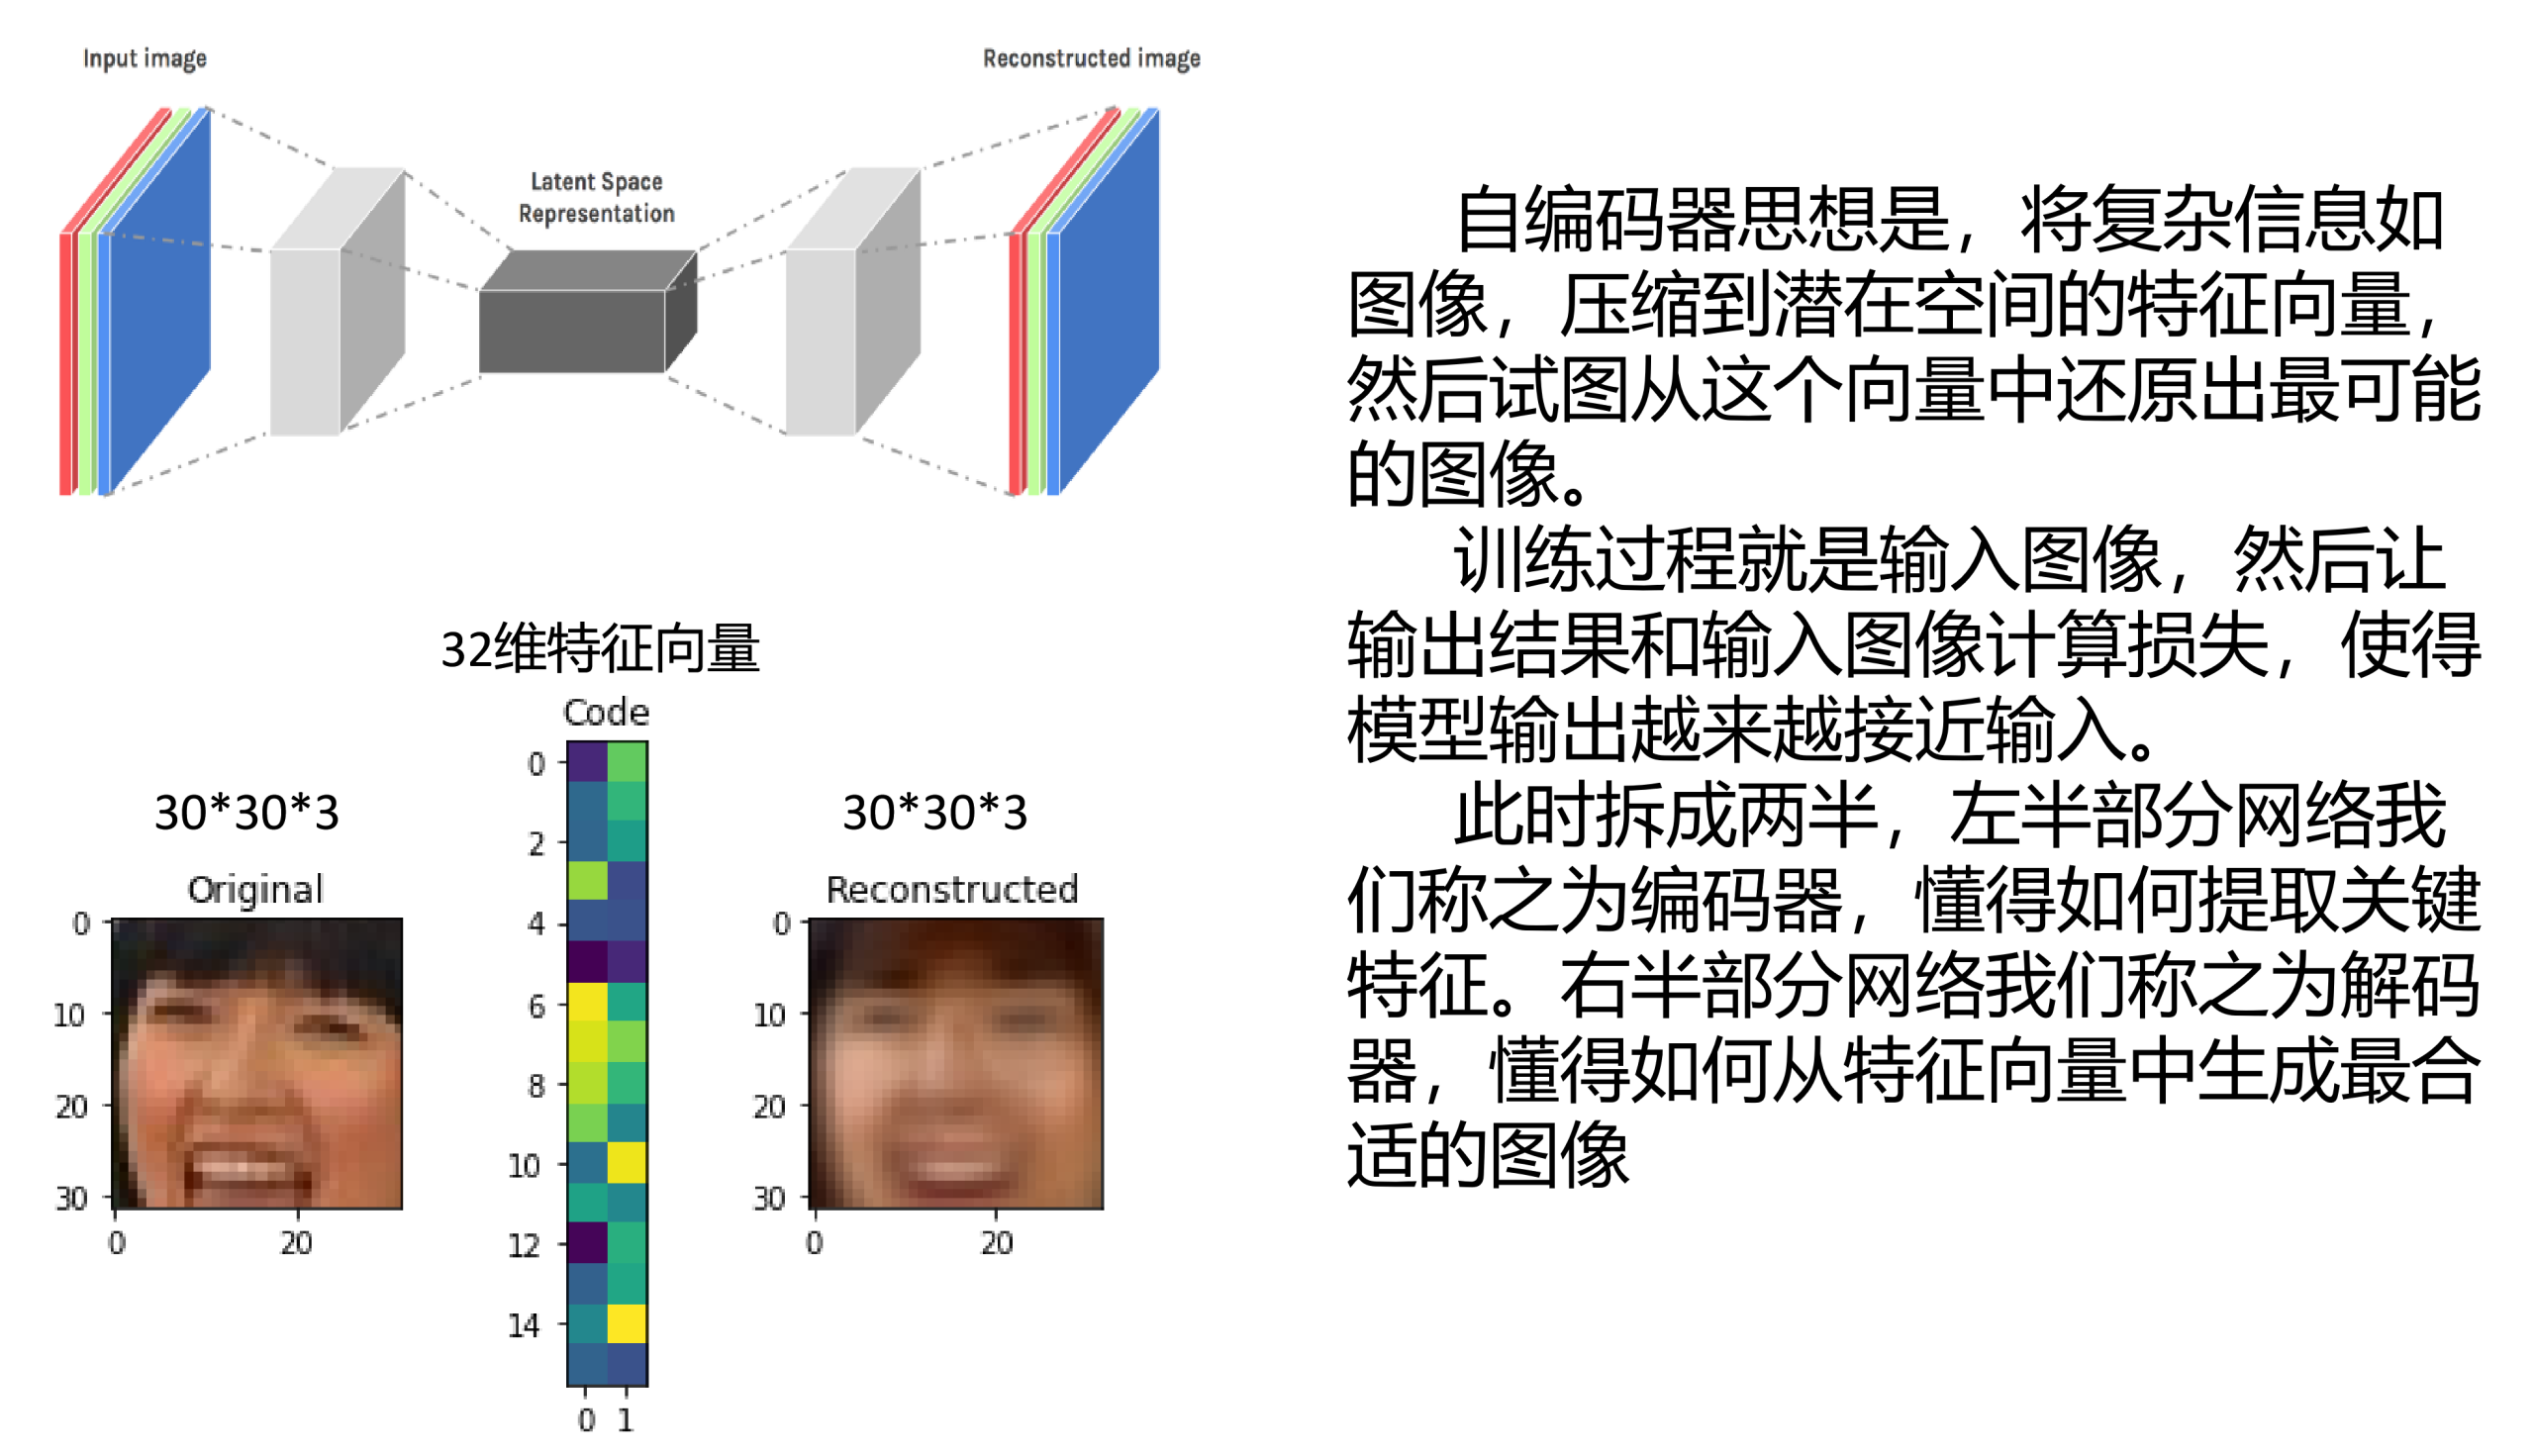
图注:一张图里画了两件事。上半部分是标准的自编码器流程:Input image → Latent Space Representation(中间的瓶颈型小立方体)→ Reconstructed image;下半部分是一张真实人脸照片,先被编成一列彩色方块(即 latent 向量),再重建出一张明显模糊的人脸。页面文字点出这列方块里各维的含义:”眼睛大小、头发颜色、鼻子大小……”。它想说的不是自编码器本身,而是”一张图可以变成一个向量,而且向量的每一维有语义”。
同样的道理搬到文本上:一句话也可以变成一个向量。课件第 3 页把这句话直接摆在图上,
图注:仍是那张自编码器结构图,幻灯片在它上面压了一个从左上指向右下的大号蓝色箭头,配的文字是 你好,你是谁 → [0.12, 0.65, 1.22, 0.17 ...] → my name is jack。意思是:输入一句中文,中间得到一串浮点数向量,再由这串向量产出目标文字。同一个语义可以对应不同语言的表面形式,而向量是它们共同的中间表示,这就是”embedding 是语义空间里的坐标”的最朴素演示。
这里要建立的三个认知:
– 模型的输入永远是数字,文本必须先变成向量(embedding);
– 这串向量是”学”出来的,不是人工设计的(课件第 1 页:无需人工设计特征提取规则);
– 得到一个句子向量之后,想拿它做什么(分类、翻译、检索),是你接下游网络的事。
4.2 BERT 的整体结构:Encoder 堆叠
课件第 4 页给出了 BERT 结构的骨架图,这张图是全篇的”母图”。
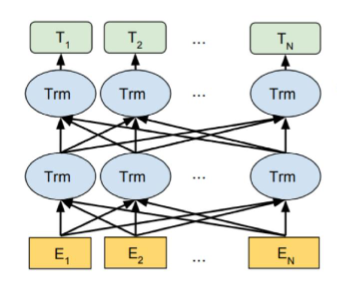
图注:底部一排黄色方块 E_1 … E_N 是输入嵌入(对应 N 个 token 位置);中间两层浅蓝色圆角节点标着 Trm(Transformer 块),节点之间画满了灰色的两两相连箭头,这表示任意两个位置之间都有注意力通路,也就是双向;顶部一排绿色方块 T_1 … T_N 是每个位置对应的输出向量。注意 E 和 T 的数量完全相同:BERT 不改变序列长度,输入 L 个 token 就输出 L 个向量。
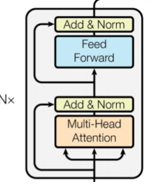
图注:这是单个 Transformer 编码器块的内部结构(自下而上看)。输入先经过 Multi-Head Attention(多头自注意力),再经过 Add & Norm(残差相加 + 层归一化),然后进入 Feed Forward(前馈网络),最后再来一次 Add & Norm;中间层结构图左侧标着 Nx,意思是这个块会被重复堆叠 N 次。两张 Add & Norm 旁边都能看到从输入绕过子层直接接到输出的残差旁路。
课件第 4 页把它一句话总结为:「Bert 就是一个由 3 个可训练 Embedding 输入层 + 多层 Transformer 编码器堆叠的网络结构。」
这里必须记住一个数字来源:课件第 8 页的代码注释写明了本项目的 config.json,12 层 Transformer 层、768 维隐藏层、约 1.1 亿个参数。也就是说上面那个 Nx 在本项目里是 12,每个位置的向量维度是 768。
讲完结构,第 4 页又把这套”输入→向量”的直觉重放了一遍(复用第 2 页那张自编码器图),才转到下面的三类 embedding:
图注(复用视角):从”照片 → latent 向量 → 重建照片”过渡到”句子 → 768 维向量 → 下游输出”,说明接下来的三类 embedding 干的正是把离散符号编成连续向量这件事。
4.3 Input Embedding:Token + Segment + Position 三类相加
这是全篇最该背下来的一张图。课件第 4 页的文字是:”通过三种不同的 embedding 层将输入转换为嵌入向量:词向量、区分句子向量、位置向量”。
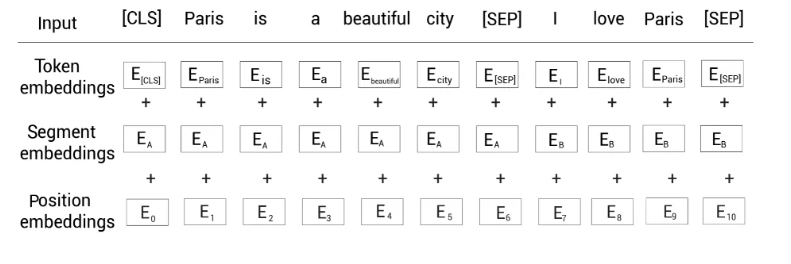
图注:这张图把三类嵌入做成了上下对齐的四行,最底部用 + 把三行逐列相加。
– 第一行 Input:[CLS] Paris is a beautiful city [SEP] I love Paris [SEP],共 11 个位置。
– 第二行 Token embeddings(词向量):每个位置一个方块,符号写作 E_[CLS]、E_Paris、E_is、E_a、E_beautiful、E_city、E_[SEP]、E_I、E_love、E_Paris、E_[SEP],注意 Paris 出现两次、[SEP] 出现两次,同一个 token 拿到的是同一个 token embedding。
– 第三行 Segment embeddings(区分句子的向量):前 7 个位置全部是 E_A,后 4 个位置全部是 E_B。第一个句子连同它末尾的 [SEP] 都算句子 A,第二个句子连同末尾的 [SEP] 都算句子 B。
– 第四行 Position embeddings(位置向量):E_0 到 E_10,每个位置一个独立可学习的向量。
– 合并方式:每一列三个方块之间都是 +,也就是逐元素相加,得到 11 个 768 维向量送入 Encoder。

图注:这是同一张图被裁出来的第一行,单独放大展示输入序列本身:[CLS] Paris is a beautiful city [SEP] I love Paris [SEP]。它提醒读者:三类 embedding 是”对齐到 token 位置”的,所以才能逐元素相加。
写成公式:
e_i = E_{\text{token}}(t_i) + E_{\text{segment}}(s_i) + E_{\text{position}}(i), \qquad e_i \in \mathbb{R}^{768}
X = [e_0, e_1, \dots, e_{L-1}]^{\top} \in \mathbb{R}^{L \times 768}
带数字的小例子(就用图上这句话):
– 序列长度 L = 11 → 输入矩阵 X 的形状是 11 \times 768;
– token 序列长度是 5(Paris is a beautiful city)+ 3(I love Paris)+ 2 个 [SEP] + 1 个 [CLS] = 11;
– beautiful 这个位置拿到的是 E_{\text{beautiful}} + E_A + E_4,三者的维度都是 768,相加后仍是 768 维;
– 第二个 Paris 位置的 token 向量与第一个 Paris 相同,但 segment 向量(都是 E_A)相同、position 向量不同(E_1 vs E_9),所以两个位置最终拿到的输入向量不一样,这就是位置嵌入存在的意义。
补充(通识,课件未展开):中文 BERT 的实际 tokenizer 是 WordPiece,
[CLS]、[SEP]、[MASK]、[PAD]、[UNK]都是词表里的特殊符号;长单词会被切成子词(如playing → play + ##ing,##表示”接在前一个子词后面”)。因此上面 11 个位置在实际运行时会先经过 tokenizer 的切分。
4.4 [CLS] 与 [SEP] 的作用
[CLS](classification 的缩写)
– 位置:永远放在序列的第一个位置;
– 本身没有词义,不对应任何一个真实字符;
– 关键性质:它在最后一层的输出(课件里写作 R_[CLS])聚合了整个句子的语义,是整句的”代表向量”;
– 用途:句子分类、句子对分类这类序列级任务直接取它(第 6 页表格里”句子分类/句子对分类”这一列写的就是”只取 [CLS] 位置”)。
[SEP](separator 的缩写)
– 用来分隔两个句子,并且各自的末尾都要放:[CLS] A [SEP] B [SEP];
– 单句输入时同样要加,变成 [CLS] A [SEP];
– 配合 segment embedding:A [SEP] 一段是 E_A,B [SEP] 一段是 E_B,”[SEP] 是句子结束标记”这个信息也要靠它自身的向量表达出来。
课件第 5 页的表格(见 4.8 节图注)给出了一个”哪个任务取哪个位置输出”的通用对照,值得整体记住:序列标注(NER、词性标注)和问答(SQuAD)要全部位置的输出,因为要逐词判断或预测答案的起始/结束位置;句子分类、句子对分类(自然语言推理)、文本相似度则只依赖 [CLS] 或池化后的句子向量。
4.5 Encoder-only 与双向注意力的意义
课件第 1 页给 BERT 的定位是”基于 Transformer 架构的预训练语言模型”,第 4 页的结构图里,Trm 节点之间的箭头是两两全连接的,这不是画得随意,它对应的正是自注意力机制:序列中任意两个位置都可以互相”看见”。
为什么双向重要?因为自然语言里大量信息要靠上下文消歧:
苹果发布了新手机vs我买了两斤苹果,同一个”苹果”,靠左右两侧的词才能确定是公司还是水果;他写的那本书我很喜欢,因为它很精彩,”它”指什么,要看前面的”书”;- 只看左侧(单向)只能利用前文,猜不出后面的限定;只看右侧同理。
代价是什么?双向意味着每个位置都能看到它自己(包括它要”预测”的那个词),所以不能再用标准的”预测下一个词”语言建模目标来训练,否则模型只要抄自己就行。BERT 的解法是把词盖住再猜,即下面的 MLM。这个”为什么必须用 MLM”的因果链,是被追问时最能体现理解深度的部分。
Encoder-only 的意思:BERT 只保留 Transformer 的编码器部分,不做生成。它输入一个序列,输出一个等长的向量序列(L \to L \times 768),没有 decoder、没有逐词生成的过程。这与 GPT 系(decoder-only、自回归生成)是两条路线。
4.6 预训练任务一:MLM(Masked Language Model,完形填空)
课件原文:”Masked Language Model (MLM) – 完形填空”。它的机制(以下为 BERT 原论文的标准做法,课件只给了名字,这里补全细节):
- 选目标:在一句话里随机挑出 15% 的 token 作为要预测的目标。
- 替换策略(80/10/10):这 15% 里,
- 80% 替换成
[MASK],例如我 [MASK] 看电影; - 10% 替换成一个随机词,例如
我 苹果 看电影; - 10% 保持原词不变,例如
我 喜欢 看电影。 - 算损失:模型对这 15% 位置的输出接一个词表大小的分类头,做多分类,只在被选中的位置上计算 loss,其余位置不参与。
- 为什么不是 100%
[MASK]:[MASK]这个符号在真实文本里根本不会出现,如果目标位置永远被替换成它,就会造成预训练与微调之间的不匹配,微调时输入里没有[MASK],模型却把”看到[MASK]才去聚合上下文”当成了条件。插入 10% 随机词、10% 原词,就是为了强迫模型对每一个位置的表示都保持”上下文敏感”,而不是只在看到[MASK]时才认真工作。
课件第 6 页配套的任务类型表(见 4.8 节)从另一个角度呼应了这件事:不同任务要取不同位置的输出。MLM 正好要”每个位置的输出”,因为预测散落在句中各处。
4.7 预训练任务二:NSP(Next Sentence Prediction)及其后续争议
课件原文:”Next Sentence Prediction (NSP) – 句子关系判断”。
给模型成对的句子 A、B(拼成 [CLS] A [SEP] B [SEP]),让模型判断 B 是不是 A 的真实下一句。构造训练样本时各取一半:
– 50% 正例:B 真的是 A 的下一句,标签 IsNext;
– 50% 负例:B 是从语料里随机抽的另一句,标签 NotNext。
这个二分类就是在 [CLS] 上接一个”Feedforward network + softmax”做的,课件第 5 页 / 第 7 页的右侧图,输出的正是 0.9 isNext / 0.1 NotNext。
NSP 对本项目为什么关键:因为 [CLS] 要被用来判断”两句关系”,模型就不得不把整句信息压缩进 [CLS] 的向量里。所以到微调做单句分类时,[CLS] 的输出天然就是一个可用的句子表示。这就是”为什么取第一个位置”这件事的根源。
后续研究的质疑(通识,课件未展开,可直接讲):
– NSP 的负例是从另一个文档里随机抽句子,任务过于简单,很多情况下只要看主题词是否一致就能答对,模型学到的是”两句是否同主题”,而不是真正的句间推理;
– RoBERTa 的一系列实验发现去掉 NSP、改用动态 mask 并加大数据与训练步数,效果反而更好,说明 NSP 至少不是必要的;
– ALBERT 则把 NSP 换成了 SOP(Sentence Order Prediction,句子顺序预测):两句来自同一篇文档但顺序可能颠倒,让模型判断”是 (A,B) 还是 (B,A)”,剔除了”主题一致性”这条捷径,从而把任务难度提上来。
– 结论性说法:MLM 是 BERT 的核心贡献,NSP 是有争议的辅助任务;句子级表示也可以靠”平均池化 / 取 [CLS]“在只有 MLM 的模型上得到。被追问时这么答既准确又显得有阅读量。
4.8 微调范式:在 [CLS] 上接分类头
课件第 5 页的文字是这个范式的完整说明:”第一个位置的输出的向量,包含了整个句子的完整语义,再接一个带有 softmax 函数的全连接网络,可以得到输入的句子分类概率。”
第 5 页的任务类型对照表:
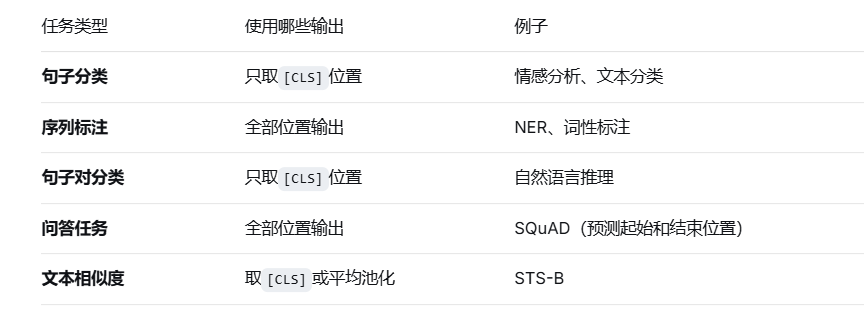
图注:这是一张三列表格,列头是「任务类型 / 使用哪些输出 / 例子」,五行内容为:
– 句子分类:只取 [CLS] 位置,情感分析、文本分类;
– 序列标注:全部位置输出,NER、词性标注;
– 句子对分类:只取 [CLS] 位置,自然语言推理;
– 问答任务:全部位置输出,SQuAD(预测起始和结束位置);
– 文本相似度:取 [CLS] 或平均池化,STS-B。
它把”[CLS] 不是随便取的”这件事讲成了通用规律:要一个句子级向量就取 [CLS],要逐词判断就取全部位置的输出。
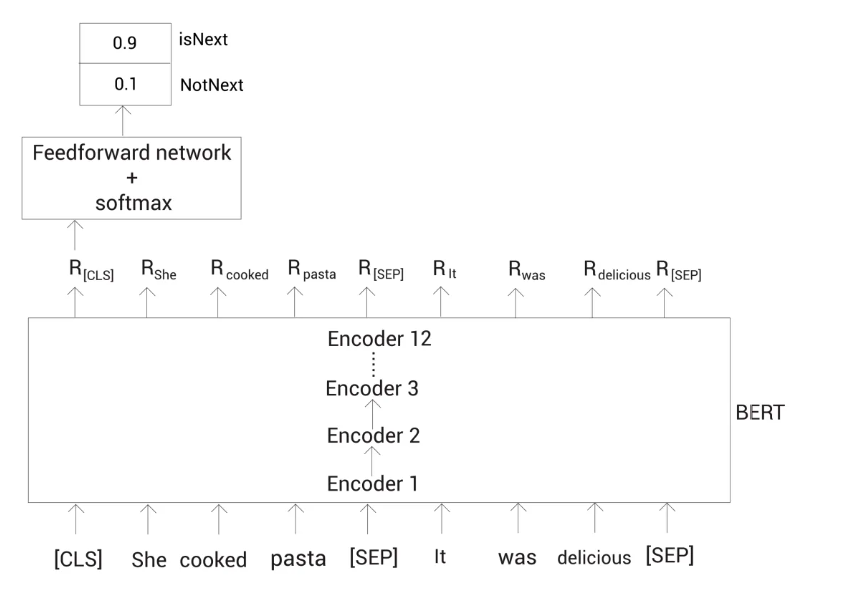
图注:这是”在 [CLS] 上接分类头”最清晰的一张图。底部输入是 [CLS] She cooked pasta [SEP] It was delicious [SEP],向上依次穿过 Encoder 1、Encoder 2、Encoder 3 … Encoder 12(共 12 层,中间用省略号略去),在顶部为每个位置各产生一个输出向量:R_[CLS]、R_She、R_cooked、R_pasta、R_[SEP]、R_It…;从图上可以清楚看到只有最左边的 R_[CLS] 被一条箭头单独引出去,送进上方的 Feedforward network + softmax,输出 0.9 isNext / 0.1 NotNext 两个数。其余位置的输出向量在图上都停留在原地、没有被使用,这就是”句子级任务只取第一个位置”的可视化。
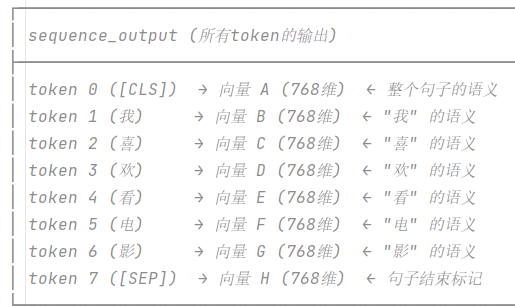
图注:这张表用一句中文 我喜欢看电影 讲同一个道理,标题是 sequence_output(所有 token 的输出),逐行给出每个位置的输出与含义:token 0 ([CLS]) → 向量 A(768 维) ← 整个句子的语义;token 1 (我) → 向量 B(768 维) ← “我”的语义;……;token 7 ([SEP]) → 向量 H(768 维) ← 句子结束标记。八个位置对应 A~H 八个 768 维向量,只有 A(也就是 [CLS] 那一个)代表整句。
微调范式的完整逻辑链:
1. 加载预训练好的 BERT 权重(已经通过 MLM + NSP 学会了语法、语义与句间关系);
2. 在 [CLS] 的输出(768 维)后面新加一个全连接层 W \in \mathbb{R}^{10 \times 768},得到 10 个 logits;
3. 过 softmax 得到 10 类概率,用交叉熵损失和真实标签算 loss;
4. 反向传播更新参数,一般 BERT 本体和分类头一起微调(课件第 8 页的 forward 正是这种”一体”写法)。
课件第 7 页的强调再引一次:”本项目只需要分类,所以需要取第一个位置的输出,只有这里的输出包含句子全部意思,其他位置输出只是对应位置词的意思。那么我们为了分类,还需要加一个 fc 层,把第一个位置输出的 768 维向量变成 10 维的类别。”
4.9 第 5 页为什么又把第 4 页的图重放了一遍
课件第 5 页的图 1–4 与第 4 页的图 1、3、4、5 是同一批文件(抽取稿里两页引用相同的图片路径)。重放一次是为了在讲”取 [CLS]“之前把”信息如何从输入流到输出”再走一遍,因此下面四张图内容相同、图注改为强调输出端每个位置都有一份向量:
图注(重看视角):输出是 T_1 … T_N 共 N 个向量而不是 1 个,所以句子级任务取 T_1([CLS]),逐词任务用全部 T_i。
图注(重看视角):正因为三类 embedding 逐元素相加,第一个位置([CLS])从进入网络的第一刻起就带着 segment 信息与 position 信息(E_0),而不是一个纯符号。
图注(重看视角):若做的是单句分类而非句子对,输入就退化成 [CLS] A [SEP],segment embedding 全是 E_A,位置向量重新从 E_0 编号。
图注(重看视角):每个 Trm 块的 Multi-Head Attention 都是双向全连接,堆到第 12 层时 [CLS] 的输出已”看过”整条序列,信息聚合发生在层堆叠里,不靠某个特殊操作。
4.10 从结构到代码:BertClassifier 与数据管道
课件第 7 页给出复合示意图,把”结构”和”分类头”画在同一张里:
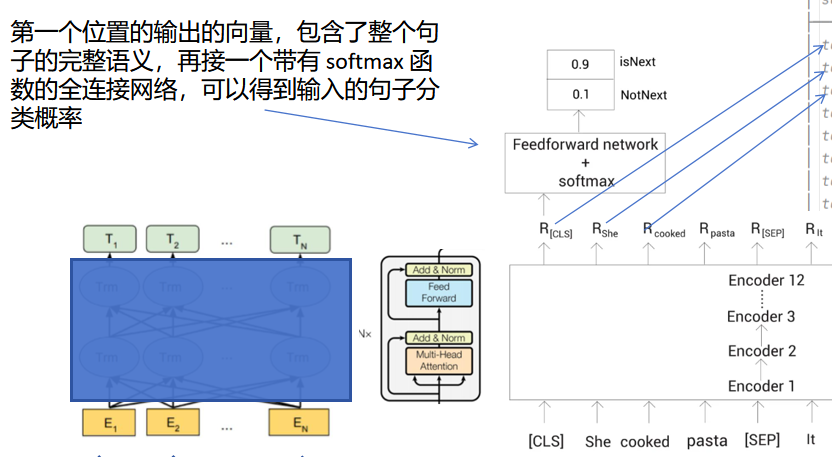
图注:这张图由三块拼成。
– 左上角中文说明:”第一个位置的输出的向量,包含了整个句子的完整语义,再接一个带有 softmax 函数的全连接网络,可以得到输入的句子分类概率”,并有一条蓝色箭头指向右下方的分类头。
– 左下角:E_1, E_2 … E_N(黄色)→ 蓝色大框内多层 Trm 节点(两两相连的灰色箭头)→ T_1, T_2 … T_N(绿色),即 Encoder 堆叠的整体视图。
– 中间偏右:单个 Encoder 块的竖排结构,自下而上是 Multi-Head Attention → Add & Norm → Feed Forward → Add & Norm(最上面一块标着 Add & Norm 的方框是蓝绿色的),左侧竖排标注 Nx。
– 右下角:输入 [CLS] She cooked pasta [SEP] It ... → Encoder 1 / Encoder 2 / Encoder 3 / … / Encoder 12 → 一排输出 R_[CLS]、R_She、R_cooked、R_pasta、R_[SEP]、R_It → 只有 R_[CLS] 向上送进 Feedforward network + softmax → 0.9 isNext / 0.1 NotNext。
课件第 8 页给出了本项目的落地实现:
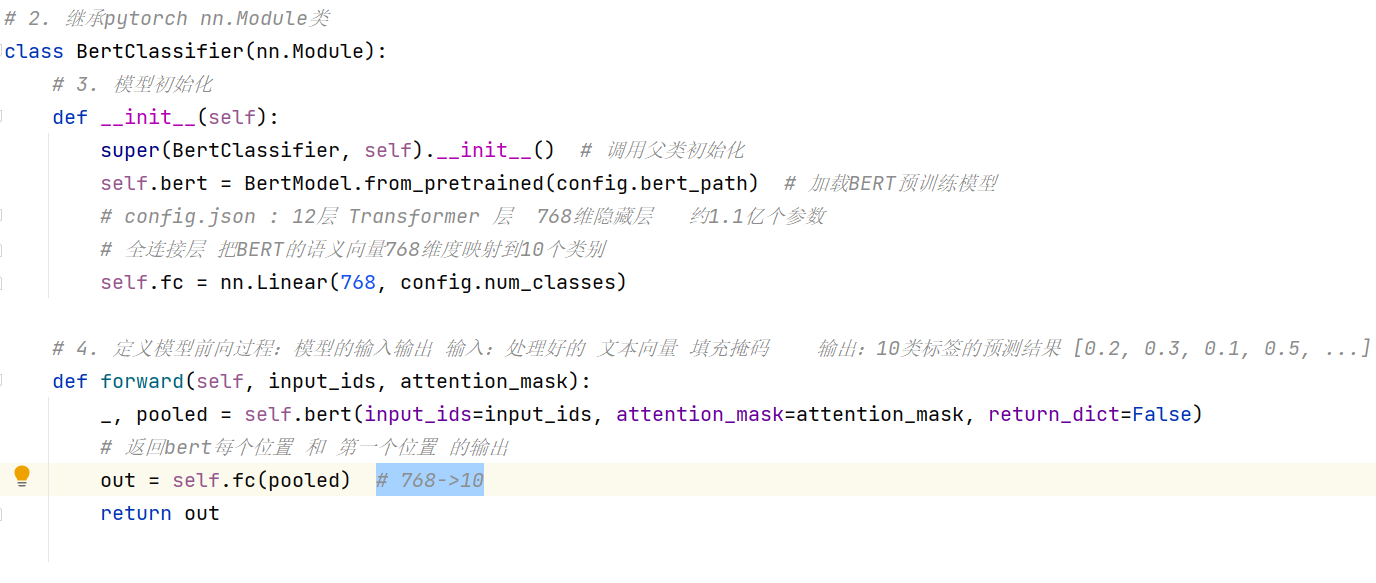
图注:这是模型定义文件的代码截图,内容如下(含页面上的中文注释):
# 2. 继承pytorch nn.Module类
class BertClassifier(nn.Module):
    # 3. 模型初始化
    def __init__(self):
        super(BertClassifier, self).__init__()          # 调用父类初始化
        self.bert = BertModel.from_pretrained(config.bert_path)  # 加载BERT预训练模型
        # config.json : 12层 Transformer 层   768维隐藏层   约1.1亿个参数
        # 全连接层 把BERT的语义向量768维度映射到10个类别
        self.fc = nn.Linear(768, config.num_classes)

    # 4. 定义模型前向过程: 模型的输入输出
    # 输入: 处理好的 文本向量 填充掩码   输出: 10类标签的预测结果 [0.2, 0.3, 0.1, 0.5, ...]
    def forward(self, input_ids, attention_mask):
        _, pooled = self.bert(input_ids=input_ids,
                              attention_mask=attention_mask,
                              return_dict=False)         # 返回bert每个位置 和 第一个位置 的输出
        out = self.fc(pooled)                            # 768->10
        return out
这段代码把前面所有原理一一对上了:
– self.bert 就是”3 个 Embedding 层 + 12 层 Encoder”,来自 config.json(12 层、768 维、约 1.1 亿参数);
– self.bert(...) 返回两个东西,课件注释写得很清楚:”bert 每个位置 和 第一个位置 的输出”,前者对应 sequence_output(L \times 768),后者就是 pooled([CLS] 那一行,768 维);
– 代码里用下划线 _ 丢掉了”每个位置”的输出,只保留 pooled,即第一个位置的向量;
– self.fc = nn.Linear(768, config.num_classes) 把 768 维压成 num_classes 维(本项目是 10 类);
– forward 的返回值就是 10 个类别的分数(未过 softmax 的 logits,训练时交给 CrossEntropyLoss 一并处理);
– attention_mask 的用途是告诉模型哪些位置是真实 token、哪些是补齐的 [PAD],避免 padding 位置参与注意力。
数据侧由 utils.py 负责:
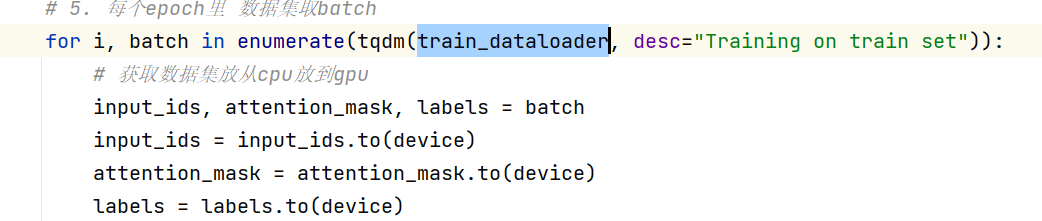
图注:训练脚本的截图,展示 train_dataloader 的用法(含页面注释):「5. 每个 epoch 里 数据集取 batch」→ for i, batch in enumerate(tqdm(train_dataloader, desc="Training on train set")):;「获取数据集放从 cpu 放到 gpu」→ input_ids, attention_mask, labels = batch,然后 input_ids / attention_mask / labels = *.to(device)。课件文字说明:utils.py 不仅实现文本格式转化,还把这个转化过程封装进 PyTorch 的 train_dataloader 迭代器,目的是训练时用一句 for i in 就能拿到处理好的批量数据,且因为是 PyTorch 框架下的封装,很多写法是固定写法,必须这么写才符合框架要求。
五、易错点与常见误解
-
常见说法:”BERT 是一个文本分类模型。”
实际上,BERT 是网络结构/编码器,输入文字、输出向量;分类能力来自你额外接的 fc 层。
为什么:课件原话,”Bert 只是一个网络结构,你甚至可以把它当成一个全连接层”。同一套 BERT 权重,接不同头就能做分类、NER、问答、相似度。 -
有人以为”BERT 的三类 embedding 是拼接(concat)起来的。”
其实是逐元素相加,维度不变(768 + 768 + 768 仍是 768 维)。
原因在于,课件图里三行之间写的是+号;相加意味着三者必须在同一语义空间中共享维度,这也是为什么它们都是 768 维。 -
常听到的一种说法是:”第一个位置(
[CLS])的输出天生就代表整句。”
真实情况是,是预训练任务(尤其 NSP)把它训练成这样的,不是结构自带。
背后的道理是,[CLS]本身无词义,是 NSP/分类任务要求用它做出判断,梯度才迫使它聚合全句信息。(这也是为什么后来的 RoBERTa 去掉 NSP 后,句子表示要改用均值池化。) -
容易想岔的地方:”MLM 就是把 15% 的词全换成
[MASK]。”
事实正相反,15% 是被选中的目标位置,其中 80% 换[MASK]、10% 换随机词、10% 保持原词。
之所以如此,[MASK]在真实文本里不存在,全用它会制造预训练/微调不一致,让模型只在看到[MASK]时才肯调用上下文。 -
先说一个误解:”BERT 是双向语言模型,能像 GPT 一样生成文本。”
实际上,BERT 是双向编码器 + 掩码语言模型,不能直接做自回归生成。
为什么:双向注意力让每个位置都”看得见”自己,标准的下一个词预测会变成抄答案;MLM 的”盖住再猜”正是为了绕开这一点。生成要用 decoder-only(GPT 系)。 -
常见说法:”位置向量用的是 Transformer 的正弦/余弦编码。”
其实原版 BERT 用的是可学习的位置嵌入(E_0 … E_10是查表得到的向量),随训练更新。
原因在于,课件图里每个位置画的是独立的 embedding 方块(E_0、E_1…),而不是一个固定公式生成的值。代价是无法外推到训练时没见过的长度。 -
有人以为”segment embedding 是在区分’第几个句子’。”
真实情况是,它只区分句子 A / 句子 B(E_A / E_B),最多两段。
背后的道理是,图上 11 个位置只出现了 E_A、E_B 两种取值;超过两句的输入要变通处理(分段),而不是靠”第 3 句用 E_C“。 -
常听到的一种说法是:”
[SEP]只是分隔符,不参与语义。”
事实正相反,它同时是序列/句子的结束标记,有自己的 embedding,且第 5 页那张表明确把token 7 ([SEP]) → 向量 H的语义写成”句子结束标记”。
之所以如此,预训练时[SEP]是判断 A/B 边界的必要信号。 -
容易想岔的地方:”分类输出维度应该和 BERT 一样是 768。”
实际上,输出是类别数(本项目 10)。768 是[CLS]向量的维度,是被nn.Linear(768, 10)映射的输入维度。
为什么:课件代码self.fc = nn.Linear(768, config.num_classes),并注释”把 BERT 的语义向量 768 维度映射到 10 个类别”。 -
先说一个误解:”微调要从头初始化 BERT 再训练。”
其实用BertModel.from_pretrained(config.bert_path)加载预训练权重,再和新增的 fc 一起微调。
原因在于,BERT 的价值全在那 1.1 亿个预训练参数里;从头训练在 18w 条标题上不可能复现。
六、横向对比与研究脉络
6.1 “新闻分类项目”项目四棒对比
| 维度 | TF-IDF + 随机森林 | FastText | BERT(transformers 微调) | LLM(DeepSeek API) |
|---|---|---|---|---|
| 文本表示 | 稀疏词袋 + IDF 权重 | 词袋 + 可学习的词向量平均 | 上下文相关的 token 向量(768 维 × N 层) | 由大模型内部完成 |
| 是否利用上下文 | 否,词序完全丢失 | 仅通过 n-gram 利用局部词序 | 是,全序列双向 | 是 |
| 是否需人工特征 | 需(分词、停用词、n-gram) | 少 | 无,端到端 | 无 |
| 训练成本 | 极低(CPU 秒级) | 低(CPU 分钟级) | 高(GPU 微调,1.1 亿参数) | 无训练,但每次调用有 API 成本 |
| 可解释性 | 强(可看词权重) | 中 | 弱(注意力只是间接证据) | 弱 |
| 典型准确率 | 基线 | 比 TF-IDF 明显提升 | 通常最高的一档(本项目用它的原因) | 零样本不加提示工程时反而不稳 |
| 在该项目里的角色 | 基线对照 | 轻量强基线 | 主力模型 | 上限参照 / 对比实验 |
6.2 预训练语言模型的发展脉络(只写有把握的部分)
| 阶段 | 代表 | 结构 | 怎么”预训练” | 局限 / 解决的问题 |
|---|---|---|---|---|
| 静态词向量 | Word2Vec / GloVe | 查表 | 词共现 / 矩阵分解 | 一个词只有一个向量,”苹果”永远同一个 |
| 上下文词向量(浅层双向) | ELMo | 双向 LSTM | 正向、反向各跑一个 LSTM,再把两层表示拼接 | 只是”两个单向的拼接”,不是同一层内真正双向;层数浅 |
| 深层双向编码器 | BERT | Transformer Encoder 堆叠(12 层) | MLM(完形填空)+ NSP(句间关系) | 强,但只做理解,不生成;NSP 效果受质疑 |
| 改良 | RoBERTa | 同 BERT | 去掉 NSP、动态 mask、更多数据 | 证明 NSP 不是必要的 |
| 改良 | ALBERT | 同 BERT(参数共享) | 用 SOP(句子顺序预测)替代 NSP | 用更难的任务避免”主题捷径” |
| 生成路线 | GPT 系 | Transformer Decoder(因果掩码) | 自回归地预测下一个 token | 天生适合生成;早期在理解任务上不如 BERT |
用一句话说清演进关系:Word2Vec 解决”词能不能变成向量”,ELMo 解决”同一个词在不同句子里要不要不同”,BERT 解决”能不能用深层双向网络、配合一个不泄露答案的预训练目标,把这些上下文表示一次性学到位”,RoBERTa / ALBERT 则回头修正了 BERT 里那个有争议的 NSP。
七、在新闻分类项目中的落地
7.1 位置:第三棒,模型与数据两侧的”成品化”
- 数据侧(对应第 9 页
utils.py):输入是标题\t标签的文本文件(训练 18w / 验证 1w / 测试 1w)。utils.py要做三件事:① 用 BERT 的 tokenizer 把标题转成input_ids;② 生成attention_mask(padding 位置为 0);③ 把标签转成类别索引,再封装成 PyTorchDataset→DataLoader(train_dataloader)。这样训练循环里只需要for i, batch in enumerate(tqdm(train_dataloader)):就能拿到input_ids, attention_mask, labels,再.to(device)送上 GPU。 - 模型侧(对应第 8 页):
BertClassifier = BertModel.from_pretrained(config.bert_path) + nn.Linear(768, 10)。中文场景应加载中文预训练权重(如bert-base-chinese),config.json里 12 层 / 768 维 / 约 1.1 亿参数。 - 训练”斌子法则”的对应关系:加载配置(
config.bert_path)→ 准备数据/模型/损失/优化器(Dataloader、BertClassifier、CrossEntropyLoss、AdamW)→ 外层轮次 + 内层批次(for epoch/for i, batch in enumerate(train_dataloader))→ 前向(out = model(input_ids, attention_mask))→ 算损失 → 梯度清零(optimizer.zero_grad())→ 反向(loss.backward())→ 更新(optimizer.step())→ 保存模型/参数字典。BERT 在这里没有改变训练骨架,只是把”前向”换成了一个 1.1 亿参数的模型。
7.2 关键参数怎么调
| 参数 | 建议 | 原因 |
|---|---|---|
max_length |
64~128 足够(新闻标题很短) | 默认 512 会白白增加显存与时间;attention_mask 保证 padding 不干扰 |
| 学习率 | 微调常用 1e-5 ~ 5e-5(比从头训练小 1~2 个数量级) | 预训练权重已经很”好”,大 lr 会把它冲垮 |
| batch size | 显存允许下 16~64 | BERT 本体大,显存是主要瓶颈 |
| 轮数 | 2~4 轮 | 18w 数据够多,多了容易过拟合 |
| 优化器 | AdamW + 少量 warmup 更好 | 微调的常用配置 |
7.3 实际坑在哪
- 必须传
attention_mask:不传的话 padding 位置也会进入注意力,短标题被长 padding 稀释,指标明显掉。 - tokenizer 必须和权重配套:用了中文权重要用对应的中文词表,混用会大量产生
[UNK]。 - 标签与 fc 输出维度必须对齐:
nn.Linear(768, 10)的第二个参数就是类别数,改类别数时必须同步改配置,否则 loss 直接报错或全错。 - 推理阶段忘了
model.eval()+torch.no_grad():会让 dropout 生效、显存暴涨、结果不稳定。 return_dict的差异:本项目代码显式写了return_dict=False,于是返回值是tuple,按位置解包成_, pooled(丢掉每个位置的输出、只留第一个位置),如果改成默认的True,就要用outputs.last_hidden_state/outputs.pooler_output取,写法会变。- 预测要过 softmax 或直接取 argmax:
fc出来的是 logits(未归一化),做展示/置信度时才需要 softmax。 - 显存不够:先降
max_length和 batch size,再考虑冻结前若干层或梯度累积,而不是一上来就上多卡。
7.4 和项目里其它方案怎么配合
- 与 TF-IDF / FastText 的关系:它们是基线和轻量对照,用同一份数据、同一套评估口径跑出指标表,BERT 的提升幅度才是”讲故事”的素材。TF-IDF 用到的 749 个停用词在 BERT 侧不需要,BERT 的 tokenizer 与预训练语料已经处理过这些。
- 与 LLM 的关系:DeepSeek API 做零样本/少样本分类,是”不训练能到什么水平”的上限/参照;它的错误分析(哪类容易混)可以反哺 BERT 的数据清洗与类别定义。
- 与模型压缩的关系:BERT 是压缩的主要对象(1.1 亿参数不适合直接上线)。蒸馏天然适配这里,让大 BERT 当教师、小模型当学生;
loss = (1-alpha)*hard_loss + alpha*(T*T)*soft_loss里的F.kl_div()就是把教师的 logits 分布(比如 10 类的软概率)迁移过去。量化(torch.quantization.quantize_dynamic()动态量化)可以直接把nn.Linear(768, 10)这类层转成 int8;剪枝(torch.nn.utils.prune.global_unstructured())则先把不重要的权重去掉再微调复精度。 - 部署:Flask 提供接口(服务端加载
BertClassifier的 state_dict),Streamlit 做客户端界面,用户输入标题即返回 10 类中概率最高的类别。
八、重点问答
Q1:BERT 的结构一句话怎么讲?
A:BERT 就是一个由三个可训练 Embedding 输入层加上多层 Transformer Encoder 堆叠起来的网络结构。输入的每个 token 先被查成词向量、句子段向量、位置向量,三者逐元素相加成一个 768 维向量,然后送进 12 层 Encoder,每个位置输出一个 768 维的上下文向量。我不把它当分类器看,它就是”输入文字、输出向量”的编码器,接什么头、怎么训练是下游的事,我们项目就是在它的第一个位置后面接了一个 nn.Linear(768, 10) 做 10 类新闻标题分类。
Q2:BERT 的输入表示是怎么做的?为什么要三类嵌入相加?
A:三类分别是 Token Embedding、Segment Embedding 和 Position Embedding,逐元素相加,不是拼接。Token 负责”这个位置是什么词”,Segment 用 E_A / E_B 区分句子 A 和句子 B,注意每个句子末尾的 [SEP] 也算在它自己那一段里;Position 用 E_0、E_1… 告诉模型顺序,因为是可学习的查表向量,不是正弦编码。相加而不是拼接,是因为三者维度都是 768、共享同一个语义空间,相加后维度不变还是 768;如果拼接就会变成 2304 维,还要多一层投影。好处是同一个词在不同位置、不同句段会拿到不同的输入向量,模型才有可能区分”同一句话里的两个 Paris”。
Q3:[CLS] 和 [SEP] 是干什么的?为什么分类取 [CLS]?
A:[CLS] 永远放在序列第一个位置,它本身没有词义,但在最后一层的输出被训练成整个句子的语义表示;[SEP] 是分隔符,同时也是句子结束标记,句子 A 和句子 B 末尾都要放,配合 segment embedding 标出边界。做句子分类时取 [CLS] 是因为只有这个位置是对着”整句关系”这个目标训出来的,其他位置的输出只对应各自那个词,课件贴的表格里也是这么分的:句子分类、句子对分类取 [CLS],序列标注和问答任务取全部位置的输出。
Q4:MLM 具体怎么做?15% 和 80/10/10 分别是什么?
A:MLM 就是完形填空。做法是随机挑出句中 15% 的 token 作为预测目标,模型在这些位置的输出上接一个词表大小的分类头做多分类,loss 只在这 15% 的位置上算。这 15% 里,80% 被替换成 [MASK],10% 被替换成一个随机词,10% 保持原词不动。之所以不 100% 用 [MASK],是因为 [MASK] 在真实文本里根本不会出现,如果目标位置永远被替换成它,就会造成预训练和微调的不一致,模型会”只有看到 [MASK] 才认真用上下文”;掺入随机词和原词,是为了逼模型对每个位置的表示都保持上下文敏感。
Q5:NSP 是什么?它有必要吗?
A:NSP 是句子关系判断:把两句拼成 [CLS] A [SEP] B [SEP],让模型判断 B 是不是 A 的真实下一句,正负例各一半,负例从别的文档随机抽。它的输出就是在 [CLS] 上接一个前馈网络加 softmax,得到 IsNext / NotNext。它对我们特别重要,因为正是它逼着 [CLS] 学会聚合整句信息,所以微调做单句分类时 [CLS] 才天然可用。但后续研究对它有质疑:负例来自不同文档,任务太简单,模型学到的更像”两句是否同主题”;RoBERTa 的实验去掉 NSP 效果反而更好,ALBERT 则把它换成更难、剔除了主题捷径的句子顺序预测 SOP。所以我的说法是:MLM 是核心贡献,NSP 是有争议的辅助任务。
Q6:为什么 BERT 用 MLM 而不是像 GPT 那样预测下一个词?
A:因为 BERT 用的是编码器堆叠,双向注意力让每个位置都能看到包括自己在内的所有位置,如果还用”预测下一个词”,模型可以直接从自己身上抄答案,任务就失去意义了。MLM 的”把词盖住再猜”正好绕开这个泄漏:目标位置被替换掉了,模型只能靠左右两侧的上下文来推理原词。这也是 BERT 和 GPT 的分水岭:BERT 是双向编码器 + 掩码语言模型,擅长理解;GPT 是因果掩码的 decoder,擅长生成。
Q7:BERT 微调做文本分类,具体怎么接?
A:加载预训练权重 BertModel.from_pretrained,然后加一个 nn.Linear(768, 10)。前向时把 input_ids 和 attention_mask 喂给 BERT,取回两个东西,所有位置的输出和第一个位置的输出,我们代码里写成 _, pooled = self.bert(..., return_dict=False),用下划线丢掉全序列那个,只留 pooled,再过 fc 得到 10 维分数。用交叉熵损失训练,BERT 本体和新加的 fc 一起微调。要注意的是 attention_mask 必须传,否则 padding 会参与注意力;max_length 别开太大,我们标题短,64 到 128 够了;学习率要小,一般 1e-5 到 5e-5,比从头训练小一两个数量级,不然容易把预训练学到的知识冲掉。
Q8:BERT 和你项目里前面那两个模型比,好在哪?
A:好在”上下文相关”。TF-IDF 加随机森林是稀疏词袋,词序完全丢了;FastText 用的是词向量取平均,也基本是一个词一个向量。而 BERT 输出的是每个 token 在具体句子里的向量,同一个词在不同语境下向量不同,所以”苹果”在科技新闻和农业新闻里会被区分开,这是指标能拉开的主要原因。代价是成本:BERT 有 1.1 亿参数,要 GPU 微调,所以我们最后还要做量化和蒸馏把它压下来;而 TF-IDF 和 FastText 是 CPU 上秒级完成的基线,用来说明”提升是真实存在、值得付出这个代价的”。
九、延伸阅读
- 论文:
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(Devlin 等,Google,arXiv:1810.04805;后发表于 NAACL 2019),三类 embedding 相加、[CLS]/[SEP]、MLM 与 NSP、15% 与 80/10/10 策略的原始出处。 - 论文:
RoBERTa: A Robustly Optimized BERT Pretraining Approach(arXiv:1907.11692),去掉 NSP、动态 mask、更大数据量的系统实验。 - 论文:
ALBERT: A Lite BERT for Self-supervised Learning of Language Representations(arXiv:1909.11942),参数共享与 SOP 任务。 - 论文:
Attention Is All You Need(arXiv:1706.03762),BERT 里那些Trm块的来源:Multi-Head Attention、Add & Norm、Feed Forward、位置编码。 - 论文:
Deep contextualized word representations(ELMo,arXiv:1802.05365),理解”浅层拼接式双向”与 BERT”深层双向”的区别。 - 代码库:Hugging Face
transformers,BertModel、BertConfig、BertTokenizer;中文权重可用bert-base-chinese(对应的config.json即课件里”12 层 / 768 维 / 约 1.1 亿参数”那一份)。 - 工具:
torch.quantization.quantize_dynamic()(动态量化)、torch.nn.utils.prune.global_unstructured()(全局非结构化剪枝)、F.kl_div()(知识蒸馏里的软标签损失),报告第七节提到的压缩手段。 - 官方文档:PyTorch
nn.Module/DataLoader文档,课件第 9 页强调utils.py里封装train_dataloader是”框架固定写法”,写错了就跑不起来,值得对着官方示例核一遍。