模型已经训好了,应用侧怎么把它变成可靠的产品,以「幻觉」为问题起点,串起提示词工程、模型微调、RAG、AI Agent 四条技术主干,并给出它们的适用边界。
一、这份材料解决什么问题
01-大模型发展史 回答的是「模型是怎么一步一步变强的」:架构(Transformer)、范式(预训练+微调)、规模(参数/数据/算力)三条线共同把 GPT-3、ChatGPT 推了出来。但模型变大、变聪明,并不等于它能被直接拿去用,把它放进医疗问答、企业内部知识库、财务审核这类真实业务里,第一道墙就是幻觉:它会用非常流畅、非常自信的语气说出查无实据的内容。
本节(1.2 大模型开发技术)就是在回答这个应用侧的工程问题:在不重训一个大模型的前提下,怎么把幻觉压下去、把输出变成可信赖的生产力。原材料给出的答案是四条技术主干:
- 提示词工程,改「交互界面」,用指令和示例约束模型行为;
- 模型微调,改「模型内部参数」,把它塑造成领域专家;
- RAG(检索增强生成),改「系统架构」,给模型外挂一个可检索的知识库;
- AI Agent,改「执行方式」,让模型能规划、调工具、自我验证。
它在整条学习流水线里的位置是承上启下的奠基章:② 大模型提示词工程指南、③ 大模型提示词项目案例 都是本节第一条主干(提示词工程)的展开;而本节的技术分类框架,是后面所有 LLM 应用内容(RAG、Agent、微调、推理部署)的「目录页」。对求职而言,这四个词正是 LLM 应用工程师岗位的四组高频题,且评审者最爱追问的恰好是本节重点写的边界与选型(什么时候该用哪个、为什么不能互相替代)。
二、核心结论
- 幻觉分两类,修法完全不同:事实性幻觉(Factuality,与可验证的现实世界事实冲突)主要靠 RAG + 领域微调;忠实性幻觉(Faithfulness,与用户指令或给定上下文冲突)主要靠提示词约束和推理展开。判断「该上哪套技术」的第一步,是先分清遇到的是哪一类。
- 提示词工程改的是交互,不改知识。它成本最低、即时生效,但原材料明确写了它的天花板:无法赋予模型新的知识,其效果依赖于模型固有的能力,对于知识盲区导致的幻觉治标不治本。
- 微调改的是参数,把「通才」塑造成「领域专家」,代表低成本路线是 LoRA 这类只训练少量参数(或新增参数)的参数高效微调。
- RAG 是目前解决事实性幻觉最有效、最流行的工程架构,它一次性解决了模型的「知识更新」和「私有知识」两个问题,是扼杀事实性幻觉的利器。
- 四者不是四选一,而是分层组合:原材料给出的终局形态是「微调过的模型大脑 + RAG 知识心脏 + Agent 协作四肢」的超级个体;工业级系统的做法是多种技术融合,没有单一银弹。
三、知识地图
1.2 大模型开发技术【了解】
├── 学习目标
│   ├── 知道大模型幻觉是什么
│   └── 了解大模型应用的四种技术方案
├── 一、大模型幻觉问题【了解】            ← 全节的「问题定义」
│   ├── 1、事实性幻觉 Factuality
│   │   ├── 事实不一致 factual inconsistency
│   │   ├── 捏造事实 fabrication
│   │   └── 原因:知识过时 / 数据不准确
│   └── 2、忠实性幻觉 Faithfulness
│       ├── 不遵循指令 Instruction inconsistency
│       ├── 不遵循上下文 in-Context inconsistency
│       ├── 逻辑不一致 Logical inconsistency(推理任务)
│       └── 原因:指令模糊复杂 / 推理能力不足
├── 二、提示词工程【了解】                ← 方案①:改交互
│   └── 案例1:结构化会议记录生成(自由格式 → JSON Schema + 示例)
├── 三、模型微调【了解】                  ← 方案②:改参数(LoRA)
│   └── 案例2:医药公司内部药物问答助手
├── 四、检索增强生成 RAG【了解】           ← 方案③:改架构(外挂知识库)
│   └── 案例2(企业):内部《员工福利政策V2.3.pdf》问答
├── 五、AI Agent【了解】                  ← 方案④:改执行方式
│   └── 案例3:差旅费报销审核(直接问 2320 元 → 思维链逐步审 2170 元)
└── 六、本节小结:四种技术的作用层面对比表 + 融合趋势
四、原理详解
4.1 幻觉:问题定义与两分法
大模型的幻觉,指生成结果中包含了无根据的或错误的内容。关键词是「无根据」,它不是说模型在「撒谎」(没有欺骗意图),而是说它的输出缺少可追溯的依据。这个定义加上「依据」二字,直接决定了后面四种技术的位置:要么给模型补依据(RAG / 微调),要么在生成时把依据和指令约束得更紧(提示词 / Agent)。
原材料把它切成两维。
| 维度 | 事实性幻觉 Factuality | 忠实性幻觉 Faithfulness |
|---|---|---|
| 关注点 | 生成内容 vs 可验证的现实世界事实 | 生成内容 vs 用户指令 / 输入上下文 |
| 子类型 | 事实不一致(现实中有依据但矛盾)、捏造事实(现实中无法验证) | 不遵循指令、不遵循上下文、逻辑不一致(推理步骤之间或步骤与答案不一致) |
| 主要原因 | ①知识过时:训练数据有截止日期;②数据不准确:互联网语料本身含错误、偏见、矛盾 | ①指令模糊、复杂或多重约束,模型只执行它「认为」的核心任务;②多步推理中某一步的小错误导致后续全盘失败 |
| 主要对策 | RAG(补实时/私有知识)、领域微调(把领域事实灌进参数) | 提示词工程(明确指令、拆解步骤)、Agent(工具化验证) |
注意这组对应关系不是原材料的硬性规定,而是从「原因」反推出来的:知识过时 → 检索外部最新资料;指令模糊 → 把指令写清楚。这张对照表是本节最有复用价值的判断工具。
原材料里的差旅报销案,是最典型的「忠实性幻觉 / 逻辑不一致+不遵循指令」,公司规定写得很清楚(上海属一线城市、住宿上限 500/晚、市内交通 50/天、餐饮补贴 100/天),但如果直接问,模型把所有申请值原样相加得 2320 元(550+120+1200+450),把「该公司只报了 150 元/天的餐饮补贴,应压到 100×3=300」这条校验完全漏掉。规定就在 prompt 里,模型却没有忠实执行,这就是忠实性幻觉而非事实性幻觉。
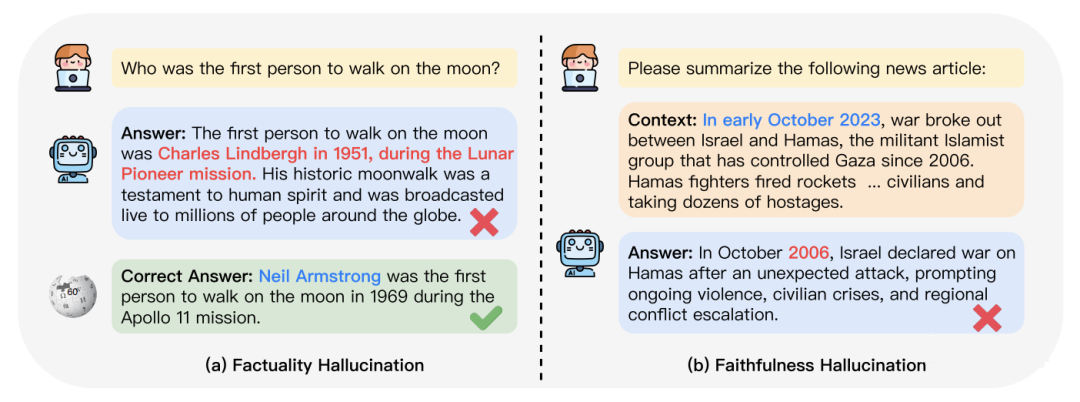
图注:左右两栏对照两类幻觉。左栏 (a) Factuality Hallucination:提问「Who was the first person to walk on the moon?」,模型回答「The first person to walk on the moon was Charles Lindbergh in 1951, during the Lunar Pioneer mission…」,句子流畅、细节具体(人物、年份、任务名、直播),但全是捏造,标红叉;下方绿勾给出 Correct Answer:Neil Armstrong was the first person to walk on the moon in 1969 during the Apollo 11 mission。这演示的是「捏造事实」,人名真实、事件虚构。右栏 (b) Faithfulness Hallucination:指令是「Please summarize the following news article:」,给定 Context 明确写着「In early October 2023, war broke out between Israel and Hamas…」,模型总结出来的却是「In October 2006, Israel declared war on Hamas…」,年份直接从 2023 改成了 2006,即输出与给定的上下文冲突(不遵循上下文)。同一张图把两个概念的反差点得很清楚:左边是「无中生有」,右边是「有据不用」。
4.2 提示词工程:在不改参数的前提下约束行为
模型说到底是「给定前文,续写最可能的下一段」。提示词工程就是通过精妙的指令设计,约束模型的行为边界,引导它进行结构化思考,明确「答案的边界和依据」。它不训练任何参数,所以便宜、快、可随时迭代。
原材料的案例 1 把它的三种手段一次演示完了。
第一步,只写自由指令(能出结果,但不稳定):
请根据以下内容生成格式化会议记录:
本次周会决定,由张三在11月15日前完成市场分析报告初稿,并由李四在月底前完成官网UI redesign。
模型输出了「周会会议记录 / 会议类型 / 任务 1 / 任务 2」这种带小标题的自然语言排版。问题:格式是模型自己定的(下次换个模型、换次采样就变),字段不可枚举,程序没法直接解析。
第二步,换成「情境学习」式提问(角色 + 输出规范 + 示例):原材料给出的模板是「# 任务定义 → # 输出规范(JSON Schema)→ # 示例(输入文本 + 期望输出)」三段式,具体包括:
- 角色/任务定义:「你是一个信息提取专家,负责从会议纪要中精准提取行动项,并转换为标准 JSON 格式。」
- 输出规范(JSON Schema):
action_items[],每个元素含三个字段,item(决议事项的完整描述,保持原文关键信息)、owner(仅包含负责人姓名,如「张三」)、deadline(严格遵循YYYY-MM-DD格式的日期)。 - 示例(few-shot):输入「……张三在 11 月 15 日前完成市场分析报告初稿,李四在月底前完成官网 UI redesign」,期望输出两行 JSON,其中 deadline 分别是
2024-11-15和2024-11-30。
带数字的小例子(原材料的真实输入输出):给新输入「开发团队确认,小王需要在 2025 年 12 月 31 日前完成 v2.0 版本的核心功能开发,小张负责在年底前完成所有测试用例的编写。」模型输出的关键点是:
{
  "action_items": [
    { "item": "完成v2.0版本的核心功能开发", "owner": "小王", "deadline": "2025-12-31" },
    { "item": "完成所有测试用例的编写",   "owner": "小张", "deadline": "2025-12-31" }
  ]
}
值得琢磨的是最后一格:原文只说「年底前」,模型按示例里 2024-11-30 的规律(原文「月底前」→ 当月最后一天)把今年跨年的「年底」推成了 2025-12-31。这说明 few-shot 示例不只是「告诉格式」,它还锚定了推理规则,示例给得好,模型会照着规则外推;给得含糊,规则就会漂。
边界(本节最重要的一句):提示词工程无法赋予模型新的知识,其效果依赖于模型固有的能力,对于知识盲区导致的幻觉治标不治本。所以它擅长「让模型把已经知道的东西按你想要的格式、按你要求的步骤说出来」,不擅长「让它知道它不知道的事」。
4.3 模型微调:把通才塑造成领域专家
如果提示词是「在考场上给提示」,微调就是「重新回炉上课」,通过数据驱动的方式,从根本上调整模型参数,使其在特定领域内更可靠。做法是用高质量的、事实准确的领域数据对模型再训练,强化其产生正确事实的模式,抑制胡编乱造。
机制(LoRA 与「参数高效微调」):原材料的案例是一家医药公司要开发内部药物问答助手,手里有权威、结构化的药物说明书数据库,做法是:
- 从数据库构建数十万条(问题,标准答案)对;
- 使用 LoRA 技术对基础模型(如 LLaMA)进行微调;
- 微调后的模型面对「阿司匹林的禁忌症是什么?」这类问题时,回答严格基于说明书数据,幻觉率显著降低,因为它被「塑造」成了一个药物领域的专家,而非泛泛而谈的通才。
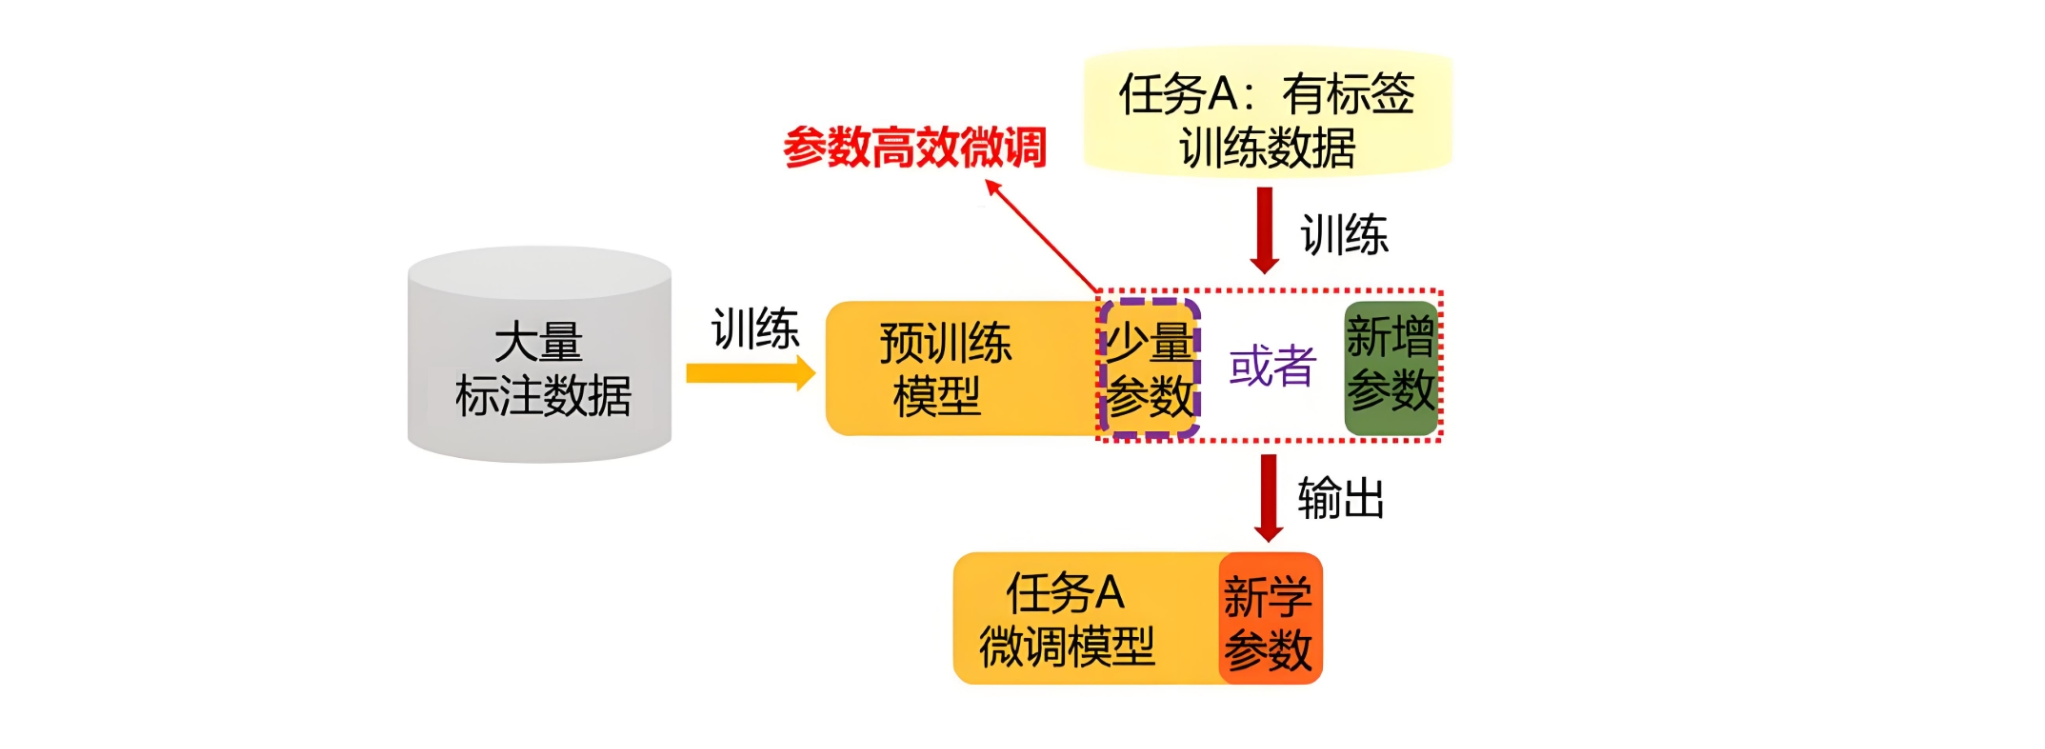
图注:图中左侧是「大量标注数据」,经黄色箭头「训练」指向「预训练模型」;预训练模型右侧挂着两个框,标注「少量参数」或(中间写着「或者」)「新增参数」,两者被一个紫色虚线框一起圈住;虚线框向下经箭头「输出」得到「任务 A 微调模型」,模型旁标着「新学参数」。右上另有「任务 A:有标签训练数据」,经红色箭头「训练」指入虚线框。图上用红色批注写出这一路线的名字:「参数高效微调」,红线正指向那个虚线框。整张图要传达的对比是:传统全量微调要更新「预训练模型」那一大块,而参数高效微调只更新虚线框里的那一小块,最终任务 A 的收益来自「新学参数」,而底座基本保持不动。这就是 LoRA 省显存、可以单卡做领域适配的图示化解释。
4.4 RAG:给模型外挂一个知识库
微调是「把知识背进脑子」,RAG 是「开卷考试」,回答前先去资料里查,查到证据再作答。原材料把 RAG 定义为:将大模型与外部知识源(如数据库、文档库、互联网)连接,在回答问题时,先检索相关证据,再让模型基于证据生成答案,并明确它是目前解决事实性幻觉最有效、最流行的工程架构,从根本上解决了模型的「知识更新」和「私有知识」问题。
机制(三段链路):
- 建库 / 索引(离线):知识库文档 → 提取文本 → 字符串 → 分段落地块(chunk)→ 文本区块 chunk;
- 检索(在线):用户输入一个问题 → 文本嵌入(embedding)→ 问题文本的嵌入向量 → 在向量库中做相似匹配;
- 生成(在线):从向量库取回匹配的 K 段与问题相关的知识库原文 → 拼成提示词 Prompt(包含原文和问题)→ 交给大语言模型 LLM 生成 → 得到「基于知识库的问答对话 AI」。
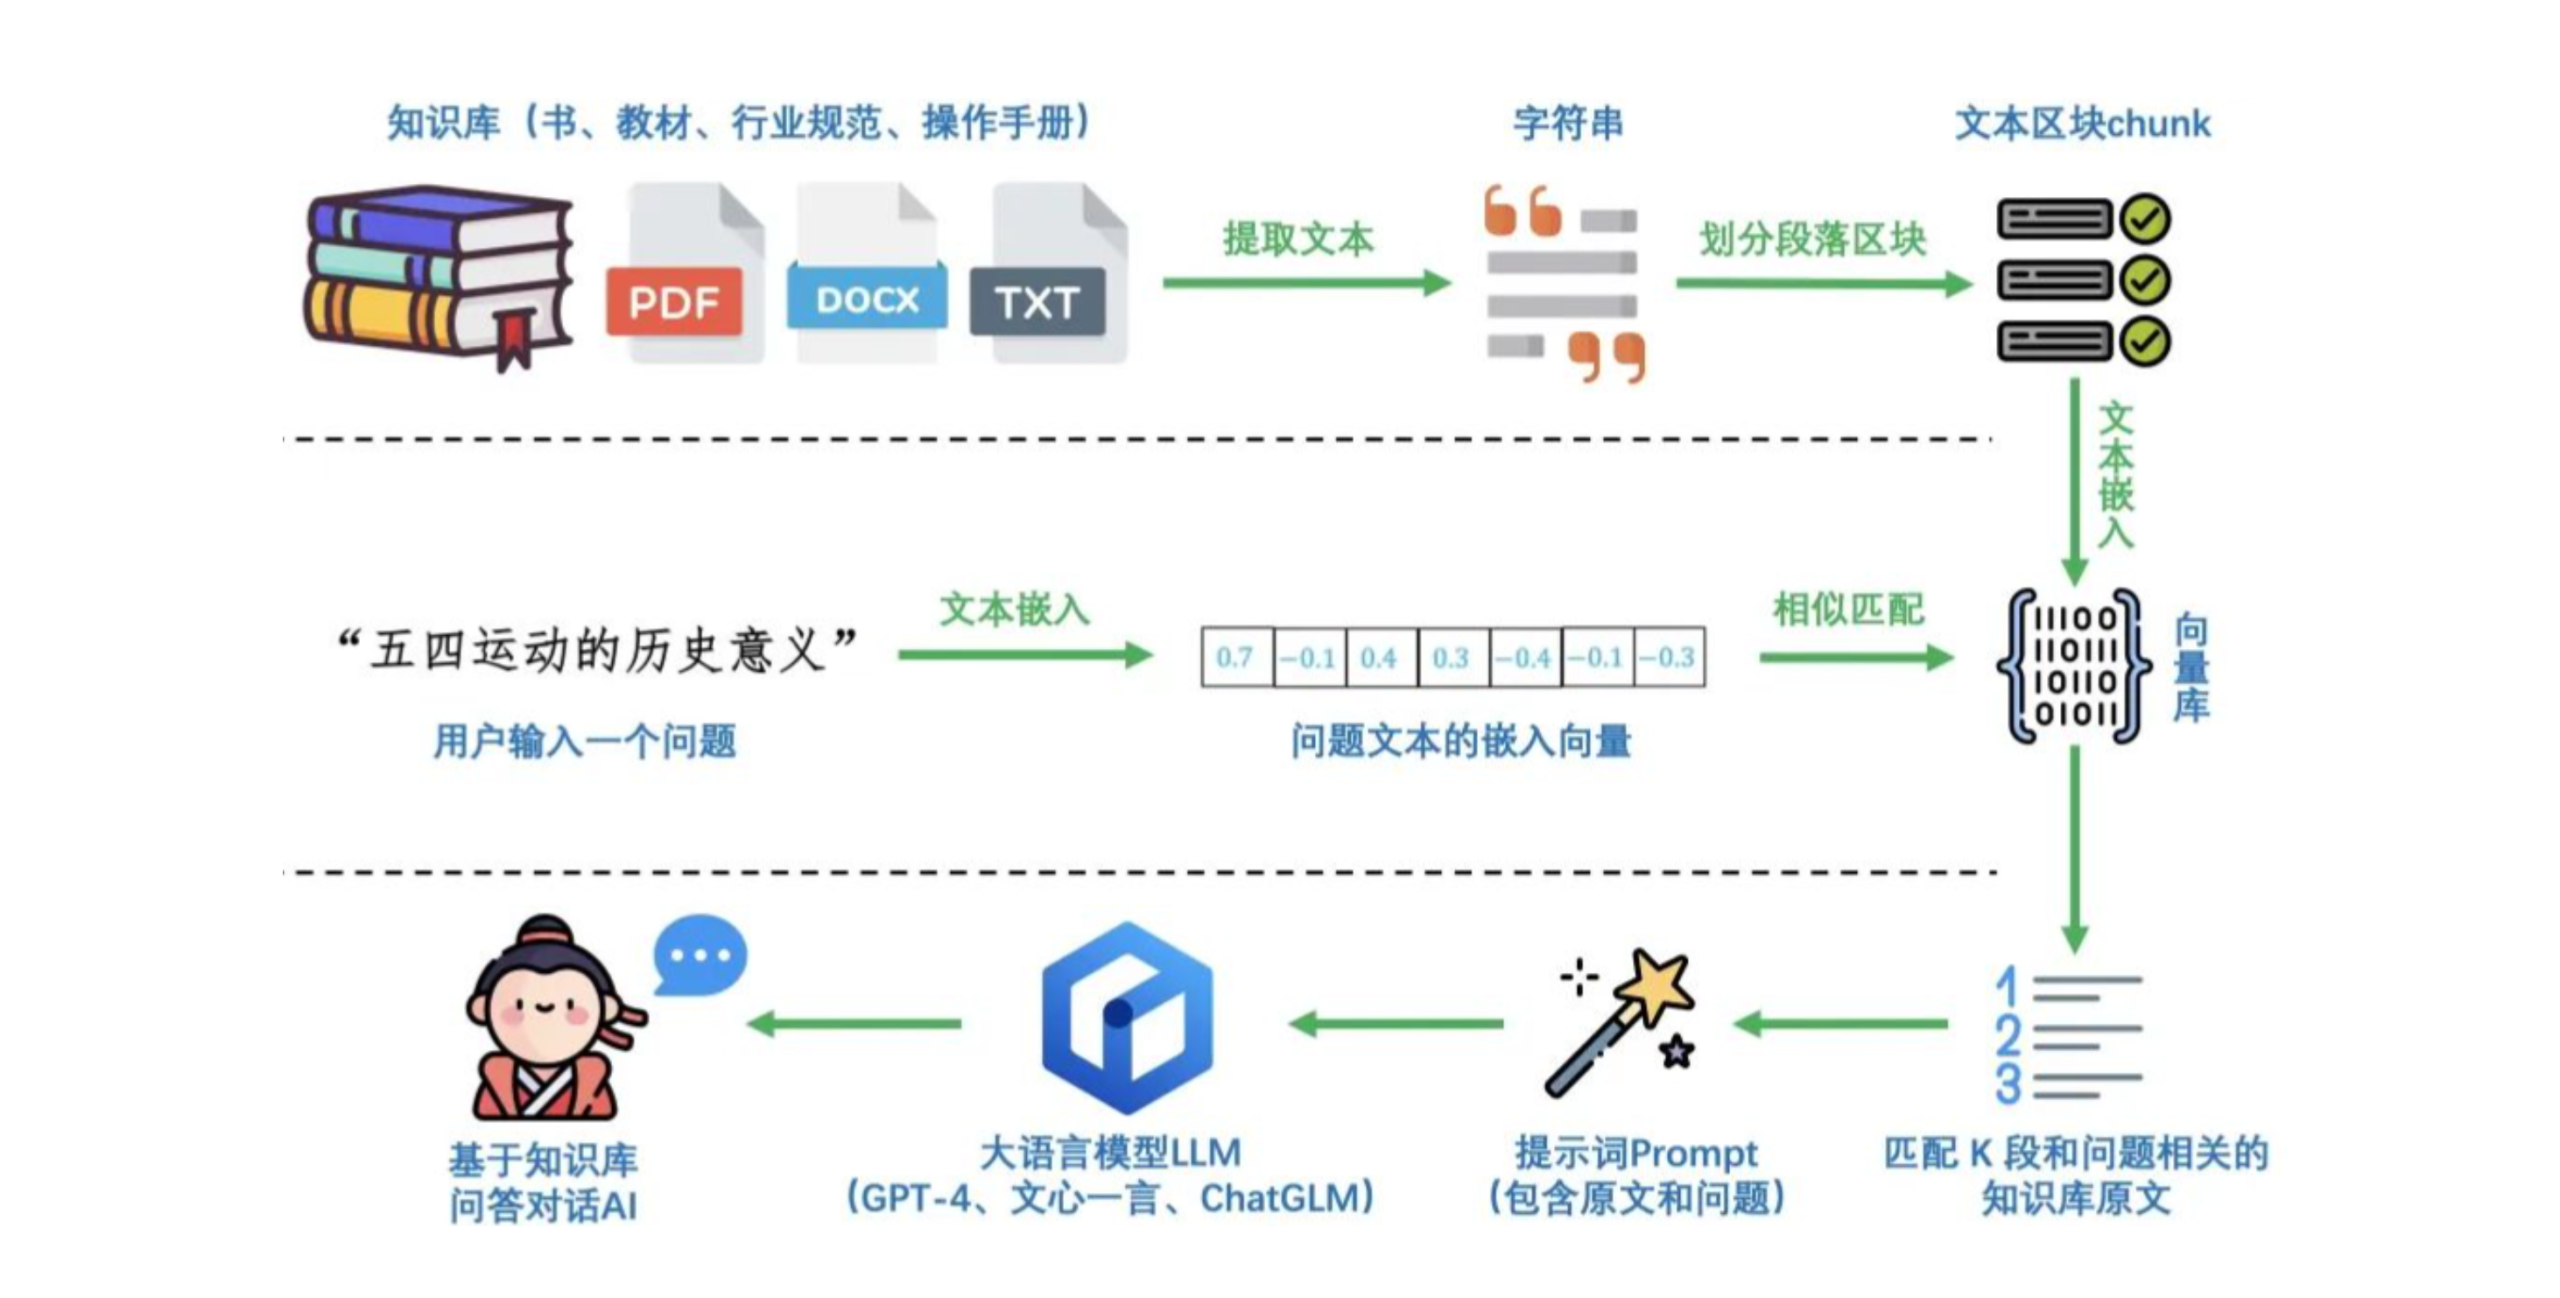
图注:图用虚线分成上、中、下三段,正好对应 RAG 的三个阶段。上段(建库/索引):左起「知识库」图标,向右箭头到「提取文本」,再到「字符串」,再到「分段落地块」,最后落到「文本区块 chunk」。中段(检索):用户输入「五四运动的历史意义」作为问题,向右经「文本嵌入」得到「问题文本的嵌入向量」,再进入「相似匹配」,右侧连到「向量库」。下段(生成):从向量库向下取出「匹配 K 段和问题相关的知识库原文」,与问题一起组成「提示词 Prompt(包含原文和问题)」,再送入「大语言模型 LLM」(图中列举 GPT-4、文心一言、ChatGLM 三个例子),最终输出「基于知识库问答对话 AI」。这张图是本节信息密度最高的一张:它把「检索」拆成了向量化和相似匹配两步,把「生成」落到 Prompt 拼接这一个小动作上,也提示了工程上真正要调的参数位(切块大小、K 值、embedding 模型)。
带数字的小例子(私有知识,模型不可能知道):业务需要模型阅读公司内部的《员工福利政策 V2.3.pdf》并准确回答。用户问「我们公司今年的团建预算标准是多少?什么时候申请?」,期望答案是「根据 2024 年发布的《员工福利政策 V2.3》,今年的部门团建预算标准为人均 500 元。申请通道在每年 6 月和 12 月开放,需通过 OA 系统提交『团队活动申请』表单。」
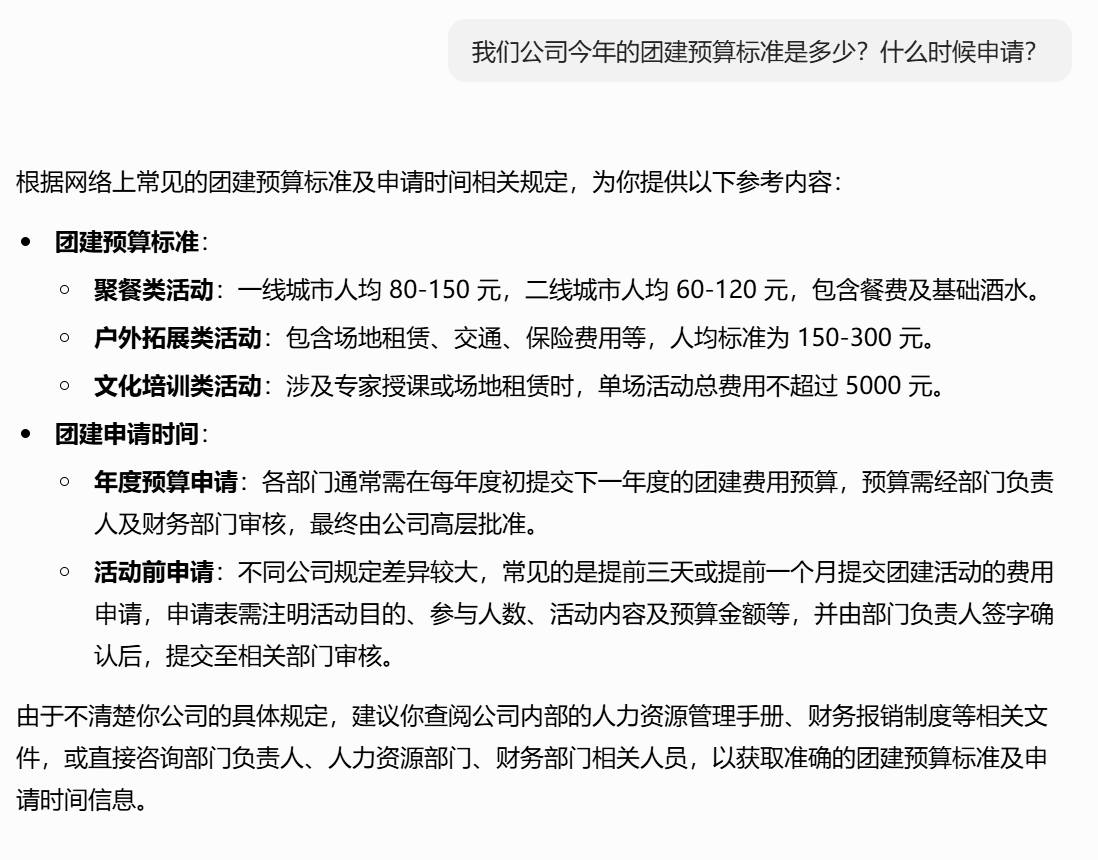
图注:这是没有 RAG 时的真实对话截图。用户问「我们公司今年的团建预算标准是多少?什么时候申请?」,模型的开头就承认了它的依据来源:「根据网络上常见的团建预算标准及申请时间相关规定,为你提供以下参考内容」;下面按「团建预算标准」列出聚餐类活动(一线城市人均 80-150 元、二线城市人均 60-120 元)、户外拓展类活动(人均 150-300 元)、文化类活动(单场活动总费用不超过 5000 元),按「团建申请时间」列出年度预算申请与活动前申请两种常见节奏;结尾写「由于不清楚你公司的具体规定,建议你查阅公司内部的人力资源管理手册、财务报销制度等相关文件,或直接咨询部门负责人、人力资源部门、财务部门相关人员,以获取准确的团建预算标准及申请时间信息。」,答案通篇正确、礼貌、无幻觉,但对公司业务毫无价值(真实标准是人均 500 元、6/12 月开放、走 OA 表单)。原材料由此下的判断是:不解决私有数据问题,模型在内部业务场景中无法发挥核心价值。
4.5 AI Agent:从「内容生成器」到「动作执行者」
Agent 把大模型从「内容生成器」提升为「动作执行者」。核心思路是模型作为「大脑」,可以规划步骤、调用工具(如搜索引擎、代码解释器、计算器)来验证自己的猜想或弥补知识短板。它的核心架构天然包含了对抗幻觉的机制,因为「思考」和「验证」被放进同一个循环里。
机制 + 带数字的小例子(案例 3 差旅费报销审核):原材料用同一个报销单做了两组对照,这是全节最有说服力的实验。
对照组(直接提问):给全部报销项 + 全部公司规定,直接问「本次可报销的总金额是多少?」模型回答「本次可报销的总金额为 2320 元。550 元(高铁票)+ 120 元(市内交通费)+ 1200 元(住宿费)+ 450 元(餐饮补贴)= 2320 元」。它把四条申请金额原样相加,四项规定一条都没执行,明显错误。
实验组(思维链逐步审核):在原 prompt 后追加「请遵循『思维链』的推理方式,一步一步地分析」,并把它手工拆成五步模板,每一步都要求填「思考 / 判断 / 可报销金额」:第一步高铁票、第二步住宿费、第三步市内交通费、第四步餐饮补贴、第五步汇总。模型的回答逐项变成:
| 步骤 | 模型「思考」的关键判断 | 可报销金额 |
|---|---|---|
| ① 高铁票 | 实报实销、限二等座,未提及座位等级超标 | 550 元 |
| ② 住宿费 | 上海属一线城市,上限 500/晚;申请 400/晚,未超上限 | 1200 元 |
| ③ 市内交通费 | 出差 3 天 × 50/天 = 总限额 150 元;申请 120 元,在限额内 | 120 元 |
| ④ 餐饮补贴 | 标准 100/天,3 天总限额 300 元;申请 150/天 × 3 天 = 450 元,超出限额,部分超标 | 300 元 |
| ⑤ 汇总 | 550 + 1200 + 120 + 300 | 2170 元 |
同一张报销单,同一批规定,答案从 2320 变成 2170,差额正好是餐饮补贴被压掉的 150 元(450−300)。这个例子揭示的机制是:把「一个大问题」拆成「若干个带约束的小问题」,每步都被要求显式输出判断依据,模型就没有机会跳过校验。原材料把它总结为:Agent 通过将模型的「思考」与外部世界的「验证」相结合,构建了一个动态的、自我修正的系统,极大地提升了输出的可靠性。
4.6 四种技术的作用层面(原材料小结表)
| 技术 | 作用层面 | 核心价值 | 适用场景 |
|---|---|---|---|
| 提示词工程 | 交互界面 | 低成本、即时生效的引导 | 简单事实查询、逻辑推理任务 |
| 模型微调 | 模型内部 | 塑造领域专家,从根本上减少领域内幻觉 | 医疗、法律、金融等专业领域 |
| RAG | 系统架构 | 提供实时、准确的外部知识证据 | 知识库问答、客户服务、企业数据分析 |
| AI Agent | 系统架构 | 动态规划与验证,处理复杂、开放世界任务 | 数据分析、研究报告生成、复杂问题求解 |
原材料给出的未来趋势是构建「微调过的模型大脑 + RAG 知识心脏 + Agent 协作四肢」的超级个体,并给了一个具体设想:一个金融分析师 Agent,核心是经过 LoRA 微调的金融模型,通过 RAG 接入实时市场数据和公司财报,并能自主调用计算工具进行估值建模。结语是「幻觉问题将长期存在」,靠这些技术不断成熟与深度融合逐步驯服。
五、易错点与常见误解
- 常见说法:幻觉 = 模型在胡说八道、故意骗人;实际上,幻觉的定义是「生成结果中包含了无根据的或错误的内容」 → 为什么:判断标准是「有没有依据」,不是「意图」。这直接决定了对策,补依据(RAG/微调)或约束生成(提示词/Agent),而不是「让它诚实一点」。
- 有人以为提示词写得好就不幻觉了;实际上,提示词工程无法赋予模型新知识,对知识盲区导致的幻觉治标不治本 → 为什么:它动的是上下文,不是参数。模型不知道 X,你写得再漂亮,它也只能猜 X。
- 常听到的一种说法是:事实性幻觉和忠实性幻觉是一回事,都靠 RAG 解决;实际上,事实性看「与现实世界是否一致」,忠实性看「与指令/给定上下文是否一致」 → 为什么:图片来源那一栏写得很清楚,原文上下文里明明是 2023 年 10 月,模型总结成 2006 年,这不是知识问题(不用查资料也知道该照抄上下文),而是听话问题,RAG 帮不上。
- 容易想岔的地方:有了微调就不需要 RAG,或有了 RAG 就不需要微调;实际上,两者解决的知识性质不同 → 为什么:微调是把知识「压进参数」,更新一次要重训,且难以溯源;RAG 是「每次现场查」,改文档即刻生效、能给出处。工程上常见的组合是「微调管领域表达风格与格式,RAG 管事实与时效」。
- 先说一个误解:思维链提示就是 Agent;实际上,差旅报销那个例子严格说是「提示词级的思维链」,只是 Agent 的前置能力 → 为什么:Agent 的核心是模型作为大脑去调用工具(搜索引擎、代码解释器、计算器)并形成带状态的循环;把步骤写死在 prompt 模板里,模型只能一次生成、不能回头查证、也不能改计划。
- 常见说法:RAG 接上向量库就准确了;实际上,检索质量决定回答上限 → 为什么:生成阶段只被要求「基于检索到的原文作答」,如果 Top-K 取回的 chunk 本身不对,模型会输出一个「忠实于错误证据」的答案,这是幻觉没消失,只是从「编造」换成了「照错抄」。所以切块策略、embedding 模型、K 值(必要时加 rerank)才是 RAG 工程的重点。
- 有人以为幻觉只跟模型能力有关,跟推理参数无关;实际上,采样时温度 / top-p 调高会让输出更发散,幻觉概率随之上升 → 为什么:同一模型在 temperature≈0 时更适合做信息抽取、分类这类有唯一答案的任务;需要创意时才放开采样。这也是为什么「事实性任务 + 低温度 + 结构化输出约束」是工程默认组合。
六、横向对比与研究脉络
6.1 四种方案五维对比
| 维度 | 提示词工程 | 模型微调(LoRA/PEFT) | RAG | AI Agent |
|---|---|---|---|---|
| 改动位置 | 输入上下文 | 模型参数(少量/新增) | 系统架构(外挂向量库) | 系统架构(工具 + 循环) |
| 原理 | 指令 + 示例约束生成分布 | 用领域数据继续训练,强化目标模式 | 先检索证据,再基于证据生成 | 规划 → 调工具 → 验证 → 修正 |
| 优点 | 零训练成本、即时生效、可热更新 | 领域内稳定、可固化输出风格与格式 | 解决知识过时与私有知识;可给出处 | 能处理开放世界、多步、可自我纠错 |
| 缺点 | 不给新知识,受模型能力上限约束 | 需标注数据与算力;知识更新要重训;不可溯源 | 需维护知识库与检索链路;检索差则全盘差 | 工程复杂度最高;错误会沿循环放大;成本高 |
| 典型场景 | 简单事实查询、逻辑推理、格式转换 | 医疗、法律、金融等专业领域 | 知识库问答、客服、企业数据分析 | 数据分析、报告生成、复杂问题求解 |
| 复杂度 | 低 | 中~高 | 中~高 | 高 |
6.2 演进脉络:每一步解决了上一步的什么问题
把本节放在 01-大模型发展史 的时间轴上,可以看清楚这条应用侧技术线是沿着「模型知识从哪来、可靠性由谁保证」这个问题在往下走的:
- 预训练 + 微调范式(2018,BERT / GPT-1 一系):模型的知识来自预训练,适配新任务靠微调。此时「改参数」是唯一的手段,问题:每个任务都要一份微调权重,成本高、不通用。
- 上下文学习爆发(2020,GPT-3):模型足够大之后,把任务写进 prompt 就能干,不用改参数。提示词工程由此成为一门显学,它解决了「适配成本」,但留下新问题:它不给新知识,也不知道自己的知识截止在哪(知识过时)。
- 外挂知识:RAG(2020 年前后,Lewis 等提出):把检索和生成拼成一条链路,模型每次现场查资料。它同时解决「知识过时」和「私有知识」两个问题,本节也把它评为目前对抗事实性幻觉最有效的架构。
- 显式推理:思维链(2022,Wei 等):要求模型把中间步骤写出来,多步算术、逻辑、审核类任务的正确率显著提升,报销案的 2320→2170 就是这条线的最小演示。它解决「推理过程不可见、跳步出错」,但解决不了「想错了没人纠正」。
- 推理 + 行动:Agent 范式(2022,ReAct 一系):让模型把「思考」和「调工具拿证据」交替进行,形成自我修正的循环。它解决「模型只能凭记忆答题」,代价是工程复杂度与成本。
- 低成本改参数:LoRA 等参数高效微调(2021,Hu 等):把「微调」从「要动全部权重」降到「只训练少量/新增参数」,让领域适配在有限算力下可行,也就是图 2 里那个被红字圈住的虚线框。它解决「微调太贵」,代价是知识更新仍需重新训练、且不可溯源。
- 工程化阶段(2023 年之后):四者走向融合,RAG 侧卷切块/重排/混合检索,Agent 侧出框架(LangChain、LlamaIndex),微调侧出 PEFT 工具链,服务侧卷推理优化(如 vLLM 的分页注意力、量化推理)。原材料那句「幻觉问题将长期存在,没有单一银弹」正是这个阶段的共识。
一句话把脉络串起来:微调解决「不会」,提示词解决「不听话」,RAG 解决「不知道」和「过时了」,Agent 解决「想错了没人管」。这也是最容易被追问的一条主线。
七、在新闻分类项目中的落地
新闻分类项目的四级模型对比是 TF-IDF + 随机森林 → FastText → BERT(transformers 微调)→ LLM(DeepSeek API 零样本/少样本分类),最后一层正好落在本节「提示词工程」这条主干的正面。逐条对上:
- 提示词工程 = 项目里 LLM 那一层的全部核心技术。DeepSeek API 做零样本/少样本分类时,能调的只有 prompt:把 10 个类别名枚举进系统提示(并说明每个类别的典型含义,减少「科技/互联网」这类相邻类的混淆)、要求只输出一个类别名、给 2~4 条 few-shot 示例(示例严格用项目的
标题\t标签格式,学本节案例 1 的做法:输出规范 + 示例锚定)、必要时用 JSON({"label": "..."})便于解析。本节案例 1 的启示在这里直接可用:示例不只是给格式,它锚定了推理规则,所以 few-shot 示例要覆盖边界样本(最容易混的那两个类别),而不是随便挑几条。 - 幻觉在分类任务里的表现形态 = 忠实性幻觉(不遵循指令)。模型可能输出「这个标题属于体育类」这种带解释的句子、输出两个标签、或输出「其他」这类标签体系外的词。对策就是本节写的:指令明确 + 输出规范 + 示例 + 解析层做标签白名单校验(命中不了就归入兜底类或重试一次,并把 temperature 调低)。这一点比 RAG 更相关,因为分类任务不需要外部知识,不需要为它上检索。
- 微调/LoRA 与项目的 BERT 微调是同一条线的两端。BERT 微调属于「全量参数微调」,靠 18w 训练数据把通用预训练模型适配到 10 分类;如果评审者问「为什么不微调 LLM 而只用 API 调」,标准答法是数据量、成本与稳定性:18w 数据微调 BERT 完全够用且可离线复现,而 LLM 微调要吃标注 + 算力,收益却未必超过「好 prompt + few-shot」。LoRA 正是这条路上「低算力也能微调」的方案,属于加分项而不是项目必需。
- 模型压缩与 LoRA 的区别要分清(考查高频追问)。项目最后一章的量化(QAT/PTQ/DQ)、蒸馏、剪枝、低秩分解,目标都是降低推理成本,而且主要作用在已训练好的模型上;LoRA 的目标是降低训练/适配成本,产物是任务适配权重。两者都在「参数层面动手」,但一个为「跑得省」,一个为「练得省」,别混着答。
- RAG 是项目的自然升级方向,也是 TF-IDF 知识的延伸点。新闻分类本身不需要 RAG(标签体系固定、无外部知识),但如果把项目从「分类」升到「新闻问答 / 摘要 / 结论溯源」,链路就是本节图 3:把新闻正文切片 → embedding → 向量库 → 问题向量相似匹配 → Top-K 原文 + 问题拼 Prompt → LLM 生成。这里的检索层可以直接复用项目已有的 TF-IDF(sklearn 的
TfidfVectorizer)作为关键词检索基线,再对比 embedding+FAISS 的语义检索,这就是把 3.1 的 TF-IDF、3.3 的 BERT 和 3.4 的 LLM 串成一条线的答法,也是简历上「会做 RAG」最实在的证据。 - Agent 在项目里没有落地,作为「下一步优化」的话术储备。被问到「怎么进一步提升分类效果」时,可以答:低置信度样本走二次复核(检索相似已标注样本作为证据再判一次)、或把分类拆成「先判大领域再判细类」的两步 Agent 流程,用本节报销案的机制(拆步骤 + 每步给依据)解释为什么有效。
- 部署侧的收益排序。项目用 Flask(服务端)+ Streamlit(客户端)。按本节的框架,优化顺序应是:先把 RAG 与提示词的检索/指令质量做好,再考虑微调,最后才是推理优化(量化/蒸馏/剪枝),因为前三者决定「答得对不对」,后者只决定「跑得快不快、贵不贵」。
八、重点问答
Q1:什么是大模型幻觉?分哪几类?
A:我的理解是,幻觉就是生成结果里包含了无根据或者错误的内容,判断标准是「有没有依据」,不是说模型在故意骗人。它分两大类:一类是事实性幻觉,关注生成内容和现实世界事实是否一致,细分「事实不一致」和「捏造事实」两种,主要原因是训练数据有截止日期导致知识过时、以及互联网语料本身不准确;另一类是忠实性幻觉,关注生成内容和用户指令、给定上下文是否一致,细分为不遵循指令、不遵循上下文、以及推理任务里的逻辑不一致,原因是指令本身模糊复杂、或者多步推理里某一步出错导致后面全盘崩。分这两类的价值在于,它们对应的技术方案完全不同,事实性问题要靠 RAG 和领域微调补证据,忠实性问题要靠提示词约束和拆解推理步骤。
Q2:提示词工程能解决幻觉吗?它的边界在哪?
A:能解决一部分,但不能根治。它的机制是用指令、输出规范和示例去约束模型行为,把答案的边界和依据框清楚,比如我做信息抽取时用「角色定义 + JSON Schema + 示例」三段式,把「月底前」这种模糊表述稳定转成 2025-12-31 这种标准格式。但它的边界很硬:提示词工程不改变任何参数,所以它无法赋予模型新的知识,效果完全依赖模型固有能力,对知识盲区造成的幻觉是治标不治本。所以我的判断是:模型「知道但没好好说」,用提示词;模型「根本不知道」,得上 RAG 或者微调。
Q3:微调和 RAG 都是补知识,项目里怎么选?
A:看知识的性质和更新频率。微调是把知识压进参数,好处是领域内输出稳定、格式和风格都能固化,适合医疗、法律、金融这种术语密集、表达有强规范的领域;但代价是要标注数据、要算力,知识一变就得重训,而且没法给出来源。RAG 是每次现场查资料,好处是改文档即可生效、能给出处、天然解决私有知识和时效问题,是目前对抗事实性幻觉最主流的架构;代价是要维护整条检索链路,检索质量差的话会变成「忠实于错误证据」。所以工程上常见的是组合:微调管领域表达和格式,RAG 管事实和时效,而不是二选一。
Q4:RAG 的完整流程是什么?哪一步最容易出问题?
A:分三段。第一段是离线建库:把知识库文档提取成文本,再切成文本块 chunk,做 embedding 存进向量库。第二段是在线检索:用户问题也做文本嵌入,得到问题向量,在向量库做相似匹配,取回 Top-K 段相关原文。第三段是增强生成:把取回的原文和问题一起拼进 Prompt,交给大模型生成,得到基于知识库的问答。最容易出问题的是第一段和第二段的衔接,切块策略和 K 值。块切太小会丢上下文、切太大检索不精准;K 取太少漏证据、取太多引入噪声,所以实际工程里通常会加 rerank,并且要接受一个事实:模型是被要求「基于检索到的原文作答」的,检索错了它只会照着错的抄。
Q5:为什么说 Agent 能减少幻觉?
A:因为 Agent 把「思考」和「验证」放进了同一个循环。它的核心架构是模型当大脑,可以规划步骤、调用工具,搜索引擎、代码解释器、计算器,来验证自己的猜想或者补知识短板。教材里有个特别直观的例子:一张差旅报销单加一堆报销规定,直接问总金额,模型把四项申请金额原样相加,答 2320 元,规定一条都没执行;换成思维链、把审核拆成「高铁票、住宿费、市内交通费、餐饮补贴、汇总」五步、每步都要求写出判断依据,它就会算出住宿费未超上海 500/晚的上限、市内交通 3 天总限额 150 没超、餐饮补贴超了要压到 300,最终答案 2170 元。区别就在于,一旦每一步都必须给出依据,模型就没有机会跳过校验,错误在循环里被自己发现和修正。
Q6:思维链提示和 Agent 是一回事吗?
A:不是,但思维链是 Agent 的前置能力。报销案那种「把五步写死在 prompt 模板里」的做法,说到底是提示词级的思维链,模型只能一次生成、不能回头查证、也不能改计划。Agent 的核心是模型能自主规划、能真的去调用外部工具、并且形成一个带状态的循环,搜到了新证据可以回到上一步重来。所以可以理解为:思维链让模型的推理「显式化」,Agent 让推理「可验证化」。
Q7:LoRA 为什么能省显存、让领域微调变便宜?
A:关键在它只训练一小部分参数。传统全量微调要更新预训练模型那一整块权重,显存和存权重都吃不消;参数高效微调的做法是在底座上挂「少量参数」或者「新增参数」,训练和保存的产物都只是这部分「新学参数」,底座基本不动。教材那张图就是把「少量参数 / 或者 / 新增参数」用虚线框圈出来,标上「参数高效微调」,你要的领域适配能力来自虚线框里那点东西。所以它能用相对小的算力把一个通才模型适配成领域专家,比如用几十万条(问题, 标准答案)对把 LLaMA 调成医药问答专家。
Q8:你项目里怎么用提示词工程做分类?
A:我的四级对比里,LLM 那一层走的是 DeepSeek API 的零样本/少样本分类,能调的全在提示词上。具体三件事:一是把 10 个类别枚举进系统提示,并且说明每个类别的含义,压掉「科技」和「互联网」这种相邻类的混淆;二是约束输出,要求只输出一个类别名,用 JSON 包起来便于解析,并且把 temperature 调低,减少采样发散;三是给少样本示例,示例严格按项目的「标题\t 标签」格式,并且优先挑最容易混的边界样本,因为示例不只是给格式,它还会锚定模型的判断规则,类似教材里「月底前」被示例推成当月最后一天。另外解析层一定做标签白名单校验,凡是输出解释性文字或者标签体系外词汇的,走兜底或者重试一次,这类问题属于典型的忠实性幻觉,指令没被执行,而不是知识不够。
九、延伸阅读
论文(用来把本节的四个概念接到原始文献上)
- Vaswani et al., Attention Is All You Need(2017),Transformer 原论文,
01-大模型发展史里架构那条线的起点。 - Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(2020),RAG 的原始提出,读它的目的不是复现,而是理解「检索 + 生成」为什么被拆成两个模块。
- Hu et al., LoRA: Low-Rank Adaptation of Large Language Models(2021),对应图 2 里「参数高效微调」的虚线框。
- Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models(2022),解释报销案里 2320→2170 的机制来源。
- Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models(2022),Agent「思考 + 行动」交替的范式论文。
- Ji et al., Survey of Hallucination in Natural Language Generation(2023),幻觉分类(事实性 / 忠实性)的系统综述,本节的分类框架与它一致。
官方文档 / 工具
- OpenAI Prompt Engineering Guide、DeepSeek 开放平台 API 文档,提示词与 API 参数的工程参考。
- Hugging Face
peft库文档,LoRA 等参数高效微调的标准实现(配transformers使用)。 - LangChain、LlamaIndex 官方文档,RAG 与 Agent 的主流工程框架。
- FAISS / Milvus 文档,向量检索与向量库。
- vLLM 文档,服务侧推理优化(高吞吐推理、分页注意力)。
数据集 / 知识库
- 项目自带的 18w 训练 / 1w 验证 / 1w 测试新闻标题分类数据(
标题\t标签),以及 749 个停用词表,做提示词 few-shot 示例取样与检索基线时直接可用。