一张图说清量化三条路线,动态量化(边推理边量化,准但慢)、静态量化(先统计再量化,快但略糙)、量化感知训练 QAT(训练时就模拟量化,让模型主动”扭曲”自己的分布去迎合量化网格)。
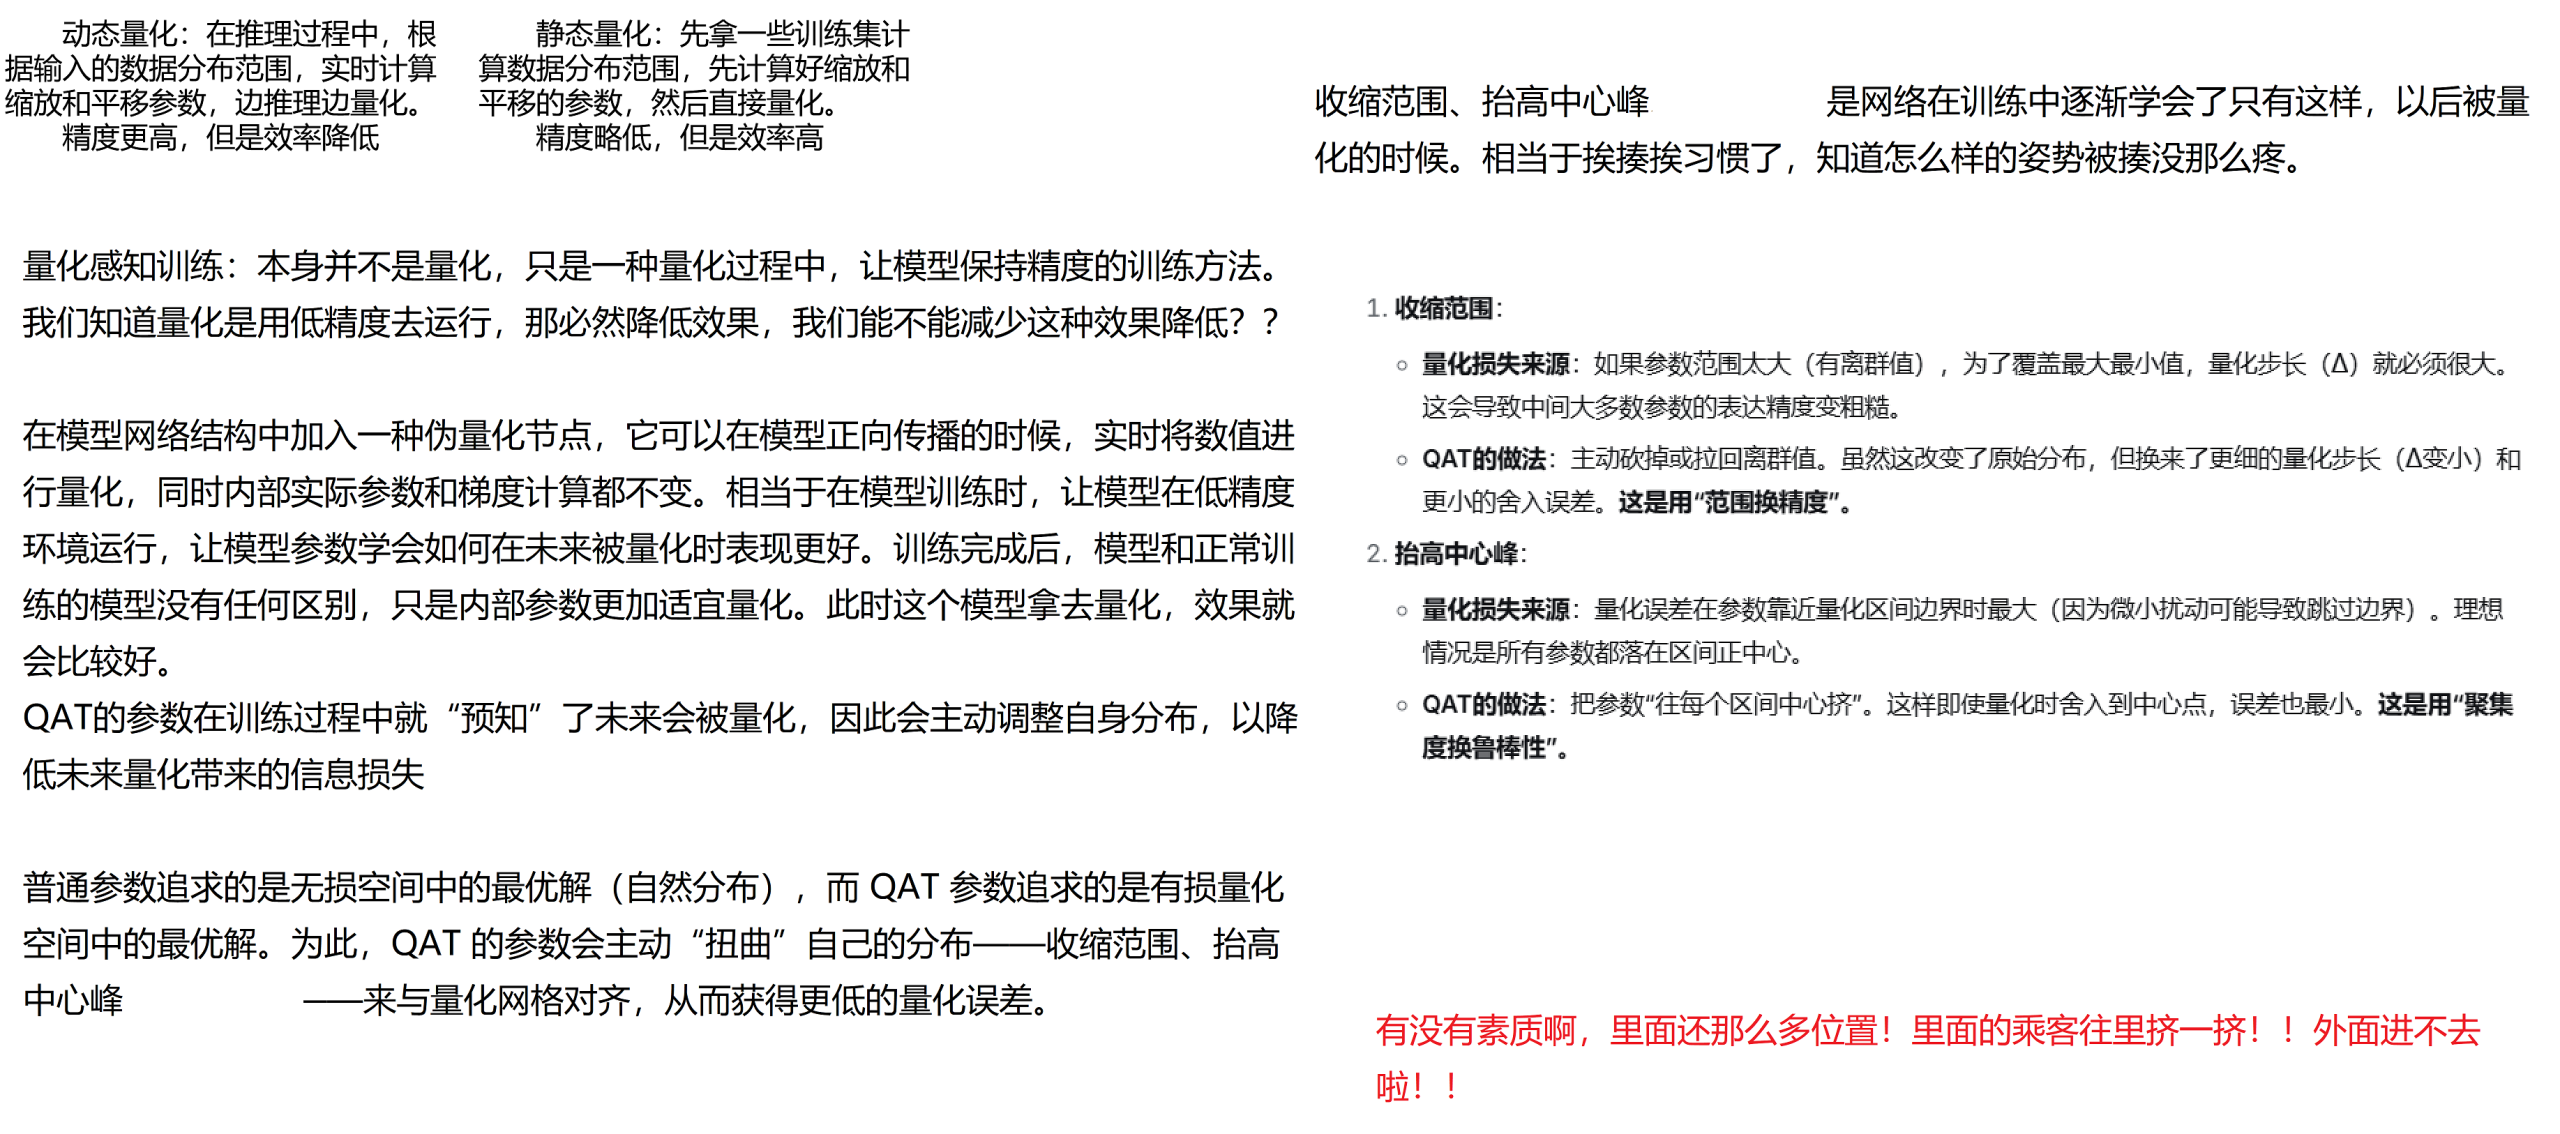
图注:原图分左右两栏。左上两块小字对比 动态量化 与 静态量化(数据分布范围什么时候算、精度与效率如何取舍);左下一大段是 量化感知训练(QAT) 的原理,核心是”伪量化节点、前向时量化、参数与梯度计算不变”。右栏解释 QAT 参数为什么会收缩范围、抬高中心峰,分两条写:1. 收缩范围(用”范围换精度”)与 2. 抬高中心峰(用”聚集度换精度”)。右下角红字是讲师的比喻:车里还有位置,乘客往里挤一挤,外面才进得来。
一、这份材料解决什么问题
前面两张图讲了量化的数学(位宽、scale、zero_point)。这张图回答的是工程选型问题:
scale/zero_point到底什么时候算?答案不同就分出动态量化与静态量化。- 算出来的区间不好,能不能让模型自己配合?这就是 QAT。
它是新闻分类项目”模型压缩手段”那一节的核心:项目要在 BERT 上做出可汇报的压缩率与速度提升,就必须讲清自己选了哪条路线、为什么。
二、核心结论
- 动态量化和静态量化的唯一区别是”数据分布范围什么时候统计”:动态是推理时按输入实时算,静态是提前拿一批数据算好、之后固定。
- 动态量化”精度更高但效率降低”,静态量化”精度略低但效率高”,原因就是静态量化把统计开销一次性前置了。
- QAT 本身不是一种量化技术,而是”让模型适应量化”的训练方法。它不减少参数、不改位宽,只改参数分布。
- QAT 的核心机制是伪量化节点(fake quantization):正向传播时把数值真的量化一遍,但内部真实参数和梯度计算都不变,所以它是一个”训练时模拟、部署时真量化”的两阶段方案。
- QAT 参数与普通参数的追求目标不同:普通参数追求无损(自然分布)空间的最优解,QAT 参数追求有损(量化网格)空间的最优解,所以它会主动扭曲分布:收缩范围(用范围换精度)+ 抬高中心峰(用聚集度换精度)。
三、知识地图
左上:两种训练后量化(PTQ)路线
| 路线 | 数据分布范围何时统计 | 精度 | 效率 |
|---|---|---|---|
| 动态量化 | 在推理过程中,根据输入的数据分布范围,实时计算并更新 scale 和 zero_point | 更高 | 效率降低 |
| 静态量化 | 先拿一些训练集计算数据分布范围,先计算好缩放的 scale 和零点的 zero_point,然后直接量化 | 略低 | 效率高 |
左下:量化感知训练(QAT)
- 本身并不是量化,只是一种量化过程中,让模型保持精度的训练方法。
- 动机:知道量化是用低精度去运行,那必然会降低效果,能减少这种效果降低吗?
- 做法:在模型网络结构中加入一种伪量化节点,它可以在模型正向传播的时候,实时将数值进行量化,同时内部实际参数和梯度计算都不变。
- 效果:相当于在模型训练时让模型在低精度环境运行,让模型学会如何在未来被量化时表现更好。训练完成后,模型和正常训练的模型没有任何区别,只是内部参数更加适宜量化。此时这个模型拿去做量化,效果就会比较好。
- 本质:QAT 的参数在训练过程中就”预知”了未来会被量化,因此会主动调整自身分布,以降低未来量化带来的信息损失。
- 一句话对比:普通参数追求的是无损空间中的最优解(自然分布),而 QAT 参数追求的是有损量化空间中的最优解。为此 QAT 的参数会主动”扭曲”自己的分布,收缩范围、抬高中心峰,来与量化网格对齐,从而获得更低的量化误差。
右栏:QAT 的两条”扭曲”策略
收缩范围、抬高中心峰,是网络在训练中逐渐学会的,只有这样才能在以后被量化时少受损失。(讲师的原话是个生动的比喻:相当于习惯了某种姿势,被”擒”的时候没那么疼。)
-
收缩范围
-
量化损失来源:如果参数范围太大(存在离群值),为了覆盖最大最小值,量化步长 Δ 就必须很大。这会导致中间大多数参数的表示精度变粗。
- QAT 的做法:主动收缩范围、拉回离群值。虽然这改变了原始分布,但换来了更细的量化步长(Δ 变小)和更小的舍入误差。
-
本质:这是用”范围”换”精度”。
-
抬高中心峰
-
量化损失来源:量化误差在参数靠近量化区间边界时最大(因为微小扰动可能导致跨越边界)。理想情况是所有参数都落在区间正中心。
- QAT 的做法:把参数往每个区间的中心挤。这样即使量化时舍入到中心点,误差也最小。
- 本质:这是用”聚集度”换”精度”。
右下红字(讲师比喻):”有没有素质啊,里面还那么多位置!里面的乘客往里挤一挤!!外面进不去啦!!”,把参数推向区间中心,就是在”往里挤”。
四、原理详解
4.1 动态量化(DQ):边推理边量化
流程:
权重:训练后一次性用 min-max 算出 scale/zero_point,直接转 int8(静态的)
激活值:
  第 1 步 前向到某一层 → 拿到该层输入张量
  第 2 步 实时统计这批数据的 min/max → 算 scale/zero_point
  第 3 步 量化 → 用整数算子算 → 反量化
第 4 步 下一层重复上述过程为什么”精度更高”:scale 是按照这一批真实输入的分布算的,所以区间总是紧贴当前数据,不会因为训练/校准数据与实际线上数据分布不一致而失配(这是静态量化最常见的精度损失来源)。
为什么”效率降低”:每一层、每一次前向都要多做一轮 min/max 统计和一次量化-反量化往返,这部分开销无法被提前摊销。
PyTorch 里就是一行:
import torch

# 动态量化:权重静态量化,激活值运行时量化
model_int8 = torch.quantization.quantize_dynamic(
    model,
    {torch.nn.Linear},   # 指定要量化的层类型
    dtype=torch.qint8,
)
适用场景:以 Linear / Embedding / LSTM 为主的模型(BERT 就是典型)。这类模型的瓶颈在内存带宽而非计算量,动态量化的收益会很明显。
4.2 静态量化(PTQ):先统计,后量化
流程:
第 1 步 准备一批有代表性的校准数据(几百条即可,不需要标签)
第 2 步 在模型里插入观察器(observer),跑一遍校准数据
第 3 步 观察器记录每层激活值的分布(min/max 或直方图)
第 4 步 由分布算出并**固定**每层的 scale/zero_point
第 5 步 真正转成整数模型 → 推理时全部用整数算子
为什么”效率高”:推理时不需要任何统计,全程整数运算(int8 GEMM),吞吐能比 fp32 高出一个量级。这也是它用于服务端/端侧部署的原因。
为什么”精度略低”:区间是提前定死的,一旦线上输入的分布超出校准范围,超出部分会被截断(clamp)到边界,产生较大误差。所以校准数据的代表性至关重要,需要注意的一点是:课堂上写的是”拿一些训练集计算”,而如果拿测试集去做校准就是数据泄漏,工程上必须用训练集/验证集的样本。
静态量化还需要”融合”:Conv+BN、Linear+ReLU 这类相邻算子要先 fuse 成一个,避免中间激活被反复量化-反量化。这是 PTQ 比 DQ 麻烦的主要原因。
4.3 QAT:让模型”预习”量化
核心机制:伪量化节点
伪量化节点做的事情,用一句话概括:前向真的量化,反向当它不存在。
正向:x → [量化 → 反量化] → x_hat   (数值真的被 round 过了,带上了量化误差)
反向:梯度按 ∂x_hat/∂x = 1 直通(straight-through estimator)
→ 参数更新时看到的是"量化后的效果",但更新规则和全精度一样为什么梯度能”直通”:round 的导数几乎处处为 0,如果老老实实按链式法则求导,梯度会全部消失,模型学不到东西。所以实现上把 round 的梯度近似为单位 1,这也正是”内部实际参数和梯度计算都不变”这句话的技术含义。
训练/部署两阶段:
| 阶段 | 模型里有什么 | 精度 |
|---|---|---|
| 训练 | 真实浮点参数 + 伪量化节点 | 浮点(但前向数值是量化后的) |
| 部署 | 删掉伪量化节点,参数转真正的 int8 | int8 |
“训练完成后,模型和正常训练的模型没有任何区别,只是内部参数更加适宜量化”,图里这句话说得很准:QAT 不产出一个特殊结构的模型,它产出一个参数分布被”调教”过的普通模型。
为什么它能提高精度:损失景观变了
- 普通训练:模型在连续(无损)空间里找最优点,参数可以停在任意实数值上。
- QAT 训练:模型在离散(有损)空间里找最优点,参数必须”靠近量化网格”才不会掉分。
目标不同 → 最优解不同 → 参数分布形态不同。这就是下一节”收缩范围、抬高中心峰”的来源。
4.4 两条扭曲策略的数学直觉
(1)收缩范围:用范围换精度
设参数区间是 [x_{min}, x_{max}],位宽 8 位(256 格):
\Delta = \frac{x_{max} – x_{min}}{256}
量化误差上界是 \Delta/2。假设某层权重原本分布在 [-0.5, 0.5],但有一个离群权重是 8.0:
| 情况 | 区间 | \Delta | 误差上界 | 中间参数的可用格数 |
|---|---|---|---|---|
| 原始(含离群值) | [-0.5, 8.0] | 8.5/256 \approx 0.0332 | ≈ 0.0166 | 主体数据只占 1/8.5 \approx 12\% 的格 |
| 收缩后(截断离群值) | [-0.6, 0.6] | 1.2/256 \approx 0.0047 | ≈ 0.0023 | 主体数据占满全部 256 格 |
步长细了约 7 倍,误差上界降了约 7 倍。代价是那个 8.0 的权重被截断到 0.6,本身误差巨大,但它是极少数,而主体参数的收益是全局性的。这就是”用范围换精度”的算术依据。
(2)抬高中心峰:用聚集度换精度
单个参数 x 的量化误差是 e(x) = \text{round}(x/\text{scale})\times\text{scale} – x,随 x 在该格内的位置变化:
误差
 Δ/2 ┤                    ╱╲                    ╱╲
     │                   ╱  ╲                  ╱  ╲
   0 ┼──────╱╲──────────╱────╲───────────╱╲───╱────╲────→ 格内位置
          0    Δ/2        Δ      3Δ/2   ...
误差在每格中心为 0、在格边界达到 \Delta/2 最大(锯齿形)。所以如果参数分布是”均匀铺满整个区间”,平均误差就是 \Delta/4 量级;而如果参数集中在每格中心附近(峰越尖越好),平均误差就趋近于 0。
QAT 做不到把参数精确放到每格中心(每格中心的位置依赖 scale,而 scale 又在变),但它能做的是:让分布从”宽而平”变成”尖而窄”,把概率质量集中到少数几个量化网格点上,从而让”边界处的坏运气”出现得更少。
一个直观的类比(讲师的公交车比喻):区间边界就像车门台阶,站在台阶上的人容易被晃下车;把乘客都往车厢中间挤一挤,车更稳,同时车厢中间挤紧了,门边才有空位让更多人(更多参数)上车。聚集度上去了,有效容量和稳定性都上去了。
4.5 三条路线的完整对照
| 维度 | 动态量化 DQ | 静态量化 PTQ | 量化感知训练 QAT |
|---|---|---|---|
| 时机 | 训练后 | 训练后 | 训练中 |
| 权重量化参数 | 训练后静态统计 | 训练后静态统计 | 训练中学到 |
| 激活量化参数 | 推理时实时统计 | 校准数据提前统计并固定 | 训练中学到 |
| 需要校准数据 | 否 | 是 | 是(就是训练数据) |
| 需要重训 | 否 | 否 | 是 |
| 精度(一般规律) | 中 | 中低 | 最高(最接近原模型) |
| 推理速度 | 中(有运行时开销) | 最快 | 同 PTQ |
| 实现成本 | 最低(一行 API) | 中(观察器 + 融合 + 校准) | 最高(改造训练流程) |
| 典型 API | torch.quantization.quantize_dynamic() |
torch.quantization.prepare/convert |
torch.quantization.prepare_qat/fake_quant |
五、易错点与常见误解
| 常见说法 | 正确说法 | 为什么 |
|---|---|---|
| QAT 是量化的第三种算法 | QAT 是训练方法,不是量化格式 | 它不改变位宽,只改变参数分布;部署时走的还是 int8 那套 |
| 动态量化比静态量化精度高,所以应该一律用动态量化 | 精度略高但速度慢,且不是所有算子都支持 | 静态量化的收益主要在吞吐,选型要看瓶颈在算力还是内存带宽 |
| QAT 训练出来的模型是”量化模型” | 训练完是普通浮点模型,量化是训练完成后另做的一步 | 图里明确写”和正常训练的模型没有任何区别” |
| 伪量化就是把参数真的变成 int8 | 前向是量化后的数值,反向梯度直通,参数本身仍是浮点 | round 导数为 0,真按链式法则求导会导致梯度消失 |
| 静态量化可以随便拿测试集来校准 | 必须用训练/验证集,用测试集就是数据泄漏 | 校准过程会”看到”测试集的分布并影响模型 |
| QAT 的”扭曲分布”是在损失精度 | 它是在有损空间里找最优,最终精度反而比 PTQ 高 | 判断标准是量化后的表现,不是和原始分布的距离 |
| 量化感知训练一定值得做 | 需要重训,时间成本高;很多场景 PTQ 已经够用 | 工程上先试 DQ/PTQ,只有掉点不可接受时才上 QAT |
六、横向对比与研究脉络
量化技术演进的一条主线:让统计更聪明,而不是让人更辛苦
| 阶段 | 代表方法 | 解决的核心问题 |
|---|---|---|
| 1 | 训练后直接 min-max(DQ) | 不用改训练流程,快速拿到压缩收益 |
| 2 | 校准 + 观察器(PTQ 静态) | 把统计开销前置,换取推理时的纯整数吞吐 |
| 3 | 更聪明的截断(KL 散度、直方图、移动平均) | min-max 被离群值撑爆的问题 |
| 4 | 更细的粒度(per-channel / per-group) | 通道间尺度差异、LLM 权重离群值 |
| 5 | QAT(伪量化 + STE) | 校准数据无法覆盖真实分布时的兜底 |
| 6 | 混合精度 / 分层策略 | 关键层保高精度,其余全量化 |
本图的位置:它把阶段 1、2、5 抽出来对照,”统计什么时候做” 与 “统计能不能反过来影响模型” 这两个变量,构成了量化选型的二维坐标。
与蒸馏/剪枝的关系:三者都是”模型压缩”,但切入点不同,量化是降低单个参数的位宽(高清 → 模糊),蒸馏是换一个更小的模型结构(复杂 → 简单),剪枝是删掉冗余参数(完整 → 残缺)。它们可以叠加使用,而且 QAT 中用”量化后的模型”去对齐”全精度模型”的输出,说到底就带上了蒸馏的思路。
七、在新闻分类项目中的落地
项目对 BERT 做压缩,最现实的执行顺序就是这张图给的三选一:
- 第一步一定先试动态量化(DQ)。理由:
- 一行 API(
torch.quantization.quantize_dynamic(model, {nn.Linear}, dtype=torch.qint8)); - BERT 的主体就是
nn.Linear堆叠 + Embedding,正好是 DQ 支持的层类型; - 不需要校准数据,不需要改模型结构,跑完就能量出”模型体积缩小比例”和”CPU 单条推理耗时变化”两个数字,这就是项目要汇报的量化收益。
- 代价:每次前向都要统计激活值分布,所以延迟改善可能不如预期,需要用实测数据说话。
- 第二步视掉点情况决定要不要上 PTQ。如果 DQ 后验证集上的 macro-F1 掉得不能接受,就改用静态量化:拿训练集的一部分(比如几千条)做校准,插观察器统计激活分布,再
convert。注意用训练集而不是测试集,否则汇报时被问到”你的校准数据哪来的”会很难看。 - QAT 在这个项目里基本可以直接排除,理由要能说清:项目已经要训 4 个模型(TF-IDF+随机森林、FastText、BERT、LLM),再为量化重训一遍 BERT 的时间成本太高;而 QAT 的收益是”在激进量化(int4/极低位宽)时才明显”,本项目用 int8 场景下 PTQ 已经够用。能说清”为什么不做”比盲目全做更专业。
- 和部署链路连起来:压缩后的模型最终要挂到 Flask 上。量化收益的最终体现是,同一台机器上单条新闻分类的 P99 延迟下降多少、QPS 提升多少。所以压缩实验的结论必须回到部署指标上,而不是只报”体积缩小 3.5 倍”。
八、重点问答
Q1:动态量化和静态量化的区别是什么?
A:核心区别是数据分布范围什么时候统计。动态量化在推理过程中根据实际输入的数据分布实时计算并更新 scale 和 zero_point,所以精度更高,但每次前向都要多一轮统计,效率会降低。静态量化是提前拿一批校准数据把每层激活值的范围算好、固定下来,然后直接量化,推理时全程整数运算,效率高,但区间是定死的,线上分布一旦超出校准范围就会被截断,精度略低。
Q2:QAT 到底做了什么?它不是一种量化方法吗?
A:QAT 本身不是量化技术,它是让模型适应量化的训练方法。做法是在网络里插入伪量化节点,正向传播时把数值真的量化一遍,让模型在低精度环境下训练,但内部真实参数和梯度计算都不变。训练完得到的模型和正常训练的模型没有结构区别,只是参数分布更适合量化,之后再走正常的量化流程,精度就会好很多。
Q3:伪量化节点的梯度怎么回传?
A:用直通估计器(straight-through estimator)。因为 round 函数的导数几乎处处为零,如果按真实链式法则求导,梯度会全部消失。所以实现上把量化的梯度近似为单位 1,让梯度”直通”过去。这就是课件里说的”内部实际参数和梯度计算都不变”的技术含义。
Q4:为什么 QAT 的参数会”收缩范围、抬高中心峰”?
A:因为 QAT 参数追求的是有损量化空间里的最优解,而普通参数追求的是无损自然分布的最优解,目标不同,最优分布形态就不同。收缩范围是因为量化步长 Δ 等于区间跨度除以格数,区间越大步长越粗、误差越大,所以把离群值拉回来能换来更细的步长,用范围换精度。抬高中心峰是因为单参数量化误差在格边界处最大、在格中心为零,所以把参数往格中心聚集能降低平均误差,用聚集度换精度。
Q5:量化误差在格内是怎么分布的?
A:是锯齿形的。在每格中心误差为零,越靠近格边界误差越大,到边界处达到半格即 \Delta/2 的最大值,然后跳回零。所以量化误差上界是 \Delta/2,而且它是系统性的、有上界的,不是随机噪声,不能靠平均消掉。
Q6:三种量化方式在项目里怎么选?
A:我的顺序是”先便宜、后昂贵”。第一步先用动态量化,一行 API、不需要校准数据、不需要重训,快速拿到压缩率和延迟两个数字。如果掉点不能接受,第二步改静态量化,拿训练集的一部分做校准,插观察器统计激活分布再转换。只有在前两步都不行、且对精度要求特别高时才上 QAT,因为它需要重训,时间成本最高。项目里我基本会排除 QAT,因为收益在 int8 场景下不明显,而重训 BERT 的成本太高。
Q7:静态量化的校准数据能用测试集吗?
A:不能。用测试集校准等于让模型提前”看到”测试集的分布并据此调整量化区间,是数据泄漏,会让评估结果虚高。必须用训练集或验证集的样本。另外校准数据不需要标签,几百到几千条有代表性的样本就够,关键是要覆盖真实线上输入的分布。
九、延伸阅读
- Jacob et al., Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference,QAT 与伪量化的经典论文
- PyTorch 官方量化文档:
quantize_dynamic(动态量化)、prepare/convert(PTQ)、prepare_qat(QAT)三套 API 的对照 - 直通估计器(Straight-Through Estimator)相关说明,理解伪量化节点梯度回传
- 本目录《【掌握】手算量化 min-max》研究报告,scale 与 zero_point 的推导
- 本目录《【掌握】二进制与字节》研究报告,位宽基础