整门量化课唯一的”手推”环节,用 min-max 方法把 0~1000 压到 int8 的 −128~128,把 scale 和 zero_point 这两个量化的核心参数从头算一遍。算通了这一遍,QAT/PTQ/DQ 的区别才有落脚点。
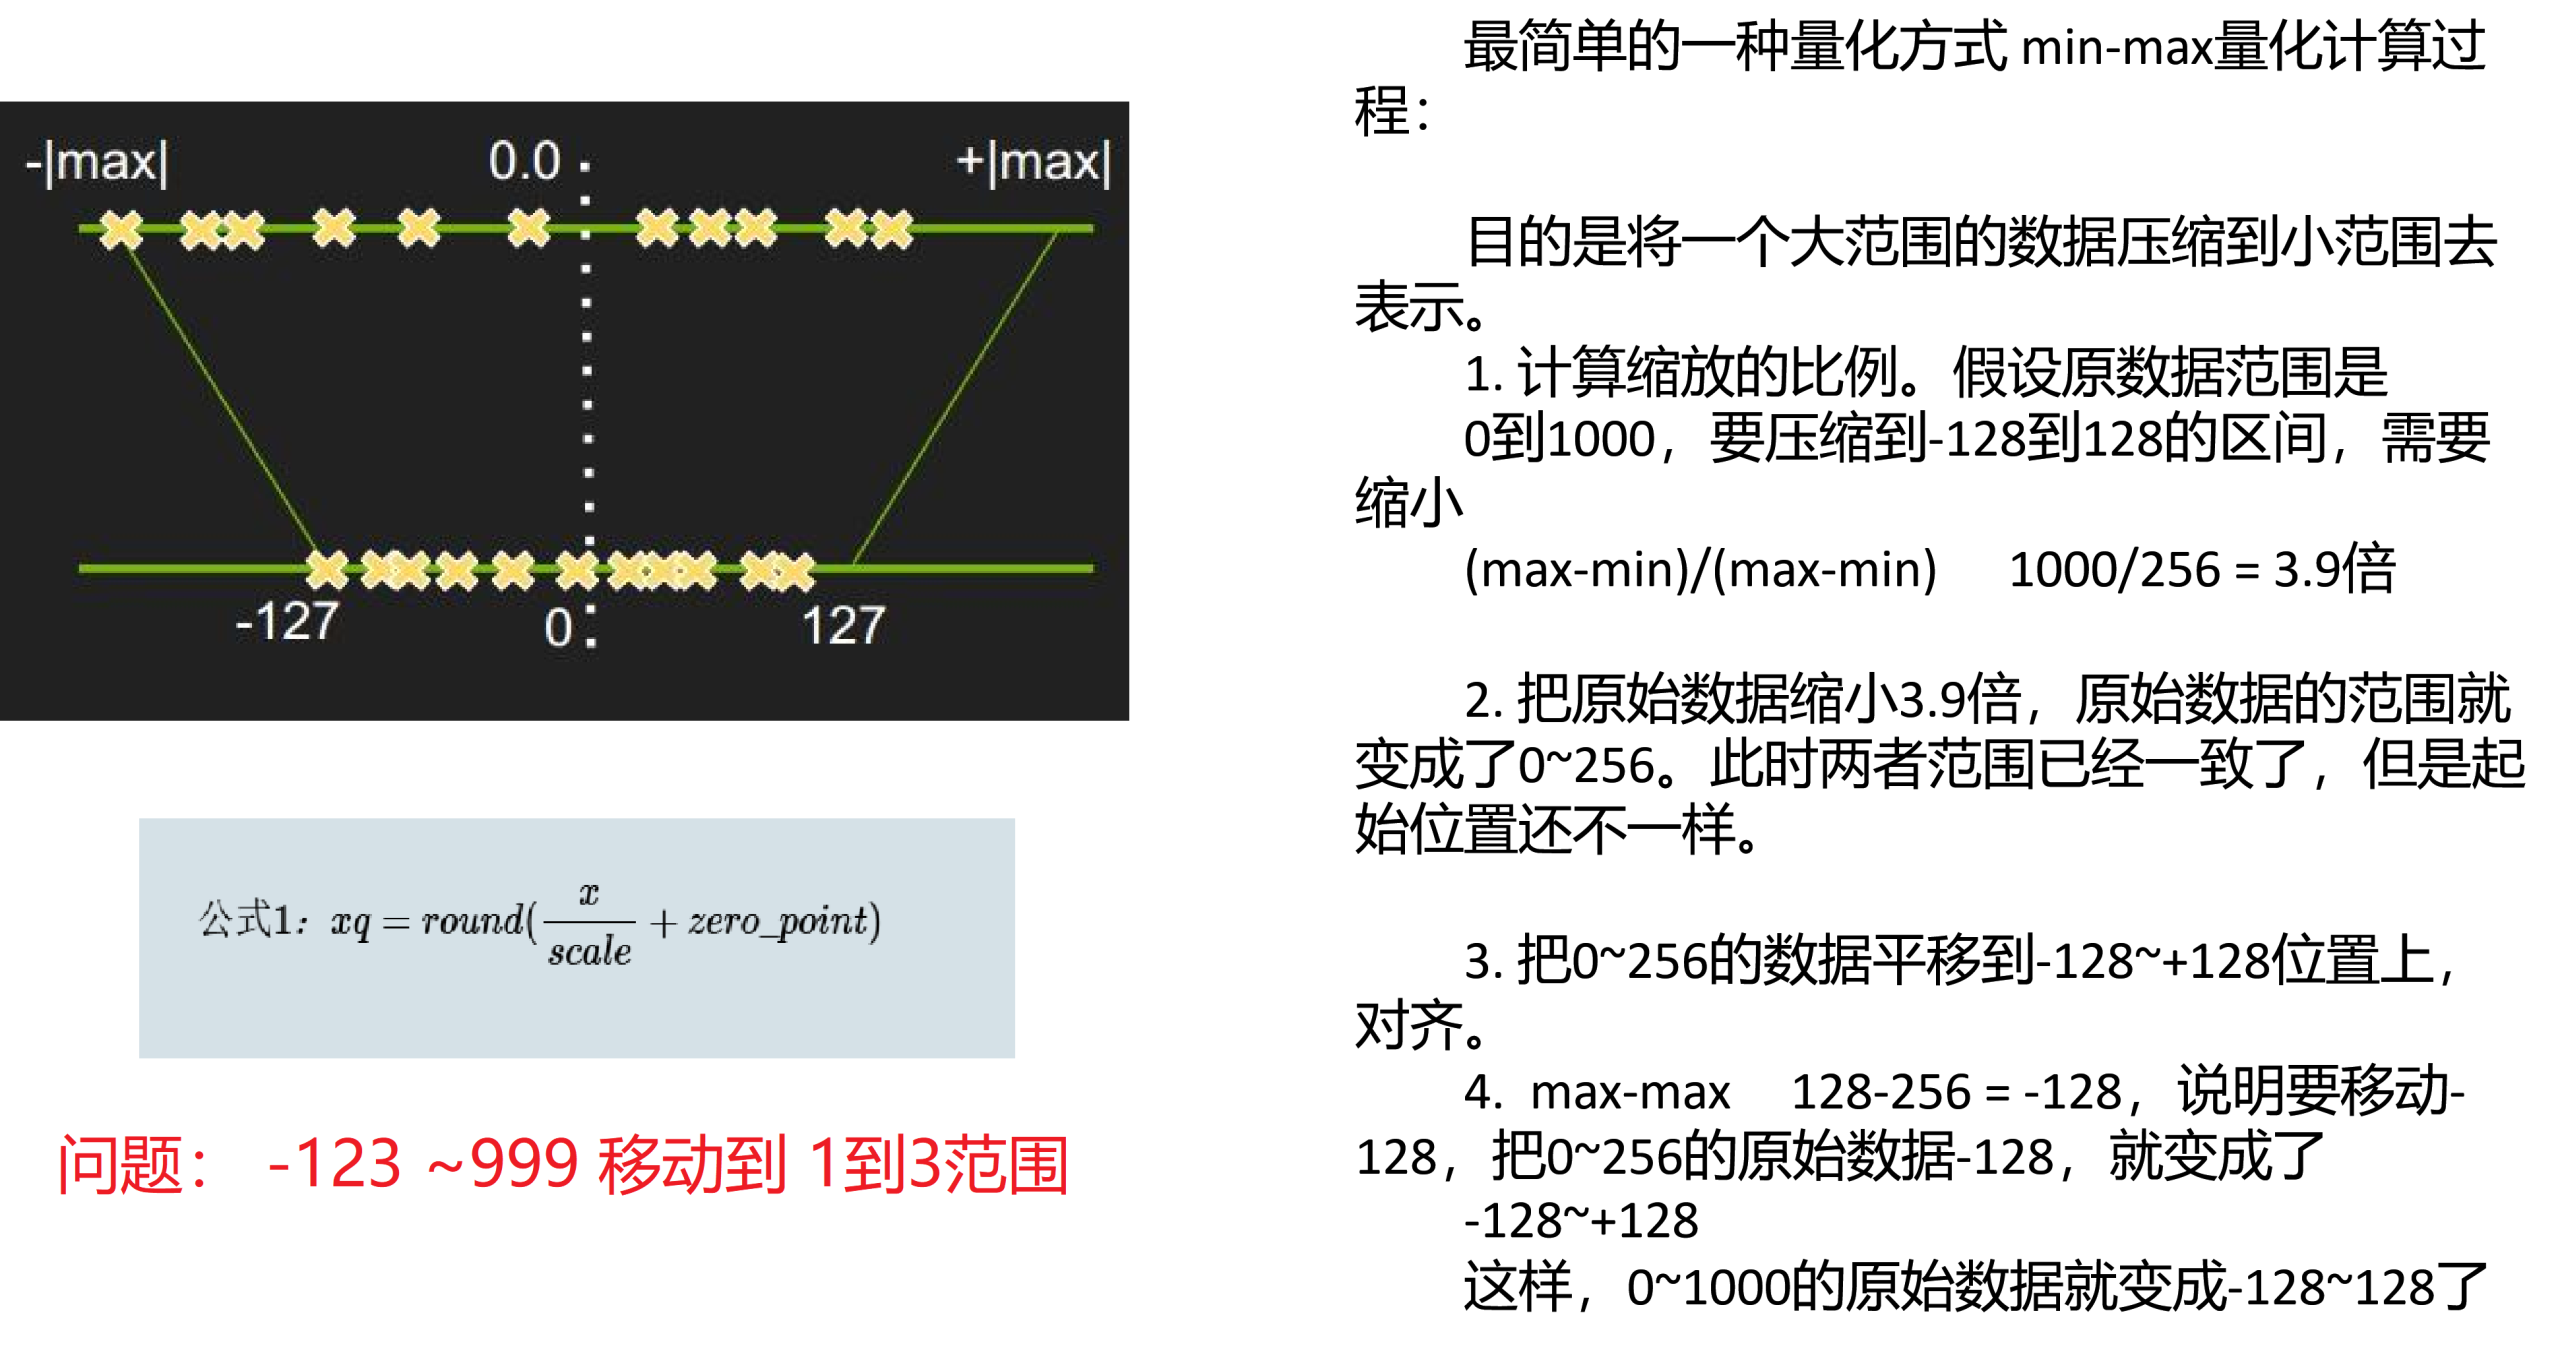
图注:原图分左右两块。左边是映射关系示意图:上轴是原始实数域(-|max| … 0.0 … +|max|),下轴是 int8 整数域(-127 … 0 … 127),中间两条斜线表示线性映射,虚线把实数 0.0 与整数 0 对齐,这条对齐正是 zero_point 干的活。左下灰框给出公式 1:x_q=\mathrm{round}(x/\text{scale} + \text{zero\_point});再下面红字是课后练习:”−123 ~ 999 移动到 1 到 3 范围”。右栏是 min-max 的四步计算过程正文。
一、这份材料解决什么问题
前面《二进制与字节》说明了 int8 只有 256 个离散值,所以必须建立”实数 → 整数”的映射。但映射的具体参数怎么定?这张图回答了这个问题:
scale决定分辨率(一格整数代表多少实数);zero_point决定对齐方式(实数 0 落在哪个整数上)。
而且它刻意用手算而不是调 API 的方式讲,因为在真实工程里,scale/zero_point 的取值来源(是统计训练数据的 min/max?还是用 KL 散度搜出来的?还是每通道单独统计?)正好是 PTQ 与 QAT、per-tensor 与 per-channel 的分水岭。手算过一遍,才知道那些自动化工具在你背后做了什么。
二、核心结论
- 量化的核心公式只有一条:x_q = \mathrm{round}(x/\text{scale} + \text{zero\_point}),反量化是它的逆运算 x \approx \text{scale}\times(x_q – \text{zero\_point})。
- min-max 量化分两步走:先缩放(除法,把范围压小)→ 再平移(加法,把起点对齐)。原图的第 2、3 步就是在强调”范围一致了但起始位置还不一样”。
scale = (max − min) / (q_max − q_min)。原图例子里 (1000-0)/(128-(-128)) = 1000/256 = 3.9,所以 scale 也叫”缩放倍数”。zero_point由”把实数 0 对齐到某个整数”这个约束反解出来。原图第 4 步用q_max − max = 128 − 256 = −128求出平移量,说明要把对齐好的数据整体减 128。- min-max 是最简单但最怕离群值的量化方式:一个极端大值会把 scale 撑大、把其余数据挤到几格整数里,精度断崖式下跌。这就是后来 per-channel / per-group 缩放和 KL 校准存在的理由。
三、知识地图
左栏(图 + 公式 + 练习题)
| 元素 | 内容 |
|---|---|
| 上轴(实数域) | -|max| ←— 中心 0.0,→ +|max| |
| 下轴(int8 整数域) | -127 ←— 中心 0,→ 127 |
| 连线 | 两条斜线连接两端,表示线性映射;虚线连接 0.0 与 0 |
| 公式 1 | x_q = \mathrm{round}\left(\dfrac{x}{\text{scale}} + \text{zero\_point}\right) |
| 练习题(红字) | −123 ~ 999 移动到 1 到 3 范围 |
右栏(标题:最简单的一种量化方式 min-max 量化计算过程)
目的是将一个大范围的数据压缩到小范围去表示。
- 计算缩放的比例。假设原数据范围是 0 到 1000,要压缩到 −128 到 128 的区间,需要缩小 (max−min)/(max−min),即 1000/256 = 3.9 倍。
- 把原始数据缩小 3.9 倍,原始数据的范围就变成了 0~256。此时两者范围已经一致了,但是起始位置还不一样。
- 把 0~256 的数据平移到 −128~+128 位置上,对齐。
- q_{max}-max = 128-256 = -128,说明要移动 −128,把 0~256 的原始数据 −128,就变成了 −128~+128。这样,0~1000 的原始数据就变成 −128~128 了。
四、原理详解
4.1 先看清那张示意图在说什么
示意图画的是两个数轴之间的线性映射:
实数域:   -|max| ————————————  0.0 ———————————— +|max|
                \                |                /
                 \               |               /
                  \              |              /
整数域:    -127 —————————————   0 ————————————— 127
要点有三个:
- 两条轴的范围都被”归一化”成了对称区间:实数域是 [-|max|, +|max|],整数域是 [-127, 127]。对称意味着 0 在正中间,这让映射公式最简洁。
- 中间的虚线段把
0.0和0连起来。这体现的是量化的一条硬性约束:实数零必须精确映射到整数零(或至少映射到一个确定的整数)。原因很实际,神经网络里大量存在 0:ReLU 的输出、padding、稀疏权重。如果 0 被映射到比如 −128,那么任何”输出为 0 的神经元”都会带来一个固定的偏置误差。 - 两条斜线的斜率就是 1/\text{scale},斜率越大表示分辨率越高(一格整数代表的实数越小)。
4.2 公式 1:正向量化
x_q = \mathrm{round}\!\left(\frac{x}{\text{scale}} + \text{zero\_point}\right)
| 符号 | 含义 | 本例取值 |
|---|---|---|
| x | 待量化的实数(权重/激活值) | 例如 500.0 |
| x_q | 量化后的整数 | int8,范围 −128~127 |
scale |
缩放因子:一格整数代表多少实数 | 3.9 |
zero_point |
零点偏移:实数 0 对应的整数 | −128 |
反量化(推理时要还原成实数参与计算,或者反量化后只在部分算子里用整数算):
\hat{x} = \text{scale}\times(x_q – \text{zero\_point})
可以验算这个可逆性:代入 x=500,x_q = \mathrm{round}(500/3.9 + (-128)) = \mathrm{round}(128.2-128)=\mathrm{round}(0.2)=0,反量化 \hat x = 3.9\times(0-(-128)) = 3.9\times128 = 499.2。误差 0.8,也就是半个 scale 以内(3.9/2 = 1.95),量化误差上界就是 \text{scale}/2。
4.3 右栏四步的机械复述(这是本图最该背下来的过程)
第 1 步:算缩放比例(确定 scale)
原数据范围 [0, 1000],要压到 int8 的 [-128, 128]:
\text{scale} = \frac{x_{max} – x_{min}}{q_{max} – q_{min}} = \frac{1000 – 0}{128 – (-128)} = \frac{1000}{256} = 3.9
原图这里把分母写成了
(max-min)/(max-min),第二个max/min应该是 整数域的上下界 q_{max}/q_{min}。这是课件排版笔误,不影响计算(数字 1000/256 是对的)。记住正确写法就是上面的式子。
第 2 步:缩放(把范围压小)
所有数据除以 3.9:
[0, 1000] \div 3.9 \;\Rightarrow\; [0, 256]
此时跨度已经和整数域一致了(都是 256 格),但起点没对齐,实数 0 落到了 0 的位置,而 int8 的 0 在中间。
第 3 步:平移(把起点对齐)
要让 [0,256] 落到 [-128, 128],整体减 128:
[0, 256] – 128 \;\Rightarrow\; [-128, 128]
第 4 步:反解平移量(它就是 zero_point 的另一种算法)
原图用的写法是:
q_{max} – x_{max}^{\text{(缩放后)}} = 128 – 256 = -128
意思是”整数域上界 128 与缩放后数据上界 256 之间的差是 −128,所以整体移动 −128″。
把这个平移量和公式 1 对照,就能看出二者的等价关系。设 x 缩放 3.9 倍后为 x’ = x/3.9 \in [0,256],我们要求的是 x_q = x’ + zp’ 使 0 \mapsto -128:
0 + zp’ = -128 \Rightarrow zp’ = -128
而公式 1 里的 zero_point 是在缩放前的式子里:x_q = \mathrm{round}(x/\text{scale} + \text{zero\_point})。这里的 x/\text{scale} 就是 x’,所以两者是同一个数:
\boxed{\ \text{zero\_point} = q_{min} – \frac{x_{min}}{\text{scale}} = -128 – \frac{0}{3.9} = -128\ }
这才是 zero_point 的通用求法:让实数域最小值精确落在整数域最小值的那个偏移量。
验证一遍端到端:
| 实数 x | x/3.9 | +(-128) | round → x_q | 反量化 \hat x | 误差 |
|---|---|---|---|---|---|
| 0 | 0.00 | −128.00 | −128 | 3.9\times(0) = 0.0 | 0 |
| 500 | 128.21 | 0.21 | 0 | 3.9\times128 = 499.2 | −0.8 |
| 1000 | 256.41 | 128.41 | 128 | 3.9\times256 = 998.4 | −1.6 |
误差都在 \pm\text{scale}/2 = \pm 1.95 以内,和第 4.2 节的结论一致。
4.4 把练习题做完:−123 ~ 999 映射到 1 ~ 3 范围
红字那道题是左下角分布的另一套参数:实数域 [-123, 999],目标整数域 [1, 3](只有 3 个取值,故意做得很小,方便手算)。
第一步,算 scale:
\text{scale} = \frac{x_{max}-x_{min}}{q_{max}-q_{min}} = \frac{999-(-123)}{3-1} = \frac{1122}{2} = 561
第二步,算 zero_point(用 4.3 节推出的通用式):
\text{zero\_point} = q_{min} – \frac{x_{min}}{\text{scale}} = 1 – \frac{-123}{561} = 1 + 0.2193 = 1.2193
第三步,验证两端:
| 实数 x | x/561 | +1.2193 | round → x_q |
|---|---|---|---|
| −123(最小值) | −0.2193 | 1.0000 | 1 |
| 0 | 0 | 1.2193 | 1 |
| 500 | 0.8913 | 2.1106 | 2 |
| 999(最大值) | 1.7807 | 3.0000 | 3 |
两个端点都精确落在目标区间上,说明 scale 和 zero_point 算对了。
从这道题能读出的三条道理:
- q 只有 3 个取值(1/2/3),意味着整个 [-123, 999] 区间的数据被压成了 3 个桶,分辨率就是 561。这就是”低位宽量化掉精度”的极端演示。
- 当 q_{min} \neq 0 时,
zero_point一般不是整数(这里算出 1.2193)。工程实现里zero_point必须取整(取 round 或 ceil),取整后会引入一个”零点偏移误差”,这也是量化误差的一部分来源。 - 如果目标区间是对称的 [-128, 127],那么 q_{min} = -128,公式退化成 zp = -128 – x_{min}/\text{scale},和 4.3 节完全一致。
4.5 为什么要分”按块量化”(per-block / per-group)
课堂上紧接这张图还讲到按块量化:把张量按 (T, D) 的形状切块,块内共享一套 min-max 统计出来的 scale/zero_point。
直觉对比:
– per-tensor(整层一套参数):图省事,但如果某一层里有一个通道数值特别大,整层 scale 都被它撑大,其余通道全被压扁。
– per-channel(每通道一套):解决通道间的差异,是卷积网络的标配。
– per-block / per-group(每组一套):在 LLM 里最常用(例如 128 个元素一组),因为 LLM 的权重里存在大量离群值(outlier),细粒度分组能把它们隔离在少数组里。
代价是量化参数本身占空间:如果每 128 个权重就要存一对 scale/zero_point,这部分开销需要计入总压缩率。这就是为什么前面讲”实测压缩率低于理论 4 倍”。
五、易错点与常见误解
| 常见说法 | 正确说法 | 为什么 |
|---|---|---|
scale = (max−min)/(max−min) |
分母是整数域的 q_{max}-q_{min} | 原图这里有排版笔误;分母写错就永远是 1,量化无从谈起 |
| 量化就是”除以一个数” | 是先缩放、再平移两步 | 只除不平移,起点对不上,0 会跑偏,引入系统偏差 |
zero_point 就是 (q_{max}+q_{min})/2 这类固定值 |
它由”实数最小值对齐到整数最小值”反解出来,随数据范围变化 | 对称量化下它恰好是 q_{min},非对称量化下不是 |
| 量化误差是随机的,平均一下就没有了 | 误差有上界(≤ scale/2)且是系统性的 | 因为 round 的方向由数据分布决定,不是随机噪声 |
| min-max 是”最简单所以最好” | 最简单,但最怕离群值 | 单个极端值会撑大 scale,其余数据的有效比特数骤降 |
| 反量化后数值应该和原来一样 | 只能还原到 \pm\text{scale}/2 的误差内,且不可逆 | 量化是有损压缩,信息已经丢了 |
zero_point 可以是小数 |
实现时必须取整,取整会带来额外偏差 | 整数域本身只有 256 个格,零点必须是其中一个 |
六、横向对比与研究脉络
量化参数定标(calibration)的三条粒度路线:
| 粒度 | 量化参数数量 | 精度 | 额外开销 | 典型场景 |
|---|---|---|---|---|
| per-tensor | 每张量 1 对 | 最低 | 几乎为 0 | 简单 CNN、快速验证 |
| per-channel | 每输出通道 1 对 | 中 | 很小 | ResNet 等 CNN 的静态量化 |
| per-block/group | 每 N 个元素 1 对 | 高 | 与组大小成反比 | LLM 权重(离群值多) |
min-max 之后出现的方法,以及各自解决的痛点:
| 方法 | 解决的问题 | 核心思路 |
|---|---|---|
| min-max(本图) | 最基础,能跑通 | 直接用数据的全局极值定区间 |
| 移动平均 min-max | 训练中逐 batch 统计抖动大 | 用滑动平均平滑历史极值 |
| KL 散度校准 | 极值把 scale 撑爆 | 在候选截断阈值里挑一个让”量化前后分布最接近”的 |
| 直方图校准 | 分布非均匀 | 用激活值直方图找更合适的截断点 |
| per-channel / per-group | 通道间、组间尺度差异大 | 细粒度各自定标 |
| QAT(伪量化) | 静态校准无法适配训练 | 训练时插入伪量化算子,让模型自己学容忍误差 |
脉络一句话:min-max 定义了”量化的形式”,后面所有方法都在解决同一个问题,怎么在 256 个格里塞进数据的真实分布。数据越”长尾 + 有离群值”,就需要越细的粒度或越聪明的截断。
七、在新闻分类项目中的落地
- 讲清”动态量化”为什么不用校准数据:项目里
torch.quantization.quantize_dynamic()一行就能量化 BERT。原因是,动态量化里权重的scale/zero_point用本文的 min-max 直接从权重张量算出来(权重是静态的,随时可统计);而激活值在运行时才按每个 batch 的实际 min/max 现算。所以它不需要提前准备校准数据集,代价是每次前向都要多算一次统计。 - 理解静态量化(PTQ)为什么需要一批数据:因为静态量化要把激活值的 min/max 提前定死,只能拿一批有代表性的数据跑一遍前向去做统计,这一步正是在做本文第 1~4 步,只不过把”手算”换成了”统计 + 遍历候选阈值”。
- 讲解/汇报时能给数量级:算出
scale = 3.9后,能明确说出”int8 量化后每格代表 3.9 个单位,误差上界 1.95″,这比只说”量化会掉一点精度”专业得多。评估量化模型时,观察准确率下降是否和”误差上界 × 层数”的累积量级相符,也是排查”是量化问题还是别的问题”的手段。 - 按块量化 → 压缩率的诚实计算:如果对 BERT 的 Linear 层做 per-channel 量化,多出的
scale/zero_point开销大约是”每个输出通道 2 个 float32″,相对权重本身可以忽略;但如果做 per-group(如每 64 个一组),开销就不可忽略了。做压缩率汇报时要交代粒度,否则实测值和理论值对不上。
八、重点问答
Q1:量化公式是什么?scale 和 zero_point 分别是什么含义?
A:正向量化是 x_q = \mathrm{round}(x/\text{scale} + \text{zero\_point}),反量化是 x \approx \text{scale}\times(x_q-\text{zero\_point})。scale 是缩放因子,表示一个整数格代表多少实数,也就是分辨率;zero_point 是零点偏移,作用是把实数 0 精确映射到某个整数上。反解式是 zp = q_{min} – x_{min}/\text{scale},也就是让实数域最小值精确对齐整数域最小值。
Q2:现场把 0~1000 量化到 int8 的 −128~127,你怎么算?
A:两步。第一步算 scale:1000/(127-(-128)) = 1000/255 \approx 3.92;如果按课件口径用 256 格,就是 1000/256=3.9。第二步算 zero_point:zp = q_{min} – x_{min}/\text{scale} = -128 – 0 = -128。校验:x=500 时 500/3.9-128 = 0.2,round 后是 0,反量化 3.9\times(0+128)=499.2,误差 0.8,在半个 scale 之内。
Q3:为什么量化一定要先缩放再平移,只做缩放行不行?
A:不行。只缩放能让数据跨度和整数域一致,但起点对不上,比如 0~1000 除以 3.9 变成 0~256,而 int8 的区间是 -128~127,起点差了 128。所以必须再来一步平移把起点对齐。课件里第 2 步和第 3 步就是在强调”范围一致了但起始位置还不一样”。
Q4:zero_point 为什么必须让实数 0 精确落在某个整数上?
A:因为神经网络里有大量真实的零,ReLU 的输出、padding、稀疏权重。如果 0 被映射到一个非零整数,那么所有”本该是 0″的地方都会带上一个固定偏置,误差会随层数累积。所以量化实现里会强制约束零点对齐,这也是 zero_point 取整会产生额外误差的原因。
Q5:min-max 量化有什么缺点?后来怎么改进的?
A:缺点是怕离群值。它直接用全局极值定区间,如果有几个特别大的值,scale 会被撑得很大,剩下 99% 的数据只能挤在几个整数格里,精度断崖下跌。改进方向有三条:一是细粒度定标,从 per-tensor 到 per-channel 再到 per-group/per-block;二是换更聪明的截断策略,比如 KL 散度校准、直方图校准,找一个比极值更小的截断点;三是 QAT,在训练时插入伪量化算子让模型自己学会容忍误差。
Q6:量化误差上界是多少?
A:反量化后误差不超过 scale 的一半。因为 round 最多偏离 0.5 个整数单位,乘回 scale 就是 \text{scale}/2。比如 scale=3.9 时误差上界是 1.95。注意这个误差是系统性的、有上界的,不是随机噪声,所以不能靠平均消掉。
Q7:为什么大模型量化常用按块(per-group)而不是整层(per-tensor)?
A:因为 LLM 权重里有明显的离群值,少数通道数值特别大。如果整层共用一套 scale,这些离群值会把 scale 撑大,其余权重的有效精度被严重压缩。按块量化把 128 个元素分一组、组内各自定标,能把离群值隔离在少数组里,整体精度好得多。代价是要多存量化参数,做压缩率统计时必须把这部分开销算进去。
九、延伸阅读
- Jacob et al., Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference,量化公式与
scale/zero_point的经典出处 - PyTorch 官方量化文档:
torch.quantization观察器(observer)与校准流程(per-tensor / per-channel) - 本目录《【掌握】二进制与字节》研究报告,位宽与数据类型基础
- 本目录《【掌握】动态静态量化》研究报告,DQ / PTQ / QAT 三条路线的分工
- 本目录《【掌握】模型剪枝》研究报告,另一种压缩手段(完整 → 残缺)