从”1 bit 能表示两种可能性”出发,一路推到 KL 散度,把蒸馏里那个 soft_loss = F.kl_div(...) 的每个符号、每个参数方向、为什么必须用 KL 而不是 MSE 全部讲透。
一、这份材料解决什么问题
蒸馏的损失函数长这样:
\text{loss} = (1-\alpha)\cdot \text{hard\_loss} + \alpha \cdot T^2 \cdot \text{soft\_loss}
其中 soft_loss 是 KL 散度。这句话在工程上可以直接抄代码,但评审者往下追问一句就露馅:为什么软损失是 KL?KL 到底在算什么?温度 T 为什么还要平方?这份 PPT 就是来补这块地基的。
它要解决的原始问题是:
教师输出
[0.8, 0.1, 0.1],学生输出[0.6, 0.2, 0.2],怎么用数字衡量这两个分布”差多远”?
PPT 的推导路线非常工程师化:先不甩公式,而是从”两点距离 |3-5|“这种最朴素的直觉开始,一步步试错(减法不行→加权→除法→加 log),最后自然长出 KL 的公式,再补上信息论解释,交叉熵 = 信息熵 + KL 散度。所以你记住的不是一个从天而降的公式,而是一条为什么只能长成这样的推导链。
在新闻分类项目里的位置:项目最后要做模型压缩,蒸馏是其中一环(软标签蒸馏)。上一份材料《【掌握】软硬标签》讲了”软标签为什么有知识”,这份材料讲的是”这份知识怎么变成可求导的损失”。两者是配套的,软标签是原料,KL 散度是把原料接进反向传播的那根管子。
二、核心结论
log和bit是一回事:\log_2(x) 回答”2 的几次方等于 x”,也就是”要表示 x 种可能性需要几个 bit”。\log_2 8 = 3 bit,因为 2^3=8。本文所有 log 以 2 为底,所以单位是 bit(PyTorch 用自然对数,单位是 nat,数值差一个 \ln 2 \approx 0.693 的倍数,别混用)。- 信息量 = -\log P(x):概率越低的事情,信息量越大。”太阳照常升起”(0.99)信息量只有 0.015 bit,”太阳灭了”(0.01)高达 6.64 bit。
- 信息熵 H(P)=\sum_x P(x)\cdot(-\log P(x)) 是平均信息量,真实世界的”新闻量下限”。概率大的事信息量小、概率小的事信息量大,加权求和之后压到很低,说明”明天没什么新闻”。
- 交叉熵 = 信息熵 + KL 散度:H(P,Q)=H(P)+\mathrm{KL}(P\|Q)。交叉熵是”用虚假分布 Q 去描述真实世界 P 的代价”,信息熵是”真实世界自身的最小代价”,差值就是 Q 白白多付的钱。
- KL 不是距离:它不对称(\mathrm{KL}(P\|Q)\ne \mathrm{KL}(Q\|P))、不满足三角不等式、可以无界,只是一个”散度”。它的物理含义是:用分布 Q 去编码来自 P 的数据时,平均每个符号额外多付出的比特数。P=Q 时 KL 严格为 0(最小值)。
三、知识地图
原 PPT 10 页,权重标为【了解】,但内部有明显分层,第 1~3 页 + 第 7 页是必须能背的公式推导,第 5~6 页是信息量直觉,第 8~10 页是蒸馏落地(最常被问):
【了解】KL散度 + 信息论(10 页)
├── 铺垫:从 bit 到 log(第 1~2 页)
│   ├── 一个 bit 表示两种可能性:2×2×2 = 8,x=3 → y=8
│   ├── 反过来:8 种可能性要几个 bit? log(8) = 3
│   ├── 所有 log 以 2 为底(计算机领域习惯,数学领域习惯以 10 为底)
│   └── log 函数性质(第 2 页)
│       ├── y = log(x):2 的几次方等于 x
│       ├── log(a/b) = log(a) - log(b)(里乘除、外加减)
│       ├── x > 0;log(1) = 0;log(4) = 2
│       └── 为什么总要出现 log:单调不改变大小排序 + 减缓数值膨胀
├── 核心:如何衡量两个向量(分布)的差异(第 3 页)★
│   ├── 方案1 简单直觉:|0.8-0.6| + |0.1-0.2| + |0.1-0.2|(没考虑老师认为哪类重要)
│   ├── 方案2 按老师的重要度加权:0.8×|Δ| + 0.1×|Δ| + 0.1×|Δ|
│   ├── 方案3 减法换除法:0.8×|0.8/0.6| + …(体现"错了一倍"的比例关系)
│   │   └── 但除法最小值是 1(不像损失)、分母太小会爆炸 → 必须再套一个函数
│   └── 方案4 套上 log:0.8×log(0.8/0.6) + 0.1×log(0.1/0.2) + … → 得到 KL 公式
├── 说明(第 4 页)
│   └── 简单版推导到此为止,代码里直接调库函数;后面是更难的推导,只需了解【温度】和【训练流程图】
├── 信息量(第 5~6 页)
│   ├── 死宅日记:50% 概率学习 → 2 种可能 → log(2) = 1 bit
│   ├── 25% 概率学习 → 4 种可能 → log(4) = 2 bit
│   └── 用概率代替次数:-log(概率) = 信息量(概率越低,信息量越大)
├── 信息熵 / 交叉熵 / KL 复杂版推导(第 7 页)★
│   ├── 信息熵:真实概率 × 真实信息量,加权求和 = 0.99×0.015 + 0.01×6.64 = 0.08
│   ├── 交叉熵:真实概率 × 瞎说的信息量 = 0.99×(-log0.2) + 0.01×(-log0.8) = 2.3
│   └── 交叉熵 - 信息熵 = KL散度(描述了小学生和真实世界之间的差异)
└── 软标签蒸馏落地(第 8~10 页)★
    ├── 第 8 页:训练流程图骨架(数据 → 学生 → loss1;教师(.eval()) → loss2;loss=loss1+loss2 → backward → step)
    ├── 第 9 页:带真实数字的流程图(学生 [0.3,0.4,0.3] vs 教师 [0.7,0.2,0.1])
    └── 第 10 页:温度 T——除以 10 变软、除以 0.1 变硬;通常取 2;温度越低越硬(冻硬了)
四、原理详解
4.1 铺垫:为什么信息论里到处是 log
计算机的最小存储单位是 bit,一个 bit 能区分两种可能性(0 或 1)。那 3 个 bit 能区分多少种?2\times2\times2=8 种:
000 001 010 011 100 101 110 111这是一条正着的函数:输入”几个 bit”,输出”多少种可能”。但实际工程中我们问的永远是反过来的问题,已知有 8 种可能,要几个 bit?于是引入 log:
\log_2(x) \triangleq \text{“2 的几次方等于 } x\text{“} \qquad \log_2 8 = 3
机制/公式:本文(以及整个计算机领域)的 log 以 2 为底,因此结果的单位就是 bit。PPT 第 2 页给出的 log 性质:
\log\!\left(\frac{a}{b}\right) = \log a – \log b \quad\text{(里乘除、外加减)}
x>0 \quad(\text{因为 2 的任何次方都大于 0}),\qquad \log 1 = 0,\qquad \log 4 = 2
PPT 第 2 页还专门回答了”为什么总是出现 log”,两个理由:① log 不改变大小排序(a>b \Rightarrow \log a > \log b),所以用它当损失函数不会改变”谁更好”的判断;② log 可以减缓数值膨胀,把连乘变成连加、把指数级增长压成线性增长。这两点在后面推导 KL 时都会用上。
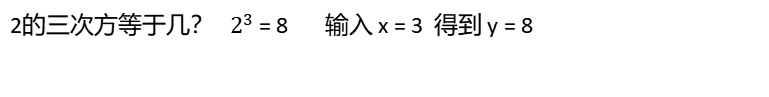
图注:原图是一行横排的板书式文字,”2 的三次方等于几? 2^3=8 输入 x=3 得到 y=8“。左边是问题,中间是幂运算的答案,右边点明这其实是一个”输入 3、输出 8″的函数关系。
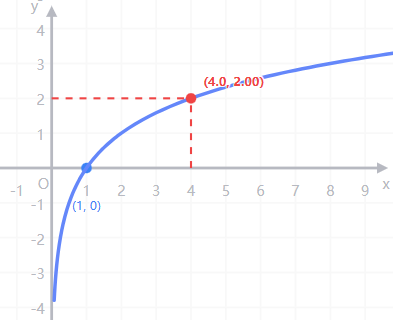
图注:这是一张 Desmos 绘制的 y=\log_2 x 函数图。蓝色曲线在 x=1 处穿过 x 轴(图上用蓝点标注 (1,0),对应 \log_2 1 = 0),在 (4.0,\,2.00) 处被红点标注,并有两条红色虚线从该点分别引到 y 轴的 2 和 x 轴的 4(对应 \log_2 4 = 2)。坐标范围:y 轴 -4\sim4,x 轴 -1\sim9。注意曲线形状,在 x\to 0^+ 时陡峭地掉向负无穷(x=0 是竖直渐近线),随着 x 增大逐渐变得平缓。这条”左陡右缓”的形状正是后面”概率越低信息量爆炸式增大”的图形来源。
4.2 核心推导:衡量两个分布的差异,为什么最后只能长成 KL
这是整份 PPT 最有价值的一页(第 3 页)。场景设定很具体:
| 猫 | 狗 | 汽车 | |
|---|---|---|---|
| 老师(真实分布 P) | 0.8 | 0.1 | 0.1 |
| 学生(近似分布 Q) | 0.6 | 0.2 | 0.2 |
方案 1:最朴素的绝对差
\text{差异} = |0.8-0.6| + |0.1-0.2| + |0.1-0.2| = 0.4
问题:没有区分轻重。老师认为”猫”是主科(0.8),”汽车”是体育课(0.1),主科差 0.2 和体育差 0.1 被一视同仁,不合理。
方案 2:按老师认为的重要程度加权
= 0.8\times|0.8-0.6| + 0.1\times|0.1-0.2| + 0.1\times|0.1-0.2| = 0.18
问题:减法不能体现比例。”猫”差 0.2、”汽车”差 0.1,绝对值上猫差得多,但从比例看汽车错了整整一倍(0.1 vs 0.2),这才是更严重的错误。所以应该用除法。
方案 3:把减法换成除法
= 0.8\times\left|\frac{0.8}{0.6}\right| + 0.1\times\left|\frac{0.1}{0.2}\right| + \cdots = 1.1667
问题有两个,PPT 说得很直白:① 除法版本”差异最小时是 1″(0.8/0.8=1),而损失函数的最小值必须是 0,最小值是 1 不合理;② 分母太小会爆炸(Q(x) 接近 0 时比值趋向无穷)。所以需要一个能”把 1 变成 0、把爆炸压住”的函数,正好就是 log。
方案 4:套上 log,得到 KL 散度
\text{差异} = 0.8\times\log\frac{0.8}{0.6} + 0.1\times\log\frac{0.1}{0.2} + 0.1\times\log\frac{0.1}{0.2}
用专业符号写出来(P = 老师/真实分布,Q = 学生/近似分布):
\boxed{\ \mathrm{KL}(P\|Q) = \sum_x P(x)\log\frac{P(x)}{Q(x)}\ }
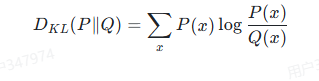
图注:原图就是 KL 散度的标准数学写法,居中一行:\mathrm{KL}(P\|Q)=\sum_x P(x)\log\frac{P(x)}{Q(x)}。斜体衬线字体(TeX 排版),带学员水印。对照上面的方案 4 可以逐项对上:\sum_x 是对所有类别求和、P(x) 是”按老师认为的重要度加权”、\log\frac{P(x)}{Q(x)} 是”除法 + log”。图上写的是 \mathrm{KL}(P\|Q) 而不是 D_{KL},含义相同。
关键理解(要能说出来):公式里 P(x) 那个权重永远是”老师的”,不是学生的。PPT 的原话是:”教师从他的角度审视学生,看看这小子错误的有多离谱。从教师的视角,看一个近似分布距离自己的标准还有多远。”,所以 KL 天然是有方向的,写 \mathrm{KL}(P\|Q) 和 \mathrm{KL}(Q\|P) 是两件不同的事。
带数字的手算(必背):取 P=[0.8,0.2]、Q=[0.5,0.5],以 2 为底(Python 实测):
\mathrm{KL}(P\|Q) = 0.8\log_2\frac{0.8}{0.5} + 0.2\log_2\frac{0.2}{0.5} = 0.8(0.678) + 0.2(-1.322) = 0.542 – 0.264 = \mathbf{0.2781}
\mathrm{KL}(Q\|P) = 0.5\log_2\frac{0.5}{0.8} + 0.5\log_2\frac{0.5}{0.2} = 0.5(-0.678) + 0.5(1.322) = \mathbf{0.3219}
两个数不相等(0.2781 ≠ 0.3219),这就是”KL 不对称”最省事的手算证明,被追问时直接写这一步,比嘴上说”它不对称”有说服力得多。
4.3 信息量:从”数次数”到”用概率表示”
第 5~6 页换了个更接地气的入口,”死宅日记”。
明天只有两种可能,睡觉或学习,各 50%。”我在旁边等着,看几轮能抽到一次’学习'”:平均 2 次一轮抽到,用 \log(2)=1 个 bit 就能记录这个全部可能性。如果是四种可能(学/睡/玩/吃),抽到一次学习平均需要 4 次,\log(4)=2 个 bit。
数次数太麻烦,改用概率表示。因为”抽到一次需要的次数”正好等于概率的倒数:
-\log(\text{概率}) = -\log\frac{1}{\text{抽到一次需要的次数}} = -\log 1 + \log(\text{次数}) = \log(\text{次数})
所以直接用 -\log(\text{概率}) 表示信息量。于是得到核心结论:
\text{自信息}\quad I(x) = -\log P(x) \qquad (0 < P(x) < 1)
数值直觉:-\log_2(0.5)=1 bit;-\log_2(0.25)=2 bit。概率越低 → 信息量越大:概率低的事情”杂七杂八的可能性太多”,需要更多 bit 才能描述;概率高的事情”根本没啥别的可能性”,几个 bit 就够。PPT 第 6 页用”写明天计划要准备多少纸”来比喻:死宅(100% 睡觉)不需要纸,冒险家(1% 概率睡觉)需要一大堆纸。
4.4 信息熵:平均信息量,即”真实世界的最小代价”
第 7 页用”明天太阳会不会升起”把三件事一次讲完。
| 事件 | 概率 | 信息量 |
|---|---|---|
| 太阳照常升起 | 0.99 | -\log_2 0.99 = 0.015 bit |
| 太阳灭了 | 0.01 | -\log_2 0.01 = 6.64 bit |
信息熵 = 真实概率 × 真实信息量,加权求和:
H(P) = \sum_x P(x)\cdot\bigl(-\log P(x)\bigr) = 0.99\times0.015 + 0.01\times6.64 = \mathbf{0.0808}\ \text{bit}
怎么读这个 0.08:”信息量高的事件发生率低,信息量低的事件发生率高”,加权之后被压得很低,明天总的来说没什么新闻,世界非常确定。信息熵 = 这个世界本身的不确定度 / 描述这个世界平均需要多少 bit,是一个下限。
4.5 交叉熵:真实概率 × 瞎说的信息量
PPT 第 7 页让一个学生模型”瞎预测”:它认为明天太阳升起的概率只有 0.2,太阳灭了的概率高达 0.8。那么”这个离谱预测的信息量”是:
\text{交叉熵} = \underbrace{0.99}_{\text{真实概率}}\times\bigl(-\log 0.2\bigr) + \underbrace{0.01}_{\text{真实概率}}\times\bigl(-\log 0.8\bigr) = 0.99\times2.3219 + 0.01\times0.3219 = \mathbf{2.3019}\approx 2.3
注意这里的乘法是”真实概率 × 我瞎说的信息量”,一半用真的(概率来自真实世界 P),一半用假的(信息量来自学生的 Q)。真实和虚假交替相乘,所以叫交叉熵:
H(P,Q) = -\sum_x P(x)\log Q(x)
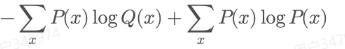
图注:原图是 KL 复杂版推导的起点,一行公式:-\sum_x P(x)\log Q(x) + \sum_x P(x)\log P(x)。前一项带负号的是交叉熵 H(P,Q),后一项带正号的是信息熵(因为 H(P)=-\sum P\log P,这里取了相反的符号)。两项横排相加,正是”把 KL 展开成交叉熵与熵做差”的那一刻,只要把 \log\frac{P}{Q} 拆成 \log P-\log Q 再整理符号,就能从第 4.2 节的 KL 定义式直接得到这一行的两项。
4.6 交叉熵 = 信息熵 + KL 散度(本文最该背的一条)
把 \log\frac{P(x)}{Q(x)} 拆成 \log P(x)-\log Q(x):
\mathrm{KL}(P\|Q) = \sum_x P(x)\bigl(\log P(x)-\log Q(x)\bigr) = \underbrace{\Bigl(-\sum_x P(x)\log Q(x)\Bigr)}_{H(P,Q)} – \underbrace{\Bigl(-\sum_x P(x)\log P(x)\Bigr)}_{H(P)}
整理得到:
\boxed{\ H(P,Q) = H(P) + \mathrm{KL}(P\|Q) \quad\Longleftrightarrow\quad \mathrm{KL}(P\|Q) = H(P,Q) – H(P)\ }
数字上完整验证一遍(仍用 P=[0.8,0.2]、Q=[0.5,0.5],log 以 2 为底):
| 量 | 公式 | 数值 |
|---|---|---|
| 信息熵 H(P) | -\sum P\log_2 P | 0.7219 |
| 交叉熵 H(P,Q) | -\sum P\log_2 Q | 1.0000 |
| KL 散度 \mathrm{KL}(P\|Q) | H(P,Q)-H(P) | 1.0000-0.7219=\mathbf{0.2781} 与 4.2 节手算一致 |
回到太阳的例子:2.3019 – 0.0808 = 2.2211 = \mathrm{KL}(\text{真实}\|\text{学生})。交叉熵减去信息熵,剩下的就是学生”多付的代价”。
物理含义(编码视角):假设数据真实由 P 生成,但你手里只有 Q 这张编码表。
– 用 Q 去编码,平均每个符号要花 H(P,Q) bit;
– 用上帝视角的真表 P 去编码,只需要 H(P) bit;
– 多花的 H(P,Q)-H(P) 就是 \mathrm{KL}(P\|Q) bit。
所以 KL 的官方读法就是:用分布 Q 去编码来自 P 的数据时,平均额外付出的比特数。这也顺带解释了两件事:
- \mathrm{KL}\ge 0 恒成立(多付的钱不可能为负),所以交叉熵 \ge 信息熵;当且仅当 P=Q 时 \mathrm{KL}=0,此时交叉熵恰好退化回信息熵。
- 当存在某个 x 使 Q(x)=0 而 P(x)>0 时,\log\frac{P}{Q}\to+\infty,KL 直接爆到正无穷,这是 KL 最实用的一个性质:一旦学生把老师认为有概率的类别判成绝对不可能(概率 0),惩罚是无穷大。工程上因此永远不直接输出”硬 0″,而是用 softmax 保证每个类别都有非零概率。
顺带补一个 PPT 没讲但常被连带问到的概念,互信息:它就是 KL 散度的一个特例,衡量两个变量”共享了多少信息”:
I(X;Y) = \mathrm{KL}\bigl(P(X,Y)\,\big\|\,P(X)P(Y)\bigr) = H(X) – H(X|Y) = H(X) + H(Y) – H(X,Y)
读法是”联合分布和’独立假设下应有的分布’之间的 KL 距离”,如果两个变量真的独立,P(X,Y)=P(X)P(Y),KL 为 0,也就是”一点信息都不共享”。互信息同样是对称的(I(X;Y)=I(Y;X)),这点和 KL 不同。
4.7 KL 不是距离(三条性质,必须能背)
| 性质 | 数学要求 | KL 是否满足 | 后果 |
|---|---|---|---|
| 非负性 | d(P,Q)\ge 0 | 是 | \mathrm{KL}\ge0,等于 0 当且仅当 P=Q |
| 对称性 | d(P,Q)=d(Q,P) | 否 | \mathrm{KL}(P\|Q)\ne\mathrm{KL}(Q\|P),必须写清方向 |
| 三角不等式 | d(P,R)\le d(P,Q)+d(Q,R) | 否 | 不能像欧氏距离那样做最近邻/聚类几何分析 |
| 有界性 | — | 否 | 可到 +\infty(见 4.6 节) |
所以中文里叫它”相对熵”或”KL 散度”,而不是”KL 距离”。\mathrm{KL}(P\|Q) 和 \mathrm{KL}(Q\|P) 的区别在蒸馏里是实打实的工程问题:前者(老师在前)叫 forward KL,性格是”老师有概率的地方,学生必须给概率”(回避型,会摊平分布、覆盖老师的所有可能性);后者叫 reverse KL,性格是”老师没概率的地方,学生别乱给概率”(聚焦型,倾向于只学准的模态、分布更尖锐)。蒸馏用的是 forward KL,这也解释了为什么学生会被迫把 0.1 这类”小概率类别”也学出来。
4.8 温度 T:让老师的软标签”软”得有道理
第 8~10 页把前面的数学接回蒸馏流程。
训练流程图(第 8~9 页):一份数据同时喂给两个模型,
- 学生模型(在用预测):拿数据集硬标签算
loss1; - 教师模型(训练好、
.eval()只是来预测):拿教师软标签算loss2; - 总损失
loss = loss1 + loss2→loss.backward()→optimizer.step()。
一句话总结 PPT 的批注:”既要模仿老师,又要学习数据集。” 第 9 页把数字写实了:学生预测 [0.3, 0.4, 0.3](猫/狗/兔),教师预测 [0.7, 0.2, 0.1](猫/狗/兔),数据集给的是硬标签 [1, 0, 0]。
温度在做什么(第 10 页):教师的原始 logits 先除以温度 T,再过 softmax:
P_i^{(T)} = \frac{e^{z_i/T}}{\sum_j e^{z_j/T}}
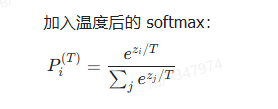
图注:原图是一个带中文小标题的公式图,标题为”加入温度后的 softmax:”,公式为 P_i^{(T)}=\dfrac{e^{z_i/T}}{\sum_j e^{z_j/T}},分子是第 i 个 logit 除以温度后的指数,分母是所有类别指数之和。这个 T 就是蒸馏里的温度系数,教师模型的输出必须先经过这一步”除以 T,再 softmax”才拿去做软标签。
PPT 用同一组 logits [0.7,\,0.2,\,0.1] 对比了两个温度:
T = 10(高温柔软):先除以 10 变成 [0.07,0.02,0.01],再 softmax:
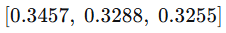
图注:原图是一个只含三个数字的横排向量框 [0.3457, 0.3288, 0.3255]。这就是 [0.07,0.02,0.01] 过 softmax 的结果(Python 实测完全吻合)。可以看到三个类别几乎被摊平了,分布变得非常”软”,PPT 把它拟人化成老师犹豫地说:”嗯…可能是猫,但也像某种狗… 要不你再看看他们之间区别?”
T = 0.1(低温生硬):先除以 0.1 把 logits 放大成 [7,2,1],再 softmax:
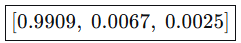
图注:原图是另一个横排数字框 [0.9909, 0.0067, 0.0025],即 [7,2,1] 过 softmax 的输出(Python 实测吻合)。第一类直接顶到 0.99 以上,几乎退化成硬标签,对应 PPT 的拟人化:”老师很激动地说:绝对是猫!别管什么其他的了。”
温度 T 控制的是”要学习多少类别之间的相对关系”。T 越大越犹豫、越软,类间关系的信息越丰富;T 越小越肯定、越硬(冻硬了),最后退化成 one-hot。PPT 明确给出:通常取 2。同时保留一句提醒,T 只是把老师的犹豫程度调出来了,学生在推理时依旧用 T=1。
4.9 KL 在代码里的落点:F.kl_div 的参数方向
前面全在讲数学,最后必须落到”动手怎么写”。PyTorch 的接口是:
import torch
import torch.nn.functional as F

def distillation_loss(student_logits, teacher_logits, labels,
                      T=2.0, alpha=0.7):
    # 1) 硬损失:学生 vs 数据集真实标签(交叉熵)
    hard_loss = F.cross_entropy(student_logits, labels)

    # 2) 软损失:学生 vs 教师软标签(KL 散度)
    #    教师:先除以 T 再 softmax,且不需要梯度
    with torch.no_grad():
        teacher_prob = F.softmax(teacher_logits / T, dim=-1)
    #    学生:用 log_softmax(数值稳定),同样除以 T
    student_logprob = F.log_softmax(student_logits / T, dim=-1)

    #    注意参数顺序:input=学生 log 概率,target=教师概率
    soft_loss = F.kl_div(student_logprob, teacher_prob, reduction='batchmean')

    # 3) 组合:软损失要乘 T*T 缩放(PPT 项目代码里的写法)
    return (1 - alpha) * hard_loss + alpha * (T * T) * soft_loss
三个必须记住的坑:
F.kl_div(input, target)的公式是target * (log(target) - input),所以:input必须传 log 概率(通常F.log_softmax的输出);target传概率(softmax的输出);- 整体算出来是 \mathrm{KL}(\text{target}\,\|\,\text{input}) = \mathrm{KL}(\text{教师}\|\text{学生}),教师在前、学生在后。这就是 4.2 节说的”教师从他的角度审视学生”,方向是对的。
reduction选batchmean:sum会随 batch size 放大损失,mean会随类别数缩小,都不好用;batchmean是 KL 语义下最常用的选项(分数维度上求和后除以 batch size 那一维)。log_softmax而不是log(softmax(x)):前者在数值上稳定得多,后者在 logits 较大时会直接溢出成-inf。同理,别对概率取log(0)。
动手验算方向(Python,以自然对数、与 PyTorch 同口径):
import math
# 按 PyTorch 文档公式复现 F.kl_div(input, target) = target * (log(target) - input)
def kl_div(input_logp, target, reduction='sum'):
    tot = sum(t * (math.log(t) - i) for i, t in zip(input_logp, target) if t > 0)
    if reduction == 'mean':
        tot /= len(target)
    return tot

P = [0.8, 0.2]   # 教师
Q = [0.5, 0.5]   # 学生

print(kl_div([math.log(x) for x in Q], P))   # 0.1927 = KL(P||Q),自然对数口径
print(kl_div([math.log(x) for x in P], Q))   # 0.2231 = KL(Q||P),明显不同 → 证明方向敏感

# 蒸馏软损失的标准写法(学生 log 概率 vs 教师概率)
s, t = [0.6, 0.3, 0.1], [0.7, 0.2, 0.1]
print(kl_div([math.log(x) for x in s], t))   # 0.02681
print(sum(ti * math.log(ti / si) for ti, si in zip(t, s))) # 0.02681 两法一致关于单位:同一个例子里,\log_2 口径下是 0.2781,\ln 口径下是 0.1927,两者只差一个 \ln 2\approx0.693 的倍数(0.2781\times0.6932=0.1928)。PyTorch 用自然对数,所以代码里看到的数值和手算 bit 数不一样,但优化方向完全一致(差常数倍不影响 argmin),被追问时能主动点出这一点很加分。
五、易错点与常见误解
常见说法:”KL 散度就是两个分布之间的距离”实际上,KL 是散度,不是度量(metric)。原因:它不对称(本文手算 0.2781 vs 0.3219)、不满足三角不等式、可以取到 +\infty。所以写公式时必须带方向 \mathrm{KL}(P\|Q),代码里 F.kl_div 两个参数也不能随意调换。
有人以为”log 的底数无所谓,反正是个常数”
实际上,底数决定单位。以 2 为底 → 单位 bit;以 e 为底 → 单位 nat(PyTorch 的口径);以 10 为底 → 单位 dit。PPT 也提醒了”计算机领域以 2 为底,数学领域以 10 为底”。底数不同只差常数倍数,优化等价,但报数时必须说清口径。
常听到的一种说法是:”交叉熵永远比信息熵大,肯定没问题”
其实成立,但有前提,不能有 P(x)>0 而 Q(x)=0 的类别。一旦出现,交叉熵直接爆到 +\infty,训练梯度就废了。所以模型输出必须走 softmax(保证处处非零),且不要手工把某些 logit 写成 -\infty。
容易想岔的地方:”蒸馏就是让学生模仿老师的预测,用什么都行,MSE 也行”
真实情况是,必须用 KL(交叉熵)的家族。因为学生输出的是概率分布,需要的是一个”分布之间差异”的度量,而 KL 正好是”用 Q 编码 P 的数据多付的 bit 数”这一有明确信息论含义的量;它天然按老师的重要度 P(x) 加权,并且对”比例上的错”敏感(4.2 节方案 3→4 的推导正是在解决这个问题)。另外 KL 配合 softmax 的梯度形式更干净:对 logits 求导就是”学生概率 − 教师概率”,而 MSE 作用在 softmax 之后会有梯度消失的区间。
先说一个误解:”温度 T 越低越好 / 越高越好”
事实正相反,T 是”软硬旋钮”,不是性能旋钮。T→ 很大时分布接近均匀(三个类别几乎一样,学不到东西);T→ 很小时退化成 one-hot(等于没用软标签)。PPT 给的常用值是 2;实践里通常在 1~10 之间小范围试。
常见说法:”温度只在训练用得上,学生推理时也要除 T”
实际上,推理时必须回到 T=1。温度是”提取教师知识”时用的工具,学生部署时就是普通的前向推理,输出走标准 softmax。
有人以为”软损失算出来就能直接和硬损失相加了”
其实软损失要乘 T^2。因为输出除以了 T,梯度大约会缩小 1/T^2 倍,乘回 T^2 才能让软损失和硬损失的梯度量级匹配(项目里的写法就是 alpha*(T*T)*soft_loss)。
常听到的一种说法是:”信息量是概率的线性函数,概率减半信息量减半”
真实情况是,信息量是 -\log P,对数关系。概率从 1 降到 0.5 加 1 bit,从 0.5 降到 0.25 又加 1 bit,从 0.01 掉到 0.005 也只加 1 bit,同样是”概率减半”,加的信息量恒定,但绝对概率越小,稀有事件的信息量越惊人(-\log_2 0.01 = 6.64 bit)。
六、横向对比与研究脉络
6.1 衡量”两个分布/向量差异”的方案对比
这就是 PPT 第 3 页四条方案的同框对比,再补上工程里常见的另外两个选择:
| 方案 | 公式 | 最小值 | 是否对称 | 对”比例错误”敏感 | 作为蒸馏损失的问题 |
|---|---|---|---|---|---|
| 绝对差(L1) | \sum_x \lvert P-Q\rvert | 0 | 是 | 否 | 不区分类别重要度,老师的主科和副科一视同仁 |
| 加权绝对差 | \sum_x P(x)\lvert P-Q\rvert | 0 | 否 | 否 | 加上了重要度,但”错一倍”和”错一点”仍被同样对待 |
| 加权比值 | \sum_x P(x)\frac{P}{Q} | 1(不是 0) | 否 | 是 | 最小值是 1 不符合损失约定;Q\to0 时爆炸 |
| KL 散度 | \sum_x P(x)\log\frac{P(x)}{Q(x)} | 0 | 否 | 是 | 就是标准答案:最小值归 0、log 压住爆炸、按老师重要度加权 |
| 交叉熵 | -\sum_x P\log Q | H(P) | 否 | 是 | 与 KL 只差一个常数 H(P),梯度完全等价 |
| JS 散度 | \frac{1}{2}\mathrm{KL}(P\|M)+\frac{1}{2}\mathrm{KL}(Q\|M),M=\frac{P+Q}{2} | 0 | 是 | 是 | 对称且有界([0,1] bit),但多算一个中间分布 M,蒸馏里没必要 |
| 互信息 | \mathrm{KL}(P(X,Y)\|P(X)P(Y)) | 0 | 是 | — | 衡量两个变量共享多少信息,不是两个分布的距离 |
一句话选择逻辑:要”不对称、带方向的分布差异”→ KL;要”对称有界、方便比较”→ JS;要”衡量变量间共享信息”→ 互信息。
6.2 演进脉络(只写有把握的部分)
- Shannon 1948《A Mathematical Theory of Communication》 建立信息论,给出”信息量 / 熵 = 用 bit 描述不确定性”的框架,PPT 里”一个 bit 表示两种可能性””用 log 数可能性”那套语言就来自这里。
- Kullback & Leibler 1951 提出 KL 散度(相对熵),把”两个分布的差异”从直观变成有信息论含义的量,PPT 项目笔记里明确记了”KL 散度 = 相对熵,Kullback & Leibler 1951 年提出”。
- 知识蒸馏:由 Hinton 等人提出(arXiv:1503.02531),核心贡献正是”用带温度 T 的软标签 + KL 散度让学生模型学到类间关系”,也就是本 PPT 第 8~10 页这套流程。
- 工程化落地:PyTorch 提供
F.kl_div,聚类式教学里形成固定写法loss = (1-alpha)*hard_loss + alpha*(T*T)*soft_loss(本季项目的蒸馏模块就用这一行)。
脉络上记住因果链即可:信息论给了”bit/熵”的语言 → KL 给了”分布差异”的度量 → 蒸馏把两者拼成一条可求导的软损失。
七、在新闻分类项目中的落地
位置:项目最后的模型压缩阶段,蒸馏(软标签蒸馏)模块。前面已经跑通了 TF-IDF + 随机森林 → FastText → BERT 微调 → LLM(DeepSeek API) 四级对比,蒸馏的作用是”把大模型的能力塞进小模型”,用 BERT(或更大的教师)当老师,去带一个更小的学生。
具体怎么接:
- 数据和模型:训练集 18w / 验证 1w / 测试 1w,格式
标题\t标签,10 个类别。教师模型model.eval()+torch.no_grad()只做推理,逐个 batch 产出 10 维软标签;学生每个 batch 同时拿硬标签(来自标题\t标签)和教师软标签。 - 损失:
loss = (1 - alpha) * hard_loss + alpha * (T * T) * soft_loss # hard_loss = F.cross_entropy(student_logits, labels) # soft_loss = F.kl_div(F.log_softmax(student_logits/T, dim=-1), # F.softmax(teacher_logits/T, dim=-1), # reduction='batchmean') - 关键参数怎么调:
- T 从 2 起手。新闻标题的类别混淆主要集中在”体育 vs 娱乐””财经 vs 科技”这类相邻类别上,PPT 说 T 控制”要学习多少类别之间的相对关系”,T 太小这些微弱关系就被压没了。若发现学生几乎只学到 top-1,就把 T 调到 4~6 试;若学生分布被摊平、准确率掉了,就降到 1.5 左右。
- alpha 起步 0.5~0.7。alpha 偏小(更重硬标签)→ 学生更像”直接训练的基线”;alpha 偏大 → 更依赖老师,教师本身弱的话会一起跑偏。教师必须确实比学生强(在这个项目里就是 BERT 带 FastText/小 BERT),否则蒸馏是负收益。
reduction='batchmean',别用默认值;T*T的缩放不要漏。- 实际会踩的坑:
- 忘了
teacher.eval()或忘了no_grad()→ 教师 BN/dropout 在训练态乱跳 + 显存翻倍 OOM(PPT 第 8/9 页特意标了.eval()只是来预测)。 F.kl_div参数写反、或忘了log_softmax→ 损失变成负的或 NaN。- 数据加载顺序不一致导致”学生看到第 i 个 batch 的输入、教师算的是另一个 batch” → 直接用同一次前向共享输入张量,别让两个模型各自
next(dataloader)。 - 硬 0:如果教师某些类别概率算出来是极小值,配合 KL 的 +\infty 特性容易炸梯度,用 softmax(而非手工截断为 0)保住非零。
- 和其它压缩手段怎么配合:蒸馏、量化(QAT/PTQ/动态量化
torch.quantization.quantize_dynamic())、剪枝(torch.nn.utils.prune.global_unstructured())、低秩分解可以叠加。推荐顺序是先蒸馏把”学到的知识”灌进去,再量化/剪枝把体积压下来;反过来的话,剪枝/量化会把软标签阶段需要的精细概率分布弄毛(量化误差正好打在那些 0.05、0.1 的小概率上,而它们正好是 KL 里”类间关系”的载体)。这也是为什么软标签里的 0.1 比 0 值钱,量化和剪枝最该保的正是这些小数。
讲解/简历里怎么讲这一段:不要只说”我做了蒸馏”,要说”我用带温度 2 的软标签蒸馏,把损失写成 hard_loss + T²·KL(教师‖学生),用 BERT 带小模型,因为 KL 按教师视角加权的特性保留了体育/娱乐这类易混类别的类间关系,蒸馏后的学生比同尺寸直接训练的模型准确率更高”。
八、重点问答
Q1:KL 散度是什么?为什么说它不是”距离”?
A:KL 散度也叫相对熵,衡量的是”用分布 Q 去编码来自 P 的数据时平均多付出多少比特”,公式是 \sum_x P(x)\log\frac{P(x)}{Q(x)},P=Q 时为 0。它不是距离,三个原因:一是不对称,我手算过 P=[0.8,0.2]、Q=[0.5,0.5] 时 \mathrm{KL}(P\|Q)=0.2781、\mathrm{KL}(Q\|P)=0.3219,两个数不相等,所以必须写清方向;二是不满足三角不等式;三是它可以取到正无穷,比如老师认为某个类别有概率、学生给了 0。所以中文叫”散度”而不是”距离”。
Q2:交叉熵、信息熵、KL 散度三者的关系?
A:一句话,交叉熵 = 信息熵 + KL 散度。信息熵 H(P)=-\sum P\log P 是真实世界自身的平均信息量,是描述这个世界的代价下限;交叉熵 H(P,Q)=-\sum P\log Q 用真实概率乘以我(错误分布 Q)的信息量,是”用错的编码表去编码”的代价;两者相减,剩下的就是白多付的钱,也就是 KL。我的例子是 P=[0.8,0.2]、Q=[0.5,0.5]:H(P)=0.7219,交叉熵是 1.0,1.0-0.7219=0.2781,和直接算 KL 完全一致。所以交叉熵恒大于等于信息熵,因为多付的钱不可能为负。
Q3:信息量为什么是 -\log 概率?
A:从”要几个 bit 记下来”推出来的。一件事有 2 种可能,需要 \log_2 2=1 个 bit;4 种可能需要 \log_2 4=2 个 bit。而”挑中一次需要的次数”正好是概率的倒数,所以 -\log(\text{概率})=-\log(1/\text{次数})=\log(\text{次数})。结论就是概率越低信息量越大:太阳照常升起概率 0.99,信息量只有 0.015 bit;太阳灭了概率 0.01,信息量高达 6.64 bit。而且它是对数关系不是线性翻倍,概率每次减半就加 1 bit,但越稀有的事件信息量绝对值越吓人。
Q4:蒸馏的软损失为什么用 KL,不用 MSE?
A:因为学生输出的是一整个概率分布,需要的是一个”衡量分布差异”的量。PPT 里有个很漂亮的推导:先试绝对差,发现不区分类别重要度;再按老师的重要度加权,发现体现不出”错了一倍”这种比例错误;换成除法,最小值又变成 1(不是 0)而且分母小了会爆炸;最后套上 log,才同时满足”最小值归 0″”压住数值爆炸””按老师视角加权”这三条,这就是 KL。另外 KL 的梯度形式也友好,对 logits 求导就是”学生概率减教师概率”,而 MSE 套在 softmax 之后会有梯度饱和区。
Q5:F.kl_div 怎么用?参数顺序是什么?
A:公式是 target * (log(target) - input),所以 input 必须传对数概率(一般用 F.log_softmax,别用 log(softmax(x)) 会数值不稳甚至 -inf),target 传概率(F.softmax 的输出)。整体算出来是”教师在前、学生在后”的 KL,方向正好符合”老师审视学生”的语义。reduction 我一般选 batchmean,sum 会随 batch 放大、mean 会随类别数缩小。写反或者忘了 log_softmax,损失会直接变负或者 NaN。
Q6:温度 T 是干什么的?为什么损失还要乘 T^2?
A:T 控制老师软标签的”软硬程度”。教师 logits 先除以 T 再 softmax:T 大(比如 10)分布被摊平,[0.7,0.2,0.1] 变成 [0.3457,0.3288,0.3255],类别之间的相对关系更丰富;T 小(比如 0.1)相当于把 logits 放大成 [7,2,1],输出 [0.9909,0.0067,0.0025],几乎退化成硬标签。实践里通常取 2。至于 T^2:因为输出除了 T,梯度大约被缩小了 1/T^2 倍,乘回 T^2 才能让软损失和硬损失的梯度量级匹配,不然调整 T 的时候 alpha 也得跟着重调,没法用。
Q7:为什么蒸馏里的 KL 要”教师在前、学生在后”?方向换过来会怎样?
A:\mathrm{KL}(\text{教师}\|\text{学生}) 是 forward KL,它的性格是”老师认为有概率的地方,学生必须也得给概率”,会逼学生把老师那些 0.1、0.2 的小概率类别也学出来,这就是我们想要的类间关系。换成 \mathrm{KL}(\text{学生}\|\text{教师}) 是 reverse KL,性格是”老师没概率的地方学生别乱给”,倾向于只学最准的模态、分布更尖锐,会丢掉”老师犹豫的那部分”。所以方向不能反。
Q8:交叉熵损失和 KL 散度损失有什么区别?
A:在同一个 P 下,两者只差一个常数 H(P):\mathrm{KL}(P\|Q)=H(P,Q)-H(P)。因为 H(P) 不依赖被优化的模型参数,梯度完全一样,所以直接拿交叉熵当损失(比如 F.cross_entropy)和算 KL 是等价的。但蒸馏场景里必须用 KL:那时候”P”是教师模型的输出,学生不能去优化教师,我们要的是”迫使两者靠拢”,KL 的”差异”语义更直接,也方便和硬损失加权相加。
九、延伸阅读
- Shannon, C. E. (1948), A Mathematical Theory of Communication — 信息论的起点,bit、熵、编码代价这套语言都出自这里。
- Kullback, S. & Leibler, R. A. (1951), On Information and Sufficiency, Annals of Mathematical Statistics — KL 散度(相对熵)的原始出处。
- Hinton, G., Vinyals, O. & Dean, J., Distilling the Knowledge in a Neural Network(arXiv:1503.02531) — 带温度软标签 + KL 的标准蒸馏配方,对应本 PPT 第 8~10 页。
- PyTorch 官方文档
torch.nn.functional.kl_div— 查参数方向与reduction语义的第一手依据(公式target * (log(target) - input)就写在文档里)。 - PyTorch 官方文档
torch.nn.functional.cross_entropy/log_softmax— 对照理解”交叉熵 = 熵 + KL”以及为什么要用log_softmax。 - Chris Olah, Visual Information Theory(colah’s blog) — 用”编码/长度”的图解方式讲熵、交叉熵、KL,很适合把第 5~7 页的直觉再固化一遍。
- Desmos 在线绘图工具(PPT 第 2 页那张 \log_2 x 曲线就是 Desmos 截的)— 自己拖一下 y=\log_2 x,看它在 x\to0^+ 的陡降和 x 增大后的平缓。