从「一层 RNN 的隐状态递推」出发,把参数共享、时间展开、BPTT 梯度连乘这条主线讲透,再用门控(LSTM 三门一状态、GRU 两门一状态)补上长依赖这个窟窿,最后落在「RNN 系列天生不可并行」这个致命短板上,也就是 Transformer 出现的理由。
一、这份材料解决什么问题
前一站(day01/day02)把文本变成了离散符号:词表、索引、one-hot 或词向量。但词袋类的表示有同一个病根,它把序列当成一个集合。”我爱你” 和 “你爱我” 的词袋一模一样;TF-IDF + 随机森林 / FastText 处理新闻标题分类时,模型的输入里没有词序。
RNN 要回答的问题是:怎么让网络按顺序读,并把「读到第 3 个词时还记得第 1 个词」这件事变成可学习的东西?
答案就一个动作,把上一时刻算出来的隐藏状态 h_{t-1} 和当前输入 x_t 拼起来,过同样的那层网络,得到 h_t,再喂给下一时刻。它的三个直接后果构成了整份材料的骨架:
| 后果 | 好处 | 代价 |
|---|---|---|
| 同一组权重在每个时间步复用(参数共享) | 能处理任意长度序列,参数量与序列长度无关 | 序列越长,反传路径越长 |
| 信息靠 h_t 一路”手递手”传 | 有记忆,理论上能建模任意阶依赖 | 传递路径上梯度反复相乘 → 消失/爆炸 |
| 第 t 步必须等第 t-1 步算完 | 顺序建模天经地义 | 不能并行,这是被 Transformer 取代的根本原因 |
为什么 LLM 应用工程师要补它:① 被追问时「RNN 为什么被 Transformer 取代」「LSTM 三个门」「GRU 和 LSTM 区别」是高频必答;② 现在读 BERT / GPT 代码时的张量思维(batch / seq_len / hidden 三个轴怎么摆、output 与 hn 谁是谁)就是在这份材料里练出来的;③ 第七节会说明,在新闻分类项目里 LSTM 是被跳过但必须能讲清为什么被跳过的方案。
二、核心结论
- RNN 的全部定义就是一条递推式:h_t=\tanh(W_{ih}x_t+W_{hh}h_{t-1}+b)。所谓”记忆”不是额外的存储,而是 h_{t-1} 参与了 h_t 的计算:把手算例子摊开看,t=2 的那一步里 x_1 的贡献(0.5\times0.4621=0.2311)确实混进了 z_2。
- “时间展开”不是”多层堆叠”。展开图里同一层被画成 T 个方块,但它们共享同一组 W、b,参数量与
seq_len完全无关;num_layers=2才是真的两套参数。这两件事的形状差异在 PyTorch 里能一眼看出来(见 §5 易错点 3)。 - BPTT 的梯度是连乘:\prod_t (\sigma'(z_t)\cdot W)。\tanh’ \le 1 恒成立,所以 |W_h|<1 时连乘必然衰减,本报告的手算例子中,三步连乘从 0.7864 掉到 0.1304,而把序列拉到 20 步只剩 4.3\times10^{-5}。这就是”学不到长期依赖”的数学原因。
- LSTM 的关键不是”三个门”,是细胞状态那条加性通路:C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t,C_t 对 C_{t-1} 的偏导就是门值 f_t 本身(不是矩阵 W 的连乘)。当 f_t\approx1,梯度几乎无损地穿过整条时间链,所以是缓解梯度消失,不是消灭它(f_t 还是由 \sigma 算出来的,仍是 <1 的数)。
- RNN 系列的共同硬伤是不可并行:L 个时间步是 L 次串行依赖,GPU 只能并行 batch 维。Transformer 的串行深度是 O(1),这就是”为什么用 BERT 不用 LSTM”的工程答案。GRU 比 LSTM 少一个门、参数量约 3/4,但两者都不解决并行问题。
三、知识地图
按原材料 7 节整理,权重列取自各节「学习目标」与代码注释里的”需要掌握的”字样(原件对 API 细节一律标注为”无 / 建议重点了解”,权重主要由本报告按评定口径补标)。
| # | 小节 | 内容要点 | 权重 |
|---|---|---|---|
| 1 | 认识 RNN 模型 | RNN 定义(循环计算隐藏状态)、完整结构三件套(词嵌入层 + RNN 层 + 输出层)、应用领域、按输入输出分类 | 掌握分类轴 |
| 1.3 | 按输入–输出结构分类 | N→N(序列标注)/ N→1(文本分类)/ 1→N(看图说话)/ N→M(Seq2Seq,最常用) | 掌握 |
| 1.3 | 按内部结构分类 | 传统 RNN / LSTM·Bi-LSTM / GRU·Bi-GRU | 掌握 |
| 2 | 传统 RNN | 内部结构图、拼接→全连接→tanh、h_t 公式、tanh 作用、nn.RNN 形状规则 |
掌握公式与形状 |
| 2.2 | day03_04 演示 | nn.RNN 四个 demo:单层 / batch / 多层 / 双向,看 output、hn 形状 |
理解 |
| 2.3 | 优缺点 | 简单快 / 长序列差;梯度消失与爆炸(BPTT 雅可比连乘) | 掌握 |
| 3 | LSTM | 四部分:遗忘门、输入门、细胞状态、输出门;每个部件的结构图 + 公式 + GIF 演示;Bi-LSTM | 掌握 |
| 3.3 | day03_05 演示 | nn.LSTM 的输入 (x,(h_0,c_0))、输出 \big(output,(h_n,c_n)\big)、双向后维度翻倍 |
理解 |
| 4 | GRU | 三个部分:重置门、更新门、隐藏状态;四步计算;Bi-GRU;nn.GRU |
掌握公式与选型 |
| 4.3 | 总结表 | RNN / LSTM / GRU 在核心原理、内部状态、API、输入输出形状、优缺点上的横向对比 | 掌握 |
| 5 | 扩展案例:人名分类器 | 数据格式、one-hot(全课程唯一一次)、Dataset/DataLoader、三个模型统一训练、预测 top-k | 理解流程 |
| 6 | LogSoftmax | nn.LogSoftmax = softmax + log,与 CrossEntropyLoss 内含 softmax 的关系 |
了解 |
| 7 | 常见高频题 | RNN 状态更新公式 / 梯度消失成因与解法 / LSTM 三门 / GRU 与 LSTM 差异 | 掌握 |
| 8 | 代码作业 | nn.LSTM 形状验证(4,10,16→(4,10,32))、双向 GRU 输出(4,8,128) |
理解 |
四、原理详解
4.1 一个完整的 RNN 网络长什么样
原材料把 RNN 网络拆成三件套:词嵌入层(离散词索引 → 连续向量)→ RNN 层(按时间步生成隐藏状态)→ 输出层(按任务接全连接 + Sigmoid/Softmax)。注意:课堂上演示的 nn.RNN(...) 只是其中的 RNN 层,不是整个网络。
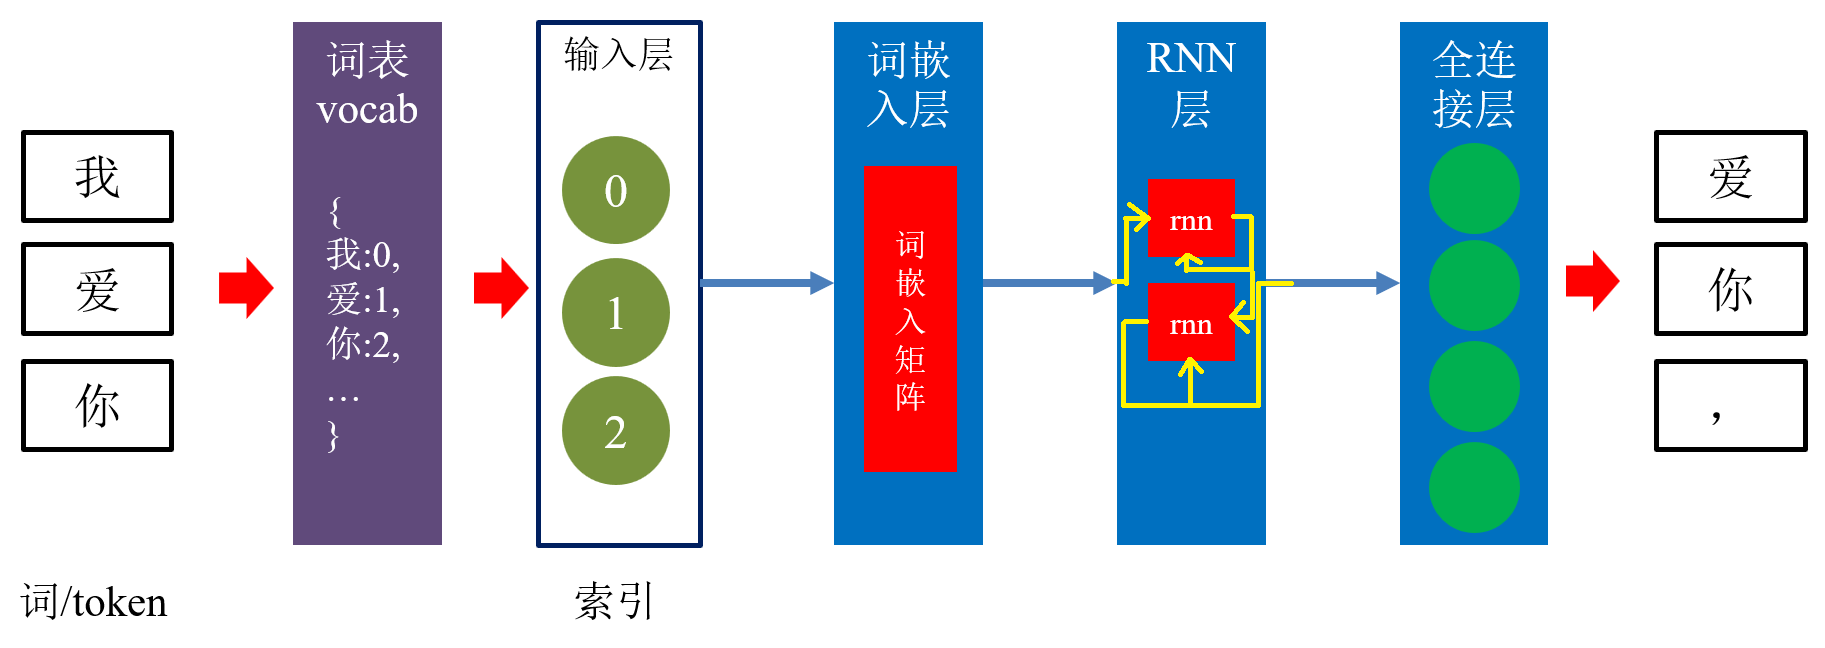
图注:图从最左边开始,输入文本是「我 爱 你」三个框,箭头指向紫底方框「词表 vocab」,里面写着 {我:0, 爱:1, 你:2, …};再指向「输入层」,画成三个胶囊形状的索引 0 / 1 / 2;再指向「词嵌入层」,是一根竖着的红色长条,标注词嵌入矩阵;接着进入蓝色区域「RNN 层」,里面画了上下两个 rnn 红色方块,中间有一对黄色循环箭头(这就是”循环”的视觉表达:两个方块之间来回传递状态);向右是「全连接层」一列绿点;最右输出框里是「爱 你,」。整个流程用”红色粗箭头 = 数据流、蓝色细箭头 = 层内/层间连接”区分;注意输入「我 爱 你」和输出「爱 你,」错开了一位,正是一个”预测下一个词”的训练样本示意。
4.2 单层 RNN 的内部结构:拼接 → 全连接 → tanh
中间那个方块的输入有两部分:上一时间步的隐藏状态 h^{(t-1)} 和当前时间步的输入表示 x^{(t)}(通常是词向量)。两者先拼接成新张量 [x^{(t)},h^{(t-1)}],过一个全连接层,再过 \tanh 激活,得到 h^{(t)},交给下一个时间步。如此循环。
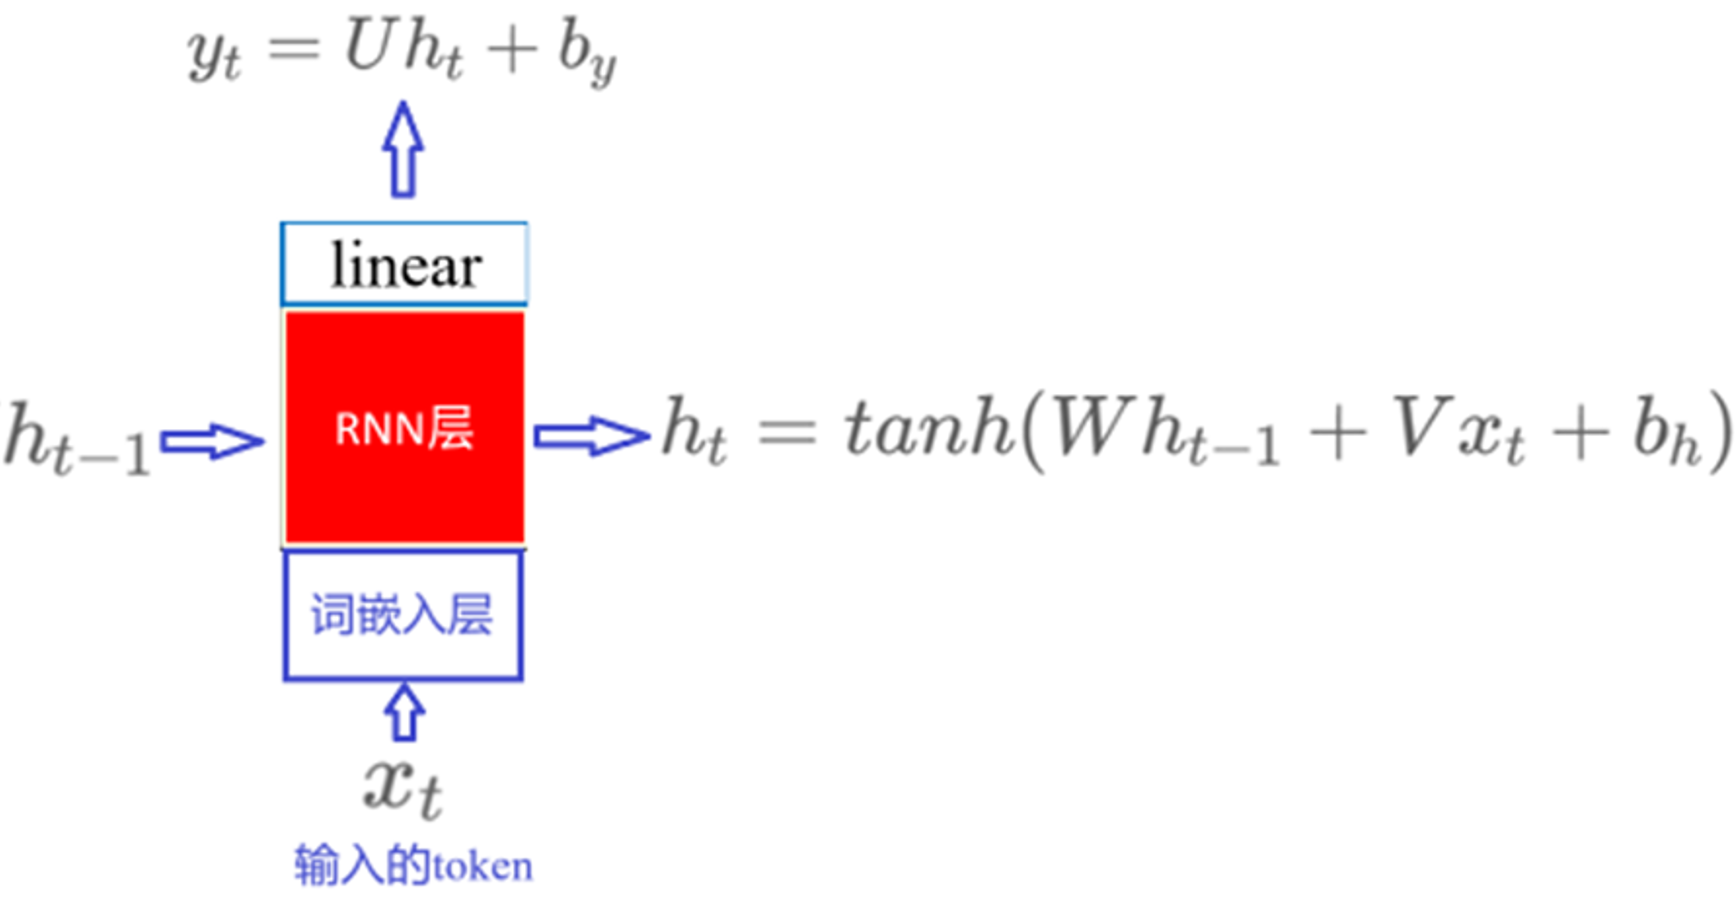
图注:单层 RNN 计算模型示意图,标出当前时间步的两个输入(上一时间步输出/隐藏状态、当前时间步输入)与输出(当前时间步隐藏状态),是上图和下面展开图之间的过渡。
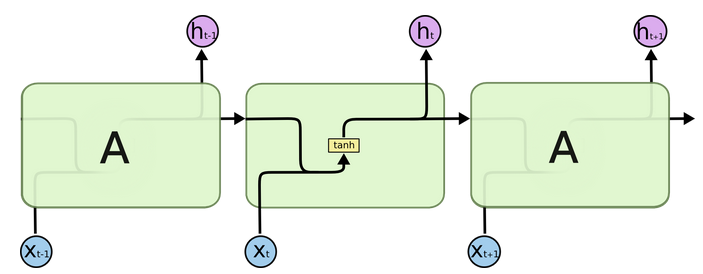
图注:三个标着 A 的方块从左到右排开,是同一层 RNN 在 t-1,\ t,\ t+1 三个时刻的”展开”。每个 A 下方是一个蓝色的输入圆点,标注 x_{t-1}、x_t、x_{t+1};上方是一个紫色的输出圆点,标注 h_{t-1}、h_t、h_{t+1}。A 之间有水平箭头相连,这就是隐藏状态在时间步之间的传递方向。中间那个 A 被画开来看:从左侧进来的水平箭头(h_{t-1})与从下方竖着进来的箭头(x_t)先汇合,再一起穿过一个标着 tanh 的方框,输出一个箭头向上(得到 h_t)、另一个箭头向右(交给下一个 A)。这就是 h_t=\tanh(W[x_t,h_{t-1}]+b) 的图形化翻译。
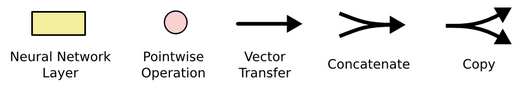
图注:这套结构图的图例(出自 Chris Olah 讲解 LSTM 的博客,第 3、4 节共用):黄色矩形 = Neural Network Layer(带参数的神经网络层,如全连接/sigmoid/tanh 层);粉色圆圈 = Pointwise Operation(逐元素运算,如 ⊗ 乘、⊕ 加);实心箭头 = Vector Transfer(整条向量在这条线上流动);两条线并一条 = Concatenate(拼接);一条线分两条 = Copy(复制,同一份数据分别送往两个去处)。看后面 LSTM 图时,凡是”线上没有方框”的地方就只是把向量原样搬过去,没有额外参数。
内部计算公式(原材料写法):
h_t=\tanh\big(W_t[X_t,h_{t-1}]+b_t\big)
第 7 节给出的等价写法是 h_t=f(W_{xh}x_t+W_{hh}h_{t-1}+b),输出 y_t=g(W_{hy}h_t)。两者是同一件事:拼接矩阵乘 W[x_t,h_{t-1}] 与分开的两个矩阵乘 W_{xh}x_t+W_{hh}h_{t-1} 完全等价,可以互相转换。tanh 的作用是把流经网络的值压缩到 (-1,1),调节数值范围。
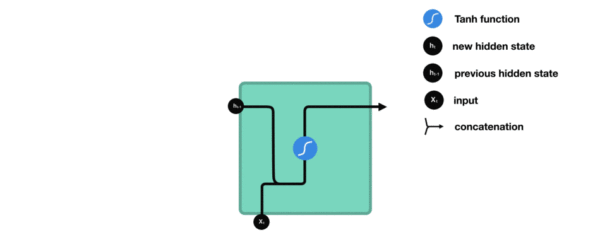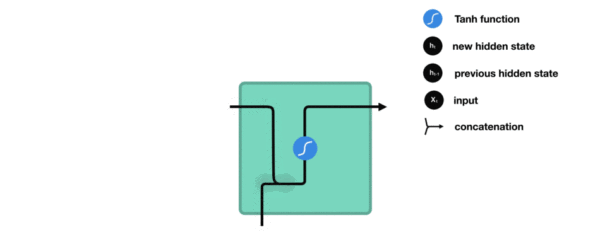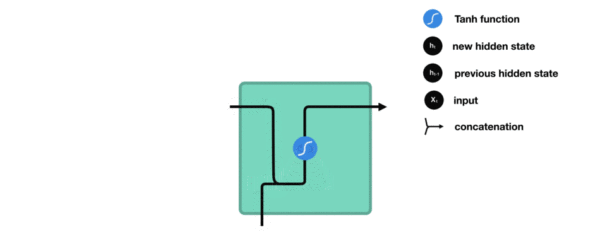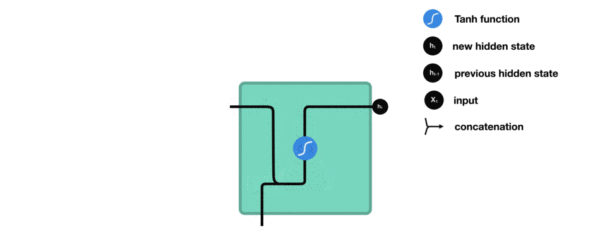
图注:动画逐帧展示 [x^{(t)},h^{(t-1)}] 如何拼接、进全连接层、再由 tanh 得到 h^{(t)}。动图无法在静态报告中呈现,请回原文件查看。
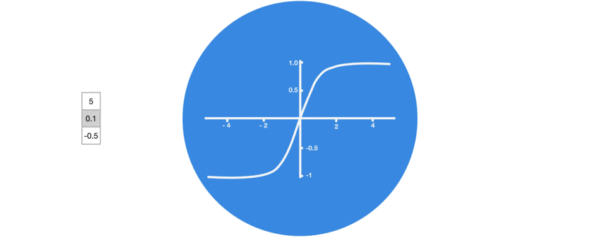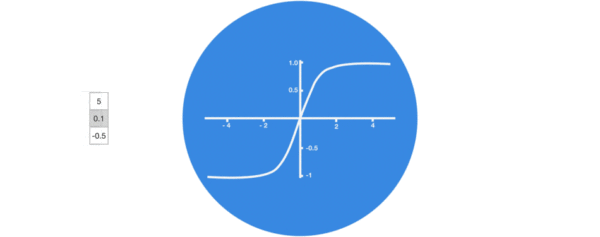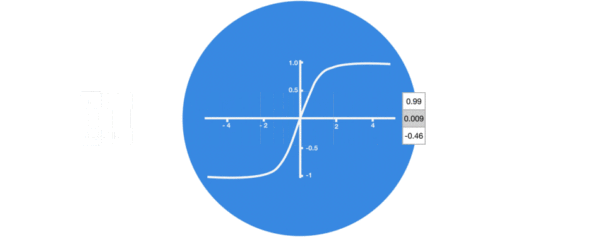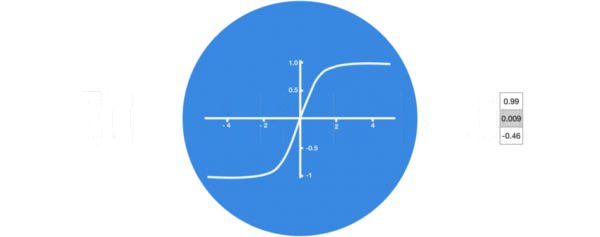
图注:动画演示 tanh 把任意大小的输入压缩进 (-1,1) 区间。
手算例子①:1 维隐状态、三个时间步(重点)
把维度压到最低,所有数字都能纸笔算。设:
- 隐状态维度 H=1,输入维度也是 1;
- W_{xh}=0.5,W_{hh}=1.0,b=0,初始隐藏状态 h_0=0;
- 输入序列 x=[1.0,\ 2.0,\ -1.0](三个时间步)。
递推式:z_t=W_{xh}x_t+W_{hh}h_{t-1}+b,h_t=\tanh(z_t)。
| t | x_t | W_{xh}x_t | W_{hh}h_{t-1} | z_t | h_t=\tanh(z_t) |
|---|---|---|---|---|---|
| 1 | 1.0 | 0.5\times1.0=0.5 | 1.0\times0=0 | 0.5 | \tanh(0.5)=0.4621 |
| 2 | 2.0 | 0.5\times2.0=1.0 | 1.0\times0.4621=0.4621 | 1.4621 | \tanh(1.4621)=0.8981 |
| 3 | −1.0 | 0.5\times(-1.0)=-0.5 | 1.0\times0.8981=0.8981 | 0.3981 | \tanh(0.3981)=0.3783 |
三件必须从这张表里读出来的事:
- 参数共享看得见:三步用的是同一个 0.5 和同一个 1.0,没有 t=1 专用的权重。
- 记忆是”混进去”的:t=2 的 z_2=1.4621 里,只有 1.0 来自当前词 x_2,另外 0.4621 来自 h_1,而 h_1 完全由 x_1 决定。所以 x_1 对 t=2 的影响是 0.5\times0.4621=0.2311,这就是”读第二个词时还记得第一个词”。
- 拼接等价:如果写成 W[x_t,h_{t-1}] 的形式,令 W=[0.5,\ 1.0],则 t=2 时 W[x_2,h_1]=0.5\times2.0+1.0\times0.4621=1.4621,与上表的 z_2 一模一样。
4.3 时间展开 ≠ 多层堆叠
这是本份材料最容易混的一处,也是常被问。
时间展开(unrolling):把同一个 RNN 层在 t=1..T 的计算”摊平”画出来,看起来像 T 层深的前馈网络。但它只有一组参数,反传时梯度要按时间步累加到同一份 W 上:
\frac{\partial L}{\partial W}=\sum_{t=1}^{T}\frac{\partial L_t}{\partial W}
多层堆叠(num_layers=2):真的有两组独立参数,第 2 层在第 t 步的输入是第 1 层在第 t 步的输出。
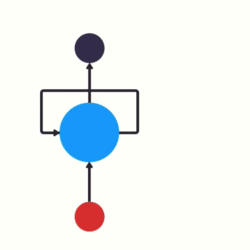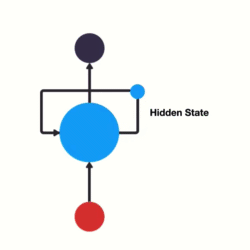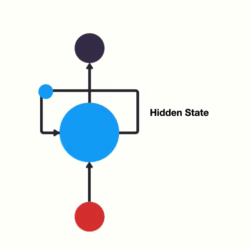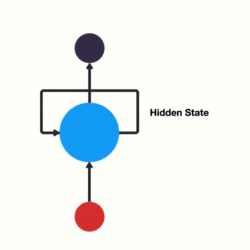
图注:单层 RNN 的”循环”画法,隐藏状态 h 从输出绕回输入端,与下一时间步的输入一起进入同一个网络层(GIF 动画,见原文件)。
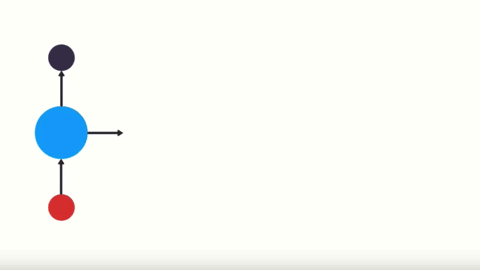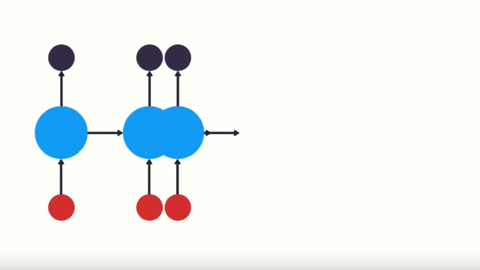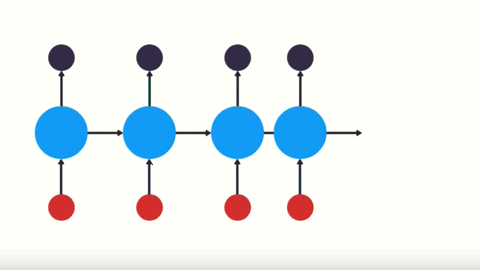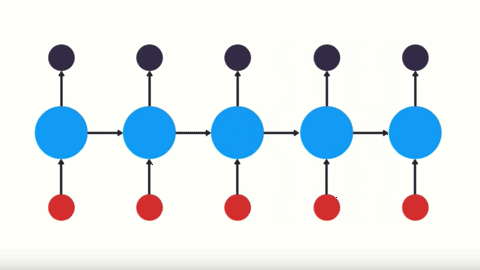
图注:把上图按时间步摊开得到的展开画法:同一个 RNN 层被复制成 T 份,横向箭头表示隐藏状态 h 从上一时间步流向下一时间步(GIF 动画,见原文件)。注意所有副本共享同一组参数,”展开”只是画法,不是新层。
参数量对比(input_size=10、hidden_size=8、PyTorch 的 nn.RNN 参数布局是 W_{ih}(8\times10)、W_{hh}(8\times8)、b_{ih}(8)、b_{hh}(8),故 2\times(HI+H^2+H)=304):
| 配置 | 参数量 | output 形状(batch_first=True) |
hn 形状 |
|---|---|---|---|
num_layers=1, seq_len=3 |
304 | (1, 3, 8) |
(1, 1, 8) |
num_layers=1, seq_len=6 |
304(不变) | (4, 6, 8) |
(1, 4, 8) |
num_layers=2, seq_len=6 |
608 | (4, 6, 8) |
(2, 4, 8) |
num_layers=2, bidirectional=True, seq_len=6 |
1216 | (4, 6, 16) |
(4, 4, 8) |
这张表全部来自原材料 day03_04_演示传统的RNN 四个 demo 的实际打印结果。两个反直觉点:seq_len 从 3 变到 6,参数量一点没变;num_layers 从 1 变到 2,output 的最后一维仍然是 8(只有双向的 num_directions 才会把它翻倍成 16)。
4.4 按输入–输出结构分类
| 类型 | 结构 | 实现方式 | 典型应用 | 原图 |
|---|---|---|---|---|
| N→N | 等长,一一对应 | 每个时间步都出结果 | 词性标注、命名实体识别、等长文本生成(合辙诗句) | 10.png |
| N→1 | 序列→单值 | 取最后一个时间步的隐藏状态 h_T,接全连接 + Sigmoid/Softmax | 文本分类、情感分析、意图识别 | 011.png |
| 1→N | 单向量→序列 | 把该向量作为每个时间步的条件信息 | 图像生成文字(Image Caption) | 012.png |
| N→M | 不等长,最常用 | 编码器把输入压成上下文表示 c,解码器每步用 c 生成输出 → Seq2Seq | 机器翻译、文本摘要、阅读理解 | RNN15.png |
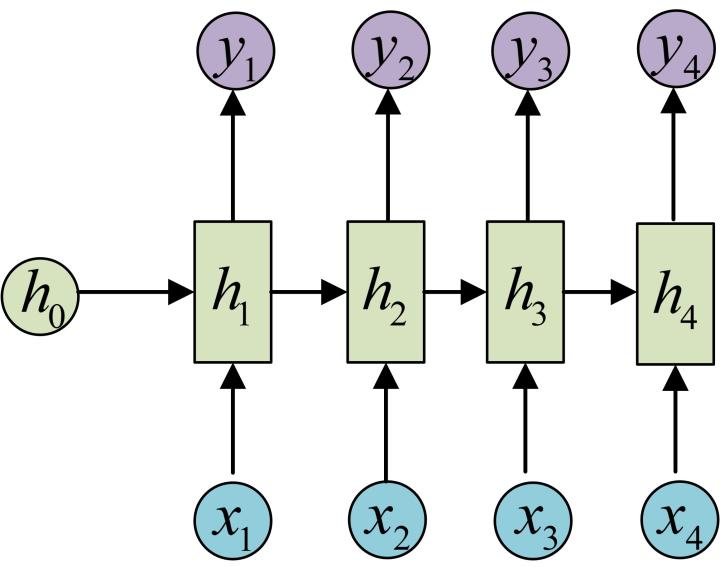
图注:N→N 结构示意图,输入与输出序列长度相同、逐位置对应。
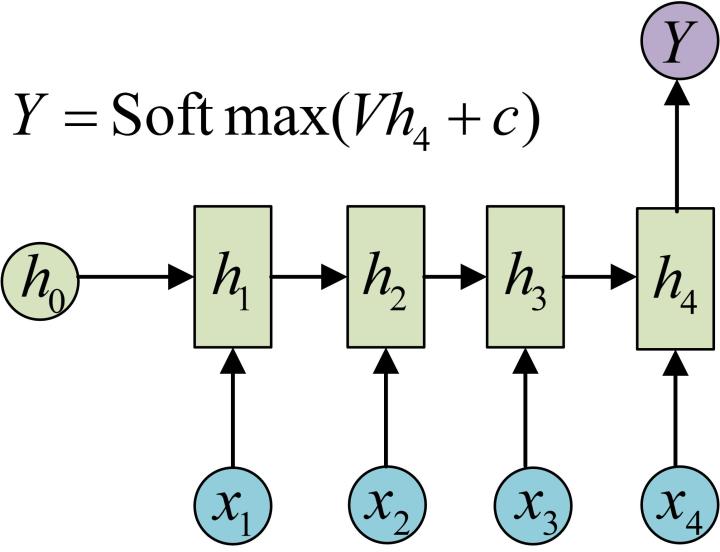
图注:N→1 结构示意图,整条序列只产出一个输出(取末时间步隐藏状态后接输出层)。文本分类走的就是这条路。
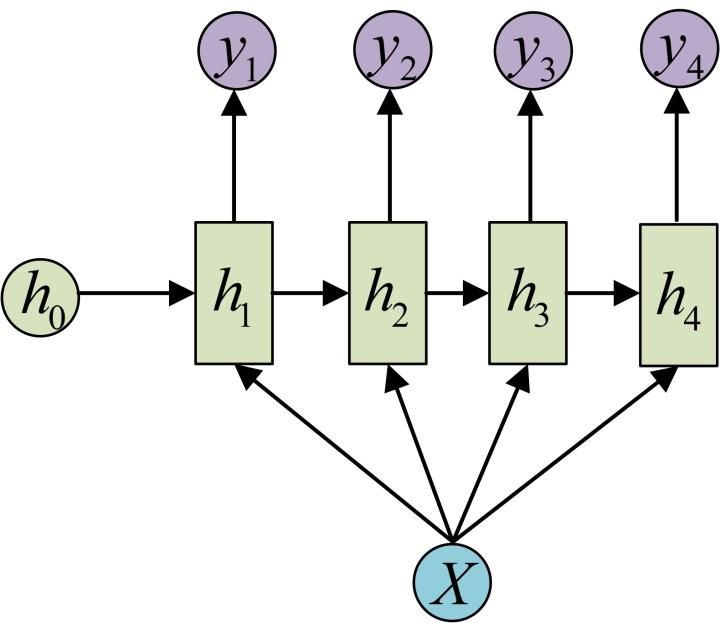
图注:1→N 结构示意图,一个固定向量在每个时间步都作为条件输入。
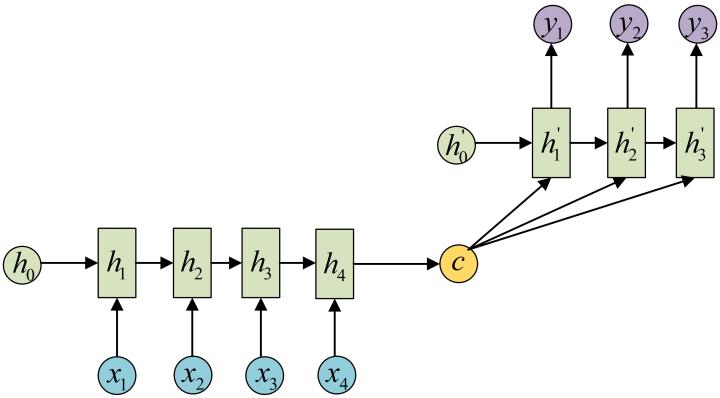
图注:N→M(Seq2Seq)结构示意图,Encoder 把输入序列压成上下文表示 c,Decoder 在每个时间步利用 c 生成输出序列。
4.5 深层 RNN 与 BiRNN:只看形状就够
- 深层(
num_layers=n):把 RNN 层叠 n 次,第 k 层每个时间步的输出作为第 k+1 层同时间步的输入。hn的第 0 轴从num_layers*num_directions体现出来。 - 双向(
bidirectional=True):不改变内部结构,把同一层沿序列正方向和反方向各跑一遍,两个方向的输出在最后一维拼接,因此output的最后一维变成hidden_size*num_directions;hn的 0 轴也翻倍。它能让每个位置的表示同时看到”前文”和”后文”。
形状规则(batch_first=True,B=batch,L=seq_len,H=hidden_size,D=num_directions):
\text{input}:(B,L,\text{input\_size}),\quad h_0:(num\_layers\times D,B,H)
\text{output}:(B,L,H\times D),\quad h_n:(num\_layers\times D,B,H)
原材料作业的实测结果可以作为自检标准:nn.LSTM(input_size=16, hidden_size=32, num_layers=2) 吃 (4,10,16) → output (4,10,32)、h_n (2,4,32)、c_n (2,4,32);nn.GRU(input_size=32, hidden_size=64, bidirectional=True) 吃 (4,8,32) → output (4,8,128)、h_n (2,4,64)。
# 双向 LSTM:形状是自检代码的第一道关
import torch, torch.nn as nn
lstm = nn.LSTM(input_size=16, hidden_size=32, num_layers=2, batch_first=True)
x = torch.randn(4, 10, 16)                  # (batch_size, seq_len, input_size)
output, (h_n, c_n) = lstm(x)                # h0/c0 省略时默认为全零
print(output.shape)   # torch.Size([4, 10, 32])  所有时间步、最后一层、两方向拼接后的结果
print(h_n.shape)      # torch.Size([2, 4, 32])   num_layers=2 × batch=4 × hidden=32
print(c_n.shape)      # torch.Size([2, 4, 32])
4.6 BPTT:梯度为什么会消失/爆炸
时间维度上的反向传播(BPTT,Backpropagation Through Time)里,损失对早期隐藏状态的梯度是多个时间步雅可比矩阵的连乘,形式上可简化为:
\frac{\partial L}{\partial h_0}\approx\prod_{t=1}^{T}\Big(\sigma'(z_t)\cdot W\Big)
其中 \sigma(\cdot) 通常是 tanh 或 sigmoid,其导数小于 1(\tanh'(z)=1-\tanh^2(z)\le1,\text{sigmoid}’=\sigma(1-\sigma)\le0.25),W 是循环权重矩阵。于是:
- 连乘结果范数逐步变小 → 梯度消失:参数更新缓慢甚至停滞,模型学不到长期依赖;
- 连乘结果范数逐步变大 → 梯度爆炸:更新过大、训练不稳定,可能数值溢出出 NaN。
手算例子②:把上面的例子摊开,看梯度怎么连乘
用【手算例子①】的设定(W_{xh}=0.5、b=0、x=[1,2,-1]),只把 W_{hh} 换成 0.5 / 1.0 / 2.0,逐时间步算 \tanh'(z_t)\cdot W_{hh} 并累乘:
| W_{hh} | t=1:z_1 / \tanh’ / 累计 | t=2:z_2 / \tanh’ / 累计 | t=3:z_3 / \tanh’ / 累计 |
|---|---|---|---|
| 0.5 | 0.5 / 0.7864 / 0.3932 | 1.2311 / 0.2895 / 0.0569 | −0.0786 / 0.9939 / 0.0283 |
| 1.0 | 0.5 / 0.7864 / 0.7864 | 1.4621 / 0.1935 / 0.1522 | 0.3981 / 0.8569 / 0.1304 |
| 2.0 | 0.5 / 0.7864 / 1.5729 | 1.9242 / 0.0817 / 0.2571 | 1.4165 / 0.2099 / 0.1079 |
三个读法:
- W_{hh}=1.0 时,三步之后梯度已经衰减到 0.13,只剩第一步的 1/6。三步就把 6 倍的信息量吃掉了。
- 把序列拉长到 20 步(每步输入固定为 0.3,避免早期饱和):W_{hh}=0.5 → 累计 \prod\approx2.0\times10^{-7};W_{hh}=1.0 → 4.3\times10^{-5};W_{hh}=2.0 → 1.4\times10^{-15}。这就是”20 步之外的依赖学不到”的全部含义,梯度小到浮点数都表示不出来。
- W_{hh}=2.0 那一行还揭示了一个细节:t=1 的累计是 1.57 > 1(在放大),但到 t=2 立刻掉到 0.26。原因是 \tanh 饱和,z_2=1.92 时 \tanh’ 已经只有 0.08。所以梯度爆炸往往出现在序列前段或激活不饱和时(例如换成线性激活/ReLU),而梯度消失才是 RNN 的常态病。
三种常见解法(原材料第 7 节列出,前两种本报告补充机制):
| 方法 | 做法 | 为什么有效 |
|---|---|---|
| 门控结构 | 换 LSTM / GRU | 把”W 连乘”换成”门值连乘 + 加性通路” |
| 梯度裁剪 | torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=5) |
只治爆炸:把梯度范数超过阈值的整体按比例缩回 |
| 合理初始化 | 正交初始化 / 按 \frac{1}{\sqrt{H}} 缩放 | 让初始 W 的谱半径贴近 1,不主动放大也不主动衰减 |
4.7 LSTM:三门 + 一状态,逐个公式看
LSTM(Long Short-Term Memory,长短时记忆结构)是传统 RNN 的变体,核心结构分四部分:遗忘门、输入门、细胞状态、输出门(常说的”三门一状态”)。它比 RNN 多了一个细胞状态 C_t,一条贯穿所有时间步的”主传送带”。
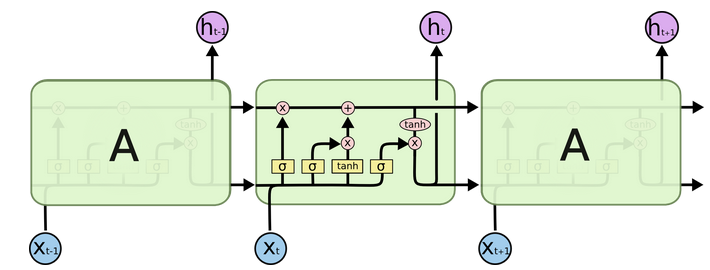
图注:三个 A 方块沿 t-1,t,t+1 展开(图例同 4.2 节:黄框 = 带参数的层、粉圈 = 逐元素运算、箭头 = 向量传递)。与 4.2 节 RNN 图最大的差别是:从左侧 A 块进入中间 A 块的是两条水平线,不是一条,上面那条是细胞状态 C,下面那条是隐藏状态 h;两条线都要往右传给下一个时间步。中间块被画开后,可以数到下面一排三个标 σ 的黄色方框(三个门)加一个标 tanh 的方框(候选细胞状态),以及主干线上串联的 ⊗ 和 ⊕ 两个粉色圆圈。下方仍是 x_t 输入、右上方仍是 h_t 输出。
四个部件的公式与作用(原材料逐部件给出结构图与公式):
① 遗忘门:f_t=\sigma\big(W_f[x_t,h_{t-1}]+b_f\big)
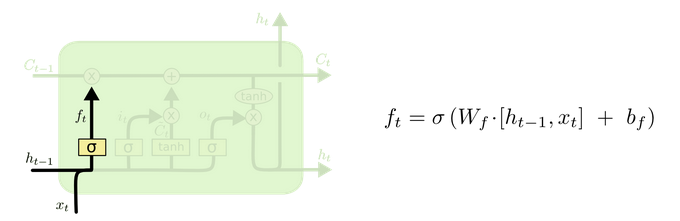
图注:遗忘门部分的结构图与计算公式。计算方式与传统 RNN 内部结构非常相似,把 x^{(t)} 与 h^{(t-1)} 拼接成 [x^{(t)},h^{(t-1)}],过一个全连接层,再用 sigmoid 激活得到门值 f_t。f_t 随后作用在上一时间步的细胞状态上,代表”遗忘过去多少信息”。因为 f_t 是由 x_t 和 h_{t-1} 算出来的,所以含义是:根据当前输入和上一时刻的隐藏状态,决定要丢掉多少旧记忆。
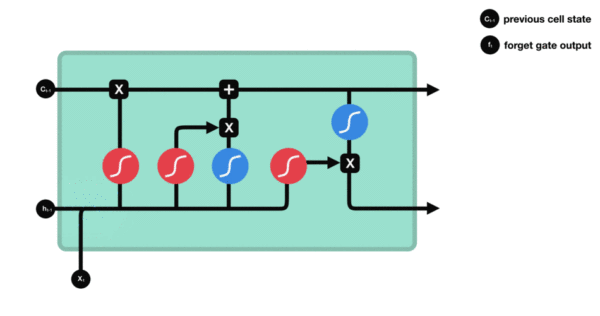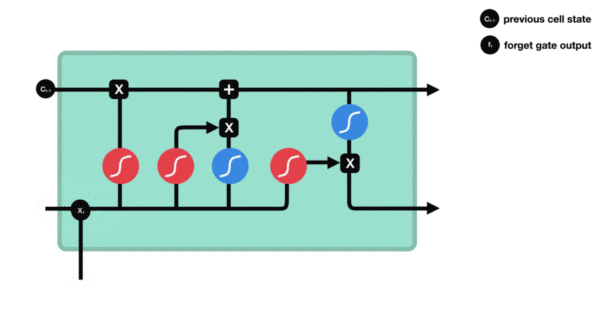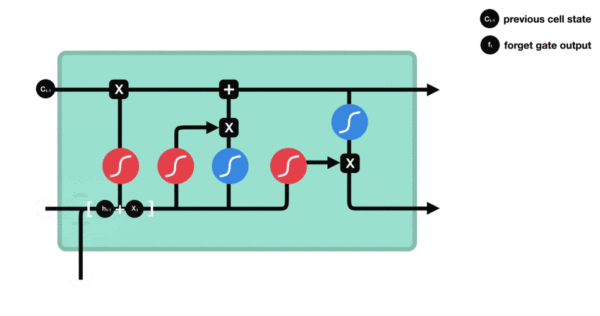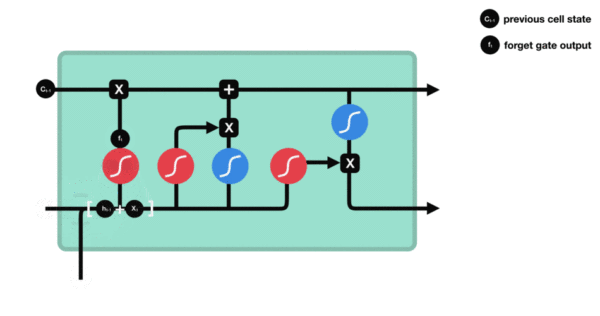
图注:遗忘门的拼接→全连接→sigmoid→作用到 C_{t-1} 的逐帧动画(GIF,见原文件)。
激活函数 sigmoid 的作用:把值压缩到 (0,1) 之间,当作”门开合的程度”,0 就是完全关掉(一点都不过),1 就是完全打开(原样通过)。
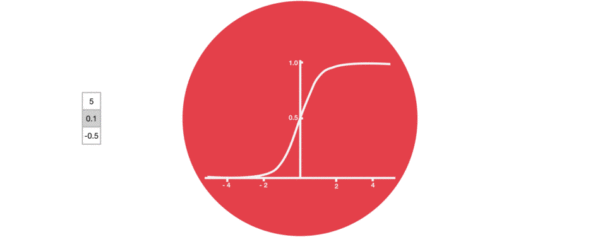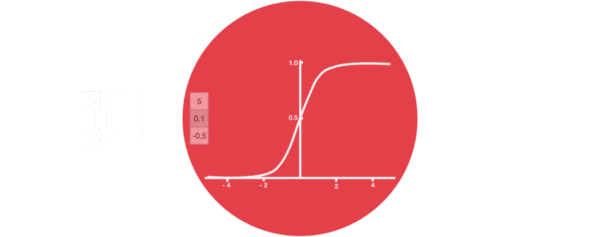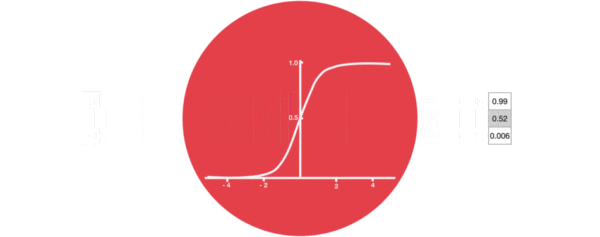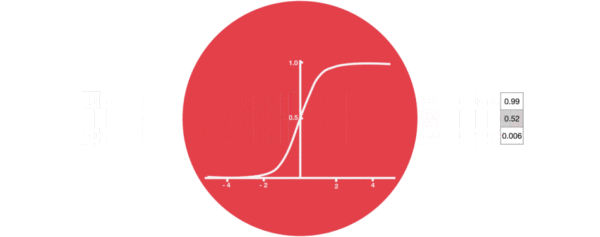
图注:动画演示 sigmoid 把值压进 (0,1) 区间。
② 输入门:i_t=\sigma\big(W_i[x_t,h_{t-1}]+b_i\big),\tilde C_t=\tanh\big(W_C[x_t,h_{t-1}]+b_C\big)
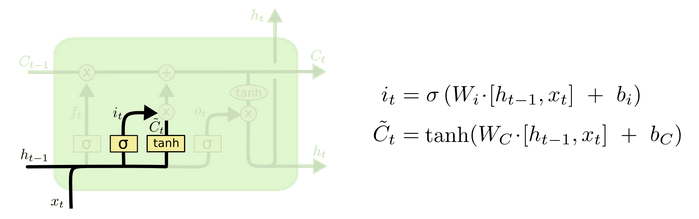
图注:输入门部分的结构图与计算公式。这里有两个公式:第一个产生输入门门值 i_t,计算方式和遗忘门几乎相同,区别只在之后要作用的目标上,含义是”输入信息有多少需要放行”;第二个与传统 RNN 的内部结构计算完全相同,但 LSTM 得到的是当前候选细胞状态 \tilde C_t,而经典 RNN 得到的是隐藏状态。
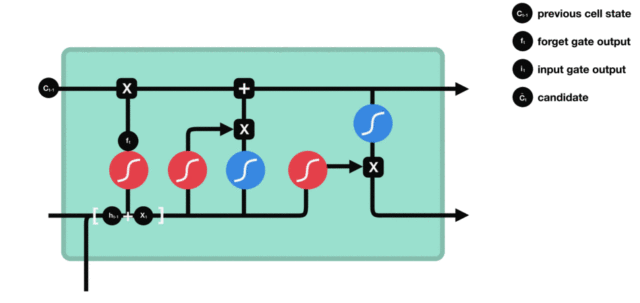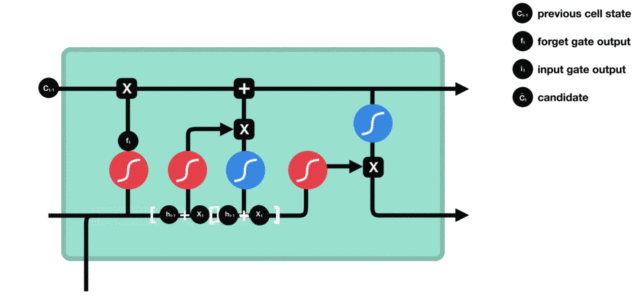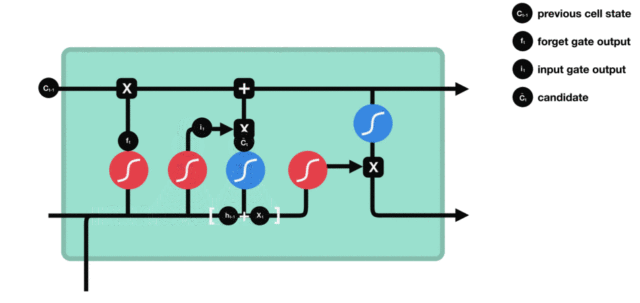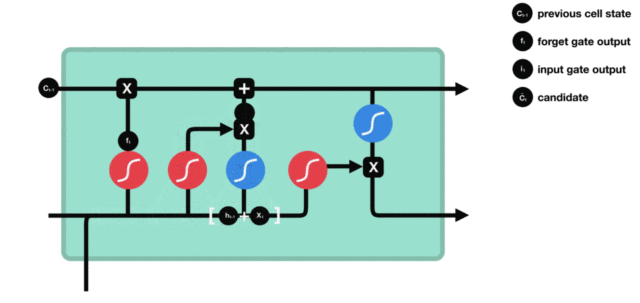
图注:输入门两路计算(i_t 与 \tilde C_t)及二者相乘的动画(GIF,见原文件)。
③ 细胞状态更新:C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t
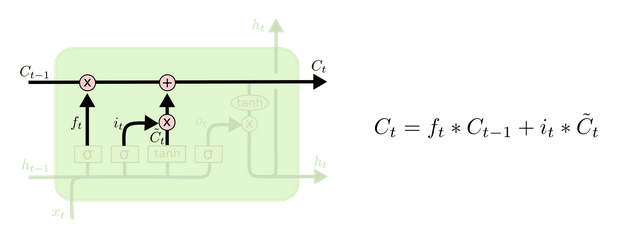
图注:细胞状态更新图与公式。这一部分没有全连接层,图里那条从左端 C_{t-1} 贯穿到右端 C_t 的水平粗线是整张图的骨干,上面只串了两个粉色圆圈:先一个 ⊗(把遗忘门门值与上一步的 C_{t-1} 逐元素相乘),紧接着一个 ⊕(把输入门门值与当前步算出的未更新细胞状态相乘后的结果加进来)。右端输出 C_t,再分出一条线向上经 tanh 后与 o_t 相乘得到 h_t(”Copy” 图例的含义)。整段更新就是遗忘门和输入门的一次联合作用。
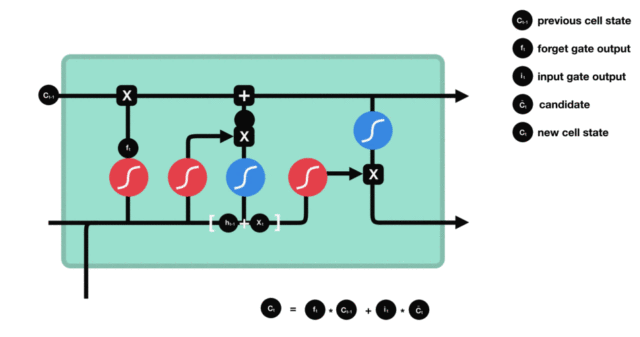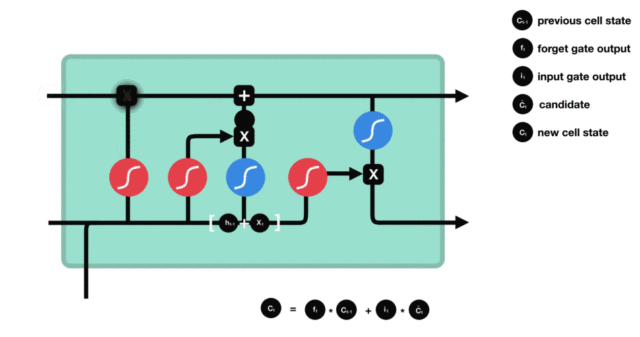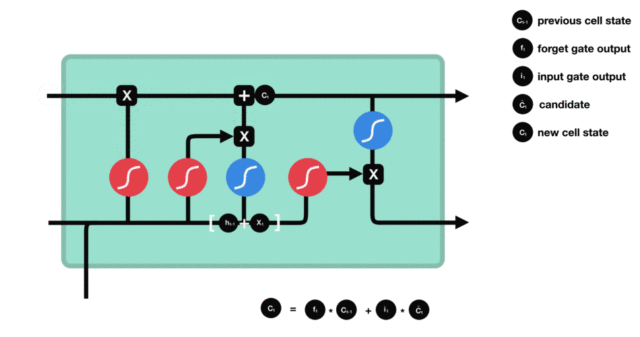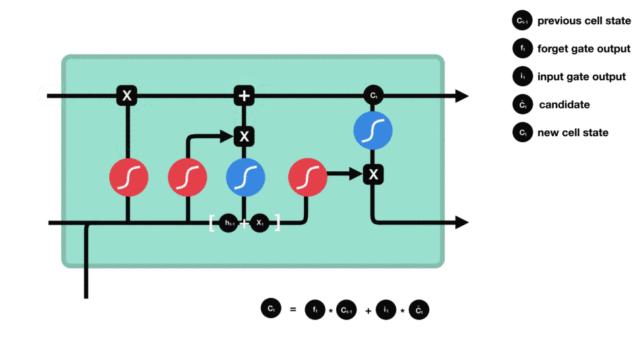
图注:C_{t-1} 经 ⊗(f_t)与 ⊕(i_t\odot\tilde C_t)得到 C_t 的动画(GIF,见原文件)。
④ 输出门:o_t=\sigma\big(W_o[x_t,h_{t-1}]+b_o\big),h_t=o_t\odot\tanh(C_t)
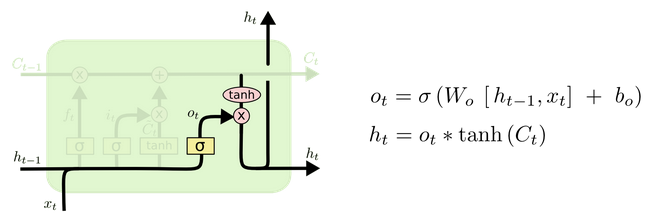
图注:输出门部分的结构图与计算公式,同样是两个公式:第一个计算输出门门值 o_t(与遗忘门、输入门算法相同);第二个把该门值作用在更新后的细胞状态 C_t 上(先对 C_t 做 tanh 激活),得到隐藏状态 h_t,作为下一时间步输入的一部分。整个输出门的过程,就是为了产生 h_t。
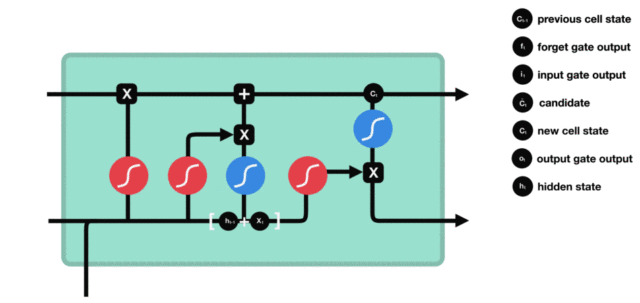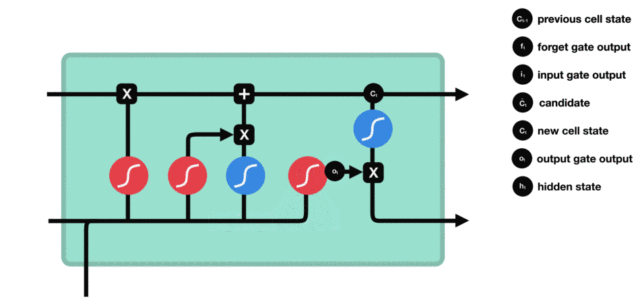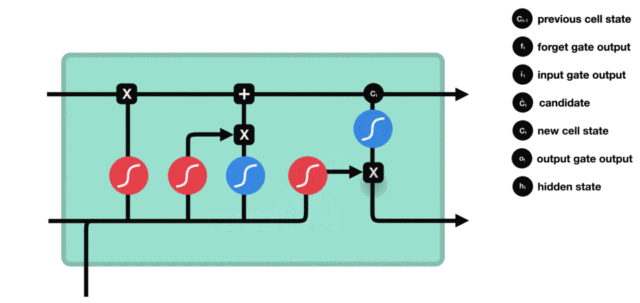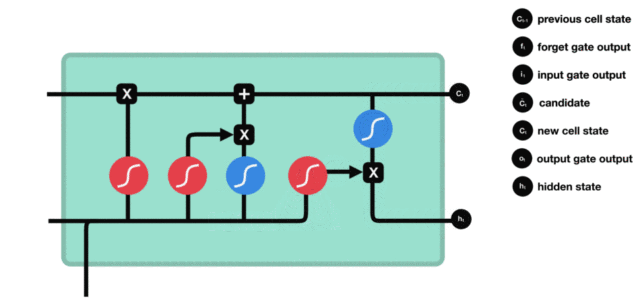
图注:输出门门值 o_t 与 \tanh(C_t) 相乘得到 h_t 的动画(GIF,见原文件)。
手算例子③:1 维 LSTM 的两步前向
设 H=1,C_0=0。门值是 σ/tanh 算出来的,这里直接给定,只为看清”门怎么作用”这层算术(真实训练时它们都是学出来的):
t=1:f_1=0.90,\ i_1=0.50,\ \tilde C_1=0.80,\ o_1=0.40
C_1=f_1\odot C_0+i_1\odot\tilde C_1=0.90\times0+0.50\times0.80=\mathbf{0.4000}
h_1=o_1\odot\tanh(C_1)=0.40\times\tanh(0.4)=0.40\times0.3799=\mathbf{0.1520}
t=2:f_2=0.30,\ i_2=0.90,\ \tilde C_2=-0.60,\ o_2=0.70
C_2=0.30\times0.4000+0.90\times(-0.60)=0.12-0.54=\mathbf{-0.4200}
h_2=0.70\times\tanh(-0.42)=0.70\times(-0.3965)=\mathbf{-0.2775}
看点在于C 和 h 是两条独立的数:t=1 时细胞状态里存了 0.40,但对外输出的 h_1 只有 0.1520,因为输出门 o_1=0.40 把它”卡”了一半多。到了 t=2,遗忘门降到 0.30,旧记忆只剩 0.30\times0.40=0.12 被保留,而新写入的 -0.54 占了主导,于是 C_2 翻成负数。遗忘门就是记忆的”半衰期旋钮”。
再看门的长期作用:如果每步都是 f=0.9、每步写入 i\odot\tilde C=0.4,那么 C 会按等比级数累积,C_{20}=3.5137,稳态是 \frac{0.4}{1-0.9}=4.0。也就是说 f=0.9 相当于”记忆的衰减时间常数约 10 步”;如果 f=1.0,C 会无限累加(这也是 LSTM 训练时容易”记太多”的原因)。
为什么这套结构能缓解梯度消失(重点):传统 RNN 里梯度穿时间要连乘 \tanh'(z_t)W_{hh},含矩阵 W;LSTM 里 \frac{\partial C_t}{\partial C_{t-1}}=f_t,是逐元素的门值,而且 C_t 里 C_{t-1} 走的是加法通道。当 f_t\approx1 时这条通道近似”梯度恒等传送带”,误差可以跨很多步不怎么衰减。但这是缓解不是解决,f_t 本身还是 sigmoid 输出(<1),长到几百步照样衰减。原材料在 LSTM 的代码注释里写得很直白:”主要缓解梯度消失,无法完全解决”。
4.8 Bi-LSTM
Bi-LSTM 不改变 LSTM 任何内部结构,只是把 LSTM 应用两次且方向不同,再把两次结果拼接作为最终输出。
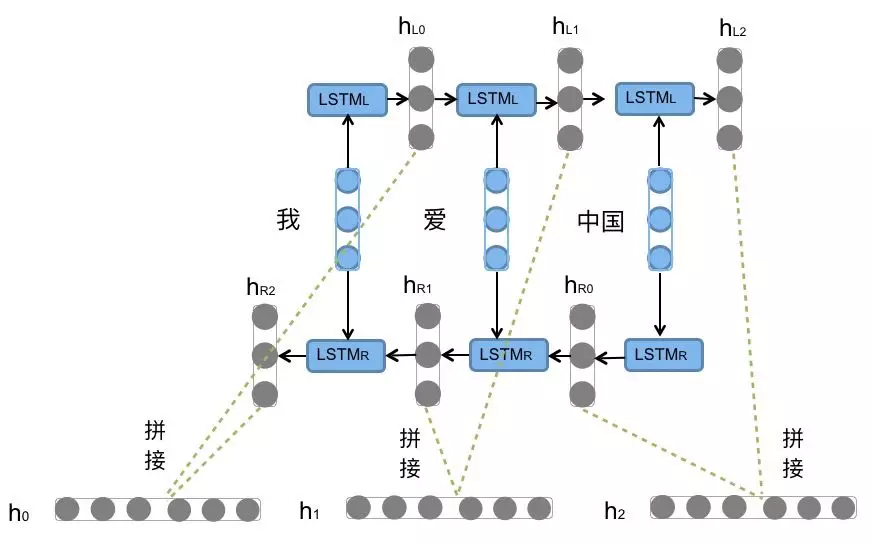
图注:图中间竖排着输入序列「我」「爱」「中国」。上方一行是三个 LSTM_L 方块,从左到右处理(图中输出圆点依次标 h_{L0}、h_{L1}、h_{L2},箭头由左指向右);中间一行是三个 LSTM_R 方块,从右到左处理(输出依次标 h_{R2}、h_{R1}、h_{R0},箭头由右指向左);两行的输出各用黄色虚线向下汇聚,到底部一行标着「拼接」的位置汇成 h_0、h_1、h_2,底部那些圆点比输入行明显更宽,直观表示”两个方向的隐藏状态在最后一维拼在一起,长度翻倍”。
意义与代价:这种结构能捕捉语言语法中一些特定的前置/后置特征,增强语义关联(例如判断”苹果”是指水果还是公司,需要同时看左右文)。代价是模型参数和计算复杂度都增加一倍,所以原材料提醒:一般需要对语料和计算资源做评估后再决定是否使用。
4.9 GRU:两门一状态,简化版 LSTM
GRU(Gated Recurrent Unit,门控循环单元)同样能捕捉长序列语义关联、缓解梯度消失,但结构比 LSTM 简单:核心是重置门(决定保留多少旧信息)、更新门(决定旧信息在生成新状态时的参与程度)、隐藏状态(存储关键信息)三个部分。
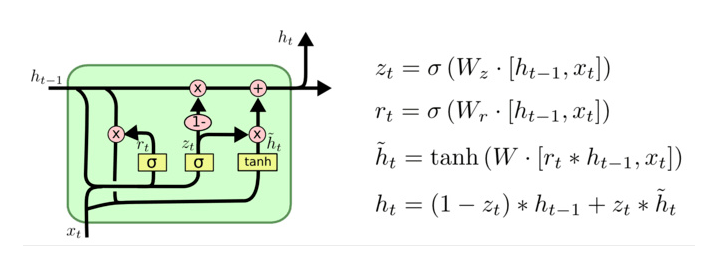
图注:GRU 的结构图与四个公式。h_{t-1} 从左侧沿主线进入,x_t 从左下角进入;下方一排黄色方框依次是 \sigma、\sigma、\tanh(分别产生 r_t、z_t 和候选状态 \tilde h_t)。h_{t-1} 有一条支路被 r_t 逐元素相乘(⊗)后送进 \tanh 的输入;z_t 的输出先经过一个标着 1− 的粉色圆圈,再与主线上的 h_{t-1} 相乘(⊗);\tilde h_t 在右侧被另一个 ⊗ 处理,最后两者在 ⊕ 处相加得到 h_t。图上给出的四个公式是:z_t=\sigma(W_z\cdot[h_{t-1},x_t])、r_t=\sigma(W_r\cdot[h_{t-1},x_t])、\tilde h_t=\tanh(W\cdot[r_t*h_{t-1},x_t])、h_t=(1-z_t)*h_{t-1}+z_t*\tilde h_t。注意最后一条与下面原材料正文的写法只是加号两项交换了位置,完全等价。
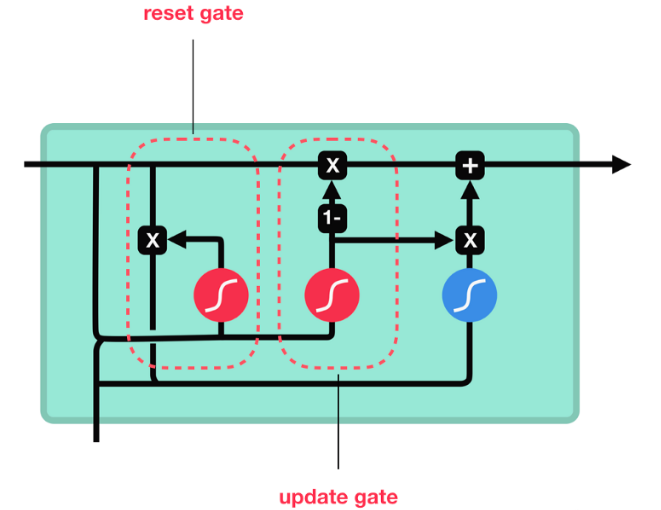
图注:用绿色底块画出的完整 GRU 单元,h_{t-1} 从左进、x_t 从下进、h_t 从右出,主线是一条贯穿左右的水平线。图中有三个标 σ 的圆圈(两个红色、一个蓝色);用红色虚线框分别圈出两个门并加了英文标注:左边的框是 reset gate(含一个 σ,其门值与 h_{t-1} 的一条支路做 ⊗),中间偏右的框是 update gate(含一个 σ、一个 1− 方块和一次 ⊗)。主线后半段还有一个 ⊗ 与一个 ⊕,正是”新旧状态加权融合”发生的位置。
四步计算(原材料正文):
z_t=\sigma(W_z[x_t,h_{t-1}]+b_z)\qquad r_t=\sigma(W_r[x_t,h_{t-1}]+b_r)
\tilde h_t=\tanh\big(W_h[x_t,\ r_t\odot h_{t-1}]+b_h\big)
h_t=(1-z_t)\odot h_{t-1}+z_t\odot\tilde h_t\quad(\text{等价写法}:h_t=z_t\odot\tilde h_t+(1-z_t)\odot h_{t-1})
- 第 1 步:算更新门与重置门(拼接 → 线性变换 → Sigmoid);
- 第 2 步:重置旧信息,r_t\odot h_{t-1},决定旧状态中哪些信息可以参与当前计算;
- 第 3 步:算候选隐藏状态,把 x_t 与重置后的隐藏状态拼接,过线性变换 + Tanh;
- 第 4 步:用更新门做加权融合并输出 h_t。z_t\to1 表示更多采用新状态,z_t\to0 表示更多保留旧状态。
Bi-GRU 与 Bi-LSTM 逻辑完全相同:不改内部结构,正反方向各跑一次再拼接。
手算例子④:1 维 GRU 一步融合
设 h_{t-1}=0.2、更新门 z_t=0.30、候选状态 \tilde h_t=0.70(同样是直接给定,省去 σ/tanh 的中间步骤):
h_t=(1-0.30)\times0.2+0.30\times0.70=0.14+0.21=\mathbf{0.35}
把门值推到极端看它的意义:z_t=0.05 → h_t=0.95\times0.2+0.05\times0.7=0.225(几乎完全保留旧状态,旧信息原样穿过时间步);z_t=0.95 → h_t=0.05\times0.2+0.95\times0.7=0.675(几乎完全替换成新状态)。
关键对比:LSTM 的对应式子是 C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t,有两个独立的门分别控制”忘多少”和”写多少”;GRU 只有一个 z_t,由它同时决定保留多少旧的、写入多少新的((1-z_t) 与 z_t 之和恒为 1)。这就是”GRU 用更少的参数换到接近 LSTM 效果”的全部秘密,也是它表达能力略弱的来源。
4.10 RNN 系列的局限:串行、长依赖、不可并行
原材料在 GRU 小节里把三条缺点写得很直接:
- 长依赖仍然学不好:LSTM/GRU 只是缓解了梯度消失(”不能完全解决梯度消失/爆炸问题”)。
- 不可并行计算,原文原话:”在大规模数据量的实际场景中,是 RNN 结构的关键瓶颈”。
- 参数多、调参难、可解释性差(LSTM 小节列出)。
为什么”串行”是致命伤?第 t 步的 h_t 依赖 h_{t-1},L 步序列就必须跑 L 次有依赖关系的前向/反向。GPU 有几千个核心,但在 RNN 上只能在 batch 维和 hidden 维并行,时间维串着走:
| 结构 | 串行深度 | 单步能并行的量 | 长度 512 的序列 |
|---|---|---|---|
| RNN / LSTM / GRU | O(L)(必须依赖前一步) | batch × hidden | 512 次串行依赖 |
| 自注意力(day04 起) | O(1)(一次算全序列两两关系) | batch × head × L × L | 1 次矩阵乘法打包完成 |
再看训练数据的规模:人名分类案例里序列长度只有 10(截断后),RNN 一轮 50 epoch 就够;一旦序列变成 512 或 2048,串行代价会线性放大。这就是 Transformer 取代 RNN 的工程理由,而不是”效果差一点”这种量级的问题。
4.11 扩展案例:人名分类器(RNN / LSTM / GRU 三选一)
原材料用”输入人名 → 判断国籍”把三个模型跑了一遍,这是本课程里唯一使用 one-hot 编码的案例(工程中一律用 nn.Embedding 或预训练语言模型)。
- 数据:
(home)/data/name_classfication.txt,每行”人名 + 制表符 + 国家名”(如Huffmann\tGerman、Deng\tChinese、Abaimov\tRussian),清洗掉过短的行后共 20074 条。 - 词表:
string.ascii_letters + " .,;'"= 52 个字母 + 5 个特殊符号 = 57;因为是按字符建模,无需 jieba 分词、无需构建词表。 - 标签:18 个国家(Italian / English / Arabic / Spanish / Scottish / Irish / Chinese / Vietnamese / Japanese / French / Greek / Dutch / Korean / Polish / Portuguese / Russian / Czech / German),随机猜的准确率约 1/18\approx5.6\%。
- 张量形状:
max_length=10,每个样本 one-hot 成 (10,57),模型第一层input_size=57;hidden_size=128、output_size=18。 - 训练:
DataLoader(batch_size=64, shuffle=True),CrossEntropyLoss+Adam(lr=1e-3),50 个 epoch,训练流程就是”前向 → 算损失 → 梯度清零 → 反向 → 更新参数 → 保存”。 - 实测结果:第 1 轮 loss 1.7985 / acc 0.4859(已远高于 5.6% 的随机线),第 25 轮 loss 0.5126;预测
rose→ German 0.9150、Vietnamese 0.0344、Dutch 0.0295。 - 分类头写法:这就是 §4.4 的 N→1 结构,取所有时间步输出的最后一个时间步
output[:, -1, :](形状 (B,H))接全连接层,而不是用hn。三个模型的forward只差一行返回值:LSTM 多返回(hn, cn)。
class MyRNN(nn.Module):
    def __init__(self, input_size, hidden_size, output_size, num_layers=1):
        super().__init__()
        self.rnn = nn.RNN(input_size, hidden_size, num_layers, batch_first=True)
        self.fc = nn.Linear(hidden_size, output_size)

    def forward(self, x, hidden=None):
        output, hidden = self.rnn(x, hidden)     # output: (B, L, H)
        last_output = output[:, -1, :]           # (B, H) 只取最后一个时间步
        return self.fc(last_output), hidden
4.12 附带的 LogSoftmax
第 6 节把 nn.LogSoftmax 拆开验证了一遍:输入 logits [3.2, 5.1, -1.7],nn.LogSoftmax(dim=0) 得到 [-2.0404, -0.1404, -6.9404];手工先 softmax 得 [0.1300, 0.8690, 0.0010],再取 log 得到同一个结果。这解释了为什么”CrossEntropyLoss 自带了 softmax”,它的输入是 logits,内部用 log_softmax 保证数值稳定,所以模型输出层不要再接 softmax。
五、易错点与常见误解
-
常见说法:”RNN 的 output 就是预测结果”;实际上,
output是所有时间步的隐藏状态,\boldsymbol{y} 是它接全连接层之后的东西。
output形状 (B,L,H\times D),是”每个位置一个向量”;分类要的是 (B,\text{num\_classes}),中间必须过一层nn.Linear。这也是为什么模型里self.fc = nn.Linear(hidden_size, output_size)是固定搭配。 -
有人以为”
hn和output[:, -1, :]是两回事”;实际上,单层单向时,两者数值完全相同(只是形状不同)。
原材料 demo02 把两者都打印出来了,hn是(1,4,8)、output[:, -1, :]是(4,8),数值逐元素一致(同一批数据、同一个末时间步)。但多层或双向时不能互换:hn的第 0 轴含每层每个方向的末状态,而output[:, -1, :]只是最后一层、两个方向拼接后的末状态。 -
常听到的一种说法是:”时间展开 = 网络变深了,所以参数量增加”;实际上,展开是画法,参数不变。
seq_len从 3 变到 6,nn.RNN(input_size=10, hidden_size=8)的参数量都是 304。而且层数不影响output的最后一维:num_layers=1→2时output仍是(4,6,8),只有hn的第一个轴从 1 变 2;只有bidirectional=True才把output最后一维翻倍成 16。这三条都出自原材料的实际打印,是最容易被”画得像多层网络”误导的地方。 -
容易想岔的地方:”LSTM 解决了梯度消失”;实际上,是缓解,不是解决。
LSTM 给出的加性通路 \partial C_t/\partial C_{t-1}=f_t 确实让梯度退化得慢得多,但 f_t 仍是 sigmoid 输出(小于 1),时间步一多照样衰减;原材料原文写的是”主要缓解梯度消失,无法完全解决”。同理 GRU”不能完全解决梯度消失”。 -
先说一个误解:”门控是对整个张量开或关”;实际上,门是逐元素(pointwise)的向量,每个维度独立开合。
本报告的手算例子把门当成标量,只是为了算得动;真实 f_t,i_t,o_t 都是长度 H 的向量,\odot 是逐元素乘,所以同一个单元可以”第 3 维全忘、第 7 维全留”。 -
常见说法:”BiLSTM 更强,所以处处该用双向”;实际上,生成/解码任务不能用双向。
双向要求整条序列都可见(反向那一遍要从末尾往前读)。机器翻译的解码器、语言模型、文本续写是一边生成一边往前走的,第 t 步的输出只能看 x_{1..t}。双向适合编码侧和分类类任务(NER 标注、句子分类),且代价是参数与计算量翻倍。 -
有人以为”细胞状态 C_t 就是隐藏状态 h_t“;实际上,C_t 是内部长期记忆,h_t 是它的”对外投影”。
见【手算例子③】:C_1=0.40 而 h_1=0.1520,差距来自输出门 o_1=0.40 和 \tanh 的压缩。C_t 只在单元内部流转,h_t 才是喂给下一层/输出层的量。 -
常听到的一种说法是:”
batch_first不重要”;实际上,PyTorch 默认是False,形状会错位。
nn.RNN/LSTM/GRU的batch_first默认为False,此时输入是 (\text{seq\_len},\text{batch},\text{input\_size});课程里统一写batch_first=True,输入才是 (B,L,\text{input\_size})。这个习惯和后面 BERT/transformers 的输入形状是一致的,写错会导致output[:,-1,:]取到的是某个 batch 的最后一个 batch 维切片而不是时间维末端。 -
“数据加载器长度”注释写错:案例注释写
20074/32 = 628,但代码里batch_size = 64,实际打印是 314(\lceil20074/64\rceil)。读课件代码时以打印结果为准,注释是上一版残留。
六、横向对比与研究脉络
6.1 三个结构逐项对比
| 维度 | 传统 RNN | LSTM | GRU |
|---|---|---|---|
| 核心原理 | 沿序列方向循环计算隐藏状态 | 遗忘门 + 输入门 + 输出门 + 细胞状态控制信息流 | 更新门 + 重置门控制信息流(简化版 LSTM) |
| 口决 | 一状态 | 三门一状态 | 两门一状态 |
| 内部状态 | h_t | h_t + c_t | h_t |
| PyTorch API | nn.RNN(input_size, hidden_size, num_layers, batch_first, bidirectional) |
nn.LSTM(...) |
nn.GRU(...) |
输入(batch_first=True) |
(B,L,input_size)、h0:(layers*D,B,H) |
同左,另需 c0:(layers*D,B,H) |
同左,无 c0 |
| 输出 | output:(B,L,H*D)、hn:(layers*D,B,H) |
同左,另有 cn:(layers*D,B,H) |
同左,无 cn |
| 每层参数量 | 2(HI+H^2+H) | 4(HI+H^2+H) | 3(HI+H^2+H) |
| 本项目尺寸(I=57,H=128,单向单层) | 47,616 | 95,232 | 71,424 |
| 长序列效果 | 差 | 好 | 接近 LSTM |
| 计算复杂度 | 低 | 高 | 中(LSTM > GRU > RNN,原材料原话) |
| 缺点 | 梯度消失/爆炸、难建模长期依赖、不可并行 | 参数多、训练慢、调参难、可解释性差、不可并行 | 不能完全解决梯度消失、不可并行 |
| 适用场景 | 短序列、教学/基线 | 需要长依赖且算力够(NER、机器翻译编码器) | 想省参数省时间、效果要求接近 LSTM |
选型结论(原材料)就一句:GRU/LSTM > RNN;再加一句工程口径:参数预算紧 → GRU,效果优先 → LSTM,两者都不能并行。
6.2 演进脉络(谁解决了谁的什么问题)
| 阶段 | 结构 | 解决的问题 | 留下的问题 |
|---|---|---|---|
| 传统 RNN | h_t=\tanh(W[x_t,h_{t-1}]+b) | 序列建模、参数共享、可变长度 | BPTT 梯度连乘 → 长期依赖学不到;串行 |
| → LSTM(Hochreiter & Schmidhuber, Long Short-Term Memory) | 三门 + 细胞状态 | 用门控和加性细胞状态通路缓解梯度消失 | 参数翻倍、计算慢;仍不可并行;定长 c 是 Seq2Seq 的信息瓶颈 |
| → Bi-LSTM | 双向各跑一次再拼接 | 每个位置同时看到左右文 | 参数与计算再翻一倍;不能用于解码 |
| → GRU(Cho 等, Learning Phrase Representations using RNN Encoder–Decoder) | 两门一状态,合并 LSTM 的门 | 用更少参数拿到接近 LSTM 的效果 | 表达能力略弱;仍不可并行 |
| → Seq2Seq / Attention(day04、day05 的内容) | 编码器–解码器 + 注意力 | 缓解”整句压成一个向量 c“的瓶颈 | 骨干仍是 RNN,串行问题没解决 |
| → Transformer / BERT(day05 起) | 纯注意力,去掉递归 | 串行深度降到 O(1),全局依赖一步直达 | 计算量 O(L^2)、需要更多数据/预训练 |
一句话脉络:RNN 用”循环”换来了序列建模,LSTM/GRU 用”门控”换来了长依赖,而 Transformer 直接放弃”循环”,用并行换效率,三者是同一目标下的三次取舍。
七、在新闻分类项目中的落地:为什么最终选 BERT 而不是 LSTM
新闻分类项目的四模型对比路线是 TF-IDF + 随机森林 → FastText → BERT(transformers 微调)→ LLM(DeepSeek 零样本/少样本),任务是把新闻标题分成 10 个类别,训练 18w / 验证 1w / 测试 1w。LSTM 不在这条线上,而这份材料是理解”为什么它不在”的必修课,评审者问”为什么用 BERT 不用 LSTM”时,答案必须来自这一节的机制,而不是”BERT 更新”。
7.1 六个具体理由
- 串行 vs 并行的算力账(第 1 理由)。18w 条标题,LSTM 的 L 个时间步必须串着算,GPU 只能在 batch 和 hidden 维并行;Transformer 把整条标题一次编码,串行深度 O(1)。同样的显卡,BERT 一个 epoch 的吞吐高一个量级。§4.10 那张”串行深度”表就是这个决策的量化依据。
- 项目场景用不上门控的长处。新闻标题平均二十来字,截断到 32 就够,这根本不算”长依赖”场景。LSTM 的门控是为几十上百步的依赖设计的,在这里属于”买了一台能跑 500 步的机器去跑 30 步”。
- 表示的来源不同:从零学 vs 预训练迁移。§4.11 的人名分类器要 model 自己从 one-hot/embedding 学起,20074 条样本、50 个 epoch 才到 ~0.83(这只是 18 分类);新闻标题是 10 分类、需要语义级区分(”体育”vs”娱乐”看着像的词很多),从零训 embedding + LSTM 的样本效率远不如”预训练 + 微调”。BERT 的权重自带了大规模语料的语言知识,fine-tune 是把它对齐到 10 个类别上。
- 双向的信息代价。BiLSTM 也能双向,但要正反各跑一遍(参数 ×2、时间 ×2)才能让每个位置看到全局;BERT 的双向编码器在一层注意力里就同时看到全句,而且不需要两个方向各存一份状态。
- 训练过程的稳定性与配套。§4.6 的梯度连乘意味着 LSTM 通常要配梯度裁剪、注意初始化、观察 loss 抖动;BERT 微调用现成的
transformers训练脚本 + Adam 默认参数就能收敛,项目里”训练斌子法则”的五步(前向 → 损失 → 清零 → 反向 → 更新)在两边一样,但调参面小得多。 - 生态与可交付性。transformers 里
BertForSequenceClassification直接给 10 类 logits,配合 tokenizer 处理截断/填充,服务端 Flask + 客户端 Streamlit 的接口不需要自己写[B,L,H]的手工形状管理;后续要做模型压缩(量化 / 蒸馏 / 剪枝)时,蒸馏也天然是”BERT 教师 → 小模型学生”的搭配。
7.2 那这份 LSTM 知识在项目里怎么用
- 考察重点:RNN → LSTM → GRU → Attention → Transformer 的演进线是必答;”LSTM 为什么被取代”如果只答”效果差”,会被追问到无法自证。
- 和 TF-IDF+随机森林的对比:随机森林的输入是 TF-IDF 的稀疏词袋(丢词序),LSTM 是第一个”带顺序”的方案,说明你清楚自己在哪一步跳过了什么。
- 和 FastText 的对比:FastText 用词/ngram 平均 + 浅层分类,快但没有顺序建模;LSTM 有顺序但慢;BERT 有顺序 + 预训练且可并行。三者正好构成”表示能力 vs 计算代价”的一条线。
- 和 LLM 的对比:DeepSeek API 零样本/少样本路线不需要训练,但推理成本高、批量吞吐受限;BERT 微调是延迟/成本最优的折中,这跟”RNN 串行所以吞吐低”是同一类工程权衡。
- 蒸馏里直接用到形状习惯:蒸馏损失 \text{loss}=(1-\alpha)\cdot\text{hard\_loss}+\alpha\cdot T^2\cdot\text{soft\_loss},其中软标签来自教师 logits 过
softmax(T),§4.12 的 log_softmax 与CrossEntropyLoss内含 softmax 这件事决定了F.kl_div()的输入要传 log 概率,否则数值会偏。学生模型若是小型 LSTM/GRU,hidden_size、num_layers就是剪枝/蒸馏的自由度。
7.3 如果真要在这个项目上跑 LSTM,参数怎么定
| 参数 | 建议 | 依据 |
|---|---|---|
input_size |
= 词向量维度(本项目 128~300 量级) | §4.11 里用 57(字符级 one-hot),工程里换成 nn.Embedding |
hidden_size |
128~256 | 课程案例用 128,10 分类够用 |
num_layers |
1~2 | 层数只影响 hn 第 0 轴和容量,不影响 output 最后一维 |
bidirectional |
分类任务可开(output 最后一维 ×2,接 nn.Linear(2*hidden, 10)) |
§4.8 |
| 分类头 | output[:, -1, :](双向时该位置已含两方向拼接)→ nn.Linear |
§4.11 N→1 结构的取法 |
Dropout |
层间 0.2~0.5;只有 num_layers>1 时才真正起作用 |
常规做法 |
| 优化器 / lr | Adam,1e-3(课程案例):配 nn.CrossEntropyLoss |
案例实测收敛正常 |
| 梯度裁剪 | clip_grad_norm_(..., 5) |
§4.6 爆炸的唯一直接对策 |
| 序列处理 | 截断/填充到固定长度(如 32) | 案例用 max_length=10 |
7.4 实际坑
- padding 污染
hn:为了 batch 而把标题补齐到 32 时,短标题后面的 pad 位置也在跑时间步,直接取hn(或output[:,-1,:])会把 pad 的隐藏状态当成句子表示。正确做法是pack_padded_sequence/pad_packed_sequence,或者按真实长度取output[i, len_i-1, :]。这是 LSTM 分类最常踩的坑,也是”为什么工程上更愿意用 BERT”的隐藏原因之一(BERT 用 attention mask 一行解决)。 batch_first忘写:默认False,输入得写成 (\text{seq\_len},B,\text{input\_size}),否则形状对不上或”看着跑通、结果全错”(§5 第 8 条)。- 数据类型:
CrossEntropyLoss要int64标签(案例里dtype=torch.int64,分类数是 18/10),标签编码用countries.index(y)这种字符串查表方式在 18 类没问题,10 类也要建映射表。 - 双向别用在生成侧:如果后续把模块扩展到标题生成/摘要,双向会泄露未来信息(§5 第 6 条)。
- 过拟合:18w 标题上直接训 LSTM,模型容量够但正则少,验证集 1w 会先升后降,这也是转向”预训练 + 微调”的直接动因。
八、重点问答
Q1:RNN 的隐状态是怎么算的?为什么它能处理任意长度的序列?
A:核心就一条公式,h_t=\tanh(W_{xh}x_t+W_{hh}h_{t-1}+b),也就是把当前输入和上一时间步的隐藏状态拼起来,过一层全连接再套 tanh。它能处理变长序列靠的是参数共享:每个时间步复用同一组 W 和 b,所以序列是 3 个词还是 300 个词,参数量完全一样,模型结构不用改;序列长度只影响算几次循环,不影响参数个数。我手算过一维的例子,W_{xh}=0.5、W_{hh}=1,输入 [1,2,-1],三步的隐藏状态是 0.4621、0.8981、0.3783,三步用的都是同样的两个权重。
Q2:”时间展开”是不是就是把 RNN 变深了?
A:不是,这是两个不同的事。时间展开只是画法:把同一个 RNN 层在 t=1..T 的计算摊平画出来,看起来像 T 层深的前馈网络,但它们共享同一组参数,反传时梯度按时间步累加到同一份权重上。真正的加深是 num_layers,那才是两组独立参数。有个特别好验证的对比:nn.RNN(input_size=10, hidden_size=8) 单层是 304 个参数,seq_len 从 3 涨到 6 参数量一点不变;而 num_layers=2 变成 608,但 output 的最后一维仍然是 8,只有开双向才会翻倍成 16。这三个数字都来自课程代码的实际打印。
Q3:RNN 的梯度为什么会消失或爆炸?怎么解决?
A:因为 BPTT 里梯度是跨时间步的连乘,\prod_t(\sigma'(z_t)\cdot W)。\tanh 的导数最大是 1,只要有 |W|<1,连乘必然衰减;反之 |W| 大就放大,直到数值溢出出 NaN。我在一维例子上算过,W_{hh}=1 时三步连乘只剩 0.13,序列拉到 20 步只剩 4.3\times10^{-5},梯度小到浮点数都表示不出来,所以长期依赖学不到。解法有三类:换门控结构(LSTM/GRU)、梯度裁剪(只治爆炸)、合理初始化让 W 的谱半径贴近 1。另外注意梯度爆炸往往出现在序列前段或激活不饱和时,比如换成线性激活,因为 tanh 一旦饱和导数就趋近 0 了。
Q4:LSTM 的三个门分别做什么?为什么它能缓解梯度消失?
A:遗忘门决定保留或忘记多少旧记忆,f_t=\sigma(W_f[x_t,h_{t-1}]+b_f);输入门决定写入多少新记忆,i_t 控制 \tanh 算出的候选状态 \tilde C_t 写多少进去;输出门决定细胞状态里哪些信息对外输出,h_t=o_t\odot\tanh(C_t)。细胞的更新是 C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t。缓解梯度消失的关键不在”三个门”本身,而在细胞状态那条加性通路:C_t 对 C_{t-1} 的偏导就等于 f_t,是逐元素的门值,不是矩阵 W 的连乘;f_t 接近 1 时误差几乎能无损穿过很多时间步。但它是缓解不是解决,f_t 还是 sigmoid 出来的数,长到几百步照样衰减。
Q5:GRU 和 LSTM 怎么选?
A:GRU 是简化版 LSTM,把三个门压成两个,重置门 r_t 决定保留多少旧信息、参与候选状态的计算,更新门 z_t 同时决定保留多少旧状态和写入多少新状态,h_t=(1-z_t)\odot h_{t-1}+z_t\odot\tilde h_t;而且它只有一个状态 h_t,没有单独的细胞状态。所以参数量是 LSTM 的 3/4,训练更快,效果接近 LSTM。选型上:算力和参数预算紧、序列不算超长,用 GRU;要极限效果、愿意付更多计算,用 LSTM。我手算过一维的融合,h_{t-1}=0.2、z=0.3、\tilde h=0.7 时 h_t=0.35;z 取 0.05 几乎原样保留旧状态,取 0.95 几乎完全替换。一句话总结区别:LSTM 有两个门分别管”忘”和”写”,GRU 用一个门同时管,(1-z_t) 和 z_t 加起来恒为 1。
Q6:双向 LSTM 一定更好吗?什么时候不能用?
A:不一定。双向不改变 LSTM 的内部结构,就是把同一层正着跑一遍、反着跑一遍,再把两个方向的输出拼接,好处是每个位置能同时看到前文和后文,比如判断”苹果”是水果还是公司就得看两边。代价是参数和计算量都翻倍,而且生成类任务根本不能用:反向那一遍要求整条序列都可见,但机器翻译的解码器、语言模型、文本续写是一边生成一边往前走的,第 t 步只能看 x_{1..t},用双向就把未来信息泄露了。所以双向适合编码侧和分类、序列标注这类任务。
Q7:nn.LSTM 的 output 和 hn 有什么区别?形状怎么记?
A:batch_first=True 时输入是 (B,L,\text{input\_size});output 是所有时间步、最后一层的隐藏状态,形状 (B,L,H\times D);hn 是每个层每个方向的末状态,形状 (num\_layers\times D,B,H);LSTM 还多一个同样形状的 cn。D 是方向数,单向往 1、双向是 2。分类任务的标准写法是取 output[:, -1, :] 接全连接层。有两个坑:一是 batch_first 默认 False,不写输入顺序就反了;二是单层单向时 hn 和 output[:, -1, :] 数值完全相同(课程代码里打印出来逐元素一致),但多层或双向时不能互换。我按课程的作业验证过:nn.LSTM(16, 32, num_layers=2) 吃 (4,10,16) 得到 output (4,10,32)、h_n 和 c_n 都是 (2,4,32);双向 GRU、hidden 64 时输出最后一维是 128。
Q8:既然 LSTM 效果不错,为什么现在的模型都用 Transformer?
A:因为不可并行这个结构性缺陷,而不是效果差一点。RNN 系列第 t 步依赖第 t-1 步,长度为 L 的序列就有 L 次串行计算,GPU 只能在 batch 和 hidden 维并行,时间维串着走;Transformer 用自注意力一次算出全序列的两两关系,串行深度是常数级,训练吞吐差一个量级。再加上门控只能缓解不能解决长依赖,而注意力是任意两个位置直接相连。所以我做的新闻标题分类项目里,四模型路线是 TF-IDF + 随机森林 → FastText → BERT 微调 → LLM,中间没有 LSTM:标题才二十来字,用不上门控的长依赖能力,而 BERT 的预训练权重比从零训 embedding 的样本效率高得多,还能用 attention mask 一行解决 padding 问题。LSTM 在被追问时是必答的原理题,在工程里是”知道为什么被跳过”的对照项。
九、延伸阅读
- Chris Olah, Understanding LSTM Networks:本材料 LSTM 结构图与其图例(Neural Network Layer / Pointwise Operation / Vector Transfer / Concatenate / Copy)的来源,RNN 到 LSTM 的最经典图解。
- Hochreiter & Schmidhuber, Long Short-Term Memory(LSTM 原始论文,1997):三门 + 细胞状态的设计出处。
- Cho 等, Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation(GRU 的提出)。
- Bengio、Simard、Frasconi, Learning Long-Term Dependencies with Gradient Descent is Difficult:梯度消失问题被系统论证的经典文献。
- PyTorch 官方文档:
torch.nn.RNN、torch.nn.LSTM、torch.nn.GRU、torch.nn.LogSoftmax、torch.nn.utils.clip_grad_norm_、torch.nn.utils.rnn.pack_padded_sequence。 - 本目录后续材料:
day04_注意力机制、day05_07_Transformer架构(RNN 串行瓶颈的正面解法)、day09_RNN英译法案例(Seq2Seq 落地)、day10_FastText工具介绍、day11_transformers迁移学习。 - 数据集:人名分类数据
name_classfication.txt(本项目课程在 §5 使用,格式为”人名 + TAB + 国家名”)。
原图存档
以下是本报告中未逐张插图、按主题归组的原图(均在 assets/day03_RNN及其变体/ 下),需要回看细节时按文件名查原文件即可。
A. N→N / N→1 / 1→N / N→M 四类输入输出结构:10.png(N→N 等长)、011.png(N→1 序列到单值)、012.png(1→N 单输入到序列)、RNN15.png(N→M 即 Seq2Seq),已在 §4.4 全部插入。
B. 传统 RNN 结构与动画:rnn_all.png(完整网络:词表 → 输入层 → 词嵌入层 → RNN 层 → 全连接层 → 输出)、rnn_model.png(单层计算模型)、21.png(沿时间展开)、22.png(图例)、RNN2.gif(循环画法)、RNN1.gif(时间步展开画法)、RNN21.gif、RNN22.gif(拼接与 tanh 演示),已在 §4.1~§4.3 全部插入。
C. LSTM 结构、门与动画:31.png(展开结构)、32.png(遗忘门)、34.png(输入门)、35.png(细胞状态更新)、37.png(输出门)、RNN26.gif~RNN30.gif(五个门的逐帧动画)、38.png(Bi-LSTM 双向拼接),已在 §4.7、§4.8 全部插入。
D. GRU 结构与公式:gru.png(单元结构与四个公式)、gru2.png(重置门/更新门结构说明),已在 §4.9 插入。
总计:原目录 25 个图片文件,本报告 25 处引用全部插在对应小节,无遗漏。