从”逐块手写”出发把 Transformer 拆成输入(词嵌入 + 位置编码)、Mask、编码器(多头自注意力 + FFN + Add&Norm)、解码器(掩码自注意力 + 交叉注意力 + FFN)、输出(线性 + softmax)五段,再用 nn.Transformer 走一遍工程实现,这是整个 NLP 系列地基级的一份材料。
一、这份材料解决什么问题
在此之前,序列建模的主流是 RNN / LSTM / GRU。这份材料开篇就点出这类模型的两个根本问题:
- 时间步循环计算,无法并行:第 t 步必须等第 t-1 步算完,序列方向的并行度是 0,GPU 再强也用不满;
- 长距离依赖建模困难,句子越长效果越差:信息要在隐藏状态里一步步”运”过去,路径长度是 O(n),中途会被反复挤压。
Transformer 的答案是:取消循环,用 Attention 重写序列建模,注意力的本质是把”信息传递”从”沿时间步搬运”改成了”任意两个位置直接加权取用”。材料给出的原文出处是 Attention Is All You Need(Vaswani et al., 2017,arXiv:1706.03762),即 Google 在 2017 年提出的架构。
这份材料在整条学习链上的位置:
RNN/LSTM/GRU(day03)→ 注意力机制(day04)→ Transformer(day05~07,本份)
                                              ├→ Transformer 英译法案例(day08)
                                              ├→ FastText(day10,非 Transformer 路线对照组)
                                              ├→ transformers 迁移学习 / BERT 微调(day11)
                                              └→ BERT 与 GPT 架构(day12,只取 Encoder / 只取 Decoder)
对新闻分类项目(类今日头条新闻标题 10 分类,路线 TF-IDF+随机森林 → FastText → BERT → LLM)而言,这份材料是从 FastText 跳到 BERT 的那道门槛:不懂多头注意力、不懂 Mask 语义、不懂位置编码,就无法解释”为什么 BERT 只能取 Encoder 部分””为什么 tokenizer 要返回 attention_mask“”为什么微调学习率要压到 2e-5 这种量级”。同时它也是被追问时”讲讲 Transformer”这一题的完整底稿。
二、核心结论
- Transformer = 自注意力 + 位置编码 + 并行。它没有循环、没有卷积,靠 Self-Attention 让任意两个位置直接交互;代价是丢弃了顺序信息,必须显式补回位置编码(相加,不是拼接)。
- 多头注意力不增加参数量,只增加”视角”。d_{model}=512、h=8 时每头 64 维;切分是固定操作(无需学习),真正的学习发生在 Step 1 的 W_Q,W_K,W_V 投影和 Step 5 的 W_O 输出投影上,参数量仍是 4d_{model}^2。
- Mask 不删 token,只改注意力分数。实现是在 softmax 前给被遮蔽位置加 -10^9,让其权重趋近 0;padding mask 管
<PAD>,causal mask 管”不许看未来”,True统一表示”遮蔽”。 - 子层连接顺序是工程与论文的分水岭:原论文是 SDAL(Sublayer → Dropout → Add → LayerNorm,Post-LN),主流工程实现改成 LSDA(LayerNorm → Sublayer → Dropout → Add,Pre-LN),
nn.Transformer(norm_first=True)就是 Pre-LN,训练更稳、更容易去掉 warmup。 - 训练可并行、推理只能自回归:训练时目标序列右移一位 + 因果掩码,一次前向就得到所有位置的 logits;推理时没有”未来”可用,只能逐 token 生成,靠 KV cache 把已算过的 K/V 缓存起来复用。
三、知识地图
原文每个一级章节都有明确的学习目标(【了解】/【掌握】),照录如下:
day05_07 Transformer 架构(13 个一级章节)
├── 1 Transformer 背景                               【了解】
│   ├── 1.1 提出背景:RNN 的两个根本问题(不能并行 / 长依赖差)
│   ├── 1.2 核心思想:Self-Attention / 并行计算 / 位置编码
│   ├── 1.3 主要优势:非递归 / 依赖路径短 / 结构统一易堆叠
│   └── 1.4 产业地位:WMT 等榜单上几乎全是 Transformer
├── 2 认识 Transformer 架构                          【了解作用 · 掌握各部分名称】
│   ├── 2.1 模型作用:翻译/生成、预训练语言模型
│   ├── 2.2 总体架构:输入 / 编码器 / 解码器 / 输出 四大部分
│   └── 2.3 总结表
├── 3 输入部分实现                                   【了解作用 · 掌握实现】
│   ├── 3.1/3.2 文本嵌入层 nn.Embedding(+ 乘 √d_model 缩放)
│   └── 3.3 位置编码器 MyPositionalEncoding(sin/cos + register_buffer)
├── 4 掩码张量 Mask                                  【了解(作用与实现原理)】
│   ├── 4.1~4.3 本质:屏蔽注意力分数;两类 Mask 对比表
│   ├── 4.4 各注意力模块该用哪个 Mask(快捷表)
│   └── 4.6/4.7 torch.triu / torch.masked_fill / plt.matshow
├── 5 编码器部分实现                                 【了解作用 · 掌握实现】
│   ├── 5.2 缩放点积注意力 MyAttention
│   ├── 5.3 多头注意力 MyMultiHeadAttention(5 步拆分)
│   ├── 5.4 前馈网络 MyFeedForward(d_model→d_ff→d_model)
│   ├── 5.5 层归一化 MyLayerNorm
│   ├── 5.6 子层连接结构 MySublayerConnection(函数对象传参)
│   ├── 5.7 编码器层 MyTransformerEncoderLayer(2 个子层)
│   └── 5.8 编码器 MyTransformerEncoder(N 层 + 末尾 LayerNorm)
├── 6 解码器部分实现                                 【了解作用 · 掌握实现】
│   ├── 6.1/6.2 解码器层:3 个子层(掩码自注意力 / 交叉注意力 / FFN)
│   └── 6.3 解码器 MyTransformerDecoder(N 层 + 末尾 LayerNorm)
├── 7 输出部分实现                                   【了解作用 · 掌握实现】
│   └── 线性层 d_model→vocab_size + softmax(交叉熵自带 softmax)
├── 8 构建完整的 Transformer 模型                    【掌握】
│   └── MyTransformer:forward / encode / decode
├── 9 Transformer 的工程实现                         【工程实践】
│   └── nn.Transformer(batch_first、norm_first、三类 padding mask)
├── 10 扩展:词嵌入缩放的原因                        【原理补丁】
│   └── embedding 初始化方差、PE 的尺度、为什么乘 √d_model
├── 11 扩展:函数对象传参                            【语法】
│   └── 高阶函数 / lambda(服务 5.6 子层传参)
├── 12 常见高频题                                    【重点】
│   └── 架构 / 多头作用 / 位置编码 / LayerNorm vs BatchNorm / 生成策略
└── 13 代码作业                                      【练习】
    ├── 正余弦位置编码 + 热力图(50×20)
    ├── nn.TransformerEncoder 形状与参数量统计
    └── 不同 d_model 的参数量对比(结论:d_model 翻倍 → 参数量约 4 倍)
四、原理详解
4.1 整体架构:四大部分、两条数据流
Transformer 是基于 Encoder-Decoder 的架构:Encoder 负责把源序列编码成一组”带上下文的向量表示”,Decoder 负责在 Encoder 输出 + 已生成前缀的约束下产出目标表示,输出部分再把表示映射成词表上的概率。
四大部分与各自的内部构成:
| 组成部分 | 核心内容 |
|---|---|
| 输入 | 源文本嵌入 + 位置编码 / 目标文本嵌入 + 位置编码(两套,各自独立) |
| 编码器 | N 层 × (多头自注意力 + Add&Norm) → (前馈网络 + Add&Norm) |
| 解码器 | N 层 × (掩码自注意力 + Add&Norm) → (交叉注意力 + Add&Norm) → (前馈网络 + Add&Norm) |
| 输出 | 线性层(d_{model} \to vocab)+ Softmax |
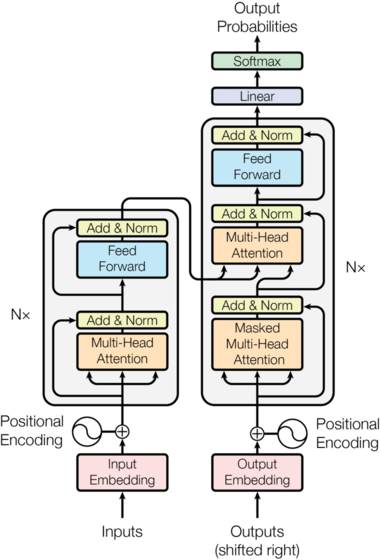
图注:经典的 Encoder-Decoder 全景图,原图的 SVG 版本。左列为编码器:Inputs → Input Embedding → 与 Positional Encoding 做加法(⊕)→ 灰色框内 Multi-Head Attention(橙色)→ Add & Norm(绿色)→ Feed Forward(蓝色)→ Add & Norm,整块左侧标注 Nx(堆叠 N 层)。右列为解码器:Outputs (shifted right) → Output Embedding → ⊕ 位置编码 → Masked Multi-Head Attention → Add & Norm → Multi-Head Attention → Add & Norm → Feed Forward → Add & Norm,同样标注 Nx。关键细节:中间那个 Multi-Head Attention 有三个输入箭头,其中一条从左边缘水平进入,它来自编码器最终 Add & Norm 的输出(这一步就是交叉注意力,Q 来自解码器、K/V 来自编码器)。顶部继续向右下走 Linear → Softmax → Output Probabilities。每个 Add & Norm 左侧都有一条绕过子层的残差线。
原文用的默认超参与原论文 base 配置一致:d_{model}=512、num\_heads=8、d_{ff}=2048、num\_layers=6、dropout 0.1。
4.2 输入部分(一):词嵌入层与 √d_model 缩放
词索引是整数,模型只能吃向量,nn.Embedding 就是一张可训练的词向量查找表 (vocab\_size, d_{model})。
输入 (batch_size, seq_len) 的索引 → 输出 (batch_size, seq_len, d_model),并乘上 \sqrt{d_{model}}:
class MyEmbedding(nn.Module):
    def __init__(self, vocab_size, d_model=512):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, d_model)

    def forward(self, x):
        x = self.embedding(x)          # (batch_size, seq_len, d_model)
        return x * self.d_model ** 0.5 # 关键:缩放
课件链接作业里的真实输出:
输入词索引序列x: torch.Size([2, 20])
输出词向量x: torch.Size([2, 20, 512])
为什么要乘 \sqrt{d_{model}}(材料第 10 章给了完整推导):
- PyTorch
nn.Embedding默认按 \mathcal{N}(0, 1/d_{model}) 初始化,单维方差 \frac{1}{d_{model}},整条向量各维独立相加后总方差 d_{model}\cdot\frac{1}{d_{model}}=1; - 正余弦位置编码的输出范围是 [-1,1],整体 \mathbb{E}[PE]\approx 0、\text{Var}[PE]\approx 0.5,尺度明显偏小;
- 乘 \sqrt{d_{model}} 后单维方差回到 1,embedding 与位置编码尺度对齐,相加时位置信息才不会被词向量淹没;同时避免注意力点积过小导致 softmax 饱和、梯度消失。
这就是 (x\cdot\sqrt{d_{model}}) \oplus PE 里那个缩放项的来历。
4.3 输入部分(二):位置编码,正余弦为什么能表达”相对位置”
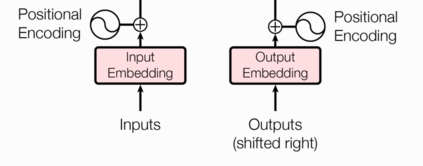
图注:输入部分结构图。左右并排两套相同结构:源文本嵌入层 与 目标文本嵌入层,各自后面接一个 位置编码器,两路输出分别送往编码器与解码器。图中用并列的两组”嵌入层 → 位置编码”表示”源和目标各有一套、原理相同但参数不共享”。
自注意力对输入是置换等变的,把句子打乱,输出只是跟着打乱,模型自己分不出来顺序。所以顺序信息必须由外部显式注入。
公式(pos 为位置,i 为维度索引,d 为 d_{model}):
PE_{(pos,\,2i)} = \sin\!\left(\frac{pos}{10000^{2i/d}}\right),\qquad
PE_{(pos,\,2i+1)} = \cos\!\left(\frac{pos}{10000^{2i/d}}\right)
代码里的实现技巧是用指数函数算分母:
10000^{-2i/d} = \exp\!\left(\log(10000)\cdot\left(-\frac{2i}{d}\right)\right)
pe = torch.zeros(max_len, d_model)
pos = torch.arange(0, max_len).unsqueeze(1)                     # (max_len, 1)
div_term = torch.exp(np.log(10000.0) * (-torch.arange(0, d_model, 2) / d_model))
pe[:, ::2]  = torch.sin(pos * div_term)   # 偶数维用 sin
pe[:, 1::2] = torch.cos(pos * div_term)   # 奇数维用 cos
pe = pe.unsqueeze(0)                      # (1, max_len, d_model),靠广播与词向量相加
self.register_buffer("pe", pe) # 不训练,但随模型一起保存/迁移设备手算小例子(d=20,材料作业的真实输出):
- 位置 0:\sin(0)=0、\cos(0)=1 →
[0.0, 1.0, 0.0, 1.0, 0.0, 1.0, ...],即”全 0 全 1 交替”; - 位置 1:前几个偶数维为 \sin(1/10000^{2i/20}),对应 i=0,1,2 依次得到
0.841471, 0.387674, 0.157827(分母 10000^{0}=1、10000^{0.1}\approx2.512、10000^{0.2}\approx6.310),奇数维取对应 \cos:0.540302, 0.921796, 0.987467。
规律(材料原话):不同维度使用不同频率的正弦/余弦函数,低维度频率高(变化快),高维度频率低(变化慢)。这等价于给每个维度配一把不同刻度的”尺子”,短波长维度负责区分邻近位置,长波长维度负责区分远距离位置。
为什么正余弦编码能表达相对位置:同一对 (2i, 2i+1) 构成一个二维向量,记 \omega_i = 1/10000^{2i/d},则 [PE_{(pos,2i)}, PE_{(pos,2i+1)}] = [\sin(pos\,\omega_i), \cos(pos\,\omega_i)]。于是
\begin{bmatrix} PE_{(pos+k,\,2i)} \\ PE_{(pos+k,\,2i+1)} \end{bmatrix}
=
\underbrace{\begin{bmatrix} \cos(k\omega_i) & \sin(k\omega_i) \\ -\sin(k\omega_i) & \cos(k\omega_i) \end{bmatrix}}_{R(k\omega_i)}
\begin{bmatrix} PE_{(pos,\,2i)} \\ PE_{(pos,\,2i+1)} \end{bmatrix}
即 PE_{pos+k} 是 PE_{pos} 的一个只依赖偏移量 k、与 pos 无关的线性变换(旋转矩阵)。也就是说”相距 k 个位置”这件事在编码空间里有统一、可学的线性表达,模型不必为每个绝对位置单独记忆。这也是它能比随机初始化更早收敛、并且在没见过的更长序列上仍可外推的原因。工程上另一种做法是用 nn.Embedding(max_len, d_model) 做可学习位置编码(材料第 9 章采用),好处是灵活,坏处是超出 max_len 就得重新训练。
工程细节:max_len 常按句子长度分布取 2~4 倍余量(材料对 max_src_len / max_tgt_len 就是这么建议的),原因是模型不该绑定数据集的具体长度,且推理阶段要支持变长输入。
4.4 掩码张量 Mask:两类 Mask 与三处用法
一句话定义(材料原话):Mask 用来在注意力计算中”遮掉”不该看的位置信息,它决定某个 Query 是否可以关注某个 Key,作用在注意力分数上,而不是直接去掉输入 token。
\text{Attention} = \operatorname{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}} + \text{mask}\right)V
| 维度 | Padding Mask(填充掩码) | Causal Mask(因果掩码) |
|---|---|---|
| 形状 | (batch_size, seq_len) |
(tgt_seq_len, tgt_seq_len) |
| 目的 | 忽略序列中的 <PAD> 填充位置 |
禁止看到未来 token,保证自回归生成顺序 |
| 何时用 | 所有注意力(Encoder/Decoder 通用) | 仅 Decoder 的自注意力 |
| 形式 | 2D 布尔向量 | 上三角布尔矩阵(含对角线) |
| 布尔语义 | True = 遮掩 / <PAD>,False = 可见 |
True = 遮掩未来 token,False = 可见 |
| 生成方式 | 按有效长度把前 lens[i] 位置置 False |
torch.triu(torch.ones(L, L), diagonal=1) |
三处注意力分别该用哪个 Mask:
| 注意力模块 | Padding Mask | Causal Mask |
|---|---|---|
| Encoder Self-Attention | ✔ | ✘ |
| Decoder Self-Attention | ✔ | ✔ |
| Encoder–Decoder(交叉)Attention | ✔ | ✘ |
实现要点:
# 1) padding mask:(B, L),True 表示被遮蔽
padding_mask = torch.ones(batch_size, seq_len, dtype=torch.bool)
lens = torch.randint(5, seq_len + 1, (batch_size,))
for i in range(batch_size):
    padding_mask[i, :lens[i]] = False     # 有效长度内可见

# 2) causal mask:(L, L),上三角(不含对角线)为 True
causal_mask = torch.triu(torch.ones(L, L), diagonal=1).to(dtype=torch.bool)

# 3) 落到分数上:把 True 位置换成大负值,再做 softmax
scores = torch.masked_fill(scores, causal_mask == True, -1e9)
attention_weights = torch.softmax(scores, dim=-1)   # 被遮位置 ≈ 0
升维与广播(材料 4.6 明确写了):mask 矩阵本身是 2D,但注意力分数是 4D (B, H, Q, K),因此在 Attention 内部统一升维:padding mask (B, k_len) → (B, 1, 1, k_len),causal mask (q_len, k_len) → (1, 1, q_len, k_len),再借助广播与分数相加。
手算感受一下 -10^9 的威力:设某行分数为 [2.0, -1e9, 1.0],softmax 后为
\frac{[e^{2}, e^{-10^9}, e^{1}]}{e^{2}+e^{-10^9}+e^{1}} \approx [0.731,\ 0.000,\ 0.269]
被遮位置的概率是 0(浮点下彻底下溢),但该位置的 token 仍然在张量里、形状不变,这就是”遮分数不删 token”的含义。
4.5 缩放点积注意力:打分 → 归一化 → 加权求和
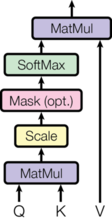
图注:缩放点积注意力的标准流程图。底部两个输入 Q、K 进入第一个 MatMul(紫色,算 QK^\top)→ Scale(黄色,除以 \sqrt{d_k})→ Mask (opt.)(粉色,可选,实现即加 -10^9)→ SoftMax(绿色)→ 第二个 MatMul(紫色)与右侧的 V 相乘 → 向上输出。它把课件那行公式拆成了五个可实现的算子,顺序与公式完全对应。
\text{Attention}(Q,K,V)=\operatorname{Softmax}\!\left(\frac{Q\cdot K^\top}{\sqrt{d_k}}\right)\cdot V
三者的语义(材料 5.2 的定义):
- Q(Query,查询):当前位置”我想关注什么”的表示;
- K(Key,键):所有候选信息的”索引/标签”,用来和 Q 比对算出相关度;
- V(Value,值):真正被加权取走、融合的内容。
为什么除以 \sqrt{d_k}:Q,K 各维近似独立、方差为 1 时,点积 Q\cdot K^\top=\sum_{i=1}^{d_k}q_ik_i 的方差是 d_k,量级会随 d_k 线性放大。除以 \sqrt{d_k} 把方差拉回 1,避免 softmax 进入饱和区(大值 → 概率接近 one-hot → 梯度趋近 0)。材料在 5.2 节代码里写的是除以 d_model**0.5,多头内部因为 d_model 已被切成 d_head,实际上每个头的尺度由 d_head 决定,这是看代码时要留意的一处细节(见第五节)。
手算小例子(d_k=2,\sqrt{d_k}\approx1.414,3 个 token):
Q=K=\begin{bmatrix}1&0\\0&1\\1&1\end{bmatrix},\quad V=\begin{bmatrix}1&0\\0&1\\1&1\end{bmatrix}
- 打分 S=QK^\top/\sqrt{2}:
S=\begin{bmatrix}0.707&0&0.707\\0&0.707&0.707\\0.707&0.707&1.414\end{bmatrix}
- 逐行 softmax 得注意力权重:
W=\begin{bmatrix}0.401&0.198&0.401\\0.198&0.401&0.401\\0.248&0.248&0.504\end{bmatrix}
- 加权求和 W\cdot V:
\text{Output}=\begin{bmatrix}0.802&0.599\\0.599&0.802\\0.752&0.752\end{bmatrix}
可以看出:行和恒为 1;第 3 个 token 与自身点积最大(1.414),权重也最高(0.504);对角线最强的那个 token 的输出更接近”自己 + 邻居的混合”。这就是”注意力把相关信息加权搬过来”的最小学例。
4.6 多头自注意力:一次前向,多个子空间
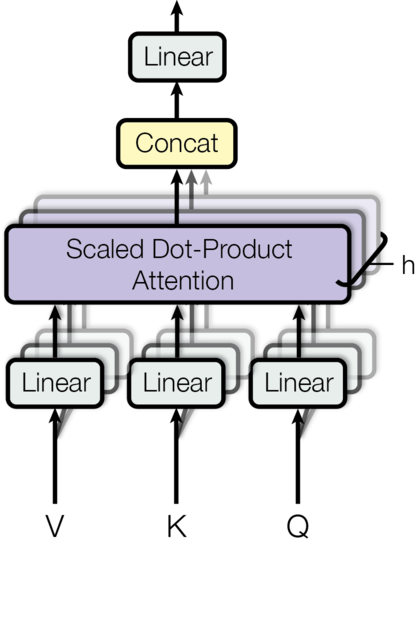
图注:多头注意力的结构图。底部 Q、K、V 三个输入各接一个灰色 Linear(原图把灰块画成堆叠的 h 层,表示”每个头一份投影”),三路进入紫色 Scaled Dot-Product Attention(同样画成堆叠的 h 份,右侧用括号标注 h),输出向上进入黄色 Concat,再经过一个灰色 Linear 后向上输出。全图从左下到右上只有一个数据流方向,没有任何跨头连线,直观表达”各头完全并行、互不干扰,只在 Concat 处汇合”。
一个注意力头只能在一个注意力空间里建模,容易只盯住某一类关系(比如只学局部、或只学全局)。多头就像让模型”从多个角度同时看同一句话”,不同的头可以分别去关注 主语-谓语、修饰关系、指代、位置邻近等不同的依赖类型。
机制(材料给出的 5 步),设 d_{model}=512、num\_heads=8 \Rightarrow d_{head}=64:
| 步骤 | 操作 | 输入形状 | 输出形状 | 说明 |
|---|---|---|---|---|
| Step 1 | 线性映射得到 Q、K、V | (batch, seq, 512) | (batch, seq, 512) | Q=XW_Q,\ K=XW_K,\ V=XW_V,学习能力在这里 |
| Step 2 | 按头切分 | (batch, seq, 512) | (batch, 8, seq, 64) | 固定切分,不涉及参数学习 |
| Step 3 | 每头独立算注意力 | (batch, 8, seq, 64) | (batch, 8, seq, 64) | head_i=\text{softmax}(Q_iK_i^\top/\sqrt{d_k})V_i,各头并行 |
| Step 4 | 拼接所有头 | (batch, 8, seq, 64) | (batch, seq, 512) | \text{Concat}(head_1,\dots,head_8) |
| Step 5 | 输出线性变换 | (batch, seq, 512) | (batch, seq, 512) | \text{Output}=\text{Concat}(\cdot)W_O,信息融合在这里 |
公式形式:
\text{MultiHead}(Q,K,V)=\text{Concat}(head_1,\dots,head_h)W_O,\qquad
head_i=\text{Attention}(QW_i^Q,\ KW_i^K,\ VW_i^V)
代码里的形状变换(这套 view + transpose 是必背操作):
query = self.linear_q(query)                                   # B, S, D
query = query.view(batch_size, -1, self.num_heads, self.d_head).transpose(1, 2)  # B, H, S, DH
# ... 多头注意力 ...
output = output.transpose(1, 2).reshape(batch_size, -1, self.d_model)             # 回到 B, S, D
output = self.linear_out(output)课件实测形状(d_model=512, num_heads=8, batch=4, seq_len=10):单头路径的权重是 (4, 10, 10),多头路径的权重是 (4, 8, 10, 10),输出都回到 (4, 10, 512)。
参数量小例子(手算):多头不会因为切分而增加参数量。W_Q,W_K,W_V,W_O 各是 d_{model}\times d_{model}:
\underbrace{4\times 512^2}_{=1{,}048{,}576}\ +\ \underbrace{4\times 512}_{\text{bias}} = 1{,}050{,}624
8 个头各 64 维的总和恰好等于”单头 512 维”,因为 8\times(512\times 64)=512\times512。多头买的是”多视角”,不是”多参数”,这也是工程上它”效果与效率的最佳平衡”的原因。
4.7 残差连接 + LayerNorm:子层连接结构(Pre-LN vs Post-LN)
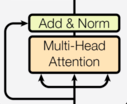
图注:子层连接的局部放大图(从全景图中截出的一个 Add & Norm 单元)。底部一条输入线分两路:一路进入橙色子层方块(多头注意力/前馈网络),另一路作为残差直连线绕过子层从左侧上行;子层输出与残差线在绿色 Add & Norm 处相加后向上输出。图中可以清楚看到”旁路”与”主路”两条独立的连线在绿色方块汇合,这就是 x+\text{Sublayer}(x) 的图形表达。
LayerNorm 公式:
y=\gamma\cdot\frac{x-\mu}{\sqrt{\sigma^2+\epsilon}}+\beta,\qquad
\mu=\frac{1}{d}\sum_{i=1}^{d}x_i,\quad \sigma^2=\frac{1}{d}\sum_{i=1}^{d}(x_i-\mu)^2
实现对最后一个轴(特征维)做标准化,\gamma(初始化为 1)、\beta(初始化为 0)是可学习参数:
mean = torch.mean(x, -1, keepdim=True)     # (B, S, 1)
std  = torch.std(x, -1, keepdim=True)      # (B, S, 1)
x = (x - mean) / (std ** 2 + self.eps) ** 0.5
x = self.gamma * x + self.beta
LayerNorm 的三个作用(材料原话):解决内部协变量偏移(层输入分布随深度漂移导致学习困难)、加速训练(规范化到合理范围使梯度更稳定)、提高泛化能力(减少对初始权值的依赖)。
子层连接结构 = Sublayer + Dropout + Add + LayerNorm,其中顺序是重点:
- 原文顺序(SDAL,Post-LN):x_{out} = \text{LN}\big(x + \text{Dropout}(\text{Sublayer}(x))\big)
- 主流工程顺序(LSDA,Pre-LN):x_{out} = x + \text{Dropout}(\text{Sublayer}(\text{LN}(x)))
课件的实现就是 Pre-LN,且用函数对象传参把”子层”做成可插拔(第 11 章专门讲了高阶函数/lambda):
def forward(self, x, sublayer):
    # SDAL(原文): sublayer - dropout - Add - LayerNorm
    # LSDA(工业实现): LayerNorm - sublayer - dropout - Add
    return self.dropout(sublayer(self.layer_norm(x))) + x
为什么主流转向 Pre-LN:Post-LN 把归一化放在残差相加之后,随着层数变深,残差主干的尺度会被一次次重新归一化,梯度需要穿过每层的 LN,深层训练不稳、通常依赖 learning-rate warmup 才能收敛;Pre-LN 让残差路径变成一条”干净的直通高速路”(x + f(\text{LN}(x))),梯度可以无衰减地回传到浅层,训练更稳、对 warmup 的依赖大幅降低,这是现代大模型普遍采用 Pre-LN 的原因。课件在编码器/解码器的末尾额外再加一个 LayerNorm,注释明确写着”工程上在编码器最后添加了 LN,原论文中编码器最后没有 LN”,这是 Pre-LN 结构的配套做法,用在堆叠出口做一次统一归一化。
两个手算细节:
- 残差连接要求子层输入输出形状一致,这就是为什么注意力层/FFN 都设计成 d_{model}\to d_{model};
- LayerNorm 在 d=512 时每层只有 2\times512=1024 个参数(\gamma,\beta),相对注意力的 105 万可以忽略,但没有它,深层堆叠几乎训不起来。
4.8 前馈网络 FFN:逐位置的两层全连接
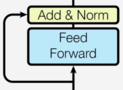
图注:前馈网络子层的放大图。蓝色 Feed Forward 方块接收下方输入,输出向上进入绿色 Add & Norm,左侧同样有一条从输入线绕出的残差旁路进入 Add & Norm。图的重点在”FFN 自带一套 Add & Norm”,即它和注意力一样是并列的子层,而不是附着在注意力内部。
\text{FFN}(x)=\max(0,\ xW_1+b_1)W_2+b_2,\qquad W_1\in\mathbb{R}^{d_{model}\times d_{ff}},\ W_2\in\mathbb{R}^{d_{ff}\times d_{model}}
def forward(self, x):                    # (B, S, d_model)
    x = F.relu(self.linear1(x))          # (B, S, d_ff)  —— 先升维
    x = self.dropout(x)
    x = self.linear2(x)                  # (B, S, d_model) —— 再降回
    return x
作用(材料原话):具有两层线性层,在注意力之后增加非线性变换,提升模型表达能力。它的另一个常被忽略的特点是逐位置(position-wise):同一个 FFN 独立作用于序列上每个位置,位置之间不交换信息,所有跨位置的信息交换都发生在注意力层。
参数量小例子:d_{model}=512,\ d_{ff}=2048 时
\underbrace{(512\times2048+2048)}_{W_1,b_1}+\underbrace{(2048\times512+512)}_{W_2,b_2}\approx 2.1\times10^{6}
比注意力层的 1.05\times10^6 还大一倍。所以”Transformer 参数主要在 FFN”这个说法是对的,也是为什么后续做量化/蒸馏/剪枝(项目和被追问时的模型压缩专题)时,FFN 的线性层往往是重点对象。
4.9 编码器层与编码器:两层子层 + 末尾 LN
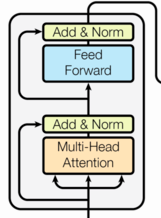
图注:编码器层内部结构图(不带 Nx 标注的单个层)。自下而上:三个输入箭头(Q、K、V 都来自同一条输入线,体现”自注意力”)进入橙色 Multi-Head Attention → 绿色 Add & Norm → 蓝色 Feed Forward → 绿色 Add & Norm 输出。两个 Add & Norm 左侧各有一条从下方绕出的残差旁路,构成两个独立的子层连接结构。
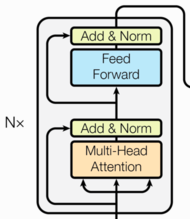
图注:编码器整体图,与上图内容完全相同,但左侧多出 Nx 标注,表示这个结构被堆叠 N 层。对应原文的编码器实现:nn.ModuleList([EncoderLayer(...) for _ in range(num_layers)]),逐层 for 循环前向,最后接一个 LayerNorm。
编码器层的前向只有两行,却把四个组件串完了:
x = self.sublayer1(x, lambda x: self.multi_head_attention(x, x, x, padding_mask=padding_mask)[0])
x = self.sublayer2(x, lambda x: self.feed_forward(x))
return x
注意 multi_head_attention(x, x, x) 的三个参数都是 x,这就是”自注意力”的字面含义:Query、Key、Value 同源。整个编码器的作用(材料原话)是”对输入进行特征提取,也称为编码”,数据流形状全程不变:
输入数据 source: (B, S)  →  词向量: (B, S, 512)  →  编码器输出: (B, S, 512)
实测: torch.Size([4, 10]) → torch.Size([4, 10, 512]) → torch.Size([4, 10, 512])
4.10 解码器层与解码器:三个子层,多了一个交叉注意力
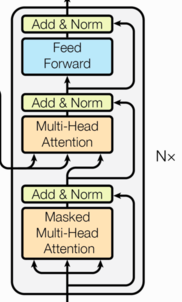
图注:解码器层结构图,自下而上共三个子层:Masked Multi-Head Attention(橙色,名字里的 Masked 指因果掩码)→ Add & Norm → Multi-Head Attention(橙色,三个输入箭头中有一条从左边缘水平进入,即来自编码器的输出,其余两个来自解码器自身路径)→ Add & Norm → Feed Forward(蓝色)→ Add & Norm,右侧标注 Nx。每个 Add & Norm 左侧都有残差旁路。图里能直接看出解码器比编码器”多一个子层”,多出来的正是中间那个交叉注意力。
解码器层的三个子层各司其职(材料 6.2):
- 自注意力:建模目标序列内部依赖(带因果掩码);
- 交叉注意力:利用编码器输出完成源-目标对齐;
- 前馈网络:提升特征表达并稳固融合。
# 子层1:带因果掩码的自注意力
x = self.sublayers[0](x, lambda x: self.mask_attention(x, x, x, tgt_mask=tgt_mask)[0])
# 子层2:交叉注意力 —— Q 来自解码器,K/V 来自编码器输出
x = self.sublayers[1](x, lambda x: self.multi_head_attention(x, encoder_output, encoder_output, padding_mask=src_mask)[0])
# 子层3:前馈网络
x = self.sublayers[2](x, self.feed_forward)交叉注意力的参数怎么传,是最容易写错的一处:self.multi_head_attention(Q=x, K=encoder_output, V=encoder_output, padding_mask=src_mask)。因为 MyAttention 内部是 Q K^\top/\sqrt{d_k},Key 的长度决定分数矩阵的最后一维,所以这里必须传源序列的 padding mask(src_mask,形状 (B, src_seq_len)),遮的是源端的 <PAD>。这也解释了为什么 nn.Transformer 里对应参数叫 memory_key_padding_mask。
解码器 = N 个解码器层 + 末尾 LayerNorm,输入输出形状:
x(右移一位的目标序列词向量): (4, 20, 512)
encoder_output:              (4, 10, 512)
输出:                         (4, 20, 512)
4.11 输出部分:线性层 + Softmax
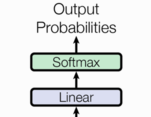
图注:输出部分结构图,两个方块上下相连:上面是 Linear,下面是 Softmax,数据自下而上流动,解码器的 (B, S, d_model) 表示先经线性层映射到词表维度,再经 softmax 变成概率分布。
- 线性层的作用(材料原话):通过线性变化得到指定维度的输出,也就是转换维度,d_{model}\to vocab\_size;
- Softmax 的作用:把最后一维的数字缩放到 [0,1] 的概率分布并保证和为 1。
logits = self.linear1(x)          # (B, S, d_model) -> (B, S, vocab_size)
# prob = F.softmax(logits, dim=-1) # 若用 nn.CrossEntropyLoss 就不要手动 softmax课件实测:预测分数logits: torch.Size([4, 20, 2000])、预测概率prob: torch.Size([4, 20, 2000])。
一个必须记住的工程细节(材料注释):nn.CrossEntropyLoss 内部自带 softmax,训练时输出 logits 即可,手动再过一次 softmax 会造成”softmax 两次”,梯度被错误缩放。
4.12 训练与推理:同一条公式,两种跑法
这是把架构”用起来”的关键一步,材料通过 MyTransformer 的 forward / encode / decode 三个方法和 nn.Transformer 的实践把它讲清楚了。
训练阶段(可并行):
- 目标序列右移一位(”Outputs (shifted right)”):输入
<bos> w1 w2 ... w_{n-1},监督标签w1 w2 ... w_n <eos>; - 一次前向把整段目标序列送进解码器,靠 causal mask 保证第 t 个位置只能看到 \le t 的位置;
- 于是”第 t 步预测下一个词”这个任务,对所有位置同时成立,一次前向产出全部位置的 logits,与标签逐位置算交叉熵。序列方向的并行度就是 n。
推理阶段(只能自回归):
- 编码器可以先算一次、反复复用(对应
encode()方法的存在,以及decompose成 encode/decode 的意义); - 解码器每步只能送进”已生成的前缀”,取最后一个位置的 logits,选词,再拼回输入,无法并行;
- 优化手段是 KV cache:已生成 token 的 K,V 每层都算过且不再变化,缓存起来,每步只为新 token 算 Q,注意力只需要和缓存做点积。这是推理加速最基础的一招(也是为什么大模型推理显存占用随上下文长度增长)。
生成策略(材料高频题第 5 题给的对照表):
| 策略 | 定义 | 应用场景 |
|---|---|---|
| 贪心搜索 | 每步选概率最高的词 | 低延迟、需稳定输出 |
| Beam Search | 每步保留多个候选路径,选整体最优 | 翻译、摘要等重质量任务 |
| Top-k 采样 | 仅在前 k 个高概率词中随机采样 | 对话、文案等需一定多样性 |
| Top-p 采样 | 在累计概率达到 p 的词集合中采样 | 开放式生成,兼顾自然度与多样性 |
材料给的结论:通用大模型里最主流的是采样式解码,即 Top-p(nucleus sampling)配合 temperature 参数。
4.13 复杂度分析:O(n^2d) 的自注意力与”并行性优势”
| 对象 | 每层计算量(粗算,单样本) | 依赖路径长度 | 序列方向并行 |
|---|---|---|---|
| RNN/LSTM | O(n\cdot d^2)(每步一次 d\times d 矩阵乘) | O(n),信息要逐时间步搬运 | ✗ 第 t 步等第 t-1 步 |
| 自注意力 | O(n^2\cdot d)(QK^\top 与 \cdot V 各 2n^2d) | O(1),任意两点直接交互 | ✔ 一次矩阵乘算完整个序列 |
| FFN(逐位置) | O(n\cdot d\cdot d_{ff}) | — | ✔ |
注意这两件事是分开的:
- 并行性优势来自”没有循环”:即使总 FLOPs 不比 RNN 少,Transformer 也能把 n 个位置一次性喂给 GPU,把原本 n 次串行的小矩阵乘变成几次大的批量矩阵乘,硬件利用率天差地别。材料对优势的三条归纳是:非递归结构支持并行计算(整段序列同时参与计算,缩短训练时间、提升硬件利用率)、依赖路径更短(信息传递不再受”步数”限制)、结构统一易堆叠扩展(多头注意力 + 前馈网络为基本模块,适合大规模预训练与迁移学习)。
- 代价是 O(n^2) 的时间和 O(n^2) 的注意力矩阵显存:序列翻倍,注意力部分的开销涨 4 倍。
粗算一下谁主导(d=512、d_{ff}=2048、单层、单样本):
| 序列长度 n | 注意力(4n^2d) | FFN(2n\cdot d\cdot d_{ff}) | 比值 |
|---|---|---|---|
| 128 | ≈ 33.6 M | ≈ 268.4 M | 0.12 |
| 512 | ≈ 536.9 M | ≈ 1073.7 M | 0.50 |
| 1024 | ≈ 2147.5 M | ≈ 2147.5 M | 1.00 |
| 2048 | ≈ 8590 M | ≈ 4295 M | 2.00 |
短序列(n < d_{ff}/2 = 1024)时 FFN 才是算力大头;长序列时注意力反超并迅速主导。这解释了工程上两个方向的选择:短文本分类任务(比如新闻分类项目的标题分类,n 只有几十)里注意力开销很小、可以放心堆参数;而长文本/长上下文的瓶颈全在注意力,才会出现稀疏注意力、滑窗注意力、分块注意力等长序列优化方向。
4.14 工程实现:nn.Transformer 的掩码三件套
手写一遍之后,材料第 9 章给出工业做法:用 nn.Transformer 承载编码器-解码器,词嵌入、位置编码、输出线性层自己写。
self.transformer = nn.Transformer(
    d_model=d_model, nhead=n_heads,
    num_encoder_layers=num_layers, num_decoder_layers=num_layers,
    dim_feedforward=d_ff, dropout=dropout,
    batch_first=batch_first,     # 让输入输出形状固定为 (batch_size, seq_len, *)
    norm_first=True,             # 子层顺序:True=pre-LN(LSDA),False=post-LN(SDAL)
)
self.fc_out = nn.Linear(d_model, tgt_vocab_size)
为什么输入输出要自己实现(材料给了两条理由):① 模型不建议绑定数据参数;② 要支持推理/预测阶段的变长输入。因此工程上常用可学习位置编码 nn.Embedding(max_len, d_model),max_len 取句子长度分布的 2~4 倍。
四个 mask 参数,语义必须背清楚(True 一律表示”被遮蔽”):
| 参数 | 形状 | 作用位置 |
|---|---|---|
tgt_mask |
(tgt_seq_len, tgt_seq_len) 上三角,对角线下为 False |
解码器的因果掩码,只看当前及之前 |
src_key_padding_mask |
(batch_size, src_seq_len) |
编码器自注意力(源序列的 <PAD>) |
tgt_key_padding_mask |
(batch_size, tgt_seq_len) |
解码器掩码自注意力(目标序列的 <PAD>) |
memory_key_padding_mask |
(batch_size, src_seq_len),等于 src_key_padding_mask |
解码器的交叉注意力(源序列的 <PAD>) |
课件给了两个真实的工程提示:
batch_first=True只是把(S, B, D)换成(B, S, D),不改语义;- 当
norm_first=True时会看到一条 UserWarning:enable_nested_tensor is True, but self.use_nested_tensor is False because encoder_layer.norm_first was True,这是 Pre-LN 与嵌套张量优化不兼容的正常提示,不是 bug。
参数量小例子(用课件作业的真实输出,逐项手算可对上)。以 nn.TransformerEncoderLayer(d_model=64, nhead=4, dim_feedforward=128) 为例:
| 组件 | 计算 | 参数量 |
|---|---|---|
| 自注意力 W_Q,W_K,W_V | 3\times64\times64+3\times64 | 12 480 |
| 自注意力 W_O | 64\times64+64 | 4 160 |
| FFN linear1 | 64\times128+128 | 8 320 |
| FFN linear2 | 128\times64+64 | 8 256 |
| norm1 + norm2 | 2\times(64+64) | 256 |
| 单层合计 | 33 472 |
两层即 66 944,与课件作业 2 打印的 总参数量: 66,944 完全一致。作业 3 的三组配置同理:
| 配置 | 2 层参数量(课件实测) |
|---|---|
| d_model=64, nhead=4, dim_ff=256 | 99,968 |
| d_model=128, nhead=8, dim_ff=512 | 396,544 |
| d_model=256, nhead=8, dim_ff=1024 | 1,579,520 |
结论(材料原话):d_model 翻倍时,参数量约增加 4 倍,因为线性层参数量与 d_{model}^2 成正比。用 base 配置再粗估一次:每层 \approx 4d^2+2d\,d_{ff}=4\times512^2+2\times512\times2048\approx3.15\text{M},编码器 6 层 + 解码器 6 层 ≈ 37.7M(还没算 embedding 与输出线性层,输出层 512\times4000\approx2.05\text{M} 本身就不小)。
五、易错点与常见误解
- 常见说法:位置编码是拼接到词向量后面;实际上,是逐元素相加(x\cdot\sqrt{d_{model}} \oplus PE),形状保持 d_{model} 不变。→ 因为拼接会改变特征维度、让后续每层的 d_{model} 变动;相加则保证”同一维度同时承载语义与位置”。
- 有人以为 Mask 会把
<PAD>位置删掉/置零输入;实际上,Mask 只作用在注意力分数上(加 -10^9 后 softmax 权重≈0),token 仍在张量里、形状不变。→ 材料 4.5 明确写了”Mask 不删 token,只屏蔽注意力分数”。 - 常听到的一种说法是:掩码里
True表示”可见”;实际上,True= 被遮蔽(padding 的<PAD>位置、causal 的未来位置)。→ 少写一个取反,训练就会在 PAD 上”学”东西。另外常见 tensorflow/nn.MultiheadAttention语境里True也可能表示”可见”,跨框架复用代码时必须逐个核对语义。 - 容易想岔的地方:因果掩码升维后随手和 3D 分数相加;实际上,先核对形状。课件代码里有一个真实暴露的广播坑:单头路径下
scores是(4, 10, 10),因果掩码升维成(1, 1, 10, 10),masked_fill之后形状变成(1, 4, 10, 10),batch 被挤到第 1 维,打印输出确实出现输出output: torch.Size([1, 4, 10, 512])、注意力权重attention_weights: torch.Size([1, 4, 10, 10]);而多头路径因为scores本来就是(4, 8, 10, 10),与(1,1,10,10)广播后仍是(4, 8, 10, 10),错误被掩盖。→ 写法上要么保证 mask 升到与 scores 同秩且维度对齐,要么加assert scores.shape校验。 - 先说一个误解:
LayerNorm里torch.std之后再平方开方是错的;实际上,数值上恰好等价(std已开方,平方回到方差,再开方又是标准差),但语义绕了一圈,容易在改成torch.var或手算时出错;直接写 1/\sqrt{\sigma^2+\epsilon} 更清楚。→ 另一个高频错误是归一化的轴选错:LayerNorm 归一化的是最后一维(特征维),不是序列维、也不是 batch 维。 - 常见说法:多头注意力会显著增加参数量;实际上,参数量不变:h 个头每头 d_{head}=d_{model}/h 维,h\times(d_{model}\times d_{head})=d_{model}^2。真正增加的是中间张量(
(B, H, S, S)的注意力矩阵)和少量重排开销。 - 有人以为多头的”拼接”需要学习怎么拼;实际上,Step 2 切分、Step 4 拼接都是固定操作、无参数;学习只发生在 Step 1(QKV 投影)和 Step 5(输出投影)。
- 常听到的一种说法是:Transformer 原论文和工程实现是同一个结构;实际上,两处差异:① 子层顺序 SDAL(Post-LN)→ LSDA(Pre-LN);② 原论文编码器末尾没有 LayerNorm,主流工程实现补了一个。→ 写代码/回答被追问时不要混着说。
- 容易想岔的地方:训练和推理都是逐 token 的;实际上,训练靠”右移一位 + 因果掩码”一次前向并行算完全部位置;推理没有未来信息,必须自回归,只能用 KV cache 加速。
- 先说一个误解:
nn.Transformer自带词嵌入和输出层;实际上,它只含编码器-解码器,词嵌入、位置编码、输出线性层都要自己写;相应地 mask 也得自己构造,而且是四个参数。 - 常见说法:训练时在输出层手动过一遍 softmax;实际上,用
nn.CrossEntropyLoss时传 logits(它自带 softmax)。 - 有人以为
max_len设成训练集最大长度就够;实际上,材料建议取句子长度分布的 2~4 倍,因为模型不该绑定数据参数,且推理阶段要支持变长输入。
六、横向对比与研究脉络
6.1 序列建模三种范式
| 维度 | RNN / LSTM / GRU | CNN(TextCNN) | Transformer(Self-Attention) |
|---|---|---|---|
| 核心原理 | 时间步循环 + 门控状态传递 | 固定窗口卷积滑过序列 | 任意两位置加权交互 + 位置编码 |
| 依赖路径长度 | O(n) | O(n/k)(堆叠后缩短) | O(1) |
| 序列方向并行 | ✗ | ✔ | ✔ |
| 每层计算量 | O(n\cdot d^2) | O(n\cdot k\cdot d^2) | O(n^2\cdot d)(自注意力)+ O(n\cdot d\cdot d_{ff})(FFN) |
| 长序列代价 | 长依赖衰减,梯度问题 | 感受野受限 | 注意力矩阵 O(n^2) 时间/显存 |
| 典型适用 | 中小规模序列、流式 | 短文本分类、局部 n-gram | 大规模预训练、翻译、通用骨干 |
材料第 1 章还有一张”无 Attention 的 RNN 在长句上性能快速下降”的实验曲线作为实证支撑:
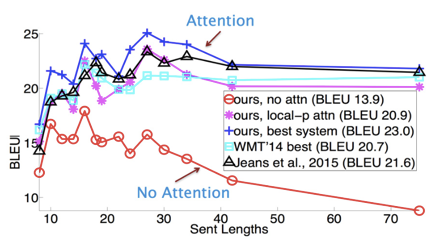
图注:横轴 Sent Lengths(句子长度 10~70+),纵轴 BLEU。图中 5 条曲线(含图例给出的整体 BLEU):ours, no attn(红圈,BLEU 13.9)随句子变长明显下滑,70 词附近跌到 10 出头;ours, local-p attn(品红星,20.9)、ours, best system(蓝十字,23.0)、WMT'14 best(青方块,20.7)、Jeans et al., 2015(黑三角,21.6)在中长句上基本持平在 20~23 之间。图上两处文字标注分别指向上升/持平的那一簇(Attention)与下滑那条(No Attention),这就是”用 Attention 编码长距离信息”的直接实验证据。
6.2 产业与学术地位
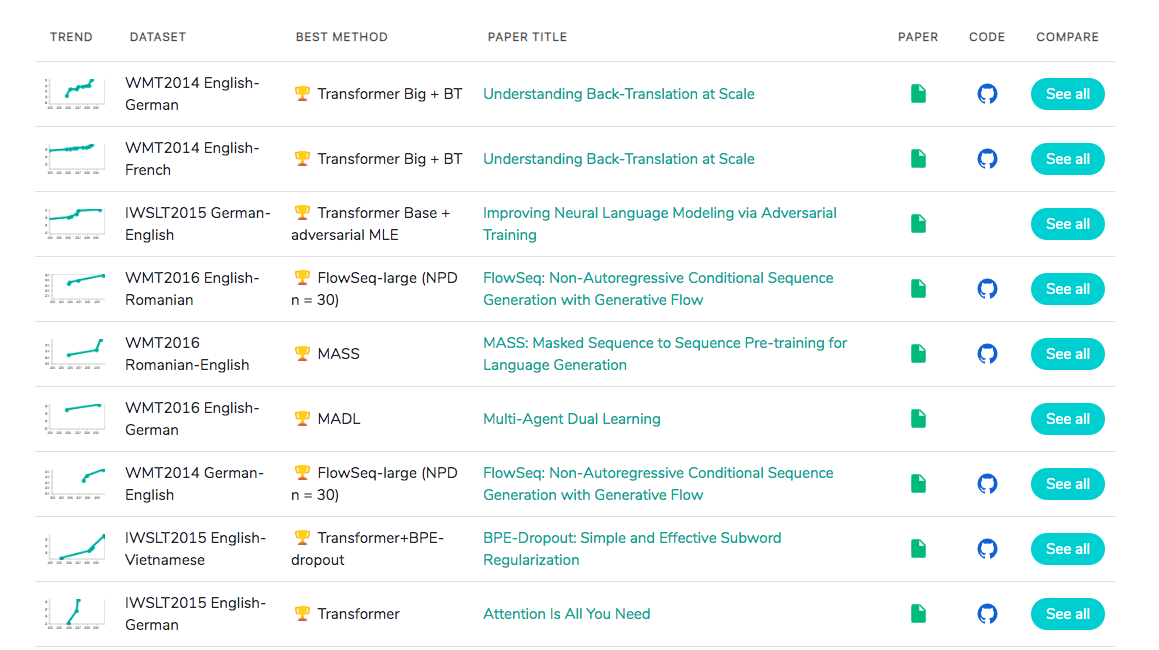
图注:机器翻译任务的榜单页截图(paperswithcode 风格),表头为 TREND / DATASET / BEST METHOD / PAPER TITLE / PAPER / CODE / COMPARE,逐行列出各数据集当前的最佳方法。可见行的 BEST METHOD 一栏全部是 Transformer 家族:Transformer Big + BT(WMT2014 English-German、English-French)、Transformer Base + adversarial MLE(IWSLT2015 German-English)、FlowSeq-large (NPD n = 30)(WMT2016 English-Romanian、WMT2014 German-English)、MASS(WMT2016 Romanian-English)、MADL(WMT2016 English-German)、Transformer+BPE-dropout(IWSLT2015 English-Vietnamese)、Transformer(IWSLT2015 English-German,论文标题即 Attention Is All You Need)。材料据此下的判断是:Transformer ≈ 现代 NLP 的基础设施。
6.3 位置编码的三条路线
| 路线 | 形式 | 优点 | 缺点 |
|---|---|---|---|
| 正余弦(Sinusoidal,本材料 3.3) | 固定公式,\sin/\cos 多频率 | 无需训练、有相对位置线性性质、可外推到更长序列 | 表达力受固定函数限制 |
| 可学习(Learned,材料第 9 章工程实现) | nn.Embedding(max_len, d_model) |
灵活、实现简单、跟随数据分布 | 超出 max_len 无法外推,需重训 |
| 旋转位置编码 RoPE(材料高频题提到) | 对 Q/K 施加旋转矩阵 | 相对位置性质好,长上下文友好 | 需要在注意力内部改动 |
6.4 归一化与子层顺序
| 对比项 | BatchNorm | LayerNorm |
|---|---|---|
| 归一化方向 | 沿 batch 维:同一特征、不同样本 | 沿 feature 维:同一样本、不同特征 |
| 对 batch size 的依赖 | 强(小 batch 不稳) | 无 |
| 训练/推理行为 | 统计量不同(需 running mean/var) | 一致 |
| 典型场景 | CNN 视觉任务 | Transformer / RNN 等序列建模 |
| 对比项 | Post-LN(SDAL,原论文) | Pre-LN(LSDA,主流工程) |
|---|---|---|
| 顺序 | Sublayer → Dropout → Add → LayerNorm | LayerNorm → Sublayer → Dropout → Add |
| 残差路径 | 被 LN 反复改写 | 干净的直通路径 |
| 深层训练 | 不稳,强依赖 warmup | 稳定,可弱化/去掉 warmup |
nn.Transformer 参数 |
norm_first=False |
norm_first=True |
6.5 演进关系(这份材料讲得清的脉络)
RNN/LSTM(循环、串行、长依赖衰减)
   └─ 注意力机制:让解码器在编码器所有隐藏状态上加权取用(仍是 RNN 骨架)
        └─ Transformer(2017):把注意力提为主干,删掉循环 → 任意位置直接交互 + 位置编码
             ├─ 只取 Encoder(双向、无因果掩码)→ BERT 系列:理解/分类/抽取
             ├─ 只取 Decoder(因果掩码 + 自回归)→ GPT 系列:生成/对话
             └─ 保留 Encoder-Decoder → 机器翻译、摘要等 seq2seq 任务
七、在新闻分类项目中的落地
新闻分类项目(新闻标题 10 分类,TF-IDF+随机森林 → FastText → BERT 微调 → LLM 零样本/少样本)里,这份材料直接对应第三条路线 BERT 微调,也是解释”为什么慢、为什么贵、参数该调哪儿”的理论依据。
1)BERT 为什么只要 Encoder。BERT 做的是分类/理解,输入是完整的一整句标题,不存在”生成下一步”的问题,因此不需要因果掩码、不需要解码器、不需要交叉注意力。它拿的就是这里的编码器(N 层 × 多头自注意力 + FFN + Add&Norm),再在句首加 [CLS] 位的表示接一个分类头。理解了 4.9 节的编码器数据流(形状全程保持 (B, S, d_model)),就理解了为什么 BERT 的输出天然可以”每层、每个 token 都拿去做下游任务”。
2)max_len / 截断填充 / attention_mask 的来历。标题长度参差不齐,要 batch 就得 padding 到固定长度,这正对应材料第 4 章的 padding mask。HuggingFace tokenizer 返回的 attention_mask 就是这里的 padding_mask(1=有效、0=PAD,注意语义方向与手写版相反,用 .to(torch.bool) 后要核对 True 到底代表谁),max_length=64(标题场景通常够)和 truncation=True, padding='max_length' 一起决定了计算量。项目里最容易出问题的地方:训练时忘了把 attention_mask 传给模型,模型就会把 <PAD> 当成真实 token 去算注意力,指标悄悄掉几个点,且很难 debug。
3)关键参数怎么调。微调 BERT 时学习率必须压小(典型 2e-5 ~ 5e-5),原因就写在 4.7 节:LayerNorm + 残差让浅层梯度可以直达,但也让预训练权重非常”敏感”,大学习率会直接破坏预训练学到的表示(灾难性遗忘)。batch size 视显存取 16/32,配合 warmup 与线性衰减。层数/头数一般不动(d_model=768, h=12 的 base 配置),能动的是 max_length、batch size、epoch 数。
4)实际坑。
- 显存与序列长度是平方关系:标题短(n\approx20\text{~}30),注意力开销极小,此时 FFN 才是算力大头(对照 4.13 的粗算表,n=1024 才是交叉点),所以想让推理更快,先动 FFN 宽度和层数,而不是先想注意力优化;
- 训练可以并行、推理不行:BERT 只做一次前向就出 10 类 logits,所以比生成式模型快得多,这也是”为什么分类任务优先用 BERT 而不是 LLM”的硬理由;
- 位置编码与数据长度:换成自训练的小 Transformer 时,
max_len要按标题长度分布取 2~4 倍余量;用 BERT 则受其 512 上限约束(标题场景完全够用)。
5)与其它三种方案的配合关系。
| 方案 | 与 Transformer 的关系 | 在项目里的角色 |
|---|---|---|
| TF-IDF + 随机森林 | 完全不含注意力/嵌入,纯统计特征 + 树模型 | 基线,用来量化”上神经网络值多少分” |
| FastText | 词向量平均 + 线性分类,无位置、无注意力、无顺序建模 | 轻量基线,证明”有词向量还不够” |
| BERT 微调 | 本材料编码器的直接工业化形态 | 主力模型,10 分类精度担当 |
| LLM(DeepSeek API 零样本/少样本) | Decoder-only,因果掩码 + 自回归 + KV cache | 无标注/新类别快速兜底,但成本与延迟高 |
6)模型压缩的落点。项目最后一环是量化/蒸馏/剪枝。对照 4.8 与 4.13 的参数量分析:线性层(FFN 的 W_1,W_2 与注意力投影)贡献了绝大部分参数,也是量化(quantize_dynamic)、低秩分解、非结构化剪枝的主要目标;LayerNorm(每层只有 2d 个参数)几乎不值得动。做知识蒸馏时,教师模型的”中间层输出”就是这里编码器逐层的 (B, S, d_model) 表示,”软标签”就是输出部分 softmax 后的概率分布,这就是项目蒸馏损失 loss = (1-alpha)*hard_loss + alpha*(T*T)*soft_loss 里 F.kl_div() 两个分布的对象来源。
八、重点问答
Q1:讲一下 Transformer 的整体架构?
A:我从”四大部分”来记。第一是输入部分,源序列和目标序列各有一套”词嵌入 + 位置编码”,词嵌入乘 \sqrt{d_{model}} 做尺度对齐,位置编码是相加不是拼接。第二是编码器,N 层堆叠,每层两个子层:多头自注意力 + Add&Norm、前馈网络 + Add&Norm。第三是解码器,N 层堆叠,每层三个子层:带因果掩码的多头自注意力、多头交叉注意力(Q 来自解码器、K/V 来自编码器输出)、前馈网络,每个子层同样配 Add&Norm。第四是输出部分:线性层把 d_{model} 映射到词表维度,Softmax 得到概率分布。整个结构的核心是”用自注意力替代循环”,让任意两个位置直接交互,从而既能并行训练,又不受依赖路径长度的限制。
Q2:为什么需要位置编码?正余弦编码为什么能表达相对位置?
A:自注意力对输入是置换等变的,把词序打乱,输出只是跟着打乱,模型自己区分不出顺序,所以顺序信息必须显式注入。正余弦编码的公式是偶数维 \sin(pos/10000^{2i/d})、奇数维 \cos(pos/10000^{2i/d}),不同维度用不同频率,低维变化快、高维变化慢,等于给每个维度配了一把不同刻度的尺子。它之所以能表达相对位置,是因为对同一对维度,PE_{pos+k} 正好等于 PE_{pos} 乘上一个只依赖偏移 k、与 pos 无关的旋转矩阵,也就是说”相距 k 个位置”这件事在编码空间里有统一的线性表达,模型不用为每个绝对位置单独记忆。工程上还有两种替代方案:可学习的 nn.Embedding(max_len, d_model),以及 RoPE 旋转位置编码。
Q3:多头注意力的作用是什么?参数量会变多吗?
A:作用一句话概括是”多个视角 × 并行计算 × 信息融合”。单头只能在一个注意力空间里建模,容易偏向某一类关系,比如只学局部或只学全局;拆成 8 个头后,不同的头可以在各自的子空间里分别关注不同的依赖类型,表达能力和稳定性都更好。参数量不会变多:设 d_{model}=512、h=8,每头 64 维,h\times(d\times d_{head})=d^2,所以 Q/K/V/O 四个投影加起来还是 4d^2,8 个头总和与单头 512 维完全相等。需要提醒一点:真正的学习能力在 Step 1 的 QKV 投影和 Step 5 的输出投影上,中间”切分”和”拼接”都是固定操作,不含参数。
Q4:注意力里为什么要除以 \sqrt{d_k}?
A:为了让 softmax 的输入尺度稳定。假设 Q、K 的每一维近似独立、方差为 1,那么点积 \sum q_ik_i 的方差就是 d_k,d_k 越大,分数绝对值的量级越大。分数过大时 softmax 会饱和,最大项接近 1,其余接近 0,梯度几乎消失,训练推不动。除以 \sqrt{d_k} 把方差拉回 1,分布保持在 softmax 的线性区间。顺带一个代码层面的坑:手写多头时注意这里的 d_k 应该是每个头的维度 d_{head},而不是 d_{model}。
Q5:残差连接和 LayerNorm 的作用?Pre-LN 和 Post-LN 有什么区别?
A:残差让梯度可以绕过子层直接回传,解决深层网络的退化问题;LayerNorm 把每个位置的特征维标准化(\gamma\frac{x-\mu}{\sqrt{\sigma^2+\epsilon}}+\beta),解决内部协变量偏移、让梯度更稳、收敛更快,也降低对初始权重的依赖。顺序是关键差异:原论文是 Post-LN,即 LN(x + Dropout(Sublayer(x))),归一化放在残差相加之后;主流工程实现改成 Pre-LN,即 x + Dropout(Sublayer(LN(x))),归一化放在子层入口。Post-LN 的残差主干被反复归一化,层数一深就训练不稳、强依赖 warmup;Pre-LN 让残差路径变成干净的直通路径,训练稳定得多,所以现代大模型基本都用 Pre-LN,nn.Transformer 里就是 norm_first=True。另外工程上会在编码器/解码器堆叠末尾再加一个 LayerNorm,原论文没有。
Q6:前馈网络 FFN 的作用是什么?为什么说参数主要在 FFN?
A:FFN 是两层线性层夹一个 ReLU:W_1 把 d_{model} 升到 d_{ff},W_2 再降回来,作用是在注意力之后补一个非线性变换,提升模型表达能力。它还有一个常被忽略的特点:它是逐位置的,同一个 FFN 独立作用于序列上每个位置,位置之间不交流信息,所有跨位置的信息交换都在注意力层完成。参数量上,以 base 配置算:注意力 4d^2=4\times512^2\approx1.05\text{M},FFN 2\times d\times d_{ff}=2\times512\times2048\approx2.10\text{M},FFN 是注意力的两倍。所以”Transformer 参数大头在 FFN”,这也决定了做量化、剪枝、蒸馏时的主要目标就是这些线性层。
Q7:Mask 有哪几种?分别用在哪里?实现上怎么做?
A:常用的两类。Padding Mask 形状 (batch_size, seq_len),用来屏蔽填充的 <PAD>,编码器自注意力、解码器自注意力、交叉注意力都要用;Causal Mask 形状 (seq_len, seq_len) 上三角矩阵,只用在解码器的自注意力和里,保证第 t 个位置只能看到当前及之前、看不到未来。实现上有三个要点:一是 mask 不是删 token,而是作用在注意力分数上,在 softmax 前把被遮位置换成 -10^9(或 -inf),它们的权重就趋近 0;二是布尔语义要统一,我这边约定 True 表示”被遮蔽”,False 表示”可见”,torch.triu(torch.ones(L, L), diagonal=1) 生成的正是这样的因果掩码;三是形状要对齐,mask 本身是 2D,但分数是 (B, H, Q, K),所以要在注意力内部升维,padding mask 变成 (B, 1, 1, K),因果掩码变成 (1, 1, Q, K),再靠广播相加。这里我踩过一次广播坑:3D 分数配 (1,1,Q,K) 掩码会静默广播成 (1,B,Q,K),形状错了但不报错,所以要么保证同秩,要么加 assert。
Q8:训练阶段和推理阶段有什么不同?
A:训练阶段可以并行:目标序列右移一位,靠因果掩码保证每个位置只能看到自己及之前,于是一次前向就能得到所有位置的 logits,和真实标签逐位置算交叉熵,序列方向的并行度就是序列长度。推理阶段只能自回归:不存在”未来”标签,必须先生成第 1 个词、拼回输入、再算第 2 个,逐 token 前进;编码器的输出可以只算一次、反复复用,所以工程上会把 encode 和 decode 拆开。加速的关键是 KV cache:已生成 token 在各层的 K、V 不会再变,缓存起来,每步只为新 token 算 Q 和缓存做点积,复杂度从”每步重算整段”降到”每步只算一个新位置”,这也是大模型推理显存随上下文长度线性增长的原因。
Q9:Transformer 相比 RNN 的优势和代价是什么?复杂度如何?
A:优势有三条:并行,非递归结构,整段序列一次参与计算,把 RNN 的 n 次串行小矩阵乘变成几次批量大矩阵乘,硬件利用率完全不同;依赖路径短,任意两个位置直接交互,路径长度 O(1),而 RNN 是 O(n),长句和跨段依赖更稳;结构统一,多头注意力 + FFN 是整齐的基本模块,堆叠和扩参很直接,非常适合大规模预训练。代价主要在复杂度:每层自注意力是 O(n^2\cdot d) 时间和 O(n^2) 的注意力矩阵显存,序列翻倍开销涨 4 倍;RNN 是 O(n\cdot d^2) 但完全串行。具体谁主导要看序列长度:短序列(n<d_{ff}/2,base 配置大约是 1024)时 FFN 是大头,长序列时注意力反超并快速主导,所以长文本的优化重点全在注意力,像稀疏注意力、滑窗注意力这些方向。
Q10:LayerNorm 和 BatchNorm 的区别?
A:区别在归一化的方向。BatchNorm 沿 batch 维做,即”同一个特征、不同样本之间”统计均值和方差,依赖 batch size,小 batch 时统计量不稳,训练和推理行为还不一样(要用 running mean/var),典型用在 CNN 视觉任务。LayerNorm 沿 feature 维做,即”同一个样本、不同特征之间”,跟 batch 无关,训练推理行为一致,样板长度不齐、序列建模场景更合适,Transformer 和 RNN 都用它。另外值得一提:Transformer 里如果用 LayerNorm,加上残差就能让每一层的输入分布保持稳定,这是能堆到几十上百层的前提。
九、延伸阅读
论文 / 文献
- Vaswani et al., Attention Is All You Need, 2017,本材料的原始出处,课件给出的地址:https://arxiv.org/pdf/1706.03762.pdf(也正是榜单截图里 IWSLT2015 English-German 那行的最佳方法论文)。
- RoPE(旋转位置编码,RoFormer):材料在高频题里点名的位置编码替代方案,用于理解”位置编码的演进”。
- 长序列注意力方向(稀疏/滑窗注意力等):对应第 4.13 节 O(n^2) 瓶颈的工程解法,可作为”Transformer 之后发生了什么”的延伸。
官方文档 / 工具
- PyTorch
torch.nn.Transformer/TransformerEncoderLayer/TransformerDecoderLayer:https://pytorch.org/docs/stable/generated/torch.nn.Transformer.html,重点读norm_first、batch_first和四个 mask 参数。 - PyTorch
torch.nn.LayerNorm/torch.nn.Embedding/torch.nn.MultiheadAttention:理解normalized_shape、初始化分布、注意力实现细节。 torch.triu/torch.masked_fill/torch.arange/torch.exp:构造两类掩码、计算div_term的全部工具。matplotlib.pyplot.matshow:可视化掩码矩阵与注意力权重热力图(课件用它验证”被遮位置权重为 0″)。
课程内后续材料(同目录)
day08_Transformer英译法案例:把本份手写的 Transformer 训练成可用的英译法模型。day11_transformers迁移学习:HuggingFace transformers 微调,新闻分类项目 BERT 路线的直接实现。day12_BERT与GPT架构:只取 Encoder 与只取 Decoder 两条分支的对照。day04_注意力机制:本份的前置,先理解 Q/K/V 加权融合的直觉再回来看多头。