序列建模里”同时看左右两边上下文”的最早、最经典的工程解法,用两个方向相反的 LSTM 各扫一遍序列,再把同一位置的输出拼起来。
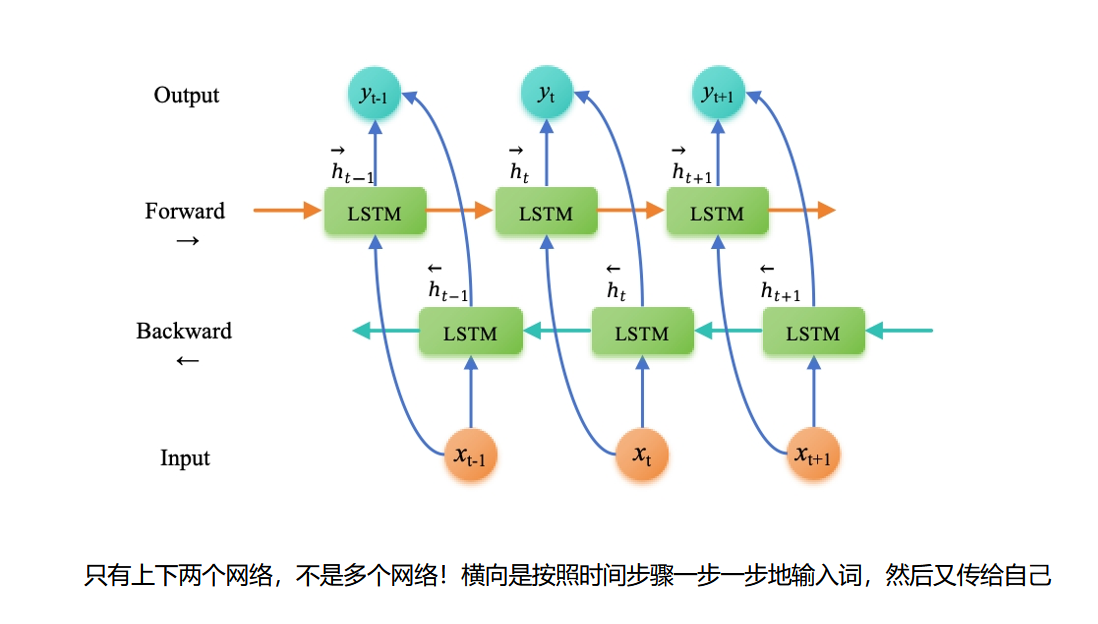
图注:原图是一张标准的 BiLSTM 展开图,纵向分四层:Input(输入 x_{t-1}, x_t, x_{t+1},橙色圆)→ Backward ←(绿色 LSTM 块,箭头向左,携带 \overleftarrow{h})→ Forward →(绿色 LSTM 块,箭头向右,携带 \overrightarrow{h})→ Output(输出 y_{t-1}, y_t, y_{t+1},青色圆)。两条蓝色曲线把同一时间步的前向隐状态 \overrightarrow{h}_t 与后向隐状态 \overleftarrow{h}_t 汇到同一个输出节点 y_t。图下红字是讲师的重点提醒:”只有上下两个网络,不是多个网络!横向是按照时间步一步一步地输入词,然后又传给自己”,即横向的重复方块是同一层的时间展开,不是堆叠。
一、这份材料解决什么问题
单向 RNN/LSTM 有个硬伤:读第 t 个词时,它只能看到前面的词。但自然语言的含义往往由后面的词决定。最经典的例子:
“我去银行取钱” / “我在河边散步,走到银行”
中文的”银行”两个字在两种语境里字面完全相同,只有靠后文的”取钱”或”河”才能区分。单向模型在读到”银行”的瞬间,还没看到后面的词,就把它编码成一个错误含义的向量,而错误一旦写进隐状态就很难修正。
BiLSTM 的解法直白而有效:既然一个方向看不见,那就再派一个反方向读一遍。
它也是新闻分类项目技术演进上重要的一环,BERT 的双向注意力,正是”让每个位置同时看到左右两边”这一诉求在 Transformer 上的进一步实现。
二、核心结论
- BiLSTM 就是两个独立 LSTM 层,一个从左到右读(前向 \overrightarrow{h}),一个从右到左读(后向 \overleftarrow{h}),两者共享同一份输入序列。
- 横向的重复方块是”时间展开”,不是多层堆叠,原图红字专门强调这一点,因为这是初学者最常见的误解。
- 每个时间步的输出是前后两个隐状态的拼接:h_t = [\overrightarrow{h}_t\,;\overleftarrow{h}_t],因此输出维度是单层的 2 倍。
- 两个方向的参数不共享:前向和后向各有一套独立权重(W_f 与 W_b),它们是两个不同的模型。
- BiLSTM 要求看到完整序列,因此不能用于自回归生成(在线流式预测、机器翻译解码器),它只能用在”编码器”一侧。
三、知识地图
| 层(自下而上) | 元素 | 说明 |
|---|---|---|
| Input | x_{t-1}、x_t、x_{t+1} | 按时间步依次送入,每个时间步一个词向量 |
| Backward ← | 3 个绿色 LSTM 块,箭头向左 | 反向链:从最后一个词读回第一个词,产出 \overleftarrow{h} |
| Forward → | 3 个绿色 LSTM 块,箭头向右 | 正向链:从第一个词读到最后一个词,产出 \overrightarrow{h} |
| Output | y_{t-1}、y_t、y_{t+1} | 接收同位置的前向与后向隐状态,得到该位置的最终表示 |
| 蓝色曲线 | 从 \overrightarrow{h}_t、\overleftarrow{h}_t 各自汇入 y_t | 表示”两个方向在同一位置汇合” |
| 底部红字 | “只有上下两个网络,不是多个网络!横向是按照时间步一步一步地输入词,然后又传给自己” | 时间展开 vs 层堆叠的区分 |
三个方向的箭头要分清:
输入流:      水平向右(按时间步推进)—— 两个 LSTM 都接收
前向隐状态流:水平向右,h→ 从 t-1 传给 t
后向隐状态流:水平向左,h← 从 t+1 传给 t
输出汇聚:    垂直向上,同位置的 h→ 与 h← 一起进入 y
图中标在上方的 \overrightarrow{h}_{t-1},\overrightarrow{h}_t,\overrightarrow{h}_{t+1} 是前向链的隐状态;标在下方的 \overleftarrow{h}_{t-1},\overleftarrow{h}_t,\overleftarrow{h}_{t+1} 是后向链的隐状态。注意后向链虽然箭头向左,但它在每个位置都产出一个隐状态,所以每个位置都能拿到”从右边看过来”的表示。
四、原理详解
4.1 先把”时间展开”和”层堆叠”彻底分清
原图底部那句红字是全图最重要的一句话。初学者看到三组 LSTM 方块,第一反应常常是”这是三层 LSTM”。不是。
【时间展开(正确理解)】—— 一个 LSTM 单元在三个时刻被重复使用
   t-1        t          t+1
  [LSTM] →  [LSTM] →   [LSTM]      参数只有一套(同一个单元)
    ↑          ↑          ↑
   x_{t-1}    x_t        x_{t+1}

【层堆叠(错误理解)】—— 三个不同的 LSTM 层
  [LSTM 1] ← 接收输入
  [LSTM 2] ← 接收 LSTM 1 的输出
  [LSTM 3] ← 接收 LSTM 2 的输出
判断依据:横向的方块之间有一条水平箭头(表示”把隐状态传给下一个时间步”),这就是时间展开;如果是层堆叠,第二个方块会接收第一个方块的完整输出但时间步位置不变(通常是竖直箭头)。
为什么会混淆:RNN 一族的计算图天生就是”同一个函数的重复调用”,画出来像多层,实际参数是共享的。这一点在数参数量时最关键,一个 d 维隐状态的单层 LSTM 参数量约为 4\times(d^2 + d\cdot d_{in}),和序列长度无关。
4.2 前向链和后向链分别干什么
前向链(\overrightarrow{h}):与普通单向 LSTM 完全一样。
\overrightarrow{h}_t = \mathrm{LSTM}_f(x_t,\ \overrightarrow{h}_{t-1}),\qquad t = 1,2,\dots,T
后向链(\overleftarrow{h}):把输入序列倒序送入另一个 LSTM。
\overleftarrow{h}_t = \mathrm{LSTM}_b(x_t,\ \overleftarrow{h}_{t+1}),\qquad t = T,T-1,\dots,1
合并方式(三种常见选择):
| 合并方式 | 公式 | 输出维度 | 特点 |
|---|---|---|---|
| 拼接(最常用) | h_t = [\overrightarrow{h}_t\,;\overleftarrow{h}_t] | 2d | 保留两个方向的独立信息,下游接 Linear 处理 |
| 相加 | h_t = \overrightarrow{h}_t + \overleftarrow{h}_t | d | 维度不膨胀,但两方向信息会互相干扰 |
| 平均 | h_t = (\overrightarrow{h}_t + \overleftarrow{h}_t)/2 | d | 与相加类似,数值更稳定 |
原图画的是拼接再向上汇入输出层(两条蓝线各自上升进入 y_t),对应第一种。
一个具体的小例子,假设隐状态维度 d=3,在 t 时刻:
\overrightarrow{h}_t = [0.9,\ -0.2,\ 0.4],\qquad \overleftarrow{h}_t = [0.1,\ 0.8,\ -0.6]
拼接后:
h_t = [0.9,\ -0.2,\ 0.4,\ 0.1,\ 0.8,\ -0.6]\quad(\text{维度 }6 = 2\times3)
这 6 维向量就是位置 t 的最终表示。前 3 维描述”从左边看这个位置是什么”,后 3 维描述”从右边看这个位置是什么”。下游分类头接一个 Linear(6, num_classes) 就能用它做分类。
4.3 为什么”两次单向”就能看到双向上下文
关键点是后向链的每一步也只依赖它自己那一侧的信息(它的”左”就是序列的右边)。所以:
- 前向链在位置 t 只见过 x_1 \dots x_t;
- 后向链在位置 t 只见过 x_T \dots x_t;
- 两者合并后,位置 t 的表示就同时包含了它左边和右边的全部信息。
用”银行”那个例子对比:
| 模型 | 在 t=”银行” 这个位置,表示里包含的信息 | 能否区分”取钱/河边” |
|---|---|---|
| 单向 LSTM | 只有”我去银行” | 否 |
| BiLSTM | “我去银行” + “取钱”(或”河边散步”) | 是 |
这就是原图把两条蓝线分别画到同一个输出节点上的意义:合并发生在”每个位置”,而不是只在序列末尾。这一点常被搞错,有些人以为 BiLSTM 只是”两个方向的最终状态拼起来”,那样就只有序列级表示,没有逐位置的上下文了。
4.4 与 BERT 的双向性对比(最容易被追问的点)
| 维度 | BiLSTM 的”双向” | BERT/Transformer 的”双向” |
|---|---|---|
| 实现方式 | 两次单向遍历,各自独立算完再拼接 | 自注意力一次性让每个位置 attend 到所有位置 |
| 每个位置的左右信息 | 通过两个 h 拼在一起来体现 | 在同一层内直接混合 |
| 深度上的双向 | 只有一层是双向的,多层堆叠时上一层的双向输出才进下一层 | 每一层的每个位置都是双向的 |
| 是否能看到”未来” | 编码器可以;不能用于生成 | 编码器可以;解码器用 causal mask 禁止 |
| 计算复杂度 | O(T\cdot d^2),串行(时间步之间有依赖,无法并行) | O(T^2 \cdot d),可并行(这是它取代 RNN 的关键原因) |
| 长距离依赖 | 需靠隐状态链传递,易衰减 | 任意两个位置之间路径长度为 1 |
一句话总结:BiLSTM 是”用两次顺序读取换来了双向性”,代价是无法并行;Transformer 用自注意力在一层之内同时完成双向聚合,代价是 O(T^2) 的复杂度。这就是 NLP 主干网络从 RNN 转向 Transformer 的核心动因。
4.5 为什么不能用于生成任务
BiLSTM 的后向链要读到序列最后一个词才能产出 \overleftarrow{h}_1。而在自回归生成里,生成第 t 个词时第 t+1 个词根本还不存在,后向链无从启动。
所以工程约定非常明确:
| 位置 | 可用结构 | 原因 |
|---|---|---|
| 编码器(理解任务:分类、NER、序列标注、抽取式问答) | BiLSTM / Transformer Encoder | 输入完整可见 |
| 解码器(生成任务:翻译、摘要、对话) | 单向 LSTM / causal Transformer | 不能看到未来 |
| 流式/在线场景(实时字幕、逐字输入) | BiLSTM | 拿不到完整序列 |
新闻分类项目的任务(给一个新闻标题输出类别)属于编码器型任务,所以双向结构可用,这也是它后面能直接换成 BERT 的根本原因。反过来,如果任务是”根据标题生成摘要”,那就只能用解码器结构。
五、易错点与常见误解
| 常见说法 | 正确说法 | 为什么 |
|---|---|---|
| 图里三层 LSTM,所以是三层 BiLSTM | 横向是同一层的时间展开,图中只有”前向一层 + 后向一层” | 原图红字专门强调:”只有上下两个网络,不是多个网络” |
| 两个方向共享参数,只是读取顺序不同 | 前向和后向是两个独立的 LSTM,各有一套权重 | 若共享参数,反向读取会得到无意义的结果 |
| 两个方向的最终隐状态拼起来就是输出 | 是每个时间步都拼接(逐位置输出),不是只在序列末尾合并 | 原图两条蓝线在每个 t 都汇入 y_t |
| BiLSTM 输出维度不变 | 拼接时维度翻倍(d\to 2d),下游层输入维度要相应调整 | 这是接分类头时最常见的 shape 错误来源 |
| BiLSTM 也可以当解码器用 | 不能,它必须看到完整序列 | 自回归生成时未来词不存在,后向链无法工作 |
| BiLSTM 比单向强很多,所以一定用它 | 只在”上下文双向都有用”的任务上强;生成任务会直接崩 | 结构必须匹配任务类型 |
| BiLSTM 和 BERT 的双向是一回事 | 一个是”两次单向遍历后拼接”,一个是”层内一次性全局注意力” | 并行性与复杂度完全不同 |
六、横向对比与研究脉络
序列编码结构演进对比:
| 结构 | 上下文方向 | 并行性 | 长距离依赖 | 复杂度 | 代表时代 |
|---|---|---|---|---|---|
| 单向 RNN/LSTM | 仅左侧 | 串行 | 弱(梯度衰减) | O(T d^2) | 2014 前 |
| BiLSTM | 左右(拼接) | 串行 | 中 | O(T d^2) | 2015–2018 主流 |
| BiLSTM + Attention | 左右 + 全局加权 | 串行 | 强 | O(T d^2) | 2016–2018 |
| Transformer Encoder | 全局(层内) | 全并行 | 强 | O(T^2 d) | 2017 起 |
| BERT(多层 Encoder) | 全局、每层双向 | 是 | 强 | O(T^2 d) | 2018 起 |
演进脉络:
- RNN(Elman/Jordan):引入隐状态传递,能建模变长序列,但单向且梯度易消失。
- LSTM / GRU:用门控机制缓解长依赖问题,但方向仍是单向。
- BiLSTM:最直接的补救方案,两个方向各扫一遍然后拼接,成为 2015–2018 年几乎所有序列标注/NER/阅读理解 SOTA 模型的标配(”BiLSTM + CRF” 是 NER 的经典组合)。
- BiLSTM + Attention:在双向表示之上再加一层注意力聚合,让”哪些位置重要”可学习。
- Transformer / BERT:把”双向”从”两次遍历”升级为”层内一次全局注意力”,同时解决了并行性问题,这才是它取代 BiLSTM 的真正原因,不只是效果更好。
与蒸馏的关系(本文件为何放在蒸馏目录):BiLSTM 是典型的序列型特征提取器。中间特征蒸馏要对齐的”中间层特征图”,在 NLP 里就是这类网络逐位置的隐状态序列 (\overrightarrow{h}_1,\dots,\overleftarrow{h}_T)。理解 BiLSTM 的输出形态(T\times 2d 的矩阵),才能理解为什么特征蒸馏要先解决”尺寸对齐”和”维度对齐”,序列长度 T 会随样本变化,这就是需要插值/池化对齐的地方。
七、在新闻分类项目中的落地
- 它是 BERT 的”前身”对照:新闻分类项目的模型对比章节里,从 FastText(词袋+平均池化,完全无序)→ 单向 RNN/LSTM(只看左侧)→ BiLSTM(左右拼接)→ BERT(层内全局双向注意力),这条线索能清楚解释为什么 BERT 效果更好:不是”层数多”,而是”上下文建模能力从局部拼接升级为全局注意力,且可以并行”。
- 解释 FastText 的天花板:FastText 把标题里所有词的 embedding 平均一下,等效于”完全无序的词袋”,连语序都丢了。BiLSTM 至少能建模顺序,所以它和 FastText 之间的差距,就是”有序 + 双向上下文”带来的收益。
- 10 分类里双向上下文的实际价值:新闻标题很短(十几个字),但同样存在”靠后文定类别”的情况,例如”某地新设养老服务中心免费开放”(社会)vs”某养老基金新设服务中心”(财经)。这类标题里,光看前半段会判错,双向上下文能救回来。
- 对应 BERT 的实现细节:BERT 最终用
[CLS]位置的向量做 10 分类,可以类比成”把所有位置的双向表示聚合成一个序列级表示”。理解 BiLSTM 的”逐位置拼接 → 池化” 流程,就自然理解 BERT 为什么要单独设一个[CLS]token 来承载全局语义。 - 和蒸馏衔接:如果学生模型用 BiLSTM(而不是 FastText),就具备了”可对齐的中间层隐状态”,中间特征蒸馏变得可行,对齐时把学生的隐状态序列 (T\times 2d_S) 通过线性投影映射到教师的 (T\times d_T),再算 MSE。这是选学生结构时值得考虑的一个加分项:FastText 快但无中间层可蒸馏,BiLSTM 稍慢但能做特征级蒸馏。
八、重点问答
Q1:画出来的 BiLSTM 有三组方块,是三层网络吗?
A:不是。横向的重复方块是同一个 LSTM 单元在时间步上的展开,不是层堆叠。判断依据是方块之间横向有箭头,表示隐状态在时间维度上传递;如果是层堆叠,那是竖向连接、接收上一层同一时刻的全部输出。所以图中只有两层:一个前向 LSTM、一个后向 LSTM。数参数量时也和序列长度无关。
Q2:BiLSTM 的前向和后向共享参数吗?
A:不共享。它们是两个独立的 LSTM,各有一套权重。因为后向链是倒序读取序列,学习的是”从右往左”的依赖模式,如果用同一套参数,反向读取会得到无意义的结果。这也是为什么 BiLSTM 的参数量大约是单向 LSTM 的两倍。
Q3:两个方向的输出怎么合并?合并后维度是多少?
A:最常用的是拼接:h_t = [\overrightarrow{h}_t ; \overleftarrow{h}_t],维度从 d 变成 2d,下游接 Linear 时要相应调整输入维度,这是实际编码里最常见的 shape 报错来源。另外也可以相加或取平均,维度保持 d,但两个方向的信息会互相干扰。
Q4:BiLSTM 为什么能”看到双向上下文”?
A:因为两个方向的表示在每个时间步都合并。前向链在位置 t 只见过 t 左边的词,后向链只见过 t 右边的词,把两者拼起来,位置 t 的表示就同时包含了左右两侧的全部信息。注意是逐位置合并,不是只在序列末尾把两个最终状态拼起来,后者只能得到序列级表示,丢掉逐位置的上下文。
Q5:BiLSTM 和 BERT 的双向有什么区别?
A:实现机制不同。BiLSTM 是用两次单向遍历,各自算完再拼接,所以时间步之间有依赖、无法并行,复杂度是 O(T d^2)。BERT 是用自注意力在一层之内让每个位置直接 attend 到所有位置,天然可并行,复杂度是 O(T^2 d)。另外 BiLSTM 只有那一层是双向的,多层堆叠时是上一层双向输出进下一层;BERT 是每一层的每个位置都是双向的。并行性才是 BERT 取代 RNN 的关键原因。
Q6:为什么 BiLSTM 不能用在生成任务上?
A:因为后向链必须读到序列最后一个词才能产出靠前位置的隐状态,而自回归生成时未来的词还不存在,后向链根本启动不了。所以约定是:编码器侧(分类、NER、抽取式问答)可以用 BiLSTM,解码器侧(翻译、摘要、对话)只能用单向结构或带 causal mask 的 Transformer。流式在线场景同样不能用。
Q7:新闻分类项目里为什么最终选 BERT 而不是 BiLSTM?
A:三个原因。第一,BERT 通过自注意力实现层内全局双向,上下文建模能力比 BiLSTM 的”两次遍历拼接”更强,长距离依赖路径更短。第二,BiLSTM 时间步之间有依赖无法并行,训练慢,而 Transformer 可以整序列并行。第三,BERT 有大规模预训练语言模型底座,在 18w 条训练数据的量级上,迁移学习的收益远大于从零训练的 BiLSTM。项目里保留了 FastText 和 BERT 的对比,就是要量化这两端之间的差距。
九、延伸阅读
- Hochreiter & Schmidhuber, Long Short-Term Memory(1997),LSTM 原始论文
- Graves & Schmidhuber, Framewise Phoneme Classification with Bidirectional LSTM(2005),BiLSTM 的早期提出
- Huang, Xu, Yu, Bidirectional LSTM-CRF Models for Sequence Tagging(2015),BiLSTM+CRF 的经典组合
- Vaswani et al., Attention Is All You Need(2017),Transformer,理解”层内双向”的来源
- 本目录《往期知识/nlp-html/day03_RNN 及其变体》研究报告,RNN/LSTM/GRU 的完整推导
- 本目录《【了解】中间特征》研究报告,特征蒸馏为什么要处理序列长度对齐
- 本目录《【掌握】Bert 原理结构极速版》研究报告,从 BiLSTM 到 BERT 的对照