蒸馏最核心的一步,把教师模型的软标签([0.7 0.2 0.1] 这样的概率向量)当成学生的监督信号,学生学到的不是”答案”,而是”答案之间的关系”。
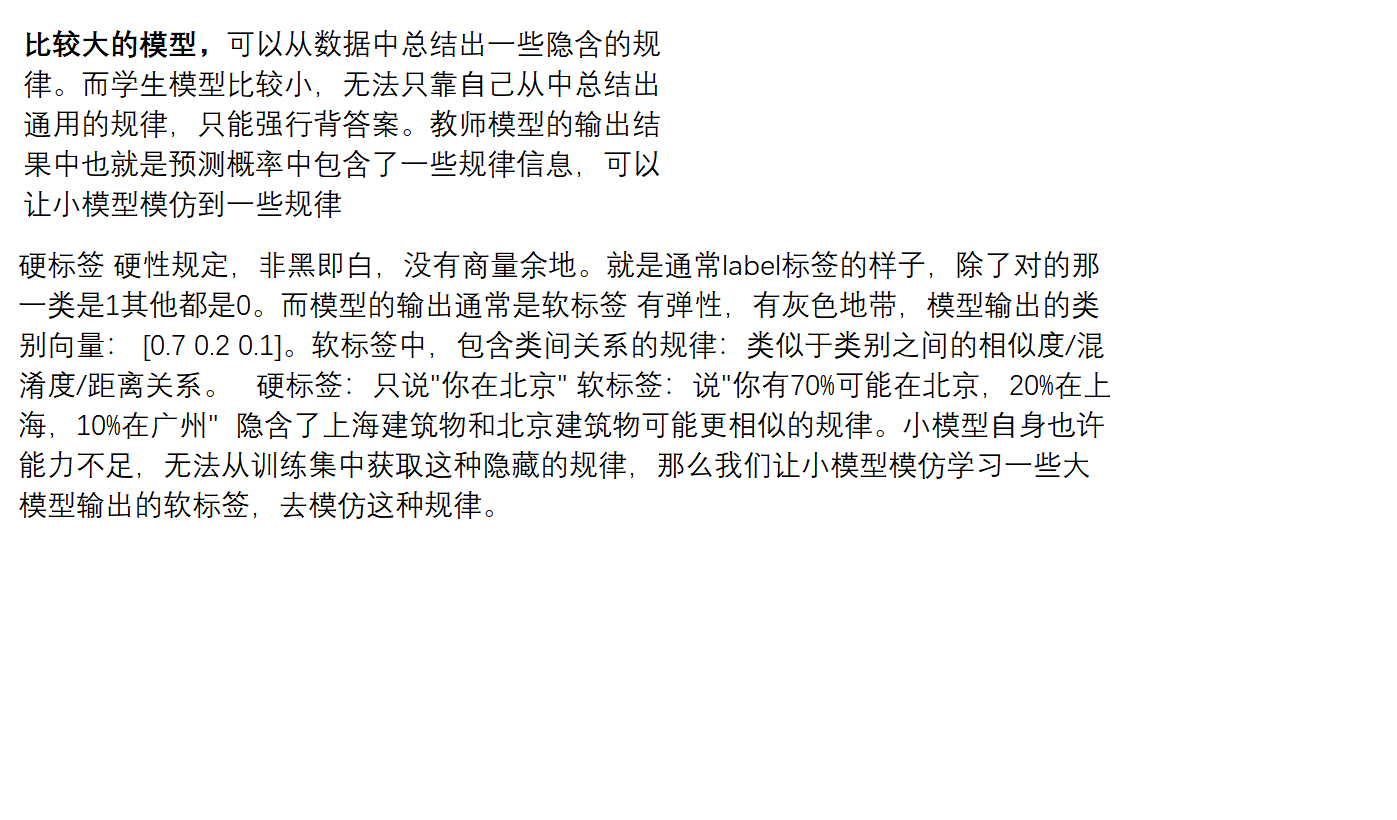
图注:原图是一段完整讲解。上半段解释为什么要蒸馏:大模型能从数据里总结出隐含规律,小模型靠自己总结不出来,只能”强行背答案”;而教师模型的输出(预测概率)里就带着这些规律信息,可以让小模型模仿。下半段对比硬标签与软标签:硬标签”非黑即白、没有商量余地”(正确类为 1、其余为 0),软标签”有弹性、有灰色地带”(如 [0.7 0.2 0.1]),并给出经典类比,硬标签只说”你在北京”,软标签说”你有 70% 可能在北京、20% 在上海、10% 在广州”,而这句”20% 在上海”里就隐含了”上海建筑与北京建筑更相似”的规律。
一、这份材料解决什么问题
模型蒸馏要回答一个看起来反直觉的问题:如果小模型有能力学出教师的效果,它早就学出来了;如果它没能力,那给它教师的答案又有什么用?
这张图给出的答案是:教师给的不只是答案,而是”答案的分布”。分类任务的输出是一个概率向量,这个向量浓缩了教师对类别之间关系的理解,而这份理解是免费附赠的监督信息,不额外花一分标注成本。学生学这个分布,等于同时学了”正确答案”和”类别之间的相似结构”。这就是蒸馏能让学生超过直接用硬标签训练的同尺寸模型的原因。
对应到新闻分类项目:蒸馏是模型压缩手段之一,而”软标签 + KL 散度 + 温度 T”就是它的标准实现配方。
二、核心结论
- 硬标签是 one-hot 向量:正确类为 1,其余全 0,信息量只有”对/错”。
- 软标签是模型的输出概率分布,如
[0.7 0.2 0.1],除了正确答案,还告诉你”次优答案是谁、有多接近”。 - 软标签里真正的知识是”类间关系”,类别之间的相似度/混淆度/距离关系。原图的例子最清楚:”20% 可能在上海”隐含了”上海建筑与北京建筑更相似”。
- 蒸馏的动机:小模型能力不足,无法只靠自己从数据中总结出通用规律,只能强行背答案;给它软标签,等于给它一份”规律速查表”。
- 温度 T 控制软标签的”软硬程度”,且反向传播时要用 T^2 缩放软损失,才能让软损失和硬损失的梯度量级匹配。
三、知识地图
第一段:为什么要蒸馏
| 原文要点 | 解读 |
|---|---|
| 比较大的模型,可以从数据中总结出一些隐含的规律 | 大模型的容量足以学到类间结构、难点样本的边界等”额外信息” |
| 而学生模型比较小,无法只靠自己从中总结出通用的规律,只能强行背答案 | 小模型容量不足,只能记住样本→标签的映射,泛化差 |
| 教师模型的输出结果中,也就是预测概率中包含了一些规律信息 | 概率分布 = 知识的载体 |
| 可以让小模型模仿到一些规律 | 用教师的分布当监督信号 |
第二段:硬标签 vs 软标签
| 维度 | 硬标签 | 软标签 |
|---|---|---|
| 形态 | one-hot:正确类 1,其余 0 | 概率向量:[0.7 0.2 0.1] |
| 原图形容 | 硬性规定,非黑即白,没有商量余地 | 有弹性,有灰色地带 |
| 携带信息 | 只说”对的是哪一类” | 还说”其余类各有多像” |
| 是否含类间关系 | 完全不含 | 类似类别之间的相似度/混淆度/距离关系 |
| 原图类比 | “你在北京” | “70% 可能在北京,20% 在上海,10% 在广州” |
| 隐藏知识 | 无 | 20% 上海 → 上海建筑和北京建筑可能更相似 |
| 获取成本 | 人工标注 | 教师模型(几乎免费) |
结论句(原图):小模型自身也许能力不足,无法从训练集中获取这种隐藏的规律,那么我们让小模型模仿学习一些大模型输出的软标签,去模仿这种规律。
四、原理详解
4.1 一个具体例子:硬标签和软标签到底差在哪
假设任务是给新闻标题分类(新闻分类项目是 10 分类),有一条标题:
「某地新增三所社区养老服务中心」
| 类别 | 硬标签 | 教师软标签 |
|---|---|---|
| 社会 | 1 | 0.70 |
| 教育 | 0 | 0.20 |
| 财经 | 0 | 0.08 |
| 其他 7 类 | 0 | ≈ 0.02 |
硬标签告诉学生:这条是社会新闻,其他都不是。
软标签额外告诉学生:这条和”教育”很像(0.20),和”财经”稍微有点关系(0.08),和娱乐/体育基本无关。
学生学硬标签,就只在”社会”这一维上收到梯度,其余 9 维的梯度全是 0,信息量是 \log_{2}10 \approx 3.3 bit 里只用了 0 bit 描述”其他类”。学软标签,10 个维度上都有梯度,学生被迫学会”社会和教育在这个语境下是相邻的”。当测试集出现一个模糊标题(比如”某高校开设养老服务专业”)时,学过硬-软关系的学生就更可能给出合理判断。
4.2 信息量视角:软标签为什么是”额外的监督”
硬标签是一个 one-hot 分布,它的信息量只有分类任务本身要求的那一点。软标签是一个完整的分布,它携带两部分信息:
- 主信息:哪个类最可能(和硬标签重叠的部分);
- 辅信息(关键):其余类别的相对大小,这就是原图说的”相似度/混淆度/距离关系”。
打个比方:硬标签像考试只给”标准答案”,软标签像老师同时告诉你”这道题的 B 选项为什么诱人、C 选项错在哪”。后者显然能教出更会做题的学生。
这也是 ImageNet 上”软标签训练的学生超过硬标签训练的同尺寸模型”这一实验结论的直觉来源,软标签在同类样本量下提供了更多有效监督信号。
4.3 温度 T:控制软标签的”软硬”
直接用教师输出的概率有个问题:好的教师往往过于自信,输出接近 [0.99, 0.01, 0.00, ...],负类之间的差异被压缩到看不见,”类间关系”这部分信息就丢了。
解决办法是提高 softmax 温度,把分布”蒸软”:
p_i = \mathrm{softmax}\!\left(\frac{z_i}{T}\right) = \frac{\exp(z_i / T)}{\sum_j \exp(z_j / T)}
- z_i 是 logits(未归一化打分),T 是温度;
- T = 1 就是普通 softmax;
- T > 1 时分布被”拉平”,负类之间的相对大小被放大,类间关系变得可见;
- T \to \infty 时趋于均匀分布(信息过载,也失去了主信息)。
用小数字感受一下:设某样本 logits 为 z = [5.0,\ 2.0,\ 0.5],手算 p_i=\exp(z_i/T)/\sum_j\exp(z_j/T):
| T | softmax 结果 | 观察 |
|---|---|---|
| 1 | [0.9426, 0.0469, 0.0105] |
主类压倒性(94%),第 2 类只有 4.7%,类间关系几乎看不见 |
| 2 | [0.7527, 0.1680, 0.0793] |
分布被拉平,第 2、3 类的差异放大到可读 |
| 4 | [0.5565, 0.2629, 0.1807] |
“2 比 0.5 更像”这条关系非常明显 |
| 8 | [0.4431, 0.3045, 0.2524] |
继续变软,但主信息(谁最可能)开始被稀释 |
| 20 | [0.3760, 0.3237, 0.3003] |
近乎均匀,类间关系反而失真 |
读表要读出这条折中:温度太低 → 负类信息被压死,软标签退化成近似 one-hot,蒸馏无收益;温度太高 → 三个类几乎并列,主信息丢失,学生学不到”答案”。所以 T 一定要在验证集上搜。常取 T \in [2, 20](上表 T=4 是个不错的中庸点)。学生推理时用 T=1(正常 softmax),温度只是训练时的”信息放大器”。
4.4 蒸馏损失:软硬结合的配方
标准配方是两项加权:
\mathcal{L} = (1-\alpha)\cdot \mathcal{L}_{\text{hard}} + \alpha \cdot T^2 \cdot \mathcal{L}_{\text{soft}}
其中:
- \mathcal{L}_{\text{hard}}:学生输出 vs 硬标签的交叉熵(保证”答案别做错”);
- \mathcal{L}_{\text{soft}}:学生输出 vs 教师软标签的 KL 散度(学”类间关系”);
- \alpha 平衡两者(典型 0.5~0.9,侧重软标签);
- T^2 是梯度补偿因子。
为什么必须乘 T^2:softmax 在温度 T 下的梯度量级大约是普通 softmax 的 1/T^2。如果不乘 T^2,提高温度后软损失的梯度会变小到不起作用,\alpha 的权重就形同虚设。乘上 T^2 后,无论 T 取多少,软损失的梯度量级保持一致,这才叫”系数可移植”。
PyTorch 里的实现骨架:
import torch, torch.nn.functional as F

T = 4.0
alpha = 0.7

# 教师:冻结,只做前向;用 T 放大软标签信息
with torch.no_grad():
    teacher_logits = teacher(input_ids, attention_mask)

student_logits = student(input_ids, attention_mask)

# 软损失:KL 散度(注意输入需要 log_softmax)
log_p_student = F.log_softmax(student_logits / T, dim=-1)
p_teacher = F.softmax(teacher_logits / T, dim=-1)
soft_loss = F.kl_div(log_p_student, p_teacher,
                     reduction="batchmean") * (T * T)

# 硬损失:正常交叉熵(温度恒为 1)
hard_loss = F.cross_entropy(student_logits, labels)

loss = (1 - alpha) * hard_loss + alpha * soft_loss
几个易错点:
– F.kl_div 第一个参数要传 log 概率,第二个传概率,传错方向会算出负值或 NaN;
– reduction="batchmean" 而不是默认的 "mean",否则结果差一个 batch size 倍;
– 教师前向包在 torch.no_grad() 里,否则会白算一堆教师梯度、显存翻倍;
– 硬损失不要除以 T。
4.5 软标签在新闻分类项目这类文本任务上的特殊价值
新闻分类项目的 10 个类别里有天然易混的对:社会 ↔ 教育、财经 ↔ 房产、体育 ↔ 娱乐。硬标签训练时这些混淆边界只由”样本恰好被标成哪类”决定;而软标签会把”这条社会新闻其实很像教育”这种模糊性显式编码成一个介于 0 和 1 之间的数。
结果就是:学生模型学到的决策边界更平滑,在测试集上遇到边界样本时,准确率更稳、macro-F1 更不容易被小类别拖垮。这也是为什么”蒸馏”在低资源小类别上收益最明显。
五、易错点与常见误解
| 常见说法 | 正确说法 | 为什么 |
|---|---|---|
| 软标签就是”预测概率”,跟硬标签比只是没那么确定 | 软标签携带额外的类间关系信息,这是硬标签完全没有的 | one-hot 里”其余为 0″丢掉了所有类间结构 |
| 蒸馏就是把大模型的预测当标签用(等价于伪标签) | 伪标签通常指 hard 化后的教师预测;蒸馏的核心是保持分布形态并配温度 | 一旦对软标签取 argmax,类间关系就丢了,蒸馏退化成伪标签 |
| 温度 T 越高信息越多,所以越大越好 | T 太大会趋于均匀分布,主信息被淹没 | 通常 T\in[2,20],要靠验证集选 |
| 学生推理时也要用同一个温度 T | 推理时用 T=1 | 温度只是训练时放大软标签信息的工具 |
| 软损失不该乘 T^2,多此一举 | 不乘则软损失梯度量级变成 1/T^2,\alpha 失效 | T^2 是为了让软硬两项梯度量级可比 |
| \mathcal{L}_{soft} 用交叉熵就行 | 用 KL 散度(相对熵),教师分布作为目标分布 | 蒸馏是”让两个分布靠近”,不是”对一个 one-hot 求交叉熵” |
| 教师一定比学生强,所以蒸馏必然涨点 | 教师在某些样本上也会错,且容量差太大时学生学不动 | 实践中需要教师-学生容量匹配、并保留硬损失兜底 |
六、横向对比与研究脉络
三种”从教师拿知识”的方式对照:
| 方式 | 传递的信息 | 复杂度 | 效果 |
|---|---|---|---|
| 硬标签(原始标注) | 只有正确答案 | 最低 | 基线 |
| 软标签(logits/概率蒸馏) | 正确答案 + 类间关系 | 低(只需教师前向) | 常超过硬标签训练的同尺寸模型 |
| 中间层特征(feature/hint 蒸馏) | 中间表示的结构信息 | 高(要设计层间映射) | 在容量差距大时更有效 |
| 关系蒸馏(RKD 等) | 样本间、层间的关系 | 高 | 让结构知识传递更”抽象” |
演进脉络:
1. Hinton 等(2015) 提出知识蒸馏与”暗知识(dark knowledge)”概念,确立软标签 + 温度 T 的标准配方,本图讲的就是这一层。
2. 之后研究者发现”只看最后一层概率”信息有限,于是转向中间层特征蒸馏(FitNets 的 hint layer 思路)。
3. 再往后发展为关系型蒸馏:不再对齐单样本的输出,而是对齐”样本 A 和样本 B 的相似度”,让小模型学到数据流形的结构。
4. 在大模型时代又出现自蒸馏 / 在线蒸馏 / 序列级蒸馏(用 LLM 生成解释、理由作为更丰富的软监督),本质都是”把教师更丰富的输出当作监督信号”。
本图的位置:它是这条脉络的起点,也是最有效、最便宜的一档,不需要设计层映射,只要教师做一次前向,就能拿到完整的分布信息。
七、在新闻分类项目中的落地
- 最自然的蒸馏设置:教师 = 已经微调好的 BERT(在 18w 训练集上效果最好),学生 = FastText 或一个小号 BERT。教师跑一遍训练集拿到 18w 条软标签,学生用”软标签 + 硬标签”联合训练。
- 成本核算:教师前向 18w 条是一次性开销(离线把软标签存成
[N, 10]的 float16 矩阵,18w×10×2B ≈ 3.6 MB,完全可以落盘缓存)。相比重新训一个模型,这笔开销极小,这就是”软标签近乎免费”的量化体现。 - 超参起点:T=4、\alpha=0.7(侧重软标签)。这两个参数要在验证集上搜:T 从
[2,4,8,20]、\alpha 从[0.3,0.5,0.7,0.9]各扫一遍,报出最优组合。项目报告里”蒸馏后学生模型比同结构硬标签基线高 X 个点”就是一个有说服力的结论。 - 和量化/剪枝的叠加:先蒸馏出一个更小的学生,再对学生做 int8 量化,”小结构 + 低位宽”两者叠加,压缩率相乘(比如结构小 3 倍、量化再省 3.5 倍),这是压缩章节最有说服力的终极方案。
- 配合中间层蒸馏:如果学生也是 Transformer 结构(比如 6 层 vs 12 层),可以再加入中间层对齐损失(见本目录《【了解】中间特征》研究报告),把”输出级蒸馏”升级为”输出 + 中间层”双路蒸馏。新闻分类项目里若学生是 FastText(非 Transformer),则中间层蒸馏不可用,只能用软标签,这也是选型时要交代的约束。
八、重点问答
Q1:什么是硬标签和软标签?
A:硬标签就是普通的 one-hot 标注,正确类为 1、其余为 0,非黑即白。软标签是模型的输出概率分布,比如 [0.7 0.2 0.1],它除了告诉你最可能是哪一类,还告诉你其余类各有多像。用一个类比:硬标签只说”你在北京”,软标签说”你有 70% 可能在北京、20% 在上海、10% 在广州”,那句”20% 在上海”里就隐含了”上海建筑和北京建筑更相似”这条规律。
Q2:为什么要用软标签做蒸馏?
A:因为小模型容量不够,无法只靠自己从数据里总结出通用规律,只能强行背答案。而教师模型的输出概率里包含了两类信息:一是正确答案,二是类间关系,相似度、混淆度、距离。这份类间关系是硬标签完全没有的(one-hot 里”其余为 0″把所有类间结构都丢掉了)。让学生模仿软标签,等于把教师的这份理解免费传给它,而且不额外花标注成本。
Q3:温度 T 起什么作用?取多少合适?
A:温度用来把 softmax 分布”蒸软”。p_i = \mathrm{softmax}(z_i/T),T=1 是普通 softmax,T>1 会把分布拉平,让负类之间的相对差异变得可见。因为好的教师往往输出接近 [0.99, 0.01, 0, ...],负类关系被压得看不见,提高温度才能把”灰色地带”放大出来。常取 2 到 20,要靠验证集搜索。推理时学生用 T=1,温度只是训练时的信息放大器。
Q4:蒸馏损失怎么设计?为什么软损失要乘 T^2?
A:损失是两项加权:(1-\alpha)\cdot\mathcal{L}_{hard} + \alpha\cdot T^2\cdot\mathcal{L}_{soft}。硬损失是学生输出对硬标签的交叉熵,保证答案别做错;软损失是学生输出对教师软标签的 KL 散度,学类间关系;\alpha 典型取 0.5 到 0.9。乘 T^2 是因为 softmax 在温度 T 下的梯度量级大约是原来的 1/T^2,如果不补偿,提高温度后软损失梯度会小到不起作用。乘上 T^2 后,软硬两项梯度量级可比,\alpha 的权重才有意义。
Q5:软标签和伪标签有什么区别?
A:伪标签通常是把教师预测取 argmax 后当成硬标签用,只保留”最可能哪一类”。蒸馏的核心是保持分布的形态,不取 argmax,还配温度来放大类间关系。一旦对软标签做 argmax,类间结构就丢了,蒸馏就退化成普通伪标签训练。
Q6:KL 散度在蒸馏里怎么用?有什么坑?
A:KL 散度衡量两个概率分布的差异,蒸馏里以教师分布为目标、让学生分布去逼近它。实现上要注意三点:一是 F.kl_div 第一个参数必须传 log 概率、第二个传概率,传反了会出负值或 NaN;二是 reduction 要用 batchmean 而不是默认的 mean,否则结果会差一个 batch size 倍;三是教师的前向要包在 no_grad() 里,否则白算教师梯度、显存翻倍。
Q7:蒸馏一定能涨点吗?
A:不一定。前提是教师确实比学生强,而且教师–学生容量差距不能过大,差距太大时学生根本学不动教师的分布。实践上有两个常见做法:一是保留硬损失的权重兜底,别让 \alpha 太接近 1;二是当容量差距很大时,从”输出级蒸馏”换成”中间层特征蒸馏”,把知识按层递进地传。
九、延伸阅读
- Hinton, Vinyals, Dean, Distilling the Knowledge in a Neural Network(2015),软标签与”暗知识”的奠基论文,温度 T 的出处
- 本目录《【了解】kl 散度 + 信息论》研究报告,KL 散度、交叉熵、相对熵的数学定义
- 本目录《【了解】中间特征》研究报告,特征级蒸馏
- 本目录《【了解】双向 LSTM》研究报告,序列模型上的蒸馏结构示例