一份「从 PyTorch 张量 → 自动微分 → 神经网络基础 → 训练技巧 → CNN → RNN」的深度学习入门主干地图,说到底是快速回顾用的知识清单(导图里直接列了 day05/06/07 的午间演讲题目)。
一、这份材料解决什么问题
前面的《机器学习》《集成学习》讲的是给定特征之后怎么选模型(TF-IDF 抽特征 → 随机森林 / GBDT 分类),天花板有两个:TF-IDF 是词袋,丢掉词序、抓不住「苹果」和「手机」的语义关联;树模型再深,也学不出「未登录词 + 上下文」的表示。
深度学习这一块回答的是「怎么让模型自己学表示」。导图里的时间安排把这件事拆成了四段:
| 时间段 | 内容 | 在链条中的位置 |
|---|---|---|
| day01–day02 | PyTorch 框架详细使用 | 工具层:张量、形状、拼接 |
| day02–day05 | 神经网络基础(人工神经网络) | 原理层:神经元、前向/反向、损失、优化、正则化 |
| day06 | CNN 卷积神经网络(计算机视觉 CV) | 结构层之一:局部连接 + 权值共享 |
| day07 | RNN 循环神经网络(NLP、大模型的基础) | 结构层之二:序列建模 + 隐藏状态传参 |
为什么 LLM 应用工程师必须补这一块:导图在 RNN 分支下明确写了「NLP、大模型的基础」。BERT 的 Transformer 就是在 RNN 的位置上做的替换;模型压缩(量化 / 蒸馏 / 剪枝)操作的对象是 nn.Module;蒸馏损失里的 KL 散度、软标签里的 softmax 温度,都是从这一层的概念长出来的。跳过它直接调 transformers,遇到「loss 不降」「梯度爆炸」「过拟合」就只能瞎试。
另外,导图最上面挂了一个 「午间演讲题目」 分支,按 day05/06/07 列了 15 个问题,这是这份材料的考核口径。第三、八节会把这份清单完整覆盖。
二、核心结论
- 一次训练 = 前向传播算预测值 → 损失函数算差距 → 反向传播算偏导 → 优化器沿着负梯度方向改 w 和 b。反向传播里「算偏导」这件事由
torch.autograd自动完成,业务代码只需要写loss.sum().backward()这一行。 - 激活函数是「能不能做非线性任务」的开关。导图的说法很直接:线性求和之后套激活函数,就在线性关系里引入了非线性,「神经网络模型既能够处理回归问题,也能解决分类问题」。隐藏层默认 ReLU,输出层默认 Softmax(二分类是多分类的特例)。
- 损失函数按任务二选一:分类强烈推荐
CrossEntropyLoss(公式里内含 Softmax,所以模型 forward 层不要自己再接 Softmax);回归强烈推荐SmoothL1Loss(L1 在 0 点不可导,L2 平方会梯度爆炸,SmoothL1 综合了两者优点)。 - 优化器默认 Adam。导图的分类是:Momentum 只优化梯度值,AdaGrad / RMSprop 只优化学习率,Adam = Momentum + RMSprop,两样都优化,因此「强烈推荐最综合的 Adam」;结构简单的小网络才退回 SGD / Momentum。
- 防过拟合两件套 = Dropout + 批量归一化。Dropout 把部分神经元激活值置 0,剩下没失活的激活值乘 1/(1-p) 做补偿;BN 对每个 batch 的数据做标准化,导图标注它「主要用在计算机视觉领域」。
三、知识地图
按导图原有层级整理(权重列:★掌握 = 出现在「午间演讲题目」清单里或属于必答主干;理解 = 需要能解释但不必背 API 细节;了解 = 导图本身标注为【了解】或只需知道存在)。
深度学习
├── 午间演讲题目(考核清单,15 问)
│   ├── day05 ── 前向/反向传播、网络结构组成、激活函数选择、回归评估指标、分类评估指标  ★掌握
│   ├── day06 ── 张量形状调整方法及注意事项、张量拼接方法及注意事项、
│   │             参数初始化选择、神经网络搭建开发流程、损失函数选择            ★掌握
│   └── day07 ── 学习率/梯度优化方法(你用哪个、为什么)、如何缓解过拟合、
│                 CNN 由什么组成(+ 激活函数、参数初始化 重复追问)            ★掌握
│
├── Pytorch框架的使用
│   ├── 框架简介(底层框架;pip install torch)                                *了解*
│   ├── 张量的创建 ── 什么是张量 / 基本创建 / 线性 / 随机 / 指定值 / 元素类型转换  理解
│   ├── 张量类型转换 ── 张量↔Numpy(深拷贝 vs 浅拷贝)、张量↔标量                理解
│   ├── 张量数值计算 ── 基本运算(含下划线 in-place)、点乘、矩阵乘法             ★掌握
│   ├── 张量运算函数 ── sum / sum(dim=-1) / mean / sqrt / pow / exp / log        理解
│   ├── 张量索引操作 ── 切片(左闭右开)、列范围、布尔索引、多维索引              理解
│   ├── 张量形状操作 ── reshape / squeeze / unsqueeze / transpose / permute / view ★掌握
│   └── 张量拼接 ── cat(维度数不变) / stack(维度数 +1)                      ★掌握
│
├── 自动微分模块
│   ├── 原理 + 前向传播(由特征值算预测值)                                     ★掌握
│   ├── 反向传播(预测值+真实值→损失值→求最优 w、b)                            ★掌握
│   ├── 作用:负责计算梯度下降公式里的偏导值                                     ★掌握
│   └── 核心代码:loss.sum().backward()                                        ★掌握
│
├── 神经网络基础
│   ├── 神经元(线性求和 → 激活函数)                                          ★掌握
│   ├── 神经网络(输入层/隐藏层/输出层;菱形结构效果较好;nn.Linear 两个参数含义) ★掌握
│   ├── 激活函数(Sigmoid / Tanh / Softmax / ReLU + 分层选择规则)              ★掌握
│   ├── 参数初始化(均匀/正态/全0/全1/固定值/kaiming/xavier + 推荐组合)        ★掌握
│   ├── 搭建流程(继承 nn.Module → __init__ → forward)                       ★掌握
│   ├── 损失函数(CrossEntropyLoss / BCELoss / L1 / L2 / SmoothL1)           ★掌握
│   ├── 学习率和梯度值优化(自动:Momentum/AdaGrad/RMSprop/Adam;
│   │      手动:StepLR / MultiStepLR / ExponentialLR;β 取 0.9/0.99/0.999)    ★掌握
│   └── 正则化(Dropout:p 一般 0.1 或 0.2;BN:按 batch 标准化)               ★掌握
│
├── 神经网络开发流程
│   ├── 数据准备 ── DataFrame/Numpy/文件/容器 → Tensor → Dataset → DataLoader    ★掌握
│   ├── 搭建模型 ── 继承 nn.Module / __init__ / forward                        ★掌握
│   ├── 模型训练 ── 创建 DataLoader → 三个实例对象 → model.train() →
│   │      外层轮次 + 内层批次(前向→算损失→算指标→梯度清零/反向/更新)→ 保存 → 画曲线 ★掌握
│   └── 模型评估/预测 ── 加载模型 → model.eval() → with torch.no_grad() → 统计准确率 ★掌握
│
├── CNN卷积神经网络
│   ├── 特点:含卷积层就称为卷积神经网络                                        ★掌握
│   ├── 结构:输入层 / 隐藏层(卷积层 + 池化层)/ 输出层                         ★掌握
│   ├── 卷积层 ── nn.Conv2d(5 参数含义);图片形状调整(HWC→CHW→NCHW 及还原);
│   │      特征图计算公式                                                   ★掌握
│   └── 池化层 ── 最大池化(推荐)/ 平均池化;不涉及参数训练;
│          nn.MaxPool2d / nn.AvgPool2d                                      ★掌握
│
└── RNN循环神经网络
    ├── 定义:含循环层;专门处理序列数据(文字最有代表性)                        ★掌握
    ├── 结构:输入层 / 循环层 / 输出层                                        ★掌握
    ├── NLP 任务流程:准备语料库 → 分词去重构词表 → Embedding → 循环层           ★掌握
    ├── jieba 分词器 ── jieba.lcut(字符串)                                  理解
    ├── 词嵌入层 ── nn.Embedding(num_embeddings, embedding_dim)              ★掌握
    └── 循环层 ── nn.RNN(input_size, hidden_size, num_layers, batch_first);
           output/hidden 的 shape 含义;h0 的初始化与传递                       ★掌握
说明:导图只在
view节点上显式标了【了解】(”只能对连续张量进行形状调整”),其余权重由本报告按「是否出现在午间演讲题目清单 + 是否属于主干」推断,属于对优先级的整理,不是原材料原文。
四、原理详解
4.1 PyTorch 张量:形状操作与拼接
神经网络里 90% 的调试时间花在形状不匹配上。导图把「形状操作」和「拼接」单列成两个分支,还在午间演讲题目里连问两天(day06 问”调整形状””拼接”),可见是高频翻车点。一句话记牢:深度学习代码 = 一串形状变换,把数据从原始形状搬到模型要求的形状。
机制与注意事项
| API | 作用 | 关键限制 |
|---|---|---|
reshape |
改形状,可升维/降维 | 最多只能出现一个 -1,由 PyTorch 自动推算 |
unsqueeze(dim) |
在指定维度插入长度为 1 的新维度(升维) | — |
squeeze(dim) |
删除指定维度上长度为 1 的维度(降维) | 不传 dim 就把所有长度 1 的维度都删掉 |
transpose / permute |
交换维度位置 | transpose 一次只换两个位置;permute 一次可换多个 |
view【了解】 |
改形状 | 只能对连续张量用;is_contiguous() 判断,contiguous() 把不连续的变连续 |
导图原话:修改前后张量中元素的个数必须保持不变,reshape 能接 (3,2) (1,6) (6,),接不了 (4,2)。使用推荐:维度个数很多(≥5)且只换两个位置时用 transpose,否则用 permute,因为 transpose 语义更窄、更不容易写错轴。
拼接两兄弟:cat/concat 要求除拼接维度以外其它形状必须一样、拼完维度个数不变;stack 要求参与拼接的张量形状完全一致、拼完维度个数加 1(N 个 2 维张量 → 1 个 3 维张量)。
import torch

t = torch.arange(12)                  # shape (12,)
a = t.reshape(3, 4)                   # (3,4)
b = t.reshape(2, -1)                  # (2,6),-1 自动算成 6
# t.reshape(4, -1, -1)                # 报错:-1 最多出现一次

x = torch.randn(5, 1, 8)              # 5 个句子 × 8 维词向量
print(x.squeeze(1).shape)             # (5,8) —— 删掉长度为 1 的第 1 维
print(x.squeeze().shape)              # (5,8) —— 不传 dim,删掉所有长度 1 的维度

img = torch.randn(1, 3, 32, 32)       # (N,C,H,W)
print(img.permute(0, 2, 3, 1).shape)  # (1,32,32,3) —— 转成可视化用的 NHWC
print(img.transpose(1, 3).shape)      # (1,32,32,3) —— 只换两个轴时 transpose 也行

u = torch.randn(4, 5); v = torch.randn(4, 5)
print(torch.cat([u, v], dim=0).shape)     # (8,5)  —— 维度数不变
print(torch.stack([u, v], dim=0).shape)   # (2,4,5) —— 维度数 +1
# torch.cat([u, torch.randn(3,5)], 1)  # 报错:非拼接维度 4 != 3
# torch.stack([u, torch.randn(5,4)], 0)  # 报错:stack 要求形状完全一致
形状对应到 CNN 输入(导图专门列了这条「图片处理的注意事项」):
原图 [H, W, C]  →  [C, H, W]  →  [N, C, H, W]  →  送进 nn.Conv2d
可视化时反向:  [N,C,H,W]  →  [C,H,W]  →  [H,W,C]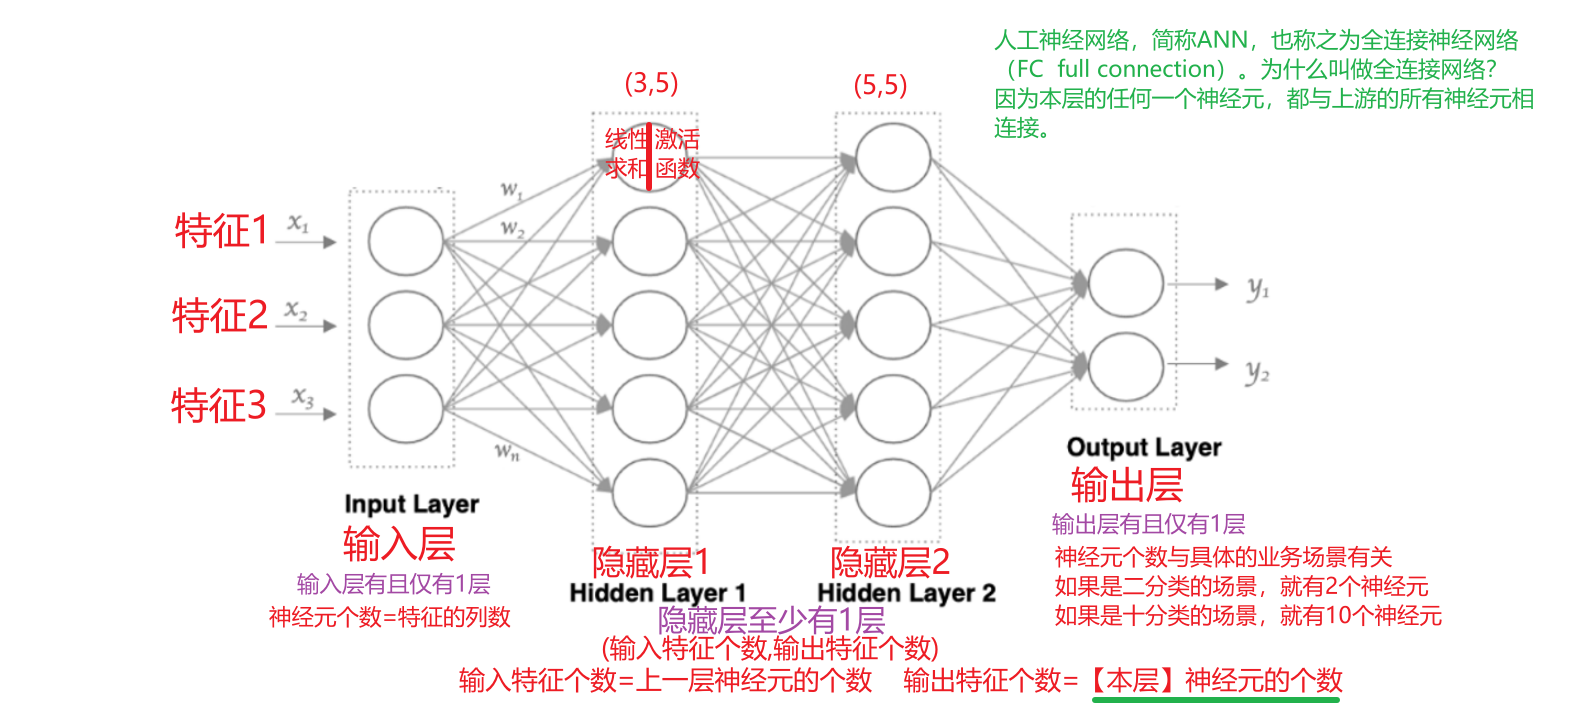
图注:全连接神经网络(ANN / FC full connection)结构图,用来说明 nn.Linear 的输入输出特征个数怎么数。左侧 Input Layer 输入层列出 特征1 x₁ / 特征2 x₂ / 特征3 x₃,图注写明「输入层有且仅有 1 层,神经元个数 = 特征的列数」;中间两层隐藏层顶部标注 (3,5) 与 (5,5),这是「(输入特征个数, 输出特征个数)」的写法,即 Hidden Layer 1 把 3 维特征映射到 5 维、Hidden Layer 2 再映射到 5 维,图注补了一句「隐藏层至少有 1 层」;右侧 Output Layer 输出层输出 y₁ / y₂,图注写「输出层有且仅有 1 层,神经元个数与具体业务场景有关,如果是二分类的场景,就有 2 个神经元;如果是十分类的场景,就有 10 个神经元」。图右上角给出定义:「人工神经网络,简称 ANN,也称之为全连接神经网络(FC full connection)。为什么叫做全连接网络?因为本层的任何一个神经元,都与上游的所有神经元相连接。」底部两行是 Linear 参数的含义:「输入特征个数 = 上一层神经元的个数」、「输出特征个数 = 本层神经元的个数」。图中每个隐藏层神经元内部都标了「线性求和 / 激活函数」,权重连线从 w_1, w_2 \dots w_n 一直连到下一层全部神经元,这就是”全连接”的视觉含义,也是 CNN 要拿掉的东西。
4.2 自动微分与前向传播 / 反向传播(带数字)
导图给的定义:前向传播是”通过样本数据的特征值,计算得到预测值”;反向传播是”将预测值、真实值带入损失函数,得到损失值。通过让损失值越来越小,求得最优的权重 w 和偏置 b”。自动微分模块的作用是”在反向传播的过程中,需要通过梯度下降公式更新权重 w 和偏置 b,该梯度下降公式中涉及到求偏导的过程,自动微分就负责帮我们计算偏导值”。一句话:前向算数,反向算导,优化器负责走。
原理是链式法则 + 计算图:前向时每次运算都记一笔「输出来自哪些输入、用什么运算」(结果带 grad_fn),调 backward() 就从 loss 反向把整条链的偏导算出来,挂在每个张量的 .grad 上。核心代码就是导图列的那一行 loss.sum().backward()。更新公式:
W_1 = W_0 – lr \times grad
W_0 当前权重值;W_1 更新后的权重值;lr 学习率;grad 梯度值(偏导值)。
这是所有优化器的共同骨架,区别只在于「grad 要不要做动量平滑」和「lr 要不要逐参数自适应」,正是 4.7 的内容。
带数字的小例子(按导图那张计算图手算一遍)
设定:单样本 x=2、w=3、b=1、真实值 y=10,损失 L=(z-y)^2,z=wx+b,lr=0.05。
第 0 步:z = 2\times3+1 = 7,L=(7-10)^2=9
反向逐段求导:
\frac{\partial L}{\partial z}=2(z-y)=2\times(7-10)=-6,\quad \frac{\partial z}{\partial w}=x=2,\quad \frac{\partial z}{\partial b}=1
\frac{\partial L}{\partial w}=-6\times2=-12,\qquad \frac{\partial L}{\partial b}=-6\times1=-6
更新:w_1 = 3-0.05\times(-12)=3.6,b_1 = 1-0.05\times(-6)=1.3
第 1 步:z=2\times3.6+1.3=8.5,L=(8.5-10)^2=2.25;\frac{\partial L}{\partial w}=-6、\frac{\partial L}{\partial b}=-3 → w_2=3.9,b_2=1.45
第 2 步:z=2\times3.9+1.45=9.25,L=(9.25-10)^2=0.5625
三次损失连起来:9 → 2.25 → 0.5625,每次变成上一次的 1/4,预测值 7 → 8.5 → 9.25 一路逼近真实值 10。注意梯度一直是负的(预测值低于真实值),所以 w - lr*grad 实际是把 w 加大,这就是「沿负梯度方向下降」的具体样子。
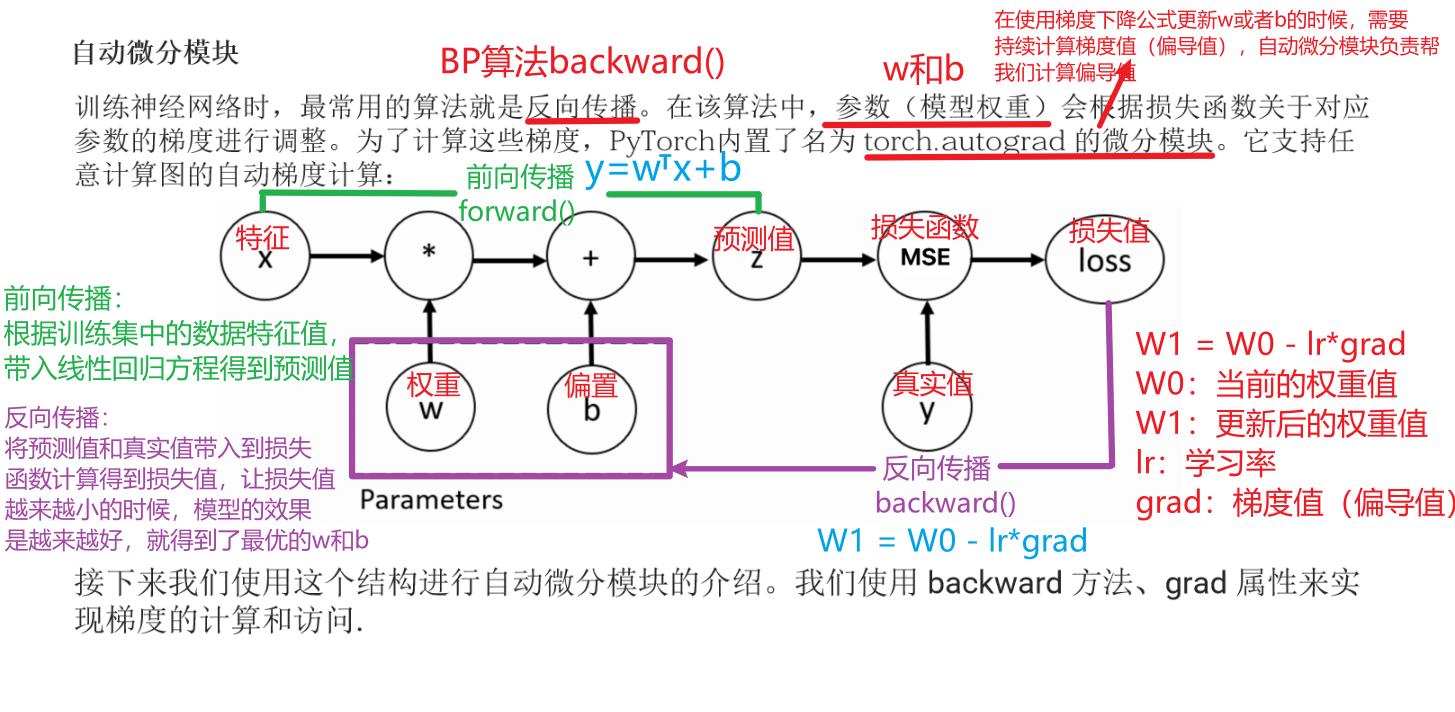
图注:左上角标「自动微分模块」,标题为「BP 算法 backward()」。图中是一条完整计算图:特征 X 经 * 节点乘上 权重 W、再经 + 节点加上 偏置 b,得到 预测值 Z;同时下方 真实值 Y 也送入 损失函数 MSE,MSE 输出 损失值 loss。绿色箭头是前向传播 forward(),旁边写着公式 y = W^T x + b;紫色双向箭头框住 Parameters(权重 W、偏置 b),右侧紫箭头标 backward(),即反向从 loss 一路回到参数。右上角红字是要背下来的更新公式 W1 = W0 − lr*grad,并逐项注释「W0:当前的权重值;W1:更新后的权重值;lr:学习率;grad:梯度值(偏导值)」。左下角两段是本节定义:「前向传播:根据训练集中的数据特征值,带入线性回归方程得到预测值」、「反向传播:将预测值和真实值带入到损失函数计算得到损失值,让损失值越来越小的时候,模型的效果是越来越好,就得到了最优的 w 和 b」。左上角文字说明 autograd 的来历:「训练神经网络时,最常用的算法就是反向传播……为了计算这些梯度,PyTorch 内置了名为 torch.autograd 的微分模块。它支持任意计算图的自动梯度计算。」右上角点明「需要持续计算梯度值(偏导值),自动微分模块负责帮我们计算偏导值」,底部收尾:「我们使用 backward 方法、grad 属性来实现梯度的计算和访问。」
4.3 神经网络基础:神经元与网络结构
导图对神经元的定义只有一句,但这就是全部:”组成:先线性求和,再进行激活函数计算”。网络结构:由 输入层、隐藏层、输出层 组成;隐藏层的层数、每层神经元个数由开发人员自定义;「网络结构呈现一个菱形的时候,相对来说效果较好」,即先宽后窄的漏斗状,不是一上来就压扁。
单个神经元:a = f\left(b + \sum_{i=1}^{n} x_i w_i\right) = f(\mathbf{w}^\top \mathbf{x} + b);一层神经元:\mathbf{h} = \mathbf{x}\mathbf{W}^\top + \mathbf{b},\mathbf{W} 形状为 (out_features, in_features)。
nn.Linear 两个参数(原题级):in_features 是输入特征个数、也就是上一层神经元个数;out_features 是输出特征个数、也就是本层神经元个数。
\mathbf{x}=[1.0, 2.0, 3.0],隐藏层第 1 个神经元 b=0.1、\mathbf{w}=[0.5,-0.2,0.3]:
0.1 + 0.5\times1.0 – 0.2\times2.0 + 0.3\times3.0 = 1.1 \;\Longrightarrow\; \text{ReLU}(1.1)=1.1
第 2 个神经元 \mathbf{w}=[0.1,0.4,-0.5]、b=0:0+0.1+0.8-1.5=-0.6 \Rightarrow \text{ReLU}(-0.6)=0。注意这个 0:ReLU 把负值按死成 0,这就是「稀疏激活」的来源,也是选 kaiming 初始化的原因。
输出层两类任务得到 logits [2.0, 1.0]:
\text{softmax}=[0.7311,\ 0.2689],\qquad \text{真实标签第 0 类} \Rightarrow \text{CrossEntropy}=-\ln(0.7311)=0.3133
这条链路(特征 → 线性求和 → ReLU → 线性求和 → Softmax → 交叉熵)就是导图「神经网络开发流程」的数学骨架。
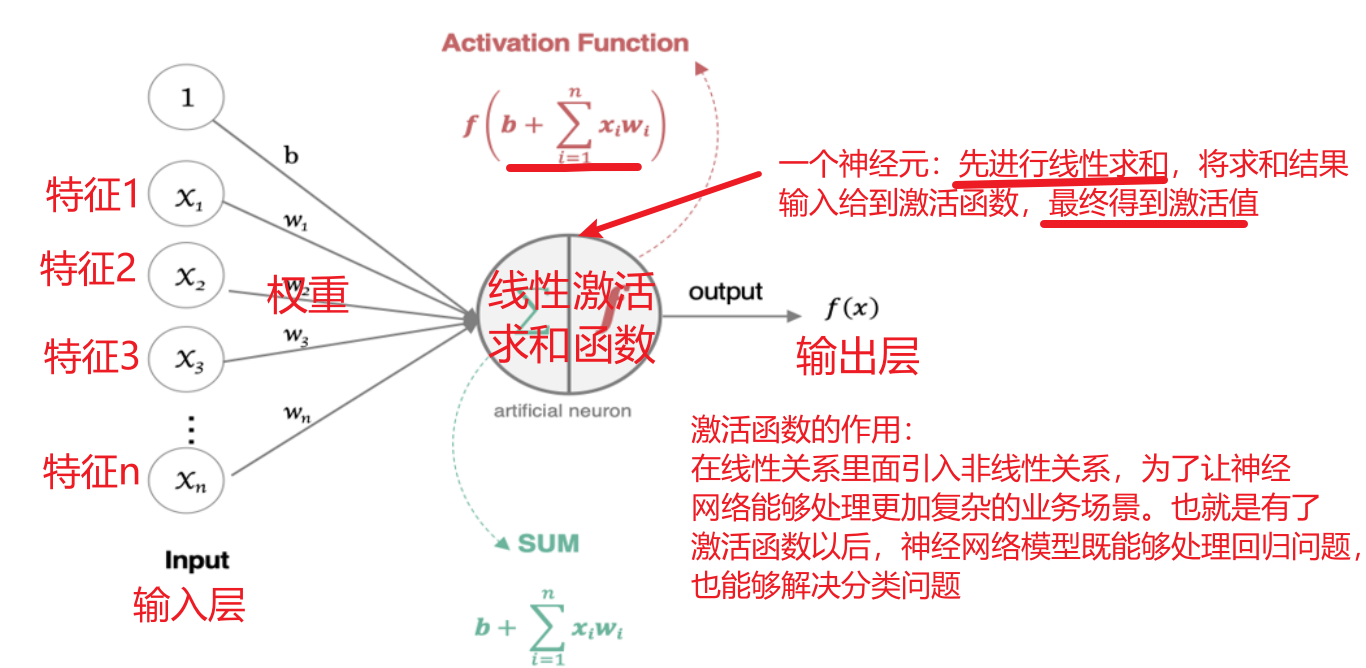
图注:单个 neuron 的解剖图。左侧 Input 输入层 列出 特征1 x₁ / 特征2 x₂ / 特征3 x₃ / ⋯ / 特征n xₙ,最上方还有一个节点值为 1 的输入,经一条标着 b 的连线接到神经元,这条「1 号输入」就是偏置项 b 的图形化表示;各特征连线上的权重标为 w₁ … wₙ,并以「权重」二字统称。中间圆形节点内部写着「线性求和 / 激活函数」,下方小字标 artificial neuron。节点上方给出完整激活函数形式 f\left(b+\sum_{i=1}^{n} x_i w_i\right),用 Activation Function 标出这条公式的作用位置;节点下方标 SUM 处给出同样的求和式 b+\sum_{i=1}^{n}x_i w_i。输出侧标 output,指向右侧小圆 f(x),下方写「输出层」。图中两段说明文字是本节的结论:「一个神经元:先进行线性求和,将求和结果输入给到激活函数,最终得到激活值」;「激活函数的作用:在线性关系里面引入非线性关系,为了让神经网络能够处理更加复杂的业务场景。也就是有了激活函数以后,神经网络模型既能够处理回归问题,也能解决分类问题。」
4.4 激活函数的选择
导图给的四种:Sigmoid、Tanh、Softmax、ReLU(推荐里还提到 ReLU 的变体 Leaky ReLU)。选择规则直接背:
| 位置 | 规则 |
|---|---|
| 隐藏层(1) | 大多数情况下用 ReLU;如果效果一般,推荐用 ReLU 的变体,例如 Leaky ReLU |
| 隐藏层(2) | 也可以用 Sigmoid,但要满足网络层数 ≤ 5 层;也可以用 Tanh,但要满足网络层数 ≤ 10 层 |
| 输出层(1) | 不管二分类还是多分类都推荐 Softmax,因为二分类是一种特殊的多分类 |
| 输出层(2) | 二分类场景也可以用 Sigmoid |
为什么有层数限制:Sigmoid 导数最大只有 0.25(\sigma'(0)=0.25),Tanh 是 \tanh'(0)=1 但两端同样饱和到 0,多层连乘会指数衰减(梯度消失),所以层数越多越不敢用。这里的「≤5 / ≤10」是这份材料的经验阈值,工程上深层网络统一用 ReLU 家族。
带数字的小例子(z=1.1 / -0.6 / 3.0):
| 函数 | z=1.1 | z=-0.6 | z=3.0 |
|---|---|---|---|
| Sigmoid 1/(1+e^{-z}) | 0.7503 | 0.3543 | 0.9526 |
| Tanh | 0.8005 | −0.5370 | 0.9951 |
| ReLU \max(0,z) | 1.1 | 0 | 3.0 |
三件事看得见:ReLU 不算指数、负区间归零(快且稀疏);Sigmoid 输出永远挤在 (0,1) 且 z=-0.6 时仍有 0.354 而不是 0(「没激活」的神经元照样往下传值);Tanh 零中心、保留负值,所以比 Sigmoid 收敛好。
输出层为什么要 Softmax 而代码里不写:CrossEntropyLoss 公式里已经包含了 Softmax(导图原话:”该公式中包含了 Softmax”)。所以 forward 最后应输出裸 logits 直接喂给损失函数;自己先 softmax 再送进去等于做两次归一化,损失会算错。
4.5 参数初始化的选择
导图列的种类:均匀分布、正态分布、全 0、全 1、固定值、kaiming 初始化(均匀/正态)、xavier(泽维尔)初始化(均匀/正态)。推荐组合:
| 维度 | 推荐 |
|---|---|
| 权重 w | kaiming 初始化 |
| 偏置 b | 全 0 |
| 激活函数是 ReLU | 用 kaiming |
| 激活函数是其他 | 其他初始化方式都行 |
| 浅层网络(隐藏层 ≤ 5 层) | 各种随机初始化方式都行 |
| 深层网络(隐藏层 > 5 层) | 推荐 kaiming 或 xavier |
为什么全 0 不能用于权重:权重全 0 时同层每个神经元前向输出相同、反向梯度相同,更新后依然完全相同,等于这层只有 1 个神经元,宽度没有意义(对称性无法打破)。偏置则不同:各神经元的权重已不一样,对称性由权重负责打破,所以偏置可以放心全 0。
为什么要按激活函数选尺度:kaiming 正是为 ReLU 设计的,ReLU 把一半输入按成 0、激活值方差减半,kaiming 就把初始化方差放大一倍来补偿,让各层激活值方差在前向中保持稳定;xavier 则是为 Sigmoid/Tanh 这类对称饱和激活函数设计的。
4.6 损失函数的选择
| 任务 | 损失函数 | 导图评价 |
|---|---|---|
| 多分类 | CrossEntropyLoss |
「优先强烈推荐」,公式中包含了 Softmax |
| 二分类 | BCELoss |
「二分类问题还可以使用 BCELoss」 |
| 回归 | L1Loss(= MAE) |
缺点是在 0 点处不可导 |
| 回归 | L2Loss(= MSE) |
缺点是误差算的是平方,可能导致梯度爆炸 |
| 回归 | SmoothL1Loss |
综合了 L1 和 L2 各自的优点,回归优先推荐 |
\text{L1}(e)=|e|,\quad \text{L2}(e)=e^2,\quad \text{SmoothL1}(e)=\begin{cases}0.5e^2, & |e|<1\\ |e|-0.5, & |e|\ge 1\end{cases},\quad e=z-y
SmoothL1 的直觉:误差小的时候按 L2 走(0 附近平滑可导,收敛细腻),误差大的时候按 L1 走(梯度恒为 ±1,不被大误差的平方放大)。
带数字的小例子(z=7、y=10、e=-3):
| 损失 | 值 | 对 z 的偏导 |
|---|---|---|
| L1 | 3 | −1(非 0 处恒为 ±1) |
| L2 | 9 | 2e=-6 |
| SmoothL1 | 2.5 | −1 |
把误差放大到 e=-30:L2 的偏导变成 -60(误差翻 10 倍、梯度也翻 10 倍,这就是梯度爆炸的来源),SmoothL1 仍是 -1(被恒住)。
4.7 学习率与梯度值的优化方法
导图把优化分成自动和手动两条线,这是本节关键框架。
自动优化(优化器)
| 优化器 | 优化对象(导图原话) |
|---|---|
| Momentum 动量法 | 只对梯度值进行优化 |
| AdaGrad | 只对学习率进行优化 |
| RMSprop | 只对学习率进行优化 |
| Adam | 既对学习率、也对梯度值进行优化;实际就是等价于 Momentum + RMSprop |
使用推荐:强烈推荐使用最综合的 Adam;如果神经网络结构比较简单,可以用 SGD、Momentum 等。超参数 β 推荐设置为 0.9、0.99、0.999。
标准答法(导图原始问法就是「你在实际工作中一般用哪个,为什么」):用 Adam,因为它一个优化器同时把梯度值和学习率两件事都处理了,等价于 Momentum + RMSprop,β 默认量级 0.9/0.999;模型结构复杂、不确定怎么调 lr 时它是稳妥的默认选择;只有在结构非常简单、想要更细粒度控制收敛行为时才退回 SGD/Momentum + 手动学习率调度。
手动优化(学习率调度器)
| 策略 | API | 关键参数 |
|---|---|---|
| 等间隔 | StepLR(optimizer, step_size=50, gamma=0.5) |
step_size 每隔多少 epoch 调一次;gamma 让新 lr = 上一次 lr × gamma |
| 指定间隔 | MultiStepLR(optimizer, gamma=0.5, milestones=[50,125,160]) |
milestones 在哪些轮次调整 |
| 指数调整 | ExponentialLR(optimizer, gamma=0.95) |
新 lr = 上一次 lr × (gamma ** epoch) |
带数字的小例子(初始 lr = 0.1):
StepLR(step_size=50, gamma=0.5):epoch 0 → 0.1,50 → 0.05,100 → 0.025,150 → 0.0125(阶梯式下降)ExponentialLR(gamma=0.95):epoch 0 → 0.1,1 → 0.095,2 → 0.09025,3 → 0.08574(每个 epoch 都在掉,曲线平滑)MultiStepLR(milestones=[50,125,160]):epoch 0 → 0.1,50 → 0.05,125 → 0.025,160 → 0.0125(手挑拐点)
导图的重要提醒:“这块内容理解即可,因为实际工作中的神经网络结构复杂,训练的轮次也是不固定的,人为控制学习率的调整过程很麻烦。” 也就是说:手动调度是「理解 + 会配」,默认方案仍然是 Adam,只有训练轮次确定、结构固定(复现论文、跑固定 pipeline)时才值得调。
4.8 正则化:Dropout 与批量归一化
目的(导图原话):为了防止神经网络过拟合。
(1)Dropout 随机失活,机制三条,条条要能背:
- 每个神经元都有概率 p 的可能性进行失活,但是神经元还是存在的(不是删掉,只是这一轮不参与);
- 将失活的神经元输出的激活值重置为 0;
- 未失活的神经元激活值乘以 1/(1-p)。
p 取值区间 0–1,一般是 0.1 或者 0.2。
为什么第 3 条要乘 1/(1-p):p=0.2 时随机失活掉 20% 的神经元,剩下神经元输出总和的期望只剩原来的 80%。为了让训练时的激活值量级与推理时(推理不 dropout、全部神经元参与)一致,训练时把幸存者放大 1/(1-0.2)=1.25 倍。这就是 inverted dropout 的补偿:p=0.2 → ×1.25;p=0.1 → ×1.111。
某层激活值 [1.1, 0.0, 3.0, 0.4],p=0.2,随机失活第 1、3 个:
原激活值        [1.1, 0.0, 3.0, 0.4]
失活后(置0)    [0.0, 0.0, 0.0, 0.4]
乘 1/(1-0.2)    [0.0, 0.0, 0.0, 0.5]     ← 0.4 × 1.25 = 0.5
推理时 model.eval() 关掉 dropout,全部神经元按原值用。
(2)批量归一化 BN,”对参与训练的每个 batch 批次的数据进行标准化的处理”,”主要是用在计算机视觉领域”。机制:对每个 mini-batch 算均值和方差,把激活值拉回标准正态,再乘可学习参数 \gamma 加 \beta:
\hat{x} = \frac{x-\mu_B}{\sqrt{\sigma_B^2+\epsilon}},\qquad y = \gamma\hat{x}+\beta
一个 batch 的激活值 [1,2,3,4],则 \mu_B=2.5、\sigma_B^2=1.25、\sigma_B\approx1.118,x=1 归一化后 \hat{x}=\frac{1-2.5}{1.118}\approx-1.3416,x=4 得到 +1.3416。\gamma 和 \beta 是可学习参数,若最优解就是「不要归一化」,网络可以学出 \gamma=\sigma_B、\beta=\mu_B 把变换撤销,这让 BN 只赚不亏。
BN 与 model.train()/model.eval():训练用当前 batch 统计量,推理用累积的全局统计量,推理忘写 model.eval() 是常见 bug,导图把两个模式各列成独立一步正是这个原因。
4.9 神经网络开发流程(数据准备 → 搭建 → 训练 → 评估)
Step 1 数据准备(导图链条):
DataFrame / Numpy / 文件 / 容器 → Tensor 张量 → Dataset 数据集 → DataLoader 数据加载器Step 2 搭建模型(三步):① 定义一个类继承自 torch.nn.Module;② 实现 __init__,初始化父类、搭建隐藏层/输出层/Dropout 层、【可选】各层参数初始化;③ 实现 forward,输入特征数据依次经过各隐藏层到输出层,得到预测结果。
import torch, torch.nn as nn

class Net(nn.Module):
    def __init__(self, in_dim=3, hidden=5, n_class=2, p=0.2):
        super().__init__()                        # ① 初始化父类
        self.fc1 = nn.Linear(in_dim, hidden)      # ② 搭建结构
        self.fc2 = nn.Linear(hidden, n_class)
        self.drop = nn.Dropout(p)                 # ② Dropout 层
        nn.init.kaiming_normal_(self.fc1.weight)  # ③ 可选:参数初始化
        nn.init.zeros_(self.fc1.bias)             #    偏置全 0
    def forward(self, x):                         # ③ forward 前向传播
        x = torch.relu(self.fc1(x))
        return self.fc2(self.drop(x))             # 输出裸 logits,交给 CrossEntropyLoss
Step 3 模型训练(含那三行”反向传播固定代码”):
from torch.utils.data import DataLoader, TensorDataset

loader = DataLoader(TensorDataset(x_train, y_train), batch_size=64, shuffle=True)  # 1
model = Net(in_dim=3)                       # 2-1 算法模型实例对象
criterion = nn.CrossEntropyLoss()           # 2-2 损失函数对象
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)   # 2-3 优化器对象

model.train()                               # 3 设置模式
for epoch in range(10):                     # 4-1 外层循环:轮次
    for x, y in loader:                     # 4-2 内层循环:批次
        y_pred = model(x)                   #   ① 前向传播
        loss = criterion(y_pred, y)         #   ② 计算损失
        acc = (y_pred.argmax(1) == y).float().mean()   # ③【可选】统计指标
        optimizer.zero_grad()               # ④ 固定代码:梯度清零
        loss.backward()                     #              反向传播
        optimizer.step()                    #              更新参数
torch.save(model.state_dict(), "model.pth")  # 5 保存训练好的模型
# 6 绘制损失值和轮次的变化曲线
这三行的顺序和必要性要能解释:PyTorch 的 .grad 是累加的,不清零上一 batch 的梯度会混进来;backward() 只算导、不改参数;step() 才真正执行 W_1=W_0-lr\times grad。三者职责分离。
Step 4 模型评估 / 预测:
model.eval()                                # 3 设置模式
with torch.no_grad():                       # 4-1 禁止反向传播、禁止更新参数
    correct = 0
    for x, y in loader:                     # 4-2 循环预测
        y_pred = model(x)                   #   ① 前向传播
        correct += (y_pred.argmax(1) == y).sum().item()   # ② 统计预测正确的样本条数
print("准确率:", correct / len(test_set))    # ③ 输出评估指标,例如准确率
with torch.no_grad() 的两个作用:省显存(不建计算图)、防止误更新参数。
4.10 网络家族之一:CNN 卷积神经网络
定义(导图原话):含有卷积层的神经网络,称之为卷积神经网络。它解决的问题是:全连接层把图片拉平后参数量爆炸(32\times32\times3 的图接到 1000 个神经元就是 300 万参数),而且丢失了空间位置信息。CNN 用两个先验把参数压下来:局部连接(一个卷积核只看一小块)+ 权值共享(同一个核在整张图上滑)。
结构
CNN = 输入层 + 隐藏层(卷积层 + 池化层) + 输出层
                ├─ 卷积层:负责特征提取              ← 含参数,要训练
                └─ 池化层:负责减少特征值个数(特征降维) ← 不含参数,不训练
(1)卷积层
参数(nn.Conv2d(in_channels, out_channels, kernel_size, padding, stride)) |
含义(导图逐项解释) | 经验取值 |
|---|---|---|
in_channels |
输入图片的通道数 | — |
out_channels |
输出通道数;也就是卷积核的个数,同时也等价于特征图的个数 | — |
kernel_size |
卷积核尺寸 | 一般是奇数,在 3–11 之间 |
padding |
在图片四周是否填充 0,作用是让图片四周的特征得到充分的提取 | 一般 0–2 之间 |
stride |
卷积核向右、向下移动的步长 | 一般 1–2 之间 |
为什么 padding 能让四周特征被充分提取:不加 padding 时滑动窗口只在图内滑,最上/下/左/右那圈像素被窗口覆盖的次数明显少于中心像素;补一圈 0 之后边缘像素也能被”当作中心”扫到。这也是 padding=2、kernel=5 时输出尺寸不变的算术根源。
特征图尺寸公式(导图直接给了这张公式图):
N = \frac{W – F + 2P}{S} + 1
W 输入尺寸、F 卷积核尺寸、P padding、S stride、N 输出特征图尺寸。
- W=32, F=5, P=2, S=1:N=(32-5+4)/1+1= 32(尺寸不变,即
padding=(F-1)/2的 same padding 效果) - W=32, F=5, P=2, S=2:N=(32-5+4)/2+1= 16.5 ← 不是整数,说明这组参数搭配不合理。公式最大的实用价值就在这里:调参数之前先算一遍,别等运行时报形状错误。
- 一个完整小网络(输入单通道 28×28):
Conv(F=5,S=1) → 24→MaxPool(k=2,s=2) → 12→Conv(F=5,S=1) → 8→MaxPool(k=2,s=2) → 4,得到 4\times4 特征图再拉平接全连接。
(2)池化层:作用,负责减少特征,特征减少后,提高运算效率;特点(常被问):池化过程不涉及神经网络模型的参数训练,它只是固定的取最大/取平均规则,没有权重;种类,最大池化(导图推荐)、平均池化,推荐理由(导图原话)”因为该方式能够将图片中有特点/具有代表性的特征保留下来”;API,nn.MaxPool2d(kernel_size, stride, padding)、nn.AvgPool2d(kernel_size, stride, padding)。
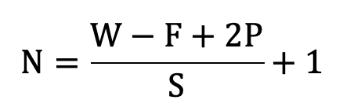
图注:导图中「卷积层」节点下唯一的一张公式图,内容就是特征图(输出尺寸)的计算公式 N = \dfrac{W – F + 2P}{S} + 1。图里只有这一个式子、没有额外文字说明,因此变量含义要结合上下文自己对应:W 是输入尺寸、F 是卷积核尺寸、P 是 padding、S 是 stride、N 是输出特征图尺寸。它的位置很关键,挂在「卷积层」节点下,说明它是「配 nn.Conv2d 那五个参数时用来验算」的工具,而不是理论推导。
4.11 网络家族之二:RNN 循环神经网络
定义(导图原话):含有循环层的神经网络,称之为循环神经网络。专门用来处理序列数据。序列数据中最有代表性的数据是文字。CNN 处理的是网格(长宽两个方向都有空间关联),RNN 处理的是序列(只有先后一个方向);关键设计是同一个循环层在不同时间步之间复用,并把上一步的「记忆」传给下一步。
机制与结构
RNN 结构 = 输入层 + 循环层 + 输出层NLP 任务执行流程(导图四步):① 准备语料库;② 预处理,分词、去重、构建词汇表;③ 词嵌入层 Embedding,输入词索引,得到词向量;④ 循环层,把词向量作为输入数据输入循环层。
分词用 jieba:分词后的列表 = jieba.lcut(字符串内容)。
词嵌入层 nn.Embedding(num_embeddings, embedding_dim):num_embeddings 是去重后词的个数(词表大小),embedding_dim 是词向量的维度、也就是向量中有多少个数字。参数量 = 两者相乘,即词表 5000 × 8 维 = 40000 个可学习参数。Embedding 本质是一张可训练的查找表,所以参数量就是表的格子数。
循环层:
rnn = nn.RNN(input_size, hidden_size, num_layers, batch_first)
output, hidden = rnn(input, h0)| 参数 | 含义(导图解释) |
|---|---|
input_size |
输入词的词向量维度 |
hidden_size |
隐藏状态的向量维度 |
num_layers |
隐藏层的层数,也就是循环网络层的层数 |
batch_first |
是否将 batch_size 的维度信息放在张量的第一位 |
| 张量 | shape 与含义(导图逐项列出) |
|---|---|
input |
[seq_len 每条句子中词的个数, batch_size 一个批次中句子的条数, input_size 输入词的词向量维度] |
h0 |
[num_layers 隐藏层的层数, batch_size, hidden_size 隐藏状态的向量维度] |
output |
[seq_len, batch_size, hidden_size] ← 本次预测结果(每个时间步都有一份) |
hidden |
[num_layers, batch_size, hidden_size] ← 更新后的隐藏状态(只保留最后一步) |
注意 output 和 hidden 的关系:output 是所有时间步的输出(seq\_len 份),hidden 只是最后一个时间步更新后的状态(第 0 维是 num_layers 而非 seq_len)。要接分类头通常取 output 的最后一步,或直接用 hidden。
设 input_size=8(词向量 8 维)、hidden_size=4、num_layers=1、batch_size=2、seq_len=3(三个词的句子):
import torch, torch.nn as nn
rnn = nn.RNN(input_size=8, hidden_size=4, num_layers=1, batch_first=True)
x  = torch.randn(3, 2, 8)     # [seq_len, batch_size, input_size]
h0 = torch.zeros(1, 2, 4)     # [num_layers, batch_size, hidden_size]
out, hn = rnn(x, h0)
print(out.shape, hn.shape) # torch.Size([3, 2, 4]) torch.Size([1, 2, 4])参数量:weight\_ih\_l0 是 4\times8=32(输入到隐藏),weight\_hh\_l0 是 4\times4=16(隐藏到隐藏),两个 bias 各 4,合计 32+16+4+4= 56 个参数。这 56 个参数在三个时间步里是同一套(权值共享),所以序列再长参数量也不涨,这既是 RNN 相比全连接处理长文本的优势,也是它「记不住很远的东西」的根源(同一套参数反复连乘)。
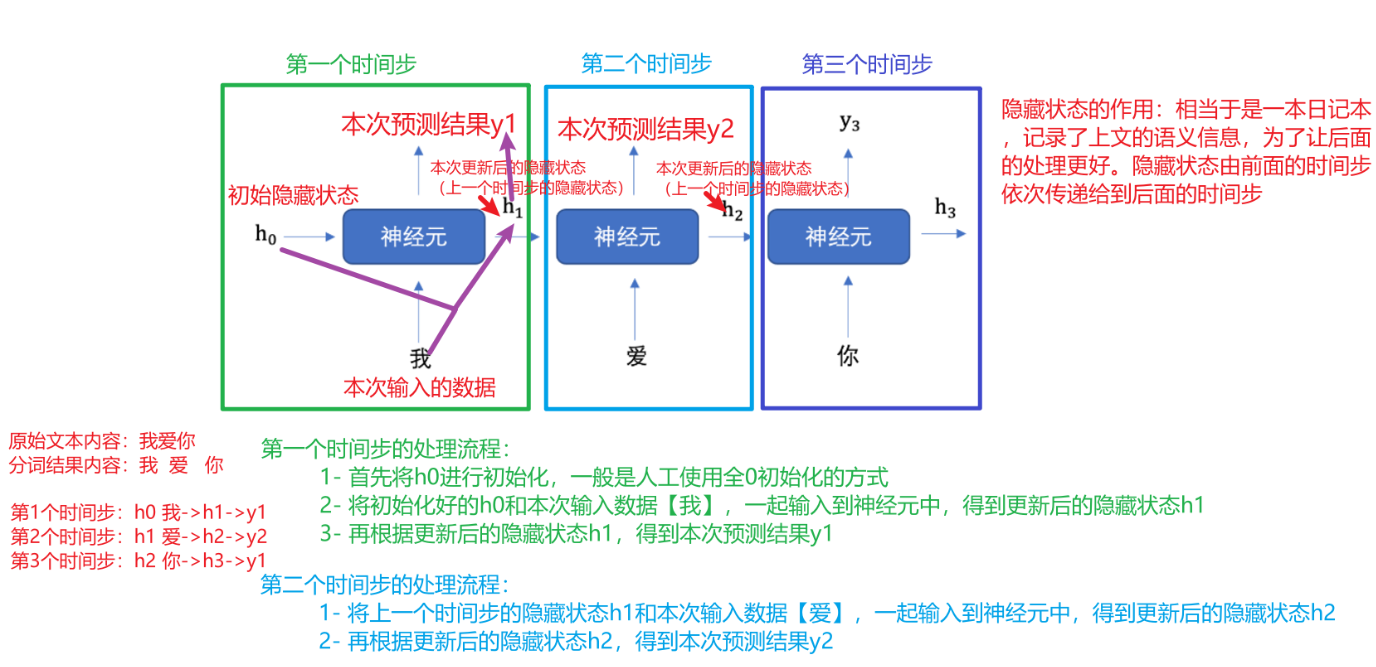
图注:导图 RNN 分支下唯一的示意图,把「循环层」按时间步展开成三列。图左端标注 原始文本内容 为「我爱你」,旁边标 分词结果 为「我 / 爱 / 你」;开头有一个 初始隐藏状态 h0 送入第一个时间步,图上文字说明 h0「一般全 0」,对应代码里的 torch.zeros(num_layers, batch_size, hidden_size)。三个时间步的骨架完全一样:上一步的隐藏状态 + 本次输入词 → 神经元(线性求和 + 激活函数)→ 一边输出本步预测结果、一边输出更新后的隐藏状态。具体是:h0 与「我」一起进神经元,得到更新后的隐藏状态 h1 和本次预测结果 y1;h1 与「爱」一起进同一个神经元,得到 h2 和 y2;h2 与「你」一起进同一个神经元,得到 h3 和第三份输出(图右下角这一格的标签仍写作 y1,与第一格重复,按上下文应为第三个时间步的输出)。图右侧红字解释隐藏状态的意义:「隐藏状态,相当于是一本日记本,记录了上文的语义信息,为了让后面的处理更好。隐藏状态由前面的时间步依次传递给后面的时间步。」 最直观的一点是:横向上每个时间步用的是同一个神经元(同一套参数),纵向上传递的只有隐藏状态,这就是 output(每个时间步都输出)和 hidden(只保留最后一步)两个返回值的图形来源。
4.12 导图中没展开、但必须知道位置的两件事
导图在 RNN 节点下只写了基础 RNN(nn.RNN),没展开 LSTM / Transformer,但它们的位置必须说清楚,否则会被追问:
- LSTM:RNN 的
h只有一个通道,同一套参数反复连乘导致长距离梯度消失;LSTM 在h之外增加一条细胞状态通道,并用门控(输入门/遗忘门/输出门)决定「写入什么、忘掉什么、读出什么」,把「反复连乘」改成「加法主导」的路径。output/hidden的语义、num_layers的含义在 LSTM 里完全一致,只是hidden变成(h, c)二元组。 - Transformer:把 RNN 的「按时间步串行递归」换成「Attention 一次性看全序列」,同时解决 RNN 无法并行、长距离依赖衰减两个问题,位置信息靠位置编码补回。BERT / GPT 都在这条线上。和项目的关系:BERT 是「预训练 + 微调」,但微调时的训练循环、损失函数、优化器、Dropout、
model.train()/eval()这套流程与 4.9 完全同构,只有模型结构和数据格式变了,训练骨架没变。
五、易错点与常见误解
① 训练忘了「梯度清零」
常见说法:「loss.backward() 会自动覆盖上一轮的梯度。」
实际上,.grad 是累加的,必须在 backward() 之前调用 optimizer.zero_grad()。
为什么:梯度累加是有意设计的特性(模拟大 batch、多 loss 共同贡献),清零的责任交给使用者。漏写会让梯度越滚越大、loss 直接发散。
② forward 里自己加了 Softmax,再送 CrossEntropyLoss
有人以为「输出层要用 Softmax,所以我最后加一层 nn.Softmax。」
其实CrossEntropyLoss 公式中已包含 Softmax,forward 应输出裸 logits。
原因在于,等价于做两次归一化,梯度被严重压扁,训练变慢甚至不收敛。自查:模型最后一行有没有 Softmax/log_softmax,有就去掉。
③ 推理时忘了 model.eval()
常听到的一种说法是:「eval() 只是个标记,不影响结果。」
真实情况是,eval() 会切换 Dropout 和 BN 的行为,直接影响输出。
背后的道理是,训练态 Dropout 随机失活并 ×1/(1-p),推理态全部神经元参与、不缩放;BN 训练态用当前 batch 统计量,推理态用累积的全局统计量。忘了切,线上结果每次都不同、指标也明显偏低。
④ 以为池化层需要训练参数
容易想岔的地方:「池化和卷积一样都有权重,也要学。」
事实正相反,导图原话,”池化过程不涉及神经网络模型的参数训练”,它只是固定的取最大/取平均规则。数参数量时池化层贡献为 0。
⑤ 混淆 cat 和 stack
先说一个误解:「都是拼接,随便用哪个。」
实际上,cat 维度数不变、要求非拼接维一致;stack 维度数 +1、要求形状完全一致。
之所以如此,stack 本质是「先 unsqueeze 再 cat」,用来把 N 个同形状张量组成带 batch 维的新张量。用错要么直接抛形状错误,要么悄悄多出一个维度传到下游。
⑥ 以为 RNN 的 output 和 hidden 是同一个东西
常见说法:「RNN 返回的 output 就是最后那个隐藏状态。」
其实output 是 [seq_len, batch, hidden_size](每个时间步都有一份),hidden 是 [num_layers, batch, hidden_size](只有最后一个时间步)。
为什么:两者第 0 维含义不同(序列长度 vs 层数)。序列标注(每个词一个标签)要用 output,整句分类可以用 hidden。
六、横向对比与研究脉络
6.1 网络家族对比
| 网络 | 核心机制 | 优点 | 缺点 | 适用场景 | 复杂度/参数量 |
|---|---|---|---|---|---|
| ANN(全连接 FC) | 每个神经元与上游全部神经元相连 | 表达能力强,任意形状特征都能吃 | 参数量随输入维度爆炸;图片拉平后丢失空间信息 | 表格数据、特征工程后分类 | 参数 \approx\sum in_i\times out_i |
| CNN | 局部连接 + 权值共享 + 池化降维 | 参数少、能学空间局部特征 | 只擅长网格结构数据,对序列不自然 | 图像分类、目标检测 | 只与卷积核个数/尺寸有关,与图片大小无关 |
| RNN | 循环层 + 隐藏状态按时间步传递 | 能处理任意长度序列,参数量不随序列增长 | 串行无法并行;长距离依赖梯度消失 | 文本分类、序列标注、时序预测 | 单层 \approx hidden\times(input+hidden)+2\times hidden |
| LSTM | RNN + 细胞状态 + 三门控 | 能记长距离依赖,缓解梯度消失 | 结构更复杂、参数是 RNN 数倍、仍串行 | 长文本建模、语音、时序 | 约为同尺寸 RNN 的 4 倍 |
| Transformer | Self-Attention 一次性看全序列 | 可并行、长依赖建模强、易堆叠 | 计算量随序列长度平方增长;需位置编码 | BERT / GPT 等大模型 | 与序列长度平方相关 |
6.2 演进脉络(谁解决了谁的什么问题)
线性回归(只能拟合直线)
   ↓ 问题:线性模型无法处理复杂业务场景
加激活函数 → 神经元(导图:在线性关系里引入非线性关系)
   ↓ 问题:单层表达力有限
堆叠隐藏层 → 多层感知机(ANN / 全连接网络)
   ↓ 问题:① 处理图片参数爆炸 ② 丢失空间信息 ③ 权重全 0 导致对称性无法打破
   解决:kaiming / xavier 初始化;CNN 用局部连接 + 权值共享压参数
   ↓ 问题:网络深了梯度消失、训练不动
   解决:ReLU 替代 Sigmoid/Tanh(导图:Sigmoid ≤5 层、Tanh ≤10 层);
          BatchNorm 稳定分布;Dropout 防过拟合
   ↓ 问题:文字是序列数据,网格那套搬不过来
RNN(循环层 + 隐藏状态按时间步传递,参数量不随序列长度增长)
   ↓ 问题:隐藏状态被反复连乘,长距离依赖梯度消失,且无法并行
   解决:LSTM 加细胞状态与门控;Transformer 用 Attention 取代递归
   ↓ 落地
BERT / GPT 等预训练大模型(训练流程与 §4.9 完全同构)
一句话脉络:激活函数解决「能不能非线性」,初始化与 BN 解决「深了能不能训」,CNN 与 RNN 解决「数据有没有结构」,LSTM 与 Transformer 解决「长序列记不记得住」。每一环都是为了修上一环的具体毛病。
七、在新闻分类项目中的落地
新闻分类项目是一条四模型逐级对比的流水线:TF-IDF + 随机森林 → FastText → BERT(transformers 微调)→ LLM(DeepSeek API 零样本/少样本分类),任务是把新闻标题分成 10 个类别,训练 18w / 验证 1w / 测试 1w,格式 标题\t标签。这份「深度学习」材料覆盖的正是第三级(BERT 微调)的全部底座,并直接支撑最后一步的模型压缩。
7.1 用在哪一步
| 项目环节 | 这份材料里的对应知识 |
|---|---|
| 从随机森林升级到 BERT | 4.6 损失函数(CrossEntropyLoss,10 类 = 10 个输出神经元)、4.4 激活函数(输出层 Softmax) |
| BERT 微调训练脚本 | 4.9 全部流程:Tensor/Dataset/DataLoader → nn.Module → 三层实例对象(模型/损失/优化器)→ model.train() → 外层轮次+内层批次 → 前向/算损失/梯度清零/反向/更新 → 保存 → 画 loss 曲线 |
| 数据管道 | 4.1 张量形状(标题\t标签 → token id → attention mask → [N, seq_len],batch 维用 unsqueeze/stack 拼) |
| FastText 与 BERT 的桥 | 4.11 的 Embedding 与词向量,FastText 用 __label__标签名 文本 训出的词向量,和 nn.Embedding 是同一概念的两种实现 |
| 模型压缩(量化/剪枝/蒸馏) | 4.8 的 Dropout/BN 影响 state_dict;量化/剪枝直接作用在 nn.Linear 这类 nn.Module 上,必须先看懂模块结构 |
| 蒸馏损失 | 4.6 交叉熵 + 软标签里的 Softmax 温度。项目公式 loss = (1-alpha)*hard_loss + alpha*(T*T)*soft_loss 用 F.kl_div(),而 KL 散度正是「交叉熵 − 熵」,所以 4.6 是它的直接前置 |
7.2 关键参数怎么调
- 优化器:BERT 微调用
AdamW(Adam 的权重衰减修正版),依 §4.7「一个优化器同时优化梯度值和学习率」的推荐,默认就用 Adam 家族。学习率不要用预训练级别的大 lr,常规做法是 2e-5 ~ 5e-5 这种小值(微调是「小步走」)。 - 损失函数:
nn.CrossEntropyLoss(),forward 输出裸 logits,不要自己加 Softmax(本文易错点②),输出层out_features=10。 - batch size:受显存限制,常用量级 16 / 32;BN/Dropout 都依赖 batch 语义,batch 太小会不稳定。
- 轮次:微调 2~4 个 epoch 就够(预训练已学过语言),不要盲设 50 轮。依 §4.7 的提醒「实际工作中训练的轮次也是不固定的」,默认不加
StepLR,让 Adam 自适应。 - Dropout:BERT 内部已自带 Dropout(量级 0.1),不要外面再叠一个大 p 的,会欠拟合;若要加,按导图推荐用 0.1 或 0.2。
- max_length 截断:新闻标题短,设小一点(如 32/64),直接决定显存和速度;
seq_len就是[N, seq_len]的第二维。
7.3 实际坑(按踩到概率排序)
- 忘了
optimizer.zero_grad()→ 梯度累加,loss 直接炸(易错点①,训练脚本最高频的 bug)。 - 推理/评估忘了
model.eval()+with torch.no_grad()→ 指标偏低且每次不一样,显存还白占;BERT 微调脚本里这两行必须在验证循环开头。 - forward 里加了 Softmax 又送 CrossEntropyLoss → 训练不收敛。
- 标签和 logits 的维序搞反 →
CrossEntropyLoss要求输入[N, n_class]、目标[N],argmax要指定dim=1。 - token 与 label 没对齐 → 文本分类是「整条标题一个标签」,不要给每个 token 都打标签。
- 学习率照搬预训练值 → loss 震荡不收敛,微调必须用小 lr。
- 量化/剪枝后忘了重新评估 → 压缩会掉点,必须回到 1w 测试集重算指标并与压缩前对比。
7.4 和项目里其它方案怎么配合
- TF-IDF + 随机森林(基线):不用本文这套流程,但它是对照系,被追问时要说清「TF-IDF 是词袋、丢词序,随机森林是树模型、特征是人肉设计的;BERT 端到端学表示,指标更高但成本也更高」。
- FastText(中间级):用
train_supervised()/autotuneValidationFile/test()拿到(样本数, 精确率, 召回率);它的 Embedding 思路与 §4.11 的nn.Embedding同源,但本质还是词袋 + n-gram、语义浅,这是它输给 BERT 的原因。BERT 则直接用 §4.9 的训练骨架与 §4.2 的参数更新方式。 - LLM(DeepSeek API)与模型压缩:LLM 零样本/少样本分类不需要训练,训练流程用不上,但它排在最末级,说明整条路线的叙事是「从要人肉特征 → 到要训练 → 到不训练只写 prompt」;模型压缩(QAT/PTQ/DQ 量化、剪枝、蒸馏)的操作对象就是 §4.8 里那些
nn.Module和参数,能看懂模块结构,才能判断哪些层可以剪、量化误差会不会失控,压缩后还要回到 §4.9 的评估流程重算指标。
八、重点问答
Q1:什么是前向传播,什么是反向传播?
A:前向传播就是根据样本数据的特征值算出预测值,数据从输入层一层层走到输出层,每层是「线性求和 + 激活函数」。反向传播是把预测值和真实值一起送进损失函数得到损失值,再让损失值越来越小,从而求出最优的 w 和 b,它从 loss 出发用链式法则反着算每个参数的偏导。两者合起来构成一次迭代:前向算数、反向算导,最后由优化器执行 W1 = W0 - lr*grad 真正改参数。我平时写的 loss.sum().backward(),就是让 torch.autograd 自动微分模块替我算偏导,值放在每个张量的 .grad 里。
Q2:神经网络结构由什么组成?激活函数怎么选?
A:结构上由输入层、隐藏层、输出层组成,隐藏层的层数和每层神经元个数由开发人员自定义,网络结构呈菱形(先宽后窄)时效果相对好。每个神经元内部都是「线性求和 + 激活函数」两步;nn.Linear(in_features, out_features) 的含义就是「输入特征个数 = 上一层神经元个数」「输出特征个数 = 本层神经元个数」。激活函数分位置选:隐藏层大多数情况用 ReLU,效果一般就换 Leaky ReLU 这类变体;也可以用 Sigmoid 或 Tanh,但受层数限制,Sigmoid 不超过 5 层、Tanh 不超过 10 层,因为两端饱和会导致梯度消失。输出层不管二分类还是多分类都推荐 Softmax,因为二分类就是多分类的特殊情况。实现上要注意 CrossEntropyLoss 已内含 Softmax,forward 输出裸 logits 就行。
Q3:PyTorch 里调整张量形状、拼接张量的方法有哪些?注意事项是什么?
A:形状操作三组:reshape 改形状(可升降维,里面最多用一个 -1 让框架推算);squeeze/unsqueeze 降维升维(unsqueeze(dim) 插入长度为 1 的新维度,squeeze(dim) 删掉指定维度上长度为 1 的维度,不传 dim 就删掉所有长度为 1 的);transpose/permute 交换维度位置。注意事项:修改前后元素总个数必须保持不变;transpose 一次只换两个位置、permute 一次换多个,导图推荐维度多(≥5)且只换两个位置时用 transpose,否则 permute;view 只能用于连续张量。拼接方面,cat 要求除拼接维度以外其它形状一致、拼完维度数不变,stack 要求形状完全一致、拼完维度数加 1。
Q4:参数初始化怎么选?
A:默认组合是权重用 kaiming 初始化,偏置用全 0。细分:激活函数是 ReLU 就用 kaiming,是其他激活函数其他随机初始化方式都行;浅层网络(隐藏层 ≤5 层)各种随机初始化都行,深层网络(隐藏层 >5 层)推荐 kaiming 或 xavier。为什么权重不能全 0,同层权重全为 0 时每个神经元的前向输出和反向梯度完全相同,更新后仍然完全相同,等于这层只有一个神经元,网络宽度白搭,这叫对称性无法打破;偏置全 0 没这个问题。kaiming 是专为 ReLU 设计的:ReLU 把一半输入按成 0、激活值方差减半,所以 kaiming 把初始化方差放大来补偿,让各层激活值方差保持稳定。
Q5:损失函数怎么选?
A:分类问题优先强烈推荐 CrossEntropyLoss(内含 Softmax,模型输出裸 logits 即可),二分类还可以用 BCELoss。回归问题优先强烈推荐 SmoothL1Loss,因为它综合了 L1 和 L2 的优点,L1Loss(MAE)的缺点是在 0 点处不可导,L2Loss(MSE)的缺点是误差算的是平方、大误差会把梯度放大,可能导致梯度爆炸。SmoothL1 的直觉是误差小的时候按 L2 走、平滑可导,误差大的时候按 L1 走、梯度被恒住。举例:误差 e=−3 时 L2 梯度是 −6,误差放大到 −30 时变成 −60,而 SmoothL1 一直是 ±1。
Q6:学习率和梯度值的优化方法有哪些?你实际工作中一般用哪个,为什么?
A:分自动和手动两条线。自动优化就是优化器:Momentum 只优化梯度值,AdaGrad 和 RMSprop 只优化学习率(逐参数自适应),Adam 两个都优化、等价于 Momentum + RMSprop;β 推荐 0.9、0.99、0.999。手动优化是调度器:等间隔 StepLR(step_size=50, gamma=0.5)、指定间隔 MultiStepLR(milestones=[50,125,160])、指数衰减 ExponentialLR(gamma=0.95)。我默认用 Adam,因为一个优化器同时把梯度值和学习率都处理了,结构复杂、不确定 lr 怎么设时它最稳;只有结构非常简单、或轮次完全固定需要精细控制收敛曲线时,才退回 SGD/Momentum 加手动调度。导图里也说了:实际工作中结构复杂、轮次不固定,人为控制学习率很麻烦,所以这部分理解即可。
Q7:如何缓解神经网络过拟合?
A:最核心两招是 Dropout 和批量归一化。Dropout 的做法是每个神经元都有概率 p 被失活、但神经元本身还是存在的,只是把它的输出激活值重置为 0,然后把没失活的神经元激活值乘以 1/(1-p) 做补偿,目的是让训练时的激活值量级和推理时(推理不 dropout)一致,p 一般取 0.1 或 0.2。BN 是对参与训练的每个 batch 批次的数据做标准化处理,再乘可学习参数 γ 加 β,导图说它主要用在计算机视觉领域。另外配合的还有:网络结构走菱形、深层网络用 kaiming/xavier 初始化、学习率别设太大。这两个机制还有个共同点,推理时必须调用 model.eval()。
Q8:CNN 卷积网络由什么组成?
A:含有卷积层的神经网络就称为卷积神经网络。结构上是输入层、隐藏层、输出层,隐藏层里最关键的是卷积层和池化层:卷积层负责特征提取,池化层负责减少特征值的个数、也就是特征降维。卷积层 API 是 nn.Conv2d(in_channels, out_channels, kernel_size, padding, stride),out_channels 既是输出通道数、也等价于卷积核个数、等价于特征图个数;kernel_size 一般是奇数、在 3~11 之间;padding 在图片四周填 0,作用是让图片四周的特征得到充分的提取,一般 0~2;stride 一般 1~2。输出尺寸用 N=(W-F+2P)/S+1 算:32 输入、F=5、P=2、S=1 输出还是 32,S 改成 2 就得到 16.5,说明这组参数搭配不合理,这个公式最大的用处就是调参前先验算。池化层推荐最大池化,因为它能把图片中有特点、有代表性的特征保留下来;还有一个常被追问的特点:池化过程不涉及神经网络模型的参数训练。
九、延伸阅读
官方文档 / 工具
– PyTorch 官方文档:https://pytorch.org/docs/stable/index.html(torch.nn、torch.optim、torch.optim.lr_scheduler 三节对本文 4.4–4.9 是权威依据)
– torch.autograd 文档:https://pytorch.org/docs/stable/autograd.html(对应本文 4.2)
– torch.Tensor 形状与拼接 API 文档(reshape / squeeze / unsqueeze / permute / cat / stack,对应本文 4.1)
– jieba 分词:https://github.com/fxsjy/jieba(对应本文 4.11 的 jieba.lcut)
论文(本文涉及的关键机制出处)
– Rumelhart, Hinton & Williams, 1986 — 反向传播算法的经典论文(对应 4.2)
– Glorot & Bengio, 2010 — Xavier 初始化(对应 4.5)
– He et al., 2015 — Delving Deep into Rectifiers,kaiming 初始化与 PReLU(对应 4.4 / 4.5)
– Srivastava et al., 2014 — Dropout(对应 4.8)
– Ioffe & Szegedy, 2015 — Batch Normalization(对应 4.8)
– Kingma & Ba, 2014 — Adam 优化器(对应 4.7)
– LeCun et al., 1998 — Gradient-Based Learning Applied to Document Recognition,LeNet 与 MNIST(对应 4.10)
– Hochreiter & Schmidhuber, 1997 — Long Short-Term Memory(对应 4.12)
– Vaswani et al., 2017 — Attention Is All You Need(对应 4.12)
数据集
– MNIST:手写数字,28\times28 单通道,最经典的 CNN 入门数据集(对应 4.10 的尺寸演算)
– IMDB:影评情感二分类,标准 RNN/LSTM 文本分类数据集(对应 4.11)
– 项目自建:头条新闻标题数据集,18w 训练 / 1w 验证 / 1w 测试,格式 标题\t标签,10 个类别(对应第七节)