把”一棵树不靠谱”变成”一片森林很靠谱”,Bagging / Boosting 两大流派 + 随机森林 / AdaBoost / GBDT / XGBoost 的完整推导;随机森林是新闻分类项目 TF-IDF 基线的基线模型。
一、这份材料解决什么问题
单个模型有天花板:决策树太浅欠拟合、太深过拟合,线性模型处理不了非线性。集成学习(Ensemble Learning)给的是同一个答案的两种变体,既然很难直接造一个完美模型,就造一堆”各自不完美、但错的地方不一样”的弱学习器,组合起来让错误互相抵消。
课件开篇的定义:集成学习”通过多个模型的组合形成一个精度更高的模型,参与组合的模型称为弱学习器(weak learner);训练时使用训练集依次训练出这些弱学习器,对未知样本预测时使用这些弱学习器联合预测”。
它在学习链条里的位置:前面是单模型(决策树、KNN、朴素贝叶斯),这里进入多模型,后面是深度学习(自动学特征,不再手工拼模型)。
对新闻分类项目,最直接的价值是随机森林,TF-IDF + 随机森林 这条基线的最后一环。把”为什么随机森林比单棵树好”讲清楚,等于同时证明你懂偏差方差、懂特征工程的意义、也懂后面 BERT 为什么值得上。AdaBoost / GBDT / XGBoost 则是表格数据的王者,也是被追问”你了解哪些树模型”时的标准答案。
二、核心结论
- 集成的本质是误差解耦。弱学习器要有效,前提是”单个够用 + 彼此不一样”。Bagging 用有放回抽样 + 特征随机制造差异,Boosting 用样本重加权制造差异。
- Bagging 降方差,Boosting 降偏差。方向用错了,怎么调参都没用:高偏差模型(深度 1 的树桩)做 Bagging 几乎没收益。
- 随机森林 = Bagging + 决策树 + 第二次随机。平均后方差为 \rho\sigma^2+\frac{1-\rho}{T}\sigma^2,相关系数 \rho 才是决定成败的那一项,加树消不掉它,只能靠特征随机压下来。
- 随机森林自带验证集。每棵树的 bootstrap 抽样会漏掉约 36.8% 的样本,这些 OOB(Out-of-Bag)样本让
oob_score=True一行代码拿到接近交叉验证的泛化估计。 - XGBoost 相对 GBDT 的三处核心改进:① 目标函数二阶泰勒展开(GBDT 只用一阶负梯度);② 显式正则化项 \gamma T+\frac{1}{2}\lambda\|w\|^2;③ 打分函数(gain)决定分裂 + 工程层的列采样、稀疏感知、近似分位点。
三、知识地图
集成学习(80 页)
├── 一、集成学习思想与分类                                  【掌握】
│   ├── 定义:多个弱学习器 → 联合预测                       【掌握】
│   ├── Bagging:自助抽样 / 平权投票 / 并行                 【掌握】
│   ├── Boosting:关注前一个的不足 / 加权投票 / 串行        【掌握】
│   └── 分类:Bagging(随机森林) vs Boosting(AdaBoost、GBDT、XGBoost、LightGBM) 【理解】
│
├── 二、随机森林算法(第 14–24 页)                         【掌握·重点】
│   ├── 双重随机:随机选数据 + 随机选特征                   【掌握】
│   ├── 为什么有放回:既有交集又有差异                      【理解】
│   ├── API:sklearn.ensemble.RandomForestClassifier        【掌握】
│   ├── 泰坦尼克号案例:单树 vs RF vs 网格搜索              【掌握】
│   └── 投票:分类平权投票 / 回归简单平均                   【理解】
│
├── 三、AdaBoost 算法(第 25–41 页)                        【掌握】
│   ├── 思想:逐步提高被分错样本的权重                      【理解】
│   ├── 迭代:训练 → 算误差 → 更新样本/模型权重             【掌握】
│   ├── 公式:模型权重 α、样本权重 D、归一化 Z、sign 集成   【掌握】
│   ├── 手算例题:10 样本、3 轮、最终 H(x)                  【掌握】
│   └── 葡萄酒数据实战(二分类 + 500 棵树 + learning_rate)  【理解】
│
├── 四、GBDT(第 42–55 页)                                 【理解】
│   ├── 提升树:拟合残差(年龄预测的递推例子)              【理解】
│   ├── 梯度提升树:拟合负梯度而非残差                      【理解】
│   ├── 初始化:目标值均值使平方误差最小                    【了解】
│   ├── 构建流程:迭代 + 组合输出                           【理解】
│   └── 泰坦尼克号案例 + 网格搜索                           【了解】
│
└── 五、XGBoost(第 56–80 页)                              【理解】
    ├── 目标函数:损失 + 正则化                             【理解】
    ├── 模型复杂度:γT + ½λ‖w‖²                            【理解】
    ├── 二阶泰勒展开 → 叶子角度转换                         【了解】
    ├── 最优 w、最优目标值、打分函数 Gain                    【了解】
    ├── API:XGBClassifier + 样本不均衡 + 分层交叉验证        【掌握】
    └── 红酒品质多分类案例                                  【了解】
课件未覆盖但常被问:Stacking / Blending(见 §4.8,通识补充)。
四、原理详解
4.1 集成学习是什么:弱学习器 + 联合预测
一个人猜硬币 50% 中对,一万个人投票,只要他们的错误不是同向的,多数人的答案就会很准。
训练集上训练出 T 个弱学习器 h_1,\dots,h_T(”弱”指单个模型精度只比随机猜好一点即可),预测时联合起来:
H(x)=\text{Combine}\big(h_1(x),h_2(x),\dots,h_T(x)\big)
Combine 的两种经典形态就是两大流派:
| Bagging | Boosting | |
|---|---|---|
| 数据采样 | 有放回抽样,每个学习器看一份不同子集 | 全部样本,按上一轮结果调整样本权重 |
| 投票方式 | 所有学习器平权投票 | 对学习器加权投票 |
| 学习顺序 | 并行,学习器之间无依赖 | 串行,有先后顺序 |
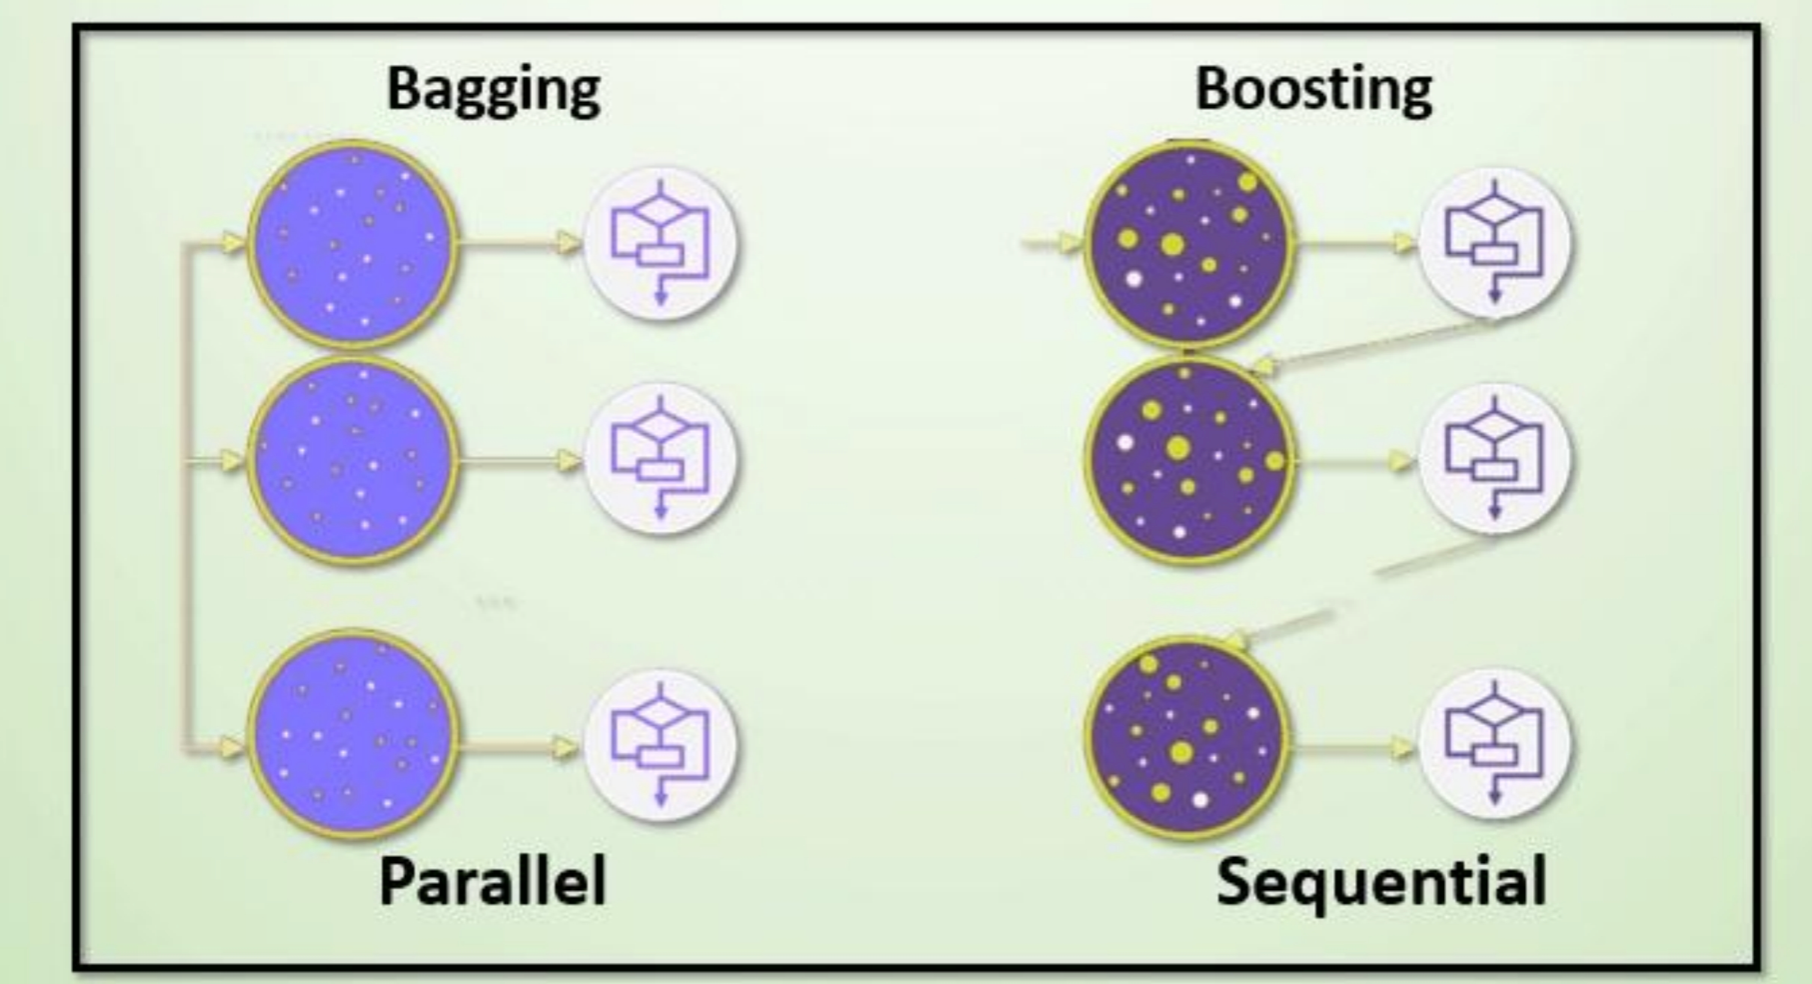
图注:左右两栏对比 Bagging 与 Boosting。左栏 Bagging 下方标注 Parallel,一条主干并列分叉出三个彼此独立的”样本子集 → 决策树”单元;右栏 Boosting 下方标注 Sequential,同样是三个”样本子集 → 决策树”单元,但首尾串联、有先后顺序,且子集里样本点的颜色与大小不一致,暗示每轮样本权重被重新调整过。
课件第 10 页给了个好记的类比:Boosting 像数码宝贝的进化链,”滚球兽 → 亚古兽 → 暴龙兽 → 机械暴龙兽 → 战斗暴龙兽”,学习积累从弱到强。这个比喻只对 Boosting 成立(Bagging 没有升级关系,只有投票)。
4.2 Bagging:并行 + 平权投票
单棵树的问题是”换一批训练数据,树的样子就全变了”(方差大),那就训练很多棵让它们互相抵消。
三步:① 有放回抽样(bootstrap)产生若干个不同的训练子集;② 每个子集训练一个弱学习器(”弱学习器可以并行训练”);③ 平权投票 / 多数表决决定预测结果。
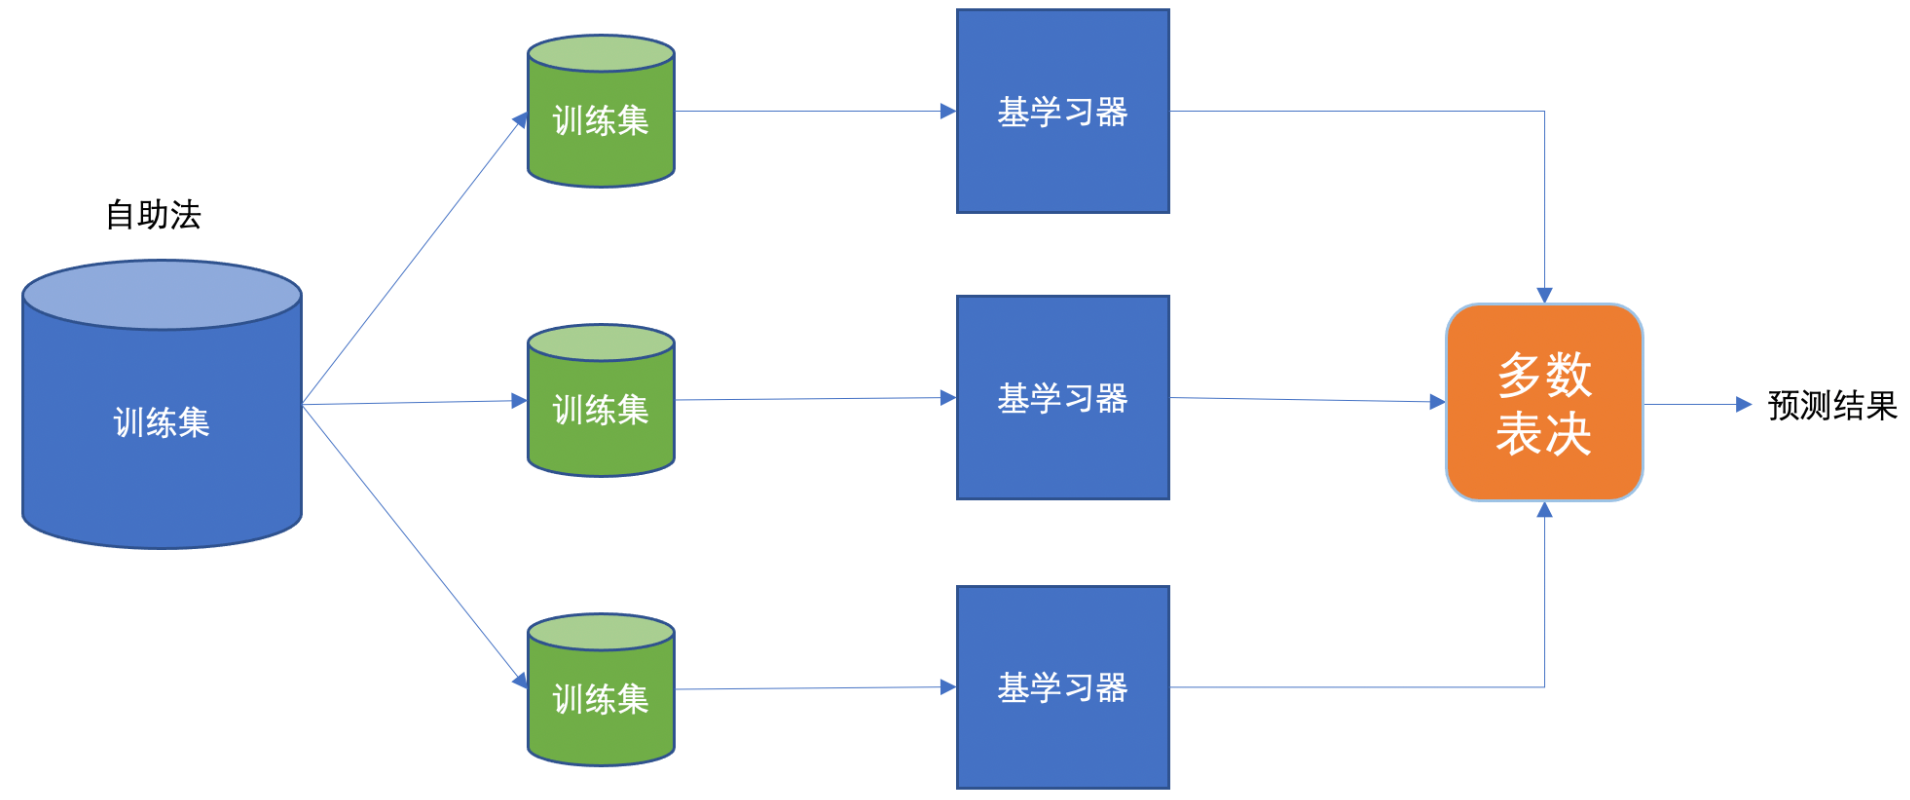
图注:左侧是一个大的蓝色”训练集”圆柱(上方红字标注”自助法”),分出三条箭头指向三个绿色的小”训练集”圆柱;每个小圆柱各接一个蓝色”基学习器”方块;三个基学习器汇入橙色圆角框”多数表决”,最后输出”预测结果”。三路完全并列,这就是 Bagging 可以并行的图形化表达。课件第 8 页用”把圈和方块分类”的二维数据把这套机制再演示了一遍(四张分图见文末存档)。
4.3 Boosting:串行 + 加权投票
每一个训练器重点关注前一个训练器不足的地方;通过加权投票得出结果(好的学习器话语权更大);串行训练,第 t 个学习器依赖第 t-1 个学习器改过的数据分布。
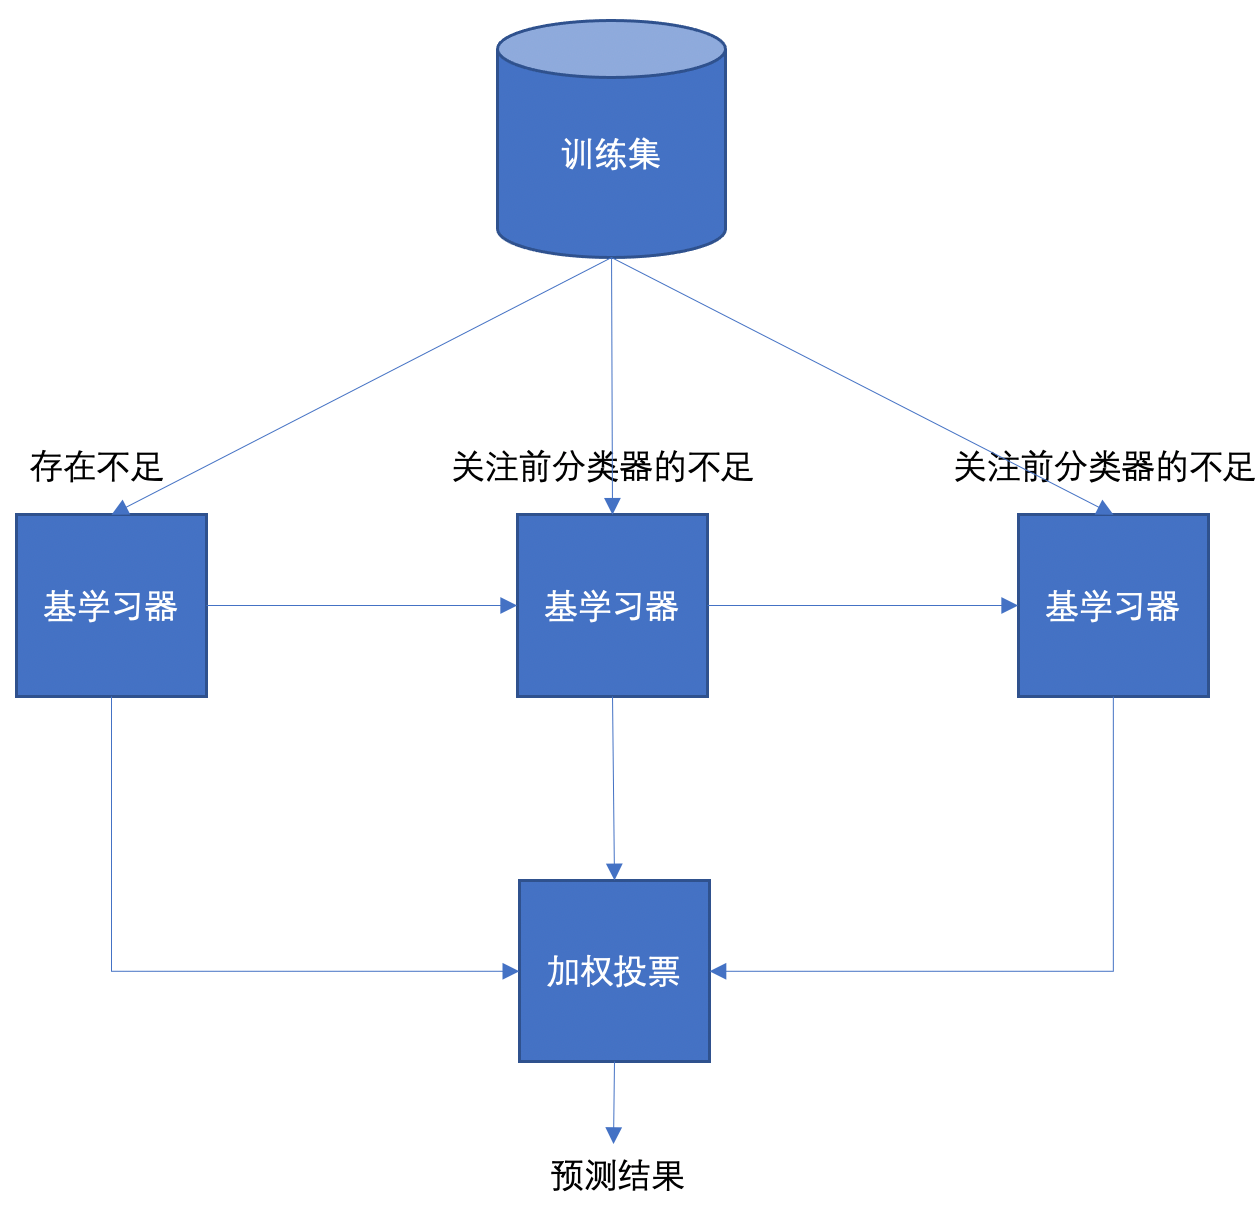
图注:顶部蓝色”训练集”圆柱向下引出三条箭头,分别指向三个并列的蓝色”基学习器”方块;第一条箭头上标注”存在不足”,第二、三条箭头上标注”关注前分类器的不足”,把”每轮都在补上一轮的短板”写在了箭头上。三个基学习器之间另有横向箭头依次串联(左 → 中 → 右),体现串行依赖;再各自向下汇聚到”加权投票”方块,输出”预测结果”。
为什么一个降偏差、一个降方差(必答):Bagging 中每个学习器在同一批数据上独立拟合同一个目标,平均后期望基本不变、方差被摊薄;Boosting 中每轮是往残差/负梯度方向追加一个修正项 f_t=f_{t-1}+h_t,集成结果不断逼近真实函数,偏差一路下降。
4.4 随机森林(重点,理论与项目双高频)
随机森林是 Bagging 思想的代表算法:Bagging + 决策树,每个弱学习器都是一棵决策树。
训练流程:① 有放回地产生训练样本;② 随机挑选 n 个特征(n 小于总特征数量);③ 用这些样本和特征训练一棵决策树;④ 重复 1–3 步构造 n 棵弱决策树;⑤ 预测时平权投票、多数表决(回归场景改为简单平均)。
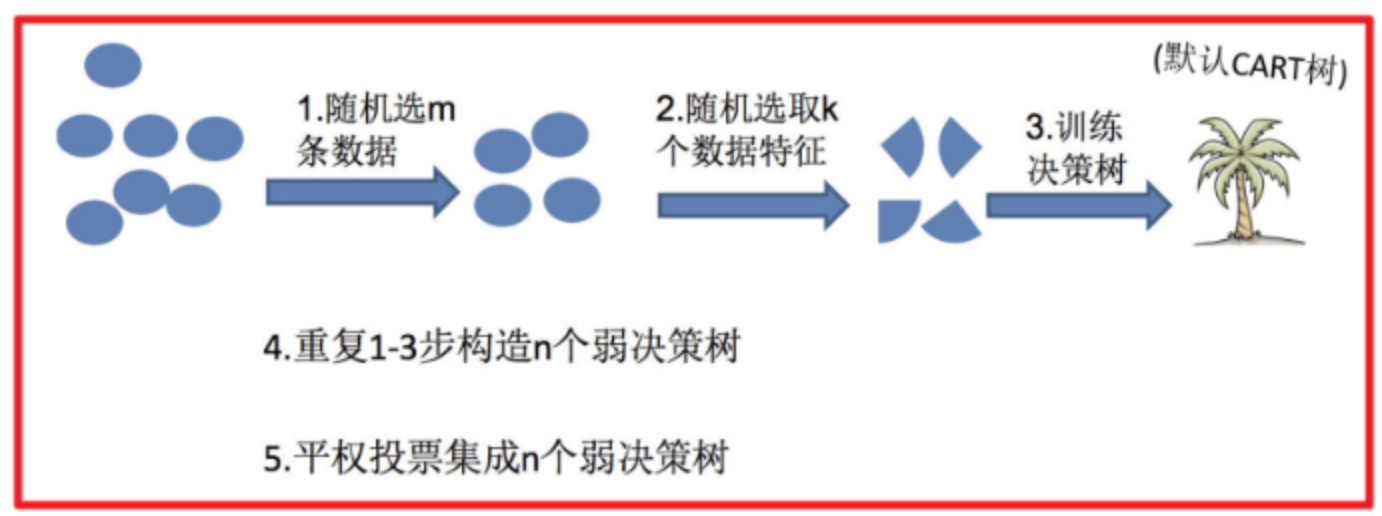
图注:流程从左到右,蓝色圆点群(原始数据集)→「1. 随机选 m 条数据」→ 变小后的圆点群 →「2. 随机选取 k 个数据特征」→ 数据被按特征拆成分散的图形碎片 →「3. 训练决策树」→ 一棵棕榈树图标(右上角标注”(默认 CART 树)”);图下方两行文字:「4. 重复 1-3 步构造 n 个弱决策树」「5. 平权投票集成 n 个弱决策树」。注意”选数据”和”选特征”被画成了两个连续的独立步骤,这就是随机森林相对 Bagging 多出来的那一次随机。
4.4.1 双重随机性
第一次随机(样本随机),解决”树长得一样”。课件思考题 1 的标准答案:如果不进行随机抽样,每棵树的训练集都一样,最终训练出的树分类结果也完全一样,集成退化成了一棵树的复制粘贴,投票毫无意义。
“有放回”的作用:无放回的话每棵树的样本完全没有交集,每棵树都是”有偏的”、差异极大,单棵树质量太差;有放回让各棵树的训练集既有交集也有差异数据,更容易发挥投票表决效果;另外约 36.8% 的样本在某棵树中一次都没被抽到,成为该树的 OOB 样本。
第二次随机(特征随机),解决”树的错误方向一样”。样本随机只让树看的数据不同,但树的错误仍然相关:某个特征判别力特别强时,绝大多数树都会在它上面分裂,于是在难样本上一起错。随机森林在每次节点分裂时只从随机抽出的 k 个特征里选最优分裂特征(分类默认 k=\sqrt{p}),强制不同的树在不同特征子集上做决策,把树与树之间的相关系数 \rho 打下来。
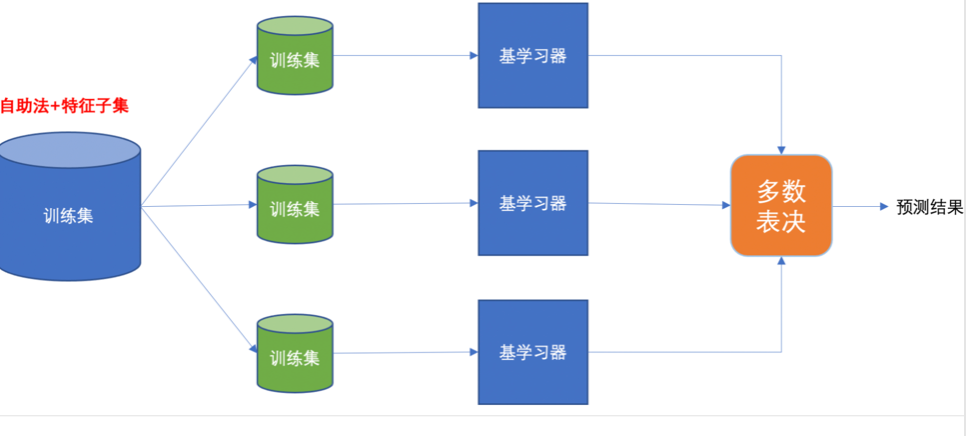
图注:这张图和第 7 页的 Bagging 思想图结构几乎一样(大”训练集”分三路到三个绿色小”训练集”,各接一个”基学习器”,汇入橙色”多数表决”框输出”预测结果”),关键差别在原图左上角的红字标注:”自助法 + 特征子集”。Bagging 只有自助法这一次随机,随机森林在图上被明确补出了”特征子集”这第二次随机。
4.4.2 为什么双重随机能降方差
设单棵树方差为 \sigma^2,任意两棵树预测的相关系数为 \rho,T 棵树取平均:
\text{Var}(\bar h)=\rho\sigma^2+\frac{1-\rho}{T}\sigma^2
这个式子把随机森林的设计动机讲完了:
- 第二项随 T 增大而消失。树数从 10 加到 500,这一项几乎归零,所以增加树的数量不会让随机森林过拟合,只会让它变慢。
- 第一项 \rho\sigma^2 消不掉,它是所有树”共同犯的错”的下限。所以降方差的核心是降 \rho,不是加树。
- 双重随机的两个动作作用点正好是 \rho:自助抽样让每棵树”见过的世界”不同,特征子集抽样让每棵树”做决策的依据”不同。
- 代价是单棵树变弱(偏差略升),但第二项衰减很快,总账仍然是赚的。
一句话:Bagging 靠平均消掉”独立的那部分方差”(\frac{1-\rho}{T}\sigma^2),随机森林的特征随机把”平均消不掉的相关部分”(\rho\sigma^2)也压小,这就是它比纯 Bagging 更稳的原因。
4.4.3 与单棵决策树的对比
| 维度 | 单棵决策树 | 随机森林 |
|---|---|---|
| 训练数据 | 全量数据 | 每棵树一份 bootstrap 子集 |
| 分裂特征 | 全部特征里选最优 | 每次分裂只在随机 k 个特征里选最优 |
| 方差 | 高(换个样本树结构全变) | 低(平均后被摊薄) |
| 偏差 | 可以很低(树足够深) | 与单树接近(平均不增偏差) |
| 过拟合控制 | max_depth / min_samples_leaf / 预剪枝 |
主要靠集成本身,单树可以放得很深 |
| 可解释性 | 强(完整分裂路径) | 弱(只能看特征重要性) |
| 并行程度 | — | 树之间完全并行(n_jobs=-1) |
| 典型表现 | 训练集 100%、测试集掉一大截 | 训练集接近 100%、测试集掉得少 |
课件第 21–22 页的泰坦尼克号案例就是把两者放在同一份数据上直接对比:同一套 x(Pclass/Age/Sex + one-hot)、同一个 random_state=22 的划分,先跑 DecisionTreeClassifier()、再跑 RandomForestClassifier(max_depth=6, random_state=9),最后用 GridSearchCV 搜参。先把基线跑出来,再谈提升。
4.4.4 OOB 估计:免费的验证集
一个样本在 n 次有放回抽样中一次都没被抽到的概率:
P(\text{未被抽中})=\Big(1-\frac{1}{n}\Big)^n\xrightarrow{n\to\infty}\frac{1}{e}\approx 0.368
即每棵树大约覆盖 63.2% 的原始样本,剩下约 36.8% 是该棵树从未见过的。对每个样本,只用那些没在训练中见过它的树去预测并聚合,所有样本的准确率就是 OOB 估计,它近似等价于一次留出法交叉验证的泛化误差。
rf = RandomForestClassifier(n_estimators=300, oob_score=True,
                            bootstrap=True, n_jobs=-1, random_state=42)
rf.fit(X_train, y_train)
print("OOB 泛化精度估计:", rf.oob_score_)     # 不需要单独的验证集
print(rf.oob_decision_function_.shape)       # 每个样本的 OOB 类别概率
三点使用结论:① 可以边调 n_estimators 边看 oob_score_ 曲线是否走平,不必反复切验证集;② OOB 用的是训练集样本(只是没被那棵树看到),不是测试集,最终指标仍要用独立 test 集;③ 数据量极大时计算 OOB 本身有开销,可按需开关。
4.4.5 特征重要性
rf.feature_importances_ 把所有树中”用某特征分裂带来的不纯度下降量”按样本数加权累计后归一化,即 MDI(Mean Decrease in Impurity)/ Gini importance。两个坑:它在训练集上计算,且对高基数特征天然偏爱(取值多 → 分裂点可选得多 → 更容易带来哪怕虚假的不纯度下降)。更可信的替代是置换重要性:在验证集上把某一列打乱,看精度掉多少。
from sklearn.inspection import permutation_importance
res = permutation_importance(rf, X_val, y_val, n_repeats=5, n_jobs=-1, random_state=42)
for name, imp in sorted(zip(feature_names, res.importances_mean), key=lambda t: -t[1])[:15]:
    print(f"{name:20s} {imp:+.4f}")
用法:MDI 用来”快速看个大概”,要下结论(比如”哪个词判别力最强”)必须用 permutation importance 在验证集上复核一遍。
4.4.6 关键参数与调参
课件第 19 页的参数清单里,真正影响效果的只有五六个:
| 参数 | 默认值 | 作用 | 调参建议 |
|---|---|---|---|
n_estimators |
10 | 树的数量 | 越大越好但越慢,误差单调下降后走平;到曲线走平(通常 100~500)就够,加树不会过拟合 |
max_depth |
None | 单棵树最大深度 | 随机森林里单树可以深(方差由集成负责);文本高维稀疏常用 20~50 或 None 配 min_samples_leaf |
max_features |
'auto'(分类时等同 sqrt) |
每次分裂候选特征数 | 降 \rho 的主旋钮。\sqrt{p} 通常是好起点;树太像就调更小(log2 p 或固定 32/64),代价是单树变弱、需要更多树 |
min_samples_leaf |
1 | 叶子最少样本数 | 设 1~5 抑制噪声;文本任务上比 max_depth 更稳 |
min_samples_split |
2 | 分裂所需最少样本 | 配合 min_samples_leaf 用 |
bootstrap |
True | 是否有放回抽样 | 保持 True 才有 OOB;设 False 就退化成”只用特征随机” |
oob_score |
False | 是否计算 OOB | 训练时顺手打开,免费拿一次泛化估计 |
class_weight |
None | 类别权重 | 10 类不均衡新闻分类用 'balanced' |
n_jobs / random_state |
None / None | 并行核数 / 复现 | -1 / 固定住,实验要可复现 |
调参顺序(别一上来就 5 维网格搜索):① 固定 n_estimators=300、max_features='sqrt',用 OOB 曲线确定树数;② 调 min_samples_leaf(1→2→4)压噪声,文本任务这步收益往往比调深度大;③ 再调 max_features 观察验证集变化;④ 最后才小范围 GridSearchCV,每次固定 random_state、用同一份验证集对比。
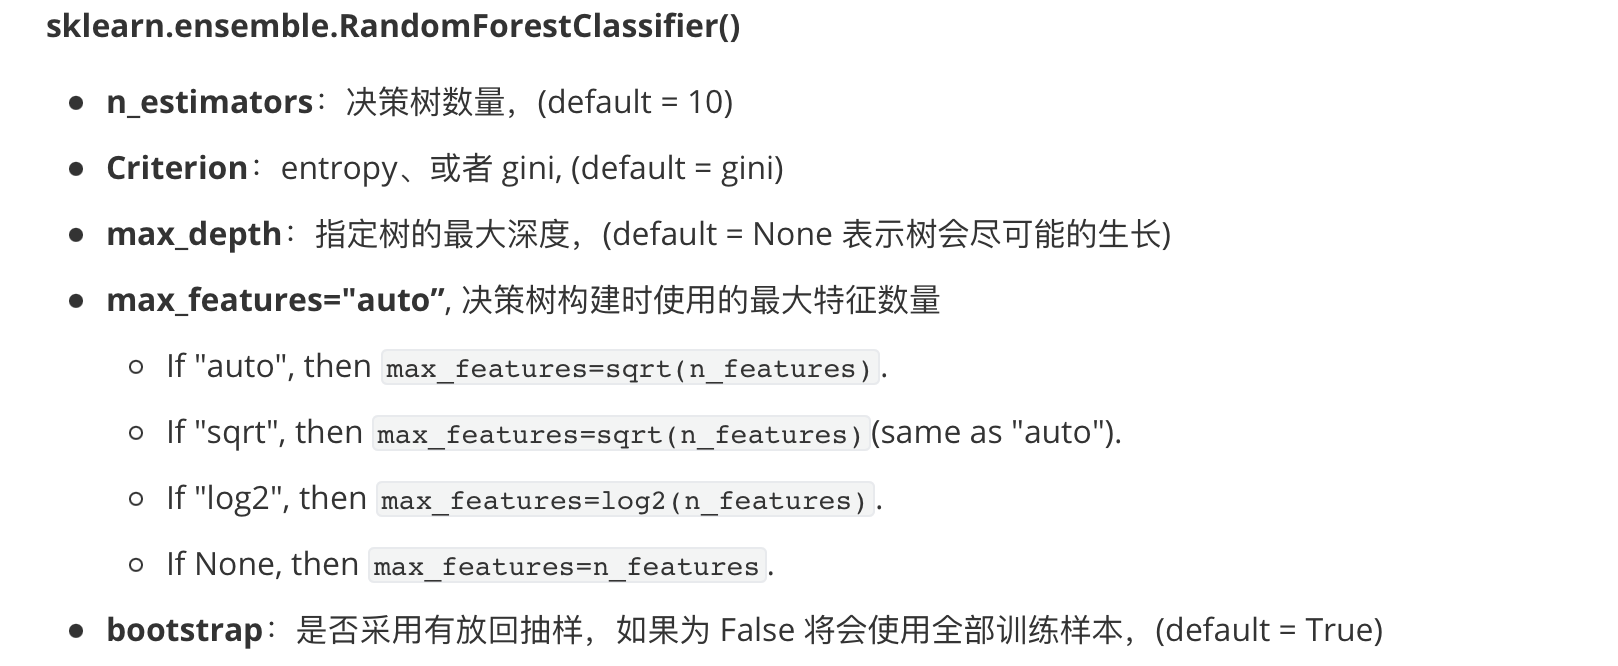
图注:这是 sklearn.ensemble.RandomForestClassifier 的参数表截图,逐项列出参数名、默认值与英文说明,可见项包括 n_estimators(默认 10)、criterion、max_depth、min_samples_split、min_samples_leaf、max_features、bootstrap、oob_score、n_jobs、random_state、class_weight 等。表中 max_features 的默认写作 'auto',这是旧版 sklearn 的写法(分类器中等同 'sqrt'),新版已直接默认 'sqrt',看到老代码不要慌。
4.5 AdaBoost:第一个真正实用的 Boosting 算法
AdaBoost = Adaptive Boosting(自适应提升)。核心思想:通过逐步提高那些被前一步分类错误的样本的权重来训练一个强分类器。
4.5.1 迭代机制
课件用六张图讲完节奏:① 初始化,所有样本权重相等,训练第一个学习器;② 调整数据分布,把分错的样本权重调大;③ 用新权重训练第二个学习器;④ 再次调整分布;⑤ 依次训练、反复调整;⑥ 加权组合成最终结果。
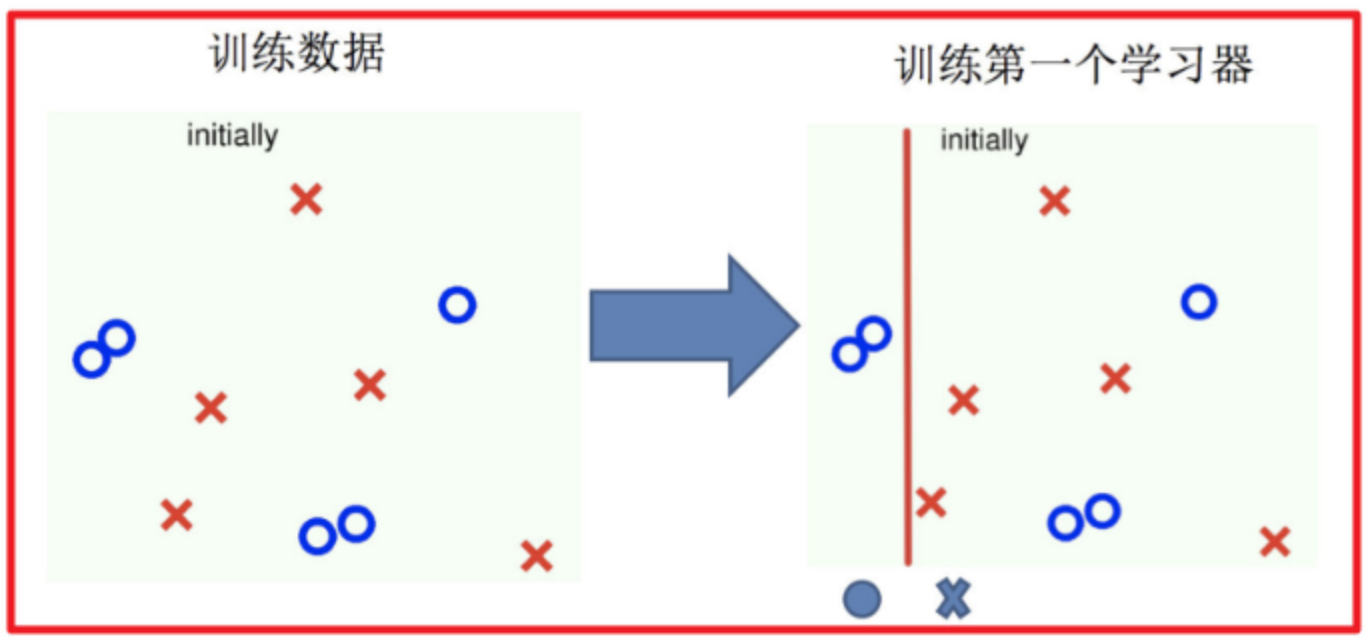
图注:左右两栏分别对应课件的「1. 训练第一个学习器」与「2. 调整数据分布」。两栏是同一批样本点的散点分布,第一栏用一条分界线(竖直线)把两类样本分开,展示第一个弱分类器的判决面;第二栏中若干个落在分界线错误一侧的点被画得明显更大,直观表示”错分样本的权重被放大了”。
4.5.2 四个公式
① 模型权重:错误率 \varepsilon_t 越小,话语权越大。
\alpha_t=\frac{1}{2}\ln\frac{1-\varepsilon_t}{\varepsilon_t}
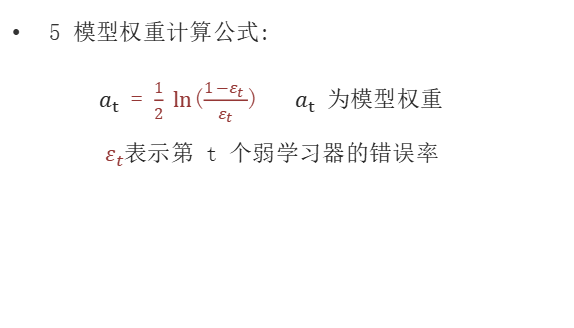
图注:课件第 30 页”5 模型权重计算公式”,图中公式为 \alpha_t=\frac{1}{2}\ln\frac{1-\varepsilon_t}{\varepsilon_t},配套文字”\alpha_t 为模型权重,\varepsilon_t 表示第 t 个弱学习器的错误率”。
② 样本权重更新:分对的样本权重乘 e^{-\alpha_t},分错的乘 e^{\alpha_t}。
D_{t+1}(x)=\frac{D_t(x)}{Z_t}\times
\begin{cases}
e^{-\alpha_t}, & \text{预测值}=\text{真实值}\\[2pt]
e^{\alpha_t}, & \text{预测值}\neq\text{真实值}
\end{cases}
③ 归一化因子 Z_t = 更新后所有样本权重之和,让 D_{t+1} 仍是一个概率分布。
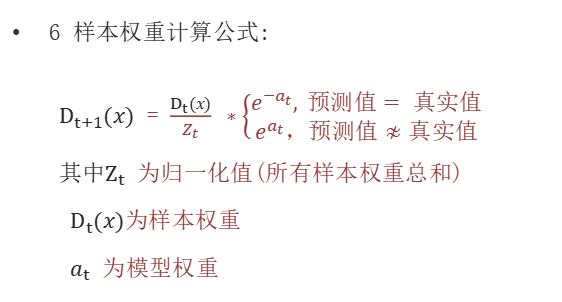
图注:课件第 30 页”6 样本权重计算公式”,图中公式为分段的 D_{t+1}(x)=\frac{D_t(x)}{Z_t}\times\{e^{-\alpha_t}\ (\text{预测值}=\text{真实值}),\ e^{\alpha_t}\ (\text{预测值}\neq\text{真实值})\},配套文字”Z_t 为归一化值(所有样本权重总和),D_t(x) 为样本权重,\alpha_t 为模型权重”。
④ 集成预测:H(x)=\operatorname{sign}\big(\sum_{t=1}^{m}\alpha_t h_t(x)\big),结果大于 0 归正类、小于 0 归负类。
逻辑闭环:错误率低 → \alpha_t 大 → 分错的样本乘上更大的 e^{\alpha_t} → 下一轮分类器被迫照顾这些难样本。这就是”自适应(Adaptive)”的由来。
4.5.3 带数字的完整例子(课件第 31–36 页手算)
已知:10 个样本,弱分类器由 x 上的单个阈值产生。
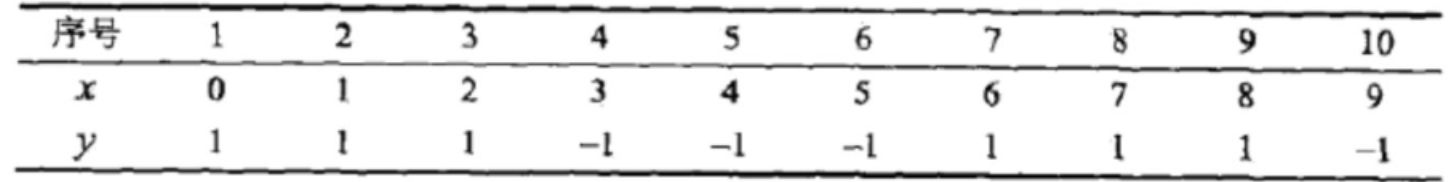
图注:课件第 31 页的训练数据表:序号 1~10,对应的 x 取值为 0,1,2,3,4,5,6,7,8,9,对应的 y 取值为 1,1,1,−1,−1,−1,1,1,1,−1。题目要求”假设弱分类器由 x 产生,预测结果使该分类器在训练数据集上的分类误差率最低,试用 AdaBoost 算法学习一个强分类器”。
初始权重 D_1(x_i)=\frac{1}{10}=0.1。
第 1 轮:遍历阈值,取分裂点 2.5(x<2.5 判 +1,x>2.5 判 −1)时误差率最低。
- 预测:x=0,1,2\to+1 ✓;x=3,4,5\to-1 ✓;x=6,7,8\to-1 ✗;x=9\to-1 ✓
- 错分 3 个 → \varepsilon_1=3\times0.1=0.3
- \alpha_1=\frac{1}{2}\ln\frac{1-0.3}{0.3}=0.4236
- 更新:分对的 7 个(序号 1,2,3,4,5,6,10)× e^{-0.4236}=0.6547 → 0.06547;分错的 3 个(序号 7,8,9,即 x=6,7,8)× e^{0.4236}=1.5275 → 0.15275
- Z_1=0.06547\times7+0.15275\times3=0.9165
- 归一化后:分对 0.07143,分错 0.1667,错样本权重变成对样本的 2.33 倍
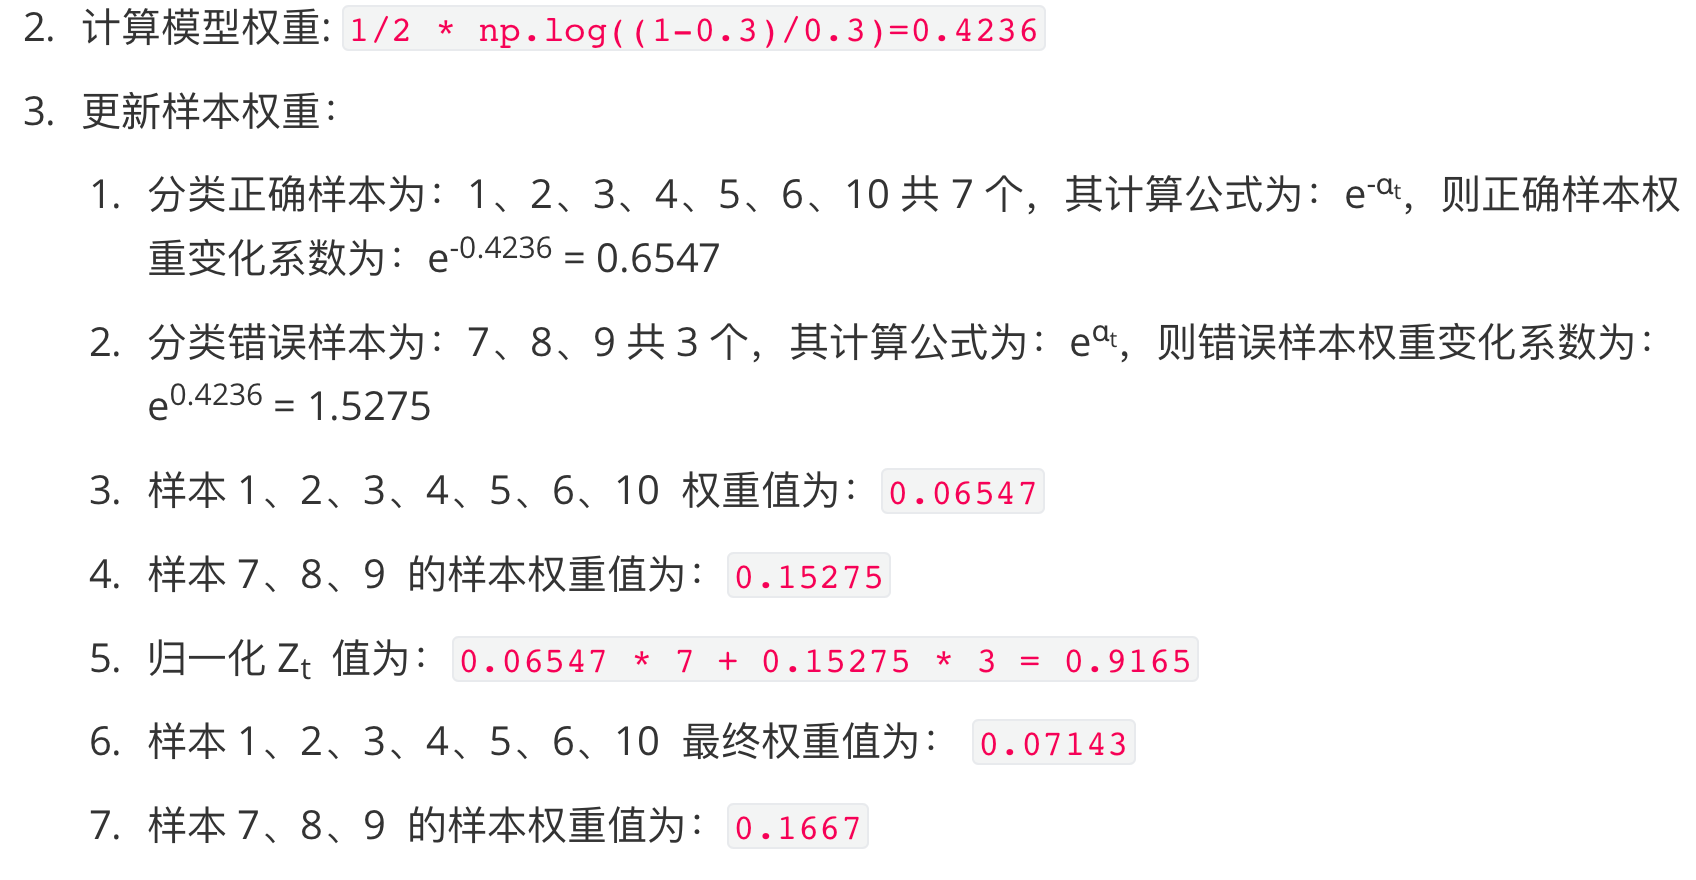
图注:课件第 33 页的权重更新推导图。上部为模型权重计算式「1/2\times\text{np.log}((1-0.3)/0.3)=0.4236」;下方两张表分别列出权重更新结果,”分类正确样本为 1,2,3,4,5,6,10 共 7 个,公式 e^{-\alpha},系数 e^{-0.4236}=0.6547“,”分类错误样本为 7,8,9 共 3 个,公式 e^{\alpha},系数 e^{0.4236}=1.5275“,对应权重值 0.06547 与 0.15275;表中给出 Z_t=0.06547\times7+0.15275\times3=0.9165,最终正确样本权重 0.07143、错误样本权重 0.1667。
第 2 轮:在新的分布 D_2(对样本 0.07143、错样本 0.1667)上重新找最优阈值,取 8.5(x<8.5 判 +1,x>8.5 判 −1),错分 x=3,4,5:\varepsilon_2=3\times0.07143=0.2143,\alpha_2=\frac{1}{2}\ln\frac{0.7857}{0.2143}=0.6496。
第 3 轮:继续更新权重,取阈值 5.5(x<5.5 判 −1,x>5.5 判 +1),错分 x=0,1,2,9:\varepsilon_3\approx0.182,\alpha_3\approx0.7515。
最终强分类器:H(x)=\operatorname{sign}\big(0.4236\,T_1(x)+0.6496\,T_2(x)+0.7515\,T_3(x)\big)
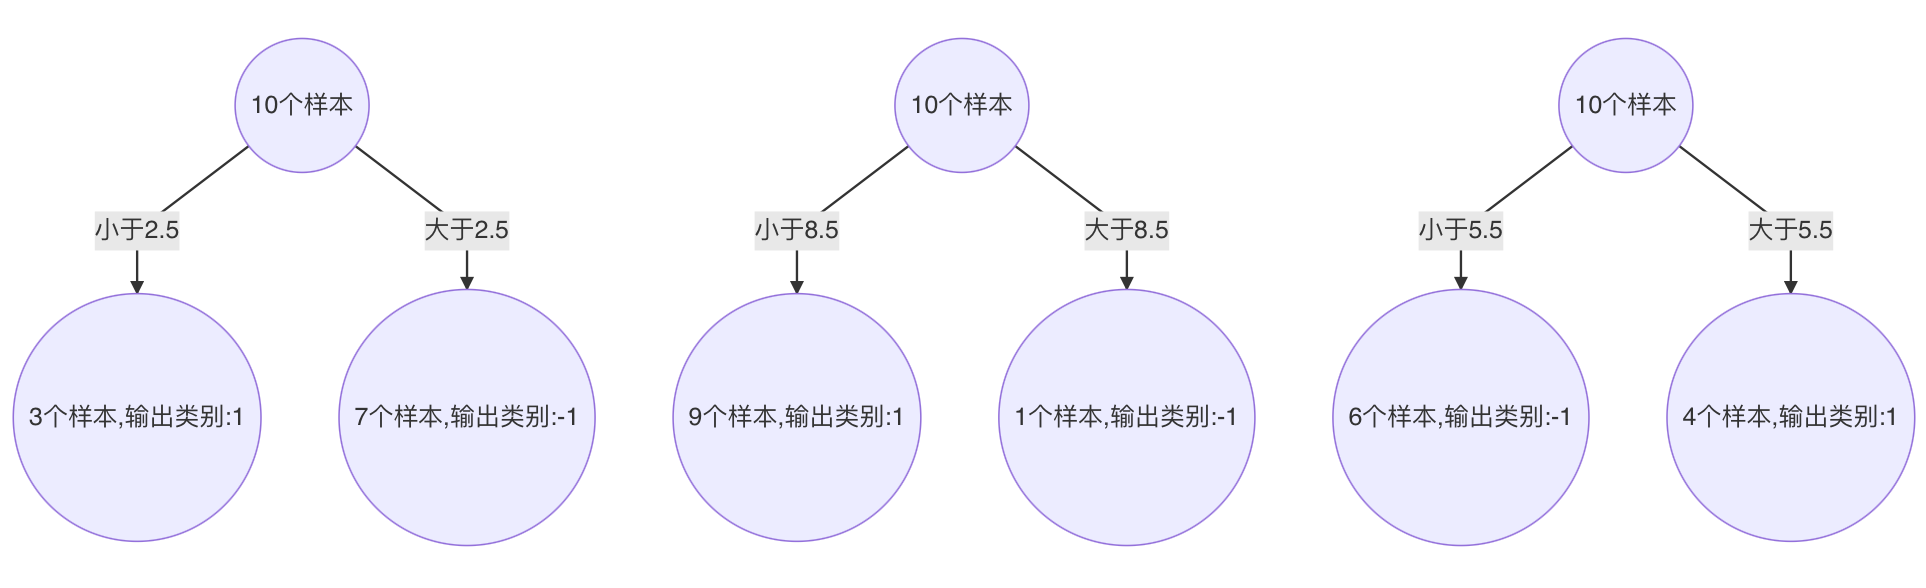
图注:课件第 36 页把三轮学到的三棵树桩并排画出,每棵都是”10 个样本、按单个 x 阈值二分”:tree1 以 2.5 切分,左侧(小于 2.5)3 个样本输出类别 1、右侧 7 个样本输出类别 −1;tree2 以 8.5 切分,左侧 9 个样本输出 1、右侧 1 个样本输出 −1;tree3 以 5.5 切分,左侧 6 个样本输出 −1、右侧 4 个样本输出 1。三棵树分别对应权重 \alpha_1,\alpha_2,\alpha_3,加权求和取 sign 得最终判决。
代一个数验证(课件原文例子,x=3,真实标签 −1):
H(3)=0.4236\times(-1)+0.6496\times(+1)+0.7515\times(-1)=-0.5254<0
判为负类,与真实标签一致。注意第 2 棵树把 x=3 判错了(给出 +1),但这个错误意见权重只有 0.6496,被两个正确意见(合计 1.1751)压过,这就是加权投票与平权投票的本质区别:Boosting 不搞一人一票,它让每轮表现好的分类器说更多话。
4.5.4 实战要点(课件葡萄酒案例)
mytree = DecisionTreeClassifier(criterion='entropy', max_depth=1, random_state=0)  # 决策树桩
myada  = AdaBoostClassifier(base_estimator=mytree, n_estimators=500,
                            learning_rate=0.1, random_state=0)
要点:① AdaBoost 一般做二分类,课件先去掉一类再用 LabelEncoder 编码成 0/1;② 基学习器要浅(max_depth=1),深度过深会让单个学习器太强,失去”逐步修正”的意义且容易过拟合(课件选择题答案:”AdaBoost 算法使用的树深度不要过深,否则容易过拟合”);③ learning_rate 作用于每一轮的权重更新(课件把它单独考了一次),它是每棵树贡献的缩放因子,学习率小则每棵树贡献小、需要更多树,但泛化更稳;④ n_estimators=500 + learning_rate=0.1 是典型”多而慢”配置。
版本坑:
AdaBoostClassifier(base_estimator=...)是旧版 sklearn 参数名,新版(1.2+)已改名estimator=,旧名会警告并在未来移除。
4.6 提升树与 GBDT:从”拟合残差”到”拟合负梯度”
4.6.1 提升树:拟合残差
残差 = 真实值 − 预测值。课件用”预测年龄”讲得很清楚:
- 目标 100 岁;第 1 次预测 80 岁 → 残差 100-80=20
- 第 2 次以上一轮残差 20 为目标,预测 16 → 残差 20-16=4
- 第 3 次以上一轮残差 4 为目标,预测 3.2 → 残差 4-3.2=0.8
- 三次串联:80+16+3.2=99.2,已非常接近 100
这就是提升树最朴素的思想:通过拟合残差把多个弱学习器组成一个强学习器。
4.6.2 GBDT:拟合负梯度
课件原话:梯度提升树不再拟合残差,而是利用梯度下降的近似方法,用损失函数的负梯度作为提升树中的残差近似值。对平方损失求导:
\frac{\partial L(y,f(x_i))}{\partial f(x_i)}=f(x_i)-y_i,\qquad
-\frac{\partial L(y,f(x_i))}{\partial f(x_i)}=y_i-f(x_i)
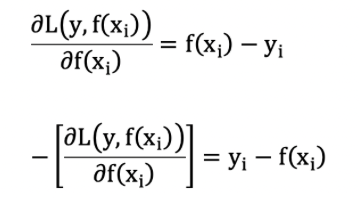
图注:图中两行公式,第一行是平方损失对预测值的导数 \partial L(y,f(x_i))/\partial f(x_i)=f(x_i)-y_i,第二行取负号得 -[\partial L(y,f(x_i))/\partial f(x_i)]=y_i-f(x_i),即”负梯度恰好等于残差”。
残差只是”平方损失 + 负梯度”的巧合。换成 logloss(分类)、Huber(鲁棒回归)等任何可导损失,”残差”这个词就不再适用,但”负梯度”永远成立,这就是 GBDT 能把 Boosting 推广到一切可导损失函数的原因。
4.6.3 构建流程与手算例子
课件第 46–51 页:① 初始化,求常数 f_0 使平方误差最小,对损失求导并令其为 0 解出 f_0= 目标值的均值(原话:”初始化树桩输出值为目标值的均值时,可使得第一个弱学习器的平方误差最小”);② 迭代构建,每一轮先算每个样本的负梯度,再遍历所有切分点、选平方损失最小的那个作为划分点(第 1 棵树以 6.5 切分,第 2 棵 3.5,第 3 棵又 6.5;课件还展示了以 1.5 为切分点时的完整比较:左子树 1 个样本 −1.75、右子树 9 个样本均值 0.19,平方损失 15.72308);③ 直到达到指定学习器个数;④ 预测时把所有弱学习器输出相加,课件例子:x=6 的预测 = 7.31+(-1.07)+0.22+0.15=6.61。
课件第 52–53 页泰坦尼克号案例的标准用法:GradientBoostingClassifier() 直接 fit/score,再用 GridSearchCV 搜 {"n_estimators":[100,110,120,130],"max_depth":[2,3,4],"random_state":[9]}、cv=3。注意 GBDT 的搜参网格比随机森林窄得多(树数 100 上下、深度 2~4),因为 Boosting 每棵树都在纠错,树太深 + 树太多很容易过拟合。
4.7 XGBoost:把 GBDT 做成工业级
课件定位很直白:极端梯度提升树,集成学习方法的王牌,在数据挖掘比赛中大部分获胜者用了 XGBoost。
4.7.1 核心改进一:显式的正则化目标函数
GBDT 是最小化训练数据的损失函数,课件指出问题:训练的模型复杂度较高,易过拟合。XGBoost 同时考虑损失和模型复杂度:
\text{obj}(\theta)=\sum_{i}^{n}L(y_i,\hat y_i)+\sum_{k=1}^{K}\Omega(f_k),\qquad
\Omega(f)=\gamma T+\frac{1}{2}\lambda\|w\|^2
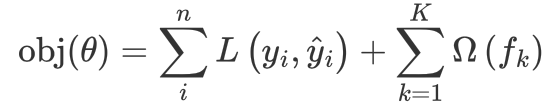
图注:XGBoost 目标函数原图:\text{obj}(\theta)=\sum_i^n L(y_i,\hat y_i)+\sum_{k=1}^{K}\Omega(f_k),前一项是 n 个样本的损失之和,后一项是 K 棵树的正则化项之和。
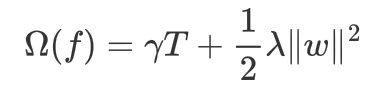
图注:模型复杂度公式 \Omega(f)=\gamma T+\frac{1}{2}\lambda\|w\|^2。课件配套文字:\gamma T 中的 T 表示一棵树的叶子结点数量(叶子越多树越复杂,惩罚越大);\lambda 后的 w 表示叶子结点输出值组成的向量的模,\lambda 是该项的调节系数。这一项在第 77 页复习页被重复了一次,可见是重点。
作用:\gamma T 相当于”每多长一片叶子都要交税”,直接影响树是否会继续分裂(见 §4.7.3 的 gain 阈值 \gamma);\frac{1}{2}\lambda\|w\|^2 是叶子权重的 L2 正则,把叶子输出往 0 压,防止某片叶子对个别样本给出极端预测。
4.7.2 核心改进二:二阶泰勒展开
课件第 62–68 页的脉络:① 第 t 次迭代的目标函数写成”前 t-1 棵树的常数部分 + 第 t 棵树的增量 + 复杂度”;② 直接求解困难 → 用泰勒展开近似(第 63 页先复习定义:”将一个函数在某一点处展开成无限项的多项式表达式”,配一阶、二阶展开公式图);③ 对 \hat y_i^{(t-1)} 做二阶展开,把目标函数近似为
\text{Obj}^{(t)}\approx\sum_{i=1}^{n}\Big[g_i f_t(x_i)+\tfrac{1}{2}h_i f_t^2(x_i)\Big]+\Omega(f_t)
其中 g_i、h_i 分别是损失函数的一阶导和二阶导;④ 展开式里”前 t-1 个弱学习器构成的目标函数那两项都是常数,可以去掉”;⑤ 从样本角度转成叶子节点角度,课件用具体例子说明:m=10 个样本分别落在 D、E、F、G 四片叶子上(3+2+2+3 个样本),于是”对所有样本求和”改写成”对每片叶子求和”;⑥ 记 G_j=\sum_{i\in I_j}g_i(落在叶子 j 上所有样本的一阶导之和)、H_j=\sum_{i\in I_j}h_i(二阶导之和),目标函数化为
\text{Obj}^{(t)}=\sum_{j=1}^{T}\Big[G_j w_j+\tfrac{1}{2}(H_j+\lambda)w_j^2\Big]+\gamma T
⑦ 对 w_j 求导令其为 0,得最优叶子权重与最优目标值:
w_j^{*}=-\frac{G_j}{H_j+\lambda},\qquad
\text{Obj}^{*}=-\frac{1}{2}\sum_{j=1}^{T}\frac{G_j^{2}}{H_j+\lambda}+\gamma T
4.7.3 核心改进三:用打分函数选分裂点
上式就是课件说的打分函数(scoring function),”从损失函数、树的复杂度两个角度来衡量一棵树的优劣”,用来选择划分点:
\text{Gain}=\frac{1}{2}\left[\frac{G_L^{2}}{H_L+\lambda}+\frac{G_R^{2}}{H_R+\lambda}-\frac{(G_L+G_R)^{2}}{H_L+H_R+\lambda}\right]-\gamma
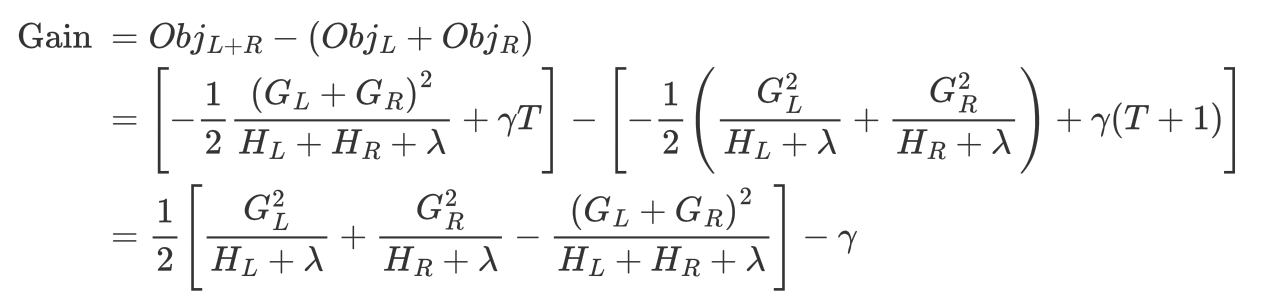
图注:课件第 69 页的打分函数(gain)公式,图中以三行式子给出分裂前后目标函数的对比与化简:括号内是”左子结点得分 + 右子结点得分 − 未分裂时父结点得分”的差额,括号外减去 \gamma(新增一片叶子要付的复杂度代价),最终得到形如 \frac{1}{2}[\frac{G_L^2}{H_L+\lambda}+\frac{G_R^2}{H_R+\lambda}-\frac{(G_L+G_R)^2}{H_L+H_R+\lambda}]-\gamma 的增益表达式。
判决规则(第 70 页):对每个叶子结点尝试分裂,算”分裂前分数 − 分裂后分数”;gain > 0 则考虑分裂,gain < 0 不建议分裂;停止条件为达到最大深度 / 叶子结点样本数低于阈值 / 所有结点分裂都不能降低损失。
价值:它把”树怎么长”从”选最低 Gini 的切分点”(ID3/C4.5/CART 的启发式)升级成有明确目标函数支撑的增益最大化学,\lambda 和 \gamma 在这里第一次有了可解释的物理意义。
4.7.4 相对 GBDT 的改进清单
| 改进 | 具体做法 | 解决的问题 |
|---|---|---|
| 损失函数正则化 | 目标函数显式加入 \gamma T+\frac{1}{2}\lambda\|w\|^2 | 抑制树的复杂度、防过拟合 |
| 二阶泰勒展开 | 用 g_i(一阶导)+ h_i(二阶导)近似,叶子权重有闭式解 -G/(H+\lambda) | 收敛更快更准(GBDT 只用一阶导) |
| 分裂点选择 | 用打分函数 gain 决定是否分裂、在哪分裂 | 分裂有了统一的目标函数依据 |
| 缺失值处理 | 稀疏感知:为缺失值学习默认分支方向 | 不用手工填缺失值 |
| 工程优化 | 列采样、近似分位点切分、特征预排序复用、多线程 | 训练快、内存可控、可并行 |
| 支持线性模型 | booster='gblinear' |
课件选择题专门考过”不可以使用线性模型”是错误说法 |
4.7.5 API 与红酒品质多分类案例
import xgboost as xgb, joblib   # pip3 install xgboost;文档 https://xgboost.readthedocs.io/en/latest/

estimator = xgb.XGBClassifier(
    n_estimators=100, objective='multi:softmax', eval_metric='merror',
    eta=0.1, use_label_encoder=False, random_state=22)
estimator.fit(x_train, y_train, sample_weight=classes_weights)   # 样本不均衡时传入权重
print(classification_report(y_true=y_test, y_pred=estimator.predict(x_test)))
joblib.dump(estimator, './data/mymodelxgboost.pth')
案例(11 特征、3269 条、6 个品质等级的多分类,且样本不均衡)展示三件事:① sklearn 风格与非 sklearn 风格都支持,xgb.XGBClassifier 包成 sklearn 接口可直接进 GridSearchCV;② 样本不均衡处理,class_weight.compute_sample_weight(class_weight='balanced', y=y_train) 算出权重后 fit(..., sample_weight=...);③ 交叉验证要用分层抽样,StratifiedKFold(n_splits=5, shuffle=True) 配 GridSearchCV,网格 max_depth: 3~4、n_estimators: 50~150、eta: 0.1~0.7。
参数名对照:
eta就是learning_rate;objective='multi:softmax'表示多分类直接输出类别;eval_metric='merror'是多分类错误率。
4.8 Stacking(课件未覆盖的通识补充)
课件 80 页里没有 Stacking,但它是集成学习第三大流派,不能不提。
做法(Stacked Generalization, Wolpert 1992):① 用 K 折交叉验证切分训练集,训练若干个不同类型的基学习器(随机森林 + SVM + 逻辑回归…);② 对每个基学习器,收集它在每一折作为验证集时产生的预测(即 out-of-fold 预测),拼成新的特征矩阵;③ 用这个矩阵训练一个元学习器(meta-learner / blender),常用逻辑回归;④ 预测时基学习器先预测,结果喂给元学习器输出最终结果。
| Bagging | Boosting | Stacking | |
|---|---|---|---|
| 弱学习器类型 | 同一种 | 同一种 | 可以异构 |
| 组合方式 | 平权投票/平均 | 加权投票(权重由误差算出) | 再训练一个模型学习怎么组合 |
| 并行性 | 完全并行 | 串行 | 基学习器可并行,元学习器最后训练 |
| 最大风险 | 弱学习器差异不够 | 过拟合、对噪声敏感 | 信息泄漏 |
最容易踩的坑:元学习器的输入必须是 out-of-fold 预测。若直接用基学习器在训练集上的预测(它见过的数据、精度虚高),元学习器会学到”基学习器永远不会错”的假象,测试时崩盘。Stacking 必须配交叉验证,不是为了让模型更稳,是为了让元学习器的输入不带泄漏。
五、易错点与常见误解
-
常见说法:”Bagging 就是随机选特征”;实际上,经典 Bagging 只做有放回抽样;”随机选特征”是随机森林加上的第二次随机 → 为什么:课件第 13 页选择题把”从数据集随机采样子集”(B)和”从特征集中随机选择多个特征”(C)都算作 Bagging 的说法答案是 BC,课程把”随机子空间”这类近亲方法也算进了 Bagging 家族。严格区分时,只有样本自助抽样属于 Bagging 原始定义,特征随机是 Breiman 在随机森林里引入的,这也是随机森林比 Bagging 更强的直接原因。
-
有人以为”树越多越容易过拟合,
n_estimators不能设大”;实际上,对 Bagging / 随机森林:加树不会过拟合,只会变慢;对 Boosting:树太多确实会过拟合 → 为什么:Bagging 的误差随树数单调下降并收敛,多出来的树只是让平均更充分;Boosting 每棵树都在拟合残差,树多了会把训练噪声也学进去(所以才有learning_rate+ 早停)。 -
常听到的一种说法是:”AdaBoost 里错误率越高的分类器权重越大”;实际上,正好相反,\alpha_t=\frac{1}{2}\ln\frac{1-\varepsilon_t}{\varepsilon_t} 随错误率单调递减 → 为什么:\varepsilon\to0 时 \alpha\to+\infty(几乎全对给最高话语权);\varepsilon=0.5 时 \alpha=0(瞎猜的分类器等于没用)。\varepsilon>0.5 时 \alpha<0,这也是 AdaBoost 要求基学习器至少比随机猜好的原因。
-
容易想岔的地方:”AdaBoost 的样本权重和分类器权重是一回事”;实际上,D_t(x) 给样本、\alpha_t 给分类器,两者每轮都更新但含义完全不同 → 为什么:\alpha_t 由错误率算出、用于最终加权投票;D_t(x) 用 \alpha_t 和是否分对来更新、用于下一轮训练时对样本加权的损失函数。搞混了推导会全线崩。顺带:提高错分样本权重是”加权”不是”复制样本”,加权改变损失函数里每个样本的贡献(sklearn 里等价于
sample_weight),重采样只是实现加权的一种有噪声的近似。 -
先说一个误解:”GBDT 每一轮都在拟合残差”;实际上,只有平方损失下”负梯度 = 残差”,其他损失(如分类的 logloss)拟合的是负梯度 → 为什么:\partial L/\partial f=f-y 只在 L=\frac{1}{2}(y-f)^2 时成立。GBDT 的一般形式是”拟合损失函数的负梯度”,这才是它支持任意可导损失的原因。
-
常见说法:”XGBoost 就是 GBDT 加了个正则化项”;实际上,至少还有二阶泰勒展开、打分函数分裂准则、稀疏感知缺失值处理、列采样与近似分位点 → 为什么:正则化只解决过拟合;二阶导让收敛更快更准;稀疏感知和分位点切分让它在大规模稀疏数据上真正可用。这是”算法改进”和”工程可用性改进”两件事。
-
有人以为”XGBoost 只能集成树模型”;实际上,也支持线性模型(
booster='gblinear')→ 为什么:课件第 78 页选择题,”xgboost 算法不可以使用线性模型进行集成”是错误说法(答案选 D)。 -
常听到的一种说法是:”OOB 分数就是测试集精度”;实际上,OOB 是训练集样本在”没见过它的那部分树”上的聚合预测精度,是泛化能力的近似估计 → 为什么:OOB 样本仍来自训练集分布,它衡量的是”集成有没有过拟合训练数据”,不能替代独立测试集上的最终指标。二者通常接近,但分布有漂移时会明显背离。
-
容易想岔的地方:
feature_importances_反映”特征对预测的因果贡献”;实际上,它只是训练集上不纯度下降的启发式累计,对高基数特征有偏,也不反映因果 → 为什么:取值多的特征有更多切分点可选,天然更容易”降低不纯度”。要用permutation_importance在验证集上复算,或做共线性检查后才能下结论。 -
先说一个误解:”Stacking 就是拿基学习器在训练集上的预测去训元学习器”;实际上,必须用 out-of-fold 预测 → 为什么:用 in-sample 预测会把”基学习器已经见过这些样本”泄漏给元学习器,学到虚高的置信度,测试时崩塌。这是集成学习里最常见的隐蔽错误。
-
常见说法:”集成学习的每一层都要很复杂”;实际上,弱学习器”弱”才是常态,尤其是 Boosting → 为什么:AdaBoost 的基学习器就是深度 1 的决策树桩;XGBoost 的
max_depth网格只有 2~4。单模型越强、彼此越像,集成的边际收益越小。
六、横向对比与研究脉络
6.1 对比表
| 维度 | 单棵决策树 | Bagging | 随机森林 | AdaBoost | GBDT | XGBoost |
|---|---|---|---|---|---|---|
| 原理 | 递归选最优特征分裂 | 自助抽样 + 平权投票 | Bagging + 特征随机 | 样本重加权 + 串行纠错 | 拟合负梯度 | GBDT + 二阶导 + 正则化 |
| 弱学习器 | 决策树 | 任意同质模型 | 决策树(CART) | 决策树桩(常用) | CART | CART 回归树(默认) |
| 训练顺序 | — | 并行 | 并行 | 串行 | 串行 | 串行 |
| 组合方式 | — | 平权投票/平均 | 平权投票/平均 | 加权投票(\alpha_t) | 加权求和(学习率) | 加权求和 + 正则惩罚 |
| 主要收益 | — | 降方差 | 降方差(\rho 更小) | 降偏差 | 降偏差 | 降偏差 + 抗过拟合 |
| 优点 | 可解释、无假设、快 | 易并行、几乎不需调参 | 精度稳定、有 OOB、有特征重要性 | 基学习器极简、理论清晰 | 精度高、支持任意可导损失 | 精度与工程双优、竞赛王者 |
| 缺点 | 方差大、易过拟合 | 偏差不降、树间相关高 | 可解释性差、预测比单模型慢 | 对噪声/离群点敏感,要求比随机猜好 | 串行难并行、需调学习率 | 参数多、调参成本高、吃内存 |
| 缺失值 | 需手工处理 | 需手工处理 | 需手工处理 | 需手工处理 | 需手工处理 | 内置稀疏感知 |
| 适用场景 | 需要解释性的小数据 | 高方差模型(深树、KNN) | 表格基线、TF-IDF 文本基线 | 二分类、视觉特征 | 表格回归/分类 | 竞赛、工业表格任务 |
| sklearn | DecisionTreeClassifier |
BaggingClassifier |
RandomForestClassifier |
AdaBoostClassifier |
GradientBoostingClassifier |
xgboost.XGBClassifier |
| 关键超参 | max_depth、min_samples_leaf |
n_estimators、max_samples |
n_estimators、max_features、max_depth |
n_estimators、learning_rate、基树深度 |
n_estimators、learning_rate、max_depth |
+ gamma、lambda、subsample、colsample_bytree |
6.2 演进脉络
单棵决策树
  问题:方差大,换一批数据树结构全变
  ↓ 自助抽样 + 平均
Bagging(1996, Breiman)
  问题:树的错误高度相关,"共同犯错"的部分平均不掉
  ↓ 每次分裂只从随机 k 个特征中选
随机森林(2001, Breiman)
  问题:只会"平均"、不擅长"纠错";在高偏差弱学习器上收益有限
  ↓ 换思路:串行 + 加权投票,每轮盯住上一轮的错
AdaBoost(1997, Freund & Schapire)
  问题:指数损失 + 要求基学习器比随机猜好,对噪声敏感
  ↓ 改用"拟合残差",把 Boosting 推广到回归
提升树(Boosting Decision Tree)
  问题:"残差"只在平方损失下成立,分类等其他损失用不了
  ↓ 用损失函数的负梯度代替残差
GBDT(2001, Friedman)
  问题:只用一阶导收敛慢;无显式正则化易过拟合;工程难扩展
  ↓ 二阶泰勒展开 + 正则化 γT + ½λ‖w‖² + 稀疏感知 + 分位点切分
XGBoost(2016, Chen & Guestrin)
  问题:精确贪心找分裂点在大数据上仍慢、内存大
  ↓ 直方图分桶 + leaf-wise 生长 + GOSS/EFB
LightGBM(微软)
另一条平行线:Stacking(Wolpert 1992)不改弱学习器,而是改组合器,用交叉验证的 OOF 预测训练元学习器来学习怎么组合,基学习器可以完全异构。
七、在新闻分类项目中的落地
这个项目是把新闻标题分成 10 个类(训练 18w / 验证 1w / 测试 1w,标题\t标签),路线是 TF-IDF + 随机森林 → FastText → BERT → LLM 四级对比。随机森林是这条链的第一级,也是”最低成本的可用基线”。
7.1 它在流水线的哪一步
- 特征工程:749 个停用词喂给
TfidfVectorizer(stop_words=...),fit_transform()得到的高维稀疏矩阵就是随机森林的输入; - 基线建模:
RandomForestClassifier训练评估,拿到第一个可交付的准确率; - 误差分析:用
feature_importances_/permutation_importance看哪些词判别力最强,用混淆矩阵看哪两类最容易混; - 对比参照:后面 FastText / BERT 的提升幅度都是相对这个基线说的;
- 部署/压缩:随机森林天然是小模型,不需要量化/蒸馏就能部署。
7.2 可直接抄的基线代码
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline

stop_words = [w.strip() for w in open("stopwords.txt", encoding="utf-8") if w.strip()]  # 749 个

pipe = Pipeline([
    ("tfidf", TfidfVectorizer(
        stop_words=stop_words,
        ngram_range=(1, 2),      # 加 bigram 补偿词序信息损失
        sublinear_tf=True,       # 长标题不过度加权
        min_df=3, max_features=200_000,
    )),
    ("rf", RandomForestClassifier(
        n_estimators=300, max_features="sqrt", min_samples_leaf=2,
        class_weight="balanced",     # 10 类新闻天然不均衡
        oob_score=True,              # 顺手拿到泛化估计
        n_jobs=-1, random_state=42,
    )),
])
pipe.fit(X_train, y_train)                      # X_train 是标题列表
print("OOB:", pipe.named_steps["rf"].oob_score_)
print("test acc:", pipe.score(X_test, y_test))
7.3 关键参数怎么定
n_estimators:300 起步。18w 条 +ngram_range=(1,2)后特征维度高,树可以多;先用 OOB 曲线确认走平,别盲目上 1000(训练时间线性增长)。max_features:sqrt是基准,也可试log2或固定8192。文本里”高判别力的词”就那么几个,很多树会抢着用同样的词 → \rho 天然偏高,调小max_features往往比加树更有效。- 更推荐调
min_samples_leaf(2~5)而不是死限max_depth。稀疏文本上叶子样本太少就是纯记噪声。 class_weight='balanced':10 类分布不均时必开;评估别只看 accuracy,要看 macro-F1。n_jobs=-1+random_state=42:前者把 18w 条的训练压到可接受,后者让每次实验可比。- 不要一上来就 5 维网格搜索:按 §4.4.6 的顺序单变量调完,最后再小范围细搜。
7.4 实际会踩的坑
max_features='auto'报错/警告:课程代码写的是旧版默认值,新版会警告或不认,改成'sqrt'。oob_score=True忘了配bootstrap=True:sklearn 会直接报错,因为 OOB 依赖有放回抽样。- 高维稀疏矩阵 + 多进程内存爆炸:
n_jobs=-1会把数据复制到每个进程,max_features=200000时可能吃掉几十 GB;数据大就把n_jobs降到 4~8 或限制max_features。 - 用
feature_importances_直接断言”这个词最重要”:MDI 对高基数特征有偏(词频特征尤其容易上榜),下结论前一定用permutation_importance在验证集上复核。 predict_proba的概率不可信:随机森林的概率是投票比例,取值离散(如 8/300)且集中在中间,不能直接当置信度。要拿它和 BERT 的概率做对比或做阈值过滤,先用CalibratedClassifierCV校准,或者只比较argmax。- TF-IDF 丢失词序:标题里”惊呆!XX 公司裁员”和”公司惊呆裁员”在 bag-of-words 下几乎一样。这就是基线里要加
ngram_range=(1,2)、也是后面 FastText(保留局部词序)和 BERT(保留全序+语义)值得上的根本原因,把这点讲出来,说明你不是照着教程跑了一遍。
7.5 和项目里其它方案的配合
- 对 FastText / BERT / LLM:随机森林给的是可解释的基线(哪个词、哪个 n-gram 在起作用),BERT 给的是精度但不给理由。二者一起用才是能拿满分的答法,”我先用 TF-IDF + RF 拿到基线并靠特征重要性发现某类主要靠特定领域词,再用 BERT 把靠语义而非关键词的例子补上”。具体数值写你自己跑出来的数。
- 对模型压缩(第 4 章):随机森林本身就是能被压缩的模型,砍
n_estimators、限max_depth都是在做剪枝;生产上用joblib保存,树结构可直接编译成 if/else 规则。量化 / 蒸馏主要作用在 BERT 上;若把 BERT 的知识以硬标签形式蒸馏到随机森林 / GBDT 这类表格模型,是压缩章节之外的一个可选变体。 - 对 LLM 零样本:LLM 不用训练数据,但成本高、延迟大。随机森林可以当”廉价路由器”,高置信度样本直接判掉,置信度低的部分丢给 LLM,这本身就是一个能讲的工程折中。
八、重点问答
Q1:集成学习为什么有效?Bagging 和 Boosting 的区别在哪?
A:核心是误差解耦,单个模型一定会错,但只要多个模型的错误不是往同一个方向错,组合起来错误就会互相抵消。Bagging 走并行路线,用有放回抽样造出多份不同训练集,各自训练一个弱学习器,最后平权投票,它的收益主要是降方差。Boosting 走串行路线,每一轮的学习器专门关注上一轮做错的地方,最后加权投票,它的收益主要是降偏差。所以两派的适用对象不一样:Bagging 适合本身方差大的模型,Boosting 适合把弱模型一步步做强。
Q2:随机森林里”两次随机”分别解决什么问题?为什么它比单棵树好?
A:第一次是样本随机,bootstrap 有放回抽样,解决”每棵树训练集一样、结果完全一样、投票没意义”的问题;同时有放回保证各棵树的样本既有交集又有差异,避免每棵树都太偏。第二次是特征随机,每次分裂只从随机抽的 k 个特征里选最优,解决”树与树之间错误高度相关”的问题。数学上,T 棵树平均后的方差是 \rho\sigma^2+(1-\rho)\sigma^2/T:第二项随树数增大而消失,第一项由相关系数 \rho 决定、加多少树都消不掉。双重随机的作用点正是 \rho,所以它比纯 Bagging 更稳。
Q3:随机森林的 OOB 是什么?有什么用?
A:bootstrap 抽样时每个样本大约有 (1-1/n)^n \approx 36.8\% 的概率一次都没被抽到,这些就是这棵树”没见过”的 OOB 样本。把每个样本只交给没见过它的那些树去预测、再聚合,算出的准确率就是泛化误差的近似估计。好处是训练时顺手就拿到了一个接近交叉验证的指标,调 n_estimators 时可以看 OOB 曲线有没有走平。要注意它用的是训练集样本,本质是”检验有没有过拟合”,最终成绩还是要用独立测试集。
Q4:随机森林的关键参数怎么调?
A:按重要性排,n_estimators 是树的数量,越大误差越低但越慢,加树不会过拟合,到 OOB/验证曲线走平就够,通常几百棵。max_features 是降相关性的主旋钮,分类默认 sqrt(p),发现树太像就调更小,代价是单棵树变弱。min_samples_leaf 设 2 到 5 能抑制噪声,在文本这类高维稀疏特征上比限制 max_depth 更有效。另外 class_weight='balanced' 处理类别不均衡,n_jobs=-1 并行,oob_score=True 白拿一个验证指标。调参顺序是先定树数、再调叶子、最后调 max_features,不要一开始就多维网格搜索。
Q5:AdaBoost 的样本权重和分类器权重分别怎么算?
A:分类器权重是 \alpha_t=\frac{1}{2}\ln\frac{1-\varepsilon_t}{\varepsilon_t},\varepsilon_t 是它在当前加权分布上的错误率,错误率越低权重越大;错误率等于 0.5 时权重就是 0,等于这个分类器没贡献。样本权重更新是分段的:分对的乘 e^{-\alpha_t},分错的乘 e^{\alpha_t},再除以归一化因子 Z_t(更新后权重总和)变成新分布。举个具体数:10 个样本初始权重都是 0.1,第一轮以 2.5 为阈值错分 3 个,错误率 0.3,算出 \alpha_1=0.4236;分对样本权重变成 0.06547、分错变成 0.15275,Z_1=0.9165,归一化后是 0.07143 和 0.1667,错样本权重变成对的 2.33 倍。最后集成时 H(x)=\operatorname{sign}(\sum\alpha_t h_t(x)),加权投票决定类别。
Q6:GBDT 和提升树的区别?为什么说”拟合负梯度”更一般?
A:提升树每一轮拟合的是残差(真实值减预测值),GBDT 拟合的是损失函数的负梯度。区别在于”残差”只在平方损失下等于负梯度,平方损失对预测值求导正好是 f(x)-y,取负号就是 y-f(x)。换成分类的 logloss 或者 Huber 损失,残差这个说法就不成立了,但负梯度永远成立。所以 GBDT 的关键贡献是把 Boosting 从”只能做平方损失回归”推广到”支持任意可导损失函数”,可以做分类、也可以做鲁棒回归。另外初始化的做法是取目标值的均值,因为那能让第一个弱学习器的平方误差最小。
Q7:XGBoost 相对 GBDT 有哪些改进?
A:我一般分三层说。目标函数层:显式加入正则化项 \gamma T+\frac{1}{2}\lambda\|w\|^2,\gamma T 惩罚叶子数量、\lambda 惩罚叶子权重,直接压制树的复杂度;同时对目标函数做二阶泰勒展开,用一阶导 g 和二阶导 h 近似,叶子权重有闭式解 -G/(H+\lambda),收敛比只用一阶导的 GBDT 更快更准。分裂策略层:用打分函数比较分裂前后的目标函数值决定是否分裂,”增益小于 0 就不分裂”,还带 \gamma 阈值;大数据下用近似分位点切分,不必精确遍历所有切分点。工程层:稀疏感知自动处理缺失值、列采样、特征预排序复用、多线程。另外它也支持线性模型做集成(booster='gblinear')。
Q8:Stacking 和 Bagging/Boosting 有什么不同?最容易踩的坑是什么?
A:Bagging 和 Boosting 的弱学习器都是同一种模型,区别在怎么造差异、怎么投票;Stacking 的基学习器可以完全异构,比如随机森林加 SVM 加逻辑回归,然后再训练一个元学习器来学习怎么组合,逻辑回归就是常用的元学习器。最大的坑是信息泄漏:元学习器的输入必须是基学习器的 out-of-fold 预测,也就是每一折里基学习器在它没见过的验证集上的预测。如果直接用基学习器在自己训练集上的预测,那些预测精度虚高,元学习器会学到”基学习器不会错”的假象,测试时性能直接崩。所以 Stacking 必须配 K 折交叉验证,这不是为了稳,是为了让元学习器的输入干净。
九、延伸阅读
数据集(课件用到)
– Titanic 数据集(./data/titanic/train.csv):演示随机森林、GBDT 的完整流程与网格搜索
– 葡萄酒数据(./data/wine0501.csv):AdaBoost 二分类实战,用到 Alcohol、Hue 两列特征
– 红酒品质数据集(./data/红酒品质分类.csv):11 特征、3269 条、6 个品质等级,XGBoost 多分类 + 样本不均衡处理
经典论文
– L. Breiman, Bagging Predictors, Machine Learning, 1996
– L. Breiman, Random Forests, Machine Learning, 2001
– Y. Freund & R. Schapire, A Decision-Theoretic Generalization of On-Line Learning and an Application to Boosting, JCSS, 1997
– J. Friedman, Greedy Function Approximation: A Gradient Boosting Machine, Annals of Statistics, 2001
– T. Chen & C. Guestrin, XGBoost: A Scalable Tree Boosting System, KDD, 2016
– D. Wolpert, Stacked Generalization, Neural Networks, 1992
官方文档与书籍
– XGBoost 文档:https://xgboost.readthedocs.io/en/latest/ (课件第 71 页给出)
– scikit-learn 集成学习指南:sklearn.ensemble(RandomForestClassifier / AdaBoostClassifier / GradientBoostingClassifier / BaggingClassifier)
– sklearn.inspection.permutation_importance、sklearn.calibration.CalibratedClassifierCV
– Hastie, Tibshirani, Friedman, The Elements of Statistical Learning(第 8、10 章,讲偏差方差分解与 Boosting 最清楚)
– LightGBM / CatBoost 官方文档(课件把 LightGBM 列为 Boosting 家族成员但未展开)
工具
– scikit-learn(本项目主力)、xgboost(pip3 install xgboost)、lightgbm、catboost
– joblib(保存 XGBoost / 随机森林模型,课件第 74 页用法)
– GridSearchCV + StratifiedKFold(多分类不均衡数据的标准调参组合)
十、原图存档
共 89 张原图,其中 16 张已插入上文对应小节(集成学习分类、Bagging/Boosting 思想、随机森林框架与步骤与 API、AdaBoost 迭代与全部核心公式与手算例、GBDT 负梯度、XGBoost 目标函数/复杂度/打分函数)。下列 73 张按主题分组存档,路径与抽取稿一致,可直接点开查证。
A. 集成学习总览与思想(第 4、5、8、10 页)
assets/集成学习/s04_01_7d5e6301.png(第 4 页)— 集成学习”多个弱学习器联合预测”的概念示意assets/集成学习/s05_01_2b26413b.png(第 5 页)— 集成学习概念配图assets/集成学习/s08_01_b36cf37c.png(第 8 页)— Bagging 三步演示之”1 采样不同数据集”assets/集成学习/s08_02_e0cd6075.png(第 8 页)— Bagging 三步演示之”2 训练分类器”assets/集成学习/s08_03_d69de12c.png(第 8 页)— Bagging 三步演示之”3 平权投票,获取最终结果”assets/集成学习/s08_04_7338b1df.png(第 8 页)— 圈/方块二分类数据集与最终判决边界assets/集成学习/s10_01_e99e7e3a.png(第 10 页)— Boosting 的生活化比喻:”滚球兽→亚古兽→暴龙兽→机械暴龙兽→战斗暴龙兽”
B. 随机森林(第 20 页;第 16/17/19 页的图已插入 §4.4)
assets/集成学习/s20_01_dc33ad62.png(第 20 页)— 随机森林 API 第 2 张截图(fit/predict/score调用示例)
C. AdaBoost 迭代机制(第 27–29 页;第 27 页第 1 图已插入 §4.5.1)
assets/集成学习/s27_02_2fcc506b.png(第 27 页)— “1 训练第一个学习器 / 2 调整数据分布”配图assets/集成学习/s28_01_710fb7b2.png(第 28 页)— “3 训练第二个学习器”示意图assets/集成学习/s28_02_dd5f3130.png(第 28 页)— “4 再次调整数据分布”示意图assets/集成学习/s29_01_9ef1026d.png(第 29 页)— “5 依次训练学习器,调整数据分布”示意图assets/集成学习/s29_02_986ead59.png(第 29 页)— “6 整体过程实现”(多轮分类器与最终判决线)示意图
D. AdaBoost 推导与手算例题(第 30、32–36 页;第 30 页两式、第 31/33/36 页例图已插入 §4.5)
assets/集成学习/s30_01_841b1ddb.png(第 30 页)— 集成预测公式 H(x)=\operatorname{sign}(\cdot) 图(配套文字:α 为模型权重,输出大于 0 归正类、小于 0 归负类)assets/集成学习/s32_01_e3777861.png(第 32 页)— 第 1 个弱分类器的误差率计算assets/集成学习/s32_02_4c60afd0.png(第 32 页)— 第 1 棵决策树:以 2.5 切分,左 3 样本输出类别 1、右 7 样本输出类别 −1assets/集成学习/s32_03_ba0ecab4.png(第 32 页)— 第 1 轮的数据与权重表assets/集成学习/s33_01_3a080381.png(第 33 页)— 第 1 轮模型权重计算结果assets/集成学习/s34_01_b8b466ea.png(第 34 页)— 第 2 个弱学习器的误差率计算assets/集成学习/s34_02_f1bffd32.png(第 34 页)— 第 2 棵决策树(以 8.5 切分)assets/集成学习/s35_01_8adbe305.png(第 35 页)— 第 2 轮模型权重计算assets/集成学习/s35_02_978a1ea0.png(第 35 页)— 第 2 轮权重更新后的数据分布assets/集成学习/s36_01_3f370524.png(第 36 页)— 第 3 个弱学习器的误差率assets/集成学习/s36_02_b650bf83.png(第 36 页)— 第 3 棵决策树(以 5.5 切分)assets/集成学习/s36_04_4080678f.png(第 36 页)— 代入 x=3:0.4236\times(-1)+0.64963\times(1)+0.7514\times(-1)=-0.52537<0,判为负类
E. AdaBoost 葡萄酒案例(第 37 页)
assets/集成学习/s37_01_c0baa24e.png(第 37 页)— 葡萄酒数据预览(Alcohol、Hue、Class label)assets/集成学习/s37_02_2b0e214a.png(第 37 页)— 需求与思路分析(读数据 → 特征处理 → 去掉一类做二分类 → 划分数据 → 单决策树 vs AdaBoost 500 棵树)
F. 提升树与 GBDT 推导(第 45–50 页;第 45 页负梯度式已插入 §4.6.2)
assets/集成学习/s45_01_fb82779a.png(第 45 页)— GBDT 假设与本轮目标(f_{i-1}(x)、h_i(x)、损失最小化)公式图assets/集成学习/s46_01_5d00e69c.png(第 46 页)— 初始化弱学习器(CART 树)的目标assets/集成学习/s46_02_57c3c591.png(第 46 页)— 平方误差对 f(x_i) 求导的推导过程assets/集成学习/s46_03_4beb6ecd.png(第 46 页)— 结论:”初始化树桩输出值为目标值的均值时,第一个弱学习器的平方误差最小”assets/集成学习/s47_01_ef5a2f67.png(第 47 页)— 第 1 个弱学习器的负梯度计算表assets/集成学习/s47_02_083d90c9.png(第 47 页)— 以 1.5 为切分点的平方损失计算(左子树 1 样本、右子树 9 样本均值 0.19,损失 15.72308)assets/集成学习/s47_03_4a21bca5.png(第 47 页)— 以 6.5 为切分点得到第 1 棵决策树assets/集成学习/s48_01_902298f2.png(第 48 页)— 第 2 个弱学习器的负梯度表assets/集成学习/s48_02_c7687ee2.png(第 48 页)— 切分点比较过程assets/集成学习/s48_03_89d4d127.png(第 48 页)— 以 3.5 为切分点时平方损失最小,得到第 2 棵决策树assets/集成学习/s49_01_9d7ff6b4.png(第 49 页)— 第 3 个弱学习器的负梯度表assets/集成学习/s49_02_9e8e3509.png(第 49 页)— 切分点比较过程assets/集成学习/s49_03_66aa2bfd.png(第 49 页)— 以 6.5 为切分点时平方损失最小,得到第 3 棵决策树assets/集成学习/s50_01_70904d1d.png(第 50 页)— 构建最终弱学习器assets/集成学习/s50_02_617473a0.png(第 50 页)— x=6 的集成结果:7.31+(-1.07)+0.22+0.15=6.61
G. XGBoost 推导(第 58–69 页;第 59 页目标函数与复杂度、第 69 页打分函数已插入 §4.7)
assets/集成学习/s58_01_8cffd9fe.png(第 58 页)— 最小化训练数据损失函数的原始目标公式assets/集成学习/s58_02_9ac2fe21.png(第 58 页)— “在损失函数中加入正则化项,提高对未知测试数据的泛化性能”assets/集成学习/s59_01_91e63ed5.png(第 59 页)— “XGBoost 是对 GBDT 的改进,并且在损失函数中加入了正则化项”assets/集成学习/s60_01_4388a691.png(第 60 页)— 电子游戏喜好预测的树结构(按年龄分小孩/大人、再按性别分男女并打分)assets/集成学习/s61_01_b3f9cf3b.png(第 61 页)— tree1 与 tree2 两棵树结论累加assets/集成学习/s61_02_616aacb1.png(第 61 页)— tree1 的复杂度表示assets/集成学习/s62_01_d29a5e68.png(第 62 页)— 第 t 次迭代的学习模型目标函数assets/集成学习/s62_02_ff1573bc.png(第 62 页)— “直接对目标函数求解比较困难,通过泰勒展开将目标函数换一种近似的表示方式”assets/集成学习/s63_01_295f2bac.wmf(第 63 页)— 泰勒展开公式(WMF 矢量格式,Markdown 无法直接渲染)assets/集成学习/s63_02_10802865.png(第 63 页)— 泰勒展开定义:”将一个函数在某一点处展开成无限项的多项式表达式”assets/集成学习/s63_03_a5d42d8f.wmf(第 63 页)— 一阶泰勒展开公式(WMF 格式)assets/集成学习/s63_04_91a3d9e2.wmf(第 63 页)— 二阶泰勒展开公式(WMF 格式)assets/集成学习/s64_01_c0ebacbd.png(第 64 页)— 目标函数对 y_i^{(t-1)} 的二阶泰勒展开近似式assets/集成学习/s64_02_ee0d8548.png(第 64 页)— 展开后各项的对应关系assets/集成学习/s64_03_6b6b5a91.png(第 64/65/67 页,课件中重复使用)— 可去掉的”前 t-1 个弱学习器目标函数”常数项assets/集成学习/s64_04_439bf478.png(第 64 页)— 去掉常数项后的目标函数assets/集成学习/s64_05_ddb74d81.png(第 64 页)— g_i、h_i 的定义(损失函数的一阶导、二阶导)assets/集成学习/s65_01_5c0575e3.png(第 65 页)— 从样本角度转为按叶子节点输出角度的损失函数assets/集成学习/s65_02_b863bbbf.png(第 65 页)— 叶子角度表达的说明assets/集成学习/s65_03_05349db5.png(第 65/66 页)— 树结构示意与”10 个样本落在 D(3)/E(2)/F(2)/G(3) 四片叶子”的计算例子assets/集成学习/s66_01_59da173d.png(第 66 页)— g_i f_t(x_i) 项转换为叶子角度assets/集成学习/s66_02_890316cc.png(第 66 页)— h_i f_t^2(x_i) 项转换为叶子角度assets/集成学习/s66_03_8e1580ba.png(第 66 页)— \lambda\|w\|^2 项(本身就是叶子角度)assets/集成学习/s67_01_87702de5.png(第 67 页)— 叶子角度的目标函数assets/集成学习/s67_02_9031d7c0.png(第 67 页)— G_i(所有样本一阶导之和)的定义assets/集成学习/s67_03_a90cdb3f.png(第 67 页)— H_i(所有样本二阶导之和)的定义assets/集成学习/s67_04_156985ac.png(第 67/68 页)— 化简后的最终目标函数assets/集成学习/s68_01_5307ce48.png(第 68 页)— “对 w 求导并令其等于 0,可得到 w 的最优值”assets/集成学习/s68_02_5605eda7.png(第 68 页)— 最优 w 与目标函数最小值的推导assets/集成学习/s69_01_bdc7862d.png(第 69 页)— 目标函数最终形式(含 -\frac{1}{2}\frac{G^2}{H+\lambda}+\gamma T)
H. XGBoost 红酒品质案例(第 72 页)
assets/集成学习/s72_01_9bb4f85b.png(第 72 页)— 红酒品质数据预览:11 个特征、3269 条数据、6 个品质类别(0~5),并提示”目标是多分类、数据存在样本不均衡问题”