用 12 页把深度学习的线性代数骨架过一遍,矩阵乘法的维度规则 → 全连接层与 Transformer 并行的本质 → 外积与低秩 → 低秩因式分解与 LoRA,是「模型压缩」章节的数学铺垫课。
一、这份材料解决什么问题
模型压缩的四大手段里,低秩分解直接就是矩阵分解,剪枝要靠 L1/L2 范数当”重要性判据”,量化本质是给矩阵乘法的输入输出做线性缩放,蒸馏的软标签损失是 KL 散度。也就是说,压缩这件事没有一项能绕开矩阵运算。
这份材料处在 4.1 模型压缩的最前面,它不推导公式,只做三件事:
- 把”矩阵乘法怎么算、形状怎么变”讲到不会再错,你取行、我取列,对应相乘再相加;
- 把课上最容易被当成”黑盒”的两件事点破:全连接层就是矩阵乘法、Transformer 能并行就是矩阵乘法行与行无依赖;
- 用”一列乘一行(外积)”和”10×10 分数矩阵”两个直觉,把低秩分解和 SVD 引出来,最后落到 LoRA。
被追问时”为什么 Transformer 能并行””LoRA 为什么省参数””SVD 凭什么能压缩模型”这三个高频问题的答案,全在这 12 页里。唯一要注意的是它标的是【了解】:要求是能说清直觉和形状规则,不要求手推 SVD 的证明。本文在保留原材料主线之外,补齐了它没有但必须会的几块(标量/向量/张量、转置、线性变换的几何意义、梯度与链式法则、L1/L2 范数),这些属于通用数学通识,会在小节里注明”(补充)”。
二、核心结论
- 矩阵乘法只有一条规则:左矩阵取一行、右矩阵取一列,对应位置相乘再求和;两个长度必须相同,否则红框对不上、根本无法运算。形状上就是 (m,n)\cdot(n,p)=(m,p)。
- 全连接层的本质就是矩阵乘法。抽取稿给出的真实代码是
self.fc = nn.Linear(768, config.num_classes),即 768 维向量乘上参数矩阵变成 10 个类别的分数。 - Transformer 的并行性来自矩阵乘法:输入 n 行 → 输出 n 行,行与行之间没有任何依赖,所以一句话多长都能一次算完。行数不影响能不能算,只影响计算量和显存。
- 一列乘一行(外积)得到秩 1 矩阵:它的每一行都只是同一行的倍数放大缩小,没有新信息,这就是”低秩”最极端的形态。
- 大矩阵拆成两个小矩阵是近似,必然有误差。低秩因式分解(SVD、梯度下降等)就是在”无法完全相等”的前提下,用更少的参数让乘积尽量接近原矩阵;而 LoRA 更进一步:不动原矩阵 W,只冻结它、外挂训练 A\times B,输出 Wx+ABx。
三、知识地图
原材料的页序是一条严丝合缝的因果链,整体权重标注为 【了解】(文件名即标注),分支如下:
【了解】深度学习+线性代数极速版(12 页)
├── ① 矩阵乘法的规则(P1–P3)        ← 全篇地基
│   ├── 内积/点积:"你取行,我取列,对应相乘再相加"(P1)
│   ├── 左矩阵 100 行也不影响运算,只影响结果有几行(P2)
│   └── 右矩阵 100 列也不影响运算,只影响结果多几列(P3)
├── ② 提问页:一列乘一行怎么算?(P4、P8 两页重复发问)
├── ③ 深度学习里的矩阵乘法(P5–P6、P9)
│   ├── 全连接层 fc 的本质就是矩阵乘法(P5,配图 s05;P9 复用同图)
│   └── Transformer 的并行特性 = 矩阵乘法规则,行间无依赖(P6,配图 s06)
├── ④ 外积与低秩的直觉(P7)
│   └── 一列×一行 → 每行只是放大缩小关系,秩很低
├── ⑤ 低秩因式分解(P10–P11)
│   ├── 矩阵乘法是严格相等的;反过来拆成两个小矩阵只是近似,有误差(P10)
│   └── 10×10 分数矩阵:看不到原始数据,也能靠分解看出"大体分布规律"(P11)
└── ⑥ 落地形态:LoRA 低秩适配器(P12,配图 s12)
    └── 不动原版 100×100 矩阵,只训练 1×100 和 100×1 两个小矩阵
四、原理详解
4.1 标量、向量、矩阵、张量(补充)
这四个词只是”数字的排布维度”从 0 到 3 的递增。标量是一个数,向量是一行/一列数,矩阵是一个二维表格,张量是更高维的堆叠。深度学习里的每一个中间结果,都可以用它来标注形状。
形状即契约。一个模型的绝大部分 bug(形状不匹配)都发生在这一层。
小例子(本项目的真实形状):
| 概念 | 例子 | 形状 |
|---|---|---|
| 标量 | 交叉熵损失值 0.417、偏置 b 中的一个数 |
() |
| 向量 | 一句话(”我爱深度学习”)经 BERT 得到的句向量 | (768,) |
| 矩阵 | 一个全连接层的权重 W | (768, 10) |
| 张量 | 一个 batch 的输入 | (32, 128, 768) |
这里补一个后面要用的数字:把上面那个标量损失算出来,softmax 输出为 [0.659, 0.242, 0.099]、真实标签是第 1 类时,-\ln 0.659 = 0.417;对 logits 求导得到 p-y=[-0.341, 0.242, 0.099],就是反向传播要用的那一行数。
4.2 矩阵乘法与维度规则(P1–P4)
“你取行,我取列,对应相乘再相加。”左矩阵的第 i 行去点乘右矩阵的第 j 列,得到结果矩阵第 i 行第 j 列的那个数。
设 A\in\mathbb{R}^{m\times n}、B\in\mathbb{R}^{n\times p},则
C_{ij}=\sum_{k=1}^{n}A_{ik}B_{kj},\qquad C\in\mathbb{R}^{m\times p}
能乘的前提只有一个:左矩阵的列数 = 右矩阵的行数(n 对上 n)。抽取稿的原话是”第一个矩阵取一行、第二个矩阵取一列,长度要相同!这样才能运算,否则无法运算,红框根本对不上”。
抽取稿 P1 的左矩阵(3×4)与右矩阵(4×4)相乘,第一个元素就是文稿里写死的那一行算式:
1\times1+2\times2+3\times0+4\times1=9
完整结果(已用代码复算):
\begin{bmatrix}1&2&3&4\\2&3&4&5\\0&1&0&1\end{bmatrix}
\begin{bmatrix}1&2&3&4\\2&3&4&5\\0&1&0&1\\1&2&0&0\end{bmatrix}
=\begin{bmatrix}9&19&11&17\\13&27&18&27\\3&5&4&5\end{bmatrix}
形状账:(3,4)\cdot(4,4)=(3,4)。P2 讲的是行数:左矩阵哪怕有 100 行也照算不误,只是结果从 3 行变成 100 行;P3 讲的是列数:右矩阵哪怕有 100 列也没关系,只是结果多出 100 列。这两页其实已经把 P6 的结论提前埋好了。
P4/P8 是提问页:抽取稿只留下”4\times1 的列向量 · 1\times4 的行向量 =?”,答案在 P7 和 P10。
4.3 转置与维度对齐(补充)
转置就是把矩阵”横过来”,A 的第 i 行第 j 列变成 A^\mathsf{T} 的第 j 行第 i 列,形状 (m,n)\to(n,m)。它最大的用途不是数学,而是把两个矩阵的维度凑成能相乘的样子。
抽取稿 P1 那个 3\times4 的矩阵 A,A^\mathsf{T} 就是 4\times3;于是 A^\mathsf{T}A 得到 4\times4 的方阵(这是 SVD 里 A^\mathsf{T}A 的特征分解),而 AA^\mathsf{T} 是 3\times3。这就是 nn.Linear(768, 10) 内部在干的事:它存的是 (10,768) 的权重,实际计算时做的是 x\,W^\mathsf{T}+b,其中 x 是 (1,768),xW^\mathsf{T} 才得到 (1,10)。
一句话记住:”先看维度,再看运算”,x\cdot W^\mathsf{T} 和 W\cdot x 完全是两回事,能算哪个由形状决定。
4.4 线性变换的几何意义(补充)
把一个矩阵看成一个动作,而不是一堆数。它作用在一个向量上,就是把这个向量”搬家”:旋转、拉伸、压缩、投影、剪切。矩阵的列向量,就等于”把基向量 \mathbf{e}_1,\mathbf{e}_2,\dots 各自搬到了哪里”。
小例子(2×2 便于画):取 M=\begin{bmatrix}2&1\\1&2\end{bmatrix}。
- 单位正方形 (0,0),(1,0),(1,1),(0,1) 被它映射成面积 |\det M| = 3 的平行四边形,行列式就是面积/体积的放大倍数;
- 取方向 \mathbf{v}_1=(1,1)^\mathsf{T}:M\mathbf{v}_1=(3,3)^\mathsf{T}=3\mathbf{v}_1,这个方向被拉长 3 倍;
- 取方向 \mathbf{v}_2=(1,-1)^\mathsf{T}:M\mathbf{v}_2=(1,-1)^\mathsf{T}=1\cdot\mathbf{v}_2,这个方向完全没变。
这两个方向就是 M 的特征向量(对应特征值 3 和 1)。在特征方向上,矩阵只是做了缩放,没有旋转,这是理解 PCA 和 SVD 的钥匙。
外积的几何意义(对应 P7):一列乘一行,得到的矩阵把所有向量都投影到同一个方向上再缩放。它只有一个”有效方向”,所以秩为 1。
4.5 全连接层 = 矩阵乘法(P5、P9)
一层的”计算”没有任何神秘之处:输入的每一个维度,都跟输出的每一个维度握手一次,握手的强度就是权重。768 个输入、10 个输出,需要 768\times10 次握手。
\mathbf{y}=\mathbf{x}W^\mathsf{T}+\mathbf{b},\mathbf{x}\in\mathbb{R}^{1\times768}、W^\mathsf{T}\in\mathbb{R}^{768\times10}、\mathbf{y}\in\mathbb{R}^{1\times10}。
原图与代码:抽取稿 P5 的配图就是这一段真实代码,self.fc = nn.Linear(768, config.num_classes)。也就是分类头:BERT 吐出的 768 维句向量,乘上参数矩阵,变成 10 类新闻的分数。

图注:截图只有一行代码 self.fc = nn.Linear(768, config.num_classes),即本项目把 BERT 的 768 维输出映射到 num_classes(本项目为 10)个类别的全连接层。它就是”矩阵乘法 + 偏置”的可训练封装。
768\times10 的权重加 10 个偏置,参数量 768\times10+10=7690 个。相比之下,模型里同为 768×768 的一个注意力权重矩阵就有 589{,}824 个参数,这也顺便解释了为什么给 10 类分类头做低秩分解没意义:它本来就只占万分之几。
P9 复用了同一张图,但配上了不同的数字标注:抽取稿里留下的是 10 1000 1000 1 10 与 1 10 1,以及”我 爱 深 度 学 习”七个字加一排 x。它是同一个意思的”放大版”示意,输入维度、中间层维度、输出维度都是矩阵的两条边,哪一条边变了,参数量就变。
图注:与第 5 页同一张代码图,第 9 页用来演示同一层的维度账:抽取稿页面上标注的维度数字为输入 10(或 1×10)、中间 1000、输出 10,并画了一排 x 表示待填的分数格子。注意此页的 1000 只是示意数字,不是模型真实配置。
4.6 Transformer 的并行性 = 矩阵乘法的行独立性(P6)
RNN 必须等第 1 个词算完才能算第 2 个词,因为它是串行的循环;而 Transformer 把”一句话”整体摆成一个矩阵,每一行是一个 token,算第 3 行的时候完全不需要知道第 1 行的结果。
\mathbf{X}\in\mathbb{R}^{n\times768}(n 是序列长度)左乘参数矩阵 W\in\mathbb{R}^{768\times d_{out}},得到 \mathbb{R}^{n\times d_{out}}。看公式 C_{ij}=\sum_k X_{ik}W_{kj},结果第 i 行只用到 X 的第 i 行。抽取稿的总结非常到位:”输入多少行,输出多少行……行数不影响矩阵乘法的可行性,但会影响计算量和显存。”
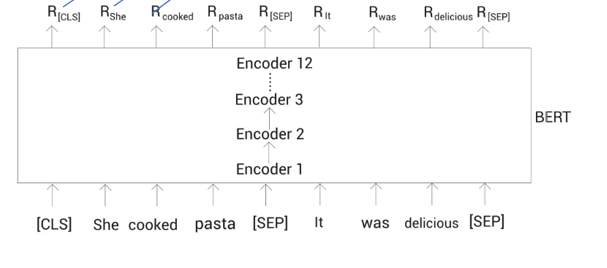
图注:这是 BERT 编码器的结构示意图。底部输入 token 依次为 [CLS] She cooked pasta [SEP] It was delicious [SEP](9 个 token,句尾补 [SEP]),中间是 Encoder 1 → Encoder 2 → Encoder 3 → … → Encoder 12 的堆叠(图中用虚线省略了中间层),右侧标注 BERT,顶部为每个位置各自的输出 R_[CLS] R_She R_cooked R_pasta R_[SEP] R_It R_was R_delicious R_[SEP]。底部 9 个 token 对应顶部 9 个输出向量,一对一、位置不串,这就是”输入多少行,输出多少行”,也是并行性的图像证据。
抽取稿给出的是”768 维 × 9999 维”的参数矩阵,n 行的输入矩阵乘它就是 n\times9999 的输出。取 n=128(序列长 128)、batch=32,则一次前向要处理 32\times128=4096 个 token 行,行数直接决定计算量和显存占用,这也是长文本吃显存的原因。
4.7 梯度与链式法则(补充,但和 P7 直接相连)
训练就是”看结果差多少,再回头怪罪每一个参数”。链式法则负责把”最终误差”一层层摊回给中间变量;而对矩阵参数求梯度,得到的就是一个外积,这正好是 P7 讲的那件事。
设 \mathbf{y}=W\mathbf{x},损失 L=\lVert \mathbf{y}-\mathbf{t}\rVert_2^2。链式法则两步:
\frac{\partial L}{\partial \mathbf{y}}=2(\mathbf{y}-\mathbf{t}),\qquad \frac{\partial L}{\partial W}=\frac{\partial L}{\partial \mathbf{y}}\,\mathbf{x}^\mathsf{T}=2(\mathbf{y}-\mathbf{t})\mathbf{x}^\mathsf{T},\qquad \frac{\partial L}{\partial \mathbf{x}}=W^\mathsf{T}\frac{\partial L}{\partial \mathbf{y}}
注意 \frac{\partial L}{\partial W} 是”列乘行”,一个外积,形状 (3,1)\cdot(1,2)=(3,2),正好和 W 同形。这就是”梯度形状永远等于参数形状”。
小例子(已用数值微分复核,误差 4\times10^{-6}):
W=\begin{bmatrix}1&2\\0&1\\1&0\end{bmatrix},\ \mathbf{x}=\begin{bmatrix}1\\2\end{bmatrix},\ \mathbf{t}=\begin{bmatrix}5\\2\\0\end{bmatrix}\ \Rightarrow\ \mathbf{y}=\begin{bmatrix}5\\2\\1\end{bmatrix},\ L=\lVert\mathbf{y}-\mathbf{t}\rVert^2=1
\frac{\partial L}{\partial W}=2\begin{bmatrix}0\\0\\1\end{bmatrix}\begin{bmatrix}1&2\end{bmatrix}=\begin{bmatrix}0&0\\0&0\\2&4\end{bmatrix}
梯度里只有第 3 行非零,因为只有第 3 个输出错了。做一步 SGD(\eta=0.01):W 的第 3 行变成 [1,0]-0.02[1,2]=[0.98,-0.04],损失从 1 降到 0.81。这就是”斌子法则”里”算损失→反向→更新”内在的全部数学。
4.8 范数:L1/L2 与剪枝、正则的关系(补充,直通「4.4 模型剪枝」那份材料)
范数就是”这把参数有多大”的度量。要判断”哪个权重不重要、可以剪掉”,必须先把”大”定义清楚,这就是剪枝的评分函数。
对向量 \mathbf{v},
\lVert\mathbf{v}\rVert_1=\sum_i|v_i|,\qquad \lVert\mathbf{v}\rVert_2=\sqrt{\sum_i v_i^2},\qquad \lVert\mathbf{v}\rVert_0=\#\{i: v_i\neq0\}
| 范数 | 几何形状 | 在优化里的效果 | 与剪枝/压缩的关系 |
|---|---|---|---|
| L1 | 菱形(有尖角) | 会把参数压到恰好为 0,产生稀疏解 | 稀疏 ⇒ 可以只存非零值;L1 值小 ⇒ 非结构化剪枝的判据 |
| L2 | 圆形(光滑) | 等比例收缩参数,不会压到 0 | 结构化剪枝常按整条通道的 L2 范数排序;也用作梯度裁剪(grad clipping) |
小例子(同样是已复算的数字):\mathbf{v}=[1,3,0,1],\lVert\mathbf{v}\rVert_1=5、\lVert\mathbf{v}\rVert_2=\sqrt{11}\approx3.317、非零元素 3 个。再看正则怎么改变权重,取 \mathbf{w}=[0.5,-1.5,2.0,0.1]、强度 \lambda=0.5:
- L1 收缩:\operatorname{sign}(w)\max(|w|-\lambda,0)=[0,-1,1.5,0], 0.5 和 0.1 被精确压成 0,两个权重可以直接删掉;
- L2 收缩:w/(1+\lambda)=[0.333,-1,1.333,0.067],全部缩小,但一个都不为 0,稀疏度没有任何提升。
这个对比就是”为什么剪枝偏爱 L1、正则项里 L2 用得多(可导、好优化)”的标准答案。
4.9 特征值与 SVD 的直觉(P7)
先看外积 → 秩 1。P7 问的是”一列乘一行怎么算”,抽取稿直接给出了答案的两句话:”大矩阵的每一行之间都只是相当于放大缩小关系,没有不同于第一行之外的新信息,秩很低”。用抽取稿给的那一列放大看:列向量 \mathbf{u}=[1,3,0,1,7,0,9]^\mathsf{T} 乘行向量 \mathbf{v}=[1,2,3,4,5,7,9],得到的 7\times7 矩阵是
\begin{bmatrix}1&2&3&4&5&7&9\\
3&6&9&12&15&21&27\\
0&0&0&0&0&0&0\\
1&2&3&4&5&7&9\\
7&14&21&28&35&49&63\\
0&0&0&0&0&0&0\\
9&18&27&36&45&63&81
\end{bmatrix}
- 第 1、4 行完全一样(因为对应的列元素都是 1);第 5 行 = 第 1 行的 7 倍;第 3、6 行全是 0。
- 它的秩 = 1,奇异值只有第一个非零:\sigma_1=\lVert\mathbf{u}\rVert_2\lVert\mathbf{v}\rVert_2=44.43,其余全是 0。
再看 SVD。任意矩阵 A 都能写成
A=U\Sigma V^\mathsf{T}
其中 V 的列是右奇异向量(输入空间里一组互相垂直的方向),U 的列是左奇异向量(输出空间里对应的方向),\Sigma 是对角阵,对角线上的奇异值从大到小排列,非零个数 = 矩阵的秩。可以把 SVD 理解成”旋转 → 沿坐标轴拉伸 → 再旋转”三步,是”特征分解”对任意(非方、非对称)矩阵的推广。
小例子(就取 P1 那个 3\times4 的矩阵 A):它的奇异值是 [9.218,\ 0.893,\ 0.486],秩为 3。若只保留最大的一个奇异值(秩 1 近似),能解释的能量占比 \sigma_1^2/\sum\sigma_i^2=98.8\%,用 Frobenius 范数衡量的相对误差是 10.96\%;保留两个奇异值时误差降到 5.24\%;保留三个则误差为 0。”用几个奇异值”就是精度与压缩比的旋钮。
4.10 低秩因式分解:从近似到 LoRA(P10–P12)
正向的矩阵乘法是严格相等的;但反过来”把一个大矩阵拆成两个小矩阵相乘”,只是近似。既然无法完全相等,就用算法(SVD、梯度下降等)让乘积尽量接近原矩阵,这就是低秩因式分解。
A\in\mathbb{R}^{m\times n} 用秩 r 近似为 A\approx B\cdot C(B\in\mathbb{R}^{m\times r}、C\in\mathbb{R}^{r\times n}),参数量从 mn 降到 r(m+n)。Eckart–Young 定理保证:在所有秩不超过 r 的矩阵里,截断 SVD 的 Frobenius 误差是最小的。
小例子 1(P11 的分数矩阵):一个班的分数矩阵 10\times10,共 100 个参数。用秩 3 近似只需要 10\times3+3\times10=60 个参数(省 40%),秩 1 只要 10+1+10=21 个数。抽取稿的比喻很准确:”我并不能完全知道大矩阵,但是我能近似知道大矩阵参数的大体分布规律”,低秩分解像特征提取,它抓到的是”讲台在哪儿”这种结构性规律,而不是每一个分数。
小例子 2(100×100 的真实数字):生成一个秩 3 的 100×100 矩阵(100\times3 与 3\times100 相乘),它的奇异值是 [112.70,98.23,84.36,0,0,\dots]。
| 保留秩 r | 参数量 | 相对误差 |
|---|---|---|
| 1 | 200 | 75.4% |
| 2 | 400 | 49.2% |
| 3 | 600 | 0.0%(原矩阵秩就是 3) |
注意这张表的核心:r 不够时误差大得吓人(75%),r 一旦达到真实秩,误差瞬间归零。所以低秩分解能不能用,取决于原矩阵是不是真的低秩。
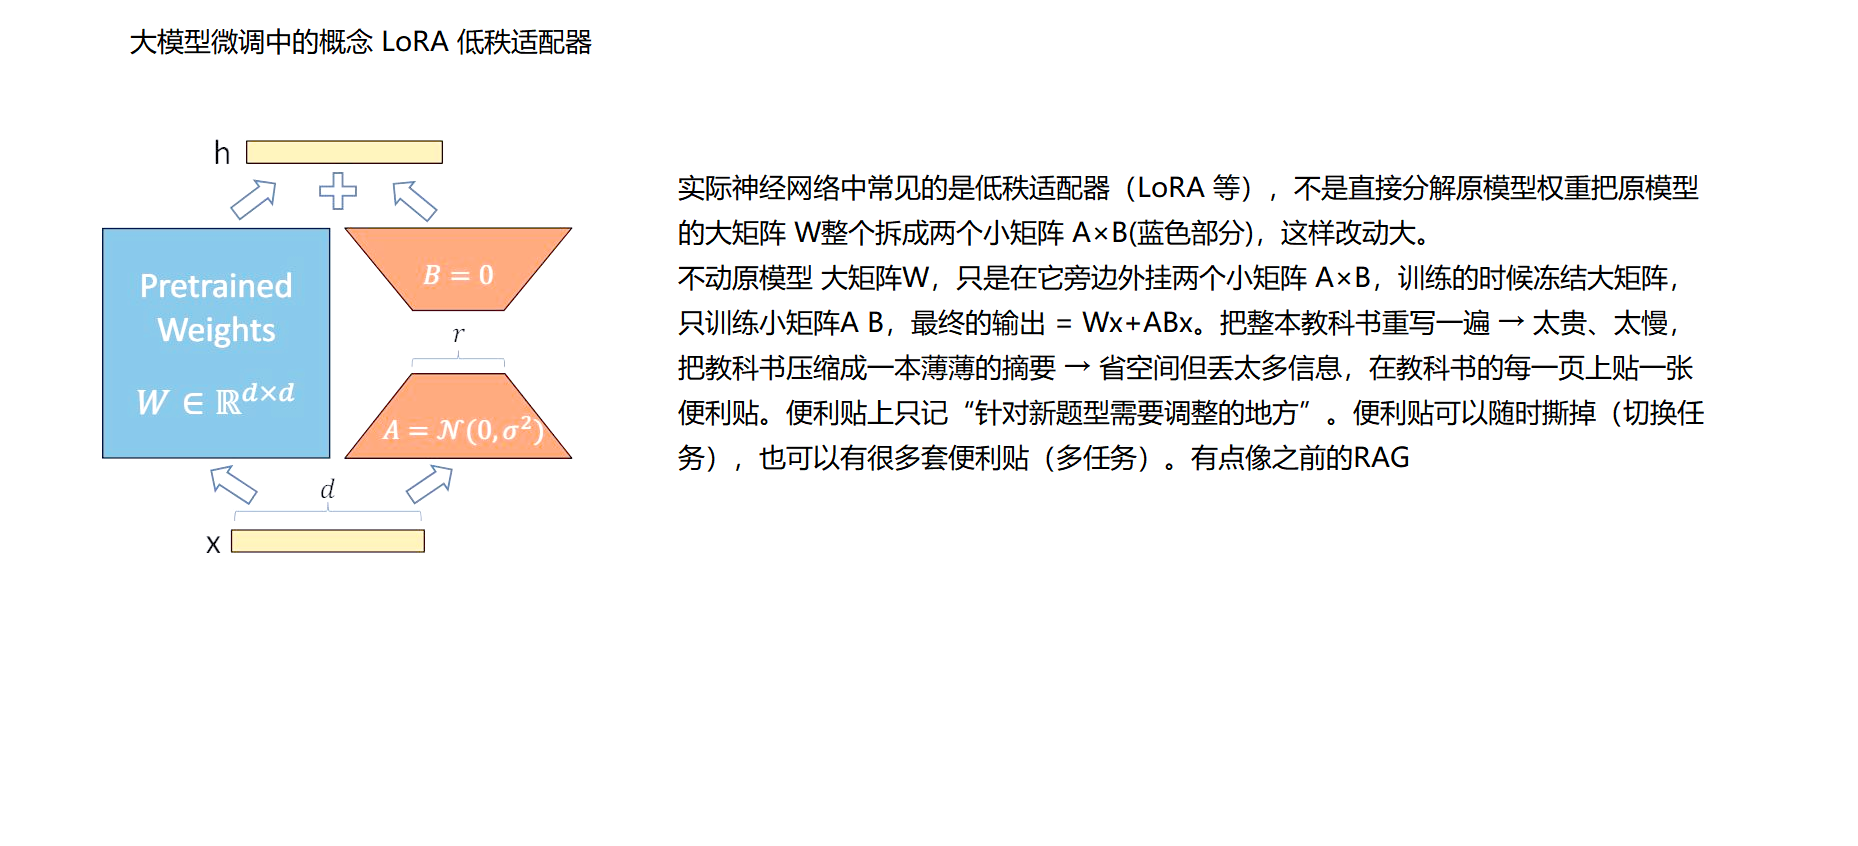
图注:这是 LoRA 的原理示意图。左侧:输入向量 x(标注维度 d)分两路,一路经蓝框 Pretrained Weights W ∈ ℝ^{d×d}(预训练权重,被冻结),另一路经橙色梯形 A = N(0, σ²)(高 d、瓶颈处标 r)和 B = 0(瓶颈 r、高 d)两个小矩阵,两路在 + 处相加后得到输出 h = Wx + ABx。右侧文字解释了它和直接分解的区别:不是直接分解原模型权重(把大矩阵 W 整个拆成两个小矩阵改动太大),而是不动原矩阵 W、只在旁边外挂小矩阵 A×B,训练时冻结大矩阵、只训练 A 和 B,最终输出 = Wx+ABx;并用”把整本教科书重写一遍 → 太贵太慢””压缩成薄摘要 → 省空间但丢太多信息””在每一页贴便利贴,只记针对新题型需要调整的地方”三个比喻说明 LoRA 的取舍,最后一句是”有点像之前的 RAG”。
小例子 3(把 LoRA 的参数账算清):d=768 时,全量微调一个 768\times768 矩阵要 589{,}824 个参数;LoRA 取 r=8 只需 768\times8+8\times768=12{,}288 个参数,约 2.1%;r=16 是 4.2%。抽取稿 P12 那句”不动原版 100×100 的矩阵,训练过程只训练 1\times100 和 100\times1 两个矩阵(只是理解意思,不是精确数字)”,说的就是 r=1 的极端情形:100\times1 乘 1\times100,200 个参数代替 10000 个。图中把 A 初始化为 N(0,\sigma^2) 随机小值、把 B 初始化为 0 也是真实的 LoRA 做法,这样训练开始时 ABx=0,模型的初始表现与预训练模型完全一致,不会一上来就把效果打乱。
五、易错点与常见误解
- 常见说法:「两个矩阵只要行列数一样就能乘」;实际上,必须左矩阵的列数 = 右矩阵的行数。为什么:点是”行的长度”和”列的长度”在配对,长度不同根本配不上(抽取稿的原话是”红框根本对不上”)。
- 有人以为「矩阵乘法满足交换律,AB=BA」;实际上,一般不等,连形状都可能不兼容。为什么:AB 是”先用 B 变换再用 A 变换”,顺序换了就是另一个变换;(3,4)\cdot(4,4) 能算,倒过来 (4,4)\cdot(3,4) 就算不了。
- 常听到的一种说法是:「输入有几百行就太长了,算不动」;实际上,行数完全不影响能不能算,只影响结果有几行、以及计算量与显存(P2、P6 两处都在说这件事)。长文本的问题不是”不能算”,而是 attention 的显存和算力开销。
- 容易想岔的地方:「低秩分解是无损压缩」;实际上,有损,只有 r\ge 原矩阵的秩时才无损。为什么:100×100 秩 3 的矩阵用 r=1 近似,相对误差高达 75.4%。
- 先说一个误解:「LoRA 是把原权重矩阵 W 分解成两个小矩阵」;实际上,LoRA 不碰 W,它是冻结 W 并外挂 A\times B,输出 Wx+ABx。图注里那句话说得很明白:”把原模型的大矩阵 W 整个拆成两个小矩阵,这样改动大”,LoRA 的动机正是避开这种改动。(顺带记住:真把 W 拆了再存成两个小矩阵,那是低秩分解压缩,不是 LoRA。)
- 常见说法:「L1 和 L2 正则差不多,都是为了限制参数大小」;实际上,L2 只等比例缩小、一个都不清零;L1 能把参数精确压成 0 从而产生稀疏。为什么:\lambda=0.5 时 [0.5,-1.5,2.0,0.1] 在 L1 下变成 [0,-1,1.5,0],在 L2 下变成 [0.333,-1,1.333,0.067]。稀疏性能直接省存储,这才是剪枝偏爱 L1 的原因。
- 有人以为「SVD 跑两次结果会不一样,所以不稳定」;实际上,数值上是稳定的,奇异值唯一,只有 U、V 的符号可以任取(一对奇异向量同时变号,乘积不变)。这是符号自由度,不是算法抖动。
- 常听到的一种说法是:「外积得到的矩阵每一行都是同一个数」;实际上,是成比例的倍数关系,系数为 0 的那几行会整行为 0。看 P7 的例子:列向量里第 3、6 个元素是 0,对应第 3、6 行就全是 0,它不影响秩,但会让矩阵看起来”缺几行”。
- 容易想岔的地方:「x\cdot W 和 W\cdot x 是同一件事,只是写法不同」;实际上,由形状决定能写哪个。为什么:
nn.Linear(768,10)存的是 (10,768) 的权重,实际算的是 xW^\mathsf{T}+b;Wx 在 (1,768) 的输入下根本乘不起来。
六、横向对比与研究脉络
6.1 矩阵层面:几种”压缩一个矩阵/张量”的路子
| 方法 | 原理 | 优点 | 缺点 | 适用场景 | 复杂度/参数账 |
|---|---|---|---|---|---|
| 低秩分解(截断 SVD) | A\approx U_r\Sigma_r V_r^\mathsf{T},Eckart–Young 保证 Frobenius 误差最优 | 有理论最优性保证,一次分解即可,无需训练 | 原矩阵不够低秩时误差爆炸;只能用于”近低秩”的权重 | 大且确实低秩的权重矩阵(如大的 FC/embedding) | 约 O(mnr);参数 r(m+n) vs mn |
| LoRA(低秩适配) | 冻结 W,训练 A(\text{随机})\times B(=0),输出 Wx+ABx | 参数降到 2% 量级,几乎不掉点,可多套”便利贴”切换任务、可随时撕掉 | 推理时若不合并不增加延迟但会增加权重;秩 r 与放置位置要调 | 换任务/领域适配,不想动预训练权重 | 参数 r(m+n),d=768,r=8 时 12,288/589,824 ≈ 2.1% |
| 剪枝(非结构化) | 按 L1/绝对值大小把个别权重置 0 | 稀疏度可很高、理论压得最狠 | 稀疏矩阵在通用硬件上不一定真加速,需要稀疏算子支持 | 追求极致压缩率、可接受专门推理库 | 评分+置零开销小,主要在重训恢复 |
| 剪枝(结构化) | 按整通道/整头的 L2 范数排序,整块删掉 | 直接减少真实的矩阵维度,通用硬件立刻加速 | 粒度粗,掉点比非结构化明显 | 要真·推理加速的部署 | 删维度后矩阵变小 |
| 量化 | 把 float32 换成 int8/int4,本质是缩放 x\approx s\cdot q | 压缩比高、内存带宽降 4 倍 | 精度损失;需要校准(PTQ)或重训(QAT) | 最后的部署环节,几乎必做 | 位宽 32→8,理论 4× |
| 蒸馏 | 学生学老师的软标签/中间层 | 模型结构可以完全不同,可大幅缩小 | 需要训练,且要老师在场 | 端侧小模型、结构大改 | 取决于学生规模 |
6.2 演进脉络(谁解决了谁的什么问题)
- 矩阵乘法是全部的地基。它有两个”副产品”被反复复用:(m,n)·(n,p) 的形状规则(用来做维度检查)和行与行无依赖(Transformer 并行性的数学来源)。
- 全连接层是矩阵乘法的最小封装(xW^\mathsf{T}+b),把”线性代数”变成”可训练的一层”。BERT 顶上的
nn.Linear(768, 10)就是它在本项目里的化身。 - Transformer 用”把序列摆成矩阵”把 RNN 的串行结构换成了并行结构,代价是把”位置”变成需要额外注入的信息(位置编码)。
- 低秩近似(SVD 等)解决的是”矩阵太大存不下”的问题,它是无损变成有损:承认无法完全相等,用更少的参数逼近。本项目「4.1 模型压缩」这一章里的低秩分解压缩用的就是这条路。
- LoRA 解决的是 SVD 这条路的两个现实问题:① 直接分解预训练权重改动太大、破坏通用能力;② 每个新任务都要重训/重存一份全量参数。LoRA 把它们换成”冻结原权重 + 只训一对小矩阵”,从”压缩一个模型”变成”用低秩增量适配一个模型”。
- 两者共享同一套数学(低秩、外积、秩的效率),但目标不同:一个是省存储,一个是省训练和版本管理。这个区别是的加分点。
七、在新闻分类项目中的落地
这份材料的每一页,几乎都能在项目里找到对应的那一行代码。
- 分类头就是这幅图里的代码。项目 BERT 微调阶段的最后一步是
nn.Linear(768, 10),768 维句向量经矩阵乘法变成 10 个类别的 logits。图注里的config.num_classes就是项目的 10 类。参数量只有 7690,没有压缩价值,别在这上面做低秩分解,这是最容易被问倒的细节。 - 梯度就是外积。训练”斌子法则”里的”前向 → 算损失 → 梯度清零 → 反向 → 更新”,前向是 xW^\mathsf{T},反向的 \partial L/\partial W=(\partial L/\partial y)\,x^\mathsf{T} 就是抽取稿 P7 讲的”列乘行”。所以 P7 不是纯数学,它是反向传播的形状来源:梯度的形状永远等于参数的形状。
- 矩阵乘法决定了 batch 与序列长度怎么调。P6 讲的”输入多少行就输出多少行、行数决定计算量和显存”直接对应实践:训练 18w 条数据时
batch_size与max_seq_len是显存的乘数项,显存不够第一个该动的是它们,不是”模型算不动”。 - 剪枝的判据来自 L1/L2。到了「4.4 模型剪枝」那份材料要做非结构化剪枝时(范数本身在本文 4.8 节),
torch.nn.utils.prune.global_unstructured()需要一个 importance score,最常用的就是权重的绝对值(L1)或通道的 L2 范数。要能说清”为什么 L1 能剪出真正的 0,而 L2 只会整体变小”。 - 低秩分解用在”大而冗余”的矩阵上。判断标准就是 4.10 那张表:先看奇异值衰减快不快(前几个奇异值占比多少),衰减快才值得分解。像 768×768 的注意力权重才有空间,768×10 的分类头没有。
- LoRA 是给项目加”第二套便利贴”的方式。如果想把 10 类新闻扩展到 20 类、或换一个领域的数据集,LoRA 可以冻结 BERT、只训
A/B两个小矩阵,显存占用和 checkpoint 体积都大幅下降(r=8 时约 2%),还能给每个任务留一套适配器。注意图注里那句”有点像 RAG”:两者都是”不动主干、外挂增量”,只是 RAG 外挂的是检索到的事实,LoRA 外挂的是参数增量。 - 和路线里其它方案的配合。前面的 TF-IDF+随机森林是稀疏表示(高维、大量 0),跟”低秩”恰好是相反方向,TF-IDF 靠稀疏省内存,低秩分解靠稠密但低秩省参数,这两个直觉不要混;FastText 的 embedding 查表本质也是矩阵取值;最终部署链是 BERT/LLM → 量化(PTQ/QAT/DQ)+ 蒸馏 + 剪枝 + 低秩分解 → 保存格式选择,low-rank 是这条链上唯一”有数学最优性保证”的一环,也是唯一能用来做任务适配(LoRA)的一环。
八、重点问答
Q1:全连接层的本质是什么?
A:本质就是一次矩阵乘法加一个偏置。输入是一个向量,参数是一个矩阵,输出的第 j 个数就是输入的每一维和权重矩阵第 j 列做点积。项目里 BERT 顶上的 nn.Linear(768, 10) 就是这样:768 维句向量乘上 (10,768) 的权重再转置,得到 10 个类别的分数,一共 7690 个参数。理解到这一步,很多”层”的困惑就没了,它不神秘,只是形状在变。
Q2:为什么 Transformer 能并行,而 RNN 不行?
A:因为 Transformer 把整个序列摆成一个矩阵,一行是一个 token,输出第 i 行只用输入第 i 行,行与行之间没有依赖,所以可以一次性算完;RNN 是循环结构,第 t 步必须等第 t-1 步的结果,天然串行。代价是 Transformer 丢掉了顺序信息,要靠位置编码补回来。反过来,行与行独立也意味着序列长度只影响计算量和显存,不影响能不能算,长文本慢和爆显存就是这个原因。
Q3:矩阵乘法为什么没有交换律?
A:因为矩阵乘法是”变换的复合”,AB 的意思是先用 B 变换再用 A 变换,换个顺序就是另一件动作。几何上,旋转 90° 再拉伸和拉伸再旋转 90°,结果不一样。而且很多时候连形状都不兼容:(3,4)\cdot(4,4) 能算,(4,4)\cdot(3,4) 就算不了,因为内层维度对不上。所以写代码时第一件事永远是检查形状。
Q4:L1 和 L2 正则有什么区别?跟剪枝有什么关系?
A:L2 是平方和开根,对参数的惩罚是等比例收缩,参数只会变小不会变 0;L1 是绝对值之和,在 0 点有个尖角,梯度下降会把小的参数直接压到恰好 0,产生稀疏。稀疏就意味着可以直接删掉那些 0,所以剪枝,尤其是非结构化剪枝,特别喜欢用 L1 或者权重绝对值当重要性判据;而训练时更常用 L2,因为它可导、形状光滑、只做收缩不破坏参数分布。我实际做的时候会先按范数排序再定阈值。
Q5:SVD 是什么?为什么能用来压缩模型?
A:SVD 是把任意矩阵写成”旋转 × 沿轴拉伸 × 旋转”,A=U\Sigma V^\mathsf{T},奇异值从大到小排列,非零奇异值的个数就是矩阵的秩。把它用来压缩的逻辑是:如果原矩阵的奇异值衰减很快,只保留前 r 个就能解释绝大部分能量,参数量从 mn 降到 r(m+n)。Eckart–Young 定理保证了在所有秩不超过 r 的近似里,截断 SVD 的 Frobenius 误差最小。代价是有损,r 太小掉点会很明显,比如我算过一个秩 3 的 100×100 矩阵,r=1 时相对误差 75%,r=3 直接归零。
Q6:LoRA 为什么省参数?它和低秩分解有什么区别?
A:LoRA 也是低秩的思路,但它不分解原权重。原权重 W 冻结不动,只在旁边外挂两个小矩阵 A(d\times r)和 B(r\times d),输出变成 Wx+ABx,训练只更新 A、B。d=768、r=8 的时候,12,288 个参数对 589,824 个,约 2%。B 初始化成 0,所以训练刚开始 ABx=0,模型起点和预训练模型完全一致。区别在于:低秩分解是”把大矩阵拆成两个小矩阵直接替换它”,为了省存储、改动大;LoRA 是”保留原矩阵、叠加一个低秩增量”,为了省训练成本、支持多任务切换,一套权重可以配很多张贴在书页上的便利贴。
Q7:转置在模型里有什么实际用处?
A:最实用的作用是凑维度。比如 nn.Linear 里存的是 (out,in) 形状的权重,输入是 (1,in),要做乘法就得把它转成 (in,out),也就是 xW^\mathsf{T}+b。另外转置还出现在 SVD、注意力里,QK^\mathsf{T} 就是因为要把”序列×维度”的两边配成”序列×序列”的相似度矩阵。所以看到 -1 或者 .T 出现在代码里,基本都是为了对齐形状。
Q8:链式法则和矩阵乘法在训练里怎么配合?
A:链式法则负责”把误差一层层摊回去”,矩阵乘法负责”每一层的具体形状”。最漂亮的一点是:对权重矩阵求梯度,结果是一个外积,\partial L/\partial W=(\partial L/\partial y)x^\mathsf{T},形状跟 W 完全一样,这就是”梯度形状等于参数形状”的原因。我实测过一个小例子:W 是 3×2、x=[1,2],只有第 3 个输出错了,梯度就只有第 3 行非零,是 [2,4],用数值微分验证误差在 10^{-6} 量级。所以前向是”取行乘取列”,反向是”列乘行”,都是同一套矩阵乘法规则。
九、延伸阅读
- 3Blue1Brown《线性代数的本质》系列视频(官方 YouTube 频道「3Blue1Brown」,中文字幕版在 B 站可搜),矩阵作为线性变换、特征向量、外积的几何直觉,正好补上本材料缺的可视化部分。
- Gilbert Strang《Introduction to Linear Algebra》(Wellesley–Cambridge Press,配套 MIT 18.06 公开课 ocw.mit.edu),SVD 与低秩近似的标准教材讲法。
- d2l.ai(动手学深度学习)第 2 章「预备知识」与第 4 章「多层感知机」,把矩阵乘法、范数、前向/反向和 PyTorch 代码一一对应起来,和本项目的训练流程最接近。
- PyTorch 官方文档:
torch.nn.Linear(形状与 xW^\mathsf{T}+b 的定义)、torch.linalg.svd/torch.svd_lowrank(截断 SVD 的工程实现)、torch.nn.utils.prune(L1/L2 判据与结构化/非结构化剪枝的 API)。 - HuggingFace PEFT 文档与
peft库(LoraConfig、get_peft_model),LoRA 的生产级实现,可以直接对照第 12 页那张图看 r、lora_alpha、target_modules这几个参数。 - NumPy 官方文档:
numpy.linalg.svd、numpy.linalg.norm(ord=1/2/'fro'),本文所有数值例子都可以用这两行 API 复现,建议自己跑一遍。