蒸馏的第二种传法,不只学教师的输出,还要学教师的中间层特征。因为大模型从数据里提取特征的”能力”本身就比小模型好,学生可以直接对着教师的特征图做 MSE 回归。
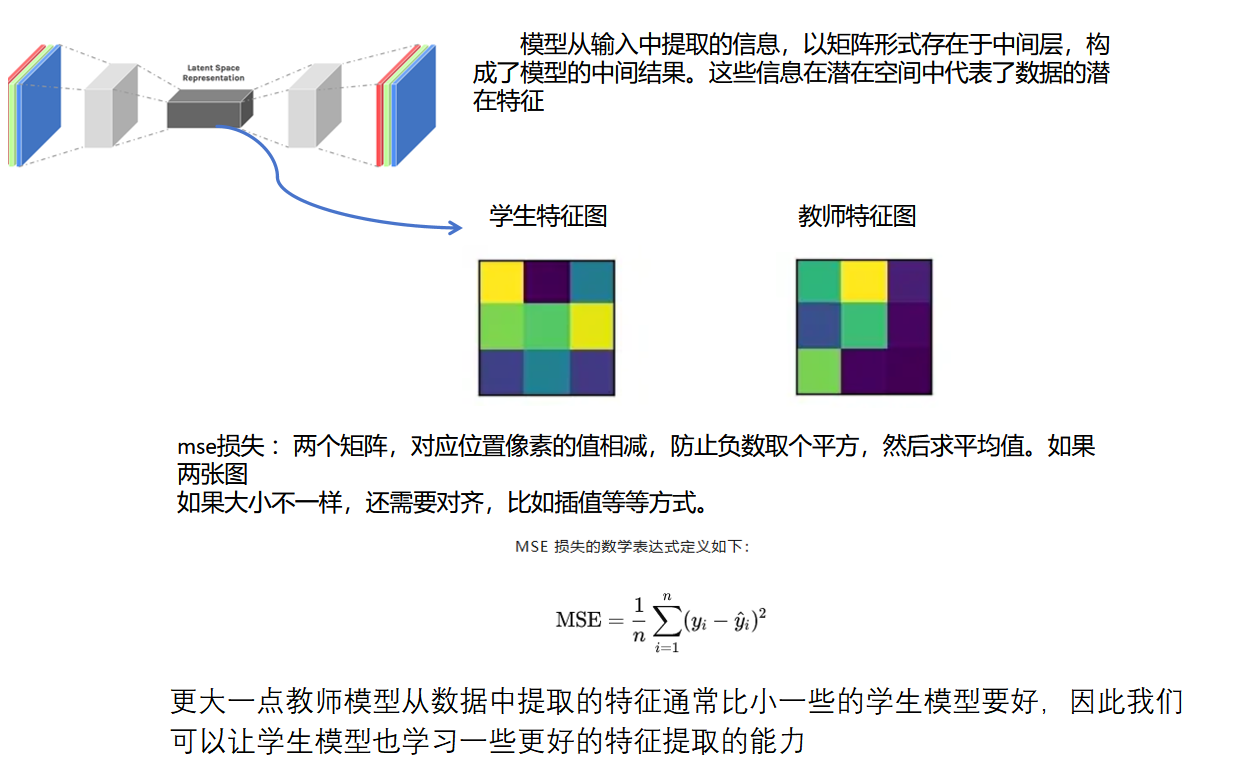
图注:原图从上到下是三块。① 上方是一个”输入 → 若干层 → 潜在空间表示(Latent Space Representation)→ 若干层 → 输出”的网络示意,配文说明中间层的输出以矩阵形式存在,是模型的中间结果,在潜在空间里代表数据的潜在特征。② 中间用一条箭头把潜在空间引出来,并排画出学生特征图与教师特征图两张热力图,两者颜色分布明显不同,说明教师和小模型在潜在空间里提取到的特征并不一致。③ 下方给出对齐方法:mse 损失(对应位置相减、平方、求均值;两张图大小不一样时还要先对齐,比如插值),并写出公式 \mathrm{MSE}=\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat y_i)^2;最后一行点明动机:更大一点的教师模型从数据中提取的特征通常比小一些的学生模型要好,因此可以让学生模型也学习一些更好的特征提取能力。
一、这份材料解决什么问题
上一篇《软硬标签》讲的是”学教师的答案分布”。但输出层只有 10 个数字(新闻分类项目是 10 分类),信息容量太小,教师在前 11 层里辛苦提炼的表示能力,被压缩到最后那个 softmax 里就剩下一丁点了。
中间特征蒸馏(也叫 hint learning / feature distillation)要解决的问题就是:把教师”看的中间过程”也传给学生。
直觉是这样的:一个 12 层的教师和一个 6 层的学生,最终都要做同一件事,把”某地新增三所社区养老服务中心”这句话编码成一个有区分度的向量。教师有 12 次机会逐步抽象,学生只有 6 次。如果只让学生的最终输出去逼近教师,学生要自己摸索出”如何用一半的层数达到同样的抽象程度”;而如果直接告诉学生”你的第 3 层输出应该长得像教师的第 6 层”,学生就有了一个明确的中间目标。
二、核心结论
- 中间层输出是矩阵(张量),它在潜在空间里代表数据的潜在特征,这是”可以拿来对齐”的前提。
- 中间特征蒸馏的监督信号是特征图之间的 MSE,不是交叉熵、不是 KL 散度。\mathrm{MSE}=\frac{1}{n}\sum(y_i-\hat y_i)^2。
- MSE 的三步机械操作:对应位置相减 → 防止负数干扰先取平方 → 对所有位置求平均。
- 尺寸不匹配是这条路线的首要工程问题:教师的特征图和学生的特征图维度通常不一样,必须先”对齐”(插值、1×1 卷积映射、线性投影等)才能算 MSE。
- 动机一句话:教师提取特征的能力更强,所以让学生直接学这份能力,这比只学输出更”深”,但也更贵、更挑结构。
三、知识地图
| 位置 | 原文 | 解读 |
|---|---|---|
| 上方网络图 | 输入 → 中间层 → Latent Space Representation → 中间层 → 输出 | 中间的窄层就是”潜在空间”,是特征的汇聚点 |
| 上方配文 | 模型从输入中提取的信息,以矩阵形式存在于中间层,构成了模型的中间结果。这些信息在潜在空间中代表了数据的潜在特征 | 确定了”传什么”,中间层张量 |
| 中部两图 | 学生特征图 / 教师特征图(并排两张热力图) | 可视化对比:两者分布不同,就是”差距”所在 |
| 下方配文 1 | mse 损失:两个矩阵,对应位置像素的值相减,防止负数取个平方,然后求平均值。如果两张图大小不一样,还需要对齐,比如插值等等方式 | MSE 的三步操作 + 尺寸对齐问题 |
| 中间公式 | \mathrm{MSE}=\dfrac{1}{n}\displaystyle\sum_{i=1}^{n}(y_i-\hat y_i)^2 | 标准均方误差定义 |
| 下方配文 2 | 更大一点教师模型从数据中提取的特征通常比小一些的学生模型要好,因此我们可以让学生模型也学习一些更好的特征提取的能力 | 动机 |
四、原理详解
4.1 中间层到底”存”了什么
一个分类网络可以看成两段:
输入 x → [特征提取器 f] → 特征 h(潜在表示) → [分类头 g] → logits z训练时,梯度只直接作用在 g 的输出上,f 是被间接”带”着学的。但真正决定模型能力上限的是 f,它决定”能不能把不同类别的样本在潜在空间里分开”。
教师和学生的差距主要就在 f 上:
– 教师 f_T 有更多层、更宽,学到的 h_T 里,语义相近的样本聚得更紧,不同类的边界更清楚;
– 学生 f_S 表达能力弱,h_S 里可能存在”两类混在一起”的情况,而这个混淆在最后 softmax 上可能只体现为一个小概率值,信号很弱。
所以直接监督 h_S 向 h_T 靠拢,相当于给学生指了一条中间路标。
4.2 MSE 损失:为什么是它,怎么算
\mathrm{MSE} = \frac{1}{n}\sum_{i=1}^{n}(y_i – \hat y_i)^2
配文中”两个矩阵,对应位置像素的值相减,防止负数取个平方,然后求平均值”就是这三步:
| 步骤 | 操作 | 为什么 |
|---|---|---|
| 1 | 对应位置相减 y_i – \hat y_i | 度量”差多少”,符号表示方向 |
| 2 | 取平方 (y_i-\hat y_i)^2 | 正负差不会互相抵消;大误差被放大(对离群差异更敏感) |
| 3 | 求平均 \frac{1}{n}\sum | 与特征图尺寸、batch 大小无关,得到可比的标量 |
一个 2×2 的玩具例子(把特征图当成图片看,正对应”像素”这个说法):
y_T = \begin{bmatrix} 1.0 & 2.0 \\ 3.0 & 4.0 \end{bmatrix},\qquad
h_S = \begin{bmatrix} 1.5 & 1.0 \\ 3.0 & 6.0 \end{bmatrix}
逐步算:
| 位置 | 教师 y_i | 学生 \hat y_i | 差 | 平方 |
|---|---|---|---|---|
| (1,1) | 1.0 | 1.5 | −0.5 | 0.25 |
| (1,2) | 2.0 | 1.0 | 1.0 | 1.00 |
| (2,1) | 3.0 | 3.0 | 0.0 | 0.00 |
| (2,2) | 4.0 | 6.0 | −2.0 | 4.00 |
\mathrm{MSE} = \frac{0.25+1.00+0.00+4.00}{4} = \frac{5.25}{4} = 1.3125
注意 (2,2) 位置差 2.0、贡献了 4.00,占总损失的 76%,这就是平方项的放大效应,MSE 会更用力地纠正差异最大的那些维度。反过来说,如果教师的某个特征维度存在极端值,MSE 也会被它主导,需要做归一化或者换 smooth-L1 / cosine 距离。
4.3 尺寸对齐:这条路线的最大工程坑
原图特意写上”如果两张图大小不一样,还需要对齐,比如插值等等方式”,因为这是纯输出蒸馏不会遇到的问题。维度不匹配有三种常见情况:
| 不匹配类型 | 例子 | 对齐方法 |
|---|---|---|
| 尺寸不同(层数不同) | 教师 12 层、学生 6 层;特征图 28\times28 vs 14\times14 | 插值(interpolate / 上采样)到同一尺寸 |
| 通道数不同 | 教师 768 维、学生 256 维 | 1×1 卷积 / 线性投影映射到统一维度 |
| 语义层不对应(不知道谁的哪层对谁) | 学生的第 3 层该学教师的第几层? | 人工设计映射规则(如等间隔采样),或搜索最优配对 |
“层匹配”是中间特征蒸馏最讲经验的部分。常见做法是:
– 按相对深度配对(学生的第 k 层对教师的第 2k 层);
– 在多个候选配对中做验证集搜索;
– 或者干脆只选一两处关键位置(比如最后一个 encoder block 的输出)做对齐,成本低、效果也常常够。
新闻分类项目里若学生是 FastText(只有 Embedding + 平均池化 + 线性层),根本没有可对齐的深层特征,中间特征蒸馏就用不了,这就是一个需要明确说出的选型约束(见第七节)。
4.4 完整的特征蒸馏训练流程
1. 冻结教师模型(eval 模式,torch.no_grad())
2. 一次前向:教师同时输出
      - 最终 logits      → 用于软标签损失
      - 指定层特征 h_T    → 用于特征损失
3. 学生一次前向:输出 logits 和对应层特征 h_S
4. 对齐:h_S' = align(h_S)        # 插值 / 1x1 卷积,使 h_S' 与 h_T 同形状
5. 三项损失加权求和:
      L = (1-α)·L_hard + α·T²·L_soft + β·MSE(h_T, h_S')
6. 反向传播,只更新学生参数
典型的损失组合:
| 损失项 | 监督什么 | 权重符号 | 典型取值 |
|---|---|---|---|
| \mathcal{L}_{hard} | 硬标签(正确答案) | 1-\alpha | — |
| \mathcal{L}_{soft} | 教师输出分布(类间关系) | \alpha | \alpha \approx 0.5\sim0.9 |
| \mathcal{L}_{feat} | 教师中间特征(表示能力) | \beta | \beta 需搜索,太大会压制主任务 |
训练提示:特征损失的数值量级通常远大于 KL 损失(MSE 的均值可能到 1~10,KL 通常在 0~1),所以 \beta 往往要取得很小(如 0.1 量级)甚至需要对特征做归一化(LayerNorm / L2 归一化)后再算 MSE/MSE 变体,否则主任务会被带偏。
4.5 用”热力图对比”理解学生学到了什么
原图把学生特征图和教师特征图画成两张色块图,是很聪明的可视化:
- 教师特征图:色块边界清晰,说明不同语义区域被明确区分(暗知识”分得开”);
- 学生特征图:色块更嘈杂、边界模糊,说明学生把该分开的东西混在了一起;
- 训练目标:让学生那张图的颜色分布逐渐逼近教师那张,视觉上就是”两张热力图越来越像”。
这个可视化也可以直接用在项目汇报里:训练前后各截一次”教师 vs 学生”的特征相似度(比如 CKA 或余弦相似度),把”数字提升”变成”图变像了”,说服力比单纯报准确率更强。
五、易错点与常见误解
| 常见说法 | 正确说法 | 为什么 |
|---|---|---|
| 特征蒸馏就是把师生特征图的 MSE 加起来 | 必须先对齐维度和尺寸(插值/投影),否则根本无法逐元素相减 | 原图明确写了”大小不一样还需要对齐” |
| 特征图尺寸不一样就没法做特征蒸馏 | 可以用插值上/下采样、1×1 卷积映射到同一形状 | 对齐手段是标准操作,不是死路 |
| 中间特征比输出信息多,所以特征损失权重应该更大 | 特征损失量级通常远大于 KL,\beta 往往要取得很小 | 权重量级不匹配会把主任务带偏 |
| MSE 就是”平均绝对误差” | MSE 有平方,对大误差的惩罚是二次的 | 例子里一个 2.0 的偏差占了总损失 76% |
| 特征蒸馏一定比软标签蒸馏更好 | 更”深”但更贵、更挑结构;输出蒸馏几乎零成本且通用 | 项目里应先上软标签,有预算再叠特征 |
| 学生的每一层都该对教师的某一层 | 通常只挑少数关键位置对齐,配对规则需要搜索 | 全层对齐成本高、且部分层语义不对应 |
| 特征蒸馏可以替代硬损失 | 它是在主任务损失之外的附加监督,不能替代 | 少了硬标签,学生可能连”答案”都学不准 |
六、横向对比与研究脉络
三种知识传递方式的信息量与成本:
| 方式 | 传递内容 | 信息载体 | 需要对齐 | 额外成本 | 效果趋势 |
|---|---|---|---|---|---|
| 硬标签 | 正确答案 | one-hot | 无 | 无 | 基线 |
| 软标签(logits) | 答案 + 类间关系 | 最后一层概率向量 | 无 | 教师一次前向 | 稳定提升 |
| 中间特征 | 表示能力 / 潜在空间结构 | 中间层张量 | 必需(插值/投影) | 教师多次前向 + 设计对齐层 | 容量差距大时提升更明显 |
| 关系型蒸馏 | 样本间/层间的关系 | 相似度矩阵、Gram 矩阵 | 必需 | 高 | 学”结构”而非”值” |
演进脉络:
- Hinton 等(2015):软标签蒸馏,把教师的输出分布当监督信号,确立了”暗知识”这一概念。
- Romero 等(2015,FitNets):提出 hint layer,第一次指出”光靠输出不够,让学生的隐藏层去逼近教师的隐藏层更有效”,并引入”先预热 hint 层、再训练整个网络”的两阶段流程。本图讲的就是这一支。
- Zagoruyko & Komodakis(2017,Attention Transfer):不再逐元素对齐特征,而是对齐注意力图(特征的通道聚合),对尺寸差异更鲁棒。
- 关系型蒸馏(RKD / CRD 等):从”对齐单个样本的特征值”转向”对齐样本之间的相似度结构”,让小模型学到数据流形的拓扑。
- 大模型时代:序列级蒸馏(对齐 token 分布)、思维链蒸馏(对齐推理过程),本质仍是”把教师更丰富的中间产物当监督”。
一句话总结演进逻辑:从”学答案”→”学特征”→”学关系”→”学过程”,每一步都是在把教师更大容量的中间产物尽可能多地搬到学生身上。
七、在新闻分类项目中的落地
- 能用的场景:如果学生模型选的是小号 BERT(比如 6 层 vs 教师 12 层),中间特征蒸馏可做:把学生的第 6 层输出对齐教师的第 12 层输出(或按相对深度配对),维度相同(都是 768)时不需要投影,直接算 MSE 即可,工程成本最低。
- 不能用的场景(必须说清):如果学生选 FastText,它的结构是 Embedding → 平均池化 → 线性层,没有可对齐的深层特征,中间特征蒸馏直接排除,只能走软标签路线。”为什么这里不用特征蒸馏”要能答出来,而不是含糊带过。
- 推荐的对齐策略(省成本版):
- 只对齐一处:学生最后一个 encoder block 的输出 ↔ 教师最后一个 encoder block 的输出;
- 两者维度相同(BERT 家族通常同为 hidden_size),只需做长度维度的插值或取
[CLS]位置的向量; - 用
[CLS]向量(768 维一维向量)算 MSE 最省事:n=768,y_i 是教师[CLS]的第 i 维。 - 损失权重:三项损失 \mathcal{L} = (1-\alpha)\mathcal{L}_{hard} + \alpha T^2 \mathcal{L}_{soft} + \beta \mathcal{L}_{feat},起点取 \alpha=0.7、\beta=0.1,然后在验证集上微调。务必监控三项损失的数值量级,如果 \beta\mathcal{L}_{feat} 明显大于主损失,说明 \beta 太大,学生会被特征对齐带偏而牺牲分类准确率。
- 汇报素材:训练前后把”教师 vs 学生
[CLS]向量的余弦相似度”画成曲线或热力图,直接对上原图那两张”学生特征图 / 教师特征图”,用同一套可视化讲”学生学得像了”,这在被追问时是很直观的加分点。 - 和量化叠加:特征蒸馏产出一个更小的学生,再对学生做动态量化,”小结构 + 低位宽”收益相乘,是模型压缩章节最有说服力的组合结论。
八、重点问答
Q1:中间特征蒸馏和软标签蒸馏的区别是什么?
A:软标签蒸馏学的是教师的输出分布,也就是最后一层 softmax 的概率向量,里面包含类间关系;中间特征蒸馏学的是教师在中间层提取到的特征表示,用 MSE 让学生对应层的特征图逼近教师的。区别在于监督信号的位置和容量:输出只有类别数那么多维,中间层是几百上千维的张量,信息量大得多,但也要额外解决维度对齐问题。
Q2:为什么中间特征值得学?
A:因为决定模型能力上限的是特征提取器,不是最后那个分类头。教师层数多、容量大,它提取到的特征在潜在空间里类内更紧、类间更开,也就是”特征提取能力更强”。学生层数少,只靠最终输出这一个稀疏信号去学,相当于要自己摸索出怎么用一半的层达到同等抽象程度。直接告讲它”你的第 3 层应该长得像教师的第 6 层”,等于给了它一个中间路标。
Q3:MSE 是怎么算的,为什么要取平方?
A:三步:两个矩阵对应位置相减得到误差,然后对误差取平方,最后对所有位置求平均。取平方有两个作用,一是防止正负误差互相抵消,二是让大误差的惩罚更重。举个例:2×2 的特征图里三个位置误差分别是 −0.5、1.0、−2.0,平方后是 0.25、1.00、4.00,其中那个 2.0 的偏差贡献了 76% 的损失。所以 MSE 会更关注差异最大的维度,但也容易被极端值主导,必要时改用 smooth-L1 或余弦相似度。
Q4:师生特征图尺寸不一样怎么办?
A:必须先对齐才能算逐元素的 MSE。常见三种情况:层数不同就按相对深度配对,比如学生的第 3 层对教师的第 6 层;空间尺寸不同就用插值上采样或下采样到同一尺寸;通道数不同就用 1×1 卷积或线性投影映射到统一维度。工程上最省事的做法是只挑一处关键位置对齐,并且尽量选维度和长度天然一致的层,比如都用 [CLS] 位置的向量算 MSE。
Q5:特征损失的权重怎么定?
A:不能设大。特征损失的量级通常远大于 KL 损失,MSE 的均值可能到 1 到 10,KL 一般在 0 到 1 之间,如果直接等权相加,主任务会被带偏。所以 \beta 一般取 0.1 量级甚至更小,或者先对特征做 LayerNorm、L2 归一化再算距离。上策是训练时监控三项损失各自的数值量级,如果附加损失明显大于主损失,就说明权重需要下调。
Q6:什么情况下中间特征蒸馏做不了?
A:学生和教师的结构差异太大时就做不了。比如学生是 FastText,结构只有 Embedding、平均池化和线性层,根本没有深层特征可以对齐,只能退回到软标签蒸馏。这也是选型时必须交代的约束,特征蒸馏要求师生都是深层网络,并且存在语义上可配对的层。
Q7:特征蒸馏中”层配对”怎么选?
A:常见做法是按相对深度配对,学生的第 k 层对教师的第 2k 层;或者在几个候选配对里用验证集搜索最优组合。更实用的做法是只选一两处关键位置对齐,比如最后一个 encoder block 的输出,因为深层的语义对应关系最明确,浅层特征差异大、对齐收益反而低。
九、延伸阅读
- Romero et al., FitNets: Hints for Thin Deep Nets(2015),hint layer 与中间特征蒸馏的开创性工作
- Zagoruyko & Komodakis, Paying More Attention to Attention(2017),注意力图蒸馏,对尺寸差异更鲁棒
- CKA(Centered Kernel Alignment),衡量师生表示相似度的常用指标,适合做汇报可视化
- 本目录《【掌握】软硬标签》研究报告,输出级蒸馏
- 本目录《【了解】双向 LSTM》研究报告,序列模型上的中间特征示例
- 本目录《【掌握】Bert 原理结构极速版》研究报告,BERT 各层输出与 hidden_size