一张「机器学习全景地图」,从 AI/ML/DL 的概念关系、数据三要素、建模流程,到 KNN / 线性回归 / 逻辑回归 / 决策树 / 集成学习 / K-Means 六大算法族,再加一个走完闭环的时间序列案例(南方电网电力负荷预测)与求职工程环节(Git、简历、求职沟通)。
一、这份材料解决什么问题
它回答的不是「某个算法怎么写」,而是评审者最想确认的那件事:你的机器学习知识是不是网状连通的。
新闻分类项目的路线是四段递进:TF-IDF + 随机森林 → FastText → BERT 微调 → LLM 零样本/少样本分类,最后做模型压缩(量化 / 蒸馏 / 剪枝 / 低秩分解)。这条路上每个东西都能在这张图上找到根:随机森林 ← 集成学习的 Bagging 分支;TF-IDF 与 749 个停用词 ← 特征工程的特征提取;10 类新闻标题 ← 有监督学习下的多分类,评价用准确率/精确率/召回率/F1;18w/1w/1w 的分法 ← 数据集划分与交叉验证;BERT 微调最怕的过拟合与学习率 ← 拟合三态与梯度下降;剪枝「去掉不重要的参数」← L1/L2 正则的同一套直觉。
导图后半段(南方电网负荷预测、人才流失预测、Git 与求职沟通流程)补的是另一类问题:你有没有独立走完过「数据 → 特征 → 训练 → 评估 → 保存 → 上线预测」的闭环。整张图的覆盖范围就是三层:机器学习基础 + 一个完整数据挖掘项目 + 工程与求职常识。
二、核心结论
- 三要素定天花板:数据决定模型效果上限,算法只是逼近上限,算力决定训不训得动。所以「怎么提升效果」的标准答案是先看数据(更多/更干净/更好的特征),再换算法。
- 有无标签决定范式,输出连不连续决定任务:有特征有标签 = 监督(标签离散→分类、连续→回归);只有特征 = 无监督(聚类、降维);部分标签 = 半监督(省标注成本);靠环境反馈拿累计奖励 = 强化学习。
- 建模是一条固定流水线:获取数据 → 数据基本处理(缺失值/异常值)→ 特征工程(最耗时最值钱) → 模型训练 → 模型评估。特征工程五件套(提取/预处理/降维/选择/组合)是唯一能同时提效果又降复杂度的环节。
- 一切训练本质都是「定义损失 → 让损失最小」:线性回归用最小二乘/MSE,逻辑回归用对数似然,决策树用信息增益/基尼指数/平方误差,K-Means 用 SSE。梯度下降是通用解法,学习率一般 0.001~0.01:太小走得慢、太大会震荡不收敛。
- 过拟合与欠拟合是一对总开关:欠拟合 = 模型太简单(特征太少)→ 加特征、加多项式;过拟合 = 模型太复杂而数据太少 → 清洗数据、加数据、正则化(L1 稀疏化 / L2 压缩参数)、降维。奥卡姆剃刀:泛化误差相同时选更简单的模型。
三、知识地图
按导图原有层级展开,【】内为建议优先级(【掌握】= 能讲原理 + 能写代码;【理解】= 能说清为什么;【了解】= 知道是什么、放在哪)。
- 机器学习概述【理解】
- 相关概述【了解】:AI(仿智,用机器模拟人,像人那样理性地思考与活动)→ ML(给训练数据让模型自己找规律、找公式,再对测试集预测)→ DL(模拟神经元网络,构建知识体系与图谱);1956 年人工智能元年;人工智能之父 约翰·麦卡锡,机器学习之父 亚瑟·塞缪尔
- 发展三要素【掌握】:
- 数据,决定效果上限。术语:样本(一条数据)、特征(从数据中抽取、对预测有用的信息/属性)、标签(需要预测的信息);数据集划分:训练集 / 测试集,常见比例 8:2 / 7:3
- 算法【理解】:分类、回归、聚类……
- 算力【了解】:CPU(IO 操作)、GPU(并行计算)、TPU(张量处理器)
- 算法分类【掌握】:有监督(有特征有标签 → 分类:二分类/多分类;回归:标签连续)、无监督(有特征无标签 → 聚类,按样本间相似性)、半监督(有特征 + 部分标签,目的是降低标注成本)、强化学习(按环境状态行动获得最多累计奖励;四要素 Agent/环境/行动/奖励)
- 建模流程【掌握】:① 获取数据 → ② 数据基本处理(缺失值、异常值)→ ③ 特征工程 → ④ 模型训练 → ⑤ 模型评估
- 特征工程五子任务【掌握】:特征提取(抽出与任务相关的特征)、预处理(不同量纲转到同一范围)、降维、特征选择(挑出重要特征)、特征组合(合成一个,一般用乘法或加法)
- 评估【掌握】:分类→准确率;回归→MAE、MSE;聚类→CH、SC
- 拟合三态【掌握】:正好 / 过拟合(训练好测试差;模型过复杂、数据不纯、数据太少)/ 欠拟合(都好不了;模型过于简单)
- 泛化【理解】:模型在新数据(非训练数据)上表现好坏的能力;奥卡姆剃刀【理解】:泛化误差相同时,更简单的模型更可取
- KNN(K 近邻)【掌握】:思想【理解】,由最近相邻样本的属性决定未知样本的属性(近朱者赤);距离【掌握】,欧式 / 曼哈顿 / 切比雪夫 / 闵氏(p=1 曼哈顿、p=2 欧式、p=∞ 切比雪夫);鸢尾花流程【掌握】,load_iris → train_test_split(test_size/random_state/stratify) → 预处理(MinMaxScaler/StandardScaler)→ fit → 交叉验证 cv + 网格搜索 GridSearchCV → predict/predict_proba → score/accuracy_score;案例【了解】,手写数字识别
- 线性回归【掌握】:概念【理解】,一元 y=kx+b(k 称权重 w、b 称偏置 bias)/ 多元 y=\mathbf{w}^T\mathbf{x}+b,API
LinearRegression;损失函数【掌握】,最小二乘、MSE、RMSE、MAE;求解,正规方程(求导/偏导/矩阵运算)与梯度下降(掌握)(流程 4 步,学习率 0.001~0.01;FGD / SGD / mini-batch / 随机平均梯度);评估【掌握】,MSE、MAE、RMSE;正则化【掌握】,L1 把不重要特征的参数压成 0(Lasso)、L2 压到趋近 0(Ridge) - 逻辑回归【掌握】:原理【掌握】,把线性回归输出送进 Sigmoid 得到 (0,1) 概率(流程 4 步),损失 = 对数似然,原则是正样本趋近 1、负样本趋近 0;评估【掌握】,准确率 / 精确率 / 召回率 / F1 / ROC 曲线与 AUC(0.5 等同随机猜测、1 完美);案例【了解】,癌症预估、电信流失用户分析
- 决策树【掌握】:概述【理解】,用于分类和回归的监督学习算法,本质是「如果……那么……」规则系统;三种树【掌握】,ID3(1975,信息增益,只能离散属性,倾向取值多的属性)/ C4.5(1993,信息增益率,可处理连续属性,缓解增益偏差,只适合能驻留内存的数据)/ CART(1984,基尼指数,分类 + 回归,离散连续都可,一定是二叉树);ID3 细节【掌握】,信息熵 H(x)=-\sum p(x)\log_2 p(x)、信息增益 IG=H(Y)-H(Y|X)(熵 − 条件熵);C4.5【掌握】,信息增益率 = 信息增益 / 特征熵(惩罚系数);CART【掌握】,分类用基尼指数最小化、回归用平方误差最小化;剪枝【掌握】,预剪枝(划分前估计,没提升就停,标为叶节点)/ 后剪枝(先长完整棵树再自底向上替换子树);案例【了解】,泰坦尼克号生存预测
- 集成学习【掌握】:思想【理解】,若干弱学习器组合提高精度;Bagging【掌握】,有放回抽样 + 随机挑 N 个特征(N < 总特征数)+ 训练 n 个弱学习器 + 平权投票多数表决,可并行、防过拟合,代表随机森林;Boosting【掌握】,逐步提高被分错样本的权重:AdaBoost(初始化权重 → 训练 → 找最小错误率算模型权重 → 更新样本权重 → 循环,结果 > 0 判正类)/ GBDT(提升树拟合残差 = 真实值 − 预测值;梯度提升树拟合负梯度,分类时损失是 logloss,构建 4 步)/ XGBoost(损失加正则化项衡量树的复杂度、二阶泰勒展开、按叶子节点看问题、gain > 0 才分裂,缓解欠拟合)
- 聚类 K-Means【掌握】:什么是聚类【理解】,按样本相似性划分到不同类别,无监督算法;家族【了解】,K-Means、层次聚类、DBSCAN、谱聚类;原理【掌握】,K 值含义(聚成几类)、K 值选择用肘部法则、实现流程 7 步、API
KMeans(n_clusters=8);评估【掌握】,SSE(越小越好)、SC 轮廓系数(越大越好)、CH 指数(越大越好) - 数据挖掘案例:南方电网电力负荷预测【理解→掌握】:时间序列介绍【了解】,应用场景(金融/交通/能源/环境)、任务分类(单变量单步 / 单变量多步 / 多变量单步 / 多变量多步)、算法选择(经典统计学时序 / 能做回归的经典 ML / 深度学习 RNN 族与 seq2seq);开发【掌握】,特征工程(时间特征、近期时间窗口负荷特征、昨日同时刻负荷特征)→ 网格搜索 + 交叉验证 → XGBRegressor → MSE/MAE →
joblib.dump();预测模块(历史数据转字典、加载模型、预测 2015-08-01 00:00:00 及以后、保存预测时间/真实负荷/预测负荷、算 MAE、画折线图);改进方向【了解】,特征工程(优化时间窗口、加温度湿度风速等外部特征)/ 算法(样本分群建模、LightGBM/RNN/iTransformer、Bagging 或 Stacking 组合)/ 预测速度(历史负荷缓存到 Redis)/ 扩展性(多数据源、容器化、预测模块解耦成接口) - 数据挖掘实战清单【了解】:人才流失预测(做这个)→ 天猫复购预测 → 捷信风控预测(有余力再做)
- Git 与简历编写【了解】:Git(分布式版本控制)/ GitHub(最大托管平台)/ Gitee(国内镜像,码云)/ GitLab(公司内部私仓);主分支 master 不允许直接改,功能在功能分支开发;PyCharm 操作对应 clone / new Branch / checkout / commit / push / merge / pull;沟通前(简历 + 一个项目文档)→ 沟通中(自我介绍 → 项目介绍 → 问答 → 提问 → 结束)→ 沟通后(录音 → 复盘 → 改进)
四、原理详解
4.1 AI、ML、DL 的关系与「三要素」
导图给的是包含链,AI 是最大的框(用机器模拟人、像人那样理性地思考和行动),ML 是 AI 的子集(不手写规则,喂数据让程序自己找规律、找公式),DL 是 ML 的子集(用模拟神经元网络去自动构建知识体系与图谱)。一句话:DL ⊂ ML ⊂ AI。三者最本质的差别在「规律从哪来」:传统程序是人写规则,机器学习是数据推规则,深度学习是连特征也由网络自己学。
三要素:数据、算法、算力,导图明确写了数据决定模型效果的上限。这句话很有价值:被问「准确率不到 90% 怎么办」,正确顺序是「先看数据量与数据质量 → 再看特征工程 → 最后才换模型调参」。算力虽只有三行(CPU 擅长 IO、GPU 擅长并行、TPU 是张量处理器),但对应项目后半段的模型压缩与部署。
同一个新闻分类任务,TF-IDF + 随机森林上限不高,TF-IDF 只有词频统计、丢了词序与上下文。把特征换成 BERT 的 embedding,上限立刻抬高。这不是算法变聪明,而是特征携带的信息量变了。
4.2 算法分类:一张「有没有标签」的表
| 范式 | 训练数据 | 典型任务 | 代表算法 | 评价指标 |
|---|---|---|---|---|
| 有监督 | 有特征、有标签 | 分类(离散)、回归(连续) | KNN、逻辑回归、决策树、随机森林、XGBoost | 准确率/P/R/F1/AUC;MSE/MAE/RMSE |
| 无监督 | 有特征、无标签 | 聚类、降维 | K-Means、层次聚类、DBSCAN、谱聚类 | SSE、SC、CH |
| 半监督 | 有特征、部分标签 | 分类 | 自训练/伪标签、标签传播 | 同分类 |
| 强化学习 | 状态-动作-奖励 | 序贯决策 | Q-Learning、策略梯度 | 累计奖励 |
半监督那一支导图特意写了动机:降低标注标签的成本。这与 LLM 路线同源,用 DeepSeek API 做零样本/少样本,本质就是用强模型替代人工标注。
4.3 建模流程与「特征工程五件套」
导图给出五步:获取数据 → 数据基本处理 → 特征工程 → 模型训练 → 模型评估。第 2 步明确了缺失值与异常值处理(导图未写方法,通用答法:数值列用均值/中位数/分组均值,类别列用众数或单列「缺失」类,缺失比例过高直接删列)。第 3 步是唯一展开成五个子任务的地方:
| 子任务 | 做什么 | 常用手段 | 项目落点 |
|---|---|---|---|
| 特征提取 | 抽出与任务相关的特征 | 文本→词袋/TF-IDF/embedding;时间→年/月/日/时/星期 | TF-IDF 向量化新闻标题 |
| 特征预处理 | 不同量纲转到同一范围 | 归一化 MinMaxScaler、标准化 StandardScaler | KNN 必需,树模型可省 |
| 特征降维 | 降低原始维度 | PCA 等(导图未展开) | 文本高维省内存 |
| 特征选择 | 挑出重要特征 | 方差筛选、卡方、模型重要性、L1 | 749 个停用词过滤属同类思路 |
| 特征组合 | 多个特征合成一个 | 一般用乘法或加法 | 组合特征常被随机森林自动学到 |
手写数字识别(导图的 KNN 案例)每张图是 8×8 灰度像素,直接当特征就是 64 维;鸢尾花只有 4 维。这些量级 KNN 都跑得动,但换成 18 万条新闻标题、词表几万维,KNN 因「每次预测都要和全部训练样本算距离」而不可用,这就是项目最终选随机森林的直接原因之一。
4.4 KNN:距离怎么定义,K 怎么选
近朱者赤。看新样本周围最近的 K 个已知样本,谁多听谁的。
四个距离是同一个闵氏距离在不同 p 下的特例:
d_p(a,b)=\left(\sum_{i=1}^{D}|a_i-b_i|^p\right)^{1/p}
p=1 曼哈顿(各维度差绝对值之和)、p=2 欧式(平方和再开方)、p\to\infty 切比雪夫(差的最大值)。
a=(1,2)、b=(4,6)。曼哈顿 =3+4=7;欧式 =\sqrt{9+16}=5;切比雪夫 =\max(3,4)=4。三种度量给出三种「谁更近」,所以距离度量本身就是超参数。
超参搜索:导图把它放在 KNN 支下,但它全流程通用。交叉验证(cv)把数据均分 cv 份,每份轮流当验证集、其余 cv-1 份当训练集;网格搜索穷举 param_grid 组合,结果用 best_score_(最优结果)、best_estimator_(最好参数模型)、cv_results_(结果集)取。
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier

x, y = load_iris(return_X_y=True)
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=22, stratify=y)  # stratify 按类别比例切

scaler = StandardScaler()                  # 消除量纲差异,KNN 必需
x_train = scaler.fit_transform(x_train)    # 训练 + 转换
x_test = scaler.transform(x_test)          # 只转换,复用训练集统计量

grid = GridSearchCV(KNeighborsClassifier(),
                    {"n_neighbors": [3, 5, 7]}, cv=5)
grid.fit(x_train, y_train)
print(grid.best_score_, grid.best_estimator_)
print(grid.best_estimator_.predict(x_test))坑:fit_transform() 只能用于训练集,测试集必须 transform(),否则测试集自身统计量会漏进流程、评估虚高。random_state 是随机种子,作用是「保证每次随机拿到相同的部分」,写它才能复现。
4.5 线性回归:从「拟合一条线」到「梯度下降」
假设特征与标签之间存在一条全局直线。一元 y=kx+b,机器学习里 k 叫权重 w、b 叫偏置 bias;多元写成 y=\mathbf{w}^T\mathbf{x}+b。导图的例子:一元用身高预测体重(1 个特征列);多元用学历、考试成绩、专业、工作年限预测薪资(多个特征列、1 个标签列)。API 是 LinearRegression。
多元形式的矩阵含义:这张附件图讲的就是 \mathbf{w}^T\mathbf{x}+b 怎么用矩阵乘法算。
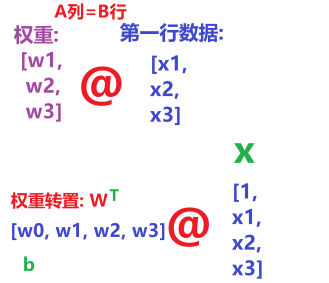
图注:图分上下两块。上块标题「A 列=B 行」(矩阵乘法的合法性条件),左侧紫色是权重列向量 [w1, w2, w3],中间红色 @ 代表矩阵乘法,右侧蓝色是「第一行数据」列向量 [x1, x2, x3]。下块是加偏置的版本:红色标注「权重转置:\mathbf{w}^T」,权重写成 [w0, w1, w2, w3],与右侧绿色 × 的 [1, x1, x2, x3] 相乘,其中 1 是给偏置 w_0 预留的那一维,最下方绿色 b 是偏置项。这张图讲的是同一件事的两种写法:把 b 单独拿出来是 \mathbf{w}^T\mathbf{x}+b;把 b 当作 w_0、并给样本补一个恒为 1 的特征,就能统一成一次矩阵乘法,这就是代码里用矩阵运算一次性算出所有样本预测值的原因。
损失函数:误差 = 预测值 − 真实值;最小二乘 = 所有样本误差的平方和;MSE = 最小二乘 / 样本个数;RMSE = MSE 开平方根;MAE = \frac1n\sum|\hat y_i-y_i|(对异常值更稳健)。
真实值 [3, 5, 7],预测值 [2.5, 5.5, 6] → 误差 [-0.5, 0.5, -1];最小二乘 =1.5;MSE =0.5;RMSE \approx0.707;MAE =0.667。RMSE 恒 ≥ MAE,差距越大说明存在个别大偏差样本。
怎么让损失最小:① 正规方程(求导、求偏导、矩阵运算一步解出解析解);② 梯度下降(导图标「掌握」):1. 给定初始位置与步长(学习率);2. 计算当前点梯度的负方向;3. 沿负梯度方向移动一个步长;4. 重复 2~3,直到两次差距小于阈值或达到迭代次数。可背成一句:下个点 = 当前点 − 学习率 ×(损失的导数/偏导),单变量求导、多变量求偏导。学习率经验值 0.001~0.01,不要过大或过小。
| 变体 | 每步用多少样本 | 优点 | 缺点 |
|---|---|---|---|
| 全梯度 FGD | 全部样本 | 方向准、稳定 | 消耗资源多 |
| 随机梯度 SGD | 随机 1 个 | 单步极快 | 易受异常值影响、震荡 |
| mini-batch | 随机一批 | 兼顾两者,目前使用最多 | 需调 batch size |
| 随机平均梯度 SAG | 1 个 + 历史梯度平均 | 收敛平滑 | 初期表现不佳 |
正则化:给损失加正则化项,减少甚至消除不重要特征的影响。L1 把不重要特征前的参数压成 0(稀疏解,顺带做了特征选择)→ Lasso;L2 压到趋近 0 但不为 0 → Ridge。
4.6 逻辑回归:回归的壳子,分类的内核
名字带「回归」,但它是分类模型。先用线性模型按特征重要性算出一个值 f(x)=\mathbf{w}^T\mathbf{x}+b(范围 (-\infty,+\infty)),再用 Sigmoid 压到 (0,1) 当概率,最后设阈值判类。
导图的四步流程逐字记住:① 用 f(x)=\mathbf{w}^T\mathbf{x}+b 算出值;② 用 Sigmoid 映射为概率值 (0,1);③ 设阈值(如 0.5),大于则判 1 类;④ 否则判 0 类。损失是对数似然损失,原则一句话:正样本预测结果尽可能接近 1,负样本尽可能接近 0。
算得 f(x)=1.2,\sigma(1.2)\approx0.769>0.5 → 判正类;算得 -1.2,\sigma(-1.2)\approx0.231<0.5 → 判负类。
评估方法(导图把分类指标全放在这一支下,是最该背的部分):
- 准确率 = 预测正确样本数 / 样本总数
- 精确率 Precision = 预测为正且真实为正 / 预测为正(”报出来的有多少是对的”)
- 召回率 Recall = 预测为正且真实为正 / 真实为正(”该抓的抓到了多少”)
- F1-Score = 2\times Precision\times Recall/(Precision+Recall)(调和平均)
- ROC 曲线 = 模型在不同阈值下表现的曲线;AUC = ROC 曲线下面积,AUC = 0.5 等同随机猜测,AUC = 1 完美
100 个样本,真实正样本 20 个,模型报正 25 个,其中真阳性 15 个 → Precision =15/25=0.6;Recall =15/20=0.75;F1 =2\times0.6\times0.75/(0.6+0.75)\approx0.667。类别极不均衡时准确率会骗人:99 负 1 正、全判负也有 99% 准确率,但 Recall = 0。
4.7 决策树:信息熵、信息增益与三种树
决策树是一套「如果……那么……」的规则系统,像生活中做决定一样层层考虑条件(导图举的例子是女孩儿相亲)。
信息熵衡量随机变量的不确定度,熵越大不确定性越高、信息越多:
H(X)=-\sum_i p(x_i)\log_2 p(x_i)
导图的 5 个手算例子全部保留作练习:
| 需求 | 计算 | 结果 |
|---|---|---|
| α(ABCDEFGH),8 符号各 1/8 | -8\times\frac18\log_2\frac18 | 3 |
| β(AAAABBCD),占比 1/2, 1/4, 1/8, 1/8 | -\frac12\log_2\frac12-\frac14\log_2\frac14-\frac18\log_2\frac18\times2 | 1.75 |
| 3 类各 1/3 | 3\times(-\frac13\log_2\frac13) | 1.58 |
| 3 类占 1/10, 2/10, 7/10 | -\frac1{10}\log_2\frac1{10}-\frac2{10}\log_2\frac2{10}-\frac7{10}\log_2\frac7{10} | 1.15 |
| 3 类占 {1, 0, 0} | -\log_2 1 | 0 |
规律:类别越均匀熵越大(最大 \log_2 类别数),越纯熵越小,全纯为 0。训练决策树的目标就是「切完之后子节点尽可能纯」。
信息增益 IG(X,Y)=H(Y)-H(Y|X),即「用这个特征切一刀后不确定性减少了多少」。导图例题:6 个样本按特征 A 分成 α(目标值 AAAB)与 β(目标值 BB)两组:
- 划分前的熵:(-3/6\log_2 3/6-3/6\log_2 3/6)=1
- α 组熵:(-3/4\log_2 3/4-1/4\log_2 1/4)=0.81
- β 组熵:(-1\times\log_2 1\times2)=0
- 条件熵 =\frac46\times0.81+\frac26\times0=0.54
- 信息增益 =1-0.54= 0.46
ID3 就是按信息增益选特征,但导图指出两个短板:只能对离散属性建树,且倾向选择取值较多的属性(取值多的特征把数据切得更碎,天然更容易「显得纯」)。C4.5 用信息增益率 = 信息增益 / 特征熵修正它,特征熵充当惩罚系数(取值越多、分布越均匀,特征熵越大,增益率被压低),并支持连续属性与缺失值。CART 换尺子:分类用基尼指数最小化、回归用平方误差最小化,一定是二叉树。方向别记混:ID3/C4.5 值越大越优先,CART 值越小越优先。年份(导图标注):ID3 1975、CART 1984、C4.5 1993。
剪枝是防过拟合的正则化方法,做法是「把子树的节点全部删掉,用叶子节点替换」。预剪枝:生成过程中对每个节点划分前先估计,若不能提升泛化性能就停止并标为叶节点,很多分支没展开,训练与测试开销显著减少,但可能错过「当前无提升、后续有显著提升」的划分,有欠拟合风险。后剪枝:先长完整棵树,再自底向上考察非叶节点,把子树换叶节点若提升泛化就替换,保留更多分支、泛化往往优于预剪枝,但训练开销比未剪枝和预剪枝都大得多。
4.8 集成学习:Bagging 与 Boosting 两条路线
单个弱学习器不准,把若干弱学习器组合起来提高精度。两支的本质区别是弱学习器之间独立并行还是串行纠错。
Bagging(代表:随机森林),并行、降方差:① 有放回产生训练样本(bootstrap 随机抽样);② 随机挑 N 个特征(N < 总特征数);③ 训练弱学习器;④ 重复 1~3 共 n 个;⑤ 平权投票、多数表决。要点:可并行、防过拟合。
Boosting,串行、降偏差,核心是逐步提高被分类错误样本的权重:
- AdaBoost:① 初始化数据权重,训练第 1 个弱学习器,找最小错误率算模型权重,更新样本权重;② 按新权重训练第二个,再算模型权重、再更新;③ 重复共 n 个,组合预测,结果大于 0 判正类、小于 0 判负类。
- GBDT:提升树拟合残差(真实值 − 预测值);GBDT 认识到「拟合的负梯度近似于残差」,于是把拟合目标从残差推广到负梯度,任意可导损失都能用,分类问题损失是 logloss,拟合目标就是它的负梯度。流程:① 初始化弱学习器,用目标值的均值作初始预测;② 迭代,每个学习器拟合上一个的负梯度;③ 到达指定个数停止;④ 预测时组合所有弱学习器输出。
- XGBoost:思想是「最小化损失函数,同时在损失里加正则化项衡量树的复杂度以提高泛化」。关键点:① 正则化项衡量树的复杂程度;② 用泰勒二阶展开近似目标函数,并理解「算第 t 个学习器时,第 t−1 个生成的目标函数是常数、可删」;③ 视角从按样本转换为按叶子节点输出(树的角度);④ 得到最终目标函数;⑤ 分裂判据:gain > 0 说明分裂后损失更小才分裂。导图给它的定位是缓解欠拟合。
4.9 聚类与 K-Means:K 值怎么定,效果怎么评
聚类没有标签,把相似的样本分到一起,「相似」用距离衡量。
K-Means 流程:① 事先确定 K(聚成几类);② 随机选 K 个样本点作初始聚类中心;③ 计算每个样本到 K 个中心的距离,选最近的作为标记类别;④ 根据每个类别中的样本点重新计算新的聚类中心(平均值);⑤ 新中心与原中心一样则停止,否则回到第 3 步,直到中心不再变化或达到最大迭代次数。
K 怎么选:肘部法则,看 SSE 随 K 变化的曲线,下降率突然变缓的拐点即最佳 n_clusters。
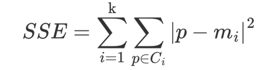
图注:图中是双层求和式 \mathrm{SSE}=\sum_{i=1}^{k}\sum_{p\in C_i}\left|p-m_i\right|^2。外层 i=1\ldots k 遍历 k 个簇,内层 p\in C_i 遍历第 i 个簇内的每个样本点 p,被平方的是样本点 p 与它所属簇质心 m_i 的差的模(图中记作 |p-m_i|)。含义就是「把每个点到它自己簇心的距离平方加起来」,故名簇内误差平方和,越小说明簇内越紧凑。它也正是 K-Means 的优化目标:每次迭代重算质心就是在降低这个量。
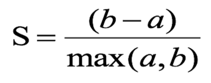
图注:图中公式 S=\dfrac{b-a}{\max(a,b)},是轮廓系数 SC 的单样本定义。图里可见符号只有 S、a、b 和分母的 \max(a,b):a 是样本与同簇其他点的平均距离(簇内不相似度,越小越好),b 是样本与最近的其它簇所有点的平均距离(簇间不相似度,越大越好)。分子 b-a 即「离别人比自己人远多少」,分母用较大者归一化,使 S 落在 [-1,1],SC 越大聚类效果越好,与导图「综合考虑簇内内聚程度与簇间分离程度」是同一件事。
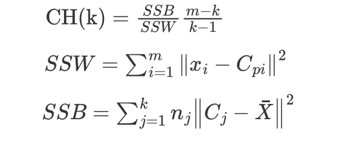
图注:这张图给了 CH 指数三个式子。第一行 \mathrm{CH}(k)=\dfrac{\mathrm{SSB}}{\mathrm{SSW}}\cdot\dfrac{m-k}{k-1},其中 m 是样本总数、k 是簇数,故 \frac{m-k}{k-1} 是自由度修正项;第二行 \mathrm{SSW}=\sum_{i=1}^{m}\left\|x_i-C_{p_i}\right\|^2 是簇内平方和(每个样本 x_i 到它所属簇 C_{p_i} 的距离平方求和,即上面那个 SSE);第三行 \mathrm{SSB}=\sum_{j=1}^{k}n_j\left\|C_j-\bar{X}\right\|^2 是簇间平方和(每个簇质心 C_j 偏离全体均值 \bar{X} 的程度,按该簇样本数 n_j 加权)。合起来看:CH 用「簇间离散 / 簇内离散」的比值衡量质量,越大越好,所以它比 SC 多考虑了一个因素:质心的个数 k(k 越大 \frac{m-k}{k-1} 越小,等于惩罚无脑增簇)。
4.10 案例:南方电网电力负荷预测(完整闭环)
需求:基于历史电力负荷数据预测未来下一个时间步的负荷,数据只有时间与电力负荷两字段,技术栈 pandas、matplotlib、sklearn、xgboost。按导图的任务分类属单变量单步预测。
├─data    # 数据源 + 数据分析的图片
├─log     # 日志
├─model   # 保存模型文件
├─src     # 主要业务逻辑,含机器学习建模代码
└─utils   # 自定义工具包
训练模块(导图标「重点」= 特征工程、训练评价):定义模型类、配置日志、取数据源 → 数据分析 → 特征工程(时间特征、近期时间窗口负荷特征、昨日同时刻负荷特征)→ 网格化搜索 + 交叉验证找最优超参数,实例化 XGBRegressor 训练 → MSE、MAE 评价 → joblib.dump() 保存。
预测模块:定义 PowerLoadPredict 类,取数据源并把历史数据转为字典(避免频繁操作 DataFrame)→ 加载模型 → 预测(确定时间段 2015-08-01 00:00:00 及以后 → 解析特征 → 预测 → 保存「预测时间、真实负荷、预测负荷」)→ 算 MAE 并画折线图看效果。
改进方向(「优化点」素材):特征工程(优化时间窗口、加温度/湿度/风速等外部特征)、算法(样本分群分别建模、LightGBM/RNN 类/iTransformer、Bagging 或 Stacking 组合)、预测速度(历史负荷缓存到 Redis)、扩展性(多数据源、容器化、预测模块解耦出接口)。这里体现两个工程直觉:「昨日同时刻负荷」= 特征组合/提取;「历史数据转字典」= 减少数据结构转换开销的推理侧优化,与模型压缩的动机同源。
4.11 工程与求职环节
- 四个名词:Git 是开源的分布式版本控制系统;GitHub 是全球最大的代码托管平台;Gitee 是 GitHub 的国内版镜像(码云);GitLab 类似 GitHub,一般用于公司内部 Git 私仓。主分支 master 保存已完成的功能代码,原则上不允许直接在上面改(风险太高),新功能在功能分支开发;PyCharm 里的操作对应 clone / new Branch / checkout / commit → push / merge / pull。
- 求职沟通流程:沟通前准备简历与项目文档(只需一个用于讲解的项目,选有把握或感兴趣的);沟通中按「自我介绍 → 项目介绍 → 问答 → 提问 → 结束」;沟通后全程录音并复盘表达(思路清晰、流畅、语速适中)与技术,要求「下一次比上一次好,哪怕只好一点点」。
- 提问红线:可问团队规模、技术栈、入职后负责什么(只问技术问题);不要问什么时候二面、加班与加班费、对今天沟通的印象、公司是外包还是自研。
- 实战清单:人才流失预测(导图标注「做这个」)→ 天猫复购预测 → 捷信风控预测(有余力再做)。
五、易错点与常见误解
- 常见说法:导图在「类别占比 {1, 0, 0}」那条注释里写「所以是:熵为 1」;实际上,正确结果是熵为 0(-\log_2 1=0) → 这是纯节点,不确定性为零;这类笔误要靠公式自检。
- 有人以为导图写「标准化:(x-mean)/var」;实际上,分母是标准差 std:x’=\frac{x-\mu}{\sigma} → Z-score 的定义就是减均值除标准差,方差是 std 的平方。
- 常听到的一种说法是:「逻辑回归是回归算法」;实际上,它是分类算法 → 判据是输出为类别 + 损失为对数似然而非 MSE,名字只因中间量沿用了线性回归的输出。
- 容易想岔的地方:「准确率高就说明模型好」;实际上,类别不均衡时必须看 Precision/Recall/F1/AUC;AUC = 0.5 就是瞎猜 → 99% 负样本时全判负也有 99% 准确率,但召回率为 0。
- 先说一个误解:「测试集也用
fit_transform()省事」;实际上,测试集只能用transform()→ 否则测试集自身统计量漏进流程,评估虚高。 - 常见说法:「KNN 训练快所以适合大数据」;实际上,它是懒惰学习,无训练但有极慢的预测,且必须先统一量纲 → 每预测一条要和全部训练样本算距离,18w 数据上不可行。
- 有人以为「有放回抽样会把所有样本抽到」;实际上,每次约只有 63.2% 的样本被抽中,剩下的袋外样本没参与训练 → 正是「每棵树看到的数据不同」造就了随机森林的多样性并降低方差。
- 常听到的一种说法是:「Bagging 和 Boosting 都能并行」;实际上,Bagging 独立可并行,Boosting 串行(后一个依赖前一个的误差/负梯度) → Bagging 降方差、Boosting 降偏差,机制不同。
- 容易想岔的地方:「决策树一定能处理连续特征、一定是二叉树」;实际上,只有 CART 一定是二叉树(离散连续都能处理);ID3 只能离散,C4.5 才支持连续 → 判据(信息增益/增益率/基尼指数)决定了各自的能力边界。
- 先说一个误解:「三种树的选择方向一样」;实际上,ID3/C4.5 值越大越优先,CART 值越小越优先 → 前者是不确定性减少量、后者是不纯度,方向天然相反。
- 常见说法:「预剪枝一定比后剪枝好」;实际上,预剪枝省时间但有欠拟合风险,后剪枝泛化通常更好但训练开销大得多 → 预剪枝可能错过「当前无提升、后续显著提升」的划分。
- 有人以为「K-Means 的 K 越大越好」;实际上,用肘部法则看 SSE 拐点,不能盲增 → K 增大时 SSE 必然单调下降,K = N 时 SSE = 0 但聚类已无意义;SC/CH 才对簇数有内在惩罚。
- 常听到的一种说法是:「半监督学习标签少所以效果一定差」;实际上,半监督的目的是用大量无标签数据降低标注成本并提升效果 → 无标签数据提供分布信息,配合少量标签常显著优于只用少量标签。
六、横向对比与研究脉络
6.1 三种决策树
| 维度 | ID3 | C4.5 | CART |
|---|---|---|---|
| 年份(导图标注) | 1975 | 1993 | 1984 |
| 分支判据 | 信息增益 | 信息增益率 = 增益 / 特征熵 | 分类基尼指数、回归平方误差 |
| 优先方向 | 增益越大越优先 | 增益率越大越优先 | 越小越优先 |
| 特征类型 | 只能离散 | 可处理连续 | 离散、连续都可 |
| 任务 | 分类 | 分类 | 分类 + 回归 |
| 树形态 | 不限 | 不限 | 一定是二叉树 |
| 已知短板 | 倾向取值多的属性 | 只适合能驻留内存的数据集 | 需调参控复杂度 |
| 缺失值 | 无专门处理 | 增加了处理方法 | — |
6.2 集成学习两大流派
| 维度 | Bagging(随机森林) | Boosting(AdaBoost/GBDT/XGBoost) |
|---|---|---|
| 训练方式 | 弱学习器独立并行 | 串行,后一个拟合前一个的误差 |
| 样本处理 | 有放回随机抽样 | 每轮提高被分错样本权重(AdaBoost)/ 拟合负梯度(GBDT) |
| 特征处理 | 随机挑 N 个特征(N < 总特征数) | 一般不额外抽样 |
| 组合方式 | 平权投票、多数表决 | 按模型权重加权(AdaBoost 结果 > 0 判正类) |
| 主要作用 | 降方差、防过拟合 | 降偏差、缓解欠拟合(XGBoost 标注) |
| 并行性 | 可并行 | 不可并行 |
| 关键超参 | 树的数量 n、特征子集大小 N | 学习率、弱学习器个数、树深、正则化项 |
6.3 距离度量与梯度下降变体
| 距离 | 定义 | 闵氏 p | 特点 |
|---|---|---|---|
| 曼哈顿 | 各维度差绝对值之和 | 1 | 对异常值相对不敏感 |
| 欧式 | 差的平方和开方 | 2 | 最常用,对量纲敏感 |
| 切比雪夫 | 差的最大值 | ∞ | 只看差异最大的那一维 |
| 闵氏 | 差的 p 次方和开 p 次方 | 可调 | 上述三者的统一形式 |
| 梯度下降 | 样本量/步 | 稳定性 | 资源 | 使用 |
|---|---|---|---|---|
| FGD | 全部 | 最稳 | 最贵 | 小数据集 |
| SGD | 1 | 最不稳 | 最省 | 在线学习 |
| mini-batch | 一批 | 平衡 | 平衡 | 目前使用最多 |
| SAG | 1 + 历史平均 | 平滑 | 需存历史梯度 | 初期表现不佳 |
6.4 聚类算法与评估指标
| 算法 | 思路 | 需指定簇数 |
|---|---|---|
| K-Means | 迭代「分配最近质心 → 重算均值」 | 需要(K) |
| 层次聚类 | 自底向上合并或自顶向下分裂 | 不需要 |
| DBSCAN | 基于密度连成簇 | 不需要 |
| 谱聚类 | 基于图/相似度的谱分解 | 需要 |
| 指标 | 衡量什么 | 方向 | 是否惩罚簇数 |
|---|---|---|---|
| SSE | 簇内误差平方和 | 越小越好 | 不惩罚(需配肘部法则) |
| SC | 簇内内聚 vs 簇间分离 | 越大越好 | 间接 |
| CH | SSB/SSW + 自由度修正 \frac{m-k}{k-1} | 越大越好 | 显式惩罚 |
6.5 演进脉络(谁解决了谁的什么问题)
- AI → ML → DL:从「人写规则」到「数据推规则」,再到「连特征也由网络自己学」,每一步都在减少人工先验。
- ID3 → C4.5:ID3 倾向选择取值多的属性,C4.5 用信息增益率(除以特征熵做惩罚)修正,并支持连续属性与缺失值;CART 另开一路,用基尼指数(分类)/ 平方误差(回归),计算量更小、统一为二叉树、同时支持分类与回归。
- 单棵决策树 → 随机森林:单树方差大、易过拟合,Bagging 用「样本有放回 + 特征随机 + 平权投票」降方差。
- AdaBoost → GBDT → XGBoost:AdaBoost 靠调整样本权重纠错;GBDT 把「拟合残差」推广为「拟合负梯度」,于是任意可导损失都能用;XGBoost 再加正则化项衡量树的复杂度,用泰勒二阶展开求解,视角从「按样本」换成「按叶子节点」,分裂判据是 gain > 0。
- KNN → 线性回归:从「不学参数、全靠预测时找邻居」到「显式学一组参数」,这是第一次出现损失函数与梯度下降。
- 线性回归 → 逻辑回归:线性输出的范围是全体实数,用 Sigmoid 压到 (0,1) 即得概率,损失从 MSE 换成对数似然,同一套线性骨架,换输出层和损失就从回归变分类。
- 反向的一条线:模型越强(随机森林 → BERT → LLM)部署成本越高,于是有了量化 / 蒸馏 / 剪枝 / 低秩分解;导图里「L1 把参数压成 0」正是剪枝思想的雏形。
七、在新闻分类项目中的落地
| 导图知识点 | 项目落点 |
|---|---|
| 有监督 / 多分类 | 新闻标题 → 10 个类别,标签离散 |
| 数据集划分 | 训练 18w / 测试 1w / 验证 1w;stratify 保证类别比例一致 |
| 特征提取 | TfidfVectorizer(stop_words=停用词).fit_transform(),749 个停用词过滤 |
| 随机森林(Bagging) | 第一个基线模型:TF-IDF + 随机森林 |
| 模型评估 | 准确率为主,配合 P/R/F1 看各类别差异 |
| 过拟合与正则化 | 随机森林自身抗过拟合;BERT 微调要靠验证集早停、降学习率、正则化控过拟合 |
| 梯度下降与学习率 | BERT 微调学习率量级远小于经典 ML,需 warmup 与较小 lr,否则 loss 震荡 |
| 交叉验证 + 网格搜索 | 经典模型阶段的超参搜索范式 |
| 聚类思路 | 先分群再分别建模(南方电网案例给的改进方向) |
| 模型压缩(算力侧) | 量化 QAT/PTQ/DQ、蒸馏(软/硬标签,F.kl_div())、剪枝(global_unstructured)、低秩分解 |
| 工程与 Git | 分支开发、commit/push/merge、项目文档与求职串讲 |
关键参数怎么调:随机森林,n_estimators 先给较大值(树多通常不掉点、代价是时间),max_depth 控单树复杂度,文本高维稀疏场景对特征缩放不敏感、可不标准化;TF-IDF,stop_words 用给定的 749 个停用词,控 max_features 与 min_df 抑制超长词表;BERT 微调,学习率小、轮次少(1~3 epoch 常见),靠验证集损失早停,max_length 与 batch size 受显存约束;LLM,prompt 里把 10 个类别定义与输出格式写死,让返回可直接解析,少样本时每类给 1~2 例;蒸馏,loss = (1-alpha)*hard_loss + alpha*(T*T)*soft_loss,温度 T 与 alpha 是主要旋钮。
实际坑在哪:① 类别不均衡,10 类样本量必然不均,主指标不只看准确率;② TF-IDF 丢词序,标题里「不」「未」若被停用词表误删会语义翻车,停用词表要按任务审视;③ 验证集纪律,调参只看验证集,测试集最后只跑一次(与 transform() 而非 fit_transform() 同一条纪律);④ 线上推理成本,BERT/LLM 延迟与显存远高于 TF-IDF + 随机森林,所以才有模型压缩这一步,被问「上线选哪个」应回答「按效果/成本曲线选」。
与项目其它方案的配合:四个模型不是替代而是成本-效果阶梯,TF-IDF + 随机森林是可控基线(快速验证数据与标签质量),FastText 用更轻的模型拿可比的文本分类效果(数据格式 __label__标签名 文本,train_supervised() / autotuneValidationFile / save_model(),test() 返回样本数、精确率、召回率),BERT 微调把上限拉高,LLM 做「不训练也能分类」的兜底与对比。这套叙事里,第一节的范式与指标是地基,集成学习是基线的原理,聚类与时序案例是「我还会做别的任务」的加分项。
八、重点问答
Q1:机器学习、深度学习、人工智能是什么关系?
A:是包含关系:深度学习 ⊂ 机器学习 ⊂ 人工智能。人工智能是最大的目标,就是让机器像人那样理性地思考和行动;机器学习是实现它的一种方式,不写死规则,而是给模型训练数据让它自己找规律、找公式,再对测试集做预测;深度学习是机器学习里最强但也最吃数据的一支,用模拟神经元网络自动构建知识体系。我记成一句话:AI 是目的,ML 是方法,DL 是方法里的重型武器。
Q2:完整建模流程是什么?最容易出问题的是哪一步?
A:五步,获取数据、数据基本处理(缺失值和异常值)、特征工程、模型训练、模型评估。特征工程又分特征提取、预处理、降维、特征选择和特征组合五个子任务。我觉得最容易出问题也最值钱的是特征工程,因为「数据决定模型效果上限」说的就是它:算法只是逼近上限,特征不行换模型也救不回来。我在项目里也验证了,TF-IDF 词表处理方式一变,随机森林分数的波动比换算法还大。
Q3:KNN 和随机森林,为什么项目选随机森林?
A:核心差在代价结构和偏差方差。KNN 是懒惰学习,没有训练过程,但每预测一条就要和全部训练样本算距离,我这 18 万条数据上根本不可用,而且它对量纲极敏感、必须先标准化。随机森林是 Bagging 集成,训练完模型就固定,预测只是一串树判断,同时靠有放回抽样和特征随机采样降方差、抗过拟合。另外随机森林能直接给特征重要性,方便解释模型。
Q4:过拟合和欠拟合怎么判断、怎么解决?
A:看训练集和测试集的差距。过拟合是训练好、测试差,原因是模型太复杂、数据太少、拟合了异常值;解法是清洗数据、增大数据量、加正则化、减少特征维度。欠拟合是两者都差,原因是模型太简单、特征学得太少;解法是加特征、做特征组合、加多项式。还有一条原则叫奥卡姆剃刀:泛化误差相同时选更简单的模型。正则会区分 L1 和 L2,L1 把不重要特征的参数压成 0,等于顺带做了特征选择,对应 Lasso;L2 压到趋近 0 但不为 0,对应 Ridge。
Q5:为什么逻辑回归名字叫回归,却是分类模型?
A:因为它的中间量确实是用线性回归那套算的,先按特征重要性算出 w^Tx+b,再用 Sigmoid 压到 0 到 1 之间当概率,最后设阈值比如 0.5,大于判 1 类、否则判 0 类。判断它是不是分类模型看两点:输出是类别而不是连续数值,损失是对数似然而不是均方误差。所以准确说法是「线性骨架 + Sigmoid + 对数似然损失 = 分类模型」。
Q6:分类任务为什么不能只看准确率?
A:因为类别不均衡时准确率会骗人,99 个负样本 1 个正样本,全判负也有 99% 准确率,但该抓的一个没抓到。所以我四个指标一起看:精确率是「报为正的里有多少是对的」,看误报成本;召回率是「真实正类里抓到了多少」,看漏报成本;F1 是两者的调和平均,用来做单一指标排序;AUC 是把不同阈值下的表现画成 ROC 曲线后的面积,0.5 是随机猜测、1 是完美,它衡量排序能力、不受阈值影响。
Q7:决策树三种实现有什么区别?信息增益有什么缺陷?
A:ID3 用信息增益选特征,问题是倾向选择取值多的属性,取值多意味着把数据切得更碎、天然更容易显得纯,所以增益有偏差。C4.5 就是来解决它的,用信息增益率,也就是信息增益除以特征熵,特征熵相当于惩罚系数,取值越多惩罚越大,它还能处理连续属性和缺失值,但只适合能驻留内存的数据集。CART 换另一套判据:分类用基尼指数、回归用平方误差,计算量更小,而且一定是二叉树,离散连续都能处理。方向别搞混:ID3、C4.5 是值越大越优先,CART 是值越小越优先。
Q8:随机森林和 Boosting 有什么区别?XGBoost 改进了什么?
A:最本质的区别是弱学习器之间并行还是串行。随机森林属 Bagging:有放回抽样样本、随机挑一部分特征,训练很多棵独立并行的树,最后平权投票,主要作用降方差、防过拟合。Boosting 是串行纠错:AdaBoost 每轮提高被分错样本的权重,按错误率给每个学习器算模型权重,最后加权组合,结果大于 0 判正类;GBDT 把「拟合残差」推广成「拟合负梯度」,所以任意可导损失都能用,分类时损失是 logloss、拟合目标就是它的负梯度。XGBoost 在 GBDT 上加了两点:损失函数里加正则化项衡量树的复杂度以提升泛化;用泰勒二阶展开近似目标函数,并把视角从按样本转成按叶子节点看,分裂时用 gain 大于 0 判断,分裂后损失更小才分裂。整体上 Boosting 主要缓解欠拟合,Bagging 主要防止过拟合。
九、延伸阅读
- 数据集:sklearn 内置
load_iris()、load_digits()、load_breast_cancer();竞赛方向(对应导图实战清单)人才流失(HR Analytics)、天猫复购预测、捷信风控。 - 官方文档(导图出现的 API 都有官方页):scikit-learn 的
sklearn.model_selection(train_test_split/GridSearchCV)、sklearn.preprocessing(MinMaxScaler/StandardScaler)、sklearn.neighbors、sklearn.linear_model(LinearRegression/Lasso/Ridge)、sklearn.cluster.KMeans、sklearn.metrics(accuracy_score);XGBoost 官方文档(XGBRegressor);Joblib 官方文档(joblib.dump()/load())。 - 工具与库:pandas / matplotlib / numpy;FastText(
train_supervised()、autotuneValidationFile、save_model()、test());PyCharm + Git。 - 文档与规范:XMind 官方帮助(导图结构与导出);Git 官方 Pro Git(分支模型的权威说明)。